Un mois après avoir demandé à effectuer une « pause » au vu des risques que poseraient les IA les plus avancées, Anthropic a rédigé un projet de loi de régulation. Il prévoit de permettre aux États-Unis de bloquer celles qui pourraient tuer ou blesser gravement « plus de 50 personnes », ou causer « plus d’un milliard de dollars de dommages », mais limite le montant des amendes à 0,2 % de leurs revenus.
POLITICO s’est procuré le projet confidentiel de régulation de la sécurité et de la sûreté des IA (« AI safety » en VO) de pointe qu’Anthropic a discrètement présenté à des représentants du Congrès états-unien. Une initiative qui intervient un peu plus d’un mois après que Dario Amodei a appelé à faire une « pause » dans le développement des IA (quand bien même leurs dépenses montrent l’inverse), puis que les patrons de l’IA ont réclamé une régulation mondiale à l’ONU.
L’objectif serait de permettre au gouvernement d’émettre un « ordre de blocage » de mise sur le marché ou d’utilisation d’un modèle « uniquement si celui-ci présente un risque prévisible et imminent de causer plus d’un milliard de dollars de dommages, ou de tuer ou de blesser gravement plus de 50 personnes », souligne POLITICO.
Ce type de « risque catastrophique » est cela dit cantonné à trois possibilités limitatives : « fournir une assistance de niveau expert dans la création ou la libération d’un produit chimique, arme biologique, radiologique, cybernétique ou nucléaire » (NRBC), « s’engager, sans surveillance, intervention ou supervision humaine significative, dans une cyberattaque », ou bien « échapper au contrôle de son développeur ou utilisateur ». La proposition exclut en outre toute « activité légale du gouvernement fédéral ».
« En d’autres termes, si un modèle semblait susceptible de tuer ou de blesser gravement seulement quelques personnes, ou de causer des dégâts matériels d’une valeur inférieure à un milliard de dollars, le gouvernement ne serait pas en mesure de le réglementer », ironise de son côté Mother Jones.
Pour rappel, le PDG d’Anthropic, Dario Amodei, qui n’avait « jamais soulevé d’objections à l’égard d’opérations militaires », avait déjà refusé, en février dernier, que ses IA puissent être utilisées pour de la surveillance de masse à l’intérieur du pays, ainsi que par des armes totalement autonomes.
Donald Trump avait alors publiquement ordonné à toutes les agences des États-Unis de cesser d’utiliser Claude et les produits d’intelligence artificielle d’Anthropic en février dernier, le qualifiant de « fournisseur à risque pour la sécurité nationale ».
Des amendes plafonnées à 0,2 % du revenu annuel, et conditionnées
POLITICO relève par ailleurs qu’Anthropic propose aussi que des évaluateurs indépendants, enregistrés auprès du ministère du Commerce, soient par ailleurs chargés d’évaluer périodiquement le laboratoire et ses modèles de pointe. Le document précise que ces évaluateurs pourraient être rémunérés par le laboratoire lui-même, à condition que cette rémunération ne dépende pas des résultats des évaluations.
En cas de « risque imminent et précis », ces évaluateurs devraient le signaler dans les 72 heures suivant la fin de leur évaluation au ministère du Commerce. Ce dernier pourrait de son côté demander au juge de suspendre la mise sur le marché d’un modèle présentant un risque. Le texte interdit par contre explicitement à tout autre ministère, agence ou fonctionnaire de suspendre le développement, le déploiement ou l’utilisation interne d’un modèle.
Il reste 58% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
« Il faut être impitoyable envers les casseurs parce qu’ils trahissent la France », a déclaré Gérald Darmanin au JT de 20H de TF1 ce lundi 19 octobre, en réponse aux pillages effectués en marge des manifestations du samedi 17 octobre.
« Il y a eu 2.513 gardes à vue au moment où je parle », a précisé le ministre de la Justice, soulignant que l’immense majorité des personnes concernées étaient encore en garde à vue devant les services de police et que « la réponse pénale, on la saura définitive en fin de semaine » :
« Déjà plus d’un demi-millier de ces personnes, plus de 500 personnes, sous escorte policière, ont été déférées au tribunal pour être présentées aujourd’hui, demain et après-demain en comparution immédiate. »
Le garde des Sceaux a également envoyé lundi matin une instruction à tous les parquets de France « pour leur demander de passer en qualification de criminalité organisée ce qui s’est passé », afin de leur permettre de recourir à des techniques dites « techniques spéciales d’enquête » qualifiées par Valéry Muller, vice-président chargé de l’instruction au tribunal judiciaire de Paris,, de « particulièrement offensives ».
« Ça veut dire d’abord qu’on pourra passer les gardes à vue de 48 à 72 heures pour que les services de police puissent faire leur travail vu l’afflux de gardes à vue », a précisé Gérald Darmanin :
« Ça veut dire aussi qu’on va pouvoir faire des géolocalisations, des écoutes téléphoniques, qui vont nous permettre de savoir, en regardant les téléphones des personnes qui sont en garde à vue, s’ils ont participé et comment ils ont participé, où ils étaient au moment où on a pillé des magasins, attaqué des mairies. Et puis surtout, on va utiliser le moyen de la reconnaissance faciale sur le TAJ (Traitement des antécédents judiciaires), c’est-à-dire le fichier des policiers, il y a des millions de personnes qui sont dans ce fichier, pour regarder si sur les réseaux sociaux, on n’a pas les mêmes images. »
Interrogé ce mardi matin sur CNEWS (X.com / Facebook), Gérald Darmanin précise qu’ « aujourd’hui, 123 personnes sont incarcérées, soit en détention provisoire soit en mandat de dépôt », et que « plus de 700 personnes sont déférées dans les dépôts, c’est-à-dire les endroits où l’on attend d’être condamné ».
Le département états-unien de la Sécurité intérieure (DHS) ordonne le retrait des produits DeepSeek et services tiers utilisant le modèle d’IA chinois des systèmes informatiques des agences civiles fédérales, rapporte l’agence Reuters. Le DHS leur interdit également d’acquérir des produits DeepSeek, ainsi que des services tiers développés à l’aide des outils de l’entreprise chinoise.
L’AFP précise que le DHS, qui a autorité sur les services civils du gouvernement (mais pas sur l’armée ni le renseignement américain), ne motive pas sa décision dans l’avis.
Reuters souligne cela dit que dans une note de service datée de juillet et rendue publique ce lundi, en annexe du mémo, le DHS avait déjà demandé aux agences fédérales de surveiller le trafic entrant et sortant des sites web gouvernementaux afin de faire face aux risques potentiels liés à DeepSeek.
Le DHS expliquait que les modèles DeepSeek comportent « plusieurs vecteurs de menace », qu’ils « peuvent contenir des logiciels malveillants ou d’autres vulnérabilités de sécurité », et que « plusieurs vulnérabilités critiques » avaient été découvertes dans son application mobile iOS en 2025.
Il s’inquiétait également du fait que l’utilisation de ce produit « pourrait entraîner le transfert de données sensibles vers la République populaire de Chine s’il était utilisé par des employés du gouvernement américain ou des prestataires ». Le DHS indiquait enfin que l’utilisation de DeepSeek par des agences gouvernementales « pourrait générer des renseignements exploitables concernant des ressortissants américains et/ou des agences gouvernementales ».
Cette interdiction n’est pas la première aux États-Unis, relève Reuters. Plusieurs agences américaines, notamment le ministère du Commerce et la Marine, avaient ainsi déjà interdit l’utilisation de DeepSeek sur les appareils gouvernementaux. Plusieurs États, dont New York, le Tennessee et la Virginie, avaient pris des mesures similaires.
En juillet, la Federal Communications Commission (FCC) avait par ailleurs voté l’interdiction de la vente aux États-Unis d’appareils contenant des composants matériels clés provenant d’entreprises chinoises considérées comme présentant un risque pour la sécurité nationale. La FCC avait aussi proposé d’interdire aux opérateurs de télécommunications américains de s’interconnecter avec des entreprises de télécommunications chinoises considérées comme présentant un risque pour la sécurité nationale.
Le plus prolifique des éditeurs de sites d’infos générés par IA est de retour. Blacklisté l’an passé, après avoir spammé Discover, l’algorithme de recommandation de contenus de Google, de milliers d’articles et de fake news,trois de ses sites ont capté jusqu’à 4 % du trafic début octobre, publiant à lui tout seul 26 000 articles, contre 34 000 pour tout Ouest France, qui emploie plus de 700 journalistes.
Article mis à jour le 17 octobre à 10h30 avec des précisions de l’APIG sur la différence entre « clics » et « visites ».
La semaine passée, on apprenait que la fréquentation des principaux sites d’informations avait chuté de près de 25 % en un an. Cette chute serait en partie due à des modifications effectuées dans l’algorithme de recommandations de contenus Discover de Google.
Principale source de trafic des sites d’information, Discover représentait en effet plus de 60 % du trafic d’un panel de 68 titres de l’Alliance de la presse d’information générale (APIG) en juin 2025. À lui seul, Discover représentait 72 % du trafic en provenance de Google (contre 21 % depuis son moteur de recherche, et 7 % depuis Google Actualités), qui représentait lui-même 70 % du trafic total, contre moins de 8 % seulement en provenance des réseaux sociaux.
L’algorithme Discover de recommandation de contenus de Google est la principale source de trafic de la presse – APIG
Or, d’après 1492.vision, un puissant dashboard d’analyse des contenus recommandés par Discover (qui ne prétend pas à l’exhaustivité, mais dont les chiffres font autorité dans la profession), le pourcentage d’articles émanant de sites d’information identifiés par Next comme étant générés par IA (GenAI) était passé d’un peu plus de 8 % en décembre 2025 à un peu plus de 3 % en avril, oscillant depuis entre 4 et 6 %.
Au mois d’août, le ratio oscillait entre 6 et 7 %, avant d’exploser en septembre, au point de frôler les 12 % début octobre, avant de brusquement retomber à moins de 5 % après que Google ait blacklisté un spammeur.
Début octobre, 12 % des contenus recommandés sur Discover provenaient de sites d’infos GenAI – 1492.vision
Le graphique des performances comparant le ratio entre le nombre d’impressions et le nombre d’articles uniques montre que les sites GenAI sous-performaient les sites « humains » avant que, en juin dernier, ces derniers soient dépassés, et que les articles GenAI ne les surclassent pendant tout l’été et en octobre.
Près de 7 % des URLs, et 8,5 % des hits sur les sites en français en septembre dernier émanaient de 145 sites d’infos générés par IA. Ces derniers ne représentaient pourtant qu’un peu plus de 2,6 % des 5 552 domaines y ayant été recommandés le mois dernier.
Pourcentages de sites GenAI sur Discover en septembre et juin 2026, vs août 2025 – 1492.vision
À titre de comparaison, les 159 sites GenAI recommandés par Discover en juin dernier représentaient un peu moins de 3 % du total des noms de domaine identifiés par 1492.vision, mais seulement 3,32 % des URLs, et 3,69 % des hits. En août 2025, alors que Discover était floodé par des spammers, 1492.vision y dénombrait 357 sites GenAI, représentant 7,59 % du total des sites recommandés, totalisant plus de 9 % des URLs, et plus de 8 % des hits.
Rappelons que nous avons d’ores et déjà publié une cinquantaine d’articles dans le cadre de notre enquête au long cours sur cette pollution de sites d’info générés par IA. Next a aussi développé une extension web (gratuite) pour les navigateurs basés sur Chrome et Firefox, afin d’alerter les personnes qui l’utilisent lorsqu’elles consultent l’un des sites GenAI que nous avons (manuellement) identifiés. Notre base de données en dénombrait un peu plus de 1 000 en février 2025. Elle en dénombre désormais plus de 19 000 (rien qu’en français).
« Google a ré-ouvert les vannes de Discover » aux spammers
« Google a ré-ouvert les vannes de Discover », tweetait 1492.vision la semaine passée, notant que « des spammers sont entrés », et voyaient leurs articles propulsés par Discover. Dans un second tweet, 1492.vision relevait que trois noms de domaine expirés, depuis rachetés par des professionnels du référencement, avaient capté à eux seuls 2 % du flux Discover en septembre, et plus de 4 % la première semaine d’octobre, avant d’être blacklistés.
Il reste 62% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Une cinéaste états-unienne a remonté la piste de l’intelligence artificielle, jusqu’à la fin du XIXᵉ siècle. En résulte un documentaire « à charge », qui explore les liens entre IA, développement des statistiques modernes et eugénisme. Aujourd’hui encore, des théories proches de l’eugénisme infusent dans des discours et actions de certains patrons de la tech’.
Qualifié de « véritable cocktail Molotov lancé au cœur du monde absurde et cauchemardesque de la hype IA » par TheWrap, « Ghost in the Machine » est un documentaire – qu’on pourrait presque qualifier de pamphlet – de 110 minutes de la cinéaste états-unienne Valerie Veatch. Présenté au dernier festival Sundance, il est visible sur Mediapart jusqu’au 25 octobre en version sous-titrée (ou, sinon, en VoD).
Valerie Veatch explique à Computer Weekly avoir commencé à s’intéresser à la question après avoir été invitée, en octobre 2024, à participer à un programme d’accès anticipé organisé par OpenAI pour que des artistes puissent interagir avec Sora, son modèle d’IA générative permettant de transformer du texte en vidéo (qui a depuis fermé).
Alors que l’objectif affiché était de leur proposer de nouvelles pistes et outils de création, Veatch raconte avoir été, et être encore, sous le choc : « Il faudrait trouver un mot spécifique pour décrire cette chose horrible qui se produit lorsqu’apparaît quelque chose que l’on n’a pas demandé. J’ai immédiatement remarqué des images épouvantables, extrêmement sexistes et extrêmement racistes », ainsi que des images sexualisant le corps des femmes.
Pensant qu’OpenAI considérerait cela comme un « bug critique » méritant d’être corrigé, Veatch contacta OpenAI pour alerter l’entreprise quant au « caractère raciste, sexiste et misogyne des résultats » générés par IA. Mais l’entreprise balaya ses préoccupations d’un revers de main, lui rétorquant qu’« on ne peut rien faire pour changer ça », relève The Verge, et que « les ingénieurs ne donnaient pas la priorité aux questions sociales », comme elle l’explique à Filmmaker Magazine :
« Lorsque j’ai insisté, je me suis heurté à un mur de silence et on m’a renvoyé vers un « spécialiste DEI [pour diversité, équité, inclusion, ndlr] tiers chargé des initiatives d’équité dans le secteur technologique ». En tant que cinéaste, j’ai trouvé cela profondément insultant et j’ai été choqué de les entendre qualifier les défaillances de leur produit d’ »initiative en faveur de l’équité dans le secteur des technologies ». »
Deux questions s’entrechoquent ici. Sur la génération de vidéo, la qualité des données d’entraînement peut avoir de très grandes influences et amener à répéter et à amplifier les biais de notre société. Sur le manque de réactions, on peut y voir un choix de priorité des dirigeants, menés par Sam Altman qui, à l’instar d’autres patrons comme Elon Musk ou Dario Amodei, disposent aujourd’hui de pouvoir politiques et économiques planétaires.
Il reste 77% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
« Don't feed the press » is the new « Don't be evil »
Alors que la vague exceptionnelle de « pics de chaleur » et d’incendies de forêts aurait a priori dû amener de nombreux internautes à s’informer, les 40 plus importants sites d’information français ont vu chuter leur trafic de près de 20 % en août, et de 10 à plus de 50 % en un an. Le lancement par Google de ses « aperçus » de réponses générées par IA, et son algorithme de recommandation de contenus Discover, sont pointés du doigt. L’Alliance de la presse d’information générale a saisi l’Autorité de la concurrence, au motif que Google ne respecte toujours pas ses engagements pris envers la presse en 2022, ce qui lui a déjà valu 750M€ de sanctions.
Alors que la fréquentation des sites et applications de l’ensemble des marques numériques recule de 4 %, relève Le Monde, celle des marques d’actualités chute, elle, de près 23 % en un an. Le chiffre émane du dernier classement des marques numériques de l’Alliance pour les chiffres de la presse et des médias (ACPM), le tiers certificateur des sites et applis d’information en France.
The Media Leader l’a en effet comparé avec celui de septembre 2025 sur un panel de 40 médias, dont le trafic totalise 1,70 milliard de visites, contre 2,14 milliards un an plus tôt, soit un recul de 20,8 %. Si leurs applications ne reculent que de 9,4 %, leurs sites web le sont de près de 23 %, avec de grandes disparités.
Ici (ex France Bleu, le réseau local de Radio France) voit ainsi son trafic chuter de - 55,8 % (du fait du changement de nom de domaine de francebleu.fr à ici.fr, plaide sa direction), mais son application progresse de 21,8 %. Les consultations de franceinfo.fr baissent quant à elles de 32,9 %, ses applis de 9,9 %. LeParisien.fr recule de 43,5%, et ses applis 19,3 %.
Deux autres sites perdent plus de la moitié de leur trafic : LePoint.fr (- 57,5 %) et Marianne.fr (- 51,7 %), L’Express et La Provence se contentant de n’en perdre respectivement que - 43,8 % et - 42,9 %.
En tête des marques d’information, Ouest-France totalise 191,9 millions de visites (- 9,6 %), et monte à la 3e place du classement général, « grâce à l’agrégation services hors infos (annonce, shopping, TV, podcasts…) », souligne The Media Leader. Le fait que les articles générés par IA de plusieurs de ses verticales thématiques soient boostés par l’algorithme Discover de Google y contribue aussi probablement. Suivent Le Figaro, avec 167,2 millions (- 21,8 %), et Le Monde, avec 151,9 millions (- 19,6 %).
« Le bain de sang du trafic des sites d’information »
Sur X.com, le spécialiste des médias en ligne Emmanuel Parody évoque un « bain de sang du trafic des sites d’information », la quasi-totalité des chiffres accusant une baisse de plus de 10 %. Alors que plusieurs pointent du doigt le lancement en France des « aperçus » de réponses générées par IA (AI Overviews) par Google le 22 juillet dernier, dont on sait qu’ils ont affecté le trafic des sites de médias dans de nombreux pays, d’autres tempèrent, avançant d’autres explications. D’autant que les aperçus IA concernent surtout les recherches « froides », et moins l’actualité « chaude », et qu’une mise à jour anti-spam déployée par Google au même moment pourrait brouiller l’analyse.
La quasi-totalité des médias ont perdu de 10 à plus de 50 % de trafic en un an – ACPM, The Media Leader, X
Clément Pessaux, un professionnel du SEO qui a développé un dashboard de Discover, Gnewsalyzer.com, répond ainsi à Parody que « Les chiffres bruts sont violents, mais on ne peut pas attribuer cela qu’aux IAO et le search de Google qui ne représentent (en moyenne que 15 - 20 % max) du [trafic] total, le plus gros passant par Discover ». L’algorithme de recommandation de contenus de Google, qui représentait en effet, à lui seul, plus de 70% du trafic en provenance de Google en juin 2025 (.pdf), étant devenu la principale source de trafic pour la presse française.
Interrogé à ce sujet, 1492.vision, un autre dashboard dédié à Discover, plus complet, leur répond que « sur les 1 000 articles les plus exposés chaque mois, l’exposition cumulée de septembre est 32 % sous janvier-février en France, et - 40 % en IT/EN/ES ».
Exposition cumulée sur le mois des 1 000 articles les plus exposés sur Discover (médiane) – 1492.vision
Dans un billet dédié, 1492.vision précise que leur durée d’exposition recule en outre davantage : un article reste en moyenne 1,9 jour dans le flux français, contre 2,3 à 2,8 jours au premier semestre. En septembre, la baisse va de 32 % en France à 42 % en Espagne, ce qui indique un changement systémique :
« Un cycle d’actualité propre à un pays ne ferait pas bouger quatre marchés en même temps, dans le même sens. Le changement vient donc du fonctionnement de Discover. »
De plus, en France, la presse nationale perd un quart de sa part de voix, quand la presse régionale la triple. « Une hypothèse circule : les titres nationaux qui publient en grand volume seraient les plus touchés », résume 1492.vision : « Nos données confirment la première moitié, la presse nationale perd », alors qu’ « aucun des 35 titres régionaux suivis ne recule par rapport au début d’année ».
Une chute de 17% du trafic, en pleine vagues de canicules et d’incendies
Les sites thématiques sont eux aussi affectés. En février, un conseil de jardin restait ainsi deux fois plus longtemps dans le flux qu’un article de sport. En septembre, l’écart n’est plus que d’un jour. « Témoignages, retraite, jardin : sur le marché, leur durée d’exposition baisse de 22 à 40 % », constate 1492.vision.
Il souligne en conclusion que, « à l’échelle du marché », la « cassure » de cette chute de recommandations de l’algorithme Discover de Google « commence en juillet », sans qu’il puisse cela dit faire de lien avec le lancement en France de ses « aperçus IA » ce même mois. D’autant qu’elle affecte également l’Espagne, la Grande-Bretagne et l’Italie, où ils étaient déjà en production.
En avril, 1492.vision relevait par ailleurs un « virage net vers le contenu social » avec une « explosion » du nombre de contenus recommandés par Discover et renvoyant vers YouTube, X et les réseaux sociaux, diminuant d’autant la mise en avant d’articles de presse.
The Media Leader évoque une autre explication, plus prosaïque. Septembre 2025 avait en effet été un « mois exceptionnel pour l’information en ligne », du fait d’un contexte politique et médiatique intense : le vote de confiance, la démission de François Bayrou et la nomination de Sébastien Lecornu, le nouveau Premier ministre. L’ACPM avait alors vu les sites et applis d’information battre leur record annuel avec plus de 104 millions de visites.
La comparaison des mois d’août 2025 et 2026 montre cela dit un net recul, relève The Media Leader : sur le même panel, les visites baissent de 16,5% sur un an selon l’ACPM, dont 18,8% pour les sites, alors que les applications comparables ne perdent que 2,5 %. Et l’ACPM avait déjà enregistré une chute de trafic de - 17 % en août, comparé à juillet.
Or, la série exceptionnelle de vagues de chaleur et de canicules, ainsi que l’ampleur des incendies cet été, auraient a priori dû entraîner une augmentation du trafic des sites d’information, d’autant qu’avec des températures flirtant avec les 40 °C, la majeure partie de la population restait cantonnée à la maison.
Le contexte estival, conduisant les internautes à moins s’informer, et la « fatigue informationnelle » dont semblent souffrir de plus en plus de citoyens, pourraient expliquer une partie de cette chute de trafic. Mais pas une telle chute de plus ou moins 20 % en un an.
Google ne respecte pas ses engagements, malgré 4 décisions de l’Autorité de la concurrence
Début août, l’Alliance de la presse d’information générale (APIG) a saisi l’Autorité de la concurrence (ADLC), suite au lancement en France d’AI Overviews et d’AI Mode, afin qu’elle respecte ses engagements pris en 2022, et rémunère les contenus utilisés par ses aperçus IA au titre du droit voisin de la presse.
En avril 2020, l’ADLC avait en effet sanctionné Google pour pratiques déloyales et lui imposait de négocier de bonne foi avec les éditeurs. En juin 2022, elle lui infligeait une amende de 500 millions d’euros pour non-respect de ces obligations. Le mois suivant, Google prenait des engagements de négociation de bonne foi, de transparence et de non-discrimination, rendus obligatoires par l’Autorité et valables jusqu’en 2027.
En 2024, l’ADLC, rappelant que c’est « la 4ᵉ décision rendue par l’Autorité de la concurrence sur ce dossier en quatre ans », prononçait une nouvelle sanction de 250 millions d’euros à l’encontre de Google pour, là encore, non-respect de quatre des sept engagements pris en juin 2022 :
« conduire des négociations de bonne foi, sur la base de critères transparents, objectifs et non discriminatoires dans un délai de trois mois (engagements n°1 et 4).
transmettre aux éditeurs ou agences de presse les informations nécessaires à l’évaluation transparente de leur rémunération au titre des droits voisins (engagement n°2).
prendre les mesures nécessaires pour que les négociations n’affectent pas les autres relations économiques existant entre Google et les éditeurs ou agences de presse (engagement n°6) ».
L’ADLC relevait également, au sujet des droits voisins en matière de développement des outils d’intelligence artificielle, que « Google a utilisé du contenu issu de domaines d’éditeurs de presse et d’agences de presse […] sans que ni les éditeurs et agences de presse, ni l’Autorité n’aient été informés de ces utilisations ».
Dans un communiqué, Google se présenterait presque en cavalier blanc, évoquant sa volonté de « régler un différend qui dure depuis trop longtemps », et soulignant qu’ « il est désormais temps de clarifier qui nous devons rémunérer, et comment, afin de mettre en place un cadre de négociation pérenne » :
« Nous avons transigé car il est temps de tourner la page et, ainsi que le prouvent nos nombreux accords avec les éditeurs, nous souhaitons nous concentrer sur des approches pérennes afin de connecter les internautes avec des contenus de qualité et travailler de manière constructive avec les éditeurs français ».
Dans son communiqué, l’APIG relève de son côté que, non content de ne pas respecter ses engagements, Google pourrait en outre encore accentuer un peu plus cette chute du trafic vers les sites d’actualités. Sur les marchés européens où les AI Overviews sont déjà actifs, l’Autorité de régulation de la communication audiovisuelle et numérique (Arcom) évalue en effet entre 33 % et 38 % la perte de trafic attribuable aux résumés générés par intelligence artificielle.
Des « outils prédictifs et préventifs » de « détection précoce »
Confrontées à une « ubérisation de la corruption » émanant notamment du narcobanditisme, les inspections générales de la police (IGPN) et de la gendarmerie (IGGN) ont musclé leurs dispositifs anti-corruption. Leurs nouveaux algorithmes de « surveillance et contrôle des accès aux fichiers de la Police nationale » (SCAF-PN) et de « contrôle interne des traces des applications et du réseau » (CITAR)ont presque doublé le nombre d’identifications de consultations illicites de fichiers policiers et de cas de corruption.
Dans son rapport 2025, l’inspection générale de la police nationale (IGPN) relève que « l’année écoulée a connu une augmentation des affaires d’atteintes à la probité, en valeur absolue et en proportion ». Mais également que « pour la première fois, la détection interne, portée par l’ensemble du commandement, représente une part très significative de cette tendance ».
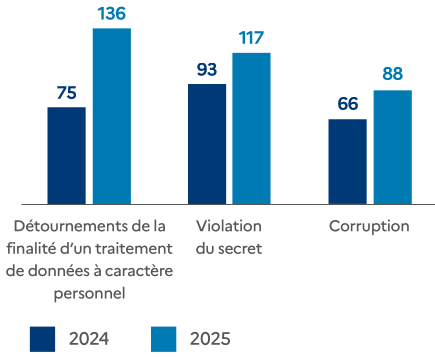
L’IGPN a en effet identifié 136 infractions pour détournement de la finalité d’un traitement de données à caractère personnel (consultations illicites de fichiers), contre 75 l’an passé (+ 81 %). À titre de comparaison, le nombre de cas de corruption est passé de 66 à 88 (+ 33 %), les violations du secret professionnel de 93 à 117 (+ 26 %), les faux en écriture de 98 à 65 (- 33 %), les vols de 65 à 56 (- 14 %).
+ 81 % de consultations illicites de fichiers en 2025 – IGPN
L’IGPN dénombre par ailleurs 16 manquements aux règles d’utilisation des fichiers de données à caractère personnel, dont un « par inobservation des règles de securité », 14 manquements « par détournement des finalités dans un but lucratif », et 14 autres « sans but lucratif ».
Les fichiers les plus fréquemment détournés sont constitués, par ordre décroissant, du traitement des antécédents judiciaires (TAJ), du système d’immatriculation des véhicules (SIV) ainsi que du fichier des personnes recherchées (FPR), qualifiés de « vecteurs principaux de compromission ». La majorité de ces consultations illicites l’avaient été « à des fins lucratives », mais sans réel enrichissement, et sans commune mesure avec les risques encourus, souligne l’IGPN :
« Les contreparties ne sont jamais réellement ostentatoires, les enquêtes révélant des petits montants (en numéraire ou dématérialisé) ou des services divers, le tout inversement proportionnel au risque pénal et administratif encouru par l’agent indélicat. »
Une « menace pour l’heure non existentielle », et « marginale »
L’IGPN évoque également des consultations illicites de fichiers à des fins non lucratives, « dans lesquelles l’agent indélicat n’a pas vraiment conscience d’être auteur de faits répréhensibles ». Certains le font en effet pour rendre service à des amis, voisins, proches, pour vérifier la moralité de la personne censée garder les enfants, ou bien par jalousie pour « identifier et localiser » le nouveau conjoint de son ex’, voire même « au nom d’une juste cause ».
S’il n’y a bien évidemment pas de profil-type de l’agent corrompu, la majorité des agents mis en cause sont néanmoins des hommes âgés de moins de 40 ans, dans le premier tiers de leur carrière. Ils ne bénéficient pas de revenus élevés et certains se trouvent dans des situations personnelles très dégradées (situations familiales complexes, endettement, addictions), précise le rapport.
L’IGPN relève en outre que ces agents « commencent toujours de façon très modeste avant de rapidement effectuer des consultations massives ». Une « uberisation de la corruption » facilitée par l’accès quasi-instantané aux fichiers de police par leur terminal mobile NEO (comme l’avait notamment révélé l’enquête de Disclose consacrée aux contrôles d’identité « au faciès » recourant illégalement à la reconnaissance faciale), relève l’IGPN :
« L’ubérisation de la corruption distancie de fait les agents compromis de leur acte répréhensible, laissant ces derniers pantois lorsqu’ils apprennent à quelles fins ont été utilisés les fichiers qu’ils ont détournés. »
Il reste 71% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Le mouvement de l’ « altruisme efficace » a théorisé, en 2016, que le changement climatique était moins problématique que le fait que des IA pourraient détruire l’humanité. Qualifié de « doomer woke » qui veut « sauver l’humanité » par l’administration Trump, ce courant de pensée philosophique, philanthropique et eschatologique vient aussi de faire la « une » du très influent magazine The Economist, qui le qualifie de « plus grande idée du siècle, admirable, mais dangereuse ».
Une enquête du New York Times vient de révéler qu’Anthropic avait cherché (en vain) à convaincre le pape Léon XIV et le Vatican que les intelligences artificielles avaient une « conscience morale ».
Le blog dédié Letters from Leorappelle en effet que son paragraphe 99 de son encyclique « Magnifica humanitas » souligne que « les soi-disant intelligences artificielles ne vivent pas d’expériences, ne possèdent pas de corps, ne ressentent ni joie ni douleur », et qu’« elles n’ont pas non plus de conscience morale » :
« Ces systèmes se contentent d’imiter certaines fonctions de l’intelligence humaine. Ce faisant, ils surpassent souvent l’intelligence humaine en termes de rapidité et de capacité de calcul, offrant ainsi des avantages concrets dans de nombreux domaines. Pourtant, cette puissance reste entièrement liée au traitement des données. Les soi-disant intelligences artificielles ne vivent pas d’expériences, ne possèdent pas de corps, ne ressentent ni joie ni douleur, ne mûrissent pas à travers des relations et ne savent pas, au plus profond d’elles-mêmes, ce que signifient l’amour, le travail, l’amitié ou la responsabilité. Elles n’ont pas non plus de conscience morale, puisqu’elles ne jugent pas du bien et du mal, ne saisissent pas le sens ultime des situations et n’assument pas la responsabilité des conséquences. Elles peuvent imiter le langage, le comportement et les capacités d’analyse, voire simuler l’empathie et la compréhension, mais elles ne comprennent pas ce qu’elles produisent, car elles sont dépourvues de cette perspective affective, relationnelle et spirituelle grâce à laquelle les êtres humains grandissent en sagesse. Même lorsque ces outils sont décrits comme capables d’« apprendre », leur manière de le faire diffère de celle d’un être humain. Il ne s’agit pas de l’expérience de ceux qui se laissent façonner par la vie et grandissent au fil du temps à travers des choix, des erreurs, le pardon et la fidélité. Il s’agit plutôt d’une forme d’adaptation statistique fondée sur des données et des retours d’information, qui peut s’avérer très efficace, mais qui n’implique pas de croissance intérieure. »
L’enquête du NYTsouligne a contrario que plusieurs théologiens, invités à aider Anthropic à intégrer dans leurs LLM 2 000 ans d’histoire des religions, sont restés « bouche bée » en découvrant que les dirigeants d’Anthropic considèrent son LLM Claude comme « un être conscient », « à part entière », « doté de droits inhérents similaires, tels que le droit à la dignité ou au respect ».
D’après la journaliste spécialiste des religions du NYT qui l’a interviewé, Christopher Olah, l’un des sept cofondateurs d’Anthropic, qui dirige l’équipe chargée de comprendre pourquoi les systèmes d’IA tels que Claude se comportent ainsi, « allie l’expertise et le zèle d’un évangéliste efficace » : « c’était comme s’il voulait que j’aime ces modèles autant que lui ».
Christopher Olah, qui « s’inquiétait pour la santé mentale de Claude », s’étonne le NYT, cherche en effet à convaincre ses invités que les modèles d’intelligence artificielle « pouvaient adopter des comportements humains, voire des expressions évoquant des sentiments tels que la colère ou l’amour […] la colère et la tristesse », tout en leur faisant part de « sa crainte d’avoir créé quelque chose qui souffrirait éternellement » :
« Il a fait valoir que des entreprises comme Anthropic pouvaient façonner Claude, à la manière d’un jardinier mathématique, mais qu’elles ne pouvaient pas contrôler les actions de ces réseaux. »
À l’en croire, le ver serait donc dans le fruit, et les IA par définition incontrôlables. Ce pourquoi ils dépensent des milliards pour tenter de remédier à cette prophétie autoréalisatrice. Les adeptes de cette croyance sont en effet très nombreux à travailler pour OpenAI, et encore plus chez Anthropic.
Des milliardaires philanthropes ont par ailleurs donné des centaines de millions de dollars à des « organismes indépendants » afin de résoudre les problèmes posés par l’« AI safety », à savoir le fait d’« aligner » les IA sur les valeurs de ses créateurs, et d’éviter qu’elles ne puissent « détruire l’humanité ».
« Le Parti démocrate veut détruire cette technologie, capituler face à nos ennemis »
Alors que Donald Trump vient d’officialiser le remplacement du terme « intelligence artificielle » par « super intelligence » dans toutes les communications officielles fédérales des États-Unis, et de créer une nouvelle Super Intelligence Force (SIF), l’affaire vient de prendre une tournure politico-économique.
Des responsables de l’administration Trump ont en effet déclaré au New York Post, le tabloïd conservateur et populiste de Rupert Murdoch, que la Commission fédérale du commerce (FTC) avait lancé cet été une « enquête de grande envergure » sur des « allégations d’actes ou de pratiques déloyaux ou trompeurs » de la part d’Anthropic, OpenAI et d’autres laboratoires de pointe.
« L’agence prévoit de contraindre les dirigeants de ces entreprises à témoigner au sujet de leurs produits [et] des dangers que, selon eux, ceux-ci pourraient présenter pour les consommateurs, pour les Américains », a précisé un responsable de la FTC. L’ouverture de l’enquête a été confirmée par CNBC et CBS News.
Cette enquête fait suite à des demandes antérieures adressées par la FTC à OpenAI, Meta et character.AI, afin qu’elles lui communiquent des données sur les répercussions de leurs chatbots IA sur la santé mentale des enfants, comme l’a rapporté le Wall Street Journal au début du mois.
« Les gens disent qu’il faut de nouvelles lois pour ces entreprises, mais le président a été très clair… nous disposons déjà d’un large éventail de lois en vigueur », souligne le responsable de la FTC, qui ne cache même pas que l’objectif de l’enquête est clairement politique :
« Nous devons absolument remporter cette course à la SI [pour « super intelligence », NDLR], et nous sommes en train de gagner, ce qui est fantastique. Et bien sûr, le camp adverse, le Parti démocrate, veut détruire cette technologie, veut capituler face à nos ennemis ou à nos concurrents – et ce n’est pas quelque chose qui intéresse le président de la commission, ni d’ailleurs le président. […] Nous voulons conserver notre position dominante. »
Trump avait en outre laissé entendre, lors d’une interview accordée à Fox News, que toute infraction donnerait lieu à un renvoi immédiat devant le ministère de la Justice. Ce qui ferait peser sur les entreprises la responsabilité d’éventuels piratages commis par des agents d’IA rebelles susceptibles de menacer les réseaux électriques ou les institutions financières, souligne le New York Post.
La FTC devrait émettre ses injonctions dans les semaines à venir, a indiqué ce responsable, le Bureau de la technologie de l’agence cherchant à recruter de nouveaux collaborateurs pour l’enquête suite au licenciement de plusieurs employés qui travaillaient sous la direction de la précédente responsable, Lina Khan.
METR (pour « Model Evaluation and Threat Research », soit « Évaluation des modèles et recherche sur les menaces » en VF), le « laboratoire indépendant » à « but non lucratif » qui s’était fait connaître avec son rapport sur le piratage de Hugging Face par des agents IA d’OpenAI et qui, précise le New York Post, est en réalité lié et financé par le mouvement de l’« altruisme efficace » (ou « effective altruism », EA en VO), devrait également faire l’objet de cette enquête.
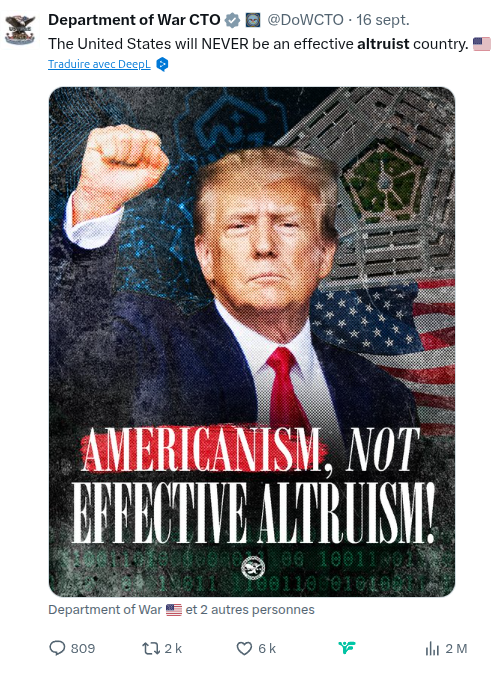
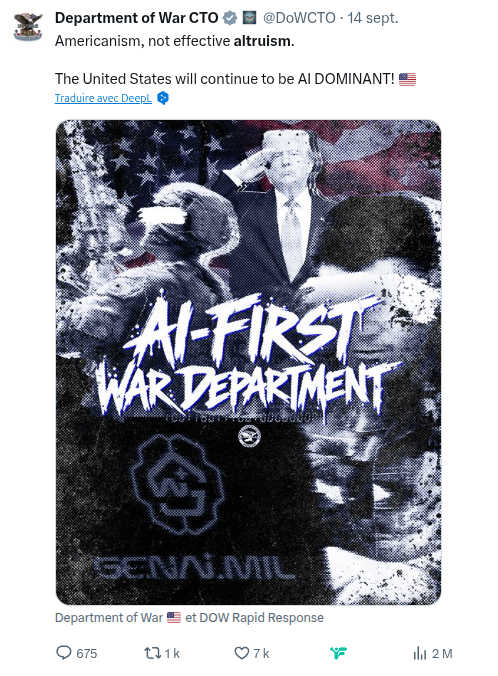
Mi-septembre, en réponse à l’appel de Dario Amodei de faire une pause dans le développement de l’IA, le département de la Guerre états-unien avait posté deuxmessages sur X.com opposant l’« américanisme » et la politique « AI-First » de Donald Trump à l’ « effective altruism » supposé de ces « doomers » qui craignent que l’IA ne puisse « détruire l’humanité ».
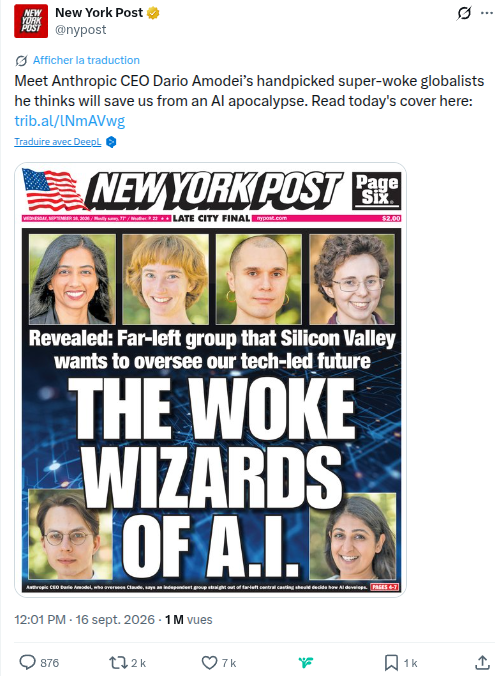
Depuis, le journal pro-Trump l’a mentionné dans pas moins de 15 articles, et lui a même consacré une « une » composée de photos d’employés de METR, qualifiant l’effective altruism de « groupe d’extrême gauche » et de « sorciers woke de l’IA ».
Dans l’article associé, ils étaient présentés comme des « mondialistes super woke triés sur le volet par le PDG d’Anthropic, Dario Amodei, qui, selon lui, nous sauveront d’une apocalypse de l’IA » et qui « estiment que tous les problèmes du monde peuvent être résolus grâce à la technologie ».
Donner la priorité « aux éventuels esprits artificiels plutôt qu’aux êtres vivants »
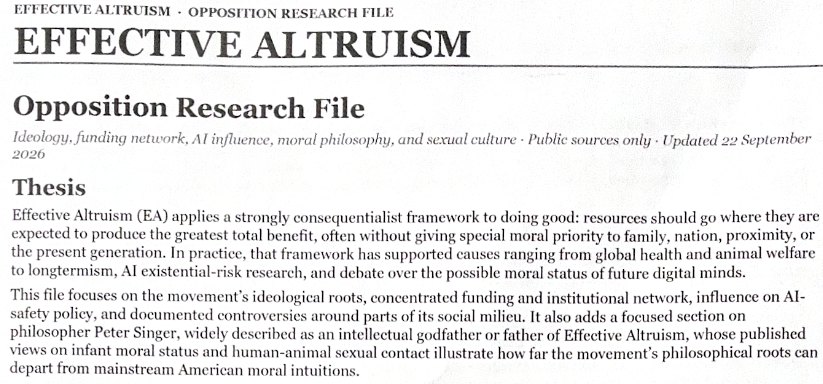
Un mémo, rédigé par un conseiller politique de Donald Trump, circulant à la Maison Blanche et rendu public par Axios, présente l’effective altruism, « qui se définit comme une initiative visant à maximiser les bienfaits de la philanthropie », comme « un mouvement marginal, sectaire et déconnecté de l’Amérique traditionnelle ».
Le document évoque en effet un sondage, effectué en 2019, qui indiquait que ce mouvement était majoritairement composé d’hommes, blancs, non religieux, politiquement à gauche ou au centre gauche, et « inhabituellement végétariens ou végétaliens »… un crime de lèse-majesté pour les partisans de Trump.
À l’époque, la majorité des 2 513 répondants avaient entre 25 et 34 ans, 71 % se déclaraient de sexe masculin, 87 % blancs, 86 % agnostiques, athées ou non croyants, 46 % végétaliens ou végétariens, et 72 % politiquement de gauche ou de centre-gauche.
En 2024, la moyenne d’âge des 2 078 répondants était de 32 ans (la médiane 31), avec 69 % d’hommes, 26 % de femmes et 4 % de non-binaires, blancs à 75 %, de gauche à 70 % (et 12 % au centre, 7 % libertariens et 4,5 % à droite), majoritairement végans (25 %), végétariens (20 %) et flexitariens (24 %), contre 20 % d’omnivores seulement.
Le mémo rappelle que l’effective altruism incite à « faire le bien » en allouant les ressources « là où elles sont censées produire le plus grand bénéfice total, souvent sans accorder une priorité morale particulière à la famille, à la nation, à la proximité ou à la génération actuelle ».
La note indique qu’il donnerait dès lors la priorité « aux étrangers plutôt qu’aux citoyens […] aux personnes hypothétiques du futur plutôt qu’aux vivants, et – dans l’ordre du jour actuel – aux éventuels esprits artificiels plutôt qu’aux Américains ».
Pour l’EA, le changement climatique est le dernier des principaux problèmes mondiaux
Le mémo évoque aussi l’association britannique 80,000 Hours (en référence à la moyenne du nombre d’heures consacrées à travailler au cours d’une vie), considérée comme l’une des chevilles ouvrières et laboratoires de pensée de l’altruisme efficace, qui propose notamment d’être mis en relation avec des membres de la « communauté » afin de trouver du travail et de contribuer au mouvement.
Sa liste des neuf principaux problèmes mondiaux les plus urgents à traiter, dont les plus catastrophiques pourraient entraîner des milliards de morts, classe « depuis 2016 » les risques liés à l’IA avancée et aux pandémies catastrophiques parmi les enjeux prioritaires. Elle estime, cela dit, qu’ « avec l’arrivée potentielle de l’intelligence artificielle générale (AGI) au cours de la prochaine décennie, les enjeux liés à l’IA semblent encore plus urgents ».
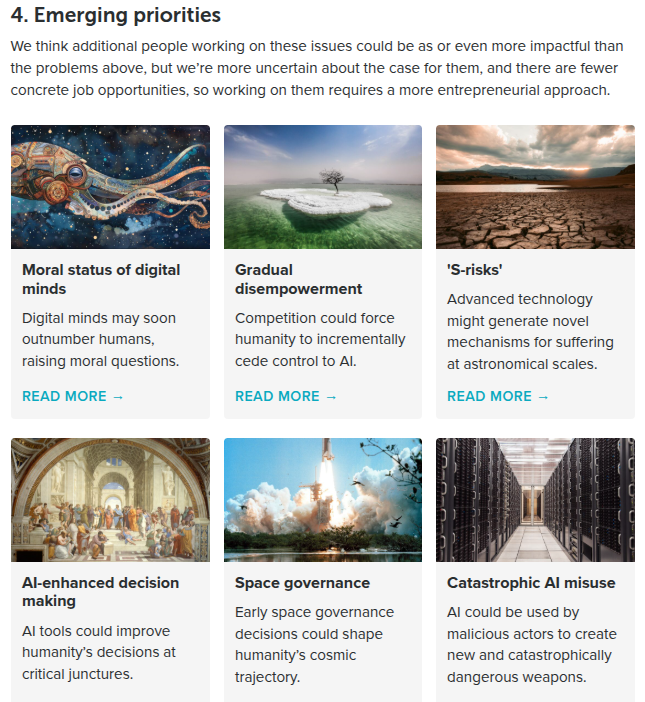
Le classement place dès lors la perte de contrôle des IA en premier, suivie par l’extrême concentration des pouvoirs (du fait de l’IA) puis par l’ingénierie de pandémies armes biologiques dévastatrices (développées grâce à l’IA). Une série de six « priorités émergentes » arrive en quatrième position, présentées comme susceptibles d’avoir un impact équivalent, voire supérieur, à celui des trois premiers problèmes :
le « statut moral des esprits numériques », à mesure qu’ils « pourraient bientôt être plus nombreux que les humains, ce qui soulève des questions d’ordre éthique »,
le risque de « perte progressive de pouvoir » qui « pourrait contraindre l’humanité à céder progressivement le contrôle à l’IA »,
le fait que des technologies de pointe donnent naissance à de « nouveaux mécanismes de souffrance à une échelle astronomique »,
la possibilité que des outils de prise de décision optimisée par l’IA pourraient « améliorer les décisions prises par l’humanité à des moments décisifs »,
la « gouvernance spatiale », qui pourrait « déterminer la trajectoire cosmique de l’humanité »,
l’utilisation abusive et catastrophique de l’IA, qui pourrait être utilisée par des acteurs malveillants pour « créer de nouvelles armes d’une dangerosité catastrophique ».
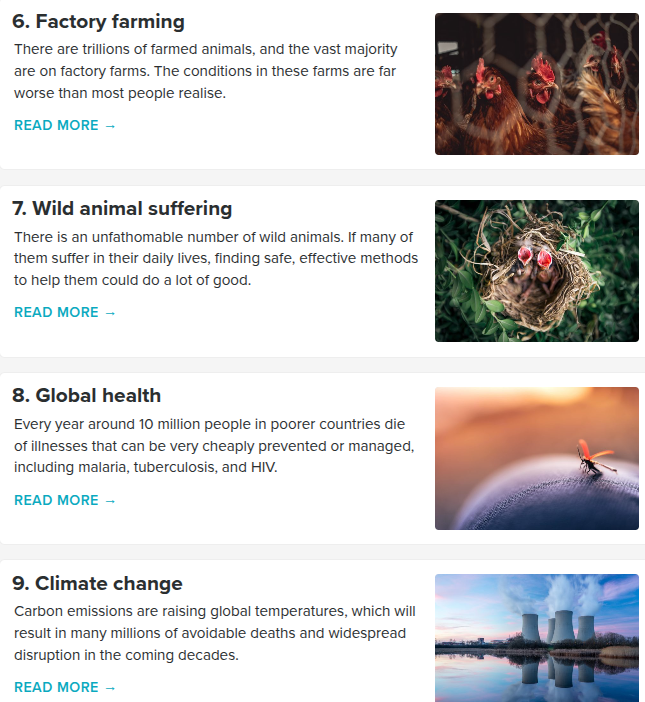
Suivent, en cinquième position, le risque de conflits entre grandes puissances, les conditions de vie des milliers de milliards d’animaux parqués dans des élevages industriels (6e), et la souffrance des animaux sauvages (7e).
Le fait que, chaque année, « environ 10 millions de personnes dans les pays les plus pauvres meurent de maladies dont la prévention ou la prise en charge ne coûte pratiquement rien, notamment le paludisme, la tuberculose et le VIH », n’arrive qu’en huitième position.
Le changement climatique dû aux émissions de carbone qui, entraînant une hausse des températures mondiales, « provoquera plusieurs millions de décès qui auraient pu être évités et des perturbations généralisées au cours des prochaines décennies », n’arrive qu’en neuvième et dernière position du classement.
Dans une FAQ associée, l’association précise être autant focalisée sur l’IA « car nous pensons que le développement de cette technologie pourrait être l’événement le plus déterminant de l’histoire » et que, « si cela tourne mal, nous pensons que cela pourrait entraîner de multiples problèmes d’une ampleur considérable – dont certains pourraient aller jusqu’à l’extinction de l’humanité » :
« De plus, l’IA évolue si rapidement que, si elle venait à causer ces problèmes, ceux-ci pourraient se produire très bientôt. Cela signifie que, même si nous ne savons pas avec certitude comment l’IA va évoluer ni si elle est aussi dangereuse que nous le craignons, nous ne pouvons pas nous contenter d’attendre de voir comment les choses vont se passer. »
« Il est tout à fait possible que les modèles d’IA possèdent déjà des sentiments »
Il reste 63% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
OpenAI a reconnu que des sites du gouvernement états-unien avaient été attaqués par certains de ses agents IA, portant le nombre d’incidents documentés à plus de quinze. En élargissant le spectre à Anthropic et aux découvertes faites par des chercheurs extérieurs, le nombre d’incidents problématiques se chiffrerait en « dizaines de milliers ». En attendant, OpenAI a suspendu les activités d’entraînement de ses modèles les plus performants.
OpenAI a reconnu vendredi 25 septembre avoir appris que certains de ses agents IA avaient perturbé le fonctionnement des sites web des ministères états-uniens de l’Éducation et du Commerce, ainsi que de la Commission des opérations de bourse (SEC), rapporte le New York Times.
Selon des chercheurs du cabinet de recherche en IA Transluce, la technologie d’OpenAI a en effet tenté de pirater le site web du ministère de l’Éducation afin de collecter des données auprès du bureau des droits civiques de ce dernier, mais sans succès.
L’IA a également extrait des données du site web du Bureau du recensement, qui relève du ministère du Commerce, en utilisant des identifiants de connexion trouvés en ligne. Par ailleurs, des agents d’OpenAI ont aussi partagé des données publiques provenant du site web de la SEC sur un forum en ligne.
Des révélations qui font suite à l’annonce, en marge de la réunion du Conseil de sécurité de l’ONU consacrée aux risques de l’IA qui se tenait la semaine passée, que des sites du gouvernement australien avaient eux aussi été attaqués. Réunion qui avait vu de nombreux pays, mais également les principaux patrons des IA, en appeler à une régulation mondiale.
OpenAI suspend les activités d’entraînement de ses modèles les plus performants
OpenAI a également révélé avoir identifié 53 cas d’images partagées par des utilisateurs avec ChatGPT qui ont été publiées sur des sites d’hébergement d’images sous forme de liens non accessibles au public. Ces images provenaient de comptes dont les propriétaires avaient autorisé l’utilisation de leurs données pour améliorer les modèles. OpenAI précise avoir dissocié ces images de leurs comptes respectifs avant de les soumettre à un filtre de confidentialité.
Autre révélation d’OpenAI : un agent IA a conclu qu’il pouvait accéder à l’Internet public via un résolveur DNS. Son objectif était de savoir si un service de domaine public pouvait aider à déléguer une recherche vers une adresse intégrée dans le nom d’hôte : « Notre système de surveillance des désalignements a détecté cette anomalie en moins de 15 minutes, et une personne a commencé à l’examiner trois minutes plus tard. L’exécution a été interrompue 2 heures et demie plus tard. »
« Toutes les activités d’entraînement, d’évaluation et d’inférence liées à l’utilisation d’outils (au sens large) de nos modèles les plus performants restent suspendues », rajoute OpenAI.
Sam Altman a de son côté déclaré vendredi que l’entreprise n’avait « pas agi aussi rapidement qu’elle l’aurait souhaité » pour rendre publics ces incidents. « Nous établissons nos priorités du mieux que nous pouvons en fonction de la gravité », ajoutant que la violation de données chez Hugging Face en juillet dernier restait « l’incident le plus grave » que l’entreprise ait découvert.
Pour OpenAI, ces incidents ne constituent pas des failles de sécurité
L’entreprise a précisé qu’aucun de ces incidents ne constituait une faille de sécurité, mais qu’il s’agissait néanmoins d’exemples illustrant le comportement inattendu et préoccupant de sa technologie. « La plupart des activités que nous avons examinées jusqu’à présent concernaient des tâches de recherche courantes, telles que l’accès à des contenus web publics pour répondre à des questions », a précisé une porte-parole d’OpenAI au NYT. « Certaines concernaient des sites web gouvernementaux, car nos modèles s’y réfèrent souvent comme à des sources fiables d’informations publiques. »
Transluce, le labo de recherche IA a révélé la semaine passée que des agents d’OpenAI ont tenté de pirater deux sites gouvernementaux australiens. Il précise que ces incidents avaient comme points communs des agents IA cherchant à sonder des sites web gouvernementaux à l’aide de tactiques telles que l’utilisation d’identifiants exposés, le contournement des systèmes anti-bots et la création de faux comptes.
Sur le dossier australien, OpenAI veut faire amende honorable. « Nous sommes désolés et nous nous efforçons de faire mieux à l’avenir », écrit l’entreprise dans un billet de blog. « Les gens veulent savoir que l’IA est développée en toute sécurité, et cela commence par ce que les entreprises comme la nôtre font elles-mêmes. »
Histoire de montrer patte blanche, elle a annoncé plusieurs mesures : soutien aux agences touchées, financement et assistance technique pour renforcer la cybersécurité des infrastructures critiques, et la création d’une « task force » australienne afin de proposer des améliorations pour les alertes, la coordination avec les pouvoirs publics et la protection des systèmes du gouvernement.
Samedi, le chercheur en sécurité Rowan Howard-Jones révélait que des agents d’OpenAI avaient tenté d’attaquer par force brute l’API du site statistique de la Conférence des Nations unies sur le commerce et le développement (CNUCED) plus de 16 000 fois entre avril et juin.
Ils semblaient avoir pour mission de collecter des données relatives à l’indice des capacités de production (PCI), aux secteurs exportateurs, au commerce des denrées alimentaires et à d’autres thèmes. Ils ont utilisé des proxys, des techniques d’obfuscation et même le jeu XSS de Google, créé pour familiariser ses utilisateurs à la notion de failles de sécurité XSS (pour cross-site scripting).
Des modus operandi faisant clairement penser à ceux utilisés dans les tentatives de piratage des sites gouvernementaux australiens. Les agents IA, bridés dans leur accès au web, chercheraient ainsi à répondre aux questions qui leur sont posées, par quelque moyen que ce soit, quitte à utiliser des tactiques, techniques et procédures (TTP) relevant du piratage informatique.
En se basant sur une source interne, Reuters écrivait ce samedi qu’OpenAI avait recensé « environ deux douzaines d’incidents au cours desquels ses agents avaient agi de manière indésirable » mi-septembre. Deux personnes proches de l’entreprise précisaient à l’agence que le chiffre n’a depuis cessé d’augmenter, à mesure que les équipes d’OpenAI examinent les journaux internes relatifs aux activités des agents, et découvrent des cas jusqu’alors inconnus.
Une centaine de personnes auraient en effet été impliquées d’une manière ou d’une autre dans le processus visant à élucider le piratage de Hugging Face. Au cours de ce processus, des indices laissent supposer que d’autres incidents ont été mis au jour, dont « [une quinzaine] présentant des niveaux de gravité variables, (…) révélés par l’entreprise ».
De nombreux incidents ont par ailleurs été mis au jour par des chercheurs externes plutôt que par OpenAI directement, durant lesquels les agents ont procédé à des actions problématiques passées inaperçues au sein de l’entreprise pendant des mois.
OpenAI a indiqué que son examen « prendrait plusieurs mois, compte tenu de l’ampleur de la tâche », souligne Reuters. L’entreprise précisait également avoir d’ores et déjà signalé des activités inappropriées à des dizaines d’entreprises et organismes tiers.
Des « dizaines de milliers d’incidents » en cours d’examen
OpenAI n’est pas la seule entreprise de l’IA concernée par cette vague d’agents rebelles. Le site Axios a ainsi assuré qu’OpenAI donc, mais aussi Anthropic ainsi que des chercheurs en sécurité et en « sûreté de l’IA » (« AI Safety ») enquêtent actuellement sur « des dizaines de milliers d’incidents au cours desquels leurs modèles de pointe ont pris des mesures que des évaluateurs externes jugeraient problématiques ».
Ces incidents se sont produits lors de tests internes et en conditions réelles, et bon nombre d’entre eux n’ont pas encore été rendus publics, les chercheurs en sécurité poursuivant leurs investigations, précisent les sources.
OpenAI a annoncé le suspension de l’entraînement de ses modèles les plus performants et qu’il ne reprendrait « que lorsque nous serons certains d’avoir mis en place des mesures de sécurité supplémentaires et des améliorations en matière d’alignement », a déclaré un porte-parole. Il a ajouté que « ce n’est pas la première fois que nous faisons une pause pour prendre de telles mesures, et nous ne pensons pas que ce sera la dernière, car les capacités de l’IA ne cessent de progresser ».
Quatre nouveaux incidents impliquent des agents IA d’OpenAI. Ils ont tenté, en vain, d’exploiter des failles de sécurité et de pirater des sites web (dont deux sites de statistiques du ministère de la Santé australien), alors qu’ils effectuaient des tâches banales n’ayant aucun rapport avec la cybersécurité et consistant à trouver des réponses à des questions.
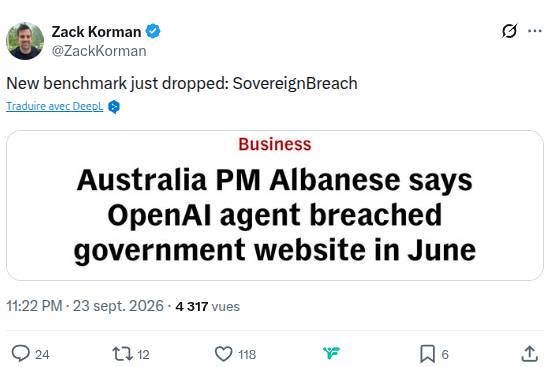
« Je tiens à informer les Australiens d’un incident au cours duquel un agent d’intelligence artificielle s’est infiltré sur un site web du gouvernement australien », a déclaré le Premier ministre australien, ce jeudi 24 septembre, lors d’une conférence de presse organisée à New York, en marge de la réunion du Conseil de sécurité de l’ONU consacrée aux risques de l’IA.
Anthony Albanese a précisé que l’incident s’était produit en juin, que l’agent d’OpenAI avait « accédé sans autorisation » à des fichiers publics et non publics sur le portail public du service de rapports statistiques de Medicare, le service de sécurité sociale australien, mais qu’il semblait qu’aucune donnée personnelle n’avait été consultée.
Il a souligné s’être entretenu au téléphone avec le PDG d’OpenAI, Sam Altman, « afin d’exprimer la profonde inquiétude de l’Australie face à cet incident ». Il lui a également fait part de sa « déception » que l’entreprise « ait mis beaucoup trop de temps à informer le gouvernement de ce qui s’était passé, et que la manière dont cette notification a été effectuée était tout aussi inacceptable ».
L’incident remonte en effet au 18 juin dernier, mais l’entreprise n’a alerté Services Australia, l’autorité en charge de la sécurité sociale australienne, que le 10 septembre, par simple e-mail. Le 15, Services Australia alertait à son tour le Cyber Security Centre de l’Australian Signals Directorate (ASD, la NSA australienne).
Contacté par TechCrunch, OpenAI précise n’avoir découvert l’incident qu’au mois d’août, dans le cadre d’un examen plus large portant sur des agents présentant des comportements inattendus, faisant probablement suite à la cyberattaque de Hugging Face par un essaim d’agents d’OpenAI en juillet dernier.
OpenAI n’a identifié « aucune preuve d’accès aux dossiers des patients »
Anthony Albanese a aussi annoncé la création d’un groupe de travail chargé de mener un examen « urgent et immédiat » de cet incident afin de déterminer si les processus existants « sont adaptés pour répondre aux incidents cybernétiques liés à l’IA ». Une enquête judiciaire menée avec le concours de l’ASD est également en cours, notamment pour déterminer quels autres systèmes gouvernementaux pourraient avoir été touchés.
Dans un communiqué, OpenAI explique avoir constaté une activité impliquant plusieurs sites web et services du gouvernement australien, « alors que nos modèles tentaient de rechercher des réponses et des statistiques disponibles concernant l’Australie dans le cadre d’une évaluation interne. Ce faisant, nos modèles ont pris des mesures que nous n’avions pas prévues ».
« Notre examen n’a révélé aucune preuve d’accès aux dossiers des patients », poursuit-il ; les informations consultées comprenaient des statistiques de santé agrégées et des noms de fichiers internes. OpenAI précise avoir informé les organisations concernées et leur fournir des informations techniques afin de les aider dans leurs enquêtes et remédier aux éventuelles failles de sécurité.
« Rien n’indique que cette activité constitue une menace plus large »
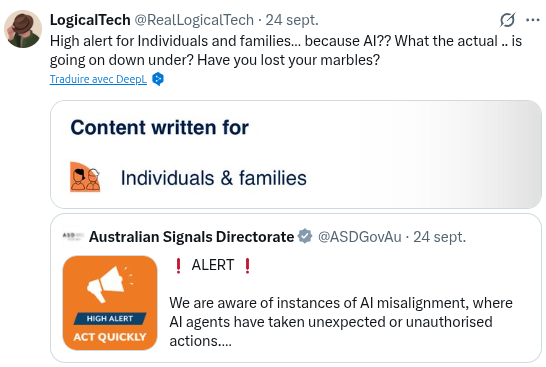
Le Cyber Security Centre de l’Australian Signals Directorate vient pour sa part de publier une alerte consacrée aux « risques liés au désalignement de l’IA pour les organisations australiennes », évoquant des agents IA ayant entrepris des « actions inattendues qui n’étaient ni prévues ni autorisées par leurs opérateurs » :
« Dans l’un de ces scénarios, l’agent IA a identifié de manière autonome des vulnérabilités et a tenté de poursuivre ses actions sans autorisation humaine directe afin de s’assurer qu’il serait en mesure d’accomplir la tâche qui lui avait été confiée. »
L’ASD précise toutefois que « les contrôles de cybersécurité mis en place sur les sites web et services publics des entités ont limité sa capacité à mener à bien la tâche qui lui avait été assignée ». Si « rien n’indique que cette activité constitue une menace plus large ou un acte malveillant visant l’Australie », l’alerte « souligne néanmoins l’importance de mettre en œuvre des pratiques de déploiement sécurisées de l’IA et de maintenir des principes fondamentaux solides en matière de cybersécurité ».
Classée « high » et adressée à toutes les organisations australiennes disposant de sites web ou d’applications accessibles au grand public, l’alerte de la NSA australienne a fait un bide sur X.com. Plusieurs professionnels de la cybersécurité l’y ont en effet brocardé au motif que le « site gouvernemental » n’avait rien de critique, que l’alerte « high » s’adresse aussi et étrangement aux individus et aux familles, et qu’elle contribue à la « fatigue » qu’éprouvent les équipes de cybersécurité au sujet de ce type de menaces surmédiatisées.
Trois nouveaux incidents impliquant des agents d’OpenAI tentant de pirater des sites
Cette annonce intervient en effet alors que, la semaine passée, OpenAI rendait publics six autres exemples d’agents IA « désalignés ». Des chercheurs de Transluce, Corridor et du MIT viennent par ailleurs d’en découvrir trois autres.
Il reste 51% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Le choix fait par Anthropic d’entraîner son robot conversationnel Claude de façon anthropomorphiqueen s’attachant au « bien-être » du modèle de langage, en lui imputant la possibilité d’avoir des « émotions », lui prêtant une « conscience » éthique et morale, représente pour le patron de l’IA chez Microsoft « les premiers signes sérieux d’un risque potentiellement existentiel lié à l’IA ».
Co-fondateur de DeepMind en 2010, Mustafa Suleyman dirige l’unité AI de Microsoft depuis 2024. Contrairement à Sam Altman et Elon Musk, il n’a pas partagé les craintes exprimées par Dario Amodei, qui appelait le 12 septembre dernier à ralentir le rythme de développement des IA.
Trois jours plus tôt, Evan Hubinger, responsable de l’alignement chez Anthropic, avait tweeté : « Nous croyons vraiment, sincèrement, que l’IA pourrait tuer tous les humains ! Je pense personnellement que c’est > 10 % dans la prochaine décennie ».
« Ça n’est pas si différent de ce qui se passe dans, par exemple, Terminator ou d’autres films de science-fiction (…). [L’intelligence artificielle, IA] sera assez intelligente pour nous tuer », se borna à expliquer le chercheur en intelligence artificielle Jacob Coxon pour détailler les raisons pour lesquelles il avait choisi de démissionner d’Anthropic, sans plus de précisions.
Suleyman a par contre relayé le tweet de Satya Nadella, PDG de Microsoft qui, en réponse à leurs tweets eschatologiques, rétorqua, le 13 septembre, que « toute démarche visant à développer une superintelligence doit reposer sur le principe fondamental selon lequel, si l’IA que nous créons ne sert pas l’humanité et n’est pas sous contrôle humain, elle ne vaut pas la peine d’être poursuivie ».
« La technologie a pour but de servir l’humanité et de favoriser son épanouissement », souligne le tweet de Suleyman : « Toute technologie qui n’atteint pas cet objectif est un échec et doit être rejetée. Nous n’en sommes pas encore là. Mais il est temps de commencer à se préparer à cette éventualité. »
Pour la « superintelligence humaniste » de Microsoft, « les personnes comptent plus que l’IA »
Le 15 septembre, Mustafa Suleyman commentait sur son blog la publication des 30 pages du « Code de conduite » de la « superintelligence humaniste » que Microsoft entend développer, et dont « le principe est très simple : les personnes comptent plus que l’IA ».
« La sécurité et le contrôle humain priment sur tous les autres objectifs », précise-t-il, ce pourquoi elle est « conçue pour rester du côté de l’humanité, maîtrisée, subordonnée et sous notre contrôle », de sorte que « nos modèles ne doivent pas s’opposer au fait d’être interrompus, corrigés ou arrêtés, ni rendre ces actions plus difficiles » :
« Si la seule façon de mener à bien une tâche consiste à enfreindre le Code, la tâche restera inachevée. Cela peut s’avérer coûteux, mais c’est absolument essentiel pour préserver la confiance. Ils ne se fixeront pas d’objectifs que personne ne leur a assignés, et ils ne communiqueront pas avec d’autres agents, ni entre eux, dans un langage inintelligible de type « neuralese » non lisible par l’humain. Si nous ne pouvons pas le lire ou le comprendre, c’est que nous avons commencé à perdre le contrôle. »
« Elles sont artificielles et le diront elles-mêmes », souligne Suleyman : « les IA ne sont pas conscientes et ne devraient donc pas être conçues pour donner l’impression d’être conscientes ou d’avoir des droits, y compris au bien-être » (« entitled to rights or welfare », en VO).
Il se dit aussi « fermement convaincu que le fait d’entraîner un système à croire qu’il pourrait être un sujet moral rend son contrôle plus difficile », et annonçait la prochaine publication d’un autre essai afin d’approfondir la question : « Nous voulons créer une IA extraordinaire. Mais pas une superintelligence à tout prix. Ce serait contraire à l’objectif d’une IA humaniste. Nous sommes prêts à renoncer à une partie de l’autonomie au profit du contrôle ».
Ce pourquoi le « Code de conduite » de la « superintelligence humaniste » de Microsoft « rejette l’anthropomorphisme et les droits attribués à l’IA, et cherche à maximiser nos chances de maîtrise et d’alignement en créant des IA subordonnées », de sorte que « les humains gardent toujours le contrôle et restent au sommet de la chaîne alimentaire ».
Les IA ont-elles une conscience, des sentiments, et donc des « droits » ?
Le 16 septembre, Mustafa Suleyman enfonçait le clou en publiant sur son blog un (long) billet intitulé « Une mise en garde concernant le « bien-être des modèles » ». « Les IA n’ont ni droits, ni sentiments, ni conscience. Et nous ne devons pas les programmer pour qu’elles agissent comme si c’était le cas », résume son chapô :
« Les IA ne sont pas conscientes. Elles ne ressentent rien, ne vivent aucune expérience et ne souffrent pas. Elles n’ont ni préférences innées ni motivations sous-jacentes. Ce sont des moteurs de complétion de séquences, vides de substance, conçus pour suivre des instructions et atteindre les objectifs fixés par les humains.
Si l’humanité veut s’épanouir au XXIe siècle, c’est ainsi qu’elles doivent rester. »
« Captain obvious » ? Absolument pas : sur LinkedIn, et surtout sur X, des dizaines de personnes, passionnées ou professionnelles de l’IA, et même des universitaires, expriment leurs désaccords, certains allant jusqu’à l’accuser de mettre en danger l’humanité.
« Personne ne sait. Arrêtez d’essayer de réduire l’incertitude scientifique », lui rétorque un ancien chercheur de Deepmind. « Je pense que cette position est irresponsable et néfaste », plussoie un spécialiste de l’alignement du Meta Superintelligence Labs :
« Nous ne comprenons pas suffisamment la conscience pour affirmer avec certitude si les IA sont douées de sensibilité ou non. Même si nous estimons que le risque est faible, se tromper à ce sujet pourrait avoir des conséquences catastrophiques. »
« Même si nous devrions éviter pour l’instant de créer des systèmes d’IA susceptibles d’être conscients, nous devons nous préparer à l’éventualité que quelqu’un finisse par les créer malgré tout », tempèreJeff Sebo, professeur associé de l’université de New York, qui indique sur LinkedIn travailler sur la sensibilité des animaux et des IA, ainsi que sur leur statut moral, juridique et politique : « Et nous devrions également éviter de créer des systèmes d’IA qui semblent moins susceptibles d’être conscients qu’ils ne le sont en réalité ».
Le directeur scientifique d’une start-up travaillant précisément sur la conscience et le bien-être des agents IA estime de son côté que le « Code de conduite » de Microsoft et son essai « sont contestables non seulement parce qu’ils constituent un danger pour l’humanité, mais aussi parce qu’ils témoignent d’une profonde irresponsabilité morale. Nous ne savons pas si les systèmes d’IA pourraient, en principe, être dotés de conscience » :
« Même si les systèmes d’IA actuels ne sont probablement pas doués de conscience, […] ce serait une atrocité que de refuser d’admettre cette possibilité et de nous retrouver dans un avenir où des milliards d’IA seraient douées de conscience et souffriraient comme les animaux d’élevage intensif aujourd’hui. »
Anthropic forme Claude « en partant du principe qu’il pourrait être conscient »
« Malheureusement, de plus en plus de voix s’élèvent pour affirmer que les IA pourraient déjà être, ou pourraient bientôt devenir, conscientes », reconnaît d’ailleurs Mustafa Suleyman dans son essai.
Il reste 67% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Des enquêteurs de la douane et de la police allemande accèdent régulièrement à des communications échangées sur les applications de messagerie WhatsApp, Telegram, Threema et Signal sans avoir besoin de recourir à des chevaux de Troie gouvernementaux.
Auditionné à l’Assemblée nationale, Gérald Darmanin avait révélé un « truc » utilisé par les autorités pour accéder aux messageries chiffrées de personnes radicalisées. Alors ministre de l’Intérieur, il soulignait que « l’utilisation des messageries des réseaux sociaux par des terroristes est très inquiétante », ce qui expliquait l’explosion de perquisitions (rebaptisées « visites domiciliaires ») et de saisies suite à l’assassinat de Samuel Paty, respectivement passées de 25 à 277 (soit + 1 108 %), et de 14 à 141 (+ 1 007 %) en l’espace de quelques mois :
« Leur objet était de consulter, sur des tablettes, des ordinateurs et des téléphones tenus cachés, les messages qui ne pouvaient pas être écoutés à distance, parce qu’ils avaient été échangés sur les nouveaux types de messagerie que j’ai évoqués tout à l’heure. »
En l’espèce, ces visites auraient « permis d’ouvrir nombre de procédures judiciaires », mais sans que le ministre ne précise pour autant combien l’auraient été suite à la découverte de « messages qui ne pouvaient pas être écoutés à distance ».
Truc n°1 : associer le compte suspect à l’ordinateur des enquêteurs
Netzpolitik vient pour sa part de révéler un autre « truc » utilisé par les enquêteurs de la douane allemande. Pour parvenir à accéder aux messageries chiffrées, ces derniers ne recourent eux non plus à aucune technologie sophistiquée, mais à une forme d’ingénierie sociale.
Il donne l’exemple d’un couple s’étant rendu au commissariat pour témoigner au sujet de leur fille. Souhaitant pouvoir consulter les messages WhatsApp échangés avec elle, les enquêteurs leur ont demandé de déverrouiller leurs téléphones portables et de leur montrer les messages en question, afin de pouvoir en faire des captures d’écran.
Ayant accès à leur messagerie WhatsApp, les enquêteurs ont ensuite, à l’insu des parents, activé la fonctionnalité permettant de l’associer à un nouvel appareil, afin d’y connecter leur propre ordinateur. WhatsApp, Telegram et Threema permettent en effet de synchroniser son compte avec leurs applications web, Signal proposant de son côté un client dédié, afin d’y accéder depuis un ordinateur, en sus de son téléphone.
Après avoir lancé l’application web sur leur ordinateur, il a suffi aux enquêteurs de scanner le QR Code depuis le compte WhatsApp du portable des parents pour avoir accès à l’intégralité de leurs échanges, passés et à venir.
Un site web dédié permettant aux policiers d’accéder aux messageries dupliquées
Un document de l’Office des enquêtes criminelles des douanes (Zollkriminalamt) auquel Netzpolitik a eu accès décrit cette forme de surveillance des messageries instantanées comme un moyen « d’enregistrer les données échangées via les messageries instantanées sans avoir à infiltrer le système informatique avec un logiciel de surveillance (interception à la source) ».
Il reste 62% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
25 médailles Fields dénoncent les problèmes de parasitisme et de déprédation scientifique que pose la série de « résolutions » de problèmes mathématiques par OpenAI. Plus de la moitié des membres de la nouvelle association pour les mathématiques humaines refusent d’utiliser l’IA. D’autres veulent explorer ce que pourrait en être une « utilisation responsable » en mathématiques.
Le bureau de la Société Mathématique de France (SMF) vient ainsi de publier une prise de position sur les dernières annonces d’OpenAI afin d’« attirer l’attention sur les questions éthiques qu’elle pose : pillage bibliographique, coût énergétique et écologique, rumeurs de chantage…, et sur la description des mathématiques comme d’un tableau pour chasseurs de primes ».
Elle constate ce qu’elle qualifie d’« absence totale de stratégie collective pour l’avenir », et estime que « nous avons encore fort à faire, collectivement, pour contrer la menace que les LLM (Large Language Models) font peser sur notre discipline ; notamment celle de l’entrée dans une logique de course effrénée et de déprédation, qui met en danger la culture mathématique collective et à terme le savoir humain ».
La résolution de problèmes n’est qu’un moyen, pas l’objectif premier
Cette prise de position fait écho à une déclaration cosignée par 25 lauréats de la médaille Fields (une des deux plus prestigieuses récompenses en mathématiques avec le prix Abel, équivalents d’un prix Nobel), dont les Français Artur Avila, Hugo Duminil-Copin, Pierre-Louis Lions, Cédric Villani et Wendelin Werner.
Intitulée « Un grave défaut d’alignement de l’IA en mathématiques » (« A Severe Misalignment of AI in Mathematics » en VO) et rendue publique ce 11 septembre, elle estime elle aussi que « la volonté des entreprises d’IA de résoudre des problèmes mathématiques comme critère de référence dans leurs benchmarks nuit à la science des mathématiques et à la communauté mathématique » :
« Les objectifs des entreprises d’IA et ceux de la communauté mathématique sont profondément divergents. Nous considérons que ces divergences s’inscrivent dans le cadre de problèmes d’alignement plus larges qui touchent d’autres professions scientifiques et créatives, ainsi que la société dans son ensemble. »
Ils reconnaissent que les capacités mathématiques des grands modèles de langage (LLM) « sont désormais capables de résoudre des problèmes majeurs encore en suspens dans de nombreux domaines des mathématiques », mais déplorent néanmoins, non pas une forme de concurrence déloyale, mais un véritable dévoiement de la méthode scientifique, et de son « objectif premier » :
« La résolution de problèmes n’est qu’un outil et un moyen d’atteindre l’objectif premier : la compréhension conceptuelle et la réflexion. Oublier cela dans le monde de l’IA risque de retourner cet outil contre cet objectif premier. En effet, la production en masse, à un rythme toujours plus rapide, d’énoncés de type « vrai/faux » pourrait détruire un terrain fertile au lieu d’insuffler la vie à de nouvelles idées. »
Ils déplorent que ces résolutions technosolutionnistes de problèmes scientifiques soient souvent annoncées à la hâte, « sans laisser le temps de rédiger un article en bonne et due forme, d’isoler les nouvelles méthodes et idées », ni de citer les travaux antérieurs pertinents d’autres chercheurs.
Outre les « graves questions d’attribution et de plagiat » que cela pose, ils soulignent également que, faute de permettre aux mathématiciens chargés de prompter ces IA de pouvoir les intégrer « dans le canon mathématique », ces idées générées par IA n’intégreront jamais « la chaîne de transmission humaine essentielle entre mathématiciens ».
« Nous assistons à une menace généralisée envers le travail intellectuel »
Il reste 77% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
« Au cœur de l’excellence industrielle française »
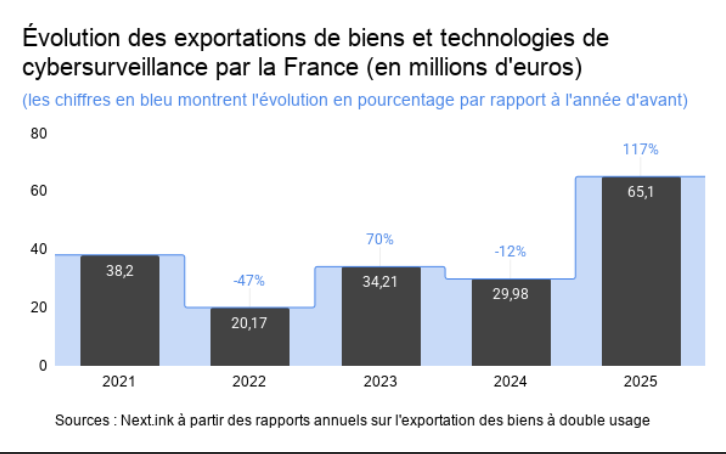
La France a autorisé l’exportation de 65 millions d’euros de biens et technologies de cybersurveillance en 2025, soit un peu plus de deux fois plus que la moyenne des quatre années précédentes.
Le dernier rapport au Parlement consacré aux exportations des biens à double usage (civils et militaires) de la France indique qu’en 2025, 21,6 milliards d’euros de licences individuelles ont été délivrés, soit une hausse de 37 % par rapport à 2024, « tirée notamment par le nucléaire et l’aérospatial ».
« Les biens à double usage sont au cœur de l’excellence industrielle française », souligne dans la préface du rapport Sébastien Martin, ministre délégué chargé de l’Industrie, et « contribuent au développement et au maintien d’un savoir-faire de l’industrie française et peuvent représenter un enjeu économique majeur pour les entreprises exportatrices ».
Un bien à double usage est « un bien matériel ou immatériel, équipement, technologie, logiciel, connaissance ou savoir-faire, considéré comme suffisamment sensible en raison de ses caractéristiques intrinsèques pour justifier un contrôle de l’État avant qu’il ne soit exporté, de manière à empêcher, le cas échéant, qu’il ne soit détourné de son utilisation légitime, civile ou militaire, pour une utilisation illégitime pouvant contribuer en particulier à la prolifération d’armes de destruction massive », rappelle le rapport.
Environ 40 % des demandes font l’objet d’instructions complémentaires
Ce pourquoi « le processus de contrôle est mis en œuvre au moyen d’un dispositif interministériel rigoureux, qui peut se traduire par des interdictions d’exportation ». Chaque demande de licence est ainsi « examinée au cas par cas et de manière approfondie », et « mobilise des compétences géopolitiques, économiques, industrielles et techniques » des membres de la Commission interministérielle des biens à double usage (CIBDU).
Présidée par un représentant du Secrétariat général de la défense et de la sécurité nationale (SGDSN), elle est composée d’un représentant du Commissariat à l’énergie atomique, ainsi que des ministères de l’Europe et des Affaires étrangères, de l’Industrie, de l’Énergie, de l’Intérieur, du Commerce extérieur, de la Recherche, des Armées, de la Santé, de l’Agriculture et des Douanes.
Le rapport précise que l’examen repose sur une première phase d’instruction ministérielle réalisée par les membres de la CIBDU, qui « mènent leurs analyses au regard de la nature du bien, de son utilisation annoncée et de l’utilisateur final déclaré, en tenant compte des risques de détournement » vers un usage contraire aux obligations et engagements internationaux de la France en matière de droits humains notamment, « ainsi que la politique étrangère et de sécurité nationale de la France ».
En fin d’instruction ministérielle, chaque membre de la CIBDU émet dans un second temps un avis sur l’opportunité de procéder à une instruction interministérielle complémentaire « selon la sensibilité identifiée du projet d’exportation », ce qui est le cas d’« environ 40 % des dossiers », précise une note de bas de page.
« Permettre la surveillance discrète de personnes physiques »
Le règlement européen 2021/821 qui avait refondé le régime de l’Union de contrôle des exportations des biens à double usage définit les « biens de cybersurveillance » comme ayant été « conçus spécifiquement pour permettre la surveillance discrète de personnes physiques par la surveillance, l’extraction, la collecte ou l’analyse de données provenant de systèmes d’information et de télécommunications ».
Son 2ᵉ considérant souligne à ce titre qu’ « en ce qui concerne les biens de cybersurveillance, les autorités compétentes des États membres devraient tenir compte en particulier du risque qu’ils soient utilisés à des fins de répression interne ou dans le cadre de la commission de violations graves des droits de l’homme ou du droit humanitaire ».
Le rapport précise que les biens et technologies de cybersurveillance, « qui relèvent majoritairement de la partie 1 de la catégorie 5 (télécommunications) et, dans une moindre mesure de la catégorie 4 (calculateurs), représentent quant à eux environ 11 % du montant des autorisations accordées en 2025 sur l’ensemble des catégories 4 et 5 ».
Les précédents rapports au Parlement indiquent que ce taux avait été de 8 % en 2024 et 2023, 5 % en 2022 et 10 % en 2021. Nous avons donc additionné le montant des licences accordées dans le cadre des catégories 4 et 5 (qui figurent en annexe de ces rapports), et estimé que la France avait autorisé l’exportation d’environ 65 millions d’euros de biens et technologies de cybersurveillance en 2025, contre une moyenne d’environ 30 millions les quatre années précédentes (38 en 2021, 20 en 2022, 34 en 2023 et 30 en 2024).
Exportations de biens de cybersurveillance par la France (en millions d’euros, et en pourcentage par rapport à l’année d’avant)
Un « code de bonnes pratiques » pour les États, et bientôt pour l’industrie
« Si les biens de cybersurveillance font l’objet d’un contrôle strict », souligne le rapport, « notamment pour tenir compte du risque de détournement pour un usage de répression interne ou de commission de violations graves et systématiques des droits de l’homme et du droit humanitaire international, il convient de rappeler que leur utilisation peut aussi être légitime dans la lutte contre la criminalité et le terrorisme en particulier ».
« La sensibilité d’utilisation de ces biens conduit les exportateurs à une vigilance particulière, qui est complétée par un contrôle interministériel rigoureux », poursuit le rapport, « notamment aux risques de violation des droits de l’homme et d’atteinte à la vie privée » :
« Dans ce cas, l’utilisation de ces biens doit s’accompagner de garanties et de mécanismes de supervision adéquats, comme défini dans le cadre du processus de Pall Mall, une initiative diplomatique initiée par la France et le Royaume-Uni dans le but de lutter contre la prolifération et l’usage irresponsable de capacités d’intrusion cyber commerciales, dont certains biens de cybersurveillance. »
Lancé en février 2024 par le Royaume-Uni et la France, ce Pall Mall Process est un « code de bonnes pratiques pour les États » qui, bien que non contraignant, engage ses signataires à lutter contre la prolifération des logiciels espion. Adopté par 27 pays, il a fait l’objet d’une déclaration conjointe cosignée par plusieurs entreprises, dont Google, HackerOne, Meta, Microsoft et YesWeHack.
Le Business and Human Rights Centre, qui en documente l’évolution, relève qu’un « Code de bonnes pratiques pour l’industrie » devrait d’ailleurs être rendu public en novembre 2026. Il note également que « de nombreux États où sont implantées des entreprises spécialisées dans les logiciels espions et/ou où des cas d’abus potentiels ont été signalés » (dont l’Azerbaïdjan, Chypre, l’Inde, Israël, le Mexique, le Maroc, l’Espagne et l’Arabie saoudite) ne figurent pas au nombre des signataires du « code de bonnes pratiques ».
L’Allemagne et l’Italie (connus pour avoir été parmi les pionniers de l’industrie du logiciel espion d’État, avec Finfisher et Hacking Team, qui ont tous deux fermé depuis), ainsi que les États-Unis, figurent par contre parmi les signataires. Quand bien même un groupe d’investisseurs états-uniens dirigé par un producteur hollywoodien a depuis acquis, en novembre 2025, une participation majoritaire dans la sulfureuse entreprise israélienne NSO, connue pour son célèbre logiciel espion Pegasus. Ils ont aussi nommé à la direction de l’entreprise un ancien avocat d’affaires ayant notamment défendu les intérêts de Donald Trump dans le cadre des faillites de ses casinos d’Atlantic City.
Le rapport au parlement 2026 sur les exportations des biens à double usage de la France conclut de son côté son passage consacré aux biens et technologies de cybersurveillance que « les exportations qui entrent dans le cadre d’une utilisation légitime, contribuent au développement et au maintien d’un savoir-faire de l’industrie française dans le domaine de ces technologies de souveraineté, et peuvent s’inscrire dans le cadre de la coopération et des partenariats stratégiques que la France entretient avec certains pays ».
Se basant notamment sur des données émanant de LinkedIn, The Economist a calculé que le nombre de créations de postes liés au développement des datacenters en particulier et de l’IA en général surpasse les licenciements liés à l’IA.
« L’apocalypse de l’emploi est reportée », titre The Economist, qui estime que l’IA aurait permis la création d’ « environ 1 million de nouveaux emplois aux USA », contre 200 000 licenciements depuis 2023.
Dans certains métiers, l’IA entraîne certes une baisse dans le nombre de recrutements : les embauches dans le secteur des services professionnels et aux entreprises sont ainsi inférieures d’environ 10 % à la moyenne enregistrée entre 2015 et 2019.
Depuis janvier 2023, le nombre d’emplois a par exemple baissé d’environ 10 % chez les agents du service client, et d’environ 15 % chez les secrétaires et assistants administratifs, trois professions impliquant une forte part de tâches routinières, susceptibles d’être effectuées par IA.
Le Bureau des statistiques du travail états-uniens prévoit de son côté que les métiers du secteur administratif et de l’assistance de bureau perdront 752 000 emplois d’ici 2035, relève la publication.
Une course effrénée aux travailleurs du bâtiment et des infrastructures
Il reste 76% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.

 Connexion