AMD sent out their latest Linux kernel graphics driver patches today for enabling some new hardware IP blocks. And as part of that, preparing for GDDR7 video memory with the AMDGPU driver...
There's a new Linux distribution focused on supporting Linux on Apple Silicon Macs. Gravity Linux is this new distribution that is a spin of Fedora Remix and is catering to the still-experimentally-supported Apple M4 Macs and newer. In addition to leveraging Asahi Linux code and reverse engineering, Gravity Linux also leverages OpenAI Codex and Claude Code...
"In a few weeks, KDE will turn 30 years old," writes core contributor Kevin Ottens, celebrating with some special KDE community data analytics (including a 30-year graph of the number of contributors):
It peaks around 180 on average (and sometimes reaches towards around 200 people) then shrinks again hitting bottom around 110 persons on average in 2017... Since then, we had two major events happening. First, 2018 is the year where we had the first set of KDE Goals being picked by the community, one being "Streamlined onboarding of new contributors". Second, we had the transition to GitLab which was fully delivered early in the second quarter of 2020...
Now it seems like the team size is around 140 people on average, so closer to the all time high of 2010 but we didn't fully close the gap yet. Interestingly though, the commit count is much closer to the one we had in 2010, with a bit less people. We even had an all time high commit count in 2023 which surpassed any other week since the creation of the project. And to make things even brighter, the trends at the end of the plot point upwards. Looks like 2026 will be a very good year. Hopefully the growth will stay stable this time and then the community will be the biggest it's ever been...
[For the KDE Plasma desktop] We find the 2010 dip but it's much less dramatic than in all the other plots. It stabilized much quicker and managed to stay with an almost identical team size. We also find the increase leading up to 2020. And clearly it's one of the projects which benefitted the most of the GitLab transition. It's average team size almost doubled during the transition! Earlier I asked where the increase we could see on KDE as a whole but not on applications was coming from? Well, this is probably it. Like the rest of KDE, 2026 will be a very good year for Plasma as well. I wonder... will it double in size again next year compared to 2020?
"I'm rather happy that KDE as a whole seems very healthy..." the post concludes. "It looks like in almost 30 years KDE built a great community and many awesome products..."
"Kudos to all the people involved for the past 30 years! Even if you're not involved any more you helped contribute something beautiful and precious to the world. We're the living proof that large commons can be created and made sustainable thanks to passionate people."
While the downstream Asahi Linux kernel has offered working speaker support and headset jack capabilities on Apple Silicon Macs, the mainline Linux kernel hasn't supported this functionality. But a set of 28 patches sent out today on the Linux kernel mailing list are working toward mainlining this important functionality for using Apple Macs on the upstream Linux desktop...
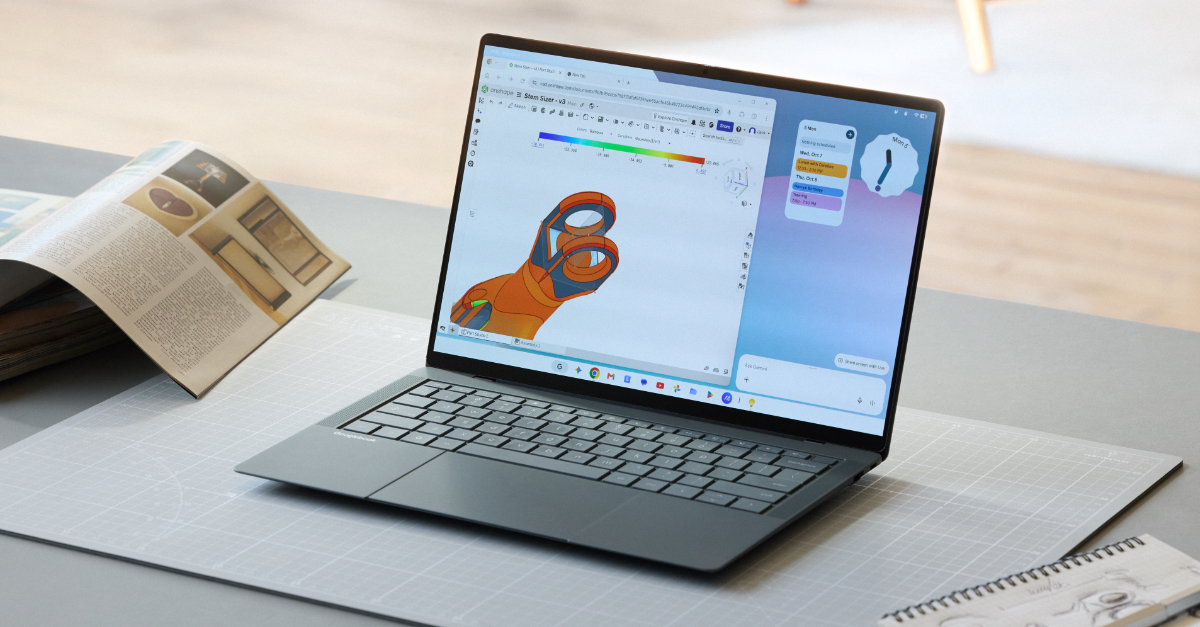
Le 12 mai 2026, Google officialisait une nouvelle catégorie d'ordinateurs portables centrée autour de son IA Gemini : les Googlebooks. Embarquant le nouveau système d'exploitation de la firme, baptisé sobrement Googlebook OS, il a pour vocation de créer une véritable passerelle entre votre smartphon...
Après avoir échoué à imposer le Chromebook auprès du grand public – même si ces appareils restent populaires dans certains marchés comme celui de l’éducation –, Google remet donc une pièce dans la machine avec sa toute nouvelle famille Googlebook. Des portables fabriqués par des constructeurs partenaires, fonctionnant sur un système d’exploitation qui combine ChromeOS à Android, avec une bonne rasade d’IA par-dessus, le tout à des prix dignes d’un MacBook Air, à partir de 1 099 euros : c’est le pari du géant du web.
Google retente sa chance dans le secteur du portable. Après une première présentation mi-mai, le géant du web lance les premiers Googlebook et cette fois, pas question de vendre des machines au rabais comme le furent les premiers Chromebook. Ces appareils émargent dans la catégorie « haut de gamme », selon les propres mots de Google, avec des prix à l’avenant.
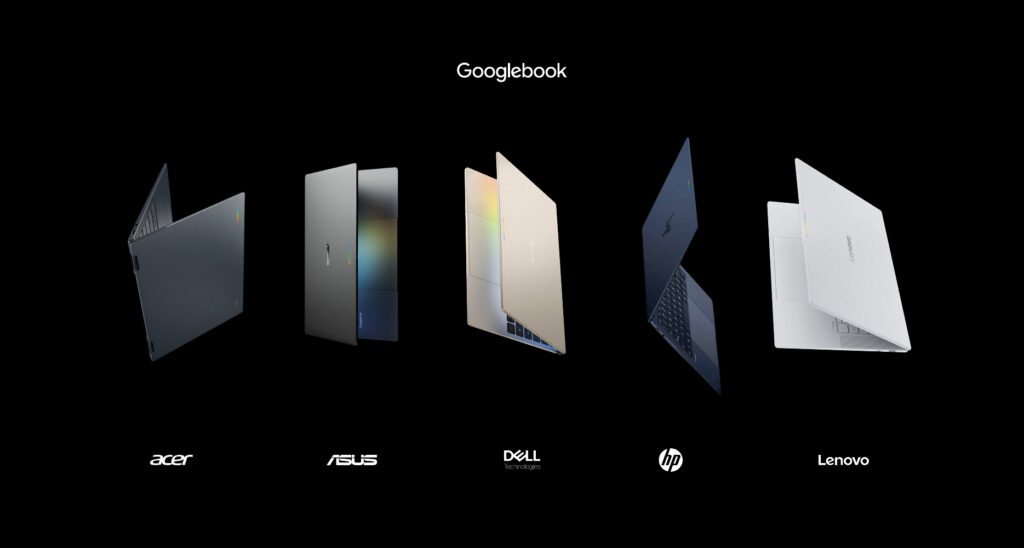
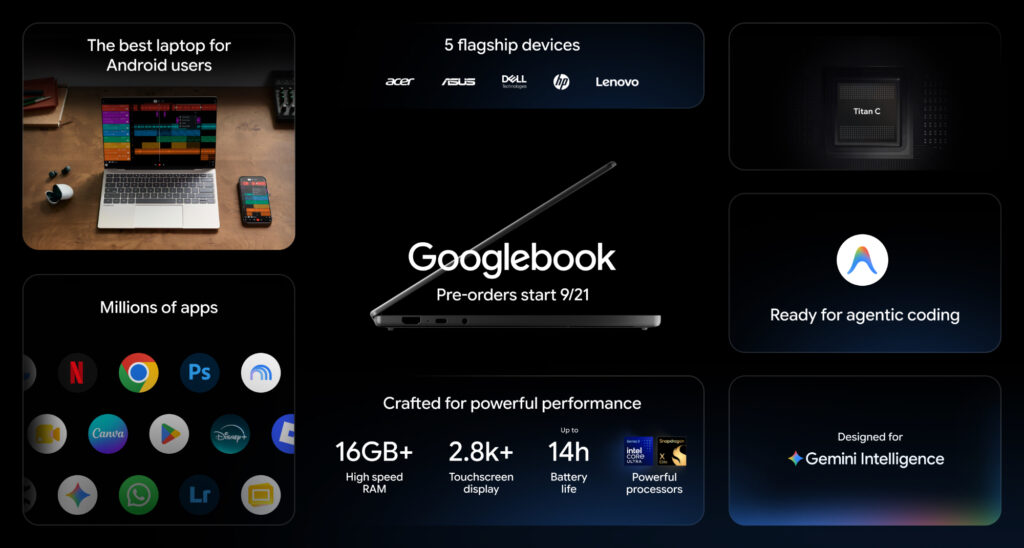
Acer, Asus, Dell, HP et Lenovo sont les constructeurs partenaires de ce lancement, avec des modèles qui débutent à 1 099 euros. Au menu : « matériaux premium » (aluminium, alliage de magnésium, fibre de carbone), écrans tactiles OLED 2,8K pour les mieux dotés, trackpad en verre avec retour haptique ou mécanique, clavier rétroéclairé, barre lumineuse discrète sur le capot.
Sous le capot, les Googlebook ont le choix entre une puce Intel (Core Ultra Series 3 Panther Lake) et une puce Qualcomm (Snapdragon X Elite) ; des modèles avec du silicium MediaTek sont également prévus. Ils embarquent de 16 à 32 Go de mémoire unifiée, et de 256 Go à 1 To de stockage.
Il s’agit d’ordinateurs portables dans tous les cas (le Googlebook 14 d’Acer peut se transformer en tablette), mais d’autres formats ne sont pas exclus à l’avenir. Rick Osterloh, vice-président de Google en charge du matériel et des services, évoque rapidement chez The Verge la possibilité d’autres designs, et pourquoi pas des ordinateurs de bureau. L’équipe qui en interne s’occupe de la gamme Pixel pourrait proposer son propre Googlebook.
C’est surtout sur la partie logicielle que la gamme Googlebook sort du lot. Le système d’exploitation, baptisé Googlebook OS (pourquoi faire compliqué) repose sur un socle partagé entre ChromeOS et Android. L’idée générale est qu’un utilisateur de smartphone Android se sente comme chez lui sur un Googlebook.
Image : Google
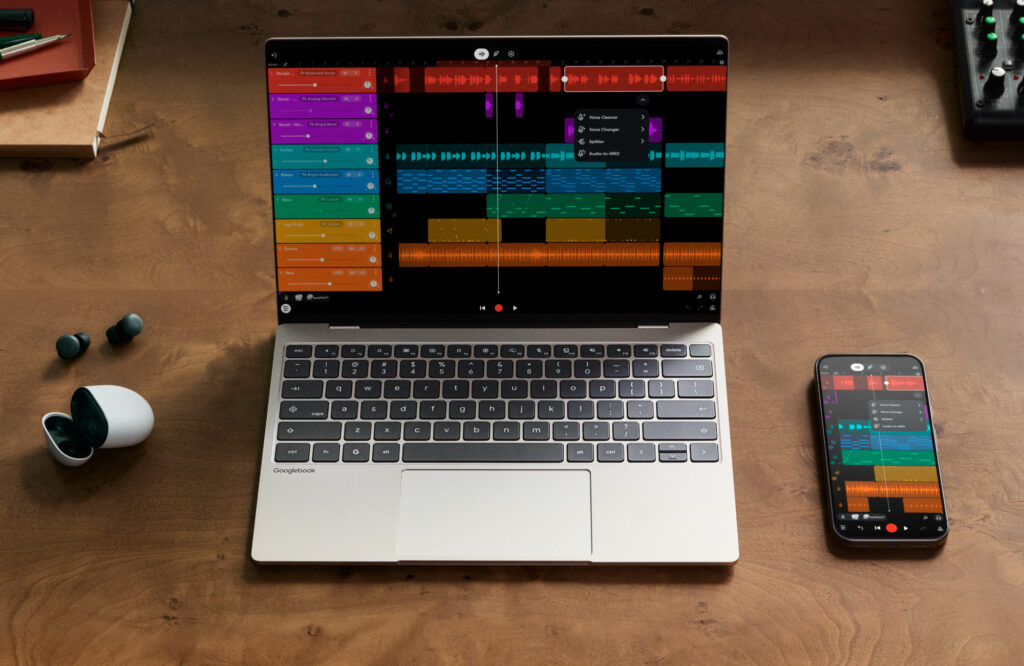
Ainsi, les paramètres Android, les mots de passe, les réseaux Wi-Fi et les messages sont synchronisés entre le portable et le téléphone. Une fonction de continuité permet de passer d’un appareil à l’autre et inversement. Google n’invente rien ici : les utilisateurs d’iPhone et de Mac connaissent ce type de fonctionnement transparent depuis des années.
Un petit air d’Apple
Les Googlebook ont accès au Play Store, donc à des millions d’applications Android et Google promet qu’ « un grand nombre est optimisé pour les grands écrans, le clavier et la souris ». L’entreprise évoque des logiciels comme Photoshop et Lightroom, mais il s’agit des versions mobiles.
Les jeux Android sont de la partie évidemment, tout comme le service GeForce Now de streaming de jeux. Il est aussi possible de projeter une app depuis son smartphone vers le portable, et d’accéder aux fichiers et documents stockés sur le téléphone ; il apparait en fait tout simplement dans la fenêtre de l’explorateur de fichiers.
Googlebook a été « conçu pour Gemini Intelligence » – image : Google
L’autre grande affaire des Googlebook est l’intégration profonde de Gemini. Les portables intègrent un NPU jusqu’à 45 TOPS, de quoi leur assurer le traitement en local de fonctions d’IA regroupées sous la bannière « Gemini Intelligence ». Google met en avant le « Pointeur magique » qui permet à Gemini d’interagir avec le contenu affiché à l’écran en secouant le curseur de la souris.
Une fonction de dictée améliorée met en forme les mémos vocaux pour être partagés par écrit. Le bureau du Googlebook pourra être personnalisé avec des widgets créés par l’utilisateur. Les Googlebook intègrent également Antigravity, la plateforme maison qui permet de concevoir des agents IA et déployer des applications depuis la machine.
Les précommandes ont débuté auprès des distributeurs français, pour une disponibilité le 5 octobre. Pour l’occasion, Google livre 12 mois d’abonnements à sa formule IA Pro, 5 To de stockage en ligne, et surtout dix ans garantis de mises à jour logicielles.
La société TypeSafe AI a présenté il y a quelques jours un nouveau modèle d’IA. Baptisé Jev, il se propose de traiter certaines opérations bien plus rapidement que les LLM « traditionnels », pour beaucoup moins cher. La comparaison reste cependant délicate.
L’annonce a fait l’effet d’une petite bombe sur les réseaux sociaux, particulièrement sur X : la société TypeSafe AI, fondée par Diogo Almeida, a annoncé son nouveau modèle de frontière, Jev.
Diogo Almeida se présente comme co-inventeur de ChatGPT. Un titre un peu exagéré. Il a travaillé effectivement sur les méthodes qui ont rendu capables les modèles GPT de suivre des instructions et de converser avec les utilisateurs. Mais il serait plus juste de dire qu’il est le co-inventeur du RLHF (Reinforcement Learning from Human Feedback), c’est-à-dire l’apprentissage par renforcement à partir de rétroaction humaine. Il est effectivement l’un des auteurs d’un papier fondateur sur la question.
Jev, en tout cas, n’est pas un LLM : il ne peut pas créer de texte ni même aider à la programmation. Il est décrit comme le premier « System One Model », une nouvelle catégorie de modèles conçus pour prendre des décisions rapides et structurées, que des services ou applications peuvent ensuite utiliser directement.
Ce qu’est Jev
Le modèle est comparé par TypeSafe AI à un appel de fonction : un état non structuré en entrée, des décisions probabilistes typées en sortie. Concrètement, on lui envoie un état (le contexte) et des questions portant sur cet état. Les réponses possibles sont fixées à l’avance par un schéma. Jev répond ensuite via trois primitives : le choix d’une option dans un ensemble, une note sur une échelle ordonnée, et un oui ou non calibré.
Pour bâtir Jev, TypeSafe AI dit avoir construit une nouvelle architecture de modèle, un échantillonneur parallèle et une nouvelle méthode de renforcement baptisée RLCD, pour « Reinforcement Learning for Calibrated Decisions ». L’échantillonneur parallèle signifie que toutes les questions d’une requête sont évaluées en parallèle, contrairement à un LLM dont chaque nouvel élément dépend du précédent.
Plusieurs points forts sont mis en avant, notamment la calibration via RLCD. Selon l’entreprise, cet entrainement doit permettre des réponses assorties de probabilités « honnêtes ». Dans ce contexte, une confiance plus élevée (donnée sous forme de pourcentage) signifie une meilleure exactitude. En outre, TypeSafe affirme que Jev ne peut pas halluciner, puisque la sortie est contrainte par le schéma. Il faut cependant lire entre les lignes : dans ce contexte, Jev garantit le respect du format, pas la justesse du format. En d’autres termes, Jev ne peut rien « inventer », mais il peut se tromper de catégorie.
Vite, un exemple !
Pour mieux comprendre l’intérêt de ce nouveau modèle, mieux vaut un exemple. Imaginons un service client qui reçoit 10 000 e-mails par jour. Pour chacun, un programme doit prendre plusieurs décisions : le client est-il mécontent ? Faut-il envoyer le message au service facturation, technique ou commercial ? Est-ce urgent ?
Aujourd’hui, ce type de tâche est souvent confié à un LLM comme GPT ou Claude. On lui envoie l’e-mail avec une consigne du type « dis-moi si c’est urgent », et il répond par une phrase : « Oui, ce message semble urgent car le client menace de résilier ». Problème, un programme informatique ne « comprend » pas les phrases. Il faut donc un travail supplémentaire pour extraire le « oui » de cette phrase. De plus, le modèle peut répondre à côté, ajouter des commentaires inutiles ou inventer une catégorie qui n’existe pas. Enfin, écrire une phrase mot par mot prend du temps et coûte cher.
Jev ne fonctionne pas avec des phrases, mais avec trois primitives. On applique une liste de questions dont les réponses sont fixées à l’avance :
Le client est-il mécontent ? Oui/Non
Quel service doit traiter cet e-mail ? Facturation/Technique/Commercial
Quelle urgence sur une note de 1 à 5 ?
Si on continue dans cet exemple, on obtiendra une réponse du type : « oui (92 % de certitude), facturation (85 %), urgence 4 (70 %) ». Cela revient à donner un formulaire à remplir pour répondre à une question plutôt que demander son avis à une personne.
Les données émises par Jev sont formatées et peuvent être reprises telles quelles par d’autres éléments de traitement de la chaine. Quand TypeSafe affirme que son modèle ne peut pas halluciner, cela signifie que Jev ne peut pas répondre par exemple « Juridique » pour le service à contacter. En revanche, rien ne l’empêche de se tromper sur le service à effectivement contacter. On peut alors appliquer un filtre pour automatiser l’envoi à une équipe humaine pour toutes les réponses dont le score de confiance est inférieur à 80 %.
L’efficacité mise en avant
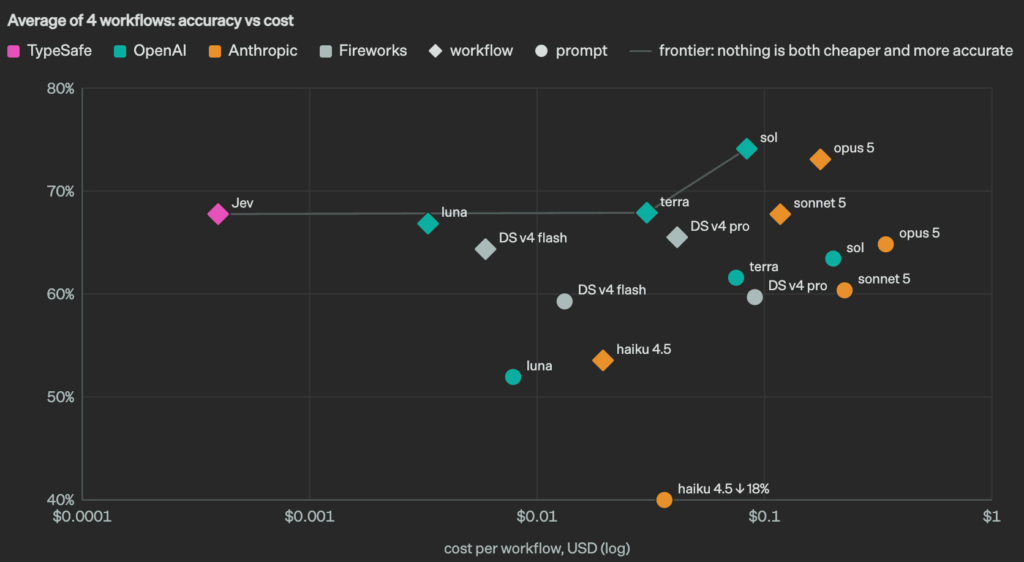
L’un des éléments les plus repris par la presse est l’efficacité du modèle. Sur les tâches pour lesquelles il a été pensé, le temps de réponse annoncé va de 70 à 500 ms, soit 40 à 200 fois plus rapide que les modèles de pointe pour des requêtes de ce type. Le prix est de 0,042 dollar par million de jetons en entrée, et la sortie est gratuite. À titre de comparaison, GPT-5.6 Terra coûte 2 dollars par million de jetons en entrée et 12 dollars en sortie.
Dans sa présentation, TypeSafe donne des chiffres mais émet elle-même des réserves. Ainsi, les gains maximaux peuvent être très précisément de x193,6 sur les performances et x444,6 moins cher. Ces chiffres viennent de quatre chaines de traitement interne : réponse aux incidents de sécurité, observation de traces d’agents, traitement de factures et service client.
Même si TypeSafe évoque une certaine prudence, il est difficile pour l’instant de jauger des performances réelles comme de la facture finale, car le modèle n’est disponible pour tout le monde que depuis le 20 septembre, sans liste d’attente. Si l’on en croit certains retours d’entreprises ayant testé le modèle, le gain semble avéré.
En outre, l’annonce de Jev est déjà contestée. Selon Nandakishor Mukkunnoth, fondateur de ConvAI Innovations, l’idée n’est pas nouvelle. Dans un billet, il indique être à l’origine des recherches qui ont mené à cette technique, dont il revendique la paternité. Il ne reproche pas à TypeSafe d’avoir copié du code, mais de ne pas avoir cité des travaux antérieurs. Sur Hacker News, plusieurs personnes notent que ce type de mésaventure est malheureusement courant, mais que l’apport de TypeSafe est surtout d’avoir réussi à en faire un produit concret.
Ce qui n’a pas empêché Nandakishor Mukkunnoth de publier une alternative libre, nommée Laya. D’autres modèles libres sont apparus en quelques jours. Si l’on en croit les premiers tests réalisés indépendamment, tous les modèles affichent des performances moindres que Jev. Si l’on donne un score de référence de 1 à ce dernier, les 78 tests effectués font ressortir des notes alternant entre 0,5 et 0,7, Laya étant dans la moyenne.
Pour réduire l’empreinte environnementale des IA (génératives), un rapport du Sénat préconise une IA « française ». Pas tant dans le sens souverain (et respectueux), mais dans le sens d’implantation des datacenters et de consommation des ressources, notamment d’électricité bas carbone (nucléaire). Cela soulève toutefois des questions sur le foncier et l’acceptation sociale.
La commission de l’aménagement du territoire et du développement durable du Sénat vient de présenter le rapport d’une mission d’information sur l’empreinte environnementale de l’intelligence artificielle. Comme nous, le Sénat se heurte à un problème de taille : les données disponibles sont encore et toujours « lacunaires », aussi bien sur la consommation en eau qu’en électricité.
Pourtant, l’enjeu est important puisque l’empreinte environnementale de l’IA est présentée comme « un défi pour la planète », mais il se heurte aux géants (principalement américains). Malgré de belles promesses sur leur empreinte environnementale, ils consomment toujours plus.
Les rapporteurs ont une solution qui ne plaira pas à tout le monde : venez en France. « L’empreinte environnementale de l’IA, qui renforce les constats établis par notre commission en 2020, constitue à la fois un défi pour la planète et une opportunité pour la France et pour l’Europe », affirme le rapporteur Damien Michallet.
Consommation en eau : voir au-delà des m³
Le rapport rappelle à juste titre que « la consommation d’eau destinée au refroidissement dépend cependant des technologies utilisées ». Les tours aéroréfrigérantes ont l’empreinte hydrique la plus élevée, avec « l’évaporation d’environ 80 % de l’eau prélevée ». C’est encore plus problématique « dans les pays, comme les États-Unis, où certains centres sont implantés dans des régions déjà soumises à un fort stress hydrique ».
En France, d’autres technologies sont utilisées et « les prélèvements d’eau destinés aux centres de données restent très limités ». Le Sénat reprend les derniers chiffres de l’Arcep sur l’année 2023 : 681 000 m³ d’eau en consommation directe, mais laisse de côté (dans la version condensée de son analyse) la consommation indirecte liée notamment à l’électricité.
Il reste 76% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
With the in-development Linux 7.3 kernel showing some nice performance improvements over Linux 7.2 in different areas, Linux 7.2 also having brought some nice gains especially for I/O, and the preceding kernels also having seen some nice performance optimizations this year, I wanted to measure how far the Linux kernel performance has evolved so far in 2026. Today's article is looking at that with how the Linux kernel performance has evolved since the Linux 6.18 LTS kernel at the end of 2025 to the current Linux 7.3 kernel.
Amazon released the Kindle 4 back in 2011 with a 6-inch E-ink display, 2GB internal storage, and running a modified version of Linux. In the years since the Amazon Kindle 4 has been jail-broken and there are some customized Linux distributions with a patched kernel to run on the Kindle 4. Now in 2026 there are patches on the Linux kernel mailing list looking to mainline support for that fifteen year old e-reader device...
La GDDR7 revient au centre des débats. Elle a porté les espoirs de ceux qui voulaient une RTX 50 avec plein de VRAM avec les modules de 3 Go, mais la firme est restée aux modules de 2 Go du fait de cette foutue pénurie qui a coupé l'herbe sous le pied de milliers de clients / geeks à travers le mond...
There's at least 15 author-driven lawsuits underway against AI companies, while publishers have filed roughly 10 more coordinated suits of their own, notes Publisher's Weekly.
Yet "While the lawsuits play out, some publishers are building bridges."
Google recently announced a partnership with Bloomsbury, De Gruyter Brill, Johns Hopkins University Press, Macmillan, O'Reilly Media, and Penguin Random House to enhance e-books from its Google Play store with AI, allowing readers to interact with the text of the books directly, ask questions and get answers, and develop tools such as quizzes and slideshows... [The CEO of the Author's Guild called the partnership "a positive step forward in the legitimized use of books in the AI ecosystem to the benefit of readers, publishers, and authors alike."]
Of even more significance is the growing number of licensing deals publishers are striking with AI companies. In 2024, HarperCollins became the first of the Big Five to publicly reveal that it had signed a deal to license its content for AI training. The three-year agreement paid $5,000 per participating title, split equally between HarperCollins and the authors. Wiley announced its first AI licensing deal in 2024 and has since made several more. For fiscal year 2026, it reported earning $49 million in revenue from the deals. The company also has a number of strategic collaborations with companies including Amazon Web Services, Microsoft, Anthropic, Perplexity, IQVIA, OpenEvidence, and others.
And publishers are even building in-house AI tools for producing royalty statements, proofreading, and providing customer service:
In its 2025 Salary and Jobs Report, Publisher's Weekly reported that 63% of industry professionals surveyed said their organizations were using AI... Keith Riegert, president of the Stable Book Group and CEO of Perfect Bound, has been a vocal advocate for the use of AI in publishing — despite calling himself a "hardcore techno-pessimist." He tells PW, "I do this because you use AI or you die at this point...." Like many in the industry, he maintains any use of AI must "start with a human and end with a human," and he draws a clear line, avoiding AI for core creative work, such as selecting titles, designing covers, or creating illustrations — reserving it for developmental editing, formatting, and admin instead... What is known is that each of the Big Five is developing proprietary AI systems for internal use, as proven by the numerous AI-related job openings the companies have posted... [And the parent company of Penguin Random House said in 2025 they used AI for marketing and to forecast demand.]
There've been a few high-profile controversies about prominent authors accused of using AI. But Princeton University Press CEO Christie Henry "is less concerned about authors secretly using AI to write than about the time spent policing the situation."
"It pulls us away from having focused time to think," she says. Princeton University Press is currently vetting companies that promise to be able to certify that a given book was written by a human, including Created by Humans, Human Authored, and Verify My Writing. Henry adds that the proliferation of plagiarized, copycat, and pirated books online, now supercharged by AI agents mass producing and reproducing content, is further draining resources, as it demands constant vigilance and takedown requests sent to Amazon, YouTube, and others.
Mise à jour du 21/09/2026 : L’équipe d’Open Printer vient de publier une petite vidéo qui présente rapidement l’imprimante. D’une durée d’une grosse minute, elle montre notamment la machine en action en niveaux de gris et en couleurs. On y découvre une imprimante beaucoup plus rapide que ce que j’anticipais et la réalisation d’une page en rouleau qui ouvre des possibilités très intéressantes pour imprimer sur des formats A3 ou encore plus large.
La vidéo est accompagnée d’une mise à jour de sa page de financement participatif. Sur celle-ci, un sondage est réalisé pour prendre en compte l’avis des éventuels intéressés. La campagne devrait débuter cet automne.
Billet original du 30/09/2025 : Vous avez été très nombreux à m’envoyer le lien vers le financement participatif de l’Open Printer. Cette imprimante papier étant assez surprenante dans son approche comme dans son esthétique, elle a, semble-t-il, interrogé beaucoup d’entre vous.
Il faut dire que les deux mots sont historiquement assez antinomiques. « Open Printer » c’est un peu comme « gentil dictateur » ou « fantôme incarné », cela ne colle pas bien ensemble. Quand on parle d’imprimante classique sur Minimachines, c’est souvent pour parler des dérives des marques qui les fabriquent et qui les enferment toujours plus dans un système absolument étanche. L’exact inverse de tout ce qui est « Open » donc. On parle de DRM, d’incompatibilité, de composants et de consommables protégés et d’obsolescence programmée. Associer « Open » et « Printer » revêt presque un caractère sacrilège et pourtant, c’est bien ce qui est proposé ici en financement participatif.
Le projet est simple, proposer au public une imprimante ouverte et libre, constructible, réparable et dont les consommables ne soient pas liés à une marque tierce. Cela parait évident mais c’est un vrai défi à relever. Sur le papier, cela ne semble avoir que des avantages. On retrouve une imprimante couleur capable de manger aussi bien des formats A4 que A3. Il sera également possible de lui donner à imprimer en longueur avec du papier en rouleau. La définition est plus que correcte avec du 600 PPP en noir et blanc et jusqu’à 1200 PPP en couleur. Pour parvenir à ce résultat, l’imprimante se base sur une tête d’impression HP 302 massivement disponible sur le marché. L’encre peut être de n’importe quel type adapté, il suffira de remplir une cartouche pensée pour être rechargée. Une solution qui permettra de changer facilement la tête d’impression en cas de pépin et qui évitera d’acheter de l’encre coûtant au millilitre autant qu’un parfum de luxe.
La connexion à l’imprimante pourra se faire de manière classique via un port USB type-C qui se branchera à la carte Raspberry Pi Zero 2W qui servira de cerveau à l’Open Printer. L’appareil profitera de la connexion Wi-Fi de la carte pour recevoir des documents distants sans fil. Un port USB Type-A permettra également de lancer une impression en direct en connectant une clé USB et en contrôlant le tout avec un petit écran de 1.47 pouces en 320 x 172 pixels grâce à une molette de navigation. Un détail qui me fait d’ailleurs penser aux premières imprimantes 3D avant l’arrivée des petits écrans tactiles. Le tout mesurera 50 cm de large pour 10 cm de profondeur et 11 cm de hauteur. Un format qui permet d’accrocher l’Open Printer au mur pour gagner de l’espace.
Si on considère l’ensemble de ces éléments et le fait que l’objet soit documenté en format Open Source via un format Creative Commons 4.0, on a là un projet à l’étendue absolument considérable. Il faut se souvenir que les toutes premières imprimantes 3D accessibles du marché ont été fabriquées par des passionnés qui ont développé des logiciels open source et assemblé du matériel disponible à la vente pour tout un chacun. Soit exactement le schéma repris ici par ce projet Open Printer. Petit à petit, le foisonnement d’idées des internautes et la mise en commun des compétences de milliers d’ingénieurs et de programmeurs a fini par produire des imprimantes 3D, des protocoles et des développements de haut niveau. Un microprogramme comme Klipper est un développement libre, Open-Source qui anime le cœur de nombreux modèles d’imprimantes 3D aujourd’hui.
Ma toute première imprimante 3D, une Anet A8, nécessitait un temps de montage et de calibration démentiel.
Aujourd’hui les imprimantes 3D sont Plug’n’Play dès la sortie du carton
La suite, on la connait. L’émulation du libre a conduit des entreprises à développer leurs propres modèles d’impression 3D en s’appuyant plus ou moins sur les développements libres. Créant un foisonnement d’idées et de solutions tel que des progrès incroyables ont été portés en quelques années. L’impression 3D qui était un loisir pour passionnés fortunés ayant beaucoup de temps libre il y a 10 ans est désormais une pratique accessible et facile aujourd’hui.
Un projet comme Open Printer pose encore beaucoup de questions.
A la lecture de la fiche technique de l’Open Printer, un détail a retenu mon attention. Le fait que le projet ne présente aucune vidéo de fonctionnement ni aucun détail sur la vitesse d’impression proposée par l’imprimante. Je suppose que l’impression d’une page ne doit pas être des plus rapides. Le détail du tarif de l’engin n’est pas non plus spécifié. Cela me chiffonnait au départ et puis je me suis posé dans la perspective de l’impression 3D. Les prix du début ont fondu très rapidement. La vitesse d’impression a également explosé. Ce qui prenait 4 heures à imprimer à ma toute première imprimante ne prend plus que 15 minutes à la toute dernière arrivée au labo.
Si Open Printer crée le même genre de mouvement de fond. Si cette imprimante Open Source est le premier domino d’un long jeu de développement et d’améliorations techniques. Il y a fort à parier que dans quelques années des kits de construction d’imprimantes similaires soient disponibles sur le marché. Un constructeur tiers pourra très bien développer une tête d’impression sur mesure. Un autre des kits d’alimentation en encre ou un jeu de moteurs plus rapides. Des internautes pourront proposer des formats encore plus grands pour imprimer sur du A2, par exemple, ou pour imprimer des plans ou des affiches. On peut même imaginer que d’autres constructeurs se mettent à développer des modèles basés sur le même principe, comme cela a été fait dans le monde de l’impression 3D. Et tout cela serait une excellente nouvelle pour les consommateurs. Un peu moins pour les marques qui proposent depuis toujours des imprimantes à 50€ pour se rattraper ensuite sur la durée avec des kits d’encre à 35€…
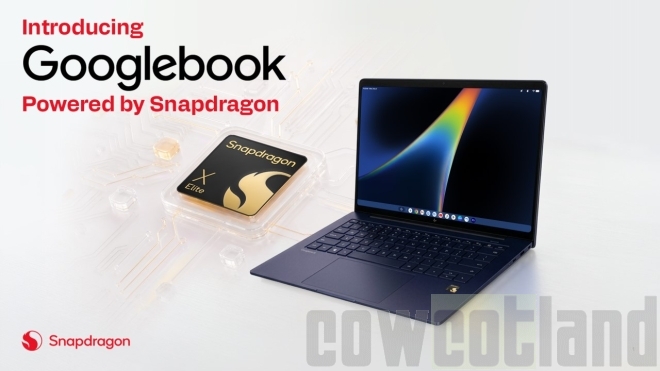
Après le Chromebook, place au Googlebook. Google et Qualcomm inaugurent une nouvelle catégorie de PC portables premium, pensée dès le départ pour Gemini Intelligence. Pour animer ces nouvelles machines, les deux entreprises ont retenu le Snapdragon X Elite, tandis que Dell et HP seront les premiers constructeurs à proposer des Googlebooks. Googlebook, le mariage entre Gemini, Android et le PC portable Le Googlebook ne semble pas vouloir être un simple Chromebook survitaminé. Google présente cette nouvelle famille comme une plateforme capable de réunir l'intelligence artificielle Gemini, les applications Android natives et une continuité renforcée avec les smartphones et les tablettes. Bref, Google veut construire un véritable écosystème autour de ses nouveaux laptops, un peu à la manière de ce que propose Apple entre ses Mac, ses iPhone et ses iPad. Plusieurs fonctionnalités sont mises en avant, notamment Cast my Apps, Magic Pointer et Rambler. Celles-ci pourront exploiter les informations présentes dans les courriels, les calendriers et les contenus affichés à l'écran afin de proposer une assistance proactive et personnalisée. Une intégration avancée avec les téléphones Android et différentes fonctions de sécurité sont également annoncées. […]
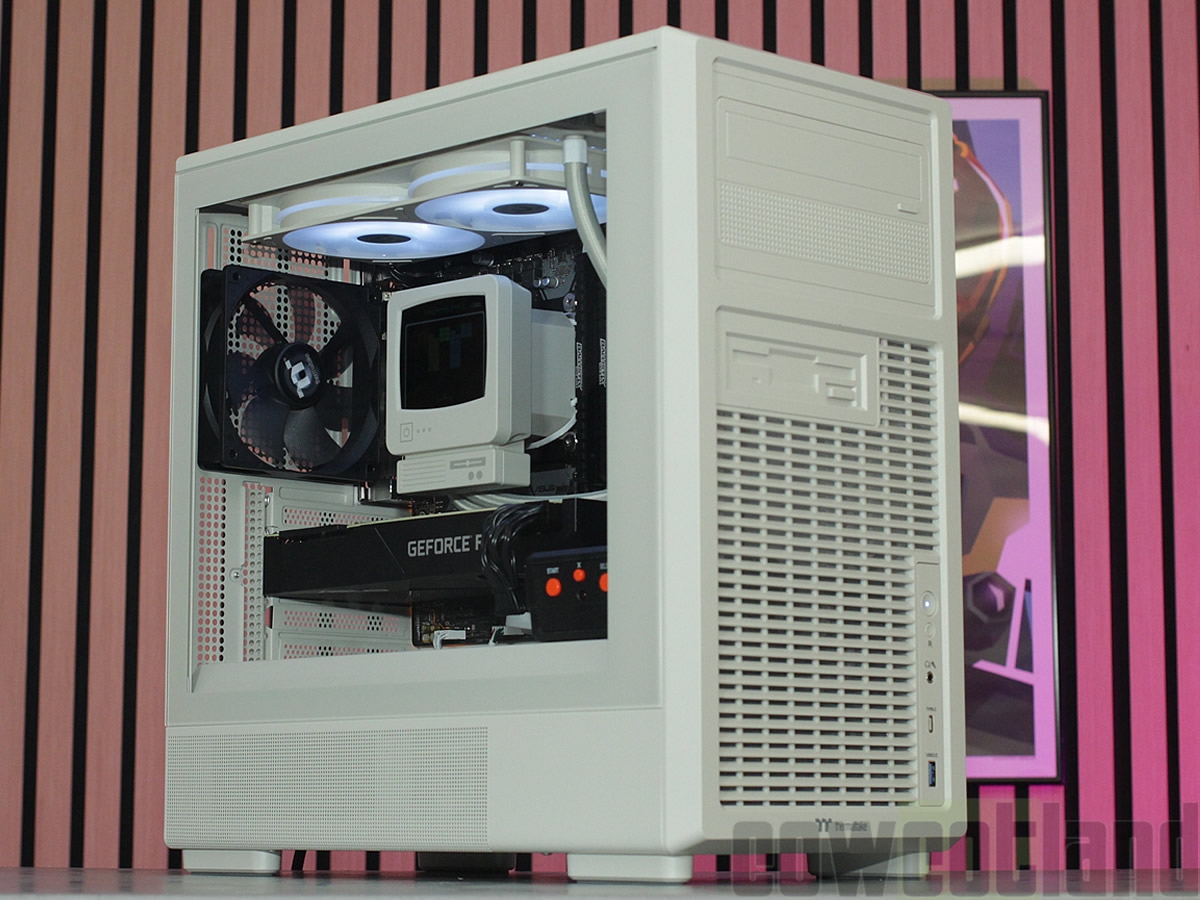
On entend très souvent, dans de nombreux domaines, que les choses étaient mieux avant. Si on peut sans trop se tromper que c'est le cas dans l'informatique avec les tarifs de la mémoire, et l'avant n'est pas si vieux que ça, d'autres domaines ont bien évolué et il serait difficile de revenir en arrière. Prenons le cas d'un boitier...
Avant
Il y a quelques années, l'alimentation prenait place dans le haut avec un petit support. L'installation restait simple, mais le rendu n'était pas terrible si on avait une fenêtre en plastique transparent sur le côté, d'autant plus que la gestion des câbles n'était pas souvent au top, voire même inexistante. Et que dire du stockage à l'avant ? Certes souvent chargé en panier, il vient encore ajouter des câbles et c'est là qu'on se dit que les disques M.2 sont quand même pratique. Mais alors, pourquoi vouloir sortir un boitier vintage ? Réponse avec le Retro 260 TG de Thermaltake. […]
Présentés en mai dernier, les PC portables Googlebook sont désormais disponibles en précommande. Il y a cinq modèles signés Acer, ASUS, Dell, HP et Lenovo... [Tout lire]
Google essuie une nouvelle amende en Europe. La Commission à la protection des données irlandaise inflige une sanction financière de 403 millions d’euros au géant du web pour infraction au RGPD. Le régulateur ordonne également à l’entreprise de se conformer au règlement européen sur la protection des données dans les six mois.
La Commission à la protection des données irlandaise (DPC) n’a pas peur des gros chiffres. En 2023, elle infligeait une amende record de 1,2 milliard d’euros à Meta pour infraction au RGPD. Rebelote aujourd’hui, cette fois contre Google qui écope donc d’une douloureuse de 403 millions.
La DPC remonte la piste de Google
En sa qualité d’autorité de contrôle pour Google (le siège européen du groupe est installé en Irlande), la DPC menait l’enquête depuis début 2020. Deux ans plus tôt, des plaintes avaient été déposées par huit organisations de défense des consommateurs regroupées au sein du BEUC (Bureau européen des unions de consommateurs).
La décision de la DPC était donc attendue depuis un bon moment. Elle porte sur le traitement des données de localisation dans trois fonctions spécifiques : l’activité sur le web et les applications (historique de navigation, recherches et certaines données de localisation), l’historique de localisation (enregistrement des lieux visités et déplacements de l’utilisateur) et la précision de la localisation (amélioration de la géolocalisation de l’appareil au-delà des seules données GPS). Le tout sur la période comprise entre la mise en œuvre du RGPD en mai 2018 et février 2020.
Google a enfreint le règlement européen sur ces trois points. En ce qui concerne l’activité sur le web et les apps, ainsi que sur l’historique de localisation, l’entreprise a traité les données de localisation sans fondement juridique valable, et d’une manière déloyale envers les utilisateurs. Google a aussi démontré son incapacité à prouver que les données personnelles recueillies par la fonctionnalité de précision de la localisation étaient traitées légalement, loyalement et en toute transparence.
La DPC a également conclu que le groupe n’a pas respecté ses obligations de transparence concernant les trois fonctions en question, et qu’il a enfreint les principes de conservation des données de localisation pour les fonctionnalités d’activité sur le web et les apps, ainsi que pour l’historique de localisation.
Une décision longue à venir
« Les données de localisation peuvent être extrêmement sensibles, car elles révèlent beaucoup de choses sur notre vie privée : l’école fréquentée par nos enfants, le nombre de visites d’une personne à l’hôpital, voire ses lieux de culte. Il s’agit d’une pratique extrêmement intrusive, qui porte atteinte au droit fondamental à la vie privée et enfreint le RGPD », rappelle Agustín Reyna, directeur général du BEUC.
Ce dernier se réjouit de la décision de la DPC, mais regrette « le temps nécessaire pour parvenir à cette conclusion » jugé « disproportionné au regard de la gravité de l’infraction ». Pour Agustín Reyna, « Une application tardive de la loi peut être aussi préjudiciable qu’une absence totale d’application. Les droits fondamentaux des consommateurs doivent être protégés plus rapidement et plus efficacement. »
Google a maintenant six mois pour se mettre en règle… même si cela semble déjà être le cas. L’entreprise a en effet rappelé à Bloomberg que le dossier porte sur d’anciennes règles de confidentialité mises à jour depuis. « Depuis 2019, nous avons considérablement fait évoluer nos pratiques et lancé des outils performants qui simplifient la gestion des données de localisation », ajoute-t-elle.
Dix organisations membres du BEUC, dont Que Choisir Ensemble (à l’époque, UFC-Que Choisir) ont déposé une seconde plainte contre Google en 2022. Elle porte sur la manière dont le groupe pousse les utilisateurs, lors de la création d’un compte, à accepter une collecte et une exploitation étendues de leurs données personnelles via des méthodes d’interfaces manipulatrices (dark patterns). La DPC a ouvert une enquête en 2023.

 Connexion


 Le 12 mai 2026, Google officialisait une nouvelle catégorie d'ordinateurs portables centrée autour de son IA Gemini : les Googlebooks. Embarquant le nouveau système d'exploitation de la firme, baptisé sobrement Googlebook OS, il a pour vocation de créer une véritable passerelle entre votre smartphon...

 La GDDR7 revient au centre des débats. Elle a porté les espoirs de ceux qui voulaient une RTX 50 avec plein de VRAM avec les modules de 3 Go, mais la firme est restée aux modules de 2 Go du fait de cette foutue pénurie qui a coupé l'herbe sous le pied de milliers de clients / geeks à travers le mond...


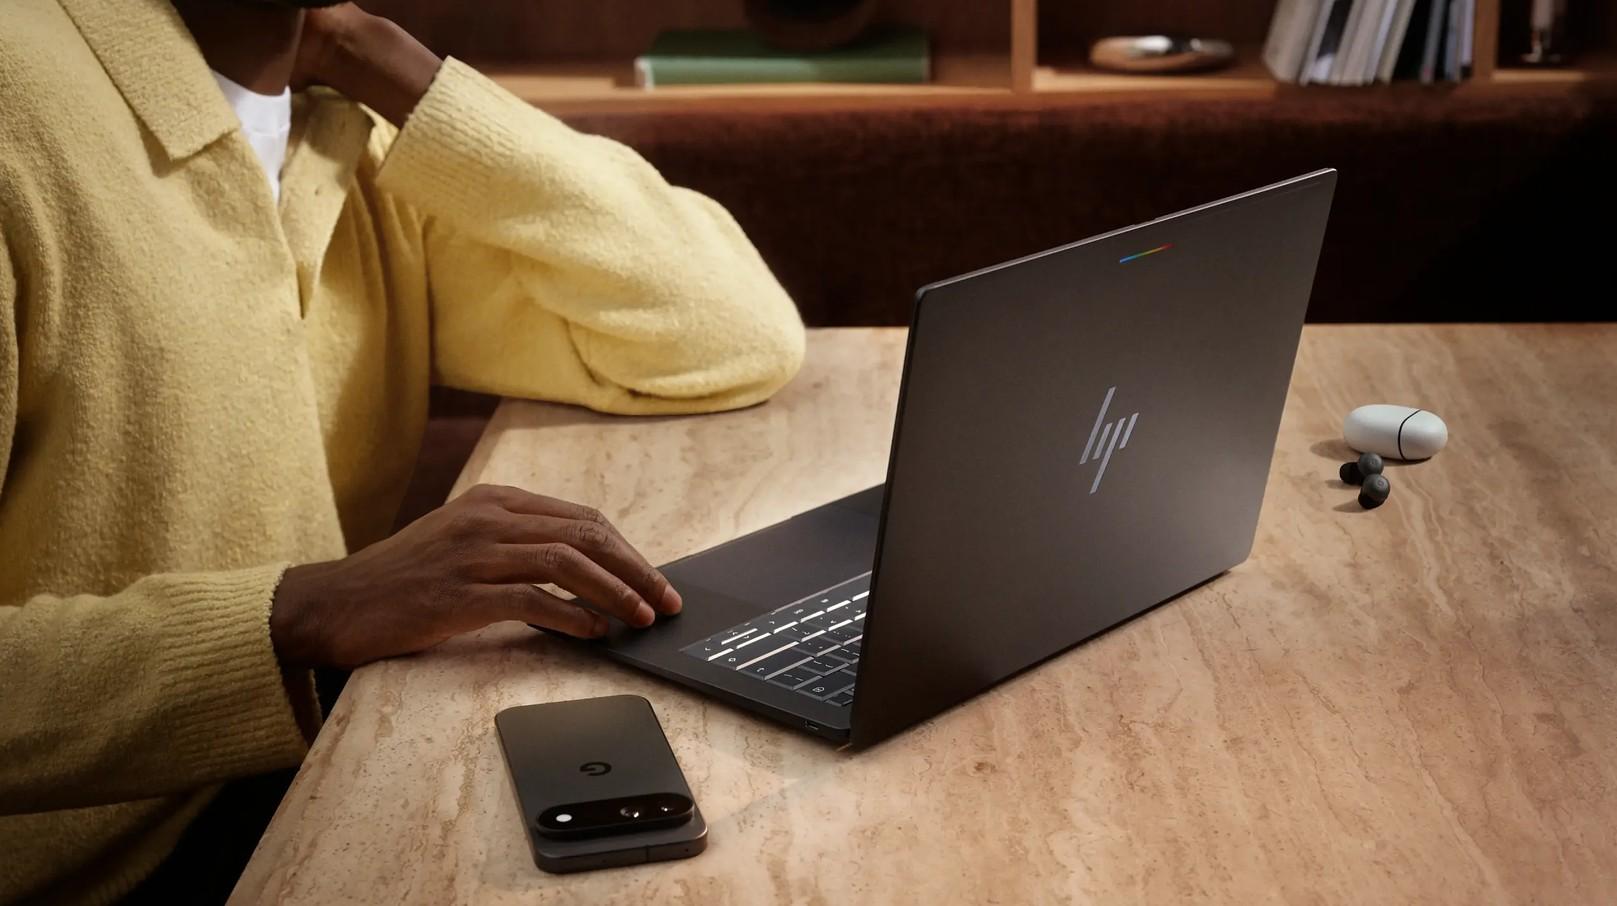 Présentés en mai dernier, les PC portables Googlebook sont désormais disponibles en précommande. Il y a cinq modèles signés Acer, ASUS, Dell, HP et Lenovo...