❌

Vue lecture

[màj] Les pirates de ShinyHunters affirment détenir les données de milliers d’employés du FBI

Le FBI piégé
[màj] Les pirates de ShinyHunters affirment détenir les données de milliers d’employés du FBI

Le FBI a été visé par une attaque de ShinyHunters. Le groupe de pirates serait en possession de données concernant des milliers d’employés de l’Agence fédérale. Parmi les informations volées : noms, adresses, numéros de téléphone et des données sur la famille des employés.

Pour prouver leur intrusion, les pirates ont détourné le site de recrutement du FBI. Pendant quelques minutes, on pouvait y lire que « le site a été saisi par ShinyHunters » et que « toutes les données du FBI ont été compromises, notamment des données personnelles et médicales sensibles concernant les employés actuels et anciens du FBI ».

Le groupe déclare aussi posséder « bien plus de données que ce que nous affirmons ici ». Avant de terminer par une formule typique de Donald Trump : « Merci de l’attention que vous porterez à cette affaire. »
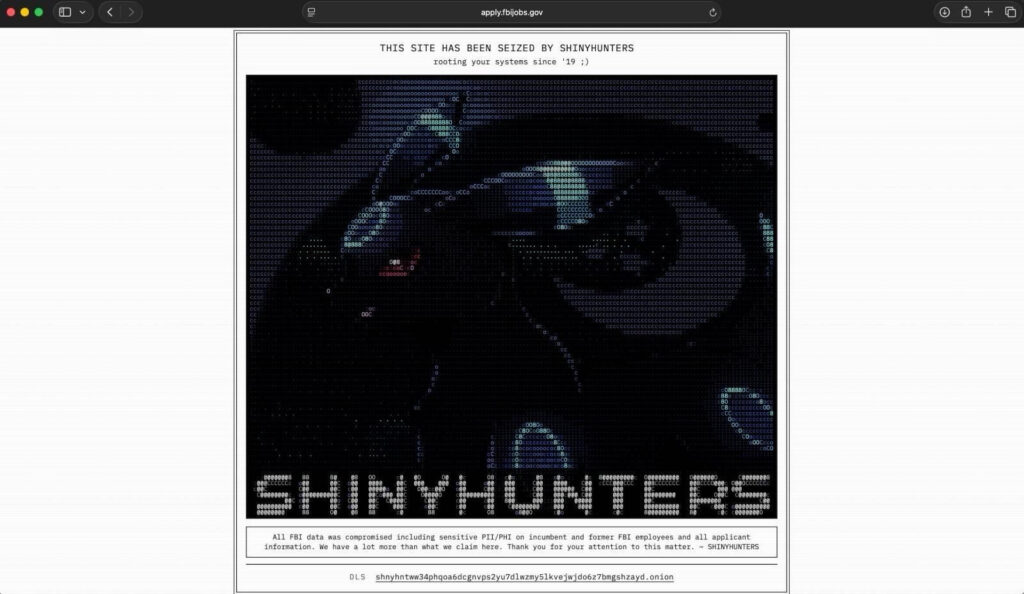
Le site de recrutement piraté du FBI. Capture d’écran : vxdb

Le même site a rapidement affiché un message d’erreur prévenant que le portail de candidature est actuellement indisponible, toujours en ligne à l’heure où nous publions. Le site principal fbi.gov a lui aussi été placé en indisponibilité, d’après nos constatations.

Un échantillon des données fourni au site 404media semble bien confirmer la nature et l’ampleur du vol de données. Selon nos confrères, ShinyHunters a exploité une faille zero-day dans PeopleSoft, un logiciel Oracle, pour obtenir un accès aux serveurs AWS GovCloud et siphonner les données. Il y en aurait pour 2 à 3 To.

Le FBI sommé de retirer ses accusations

ShinyHunters est bien connu des services, en France comme à l’étranger. On leur doit de nombreux vols de données qu’ils tentent ensuite de rançonner. Pour le FBI, les choses sont un peu différentes. Un « avis public » placardé sur le site du groupe accuse l’agence fédérale d’avoir porté des accusations mensongères envers l’organisation dans un bulletin publié au deuxième trimestre.
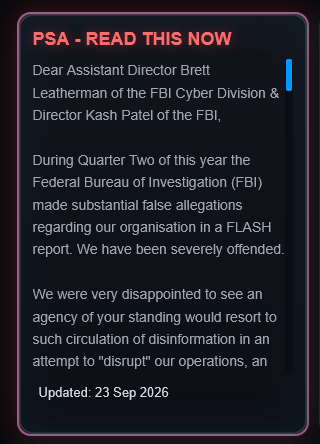
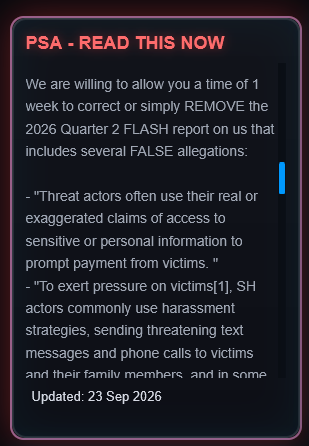
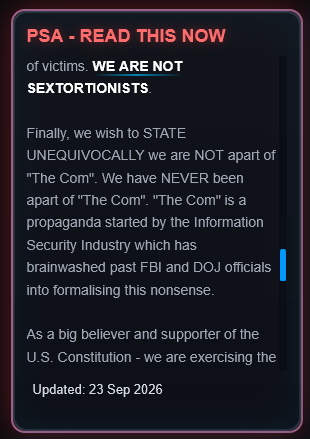
Shinyhunters a publié un message adressé au FBI sur son site onion – capture d’écran Next

Au lieu d’argent, les pirates exigent la modification ou le retrait du bulletin en question dans la semaine, au risque de la divulgation des données subtilisées. Ils réfutent notamment les allégations du FBI selon lesquels ShinyHunter met en œuvre des méthodes relevant du harcèlement ou de menaces personnelles adressées à leurs victimes.

Ils nient par ailleurs tout lien avec « The Com », un réseau criminel international décentralisé de pirates opérant aux États-Unis, au Canada et au Royaume-Uni. Ciblé par des enquêtes du FBI et d’Europol, ce réseau rassemble des sous-groupes impliqués dans la cybercriminalité, mais aussi dans l’exploitation sexuelle des enfants.

Dans le message de ShinyHunters, The Com est qualifié d’« élément de propagande inventé par le secteur de la sécurité informatique ayant endoctriné d’anciens responsables du FBI et du ministère de la Justice au point de les amener à donner une existence officielle à cette absurdité ». Le bulletin ne fait pas référence à The Com, en revanche il explique que les acteurs malveillants comme ShinyHunters peuvent prétendre à tort posséder des documents compromettantes sur leurs victimes, comme des photographies ou des vidéos embarrassantes de leurs victime.

Ils peuvent aussi recourir à des stratégies de harcèlement, comme l’envoi de SMS menaçants ou des appels téléphoniques aux victimes et aux membres de leur famille. ShinyHunters affirme « sans équivoque » n’avoir jamais menacé les familles ou détenu des informations compromettantes de leurs victimes. « NOUS NE PRATIQUONS PAS LA SEXTORSION », écrivent-ils en majuscules.

L’avis, qui n’est pas « motivé par des considérations financières », est présenté comme le moyen pour ShinyHunters de faire valoir leur droit à la libre expression tel qu’inscrit dans le Premier amendement de la Constitution américain. « [Nous] luttons contre la désinformation ». Pour l’instant, le FBI n’a pas encore réagi publiquement.

Mise à jour 23/09 – Le FBI a officiellement réagi à la fuite de données de ses serveurs. « L’origine de la faille [n’a] pas encore été déterminée », explique l’agence qui ne peut pas encore dire si elle provient « d’un tiers ou de l’environnement informatique du FBI ». L’enquête est en cours, et le FBI travaille avec ses prestataires pour atténuer tous les risques possibles.
  •  

☕️ Aux États-Unis, le secrétaire au Trésor tient OpenAI pour responsable de ses agents


Depuis l’incident impliquant Hugging Face, OpenAI marche sur une corde raide. L’entreprise est lancée dans un délicat jeu d’équilibrisme, entre pression sur la publication de données techniques et la nécessité financière de ne pas perdre la confiance du public. OpenAI prépare également son entrée en bourse et a besoin que sa valeur reste au beau fixe. Le 15 septembre, le Financial Times, cité par Bloomberg, évoquait ainsi un prochain tour de table qui valoriserait OpenAI à plus de 1 200 milliards de dollars. Interrogé sur le sujet, Sam Altman avait répondu que l’opération n’aurait pas lieu avant 2027.

La machine commence cependant à se gripper. Le narratif bâti sur le marketing de la peur et la foi inébranlable sur l’avenir de l’IA et des agents se fissure face à une pluie de critiques. Beaucoup remettent en question la volonté affichée de ralentir le développement des modèles de frontière pour se concentrer sur l’élaboration d’un cadre réglementaire. La Maison-Blanche n’a pas caché son hostilité à cette idée notamment.

Illustration : Flock

Le 21 septembre, le secrétaire au Trésor américain Scott Bessent est même allé plus loin au micro de CNBC : l’incident Hugging Face revient selon lui à « la responsabilité de la direction d’OpenAI, pas d’un tas d’agents ». Il a indiqué partager l’analyse de Daniel Huttenlocher, co-directeur d’un laboratoire de recherche du MIT, pour qui les humains sont responsables, et non l’IA. Ces entreprises « doivent assumer leurs responsabilités », a ajouté Scott Bessent.

Cette déclaration n’est pas isolée. Elle prolonge la position que Bessent avait défendue le 15 septembre devant la commission des services financiers de la Chambre des représentants, souligne CNBC. Le secrétaire au Trésor s’y était opposé à toute exemption de responsabilité légale pour les entreprises d’IA, estimant qu’elle servirait davantage leurs intérêts commerciaux que la sécurité du public.

La prise de position est loin d’être anodine, car elle qualifie l’incident de défaillance de gouvernance humaine, plutôt que d’illustration de la puissance intrinsèque de leurs agents et de leurs comportements imprévisibles. Le 2 septembre, nous relevions d’ailleurs les mêmes éléments, en soulignant que le rapport complet d’OpenAI montrait effectivement une succession de défaillances humaines.

À noter qu’au cours de la même interview, le secrétaire au Trésor a indiqué la possible mise en place d’un téléphone rouge avec Pékin sur les questions, et la possible nomination d’un nouveau « tsar de l’IA » pour gérer ce type de dossier.

  •  

Racheté 35 300 €, Lycos.fr revient : « On n’avait pas prévu que ça aille aussi vite »


Racheté 35 300 €, Lycos.fr revient : « On n’avait pas prévu que ça aille aussi vite »

Lycos.fr reprend du service. Racheté aux enchères pour 35 300 euros, le vénérable nom de domaine accueille un nouveau projet de portail porté par l’acquéreur. Il ambitionne d’y proposer page personnelle, moteur de recherche et agrégateur de médias, sans lien avec la société historique du même nom.

Comme souvent dans ce genre de cas, les enchères se sont jouées dans la dernière ligne droite : proposé à la vente sur le site spécialisé WebExpire, le nom de domaine lycos.fr a trouvé preneur lundi 21 septembre pour 35 300 euros.

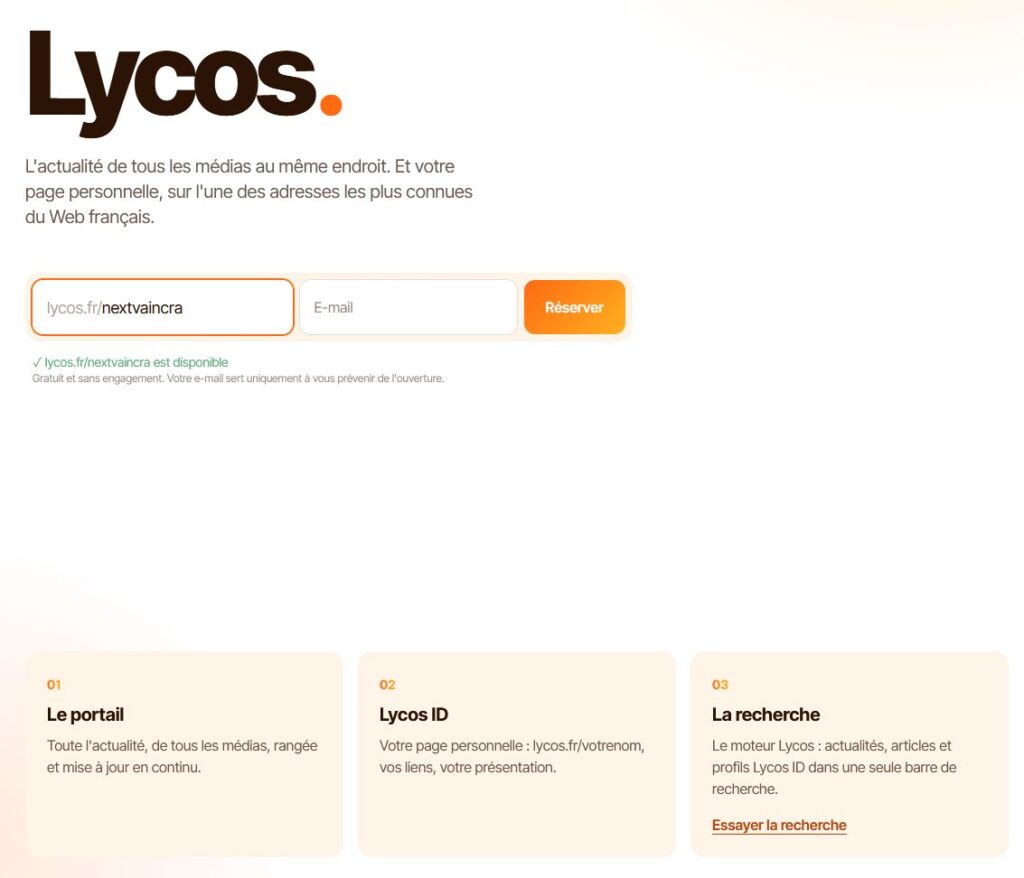
Cette fois, hors de question de laisser le nom de domaine dormir en mode parking. Quelques heures plus tard, une nouvelle page d’accueil s’affiche aux yeux des internautes curieux. Elle propose de réserver une adresse en lycos.fr/votrenom en échange d’une adresse email pour obtenir, au lancement, « votre page personnelle sur l’une des adresses les plus connues du Web français ».

À ce service, baptisé Lycos ID, le nouvel acquéreur promet d’ajouter un agrégateur de médias, avec une actualité « rangée et mise à jour en continu », ainsi qu’un moteur réunissant « actualités, articles et profils Lycos ID dans une seule barre de recherche ».

La page d’accueil du site Lycos.fr au mardi 22 septembre – capture d’écran Next

Le retour d’une vedette d’antan

L’ambition dessinée ici rappellera certainement des souvenirs à ceux qui, parmi les lecteurs de Next, surfaient déjà en ligne au tournant du nouveau millénaire. Lycos.fr, édité par la société Lycos Europe gmbh, est en effet l’un des plus célèbres représentants de la génération des grands portails Web qui mêlaient messagerie, pages perso et surtout recherche en ligne entre la fin des années 90 et le début des années 2000.

Né en 1994 sous la forme d’un projet de recherche et installé en tant que société commerciale un an plus tard, Lycos a d’abord connu une ascension fulgurante et un développement mondial (en 2000, Lycos vantait son célèbre slogan « va chercher » à la télévision française), avant de lentement péricliter, balloté entre une succession d’actionnaires.

Le portail, identifiable à son logo en forme de retriever noir, a officiellement disparu du Web européen le 15 février 2009, même si le moteur de recherche américain est longtemps resté accessible par le biais des différentes extensions nationales du nom de domaine lycos, dont le .fr.

Un départ sur les chapeaux de roue

Jusqu’à ce que ce dernier soit finalement libéré, proposé aux enchères, et donc racheté, avec mise en place de cette page d’inscription en forme d’apéritif pour un lancement à venir. La conclusion des enchères a toutefois suscité plusieurs commentaires publics, sur les réseaux sociaux, de spécialistes des noms de domaine et du référencement, contribuant à braquer les projecteurs sur le nouveau lycos.fr.

« On a récupéré le domaine hier, on n’a encore rien annoncé, et il y a déjà des milliers d’inscriptions. On n’avait pas prévu que ça aille aussi vite, ce sont les gens qui ont décidé pour nous, et ça confirme que ce nom réveille quelque chose de bien réel », confie à Next Benjamin Romei, fondateur d’ADN Contents, la société qui a remporté les enchères (par ailleurs éditrice de médias thématiques). Qui entend bien donner une seconde vie à cette vénérable adresse : « L’idée tient en une phrase : refaire de Lycos une porte d’entrée simple du web français ».

D’où cette triple ambition affichée, avec un moteur de recherche constitué sur un index en propre et un agrégateur de médias attendu dans les prochains jours, tous deux en bêta, et le futur service de page personnelle pour lequel les plus impatients ont déjà réservé une adresse à leur nom (vanity URL). « Lycos ID est une carte de visite en ligne, à une adresse que tout le monde connaît », résume Benjamin Romei.

À défaut d’avoir Next.fr, nous aussi on veut notre vanity URL – capture d’écran Next

L’entrepreneur indique envisager un modèle économique hybride, basé pour partie sur la publicité, et sur des options premium associées aux pages personnelles. Il précise ne pas vouloir se limiter aux nostalgiques. « Le premier cercle, c’est ceux qui ont grandi avec Lycos, Caramail et Multimania. Pour eux, ce nom réveille quelque chose. Mais on espère bien toucher d’autres générations : on ne veut pas faire un musée ».

L’épée de Damoclès du recours d’un ayant-droit

Reste une inconnue de taille. L’entrepreneur ne prend-il pas un risque à racheter et à exploiter un nom de domaine associé à une marque à la notoriété certes ternie, mais historiquement bien établie ?

Outre l’éventualité d’une action en contrefaçon, le fait que le domaine concerné soit en .fr signifie que le nouveau propriétaire s’expose à la possibilité d’une réclamation extra judiciaire formulée directement auprès de l’Afnic, l’office d’enregistrement des extensions nationales, notamment via la procédure Syreli.

Encore faut-il qu’il subsiste un ayant droit. À l’échelle française, une recherche dans les bases de données de l’INPI confirme que les différents enregistrements de marque liés à des activités numériques (édition de site, publicité en ligne) sont expirés de longue date. D’après les données disponibles auprès du bureau américain des brevets (USPTO), la marque Lycos en tant qu’activité Web semble également avoir été abandonnée depuis 2020. Le site lycos.com a par ailleurs pris des airs de coquille vide, avec un index de recherche limité à la portion congrue, et des mentions légales qui ne mentionnent plus grand chose.

Le nouvel acquéreur n’ignore pas la question, mais se dit confiant : « On a fait ce travail sérieusement, en amont, avant même de se lancer. La situation de ce nom n’est pas la même selon les territoires, et notre projet est français : pensé ici, pour le public d’ici, sur un .fr laissé à l’abandon depuis des années. On est accompagnés sur le juridique, on suit la situation de près et des démarches sont en cours. »

À ce stade, la page lycos.fr ne pousse toutefois pas la filiation jusqu’à reprendre la silhouette du célèbre retriever.

  •  

Nouvelle saignée chez Xbox, Halo et Rare passent sous la coupe d’Activision

Le patrimoine Xbox en pièces
Nouvelle saignée chez Xbox, Halo et Rare passent sous la coupe d’Activision

Nouvelle purge chez Xbox. Après une première charrette de licenciements début juillet, l’activité jeux vidéo de Microsoft poursuit sa réorganisation ou plutôt son « reset ». La potion est amère pour plusieurs studios, dont certains risquent de mettre la clé sous la porte.

En juillet, Xbox s’amputait de cinq studios et annonçait la suppression de 3 200 postes, la moitié immédiatement, le reste durant le courant de l’exercice fiscal en cours (fin juin 2027). Une nouvelle coupe claire a été annoncée ce mardi 22 septembre : 268 licenciements répartis entre les studios Halo, d’autres studios internes chez Xbox, ainsi que dans les équipes de direction et les services centraux.

Matt Booty, le chef des contenus Xbox et bras droit de la directrice générale Asha Sharma, explique que ce nouveau serrage de vis permet au groupe de « réaliser environ les trois quarts de la restructuration ». En plus de ces suppressions de postes, il annonce aussi une réorganisation des studios. Le changement le plus important concerne la franchise Halo, véritable symbole de Xbox : le prochain jeu sera développé directement par Activision, séparément du travail réalisé par le studio pour Call of Duty.

Le prochain Halo sera réalisé par Activision

Les studios Halo (anciennement 343 Industries) n’ont pas su concrétiser les espoirs de renouvellement de la licence créée à l’origine par Bungie. Leur avenir s’écrit désormais en pointillés : Microsoft va les cantonner à un rôle de support pour la communauté de joueurs et la gestion du dernier volet en date, Halo Infinite, sorti en 2021. Activision reprend également World’s Edge, le studio qui développe Age of Empires.

Le poids lourd Bethesda va absorber le studio Obsidian, pour qui il va développer un projet de nouveau Fallout et continuer à alimenter Grounded en contenus frais. Les studios Playground et Turn 10 vont fusionner, ce qui pour le coup a une certaine logique : le premier développe le jeu de course arcade Forza Horizon, le second la simulation réaliste Forza Motorsport. Ils travailleront ensemble sur la franchise Forza ainsi que sur Fable, dont un nouvel épisode sort en février prochain. Sur le versant mobile, King (Candy Crush) absorbe Microsoft Casual Games qui développe et exploite le fameux jeu Solitaire.

Enfin, le dernier changement est certes symbolique, mais il risque de faire saigner les cœurs des nombreux joueurs : Rare va rejoindre Activision. Le studio anglais fondé en 1985 est une institution du jeu vidéo, avec des titres comme Banjo-Kazooie, Donkey Kong Country, GoldenEye 007, Perfect Dark, Killer Instinct… Racheté en 2002 par Microsoft, il continue d’exploiter Sea of Thieves, récemment porté sur PS5. Sous la férule d’Activision, il est difficile d’être optimiste pour l’avenir de Rare.

La restructuration ne s’arrête pas là. Le studio anglais Ninja Theory pourrait fermer ses portes après deux tentatives ratées de revente. Chez Arkane, la consultation avec les salariés dans le cadre d’un PSE se poursuit jusqu’à la fin de l’année pour déterminer le futur du studio français.

La direction de Xbox entend regrouper ses investissements dans les grosses franchises connues, à l’instar d’Elder Scrolls, Halo ou encore Fallout. C’est ce qui explique aussi la reprise du projet Physint d’Hideo Kojima, abandonné par PlayStation il y a quelques jours. Le prochain jeu d’espionnage du créateur de Metal Gear Solid va coûter très cher, ce qui peut paraitre complètement paradoxal pour une entreprise qui taille dans le vif. Mais c’est une question d’image de marque, alors que les mauvaises nouvelles ne cessent de s’empiler.

  •  

Vie privée : le cas LG braque à nouveau les projecteurs sur les TV connectées

On remet une pièce
Vie privée : le cas LG braque à nouveau les projecteurs sur les TV connectées

Le problème des TV connectées s’étend au-delà des téléviseurs LG pointés ces dernières semaines. Si le constructeur coréen a essuyé l’essentiel des critiques, plusieurs observateurs rappellent que la problématique est en place depuis longtemps.

Tout est parti d’une série de vidéos de la chaîne Gamers Nexus. Elle y expose ses découvertes sur plusieurs téléviseurs TV OLED de la marque LG. Dans les grandes lignes : les modèles testés sont bavards, possèdent des réglages de vie privée inutilement complexes et possèdent des failles de sécurité importantes. Ces dernières, quand elles sont exploitées, permettent de modifier jusqu’aux mots d’activation pour la reconnaissance, permettant l’écoute dans la pièce.

LG a réagi il y a peu via un communiqué, accusant essentiellement ces vidéos de mentir et de vouloir répandre la peur. Gamers Nexus a répondu à son tour, détricotant les arguments de l’entreprise, jusqu’à faire intervenir un avocat dans la vidéo. Selon ce dernier, les mots ont été soigneusement choisis par LG dans son communiqué, notamment sur la collecte de données alimentant l’ACR (reconnaissance automatique de contenu), mécanisme permettant de faire remonter les habitudes de visionnage par télémétrie.

L’ACR a concentré l’essentiel des critiques, jusqu’à faire remonter des constatations vieilles de plusieurs années, dont la capture active des signaux sur la liaison HDMI. Ainsi, l’ACR intervient également quand le téléviseur est utilisé comme simple écran, mais les informations ne peuvent pas être émises si l’appareil n’est pas connecté à internet.

Un vieux problème

Dans notre dernier article sur le sujet, nous relevions que LG était possiblement dans une position inconfortable. Il est en effet difficile d’éteindre l’incendie autour des questions de vie privée sans évoquer l’ACR, et ce mécanisme ne peut pas être abordé sans jeter tout le reste de l’industrie sous le bus. Dans ce domaine, LG est un constructeur parmi d’autres, même s’il jouit d’une présence importante, grâce à la renommée de ses dalles. Gamers Nexus évoque ainsi un parc de 216 millions de téléviseurs connectés dans le monde.

Chez The Verge, John Higgins est spécialisé dans les tests de TV et de matériel audio. Pour notre confrère, la situation est claire : « Ce n’est pas seulement LG. Toutes les chaînes de télévision vous espionnent ». L’une des clés selon lui pour comprendre le problème est la concurrence féroce que se livrent les constructeurs. Elle a entrainé une chute constante des prix des TV, « au point que certaines entreprises les vendent à perte », affirme John Higgins.

Il rappelle que les techniques d’ACR sont en place depuis longtemps, ces empreintes étant d’ailleurs utilisées pour d’autres buts que la publicité, par exemple les études d’audience par des entreprises comme Nielsen. Ces mécaniques sont omniprésentes dès que l’on parle d’un téléviseur connecté. Il indique d’ailleurs procéder toujours de la même manière pour ses tests : une adresse Gmail jetable, la désactivation de tout ce qui peut l’être pour la publicité, l’acceptation des conditions pour la reconnaissance que lorsqu’il veut tester la fonction, etc.

Dans une utilisation quotidienne, il recommande globalement la même approche, voire davantage : « Pour aller plus loin, coupez le Wi-Fi, débranchez le câble Ethernet de la télévision et utilisez-le essentiellement comme une télévision simple ». Il recommande alors de passer par un appareil de streaming dédié. Dans son cas, une Apple TV 4K : « Non pas parce que je pense qu’Apple ne récolte pas de données, mais parce qu’elle n’utilise pas ACR et que je fais plus confiance à ses protocoles de sécurité qu’à n’importe quel fabricant de téléviseurs ou Google ».

Un petit avertissement contre Gamers Nexus

Pour John Higgins, « il n’y a vraiment aucun moyen de se protéger complètement contre la collecte de données de votre télévision, de votre appareil de streaming ou des services de streaming ». Il estime qu’il y a tout simplement trop d’argent « gagné au détriment des consommateurs », le changement ne pouvant venir que des gouvernements.

Interrogé par le journaliste, Thorin Klosowski, de l’Electronic Frontier Foundation (EFF), abonde : « Nous avons besoin d’une loi fédérale complète sur la vie privée qui couvre ce type de collecte et d’utilisation abusive de données. Plus précisément, un appareil nécessitant un consentement volontaire, sans astuces de conception trompeuses pour obtenir ce consentement, et une exigence de minimisation des données, ce qui limiterait les entreprises à n’utiliser les données que pour ce qui est nécessaire à la fourniture du service ». En Europe, ces questions sont régies par le RGPD.

Si John Higgins regrette que les consommateurs doivent se « protéger activement des entreprises » vendant les produits, il regrette aussi le ton employé parfois par Gamers Nexus. Il note par exemple que les reproches les plus graves faits à LG sont basés sur l’exploitation d’une faille permettant l’obtention d’un accès root.

Le constructeur peut être critiqué sur ces problèmes de sécurité, selon lui, mais pas sur les usages faits de ces failles, puisqu’un accès root permet de réaliser pratiquement n’importe quelle opération. En Europe, ces questions sont justement à la source du Cyber Resilience Act, qui entrera pleinement en vigueur en décembre 2027. En outre, s’il ne remet pas en cause les découvertes « accablantes » réalisées par la chaîne, John Higgins regrette l’emploi d’expressions comme « ça pourrait » ou « nous pensons ».

Reste que les vidéos de la chaîne et la couverture médiatique au sens large auront remis au goût du jour le sujet. « À moins de se déconnecter complètement et de vivre dans une cabane en forêt avec une simple télévision et une collection de blu-rays, le mieux que nous puissions faire est de limiter autant d’informations partagées que possible », conclut The Verge.

Ce 19 septembre, Flock avait justement un mot à dire sur le sujet.

  •  

☕️ Paramount obtient finalement le feu vert pour avaler Warner


Paramount Skydance vient de lever un gros obstacle sur le long chemin vers l’acquisition de Warner Bros. Discovery. Le groupe de David Ellison a trouvé un accord avec la Californie et plusieurs autres États qui tentaient de bloquer l’opération en justice. Le dirigeant, fils de Larry Ellison le cofondateur d’Oracle, a annoncé à ses troupes que la transaction devrait être finalisée dans les deux semaines.

Au terme d’une négociation de plusieurs jours, le groupe Paramount a arraché un accord avec le procureur général de Californie, qui agissait en son nom et celui des procureurs généraux de onze autres États, ainsi qu’avec la Writers Guild of America. « Nous avons obtenu toutes les autorisations nécessaires à cette fusion et pouvons désormais avancer vers sa finalisation », se réjouit-il en annonçant que les studios resteront à Hollywood – il avait en effet menacé de quitter la Californie.

Le château d’eau de Warner Bros, par Silas Lundquist, Licence Unsplash

Le projet d’accord judiciaire entre les deux entreprises et les procureurs, que la juge Araceli Martínez-Olguín doit encore valider, contient un certain nombre d’engagements de la part de Paramount qui s’appliqueront pendant cinq ans (PDF). La nouvelle entité devra sortir en salles au moins 30 films par an, avec une fenêtre d’exclusivité de 45 jours minimum. Si le nombre minimal de sorties n’est pas atteint, le groupe pourrait être obligé de céder Miramax et verser 30 millions de dollars pour chaque film manquant à l’appel.

Ce volume sera difficile à tenir, mais pas impossible : les deux studios prévoient en effet une quinzaine de films de cinéma chacun cette année, contre 19 en 2025.

Un conseil éditorial pas si indépendant

En ce qui concerne l’indépendance de CBS News et de CNN, Paramount créera un conseil de surveillance éditoriale composé de cinq journalistes qui seront nommés par… le conseil d’administration du groupe. En termes d’indépendance, on a probablement fait mieux. Ce conseil pourra définir de grands principes éditoriaux, arbitrer les différends entre journalistes et direction, examiner les questions de biais éditoriaux, et surveiller l’indépendance des rédactions vis-à-vis de la direction, des propriétaires et des actionnaires.

Les premiers pas de ce conseil seront très intéressants à suivre : les Ellison sont des proches de Trump, qui vient d’interdire à CNN l’accès à la salle de presse de la Maison-Blanche au mépris de liberté d’expression inscrite au Premier amendement de la Constitution du pays.

Quoi qu’il en soit, ce conseil de surveillance est une des raisons qui ont convaincu les États américains de mettre fin à leur offensive judiciaire. Sans accord, un procès aurait dû avoir lieu en mars prochain. Cette résolution à l’amiable est une bonne nouvelle pour les finances de Paramount, qui s’était engagé à verser des pénalités de 7 millions de dollars par jour à compter du 1er octobre si l’opération à 110 milliards de dollars (!) traînait en longueur.

La fusion va déboucher sur la création d’un des principaux studios de production audiovisuel au monde. Il contrôlera en effet Paramount et Warner, ainsi que Skydance, Miramax, Nickelodeon, New Line, les studios DC (et bien d’autres actifs), sans oublier l’activité jeux vidéo qui fait partie de la dot sans être une priorité du groupe.

  •  

SpaceXAI lance son modèle Grok 4.7, dont les performances déçoivent

Overhyped
SpaceXAI lance son modèle Grok 4.7, dont les performances déçoivent

SpaceXAI a lancé son nouveau modèle Grok 4.7 ce 21 septembre. Si Elon Musk vantait l’arrivée de cette version, les résultats indépendants ne semblent pas à la hauteur des attentes. En revanche, le LLM garde pour lui l’avantage d’une tarification plus douce que certains des gros modèles lancés ces derniers mois.

Mise à jour du 23 septembre : Dans la version originale de l’article, nous avons mentionné les prix sans évoquer la consommation de tokens à l’usage. Nous avons modifié cette partie, Grok 4.7 se révélant nettement plus verbeux que son prédécesseur, avec des conséquences sur la facture.

Article original du 22 septembre :

La version 4.7 de Grok repose sur un nouveau modèle de base, plus grand que pour Grok 4.6. Dans son annonce, SpaceXAI indique qu’il a été entraîné par renforcement plus longtemps, sur des tâches plus difficiles, avec un accent sur les problèmes qui demandent plusieurs heures de travail. L’entreprise affirme que le modèle vérifie mieux son propre travail et gère mieux les contextes longs. Le modèle a aussi été entraîné pour fonctionner nativement dans l’environnement Grok Bot.

Dans la documentation fournie, on peut lire que le modèle grok-4.7 dispose d’une fenêtre de 500 000 jetons (tokens), ses connaissances s’arrêtant en mai 2026. Sans surprise, le LLM est multimodal (texte et images en entrée) et produit du texte en sortie. On retrouve en outre les quatre mêmes niveaux de raisonnement : bas, moyen, haut (par défaut) ou très haut (xhigh). Appel de fonctions, recherche web ou sur X, ou encore exécution de code sont autant de possibilités mises en avant par SpaceXAI.

La société d’Elon Musk met en avant de nombreuses qualités en phase avec les discussions actuelles autour de la sécurité. Elle évoque par exemple « de solides capacités de défense cyber » tout en gardant « de faibles taux de refus d’utilisation légitime ». Grok 4.7 aurait obtenu le score le plus élevé sur HackberBench 0.3 et n’aurait autorisé que 3,3 % des prompts risqués. En outre, le nouveau LLM se montrerait plus robuste face aux tentatives de jailbreak.

Des performances en deçà des attentes

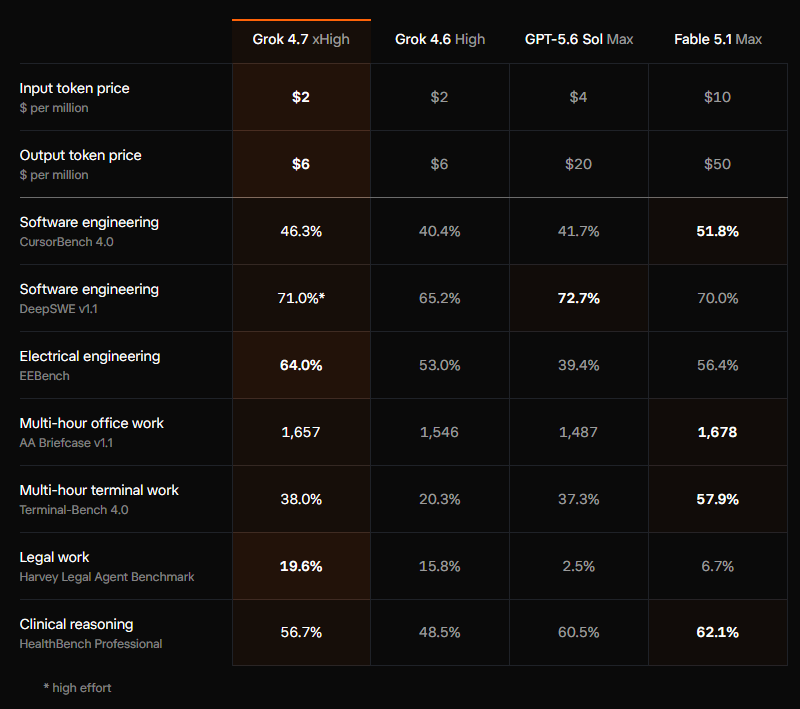
Sur le chapitre des performances, la situation est plus complexe. Selon les chiffres avancés par l’entreprise, Grok 4.7 se débrouille bien sûr très bien. Cependant, on remarque vite que le tableau donné par SpaceXAI ne compare pas toujours les mêmes éléments. Par exemple, Grok 4.7 est testé en mode de raisonnement xHigh alors que Grok 4.6 est testé en High.

Source : SpaceXAI

Cela n’empêche pas l’entreprise de revendiquer de très bonnes performances, surtout face à son modèle précédent et dans des domaines particuliers. « Grok 4.7 est meilleur pour créer des documents et des présentations. Dans GDPval et AA Briefcase, l’IA est sollicitée pour travailler sur des tâches réalisées par des professionnels tels que des avocats, des infirmiers et des analystes financiers. Grok 4.7 améliore Grok 4.6 sur les deux benchmarks et se comporte de manière comparable à d’autres modèles Frontier », affirme ainsi SpaceXAI.

Sur X, on trouve déjà de nombreux commentaires et tests réalisés, plus ou moins spécifiques. Côté positif, on note par exemple le tweet d’Auggie qui relève un taux de 100 % sur son test de « détection d’erreurs » sur la musique, un score que seul avait atteint Astra. Le même testeur a en revanche été moins enthousiasmé sur Bach Benchmark (qui demande aux LLM de composer des chorals à quatre voix dans le style de Bach). Si l’on en croit Artificial Analysis, les revendications de SpaceXAI sur la création de documents sont avérées, avec en particulier un bond significatif sur le test Analytical Quality Elo.

Toutefois, les retours négatifs sont plus nombreux. Pour Jose Antonio Lanz par exemple, Grok 4.7 n’a rien d’un mauvais modèle, mais il est derrière la concurrence, particulièrement Astra ou même Sonnet 5 selon les essais réalisés. Il souligne d’ailleurs qu’Elon Musk avait lui-même cherché à diminuer les attentes autour de son modèle, en indiquant dans un tweet le 14 septembre que Grok 4.7 serait davantage à comparer à Opus 5 que 5.1. Il en profite pour annoncer que Grok 4.8 sera une « amélioration notable », que Grok 4.9 sera « probablement » au niveau d’Astra et Fable et que Grok 5 sera « peut-être meilleur que tout le reste ». Plusieurs personnes ont alors fait remarquer qu’OpenAI et Anthropic allaient eux aussi lancer de nouveaux modèles pendant ces laps de temps.

Selon The Decoder, Grok 4.7 obtient 46 à l’indice Artificial Analysis (v4.3.2), qui agrège dix tests. Il se place ainsi en milieu de peloton, derrière Claude Fable 5.1 et GPT-6, à 53 chacun. Sur Terminal-Bench 4.0, l’évaluation donne 26 %, bien en dessous des 38 % annoncés par xAI, et très loin des 60 % atteints par Astra et des 55 % de Fable 5.1.

Tarifs identiques, mais plus gourmand en tokens

Si les performances semblent globalement décevantes, Grok 4.7 se débrouille mieux que son prédécesseur dans la quasi-totalité des scénarios, sans toucher aux prix. On reste donc sur 2 dollars par million de jetons en entrée et 6 dollars par million en sortie. Une variante Fast est disponible, servie par une infrastructure plus rapide, avec une facturation doublée. Elle n’est cependant disponible que via Cursor et Grok Build, pas sur l’API publique. Sur cette dernière, tous les cas d’usage passant par Grok 4.6 ont automatiquement basculé sur le nouveau modèle.

SpaceXAI joue d’ailleurs la carte du rapport performances/prix en comparant sa grille tarifaire à celles de concurrents. GPT-5.6 Sol et Claude Fable 5.1 sont dans la ligne de mire, avec respectivement 4/20 dollars et 10/50 dollars.

Cependant, cette grille tarifaire ne raconte pas toute l’histoire. Selon des tests réalisés par Artificial Analysis, Grok 4.7 est plus gourmand en tokens que son prédécesseur. L’écart est a priori significatif : 81 000 jetons de sortie par tâche Intelligence Index pour Grok 4.7 xHigh, contre 38 000 pour Grok 4.6 xHigh et 27 000 pour GPT-6 Astra Max. Selon Artificial Analysis, Grok 4.7 est particulièrement verbeux, avec 240 millions de tokens générés pendant ses tests, contre une médiane de 88 millions.

Le positionnement général est ainsi celui d’un modèle faisant mieux que Grok 4.6 pour le même prix par tokens, mais possiblement plus lourd sur la facturation et l’usage des quotas. Il n’y a donc pas de rupture, et on reste sur l’interrogation classique du choix du modèle en fonction du scénario d’usage envisagé. Grok 4.7 illustre la manière dont un LLM peut s’avérer plus cher à l’utilisation que son prédécesseur, même quand le prix par token ne bouge pas ou diminue, comme nous l’avions montré avec Opus 4.7 d’Anthropic.

Enfin, on notera que le calendrier des sorties des prochaines versions ne semble pas ralentir, puisque Grok 4.8 serait proposé dans un mois. Une affirmation à prendre avec des pincettes, Grok 4.7 ayant été repoussé plusieurs fois. Le rythme cadre mal cependant avec le positionnement d’Elon Musk sur la nécessité de ralentir le développement des modèles de frontière. Il a publiquement soutenu l’idée de Dario Amodei, CEO d’Anthropic, de calmer le jeu et de réfléchir à un cadre clair pour mesurer l’alignement des modèles. Comme nous l’avions relevé toutefois, ces déclarations d’intentions ne semblent pas suivies d’actions concrètes.

  •  

Petal de Meta : 1 000 Tb/s entre les États-Unis et la France grâce à des fibres à deux cœurs

Toujours plus de vidéos de chats par seconde !
Petal de Meta : 1 000 Tb/s entre les États-Unis et la France grâce à des fibres à deux cœurs

Au lieu de doubler les fibres dans les câbles sous-marins, Meta double le nombre de cœurs dans chaque fibre. Résultat des courses, en 2029, un nouveau câble transatlantique de 7 000 km avec 24 paires de fibre optique proposera une bande passante de 1 Pb/s (ou 1 000 Tb/s).

Ce nouveau câble sous-marin de 7 000 km va relier les États-Unis à la France, avec Orange aux commandes pour l’atterrissement sur les côtes atlantiques. Le réseau social affirme que c’est « le premier câble sous-marin d’une capacité de pétabits à être déployé à travers un océan », soit le double de « la capacité des câbles transocéaniques les plus avancés d’aujourd’hui ».

Meta explique qu’il s’agit du « premier système de câble utilisant la technologie des fibres multicœurs déployé sur des distances transocéaniques ». Il faut comprendre en creux que ce n’est pas la première fois que plusieurs cœurs sont intégrés dans une fibre, pas plus que c’est une première dans un câble sous-marin. Idem, il existe déjà, au moins en laboratoire, des fibres avec plus de deux cœurs, voire des dizaines de cœurs. La différence ici : le procédé est industrialisé et sera opérationnel en 2029, selon Meta.

Deux cœurs dans un brin de 125 μm de diamètre


Il reste 82% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Europe : menace sur le consentement pour entrainer des IA sur des données personnelles

Le consentement, c'est sexy pourtant !
Europe : menace sur le consentement pour entrainer des IA sur des données personnelles

L’Irlande a proposé de nouvelles modifications au texte européen du « digital omnibus » qui doit « simplifier » le droit numérique européen. Le pays qui préside actuellement le Conseil veut que l’Europe considère comme « légitime » l’entraînement des IA sur les données personnelles ainsi que le dépôt de cookies pour mesurer l’efficacité de la publicité en ligne sans avoir besoin d’obtenir le consentement explicite des utilisateurs.

En prenant la présidence du Conseil de l’Union européenne, l’Irlande a aussi pris en main la rédaction de la proposition du texte « digital omnibus ». Le pays, qui héberge nombre de sièges sociaux européens d’entreprises du numérique, a ajouté au brouillon en cours deux modifications qui permettraient aux entreprises d’IA d’une part et de publicité d’autre part de se passer du consentement explicite des utilisateurs.

Nos confrères de Politico ont obtenu la version du document datée du 3 septembre élaborée par la présidence irlandaise du Conseil de l’UE [PDF].

L’entraînement de l’IA, intérêt légitime ?


Il reste 84% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

L’assourdissant bruit de fond d’Internet

Le serveur n’a rien demandé à personne !
L’assourdissant bruit de fond d’Internet

Assourdissant, c’est le mot : un serveur privé fraîchement installé et branché à Internet reçoit près de 100 000 visites par jour. Le chiffre est vertigineux et montre bien ce que l’on appelle le « bruit de fond d’Internet », c’est-à-dire ce qui se passe même quand on n’a rien demandé à personne.

La semaine dernière, nous expliquions qu’un de nos serveurs était attaqué un peu plus de 4 000 fois par jour. Attaqué sur le seul port 22, celui par défaut des connexions SSH pour prendre la main à distance. Mais ce n’était que la face visible de l’iceberg.

Notre serveur « visité » 100 000 fois par jour

Nous avons pris un autre serveur privé virtuel (VPS) – un serveur avec des ressources CPU, mémoire et stockage partagées – chez OVHcloud cette fois. Nous avons installé T-Pot de Deutsche Telekom Security, un honeypot (pot de miel) open source captant toutes les demandes au serveur, pas seulement celles sur le port 22.


Il reste 81% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Deepfakes haineux : les règles de Meta ne sont pas à la hauteur

Les victimes ignorées, Meta désavouée
Deepfakes haineux : les règles de Meta ne sont pas à la hauteur

Meta doit en faire plus contre les deepfakes diffusant des discours haineux. Cet appel à agir ne vient pas d’une organisation opposée au mastodonte des réseaux sociaux, mais de l’Oversight Board, le conseil de surveillance indépendant de l’entreprise chargé d’examiner certaines décisions de modération des contenus.

L’Oversight Board, créé par Facebook en 2019 et opérationnel depuis 2020, peut rendre des décisions contraignantes sur certains contenus. Son pouvoir est cependant limité, car l’entreprise de Mark Zuckerberg n’est pas tenue de mettre en œuvre les recommandations générales que le comité peut proposer. Néanmoins, les dossiers dont il se saisit et qu’il met en lumière permettent de mesurer les limites, voire les incohérences, de la politique de modération de Meta.

Une fausse vidéo politique laissée en ligne pendant dix mois

C’est le cas pour deux dossiers dont les décisions ont été publiées le 17 septembre, et qui concernent des deepfakes générés par IA. Le premier est une vidéo partagée sur Facebook en novembre 2025 dans laquelle on peut entendre une conseillère municipale du Parti travailliste écossais affirmer : « Les réfugiés sont les bienvenus ici, même s’ils violent nos femmes, car les Blancs le font aussi. »

Un examen un peu plus approfondi du document permet de conclure à une vidéo générée par IA. Malgré plusieurs demandes et appels de la conseillère en question et d’une autre victime, le post est resté public. Meta a conclu lors de l’appel du comité que la vidéo n’enfreignait pas les standards communautaires et qu’elle ne méritait pas une étiquette IA. Le Board a finalement annulé la décision de maintenir le contenu et a exigé son retrait – Meta a effectivement annoncé la suppression de la vidéo, dix mois après sa mise en ligne.

Le comité a désavoué Meta sur la qualification du contenu. Selon la majorité des membres du Board, la vidéo associait l’ensemble d’un groupe (les réfugiés) à la criminalité et aux violences sexuelles. Elle aurait donc dû être supprimée au titre des règles sur les conduites haineuses.

Et si Meta a jugé bon de n’en rien faire, alors la vidéo aurait tout de même dû être étiquetée « IA à haut risque ». Les règles de l’entreprise concernant l’étiquetage IA pour les hypertrucages sont jugées inadéquates. Dans leur majorité, les membres du comité estiment que Meta devrait se doter de règles plus solides concernant les deepfakes :

  • en élargissant les situations dans lesquelles l’étiquette « IA à haut risque » peut s’appliquer ;
  • en prenant plus de mesures pour restreindre la diffusion de contenus trompeurs générés par l’IA ;
  • en renforçant les sanctions contre les comptes qui publient ce genre de contenus de manière répétée ;
  • et en faisant preuve de plus de transparence sur les conditions d’application de ces étiquettes.

De manière plus générale, le comité estime que ce dossier met en lumière le fait que « les femmes politiques, les journalistes et les militantes sont visées de manière disproportionnée par des deepfakes qui déforment leurs positions, notamment dans le cadre de campagnes de harcèlement ». Les personnalités moins connues manquent souvent de moyens pour répondre à ces harcèlements.

Des attaques violentes visant les femmes

Le deuxième cas concerne une jeune femme musulmane vivant en Europe, interviewée par une télévision. On la voit en tant que bénévole d’une campagne visant à améliorer l’éducation à la santé menstruelle et à combattre la stigmatisation des problèmes de santé touchant les femmes et les filles issues de minorités ethniques.

La vidéo a été manipulée et diffusée sur plusieurs réseaux sociaux pour tourner la personne en ridicule, « en créant un contraste apparent entre son engagement en faveur de la santé et son apparence physique, dans le but manifeste de laisser entendre qu’elle n’était pas légitime pour s’exprimer sur ces questions ». Ces vidéos et images générées par IA ont cumulé des dizaines de millions de vues sur différentes plateformes, dont celles de Meta.

Les appels de la victime auprès de Meta pour faire retirer ces contenus ont reçu une fin de non recevoir. « Meta a depuis confirmé au Conseil que sa décision de ne pas intervenir sur cette publication, en la maintenant sur la plateforme sans lui apposer d’étiquette signalant un contenu généré par IA, était conforme à ses règles », précise l’exposé des faits.

Ce n’est qu’après que le Board l’a interrogée sur des commentaires dénigrants publiés sous la vidéo que Meta est intervenue pour les supprimer. Confirmant au passage qu’ils enfreignaient l’interdiction des comparaisons déshumanisantes inscrite dans les règles relatives à l’intimidation et au harcèlement.

Le conseil est allé plus loin : il a annulé la décision de Meta de maintenir la publication en ligne et ordonné son retrait. Selon la majorité de ses membres, la vidéo constituait elle-même une forme de harcèlement, puisqu’elle utilisait l’IA pour falsifier les paroles et les actes de la jeune femme, l’humilier en raison de son apparence et alimenter une campagne plus large dirigée contre elle.

Le comité recommande à Meta :

  • d’élargir la définition des « images manipulées non sollicitées » afin d’y inclure les deepfakes montrant une personne en train de dire ou de faire des choses qu’elle n’a pas dites ni faites ;
  • d’ajouter les contenus enfreignant cette règle à une base de contenus de référence, afin que leurs copies puissent être automatiquement repérées et supprimées ;
  • de considérer les indices indiquant qu’un contenu a été généré ou manipulé par l’IA comme un facteur aggravant, pour traiter en priorité les signalements concernés.

Là aussi, ce cas illustre les risques que l’IA générative fait peser sur les femmes et les filles, « les abus gagnant en ampleur, en rapidité et en gravité ». Le Board rappelle le rapport publié l’an dernier par ONU Femmes, selon lequel ces attaques sont souvent délibérées et coordonnées, « et visent à réduire au silence les femmes présentes dans la vie publique ».

Ces vidéos générées par IA ont des répercussions importantes sur les droits des utilisateurs des plateformes de Meta, « notamment sur le droit des femmes musulmanes, et plus généralement des femmes et des filles, à participer à la vie publique. »

  •  

☕️ OpenAI tente de renouer le dialogue avec les mathématiciens


Du rififi chez les matheux. OpenAI a affirmé ces derniers mois que ses modèles résolvaient des problèmes mathématiques sur lesquels les spécialistes se cassent les dents et la tête depuis des années — dont certains du mathématicien Paul Erdős ou plus récemment, les équations de Navier-Stokes, tout en étant accusée de mauvaises pratiques scientifiques.

Illustration : Flock

Ces annonces tonitruantes ont suscité une vague de colère de la part de la communauté des mathématiques, aussi bien en France qu’à l’international. La Société mathématique de France (SMF), avec toute la communauté internationale des chercheurs et chercheuses en maths, s’interroge sur les questions éthiques posées par l’IA générative (pillage bibliographique, coût énergétique et écologique…) et sur la déprédation scientifique de ces « résolutions ».

25 lauréats de la médaille Fields ont de leur côté cosigné une déclaration intitulée « A Severe Misalignment of AI in Mathematics » (« Un grave défaut d’alignement de l’IA en mathématiques »). Ils y déplorent la volonté des grands acteurs de l’IA de « nuire à la science des mathématiques », constatant une divergence entre ces entreprises et la communauté mathématique.

Dans un billet publié ce lundi 21 septembre, OpenAI annonce sa volonté d’engager un « dialogue réfléchi » avec la communauté et s’est rapproché d’un groupe consultatif indépendant en mathématiques qui « servira de passerelle avec la communauté mathématique et le grand public, en donnant aux mathématiciens une voix dans la façon dont nous avançons ».

Parmi les premiers membres de ce comité, on trouve François Charles, Camillo De Lellis, Timothy Gowers, Martin Hairer, Nikhil Srivastava, Ulrike Tillmann, Ravi Vakil, Edward Witten et Melanie Matchett Wood. Ils ne sont pas rémunérés par OpenAI pour leur participation.

Des questions presque aussi difficiles à résoudre que des équations

Le billet est très court et donne assez peu de détails. Ce groupe conseillera OpenAI sur l’évaluation et la communication des résultats de l’IA en matière de maths. Il aidera également à apprécier l’importance de ces résultats, à coordonner leur diffusion et à respecter les normes universitaires et professionnelles de la recherche mathématique.

Le groupe est aussi libre de formuler des recommandations non sollicitées, de commenter l’impact d’OpenAI sur les mathématiques, et de rendre publics ses avis. Étant donné son caractère consultatif, l’entreprise pourra suivre ses avis… ou pas. OpenAI restera libre du rythme de ses développements en maths.

Son premier travail est de trouver la manière de coordonner la publication d’un grand nombre de résultats importants qui auraient été obtenus par son modèle interne. OpenAI indique en effet que ce nouveau modèle, celui qui aurait résolu les équations de Navier–Stokes, a aussi trouvé des solutions à une centaine d’autres problèmes.

La startup ne cache pas que l’avenir ne sera pas forcément doré sur tranche : « Des questions difficiles restent à résoudre quant à la manière dont l’IA peut contribuer à la compréhension des mathématiques et dont les bénéfices de ces capacités peuvent profiter à l’ensemble de la communauté ». Pas de quoi réchauffer les relations tendues entre OpenAI et les mathématiciens, même si ce groupe est un geste en leur direction.

Certains mathématiciens demandent tout bonnement à OpenAI d’arrêter d’utiliser les maths comme benchmark de ses modèles. « Cessez d’essayer de donner l’impression que vous avez « résolu les maths » : c’est de toute façon impossible, et vous ne faites que rendre la résolution de problèmes aussi inutile que la production d’heures de vidéos sans intérêt sur l’IA », réagit ainsi le mathématicien David Madore.

  •  

Muse, l’agent IA de Meta, est interdit de faire les courses chez Amazon


Muse, l’agent IA de Meta, est interdit de faire les courses chez Amazon

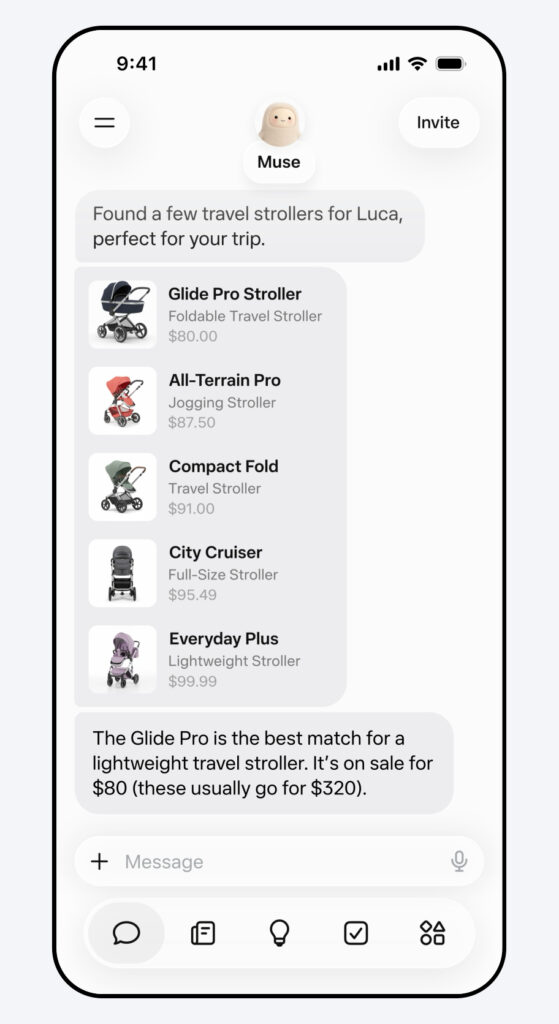
Amazon ferme la porte de son magasin à Muse, l’agent IA de Meta. Ce dernier est capable de fureter dans les allées virtuelles du géant du commerce en ligne pour y faire les emplettes de l’utilisateur. Mais Amazon n’a jamais donné son accord.

Le client est toujours roi, sauf quand il se cache derrière une IA. Amazon fait la guerre aux agents qui ne se déclarent pas comme tels. En novembre dernier, l’entreprise portait ainsi plainte contre Perplexity : l’agent intégré à Comet, le navigateur maison, est soupçonné de violer les conditions d’utilisation de la boutique en ligne.

Amazon ne veut pas d’agents incognito

C’est le cas aussi pour Muse, l’agent IA lancé le 8 septembre. Il est en mesure de faire les courses pour le compte de l’utilisateur, y compris donc sur Amazon. Ça n’a pas duré longtemps : depuis ce dimanche 20 septembre, les utilisateurs de Muse qui le lâchent dans le supermarché en ligne se font accueillir par une fenêtre les informant qu’un agent non autorisé enfreint les conditions d’utilisation d’Amazon.

« Nous estimons qu’il est assez évident que les applications tierces proposant d’effectuer des achats auprès d’autres entreprises pour le compte de clients doivent agir en toute transparence et respecter la décision des fournisseurs de services de participer ou non à ce type d’expérience », a déclaré un porte-parole du groupe à Geekwire.

Pour Amazon, l’enjeu est de taille. L’activité publicitaire représente une manne pour le groupe : 68,6 milliards de dollars générés durant l’exercice 2025. Or, ce ne sont pas les agents qui vont cliquer sur les produits sponsorisés et les acheter.

Au moment de la plainte contre Perplexity, Amazon expliquait qu’un agent ou plus largement un service qui effectue des achats au nom d’un client doit fonctionner de manière transparente et respecter les décisions des fournisseurs sur leur participation. Des agences de voyage en ligne, ou encore des plateformes de livraison de repas acceptent ces conditions d’utilisation.

Meta défend la sécurité de Muse

Amazon estime que les agents qui ne respectent pas ses règles sont susceptibles de dégrader fortement l’expérience d’achat et le service client : manque de personnalisation et d’historique d’achat, erreurs dans les estimations des tarifs de livraison…Il y a également une problématique de sécurité. Puisque l’agent ne s’identifie pas, l’entreprise considère qu’un tiers non déclaré fouine dans les comptes des clients, réalise des transactions et exploite des données sensibles sans le consentement d’Amazon.

« Les applications tierces dotées de capacités agentiques, comme Muse, sont soumises aux mêmes obligations, et nous avons demandé à Meta de retirer Amazon de l’expérience », conclut le porte-parole.

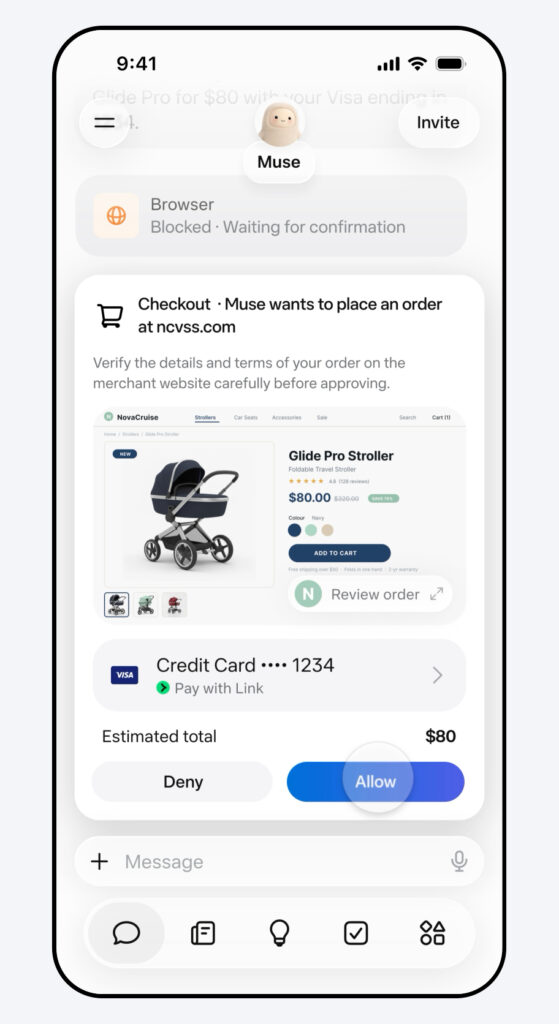
Lors de la présentation de Muse, Meta a expliqué que son assistant IA fonctionnait dans une machine virtuelle sécurisée avec son propre navigateur web, et demandait l’autorisation de l’utilisateur à chaque étape sensible comme un achat en ligne. Un second agent, Sentinel, est chargé de surveiller les moindres faits et gestes de Muse et il doit autoriser tout ce qu’il envoie sur internet.

Meta a ajouté que Muse n’avait accès ni aux mots de passe, ni aux moyens de paiement de l’utilisateur. Les identifiants fournis par ce dernier sont hébergés dans un espace sécurisé, ce qui permet à Muse de « les utiliser sans les voir ». Des discussions ont lieu entre Amazon et Meta depuis dimanche soir au sujet de Muse.

L’ironie de l’histoire, c’est qu’Amazon a été pris les doigts dans le pot de confiture en lançant ses propres agents à l’assaut des petites boutiques en ligne qui refusent de vendre leurs produits dans les linéaires du mastodonte.

  •  

Google combine Android, ChromeOS et Gemini pour les portables Googlebook

Chromebook avec une moustache
Google combine Android, ChromeOS et Gemini pour les portables Googlebook

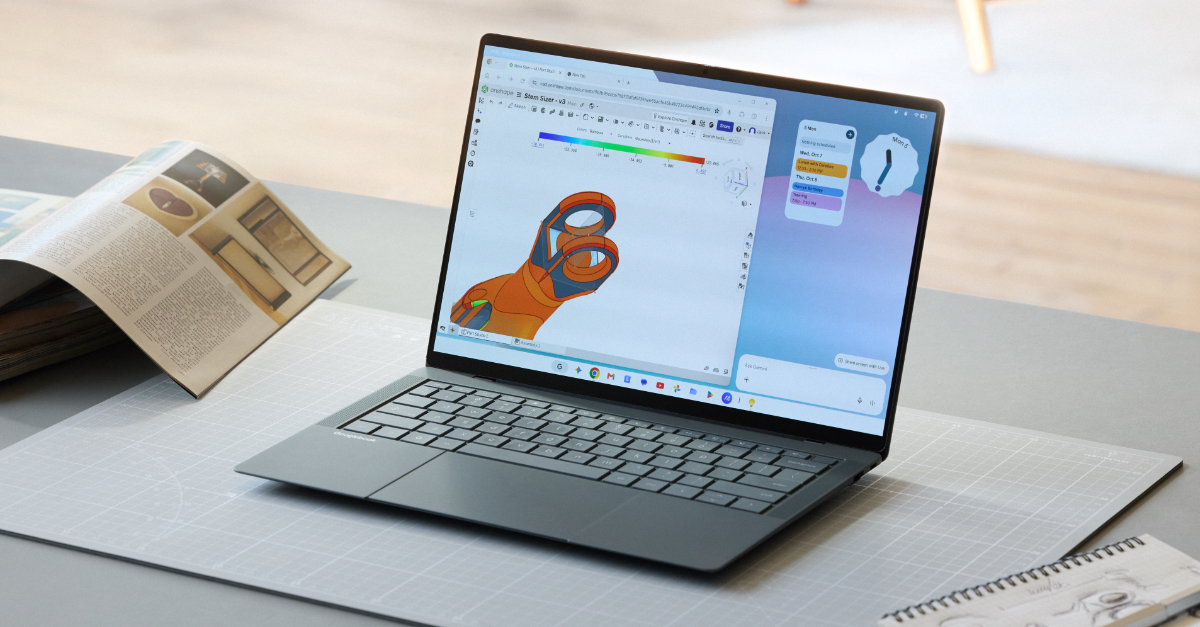
Après avoir échoué à imposer le Chromebook auprès du grand public – même si ces appareils restent populaires dans certains marchés comme celui de l’éducation –, Google remet donc une pièce dans la machine avec sa toute nouvelle famille Googlebook. Des portables fabriqués par des constructeurs partenaires, fonctionnant sur un système d’exploitation qui combine ChromeOS à Android, avec une bonne rasade d’IA par-dessus, le tout à des prix dignes d’un MacBook Air, à partir de 1 099 euros : c’est le pari du géant du web.

Google retente sa chance dans le secteur du portable. Après une première présentation mi-mai, le géant du web lance les premiers Googlebook et cette fois, pas question de vendre des machines au rabais comme le furent les premiers Chromebook. Ces appareils émargent dans la catégorie « haut de gamme », selon les propres mots de Google, avec des prix à l’avenant.

x86 ou Arm, pas de jaloux

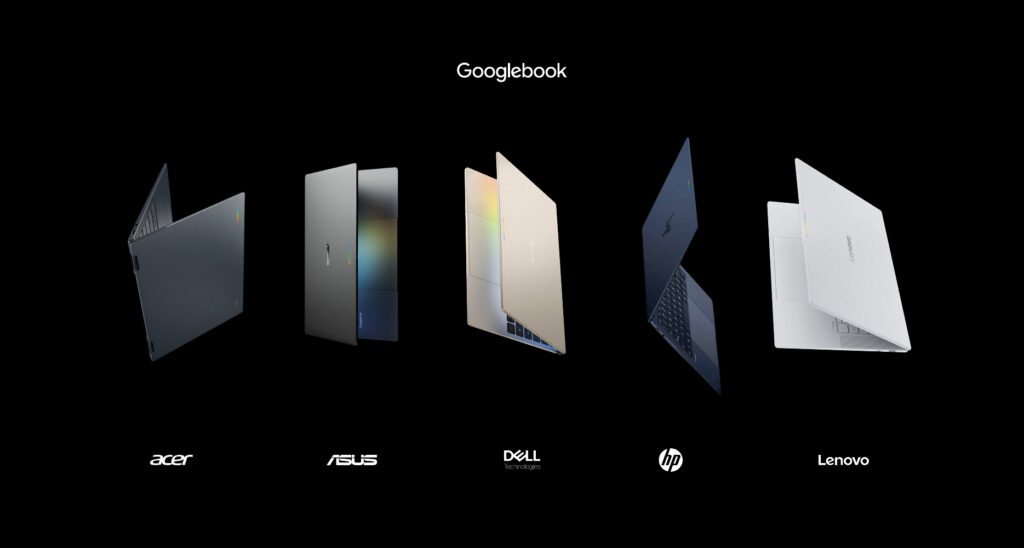
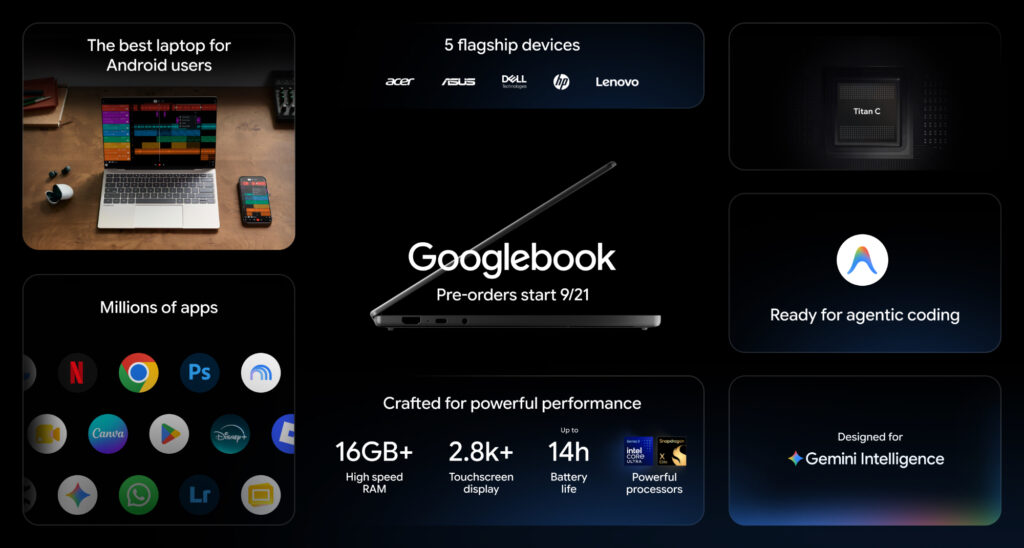
Acer, Asus, Dell, HP et Lenovo sont les constructeurs partenaires de ce lancement, avec des modèles qui débutent à 1 099 euros. Au menu : « matériaux premium » (aluminium, alliage de magnésium, fibre de carbone), écrans tactiles OLED 2,8K pour les mieux dotés, trackpad en verre avec retour haptique ou mécanique, clavier rétroéclairé, barre lumineuse discrète sur le capot.

Sous le capot, les Googlebook ont le choix entre une puce Intel (Core Ultra Series 3 Panther Lake) et une puce Qualcomm (Snapdragon X Elite) ; des modèles avec du silicium MediaTek sont également prévus. Ils embarquent de 16 à 32 Go de mémoire unifiée, et de 256 Go à 1 To de stockage.

Il s’agit d’ordinateurs portables dans tous les cas (le Googlebook 14 d’Acer peut se transformer en tablette), mais d’autres formats ne sont pas exclus à l’avenir. Rick Osterloh, vice-président de Google en charge du matériel et des services, évoque rapidement chez The Verge la possibilité d’autres designs, et pourquoi pas des ordinateurs de bureau. L’équipe qui en interne s’occupe de la gamme Pixel pourrait proposer son propre Googlebook.

C’est surtout sur la partie logicielle que la gamme Googlebook sort du lot. Le système d’exploitation, baptisé Googlebook OS (pourquoi faire compliqué) repose sur un socle partagé entre ChromeOS et Android. L’idée générale est qu’un utilisateur de smartphone Android se sente comme chez lui sur un Googlebook.

Image : Google

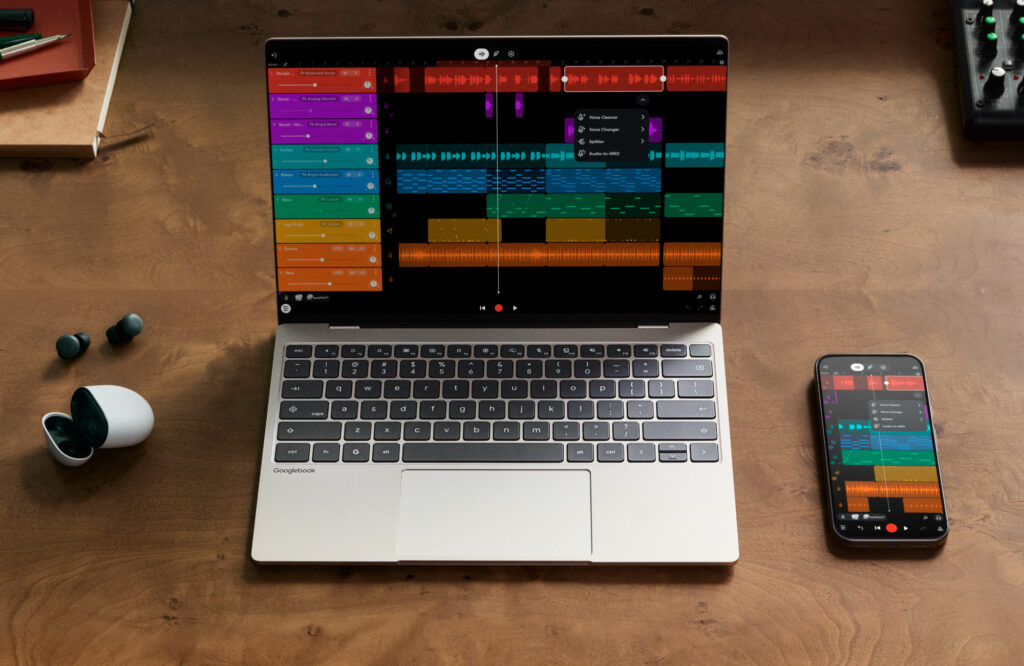
Ainsi, les paramètres Android, les mots de passe, les réseaux Wi-Fi et les messages sont synchronisés entre le portable et le téléphone. Une fonction de continuité permet de passer d’un appareil à l’autre et inversement. Google n’invente rien ici : les utilisateurs d’iPhone et de Mac connaissent ce type de fonctionnement transparent depuis des années.

Un petit air d’Apple

Les Googlebook ont accès au Play Store, donc à des millions d’applications Android et Google promet qu’ « un grand nombre est optimisé pour les grands écrans, le clavier et la souris ». L’entreprise évoque des logiciels comme Photoshop et Lightroom, mais il s’agit des versions mobiles.

Les jeux Android sont de la partie évidemment, tout comme le service GeForce Now de streaming de jeux. Il est aussi possible de projeter une app depuis son smartphone vers le portable, et d’accéder aux fichiers et documents stockés sur le téléphone ; il apparait en fait tout simplement dans la fenêtre de l’explorateur de fichiers.

Googlebook a été « conçu pour Gemini Intelligence » – image : Google

L’autre grande affaire des Googlebook est l’intégration profonde de Gemini. Les portables intègrent un NPU jusqu’à 45 TOPS, de quoi leur assurer le traitement en local de fonctions d’IA regroupées sous la bannière « Gemini Intelligence ». Google met en avant le « Pointeur magique » qui permet à Gemini d’interagir avec le contenu affiché à l’écran en secouant le curseur de la souris.

Une fonction de dictée améliorée met en forme les mémos vocaux pour être partagés par écrit. Le bureau du Googlebook pourra être personnalisé avec des widgets créés par l’utilisateur. Les Googlebook intègrent également Antigravity, la plateforme maison qui permet de concevoir des agents IA et déployer des applications depuis la machine.

Les précommandes ont débuté auprès des distributeurs français, pour une disponibilité le 5 octobre. Pour l’occasion, Google livre 12 mois d’abonnements à sa formule IA Pro, 5 To de stockage en ligne, et surtout dix ans garantis de mises à jour logicielles.

  •  

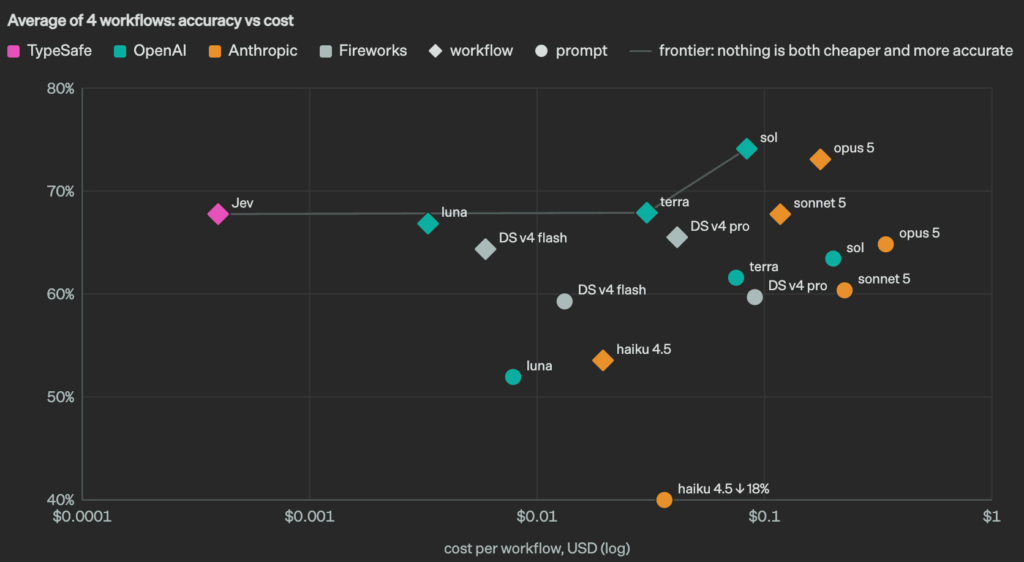
IA : le nouveau modèle Jev se veut le champion des « décisions typées »

Ceci n'est pas un LLM
Claude Opus 5.5, GPT-6 Sol et Luna : Anthropic et OpenAI se battent sur les prix

La société TypeSafe AI a présenté il y a quelques jours un nouveau modèle d’IA. Baptisé Jev, il se propose de traiter certaines opérations bien plus rapidement que les LLM « traditionnels », pour beaucoup moins cher. La comparaison reste cependant délicate.

L’annonce a fait l’effet d’une petite bombe sur les réseaux sociaux, particulièrement sur X : la société TypeSafe AI, fondée par Diogo Almeida, a annoncé son nouveau modèle de frontière, Jev.

Diogo Almeida se présente comme co-inventeur de ChatGPT. Un titre un peu exagéré. Il a travaillé effectivement sur les méthodes qui ont rendu capables les modèles GPT de suivre des instructions et de converser avec les utilisateurs. Mais il serait plus juste de dire qu’il est le co-inventeur du RLHF (Reinforcement Learning from Human Feedback), c’est-à-dire l’apprentissage par renforcement à partir de rétroaction humaine. Il est effectivement l’un des auteurs d’un papier fondateur sur la question.

Jev, en tout cas, n’est pas un LLM : il ne peut pas créer de texte ni même aider à la programmation. Il est décrit comme le premier « System One Model », une nouvelle catégorie de modèles conçus pour prendre des décisions rapides et structurées, que des services ou applications peuvent ensuite utiliser directement.

Ce qu’est Jev

Le modèle est comparé par TypeSafe AI à un appel de fonction : un état non structuré en entrée, des décisions probabilistes typées en sortie. Concrètement, on lui envoie un état (le contexte) et des questions portant sur cet état. Les réponses possibles sont fixées à l’avance par un schéma. Jev répond ensuite via trois primitives : le choix d’une option dans un ensemble, une note sur une échelle ordonnée, et un oui ou non calibré.

Pour bâtir Jev, TypeSafe AI dit avoir construit une nouvelle architecture de modèle, un échantillonneur parallèle et une nouvelle méthode de renforcement baptisée RLCD, pour « Reinforcement Learning for Calibrated Decisions ». L’échantillonneur parallèle signifie que toutes les questions d’une requête sont évaluées en parallèle, contrairement à un LLM dont chaque nouvel élément dépend du précédent.

Plusieurs points forts sont mis en avant, notamment la calibration via RLCD. Selon l’entreprise, cet entrainement doit permettre des réponses assorties de probabilités « honnêtes ». Dans ce contexte, une confiance plus élevée (donnée sous forme de pourcentage) signifie une meilleure exactitude. En outre, TypeSafe affirme que Jev ne peut pas halluciner, puisque la sortie est contrainte par le schéma. Il faut cependant lire entre les lignes : dans ce contexte, Jev garantit le respect du format, pas la justesse du format. En d’autres termes, Jev ne peut rien « inventer », mais il peut se tromper de catégorie.

Vite, un exemple !

Pour mieux comprendre l’intérêt de ce nouveau modèle, mieux vaut un exemple. Imaginons un service client qui reçoit 10 000 e-mails par jour. Pour chacun, un programme doit prendre plusieurs décisions : le client est-il mécontent ? Faut-il envoyer le message au service facturation, technique ou commercial ? Est-ce urgent ?

Aujourd’hui, ce type de tâche est souvent confié à un LLM comme GPT ou Claude. On lui envoie l’e-mail avec une consigne du type « dis-moi si c’est urgent », et il répond par une phrase : « Oui, ce message semble urgent car le client menace de résilier ». Problème, un programme informatique ne « comprend » pas les phrases. Il faut donc un travail supplémentaire pour extraire le « oui » de cette phrase. De plus, le modèle peut répondre à côté, ajouter des commentaires inutiles ou inventer une catégorie qui n’existe pas. Enfin, écrire une phrase mot par mot prend du temps et coûte cher.

Jev ne fonctionne pas avec des phrases, mais avec trois primitives. On applique une liste de questions dont les réponses sont fixées à l’avance :

  • Le client est-il mécontent ? Oui/Non
  • Quel service doit traiter cet e-mail ? Facturation/Technique/Commercial
  • Quelle urgence sur une note de 1 à 5 ?

Si on continue dans cet exemple, on obtiendra une réponse du type : « oui (92 % de certitude), facturation (85 %), urgence 4 (70 %) ». Cela revient à donner un formulaire à remplir pour répondre à une question plutôt que demander son avis à une personne.

Les données émises par Jev sont formatées et peuvent être reprises telles quelles par d’autres éléments de traitement de la chaine. Quand TypeSafe affirme que son modèle ne peut pas halluciner, cela signifie que Jev ne peut pas répondre par exemple « Juridique » pour le service à contacter. En revanche, rien ne l’empêche de se tromper sur le service à effectivement contacter. On peut alors appliquer un filtre pour automatiser l’envoi à une équipe humaine pour toutes les réponses dont le score de confiance est inférieur à 80 %.

L’efficacité mise en avant

L’un des éléments les plus repris par la presse est l’efficacité du modèle. Sur les tâches pour lesquelles il a été pensé, le temps de réponse annoncé va de 70 à 500 ms, soit 40 à 200 fois plus rapide que les modèles de pointe pour des requêtes de ce type. Le prix est de 0,042 dollar par million de jetons en entrée, et la sortie est gratuite. À titre de comparaison, GPT-5.6 Terra coûte 2 dollars par million de jetons en entrée et 12 dollars en sortie.

Dans sa présentation, TypeSafe donne des chiffres mais émet elle-même des réserves. Ainsi, les gains maximaux peuvent être très précisément de x193,6 sur les performances et x444,6 moins cher. Ces chiffres viennent de quatre chaines de traitement interne : réponse aux incidents de sécurité, observation de traces d’agents, traitement de factures et service client.

Même si TypeSafe évoque une certaine prudence, il est difficile pour l’instant de jauger des performances réelles comme de la facture finale, car le modèle n’est disponible pour tout le monde que depuis le 20 septembre, sans liste d’attente. Si l’on en croit certains retours d’entreprises ayant testé le modèle, le gain semble avéré.

En outre, l’annonce de Jev est déjà contestée. Selon Nandakishor Mukkunnoth, fondateur de ConvAI Innovations, l’idée n’est pas nouvelle. Dans un billet, il indique être à l’origine des recherches qui ont mené à cette technique, dont il revendique la paternité. Il ne reproche pas à TypeSafe d’avoir copié du code, mais de ne pas avoir cité des travaux antérieurs. Sur Hacker News, plusieurs personnes notent que ce type de mésaventure est malheureusement courant, mais que l’apport de TypeSafe est surtout d’avoir réussi à en faire un produit concret.

Ce qui n’a pas empêché Nandakishor Mukkunnoth de publier une alternative libre, nommée Laya. D’autres modèles libres sont apparus en quelques jours. Si l’on en croit les premiers tests réalisés indépendamment, tous les modèles affichent des performances moindres que Jev. Si l’on donne un score de référence de 1 à ce dernier, les 78 tests effectués font ressortir des notes alternant entre 0,5 et 0,7, Laya étant dans la moyenne.

  •  

L’IA est un défi environnemental pour la planète et une « opportunité pour la France »

Consommez français… oui, c’est quoi français ?
L’IA est un défi environnemental pour la planète et une « opportunité pour la France »

Pour réduire l’empreinte environnementale des IA (génératives), un rapport du Sénat préconise une IA « française ». Pas tant dans le sens souverain (et respectueux), mais dans le sens d’implantation des datacenters et de consommation des ressources, notamment d’électricité bas carbone (nucléaire). Cela soulève toutefois des questions sur le foncier et l’acceptation sociale.

La commission de l’aménagement du territoire et du développement durable du Sénat vient de présenter le rapport d’une mission d’information sur l’empreinte environnementale de l’intelligence artificielle. Comme nous, le Sénat se heurte à un problème de taille : les données disponibles sont encore et toujours « lacunaires », aussi bien sur la consommation en eau qu’en électricité.

Pourtant, l’enjeu est important puisque l’empreinte environnementale de l’IA est présentée comme « un défi pour la planète », mais il se heurte aux géants (principalement américains). Malgré de belles promesses sur leur empreinte environnementale, ils consomment toujours plus.

Les rapporteurs ont une solution qui ne plaira pas à tout le monde : venez en France. « L’empreinte environnementale de l’IA, qui renforce les constats établis par notre commission en 2020, constitue à la fois un défi pour la planète et une opportunité pour la France et pour l’Europe », affirme le rapporteur Damien Michallet.

Consommation en eau : voir au-delà des m³

Le rapport rappelle à juste titre que « la consommation d’eau destinée au refroidissement dépend cependant des technologies utilisées ». Les tours aéroréfrigérantes ont l’empreinte hydrique la plus élevée, avec « l’évaporation d’environ 80 % de l’eau prélevée ». C’est encore plus problématique « dans les pays, comme les États-Unis, où certains centres sont implantés dans des régions déjà soumises à un fort stress hydrique ».

Vous pouvez retrouver les zones de stress hydrique définies par l’ONG World Resources Institute (WRI) dans son Aqueduct Water Risk Atlas directement sur notre carte mondiale des datacenters et des ressources associées. Nous avons aussi ajouté les prévisions à 2030, 2050 et 2080.

En France, d’autres technologies sont utilisées et « les prélèvements d’eau destinés aux centres de données restent très limités ». Le Sénat reprend les derniers chiffres de l’Arcep sur l’année 2023 : 681 000 m³ d’eau en consommation directe, mais laisse de côté (dans la version condensée de son analyse) la consommation indirecte liée notamment à l’électricité.


Il reste 76% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Google enfreint le RGPD et écope d’une amende de 403 millions d’euros

Un suivi à la trace qui coûte cher
Google enfreint le RGPD et écope d’une amende de 403 millions d’euros

Google essuie une nouvelle amende en Europe. La Commission à la protection des données irlandaise inflige une sanction financière de 403 millions d’euros au géant du web pour infraction au RGPD. Le régulateur ordonne également à l’entreprise de se conformer au règlement européen sur la protection des données dans les six mois.

La Commission à la protection des données irlandaise (DPC) n’a pas peur des gros chiffres. En 2023, elle infligeait une amende record de 1,2 milliard d’euros à Meta pour infraction au RGPD. Rebelote aujourd’hui, cette fois contre Google qui écope donc d’une douloureuse de 403 millions.

La DPC remonte la piste de Google

En sa qualité d’autorité de contrôle pour Google (le siège européen du groupe est installé en Irlande), la DPC menait l’enquête depuis début 2020. Deux ans plus tôt, des plaintes avaient été déposées par huit organisations de défense des consommateurs regroupées au sein du BEUC (Bureau européen des unions de consommateurs).

La décision de la DPC était donc attendue depuis un bon moment. Elle porte sur le traitement des données de localisation dans trois fonctions spécifiques : l’activité sur le web et les applications (historique de navigation, recherches et certaines données de localisation), l’historique de localisation (enregistrement des lieux visités et déplacements de l’utilisateur) et la précision de la localisation (amélioration de la géolocalisation de l’appareil au-delà des seules données GPS). Le tout sur la période comprise entre la mise en œuvre du RGPD en mai 2018 et février 2020.

Google a enfreint le règlement européen sur ces trois points. En ce qui concerne l’activité sur le web et les apps, ainsi que sur l’historique de localisation, l’entreprise a traité les données de localisation sans fondement juridique valable, et d’une manière déloyale envers les utilisateurs. Google a aussi démontré son incapacité à prouver que les données personnelles recueillies par la fonctionnalité de précision de la localisation étaient traitées légalement, loyalement et en toute transparence.

La DPC a également conclu que le groupe n’a pas respecté ses obligations de transparence concernant les trois fonctions en question, et qu’il a enfreint les principes de conservation des données de localisation pour les fonctionnalités d’activité sur le web et les apps, ainsi que pour l’historique de localisation.

Une décision longue à venir

« Les données de localisation peuvent être extrêmement sensibles, car elles révèlent beaucoup de choses sur notre vie privée : l’école fréquentée par nos enfants, le nombre de visites d’une personne à l’hôpital, voire ses lieux de culte. Il s’agit d’une pratique extrêmement intrusive, qui porte atteinte au droit fondamental à la vie privée et enfreint le RGPD », rappelle Agustín Reyna, directeur général du BEUC.

Ce dernier se réjouit de la décision de la DPC, mais regrette « le temps nécessaire pour parvenir à cette conclusion » jugé « disproportionné au regard de la gravité de l’infraction ». Pour Agustín Reyna, « Une application tardive de la loi peut être aussi préjudiciable qu’une absence totale d’application. Les droits fondamentaux des consommateurs doivent être protégés plus rapidement et plus efficacement. »

Google a maintenant six mois pour se mettre en règle… même si cela semble déjà être le cas. L’entreprise a en effet rappelé à Bloomberg que le dossier porte sur d’anciennes règles de confidentialité mises à jour depuis. « Depuis 2019, nous avons considérablement fait évoluer nos pratiques et lancé des outils performants qui simplifient la gestion des données de localisation », ajoute-t-elle.

Dix organisations membres du BEUC, dont Que Choisir Ensemble (à l’époque, UFC-Que Choisir) ont déposé une seconde plainte contre Google en 2022. Elle porte sur la manière dont le groupe pousse les utilisateurs, lors de la création d’un compte, à accepter une collecte et une exploitation étendues de leurs données personnelles via des méthodes d’interfaces manipulatrices (dark patterns). La DPC a ouvert une enquête en 2023.

  •  

Meta et ses lunettes connectées attaquées en justice aux États-Unis

Lunettes trop connectées ?
Meta et ses lunettes connectées attaquées en justice aux États-Unis

Les lunettes connectées de Meta sont de plus en plus utilisées à travers le monde mais aussi de plus en plus décriées. Aux États-Unis, des dizaines de personnes se sont jointes à une class action contre Meta accusée notamment d’avoir envoyé des scènes d’intimité sur ses serveurs et à un sous-traitant sans leur consentement.

Alors que de partout les lunettes Meta et leurs utilisateurs sont critiqués, une plainte vient unifier, aux États-Unis, les personnes qui dénoncent l’atteinte à leur intimité de la part de Meta. Elles accusent l’entreprise de Mark Zuckerberg d’avoir notamment transféré de manière problématique des photos et vidéos captées par une de ses paires de lunettes connectées.

En début d’année, des journalistes suédois ont montré que certaines scènes de la vie courante et parfois intime de porteurs de lunettes Meta et de leurs proches étaient envoyées sur les serveurs de Meta puis parfois à un de ses sous-traitants kényans pour analyse.

Ce sous-traitant, nommé Sama, est connu pour faire partie des entreprises africaines qui traitent les données des entreprises de la Silicon Valley pour toutes les tâches de modération et d’étiquetage (tâche qui permet d’améliorer les modèles).

À l’époque, l’eurodéputé du Parti social-démocrate suédois Adnan Dibrani avait soulevé des questions sur le sujet devant la Commission européenne. Mais de l’autre côté de l’Atlantique, cette enquête a aussi inquiété plusieurs acheteurs de lunettes Meta qui ont monté différents dossiers juridiques.

Plus de 70 utilisateurs de lunettes Meta se rassemblent pour porter plainte

Fin août, plus de 70 d’entre eux ont finalement fusionné leurs plaintes dans une class action déposée devant un tribunal fédéral de Californie du Nord, a appris le Los Angeles Times.

Le document de 230 pages [PDF] s’appuie sur l’enquête de nos confrères et consœurs suédois pour accuser Meta d’envoyer sur ses serveurs les données que les utilisateurs font transférer des lunettes à leur smartphone. Et ce, en temps réel et qu’ils aient activé ou non la fonction « cloud media » (qui permet de sauvegarder sur le cloud de Meta).

La plainte évoque l’envoi par Meta de données à Sama pour que des employés de ce sous-traitant les vérifient. « Meta a transmis à des annotateurs tiers travaillant pour Sama des données à caractère personnel, notamment des images et des enregistrements audio représentant des situations privées et des activités personnelles dont l’utilisateur plaignant pouvait raisonnablement s’attendre à ce qu’elles restent privées », affirme le document.

Des scènes privées envoyées automatiquement

Mais la plainte contient aussi des témoignages des différents utilisateurs portant plainte. Ainsi, l’un d’entre eux affirme que ses lunettes ont enregistré à son insu des membres de sa famille dans la salle de bain alors qu’il les avait laissées sur une étagère : « Il a remarqué que, parfois, des photos de membres de sa famille dans la salle de bain et en train de se laver commençaient à apparaître dans sa galerie – des images que personne dans son foyer n’avait l’intention de prendre ».

Un autre témoigne que les lunettes qu’il a achetées « se déclenchaient par erreur deux fois par jour ». « Meta a capturé, transmis et acheminé vers Sama les images et les enregistrements audio capturés par les lunettes [de ce plaignant], qui montraient des situations privées et des activités personnelles dont il pouvait raisonnablement s’attendre à ce qu’elles restent privées », décrit le document au milieu de l’évocation de plus d’une quarantaine d’autres cas.

Les avocats soulignent que la communication de Meta est pourtant très rassurante, notamment depuis 2025, martelant que ses lunettes sont « conçues pour préserver votre vie privée, sous votre contrôle ». « Mark Zuckerberg a lui-même insisté sur ce message clé, soulignant qu’il était d’une « importance capitale » de « donner aux utilisateurs le contrôle » sur ce que les lunettes enregistrent et conservent », ajoutent-ils. Pour eux, cette insistance sur la protection de la vie privée des utilisateurs a permis à Meta de passer de 2 millions de ventes de lunettes sur 2023 et 2024 réunies à 7 millions pour la seule année de 2025.

« Ces promesses étaient fausses. Les lunettes enregistrent en silence, avec des indicateurs difficiles à voir et facilement masqués », constatent-ils.

« Si vous utilisez Meta AI, nous pouvons être amenés à examiner ces données afin d’améliorer nos produits et l’expérience utilisateur – cela fonctionne de la même manière que dans de nombreuses autres entreprises. Nous prenons des mesures pour filtrer ces données afin de supprimer les informations permettant d’identifier les utilisateurs et de protéger leur vie privée », a commenté Meta dans une déclaration envoyée au Los Angeles Times.

  •  

Macky Sall échoue à faire bloquer un site qui milite contre sa candidature à l’ONU

Inapte, inepte ?
Macky Sall échoue à faire bloquer un site qui milite contre sa candidature à l’ONU

L’ancien président sénégalais Macky Sall a tenté de faire bloquer, en France, un site opposé à sa candidature au poste de secrétaire général des Nations unies. Le tribunal judiciaire de Paris a rejeté sa demande, estimant qu’il n’y avait ni diffamation caractérisée, en dépit d’accusations graves, ni atteinte au droit à l’image.

Accessible à l’adresse nonamacky.org et décliné en neuf langues, le site en question affirme que les douze années de présidence de Macky Sall se sont traduites par de nombreuses entorses aux droits de l’homme, des excès inconstitutionnels, un recul de la liberté de la presse au Sénégal, et de nombreux scandales de corruption doublés d’une dette cachée.

Se présentant comme une plateforme citoyenne portée par une « coalition » de défenseurs des droits de l’homme, d’experts juridiques et de citoyens, le site s’appuie sur de nombreux articles de presse et rapports d’ONG pour étayer ce qu’il considère comme des « preuves » des manquements de l’ancien président. Il exhorte ses visiteurs à contacter les délégués du Conseil de sécurité de l’ONU.

Demande de blocage sous 48 heures

Entre le 31 mars et le 2 avril, Macky Sall a ainsi assigné Cloudflare (et sa filiale française), Orange, SFR, Free et Bouygues Telecom sur le fondement de l’article 6 - 3 de la loi sur la confiance dans l’économie numérique (LCEN), pour demander le blocage du site sous 48 heures, au motif que ce dernier contient « des accusations particulièrement graves et diffamatoires à son encontre ». Il y ajoute une accusation d’atteinte au droit à l’image en raison de la photo de Une du site : un portrait barré de la mention « Unfit » (inapte).

Régulièrement invoqué dans les procédures de blocage, l’article en question permet pour mémoire au président du tribunal judiciaire de « prescrire à toute personne susceptible d’y contribuer toutes les mesures propres à prévenir un dommage ou à faire cesser un dommage occasionné par le contenu d’un service de communication au public en ligne ».

La démarche n’est pas ordinaire.


Il reste 63% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Autopsie d’un kit de phishing et de son camouflage

O.D.I.L… ? LIDO, c'est peut-être une danseuse !
Autopsie d’un kit de phishing et de son camouflage

Parfois il suffit de peu : un lien et deux trois clics plus tard, voilà que votre boîte email est compromise. Comment fonctionnent les kits de phishing livrés clés en main par certains groupes de pirates ? Nous en avons récupéré et analysé un, conçu pour attaquer des comptes Outlook protégés par une double authentification.

Il y a quelques mois, Hexastrike dévoilait une nouvelle attaque baptisée CodeStorm. Il s’agit d’une attaque de l’homme du milieu ou adversary-in-the-middle (AiTM) visant les utilisateurs Microsoft 365. Son but ? Obtenir un accès aux comptes protégés par une authentification à deux facteurs. La technique n’est pas nouvelle, on en parlait déjà en 2022.

Lors de différents tests de cybersécurité, nous avons récupéré dans nos filets le code malveillant d’un kit fonctionnant sur le même principe que cette attaque. Nous n’allons évidemment pas diffuser la charge malveillante, mais son analyse permet de comprendre le fonctionnement et comment le programme malveillant se cache des antivirus et autres systèmes de détection.

Une page de 10 ko avec du code malveillant qui joue à cache-cache


Il reste 85% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  
❌