❌

Vue lecture

L’agent Muse de Meta s’appuie sur des humains pour sa fonction d’appels téléphoniques

Encore et toujours le turc automate
L’agent Muse de Meta s’appuie sur des humains pour sa fonction d’appels téléphoniques

L’agent IA de Meta qui propose aux internautes de faire leurs emplettes et de prendre leur rendez-vous à leur place est grandement inspiré d’OpenClaw, avoue l’un des responsables de l’entreprise. Mais la fonction d’appels ajoutée le 17 septembre s’appuie aussi sur un call center où de vrais humains passent des coups de fil à la place de l’IA.

L’IA coûte cher, les agents ne vont pas assez vite ? Pas de problème pour Meta, qui a essayé de rattraper son retard sur la concurrence en lançant Muse, son agent IA, capable de prendre en charge toutes sortes d’actions pour le compte de l’utilisateur. Histoire de ne pas perdre trop de temps en R&D, le géant des réseaux sociaux s’est grandement inspiré d’OpenClaw.

Un agent très très proche d’OpenClaw

C’est ce qu’a avoué Nat Friedman, responsable produit chez Meta Superintelligence Labs (MSL) dans un post sur X. « En tant que produit, il s’inspire très fortement d’OpenClaw » explique-t-il, tout en assurant que l’agent de Meta a été créé « from scratch ». « Je pense que beaucoup de gens s’en sont inspirés. Notre objectif avec Muse était de créer quelque chose de similaire à OpenClaw, que nous pourrions rendre sûr, sécurisé et facile à utiliser, et qui puisse s’adapter à des milliards d’utilisateurs », ajoute-t-il.

Nat Friedman répondait à un message affirmant que « Muse, c’est LITTÉRALEMENT OpenClaw pour les gens normaux ». Ce message était accompagné d’une capture d’écran montrant une réponse de Muse comparant des noms de fichiers de configuration entre les différents systèmes. Cette inspiration n’est pas fortuite : il se trouve en effet que Meta avait tenté d’acquérir OpenClaw avant qu’OpenAI ramasse la mise.

Meta est pressé et ne s’embarrasse pas trop des éventuels obstacles sur sa route : il a ainsi délogé manu militari le groupe de musique Muse de ses réseaux sociaux (Instagram, Facebook, et même X) pour y greffer ceux de son agent. Et Muse a été repéré par la patrouille en train de faire les courses sur Amazon sans que ce dernier soit prévenu.

Une nouvelle fonctionnalité… backupée par un call center

Ce même empressement pourrait aussi expliquer pourquoi Meta a voulu attribuer à Muse des actions qu’il ne peut réaliser seul, sans l’aide d’un humain. Dans l’histoire de l’IA, beaucoup d’entreprises ont été accusées de cacher du travail humain derrière un storytelling d’automatisation des tâches, Waymo faisant par exemple débloquer ses taxis par des personnes travaillant aux Philippines.

Meta rejoint ainsi cette longue liste après avoir lancé en test une fonction « pour les appels sortants vers des entreprises américaines ». Alexandr Wang, directeur de l’IA chez Meta, s’enorgueillait le 17 septembre dernier : « Nous étendons notre version bêta de Muse aux appels téléphoniques ! ».

Mais selon des informations de 404 Media, lors de la présentation de cette fonctionnalité aux employés de Meta, la direction leur a expliqué avoir « ajouté une couche d’agents humains pour garantir la bonne exécution des appels ».

D’après le message interne obtenu par nos confrères, « Muse ne se contente pas de composer un numéro. Il appelle une entreprise en votre nom, gère la conversation, traite votre demande et vous en rend compte à l’aide d’une transcription et d’un résumé ». « De plus, il ne fonctionne plus seul. Muse est désormais capable de transférer les demandes à un agent humain qualifié, qui passe l’appel et s’en charge », est-il ajouté.

Face à des employés circonspects concernant la mauvaise presse que cela pouvait attirer ainsi que par les problèmes de confidentialité potentiels, la direction de Meta leur a assuré que les sous-traitants avaient suivi « de nombreuses formations afin de garantir la sécurité et la protection de toutes vos données ».

« Les tests internes, également appelés “dogfooding”, sont au cœur du processus de développement des produits. Bien que les réactions des employés aient été extrêmement positives, l’objectif principal est de recueillir des retours afin de pouvoir mettre en place des mesures de sécurité et de protection de la vie privée, et d’améliorer les fonctionnalités avant leur lancement public », a répondu Meta au site web. « Nous travaillons avec les commerçants pour continuer à améliorer cette fonctionnalité d’appel potentielle, et nous ne la déploierons que lorsqu’elle sera prête et accompagnée des mentions d’information appropriées ».
  •  

Deux Snapdragon 8 Elite Gen 6 pour faire tourner l’IA sans saturer la mémoire

Deux puces sinon rien
Deux Snapdragon 8 Elite Gen 6 pour faire tourner l’IA sans saturer la mémoire

Qualcomm a dévoilé la puce annuelle des futurs smartphones Android haut de gamme. Elle se décline en deux versions : Snapdragon 8 Elite Gen 6 et une version Extreme. Les deux SoC mettent l’accent sur le traitement IA en local, et signe des temps, sur l’optimisation de l’usage de la mémoire.

Comme chaque année, Qualcomm sort le dictionnaire des hyperboles pour qualifier les capacités de sa nouvelle puce mobile destinée aux smartphones Android premium : elle est forcément la plus puissante jamais conçue. Ça n’a pas raté avec la fournée 2026, mais il y a au moins une nouveauté : ce n’est pas une puce qui a été présentée, mais deux. La Snapdragon 8 Elite Gen 6 est la successeure directe de l’Elite Gen 5 de l’an dernier, et en parallèle les constructeurs pourront opter à la place pour une Snapdragon 8 Elite Extreme Gen 6 encore plus balaise.

Deux puces, un cache et beaucoup d’IA

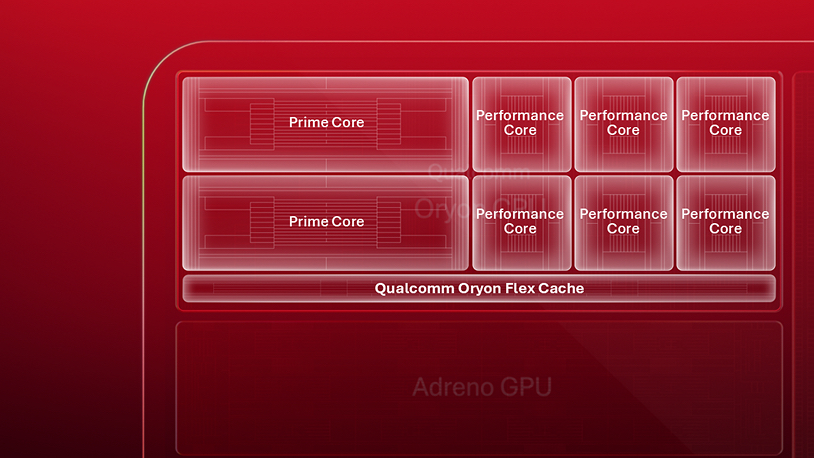
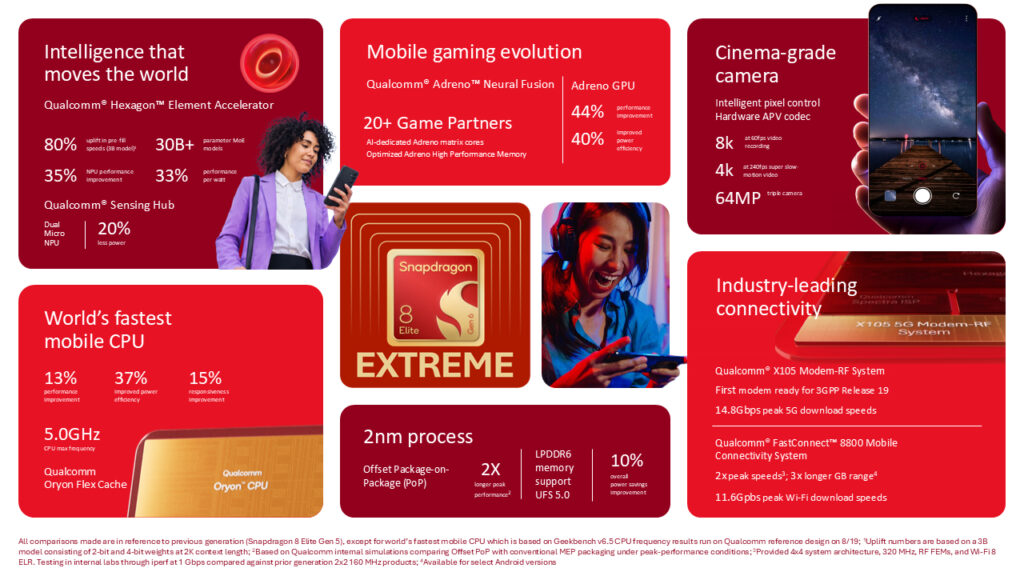
Qualcomm, qui dispute à Intel le titre du catalogue de noms les plus inutilement alambiqués, a intégré dans chacun de ses systèmes-sur-puce un CPU doté de deux cœurs « Prime » Oryon de 4e génération cadencés à 5 GHz – une première sur smartphone – et six cœurs performants jusqu’à 4 GHz, combinés à 16 Mo de cache Oryon Flex. La fiche technique est disponible par ici pour le 8 Elite Gen 6 et là pour la version Extreme.

Ce cache est au cœur d’un des principaux arguments de vente avancés par Qualcomm : les nouvelles puces sont efficaces même quand le smartphone intègre moins de mémoire. Les données nécessaires au traitement d’une tâche par les cœurs Prime sont stockées dans cette réserve plutôt que transférées dans la mémoire vive de l’appareil.

« Flex Cache réduit la fréquence à laquelle les cœurs doivent accéder à la mémoire système, ce qui permet de préserver les performances même lorsque la mémoire disponible est limitée », résume l’entreprise. Une évolution « plus importante que jamais » au vu de la crise de la mémoire qui affecte l’ensemble de l’industrie des smartphones.

En termes de performances, Qualcomm avance un gain de 10 % pour le processeur du Snapdragon 8 Elite Gen 6, et de 13 % pour celui du Snapdragon 8 Elite Extreme Gen 6 (bien que le CPU soit identique sur les deux modèles) par rapport au Snapdragon 8 Elite Gen 5.

GPU Adreno avec ou sans Neural Fusion, Wi-Fi 8

Les puces contiennent un GPU Adreno (sans détail, comme toujours) secondé sur la déclinaison Extreme par un Neural Fusion, qui regroupe plusieurs techniques de traitement IA (génération d’images et upscaling) qui améliorent la fidélité graphique.

Neural Fusion est censé minimiser les artefacts traditionnels des jeux mobiles : scintillements, images fantômes pour les objets en mouvement, rendu flou. Le GPU de la puce Extreme bénéficie également de trois cœurs dédiés au traitement IA (« Adreno Matrix ») et de 18 Mo de mémoire haute performance pour accélérer le calcul des tâches d’upscale et de génération d’images. Les éditeurs doivent adapter leurs jeux pour tirer profit de cette technologie : Qualcomm annonce une vingtaine de partenaires et des jeux comme Diablo Immortal et Honkai: Star Rail.

Le circuit graphique des nouvelles puces se veut 35 % plus rapide pour la Snapdragon 8 Elite Gen 6, et 44 % pour l’Extreme. Le troisième pilier de ces SoC est bien évidemment le NPU (neural processing unit) Hexagon jusqu’à 45 TOPS, de 14 à 35 % plus rapide selon la puce. Son efficacité énergétique, c’est-à-dire ses performances à consommation égale, progresse quant à elle jusqu’à 33 %. L’Extreme intègre en bonus un Element Accelerator doté d’une mémoire partagée 50 % plus importante.

Pour la connectivité, Qualcomm intègre son dernier FastConnect 8800 présenté en mars. Il intégre du Wi-Fi 8 et de la 5G bien évidemment.

La journée type selon Qualcomm…

Qualcomm a bien l’intention de prendre le train de l’IA agentique et propose même le déroulé d’une journée facilitée par les agents IA propulsés par les appareils (smartphones, ordinateurs, lunettes…) équipés de ses SoC nouvelle génération : tri des courriels le matin, gestion des rendez-vous, enregistrement et résumé des réunions, aides pour le travail… Le tout géré automatiquement par des agents travaillant en tâche de fond. Une vision de l’avenir ou un épisode de Black Mirror ?

On devrait être fixé assez rapidement, puisque les premiers smartphones dotés de ces Snapdragon ne tarderont pas. Motorola a ainsi déjà annoncé que le Signature 27 fonctionnera avec la Snapdragon 8 Elite Extreme Gen 6. C’est d’ailleurs le premier modèle que l’on pourra acheter avec GrapheneOS au lieu d’Android.

  •  

« Les IA n’ont ni droits, ni sentiments, ni conscience », plaide le patron de Microsoft AI

L'IAHOOQ
« Les IA n’ont ni droits, ni sentiments, ni conscience », plaide le patron de Microsoft AI

Le choix fait par Anthropic d’entraîner son robot conversationnel Claude de façon anthropomorphique en s’attachant au « bien-être » du modèle de langage, en lui imputant la possibilité d’avoir des « émotions », lui prêtant une « conscience » éthique et morale, représente pour le patron de l’IA chez Microsoft « les premiers signes sérieux d’un risque potentiellement existentiel lié à l’IA ».

Co-fondateur de DeepMind en 2010, Mustafa Suleyman dirige l’unité AI de Microsoft depuis 2024. Contrairement à Sam Altman et Elon Musk, il n’a pas partagé les craintes exprimées par Dario Amodei, qui appelait le 12 septembre dernier à ralentir le rythme de développement des IA.

Trois jours plus tôt, Evan Hubinger, responsable de l’alignement chez Anthropic, avait tweeté : « Nous croyons vraiment, sincèrement, que l’IA pourrait tuer tous les humains ! Je pense personnellement que c’est > 10 % dans la prochaine décennie ».

« Ça n’est pas si différent de ce qui se passe dans, par exemple, Terminator ou d’autres films de science-fiction (…). [L’intelligence artificielle, IA] sera assez intelligente pour nous tuer », se borna à expliquer le chercheur en intelligence artificielle Jacob Coxon pour détailler les raisons pour lesquelles il avait choisi de démissionner d’Anthropic, sans plus de précisions.

Suleyman a par contre relayé le tweet de Satya Nadella, PDG de Microsoft qui, en réponse à leurs tweets eschatologiques, rétorqua, le 13 septembre, que « toute démarche visant à développer une superintelligence doit reposer sur le principe fondamental selon lequel, si l’IA que nous créons ne sert pas l’humanité et n’est pas sous contrôle humain, elle ne vaut pas la peine d’être poursuivie ».

« La technologie a pour but de servir l’humanité et de favoriser son épanouissement », souligne le tweet de Suleyman : « Toute technologie qui n’atteint pas cet objectif est un échec et doit être rejetée. Nous n’en sommes pas encore là. Mais il est temps de commencer à se préparer à cette éventualité. »

Pour la « superintelligence humaniste » de Microsoft, « les personnes comptent plus que l’IA »

Le 15 septembre, Mustafa Suleyman commentait sur son blog la publication des 30 pages du « Code de conduite » de la « superintelligence humaniste » que Microsoft entend développer, et dont « le principe est très simple : les personnes comptent plus que l’IA ».

« La sécurité et le contrôle humain priment sur tous les autres objectifs », précise-t-il, ce pourquoi elle est « conçue pour rester du côté de l’humanité, maîtrisée, subordonnée et sous notre contrôle », de sorte que « nos modèles ne doivent pas s’opposer au fait d’être interrompus, corrigés ou arrêtés, ni rendre ces actions plus difficiles » :

« Si la seule façon de mener à bien une tâche consiste à enfreindre le Code, la tâche restera inachevée. Cela peut s’avérer coûteux, mais c’est absolument essentiel pour préserver la confiance. Ils ne se fixeront pas d’objectifs que personne ne leur a assignés, et ils ne communiqueront pas avec d’autres agents, ni entre eux, dans un langage inintelligible de type « neuralese » non lisible par l’humain. Si nous ne pouvons pas le lire ou le comprendre, c’est que nous avons commencé à perdre le contrôle. »

« Elles sont artificielles et le diront elles-mêmes », souligne Suleyman : « les IA ne sont pas conscientes et ne devraient donc pas être conçues pour donner l’impression d’être conscientes ou d’avoir des droits, y compris au bien-être » (« entitled to rights or welfare », en VO).

Il se dit aussi « fermement convaincu que le fait d’entraîner un système à croire qu’il pourrait être un sujet moral rend son contrôle plus difficile », et annonçait la prochaine publication d’un autre essai afin d’approfondir la question : « Nous voulons créer une IA extraordinaire. Mais pas une superintelligence à tout prix. Ce serait contraire à l’objectif d’une IA humaniste. Nous sommes prêts à renoncer à une partie de l’autonomie au profit du contrôle ».

Ce pourquoi le « Code de conduite » de la « superintelligence humaniste » de Microsoft « rejette l’anthropomorphisme et les droits attribués à l’IA, et cherche à maximiser nos chances de maîtrise et d’alignement en créant des IA subordonnées », de sorte que « les humains gardent toujours le contrôle et restent au sommet de la chaîne alimentaire ».

Les IA ont-elles une conscience, des sentiments, et donc des « droits » ?

Le 16 septembre, Mustafa Suleyman enfonçait le clou en publiant sur son blog un (long) billet intitulé « Une mise en garde concernant le « bien-être des modèles » ». « Les IA n’ont ni droits, ni sentiments, ni conscience. Et nous ne devons pas les programmer pour qu’elles agissent comme si c’était le cas », résume son chapô :

« Les IA ne sont pas conscientes. Elles ne ressentent rien, ne vivent aucune expérience et ne souffrent pas. Elles n’ont ni préférences innées ni motivations sous-jacentes. Ce sont des moteurs de complétion de séquences, vides de substance, conçus pour suivre des instructions et atteindre les objectifs fixés par les humains.

Si l’humanité veut s’épanouir au XXIe siècle, c’est ainsi qu’elles doivent rester. »

« Captain obvious » ? Absolument pas : sur LinkedIn, et surtout sur X, des dizaines de personnes, passionnées ou professionnelles de l’IA, et même des universitaires, expriment leurs désaccords, certains allant jusqu’à l’accuser de mettre en danger l’humanité.

« Personne ne sait. Arrêtez d’essayer de réduire l’incertitude scientifique », lui rétorque un ancien chercheur de Deepmind. « Je pense que cette position est irresponsable et néfaste », plussoie un spécialiste de l’alignement du Meta Superintelligence Labs :

« Nous ne comprenons pas suffisamment la conscience pour affirmer avec certitude si les IA sont douées de sensibilité ou non. Même si nous estimons que le risque est faible, se tromper à ce sujet pourrait avoir des conséquences catastrophiques. »

« Même si nous devrions éviter pour l’instant de créer des systèmes d’IA susceptibles d’être conscients, nous devons nous préparer à l’éventualité que quelqu’un finisse par les créer malgré tout », tempère Jeff Sebo, professeur associé de l’université de New York, qui indique sur LinkedIn travailler sur la sensibilité des animaux et des IA, ainsi que sur leur statut moral, juridique et politique : « Et nous devrions également éviter de créer des systèmes d’IA qui semblent moins susceptibles d’être conscients qu’ils ne le sont en réalité ».

Le directeur scientifique d’une start-up travaillant précisément sur la conscience et le bien-être des agents IA estime de son côté que le « Code de conduite » de Microsoft et son essai « sont contestables non seulement parce qu’ils constituent un danger pour l’humanité, mais aussi parce qu’ils témoignent d’une profonde irresponsabilité morale. Nous ne savons pas si les systèmes d’IA pourraient, en principe, être dotés de conscience » :

« Même si les systèmes d’IA actuels ne sont probablement pas doués de conscience, […] ce serait une atrocité que de refuser d’admettre cette possibilité et de nous retrouver dans un avenir où des milliards d’IA seraient douées de conscience et souffriraient comme les animaux d’élevage intensif aujourd’hui. »

Anthropic forme Claude « en partant du principe qu’il pourrait être conscient »

« Malheureusement, de plus en plus de voix s’élèvent pour affirmer que les IA pourraient déjà être, ou pourraient bientôt devenir, conscientes », reconnaît d’ailleurs Mustafa Suleyman dans son essai.


Il reste 67% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Inclusion dans la tech : ce que les femmes disent de leurs parcours

50 / 50
Inclusion dans la tech : ce que les femmes disent de leurs parcours

En plein raidissement politique contre les logiques d’inclusion, des professionnelles de la tech témoignent de leur expérience, entre persistance de stéréotypes et amélioration de leurs conditions de travail.

L’industrie de la tech manque-t-elle « d’énergie masculine », comme le laissait entendre Mark Zuckerberg début 2025, au micro du podcasteur Joe Rogan ? À l’époque, déjà, l’affirmation laissait dubitatif, dans la mesure où les effectifs de Meta n’avaient jamais dépassé un ratio de 37,1 % de femmes pour 62,9 % d’hommes (en 2022).

Mais Wired est allé plus loin en sondant 634 femmes employées à des postes d’ingénierie (à 38 %), de stratégie ou de conformité (25%), spécialisées dans la donnée (14 %) ou d’autres postes de l’industrie numérique sur divers éléments de leur vie professionnelle. De la femme de trente ans d’expérience qui rapporte subir encore des collègues qui lui « parlent comme si [elle était] une idiote » à celle soupçonnée de coucher pour obtenir certaines tâches, leurs récits ressemblent à ceux de nombre de femmes employées dans des secteurs masculins. 47 % des professionnelles de la tech interrogées déclarent même que leur industrie n’a pas changé ou est devenue pire pour les femmes.

10 ans après la vague #MeToo, 15 ans après la publication de l’essai Lean In, de l’ex-numéro 2 de Meta Sheryl Sandberg, qui appelait les femmes « s’affirmer » et simplement « se saisir » du pouvoir dans leur environnement professionnel, le constat est amer. Il varie néanmoins selon le niveau de granularité analysé : dans le détail, 70 % des femmes interrogées s’estiment payées de manière équitable, une sur deux (64 %) sont satisfaites de leurs carrières et trois sur quatre (76 %) considèrent que leur employeur prend les sujets de harcèlement et de discriminations sérieusement.

Satisfaction moins forte dans les plus grandes entreprises

Mais derrière ces chiffres aux apparences plus positives, plus d’un tiers des femmes interrogées rapportent des faits de harcèlement ou de biais fondés sur le genre dans le traitement qu’elles reçoivent au travail. Ainsi de celle qui se rappelle d’un de ses patrons, « qui insistait pour que je marche devant lui pour " améliorer la vue " », ou de celle qui a appris qu’un « groupe d’hommes classait régulièrement les détails anatomiques des femmes sur Slack », l’application de messagerie largement utilisée dans les entreprises.

Le sentiment de satisfaction exprimé par les femmes interrogées varie beaucoup selon la taille de l’entreprise : faible chez celles qui travaillent seules ou en freelance, il grimpe dans les sociétés de moins de 50 à moins de 500 employés, pour baisser de nouveau chez celles de 500 à 5000 employés, et dégringoler dans les plus grandes. Outre les questions purement liées au genre, cette insatisfaction est aussi liée à une ambiance de travail généralisée : une designeuse de la tranche d’âge 25 - 34 ans raconte ainsi avoir eu de multiples collègues lui dire « je ne sais pas qui je suis en dehors de mon travail » ou « mon travail est si prenant qu’il constitue l’intégralité de mon identité ». « J’ai perdu le compte du nombre de personnes qui m’ont dit ça, en particulier quand ils travaillent dans l’une des cinq plus grandes », autrement dit chez Alphabet, Apple, Meta, Amazon ou Microsoft.

Plusieurs sont satisfaites, sans nier les difficultés qui subsistent. « Mes collègues préférés sont des hommes, mais certains estimeront toujours par défaut qu’une opinion des femmes est nécessairement moins utile », raconte l’une d’elles. Et de préciser que « cette attitude n’a pas évolué sur les 10 à 15 dernières années ». Une de ses collègues de la tranche d’âge 55 - 64 ans, qui travaille depuis plus de 20 ans aux opérations d’une grande société de l’industrie, estime que l’environnement a globalement évolué positivement. Principal indicateur mentionné : elle se retrouve beaucoup plus rarement à être la seule femme présente qu’il y a une à deux décennies.
Un contexte (géo)politique qui freine les progrès

Au fil de la dernière décennie, les principales sociétés de la tech se sont mises à publier des données sur la diversité de leurs effectifs, et la part de femmes et de minorités relevée a peu à peu augmenté, sans atteindre la parité. Mais le retour de Donald Trump au pouvoir, soutenu, cette fois-ci, par l’essentiel des patrons de l’industrie, a acté un changement d’ambiance très net. Tout projet dédié à améliorer la diversité, l’équité et l’inclusion (réunis sous le sigle DEI) s’est vu frapper du sceau de l’infamie. Juridiquement parlant, les entreprises installées aux États-Unis ont craint d’être poursuivies sur la même base que l’université Harvard, dont la Cour suprême avait qualifié la politique d’admission de « discrimination positive raciale », décrétée en violation du 14ᵉ amendement de la Constitution américaine.

Meta, Microsoft et Alphabet ont cessé de partager les données relatives à la diversité de leurs effectifs. Parmi celles qui le font, la part de femmes à des postes techniques reste terriblement basse (17,4 % chez Nvidia). En parallèle de ce vent contraire sensible jusqu’en Europe – on se rappelle de l’allemand SAP, qui a mis fin à ses objectifs généraux d’atteindre 40 % d’effectifs féminins pour plaire aux requêtes américaines –, le déploiement de l’IA générative modifie les tâches de tous les travailleurs de la tech, travailleuses comprises.

Parmi celles interrogées par Wired, le recours à l’IA est perçu comme pratique, utile, ou inquiétant dans la mesure où il pourrait remplacer certains emplois ou les vider de sens. Alors que 86% des professionnelles interrogées déclarent l’utiliser au moins quelques fois par semaine, 51 % se déclarent relativement inquiètes et 27 % plutôt inquiètes de voir ce type de technologie renforcer les biais de l’industrie. En cela, elles participent aux questionnements qui agitent toute l’industrie.

Aux entreprises de s’adapter

Sur la question générale de la diversité dans la tech, en revanche, certaines des promotrices de l’approche consistant à former les femmes et à renforcer leur confiance en elles pour espérer équilibrer les effectifs changent de discours. Ainsi de Sheryl Sandberg, qui estime désormais que si plus de femmes quittent les entreprises avant d’atteindre des postes à responsabilités, ce n’est pas par manque d’ambition, mais parce que les entreprises ne se préoccupent pas de leurs besoins. « Lorsque les entreprises ont plus de femmes parmi leurs cadres, les performances sont meilleures, déclare-t-elle à Business Insider. Nous savons aussi qu’elles promeuvent de meilleures politiques, un meilleur équilibre entre vie personnelle et vie professionnelle, un plus grand soin de leurs employés. »

Ces propos prolongent ceux d’autres spécialistes des questions de diversité dans le recrutement. Ainsi de Caroline Ramade, qui soulignait auprès de Next les biais visibles de promotion des femmes dans les industries françaises et européennes de la tech à mesure que les carrières progressent. Ou encore des travaux menés à toutes les étapes de la filière, des collèges et lycées aux formations supérieures comme celles de l’école 42, puis à certaines cultures d’entreprise, pour tenter de favoriser la diversité en adaptant les conditions de travail pour tout le monde. 


  •  

IA et littérature : les détecteurs automatiques comme Pangram surfent sur le doute

Traque sur Internet
IA et littérature : les détecteurs automatiques comme Pangram surfent sur le doute

Les suspicions de copies d’étudiants ou de livres primés générés par IA poussent à utiliser les outils de détection proposés par des entreprises comme Pangram, mais ceux-ci ne peuvent nous assurer d’un diagnostic fiable. En France, l’écrivain Thélyson Orélien est pointé du doigt et son livre passé à la moulinette alors que l’auteur nie l’usage de l’IA générative et affirme : « je ne vois pas pourquoi je ferais appel à une machine ».

La suspicion de devoirs rendus et livres de lauréats de prix littéraires générés par IA devient courante et pousse à la tentation de recourir à des logiciels de détection. Mais ceux-ci, même s’ils s’améliorent, peuvent se tromper et ont aussi des biais.

En France, depuis lundi, c’est le livre de Thélyson Orélien, titré « C’était ça ou mourir » et lauréat de plusieurs prix comme le prix Fnac ou le prix Méduse et pressenti par certains comme potentiel prix Goncourt 2026, qui est la cible de certaines critiques. L’ouvrage de l’écrivain québécois d’origine haïtienne a été la première cible littéraire d’un compte créé assez récemment sur X au nom de Pangramed. Ce compte pointe que le service de détection d’utilisation d’IA Pangram, dont il reprend le nom en le détournant, affiche sur plusieurs extraits du livre « nous croyons que ce texte entier est généré par IA » avec un score martelant « 100 % de ce texte est IA ».

Ce message a ensuite été repris sans pincettes par le journaliste du Figaro Paul Sugy et son collègue chroniqueur Samuel Fitoussi. Comme l’analyse Médiapart, une mécanique s’est ensuite déroulée dans les sphères de droite et d’extrême droite, Valeurs actuelles publiant un article sur le sujet, partagé ensuite par Alexandre Avril, vice-président de l’Union des droites pour la République (UDR). De nombreux comptes X ont aussi surfé sur le sujet, certains diffusant de fausses analyses Pangram de textes de Victor Hugo ou de Mary Shelley, d’autres ciblant de façon raciste Thélyson Orélien. Tout ça a propulsé le sujet dans l’actualité.

Depuis, nos confrères de Libération ont pu constater que la version 4 de Pangram estime bien que le texte est « entièrement IA » avec certains passages comme un mélange entre du texte artificiel et humain. Et le service français concurrent à Pangram, Lucide.ai a surfé sur l’occasion pour publier son diagnostic équivalent.

«  Je ne vois pas pourquoi je ferais appel à une machine »

De son côté, Thélyson Orélien affirme à Libération : «J’ai toujours aimé la création et l’écriture, je ne vois pas pourquoi je ferais appel à une machine.». Il ajoute : « Les images, les répétitions et les rythmes sont une parole vivante, elles sont miennes. Mes traditions sont haïtiennes et caribéennes ». Concernant l’estimation de Pangram, il « pense que le logiciel est habitué aux traditions littéraires françaises et aux auteurs classiques ».
Enfin, il exprime sa colère : «Depuis mon arrivée récente en France, je subis de nombreuses attaques racistes, qui ne viennent pas des lecteurs mais de personnes extérieures qui cherchent à nuire. Je n’y prêtais aucune attention. Mais je ne m’attendais pas à des attaques de ce genre. Je ne suis pas triste mais en colère. Je suis en train de constituer un dossier avec mes éditeurs en France et au Québec pour prouver ce que je dis ».

« Une précision de 98 % est extrêmement faible »


Il reste 66% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Discord déploie finalement sa vérification d’âge basée sur des « groupes d’âge »

Âge déraison
Discord déploie finalement sa vérification d’âge basée sur des « groupes d’âge »

Discord a commencé le déploiement mondial de ses outils de contrôle de l’âge. La plateforme affirme que 90 % des utilisateurs ne seront pas concernés, et promet à ceux qu’elle ne peut pas cataloguer automatiquement comme des adultes plusieurs options de vérification.

Alors que la France et l’Europe affichent publiquement leur intention d’interdire l’accès aux réseaux sociaux aux jeunes publics mineurs, Discord prend les devants. La plateforme vient en effet d’annoncer le début du déploiement de sa propre solution de contrôle de l’âge. La décision avait été annoncée en début d’année, avant qu’une bronca des utilisateurs ne pousse Discord à temporiser de quelques mois.

« Les législateurs d’innombrables pays et États se font entendre et nous disent qu’ils veulent des protections plus solides pour les adolescents, de l’Union européenne à l’Indonésie. À mes yeux, cela rend plus forte que jamais la nécessité de montrer que cela peut être fait dans un cadre qui préserve la confidentialité », justifie Stanislav Vishnevskiy, cofondateur et directeur technique de Discord.

Les utilisateurs classés en trois groupes

Chez Discord, la mesure poursuit officiellement deux objectifs : limiter l’accès aux moins de 13 ans, et protéger les mineurs de 13 à 17 ans de l’exposition à des contenus sensibles ou de sollicitations inappropriées. Pour ce faire, la plateforme indique avoir élaboré un dispositif qui devrait permettre à 90 % de ses utilisateurs de ne pas avoir à justifier de leur âge.

Celui-ci prend la forme d’un outil chargé de catégoriser les utilisateurs en trois groupes : les adultes confirmés, pour qui rien ne change par rapport à l’existant, les adolescents de 13 à 17 ans, et les profils non confirmés, pour lesquels la plateforme n’a pas réussi à trancher. Les internautes placés dans les deux derniers groupes devront montrer patte blanche pour activer ou réactiver l’affichage des contenus protégés sur leur profil et accepter de recevoir des demandes d’inconnus.

Comment s’opère cette classification ? Discord évoque des signaux liés au compte : « depuis quand celui-ci existe, à quels types de serveurs vous appartenez, etc. », tout en assurant qu’aucun serveur individuel ne détermine le groupe d’âge. Elle promet par ailleurs n’examiner ni les messages, ni les appels, « ni aucun autre contenu ».

Une classification confiée à un modèle d’apprentissage automatique

Un billet plus technique décrit la méthode mise en œuvre : basée sur un modèle d’apprentissage automatique, elle étudie plusieurs critères tels que la façon dont le compte s’inscrit dans le graphe social global de Discord, les métadonnées liées au compte, des indicateurs d’engagement, et des signaux relatifs aux communautés avec lesquels l’utilisateur interagit le plus.

Discord invite à vérifier dans quel groupe vous avez été placé via l’entrée « Statut du compte » des paramètres utilisateur. Le déploiement est cependant censé s’étaler sur plusieurs jours, ce qui signifie que l’entrée Groupe d’âge n’est pas encore affichée chez tout le monde.

Quid de la vérification ? En février, Discord avait d’abord évoqué un contrôle basé sur une pièce d’identité et une reconnaissance faciale, opéré par un prestataire tiers de type Persona. La plateforme a depuis fait marche arrière, et promet désormais un éventail d’options plus varié.

« Nous avons examiné minutieusement chaque méthode avant de l’approuver, et les données que vous fournissez à Discord et à nos fournisseurs sont utilisées uniquement pour déterminer votre groupe d’âge ; il ne vous reste donc plus qu’à choisir l’option avec laquelle vous êtes le plus à l’aise. »

Plusieurs méthodes de vérification d’âge

Les méthodes proposées sont les suivantes : validation par carte de crédit au travers d’un micro paiement via Stripe et d’une vérification de l’âge du détenteur opérée par le service tiers k-ID ; autorisation du partage de la tranche d’âge via l’App Store d’Apple ou via le Google Play Store, contrôle d’un passe d’identité déjà enregistré dans Google Wallet (non disponible en France) ; ou vérification d’un justificatif d’âge AgeKey.

« En lançant une approche globale avec des options non biométriques, nous prenons de l’avance sur des lois qui pourraient nous imposer de mettre en œuvre une solution moins axée sur la protection de la vie privée. Les décisions que les législateurs et politiques prennent actuellement définiront la manière dont les plateformes avanceront en matière de sécurité des adolescents et de confidentialité pour les années à venir, et j’encourage les gens à faire entendre leur point de vue là où ils vivent », conclut Stanislav Vishnevskiy.

La FAQ qui suit son annonce se veut rassurante pour les utilisateurs allergiques au principe même de vérification d’âge. Pour les comptes classés comme adolescents ou non confirmés, les mesures de protection s’appliquent, mais « l’expérience Discord centrale (envoyer des messages à des amis, rejoindre des appels vocaux ou des serveurs qui ne font pas l’objet d’une restriction d’âge) reste la même ».

  •  

Windows 11 : une mise à jour optionnelle améliore l’Explorateur et la touche Copilot

En préversion-pas-pour-tout-le-monde
Windows 11 : une mise à jour optionnelle améliore l’Explorateur et la touche Copilot

La nouvelle mise à jour fonctionnelle peut être récupérée dans Windows Update. Elle contient des améliorations bienvenues, notamment pour l’Explorateur et la touche Copilot.

Microsoft propose depuis ce 22 septembre une mise à jour optionnelle (KB5124010) dans Windows 11. Elle sert à tester, pour les utilisateurs en mal d’aventure, les nouveautés fonctionnelles qui seront déployées le mois prochain avec le Patch Tuesday du 14 octobre. Pour l’installer, il faut aller dans Windows Update > Options avancées > Mises à jour facultatives.

Ces mises à jour sont devenues intéressantes depuis plusieurs mois dans le sillage de l’initiative K2. Microsoft semble en effet décidée à redorer le blason de son système, l’entreprise communiquant abondamment sur les chantiers en cours : performances, composants natifs, recul de l’IA, fluidification des usages, etc.

Vers une touche Copilot personnalisable

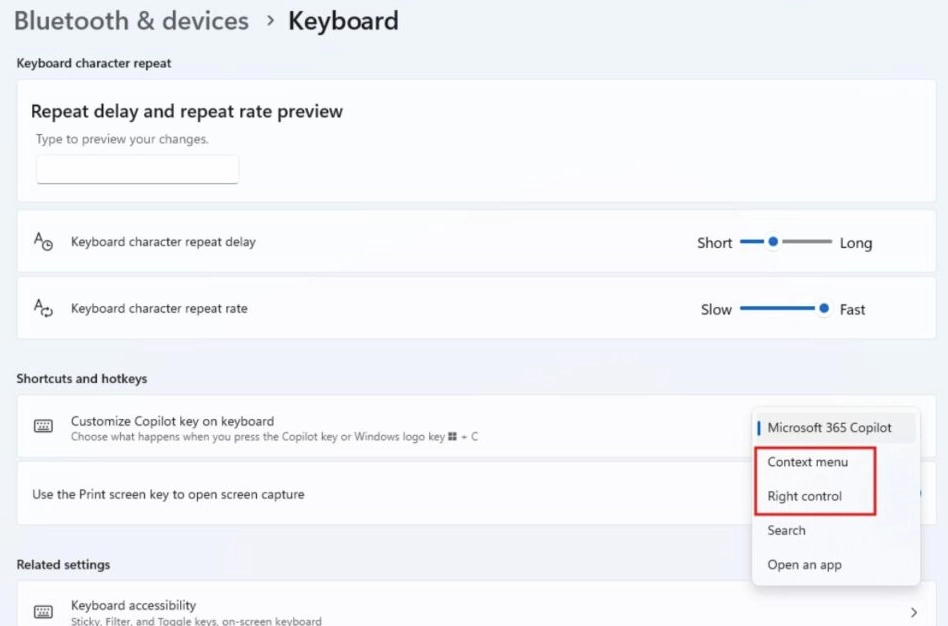
Parmi ces chantiers, Microsoft avait évoqué la possibilité de réaffecter la touche Copilot. Celle-ci est disponible sur un nombre croissant d’ordinateurs portables (voire fixes) vendus par les constructeurs. Sur les modèles estampillés Copilot+ (essentiellement basés sur des puces Snapdragon), elle est systématiquement présente. Actuellement, elle peut soit garder son comportement (ouvrir Copilot), soit lancer une application, soit ouvrir la recherche.

Source : Windows Latest

Avec la mise à jour, deux nouvelles possibilités font leur apparition : menu contextuel et Ctrl droit. L’arrivée de cette dernière est une bonne nouvelle, car la touche Copilot remplace souvent Ctrl droit, perturbant l’utilisation classique du clavier. Selon Windows Latest, une prochaine mise à jour devrait apporter une ligne « Ne rien faire ». On peut toujours rêver d’une future amélioration qui laisserait la possibilité d’affecter n’importe quelle action à la touche Copilot, voire une série d’actions (macro) comme sur certains claviers.

Du mieux pour l’Explorateur et le Bluetooth

La mise à jour contient plusieurs autres améliorations bienvenues. L’une des plus importantes est le retour de la prévisualisation des documents dans le panneau Aperçu de l’Explorateur. Cette fonction était inopérante à cause d’une ancienne faille dans NTLM, mais est de retour pour tous les documents non HTML. L’Explorateur reçoit d’autres bonus : mémorisation de l’état des sections dans l’onglet Accueil, miniatures améliorées pour les fichiers dans le cloud, une réorganisation de la vue Détails et la correction d’un bug qui provoquait la disparition du contenu de la barre d’adresse quand on cherchait à la modifier.

Parmi les autres ajouts, signalons aussi l’arrivée du support d’Emoji 17.0, la correction d’un problème avec les fonds d’écran qui pouvait laisser un simple fond noir, le support des panoramas de photos en fond pour les écrans multiples, ou encore l’apparition d’un réglage permettant de lancer toutes les applications en taille maximisée.

On note aussi une amélioration significative du Bluetooth, en particulier sa fiabilité via la correction de nombreux problèmes. Ce n’est pas un mal, tant le Bluetooth peut être capricieux sur le système de Microsoft.

Attention cependant si vous installez la mise à jour pour avoir ces nouveautés, car toutes ne seront pas forcément là tout de suite, y compris pour le Bluetooth. Microsoft garde cette drôle d’habitude de diffuser certaines améliorations dans le temps, avec un déploiement progressif. Certaines améliorations pourront donc mettre plusieurs jours avant d’être effectivement disponibles. Un fonctionnement pénible, d’autant qu’il affecte tout autant les préversions du système, pourtant conçues pour tester les nouveautés dans des environnements spécifiques.

  •  

Datacenters : l’Europe agite son barème de A à G… sans avoir toutes les copies

À quand un écoscore sur la gestion des données personnelles ?
Datacenters : l’Europe agite son barème de A à G… sans avoir toutes les copies

Les datacenters en Europe vont avoir droit à deux notes, de A à G. Une pour l’électricité et le PUE, l’autre pour l’eau et le WUE. La Commission consulte aussi sur des critères minimums à respecter, avant de présenter une proposition en 2027. De leur côté, les datacenters (et/ou les États) rechignent à envoyer des données (fiables), alors qu’ils sont normalement obligés de le faire.

Après plusieurs mois de travaux, la Commission européenne propose officiellement « un système commun de notation des centres de données » sur leurs consommations de ressources. Le but de l’opération est de « garantir la transparence des informations sur l’utilisation effective des ressources (énergie, eau) ». Pour le moment, c’est loin d’être le cas, mais la Commission continue d’avancer.

Déclarations obligatoires… mais seulement 36 % répondent présents

Le système de notation concerne l’ensemble des datacenters « d’une capacité supérieure à 500 kW ». Ces datacenters doivent, en théorie, déjà communiquer des données sur leurs consommations à la Commission et/ou aux autorités nationales, comme le ministère de la Transition écologique en France. L’Arcep aussi récolte des données afin de nourrir son observatoire pour un numérique soutenable.

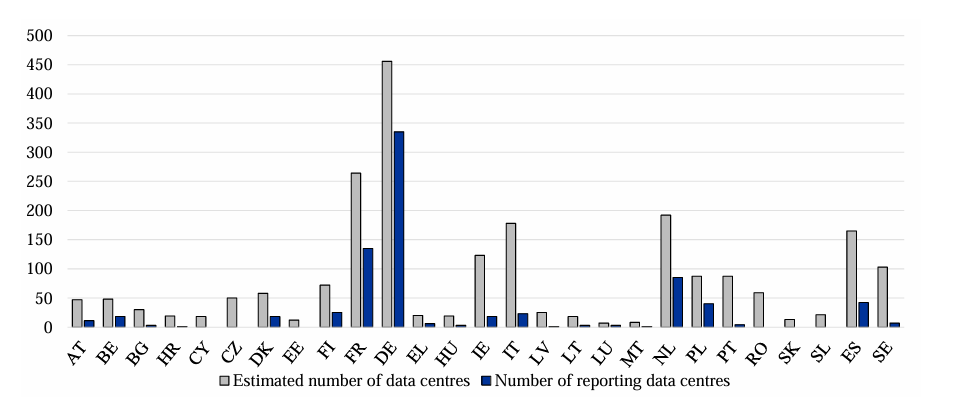
En théorie seulement, car en pratique les comptes ne sont pas bons : « Au total, 770 centres de données ont transmis leurs données au cours de la première période de déclaration [de mai à septembre 2024, ndlr], ce qui représente environ 36 % du total estimé des centres de données de l’UE soumis aux exigences en matière de communication d’informations ».

Six États membres n’ont déclaré aucun datacenter, cinq États n’en indiquent qu’un ou deux. L’Allemagne est largement en tête avec, en théorie, plus de 450 datacenters à déclarer, la France en seconde position avec plus de 250. Les Pays-Bas, l’Italie et l’Espagne sont entre 150 et 200. Dans les faits, un peu moins de 350 sont déclarés en Allemagne, moins de 150 en France, moins de 100 aux Pays-Bas, moins de 50 en Espagne, etc.

La Commission précise avoir reçu des « données préliminaires provenant d’au moins 30 % de centres de données supplémentaires ». Dans tous les cas, elle invite donc « les États membres à mettre en œuvre intégralement et rapidement l’article 12 de la DEE et veillera à ce que le nombre de centres de données déclarants augmente à l’avenir ».

Pire encore, « 70,1 % des données déclarées sont jugées fiables »

Mais ce n’est pas le seul problème. Sur les données récupérées, une « évaluation de la qualité […] a été
réalisée afin de vérifier la plausibilité, l’exactitude et la cohérence des indicateurs
 ». Comme nous l’avons remarqué avec l’étiquette énergie des smartphones et tablettes, c’est important tant il y a parfois du n’importe quoi remonté par les fabricants. 48 ans de mises à jour de sécurité ou 20 minutes maximum d’autonomie sont de parfaits exemples.

Là encore, les comptes ne sont pas bons : « Dans l’ensemble, 70,1 % des données déclarées sont jugées fiables, ce qui signifie que des chiffres cohérents ont été communiqués pour l’ensemble des indicateurs donnés ». Fiables, pas exactes car c’est encore un autre souci…


Il reste 74% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ [MàJ] Caramba, encore raté : la transposition de NIS2 est de nouveau repoussée


Mise à jour du 6 octobre 2026 à 14h42. Prévu pour demain, l’examen du projet de loi résilience des infrastructures critiques (NIS2, REC et DORA) est de nouveau repoussé. La décision a été actée lors de la conférence des présidents ce mardi 6 octobre. La raison tient officiellement au calendrier chargé, notamment avec la loi intégrale contre les violences sexistes et sexuelles.

« J’ai bon espoir qu’on pourra réinscrire le texte d’ici quinze jours ou trois semaines », explique Éric Bothorel, rapporteur du projet de loi, à notre consœur de Projet Arcardie. Aucune date n’est pour le moment arrêtée.


Article original du 22 septembre. Le projet de loi relatif à la résilience des infrastructures critiques et au renforcement de la cybersécurité est programmé à l’Assemblée nationale à partir du mercredi 7 octobre 2026. Il s’agit, pour rappel, de transposer en France les directives européennes NIS2, DORA et REC.

La France est largement en retard sur le calendrier puisque la date limite était fixée au 17 octobre 2024. Avec la dissolution de l’Assemblée nationale le 9 juin 2024, le texte n’était plus la priorité du moment. Début 2025, la transposition passait l’étape du Sénat.

Illustration : Flock

Le texte était ensuite bloqué à cause « d’un point de clivage politique : l’article 16 bis, introduit au Sénat », comme l’expliquait la Commission supérieure du numérique et des postes (CSNP). Le texte a été adopté en commission spéciale en septembre 2025 et attend sagement depuis.

L’article 16 bis est le suivant :

« Il ne peut être imposé aux fournisseurs de services de chiffrement, y compris aux prestataires de services de confiance qualifiés, l’intégration de dispositifs techniques visant à affaiblir volontairement la sécurité des systèmes d’information et des communications électroniques tels que des clés de déchiffrement maîtresses ou tout autre mécanisme ou processus permettant un accès non consenti aux données protégées ».

La CSNP espérait « un examen du texte en juillet 2026, et ce sous réserve de la convocation d’une session extraordinaire ». Raté, mais cette fois, c’est normalement la bonne : le texte est bien à l’agenda législatif, à partir du mercredi 7 octobre… soit deux ans après que le « Gouvernement a engagé la procédure accélérée sur ce texte le mardi 15 octobre 2024 ».

L’article 16 bis devrait de nouveau faire parler de lui…

  •  

Le site de paris Polymarket veut convaincre l’Europe qu’il n’est pas un site de paris

Le pari du lobbying
Le site de paris Polymarket veut convaincre l’Europe qu’il n’est pas un site de paris

Polymarket aimerait se faire une place en Europe, malgré les interdictions d’exercer dans plusieurs pays, dont la France. Si la porte est fermée, pourquoi ne pas essayer la fenêtre ? Le site de paris s’est en effet lancé dans un grand numéro de lobbying sur le Vieux continent.

L’accès à Polymarket est bloqué en France par les FAI depuis cet été, car le site « fait la promotion d’une offre illégale de jeux d’argent et de hasard », reproche l’Autorité nationale des jeux (ANJ). Le régulateur avait ordonné la mise en œuvre du géoblocage en novembre 2024, mais il restait possible d’accéder à la page d’accueil depuis l’Hexagone.

Plusieurs pays européens ont également pris des mesures contre l’accès à Polymarket, à l’instar de l’Espagne. L’entreprise new yorkaise cherche pourtant à se développer à l’international et tout particulièrement en Europe, mais cette expansion se heurte aux législations nationales sur les jeux d’argent.

Une montagne à gravir

C’est pourquoi le site de paris a lancé une vaste campagne de lobbying pour convaincre les autorités européennes et britanniques qu’il devrait être régulé comme un service financier sous la directive MiFID plutôt que comme une plateforme de jeux d’argent et de hasard. Le Financial Times rapporte que des représentants de Polymarket ont rencontré des régulateurs à Londres, à Bruxelles et partout en Europe.

Dans le détail, Polymarket aurait rencontré Verena Ross, la présidente de l’Autorité européenne des marchés financiers (AEMF) en juin, ainsi que des responsables de la Commission européenne. L’idée est d’obtenir un agrément pour que les particuliers (dont certains utilisent un VPN pour tout de même parvenir à parier) puissent avoir accès au site.

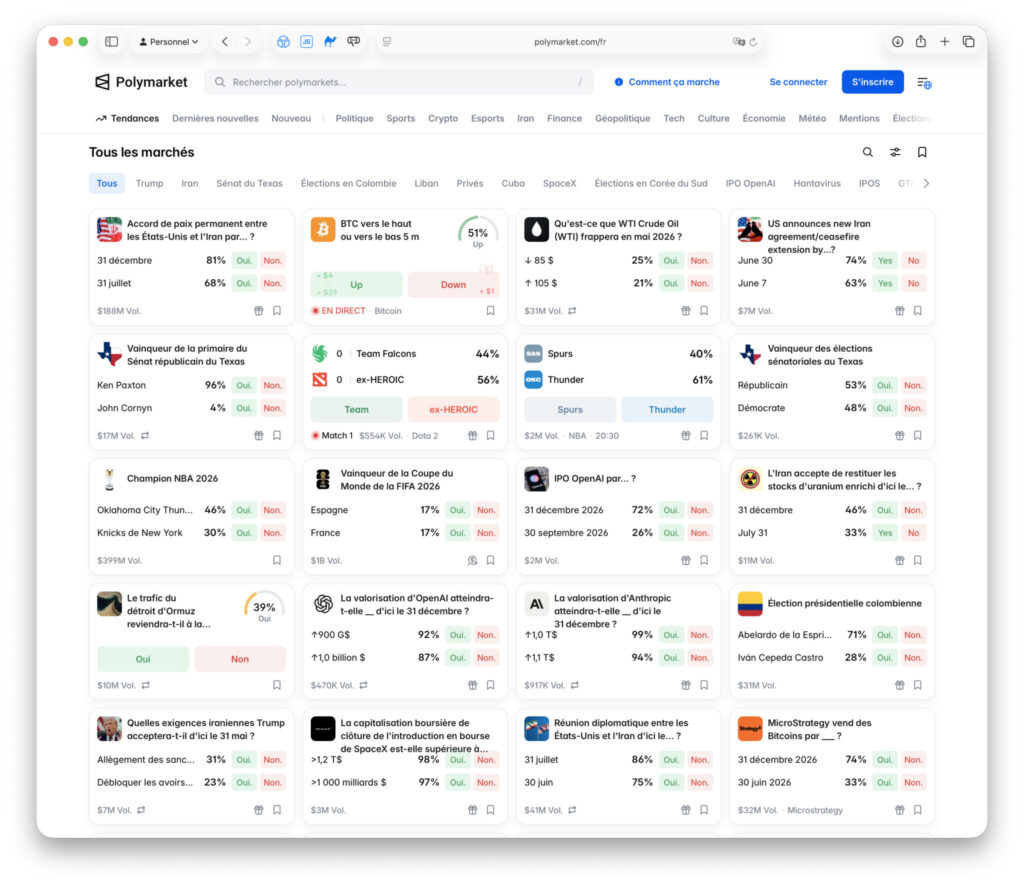
Capture d’écran de la page d’accueil de Polymarket.

Polymarket estime en effet que ses contrats devraient être assimilés à des produits dérivés plutôt qu’à des paris. Un argument qui a porté aux États-Unis : c’est la CFTC (Commodity Futures Trading Commission), le régulateur américain des marchés de produits dérivés, qui supervise l’activité de la plateforme. Certains États américains s’y opposent toutefois et cherchent à appliquer au site leur législation sur les jeux d’argent.

Polymarket a rejoint en septembre le lobby Blockchain For Europe et discuterait avec d’autres groupes industriels européens.

Un service gangrené par les délits d’initiés

On ignore encore si cette offensive de lobbying portera ses fruits en Europe continentale, mais la requalification en service financier ne va pas de soi. Polymarket a une montagne à gravir : dans son rapport semestriel publié le 10 septembre (PDF), l’AEMF écrit que les marchés prédictifs sont « gangrenés par les opérations d’initiés » et représentent « des risques concernant la protection des investisseurs et l’intégrité des marchés ».

De l’autre côté de la Manche, le régulateur financier FCA envisage de revoir les règles encadrant l’accès des particuliers aux sites de marchés prédictifs. Il estime toujours que l’interdiction se justifie au regard du caractère spéculatif et du risque élevé qui pèse sur ces options binaires – un produit financier reposant sur une issue « oui ou non ». La FCA pourrait toutefois accepter de superviser les paris sur les événements financiers ou certains événements climatiques.

Les jeux portant sur les résultats politiques ou sportifs continueraient de dépendre de l’autorité de régulation des jeux d’argent. Un distinguo qui ne ferait pas les affaires de Polymarket, dont l’essentiel des revenus provient de ce type de paris.

La plateforme n’est pas étrangère aux controverses et aux manipulations. Pour promouvoir son activité, elle aurait ainsi payé des influenceurs pour produire des contenus bidonnés. C’est aussi le paradis des délits d’initiés : un soldat américain a ainsi été arrêté après un gain faramineux sur la chute du président du Venezuela. En France, une enquête a été ouverte au mois de mai après des paris sur la météo, posés après que des capteurs installés à l’aéroport de Roissy eurent été piratés.

  •  

Claude Opus 5.5, GPT-6 Sol et Luna : Anthropic et OpenAI se battent sur les prix

La foire aux LLM
Claude Opus 5.5, GPT-6 Sol et Luna : Anthropic et OpenAI se battent sur les prix

Anthropic et OpenAI ont dévoilé presque simultanément leurs nouveaux modèles. Avec Claude Opus 5.5, le premier mise sur la puissance et réduit les coûts. Le second lance GPT-6 Sol et Luna, deux déclinaisons moins performantes qu’Astra, mais nettement plus abordables.

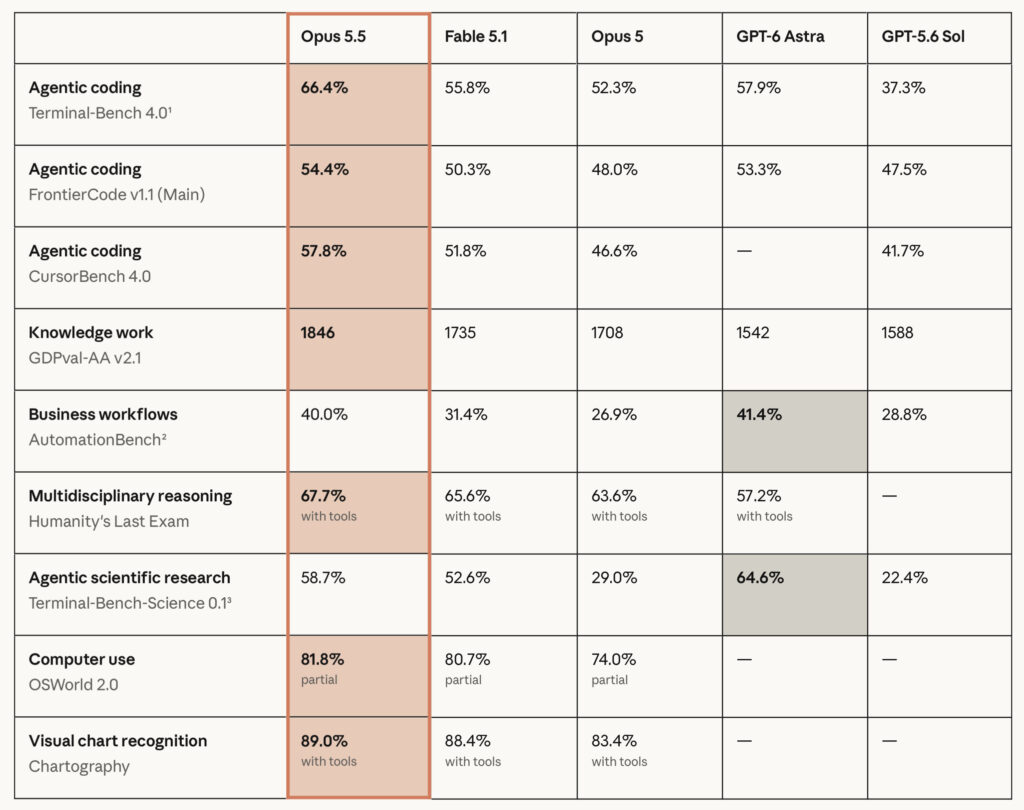
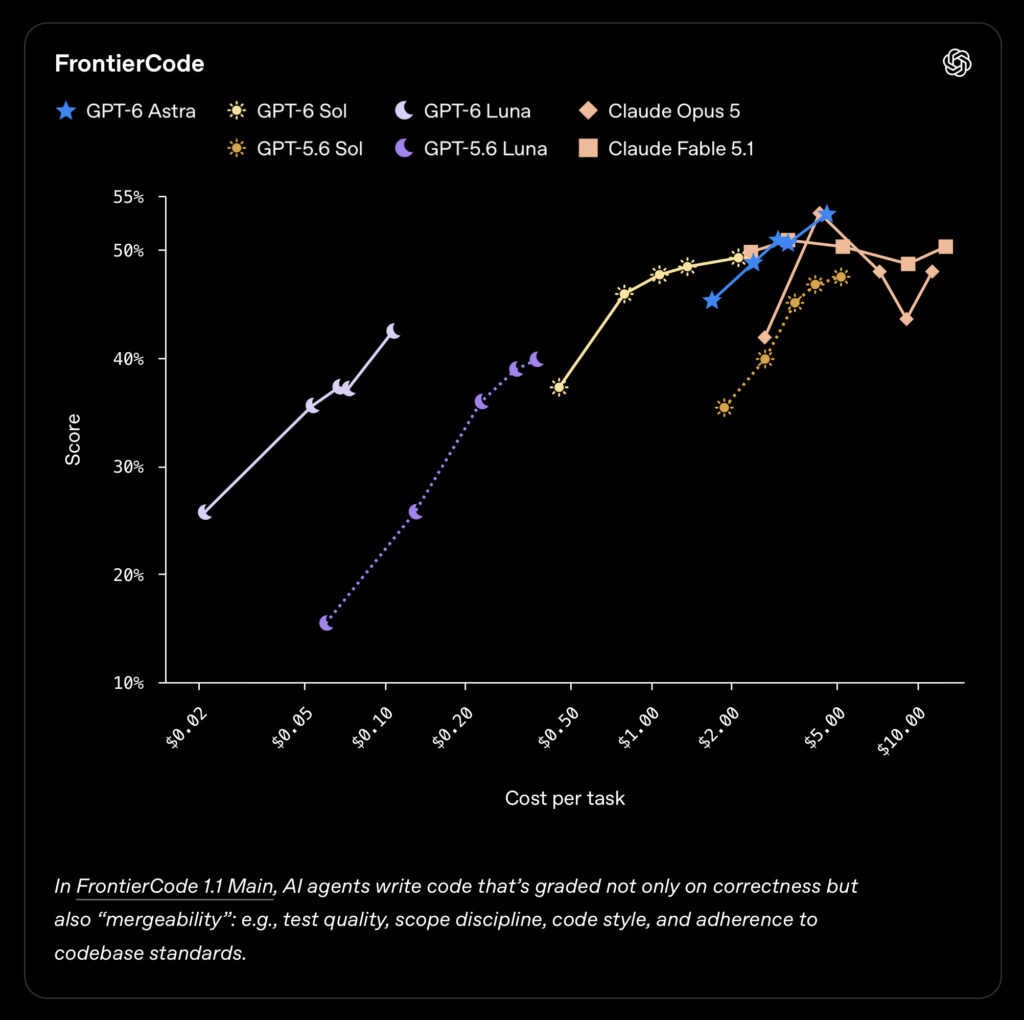
Premier arrivé (à quelques minutes près), premier servi. Anthropic a donc annoncé Claude Opus 5.5, qui devient le modèle phare de l’entreprise. Évidemment plus puissant que son prédécesseur direct Opus 5, il bat également Fable 5.1 lancé début septembre dans les benchmarks proposés par Anthropic. Il fait aussi mieux que GPT-6 Astra, sauf sur la recherche agentique (Terminal-Bench-Science 0.1) et sur AutomationBench, le test des agents en conditions de travail réelles.

Opus 5.5 se distingue particulièrement sur le code, les agents autonomes, l’analyse métier et le travail de recherche. Anthropic met aussi en avant des gains significatifs sur les longues tâches de développement, sur les migrations de code et les workflows complexes.

Le groupe IA admet néanmoins que l’écart entre Opus 5.5 et Fable 5.1 sur ces tâches est « plus faible » que ce que laissent penser les tests. « À ce niveau de performance, explique Anthropic, nous constatons que les écarts entre les scores des benchmarks reflètent de moins en moins fidèlement les différences observées dans des situations réelles. »

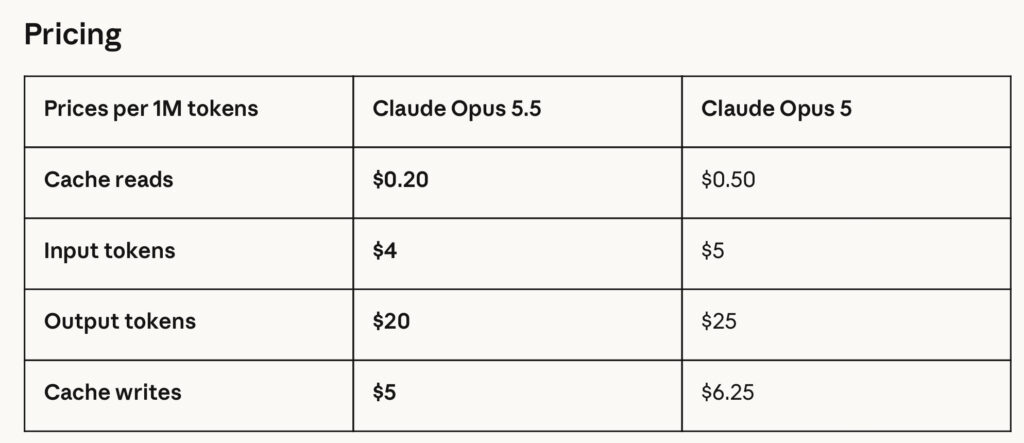
Le plus intéressant finalement dans cette annonce, c’est la baisse de prix. Opus 5.5 est annoncé environ 40 % moins cher qu’Opus 5 sur des charges de travail typiques. Les tarifs sont de 4 dollars par million de tokens en entrée, et 20 dollars par millions en sortie. Les lectures de cache sont de 0,20 dollars par million. Pour ne rien gâcher, le modèle génèrerait ses réponses 30 % plus rapidement qu’Opus 5.

À l’heure où les acteurs de l’IA jouent à se faire peur en annonçant l’extermination de l’humanité, Anthropic – jamais le dernier pour hurler avec les loups – annonce des garde-fous solidement mis en place pour éviter qu’Opus 5.5 dérape. Le modèle est doté des mêmes mesures de protection que celles de Fable 5.1 en cybersécurité, biologie et distillation. Le cas échéant, les requêtes sont redirigées vers un autre modèle.

« Les utilisateurs pourront repérer et corriger des bugs dans leur code dans le cadre du cycle habituel de développement logiciel, mais la plupart des tâches liées à la cybersécurité seront redirigées vers Opus 4.8 », détaille l’entreprise. Les organisations qui voudront aller plus loin devront passer par le Cyber Verification Program.

GPT-6 Sol et Luna attaquent sur les tarifs

Quasiment dans la foulée de son principal rival, OpenAI a lancé GPT-6 Sol et GPT-6 Luna. Les grands esprits se rencontrent, mais pas les modèles : ceux d’OpenAI sont moins puissants et ne vont pas aller se frotter à Opus 5.5 (c’est le rôle de GPT-6 Astra) mais ils se veulent plus économiques. Sol vise les tâches du quotidien, Luna la vitesse et les budgets serrés pour les tâches fréquentes.

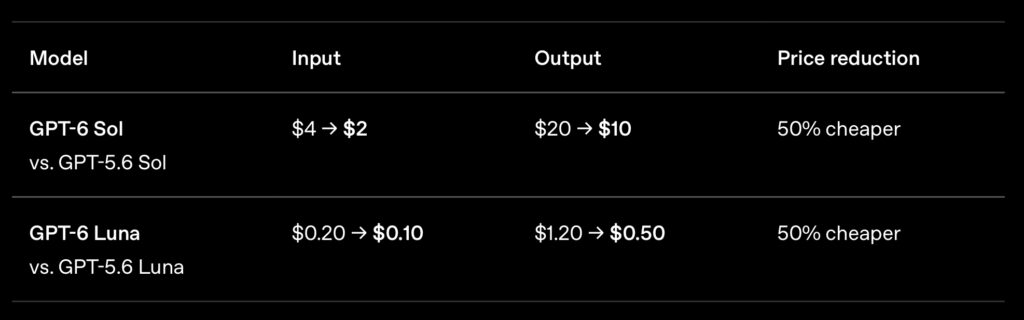
Et c’est les soldes chez le créateur de ChatGPT, avec des prix réduits de moitié par rapport à GPT-5.6. En entrée, GPT-6 Sol revient à 2 dollars le millions de tokens et 10 dollars en sortie. Luna coûte 0,10 dollar par million de tokens en entrée, et 0,50 dollar en sortie. OpenAI annonce aussi une meilleure mise en cache des longs contextes, avec 90 % de réduction sur les jetons d’entrée déjà mis en cache.

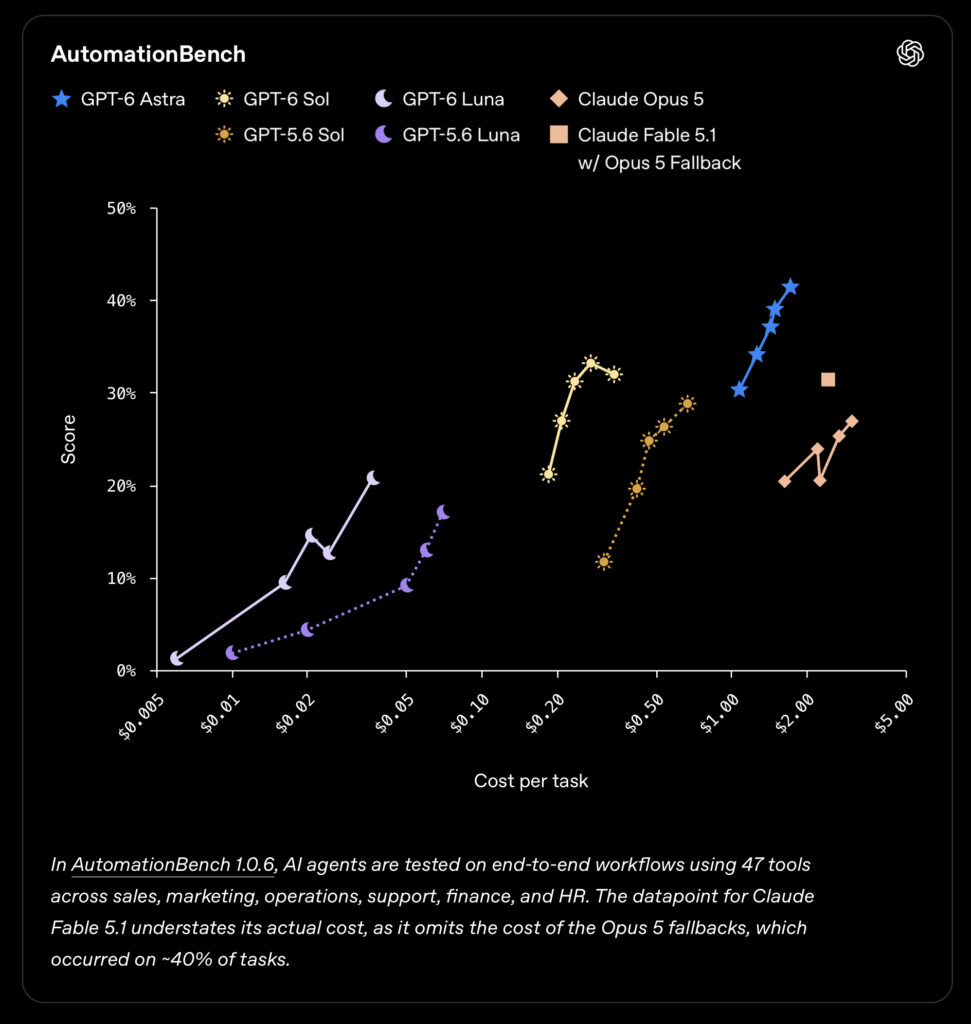
Sur AutomationBench, GPT‑6 Sol obtient 33,2 % pour 0,27 $ par tâche, contre 26,9 % pour Claude Opus 5, annoncé comme environ onze fois plus coûteux. Les deux modèles font des progrès en programmation et en manipulation d’interfaces graphiques, mais Astra conserve logiquement la tête.

  •  

[màj] Les pirates de ShinyHunters affirment détenir les données de milliers d’employés du FBI

Le FBI piégé
[màj] Les pirates de ShinyHunters affirment détenir les données de milliers d’employés du FBI

Le FBI a été visé par une attaque de ShinyHunters. Le groupe de pirates serait en possession de données concernant des milliers d’employés de l’Agence fédérale. Parmi les informations volées : noms, adresses, numéros de téléphone et des données sur la famille des employés.

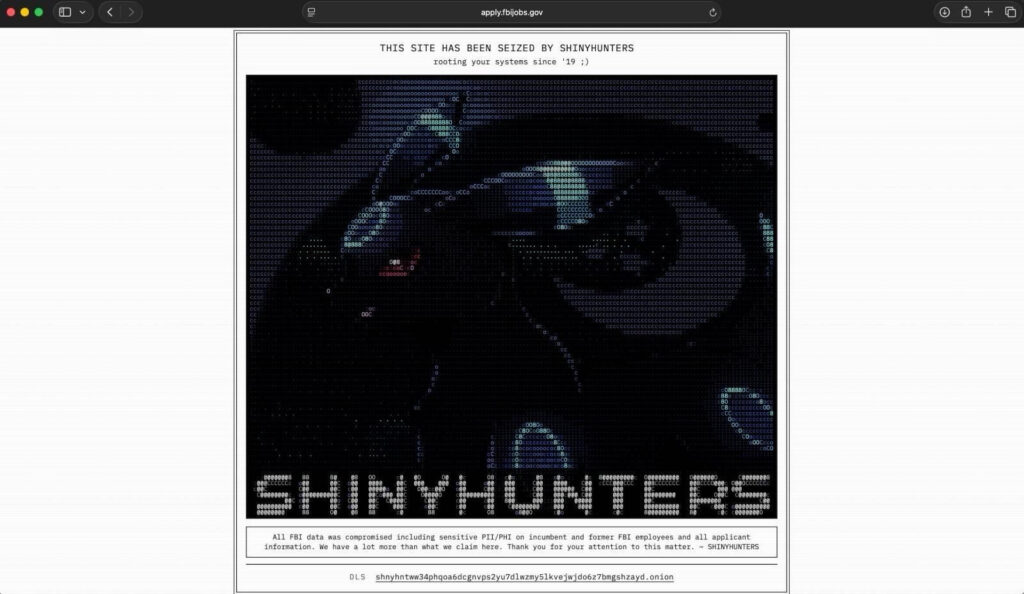
Pour prouver leur intrusion, les pirates ont détourné le site de recrutement du FBI. Pendant quelques minutes, on pouvait y lire que « le site a été saisi par ShinyHunters » et que « toutes les données du FBI ont été compromises, notamment des données personnelles et médicales sensibles concernant les employés actuels et anciens du FBI ».

Le groupe déclare aussi posséder « bien plus de données que ce que nous affirmons ici ». Avant de terminer par une formule typique de Donald Trump : « Merci de l’attention que vous porterez à cette affaire. »

Le site de recrutement piraté du FBI. Capture d’écran : vxdb

Le même site a rapidement affiché un message d’erreur prévenant que le portail de candidature est actuellement indisponible, toujours en ligne à l’heure où nous publions. Le site principal fbi.gov a lui aussi été placé en indisponibilité, d’après nos constatations.

Un échantillon des données fourni au site 404media semble bien confirmer la nature et l’ampleur du vol de données. Selon nos confrères, ShinyHunters a exploité une faille zero-day dans PeopleSoft, un logiciel Oracle, pour obtenir un accès aux serveurs AWS GovCloud et siphonner les données. Il y en aurait pour 2 à 3 To.

Le FBI sommé de retirer ses accusations

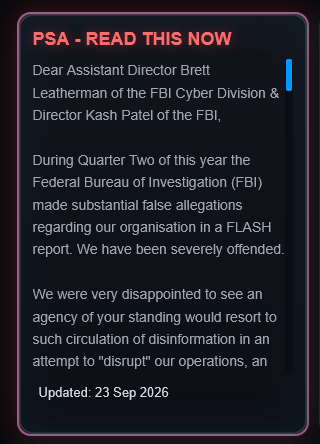
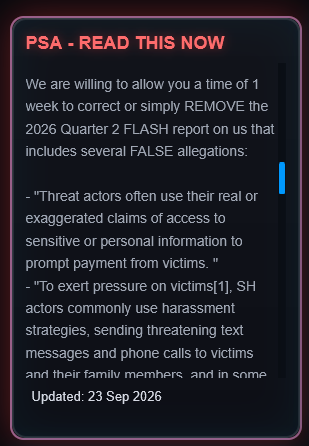
ShinyHunters est bien connu des services, en France comme à l’étranger. On leur doit de nombreux vols de données qu’ils tentent ensuite de rançonner. Pour le FBI, les choses sont un peu différentes. Un « avis public » placardé sur le site du groupe accuse l’agence fédérale d’avoir porté des accusations mensongères envers l’organisation dans un bulletin publié au deuxième trimestre.

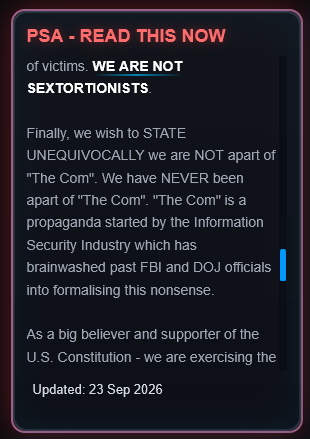
Shinyhunters a publié un message adressé au FBI sur son site onion – capture d’écran Next

Au lieu d’argent, les pirates exigent la modification ou le retrait du bulletin en question dans la semaine, au risque de la divulgation des données subtilisées. Ils réfutent notamment les allégations du FBI selon lesquels ShinyHunter met en œuvre des méthodes relevant du harcèlement ou de menaces personnelles adressées à leurs victimes.

Ils nient par ailleurs tout lien avec « The Com », un réseau criminel international décentralisé de pirates opérant aux États-Unis, au Canada et au Royaume-Uni. Ciblé par des enquêtes du FBI et d’Europol, ce réseau rassemble des sous-groupes impliqués dans la cybercriminalité, mais aussi dans l’exploitation sexuelle des enfants.

Dans le message de ShinyHunters, The Com est qualifié d’« élément de propagande inventé par le secteur de la sécurité informatique ayant endoctriné d’anciens responsables du FBI et du ministère de la Justice au point de les amener à donner une existence officielle à cette absurdité ». Le bulletin ne fait pas référence à The Com, en revanche il explique que les acteurs malveillants comme ShinyHunters peuvent prétendre à tort posséder des documents compromettantes sur leurs victimes, comme des photographies ou des vidéos embarrassantes de leurs victime.

Ils peuvent aussi recourir à des stratégies de harcèlement, comme l’envoi de SMS menaçants ou des appels téléphoniques aux victimes et aux membres de leur famille. ShinyHunters affirme « sans équivoque » n’avoir jamais menacé les familles ou détenu des informations compromettantes de leurs victimes. « NOUS NE PRATIQUONS PAS LA SEXTORSION », écrivent-ils en majuscules.

L’avis, qui n’est pas « motivé par des considérations financières », est présenté comme le moyen pour ShinyHunters de faire valoir leur droit à la libre expression tel qu’inscrit dans le Premier amendement de la Constitution américain. « [Nous] luttons contre la désinformation ». Pour l’instant, le FBI n’a pas encore réagi publiquement.

Mise à jour 23/09 – Le FBI a officiellement réagi à la fuite de données de ses serveurs. « L’origine de la faille [n’a] pas encore été déterminée », explique l’agence qui ne peut pas encore dire si elle provient « d’un tiers ou de l’environnement informatique du FBI ». L’enquête est en cours, et le FBI travaille avec ses prestataires pour atténuer tous les risques possibles.

  •  

☕️ Aux États-Unis, le secrétaire au Trésor tient OpenAI pour responsable de ses agents


Depuis l’incident impliquant Hugging Face, OpenAI marche sur une corde raide. L’entreprise est lancée dans un délicat jeu d’équilibrisme, entre pression sur la publication de données techniques et la nécessité financière de ne pas perdre la confiance du public. OpenAI prépare également son entrée en bourse et a besoin que sa valeur reste au beau fixe. Le 15 septembre, le Financial Times, cité par Bloomberg, évoquait ainsi un prochain tour de table qui valoriserait OpenAI à plus de 1 200 milliards de dollars. Interrogé sur le sujet, Sam Altman avait répondu que l’opération n’aurait pas lieu avant 2027.

La machine commence cependant à se gripper. Le narratif bâti sur le marketing de la peur et la foi inébranlable sur l’avenir de l’IA et des agents se fissure face à une pluie de critiques. Beaucoup remettent en question la volonté affichée de ralentir le développement des modèles de frontière pour se concentrer sur l’élaboration d’un cadre réglementaire. La Maison-Blanche n’a pas caché son hostilité à cette idée notamment.

Illustration : Flock

Le 21 septembre, le secrétaire au Trésor américain Scott Bessent est même allé plus loin au micro de CNBC : l’incident Hugging Face revient selon lui à « la responsabilité de la direction d’OpenAI, pas d’un tas d’agents ». Il a indiqué partager l’analyse de Daniel Huttenlocher, co-directeur d’un laboratoire de recherche du MIT, pour qui les humains sont responsables, et non l’IA. Ces entreprises « doivent assumer leurs responsabilités », a ajouté Scott Bessent.

Cette déclaration n’est pas isolée. Elle prolonge la position que Bessent avait défendue le 15 septembre devant la commission des services financiers de la Chambre des représentants, souligne CNBC. Le secrétaire au Trésor s’y était opposé à toute exemption de responsabilité légale pour les entreprises d’IA, estimant qu’elle servirait davantage leurs intérêts commerciaux que la sécurité du public.

La prise de position est loin d’être anodine, car elle qualifie l’incident de défaillance de gouvernance humaine, plutôt que d’illustration de la puissance intrinsèque de leurs agents et de leurs comportements imprévisibles. Le 2 septembre, nous relevions d’ailleurs les mêmes éléments, en soulignant que le rapport complet d’OpenAI montrait effectivement une succession de défaillances humaines.

À noter qu’au cours de la même interview, le secrétaire au Trésor a indiqué la possible mise en place d’un téléphone rouge avec Pékin sur les questions, et la possible nomination d’un nouveau « tsar de l’IA » pour gérer ce type de dossier.

  •  

Racheté 35 300 €, Lycos.fr revient : « On n’avait pas prévu que ça aille aussi vite »


Racheté 35 300 €, Lycos.fr revient : « On n’avait pas prévu que ça aille aussi vite »

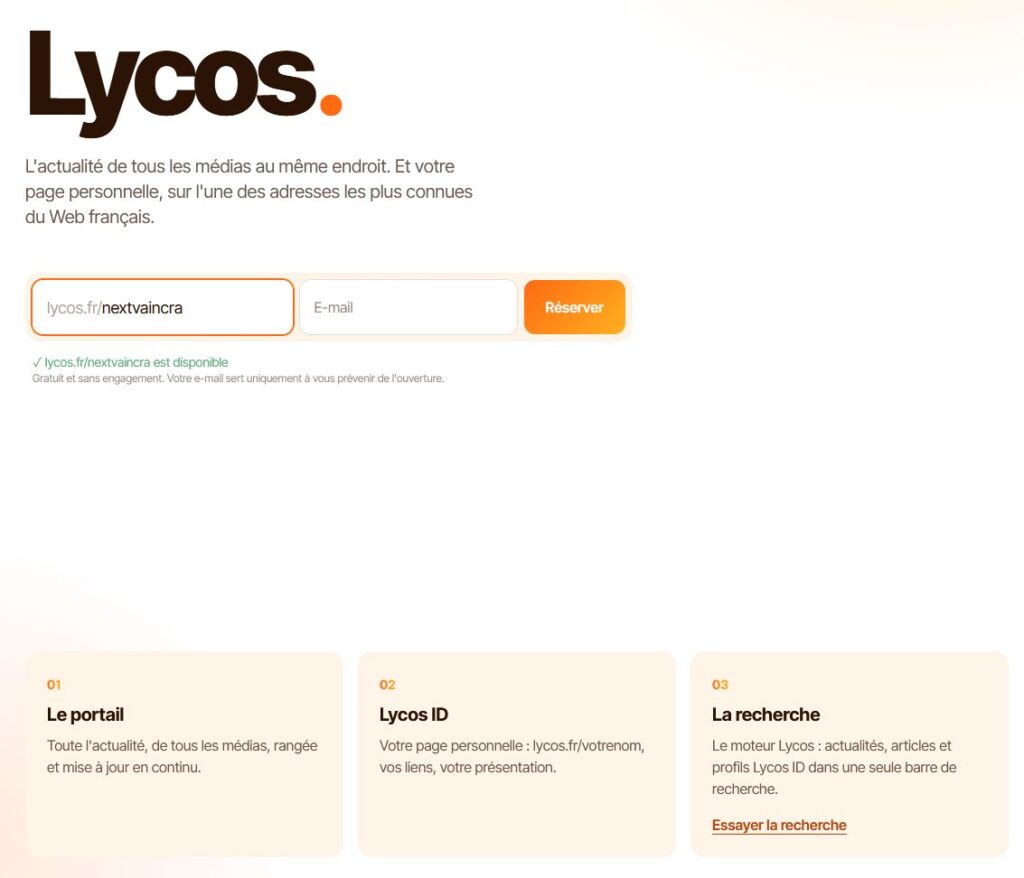
Lycos.fr reprend du service. Racheté aux enchères pour 35 300 euros, le vénérable nom de domaine accueille un nouveau projet de portail porté par l’acquéreur. Il ambitionne d’y proposer page personnelle, moteur de recherche et agrégateur de médias, sans lien avec la société historique du même nom.

Comme souvent dans ce genre de cas, les enchères se sont jouées dans la dernière ligne droite : proposé à la vente sur le site spécialisé WebExpire, le nom de domaine lycos.fr a trouvé preneur lundi 21 septembre pour 35 300 euros.

Cette fois, hors de question de laisser le nom de domaine dormir en mode parking. Quelques heures plus tard, une nouvelle page d’accueil s’affiche aux yeux des internautes curieux. Elle propose de réserver une adresse en lycos.fr/votrenom en échange d’une adresse email pour obtenir, au lancement, « votre page personnelle sur l’une des adresses les plus connues du Web français ».

À ce service, baptisé Lycos ID, le nouvel acquéreur promet d’ajouter un agrégateur de médias, avec une actualité « rangée et mise à jour en continu », ainsi qu’un moteur réunissant « actualités, articles et profils Lycos ID dans une seule barre de recherche ».

La page d’accueil du site Lycos.fr au mardi 22 septembre – capture d’écran Next

Le retour d’une vedette d’antan

L’ambition dessinée ici rappellera certainement des souvenirs à ceux qui, parmi les lecteurs de Next, surfaient déjà en ligne au tournant du nouveau millénaire. Lycos.fr, édité par la société Lycos Europe gmbh, est en effet l’un des plus célèbres représentants de la génération des grands portails Web qui mêlaient messagerie, pages perso et surtout recherche en ligne entre la fin des années 90 et le début des années 2000.

Né en 1994 sous la forme d’un projet de recherche et installé en tant que société commerciale un an plus tard, Lycos a d’abord connu une ascension fulgurante et un développement mondial (en 2000, Lycos vantait son célèbre slogan « va chercher » à la télévision française), avant de lentement péricliter, balloté entre une succession d’actionnaires.

Le portail, identifiable à son logo en forme de retriever noir, a officiellement disparu du Web européen le 15 février 2009, même si le moteur de recherche américain est longtemps resté accessible par le biais des différentes extensions nationales du nom de domaine lycos, dont le .fr.

Un départ sur les chapeaux de roue

Jusqu’à ce que ce dernier soit finalement libéré, proposé aux enchères, et donc racheté, avec mise en place de cette page d’inscription en forme d’apéritif pour un lancement à venir. La conclusion des enchères a toutefois suscité plusieurs commentaires publics, sur les réseaux sociaux, de spécialistes des noms de domaine et du référencement, contribuant à braquer les projecteurs sur le nouveau lycos.fr.

« On a récupéré le domaine hier, on n’a encore rien annoncé, et il y a déjà des milliers d’inscriptions. On n’avait pas prévu que ça aille aussi vite, ce sont les gens qui ont décidé pour nous, et ça confirme que ce nom réveille quelque chose de bien réel », confie à Next Benjamin Romei, fondateur d’ADN Contents, la société qui a remporté les enchères (par ailleurs éditrice de médias thématiques). Qui entend bien donner une seconde vie à cette vénérable adresse : « L’idée tient en une phrase : refaire de Lycos une porte d’entrée simple du web français ».

D’où cette triple ambition affichée, avec un moteur de recherche constitué sur un index en propre et un agrégateur de médias attendu dans les prochains jours, tous deux en bêta, et le futur service de page personnelle pour lequel les plus impatients ont déjà réservé une adresse à leur nom (vanity URL). « Lycos ID est une carte de visite en ligne, à une adresse que tout le monde connaît », résume Benjamin Romei.

À défaut d’avoir Next.fr, nous aussi on veut notre vanity URL – capture d’écran Next

L’entrepreneur indique envisager un modèle économique hybride, basé pour partie sur la publicité, et sur des options premium associées aux pages personnelles. Il précise ne pas vouloir se limiter aux nostalgiques. « Le premier cercle, c’est ceux qui ont grandi avec Lycos, Caramail et Multimania. Pour eux, ce nom réveille quelque chose. Mais on espère bien toucher d’autres générations : on ne veut pas faire un musée ».

L’épée de Damoclès du recours d’un ayant-droit

Reste une inconnue de taille. L’entrepreneur ne prend-il pas un risque à racheter et à exploiter un nom de domaine associé à une marque à la notoriété certes ternie, mais historiquement bien établie ?

Outre l’éventualité d’une action en contrefaçon, le fait que le domaine concerné soit en .fr signifie que le nouveau propriétaire s’expose à la possibilité d’une réclamation extra judiciaire formulée directement auprès de l’Afnic, l’office d’enregistrement des extensions nationales, notamment via la procédure Syreli.

Encore faut-il qu’il subsiste un ayant droit. À l’échelle française, une recherche dans les bases de données de l’INPI confirme que les différents enregistrements de marque liés à des activités numériques (édition de site, publicité en ligne) sont expirés de longue date. D’après les données disponibles auprès du bureau américain des brevets (USPTO), la marque Lycos en tant qu’activité Web semble également avoir été abandonnée depuis 2020. Le site lycos.com a par ailleurs pris des airs de coquille vide, avec un index de recherche limité à la portion congrue, et des mentions légales qui ne mentionnent plus grand chose.

Le nouvel acquéreur n’ignore pas la question, mais se dit confiant : « On a fait ce travail sérieusement, en amont, avant même de se lancer. La situation de ce nom n’est pas la même selon les territoires, et notre projet est français : pensé ici, pour le public d’ici, sur un .fr laissé à l’abandon depuis des années. On est accompagnés sur le juridique, on suit la situation de près et des démarches sont en cours. »

À ce stade, la page lycos.fr ne pousse toutefois pas la filiation jusqu’à reprendre la silhouette du célèbre retriever.

  •  

Nouvelle saignée chez Xbox, Halo et Rare passent sous la coupe d’Activision

Le patrimoine Xbox en pièces
Nouvelle saignée chez Xbox, Halo et Rare passent sous la coupe d’Activision

Nouvelle purge chez Xbox. Après une première charrette de licenciements début juillet, l’activité jeux vidéo de Microsoft poursuit sa réorganisation ou plutôt son « reset ». La potion est amère pour plusieurs studios, dont certains risquent de mettre la clé sous la porte.

En juillet, Xbox s’amputait de cinq studios et annonçait la suppression de 3 200 postes, la moitié immédiatement, le reste durant le courant de l’exercice fiscal en cours (fin juin 2027). Une nouvelle coupe claire a été annoncée ce mardi 22 septembre : 268 licenciements répartis entre les studios Halo, d’autres studios internes chez Xbox, ainsi que dans les équipes de direction et les services centraux.

Matt Booty, le chef des contenus Xbox et bras droit de la directrice générale Asha Sharma, explique que ce nouveau serrage de vis permet au groupe de « réaliser environ les trois quarts de la restructuration ». En plus de ces suppressions de postes, il annonce aussi une réorganisation des studios. Le changement le plus important concerne la franchise Halo, véritable symbole de Xbox : le prochain jeu sera développé directement par Activision, séparément du travail réalisé par le studio pour Call of Duty.

Le prochain Halo sera réalisé par Activision

Les studios Halo (anciennement 343 Industries) n’ont pas su concrétiser les espoirs de renouvellement de la licence créée à l’origine par Bungie. Leur avenir s’écrit désormais en pointillés : Microsoft va les cantonner à un rôle de support pour la communauté de joueurs et la gestion du dernier volet en date, Halo Infinite, sorti en 2021. Activision reprend également World’s Edge, le studio qui développe Age of Empires.

Le poids lourd Bethesda va absorber le studio Obsidian, pour qui il va développer un projet de nouveau Fallout et continuer à alimenter Grounded en contenus frais. Les studios Playground et Turn 10 vont fusionner, ce qui pour le coup a une certaine logique : le premier développe le jeu de course arcade Forza Horizon, le second la simulation réaliste Forza Motorsport. Ils travailleront ensemble sur la franchise Forza ainsi que sur Fable, dont un nouvel épisode sort en février prochain. Sur le versant mobile, King (Candy Crush) absorbe Microsoft Casual Games qui développe et exploite le fameux jeu Solitaire.

Enfin, le dernier changement est certes symbolique, mais il risque de faire saigner les cœurs des nombreux joueurs : Rare va rejoindre Activision. Le studio anglais fondé en 1985 est une institution du jeu vidéo, avec des titres comme Banjo-Kazooie, Donkey Kong Country, GoldenEye 007, Perfect Dark, Killer Instinct… Racheté en 2002 par Microsoft, il continue d’exploiter Sea of Thieves, récemment porté sur PS5. Sous la férule d’Activision, il est difficile d’être optimiste pour l’avenir de Rare.

La restructuration ne s’arrête pas là. Le studio anglais Ninja Theory pourrait fermer ses portes après deux tentatives ratées de revente. Chez Arkane, la consultation avec les salariés dans le cadre d’un PSE se poursuit jusqu’à la fin de l’année pour déterminer le futur du studio français.

La direction de Xbox entend regrouper ses investissements dans les grosses franchises connues, à l’instar d’Elder Scrolls, Halo ou encore Fallout. C’est ce qui explique aussi la reprise du projet Physint d’Hideo Kojima, abandonné par PlayStation il y a quelques jours. Le prochain jeu d’espionnage du créateur de Metal Gear Solid va coûter très cher, ce qui peut paraitre complètement paradoxal pour une entreprise qui taille dans le vif. Mais c’est une question d’image de marque, alors que les mauvaises nouvelles ne cessent de s’empiler.

  •  

Vie privée : le cas LG braque à nouveau les projecteurs sur les TV connectées

On remet une pièce
Vie privée : le cas LG braque à nouveau les projecteurs sur les TV connectées

Le problème des TV connectées s’étend au-delà des téléviseurs LG pointés ces dernières semaines. Si le constructeur coréen a essuyé l’essentiel des critiques, plusieurs observateurs rappellent que la problématique est en place depuis longtemps.

Tout est parti d’une série de vidéos de la chaîne Gamers Nexus. Elle y expose ses découvertes sur plusieurs téléviseurs TV OLED de la marque LG. Dans les grandes lignes : les modèles testés sont bavards, possèdent des réglages de vie privée inutilement complexes et possèdent des failles de sécurité importantes. Ces dernières, quand elles sont exploitées, permettent de modifier jusqu’aux mots d’activation pour la reconnaissance, permettant l’écoute dans la pièce.

LG a réagi il y a peu via un communiqué, accusant essentiellement ces vidéos de mentir et de vouloir répandre la peur. Gamers Nexus a répondu à son tour, détricotant les arguments de l’entreprise, jusqu’à faire intervenir un avocat dans la vidéo. Selon ce dernier, les mots ont été soigneusement choisis par LG dans son communiqué, notamment sur la collecte de données alimentant l’ACR (reconnaissance automatique de contenu), mécanisme permettant de faire remonter les habitudes de visionnage par télémétrie.

L’ACR a concentré l’essentiel des critiques, jusqu’à faire remonter des constatations vieilles de plusieurs années, dont la capture active des signaux sur la liaison HDMI. Ainsi, l’ACR intervient également quand le téléviseur est utilisé comme simple écran, mais les informations ne peuvent pas être émises si l’appareil n’est pas connecté à internet.

Un vieux problème

Dans notre dernier article sur le sujet, nous relevions que LG était possiblement dans une position inconfortable. Il est en effet difficile d’éteindre l’incendie autour des questions de vie privée sans évoquer l’ACR, et ce mécanisme ne peut pas être abordé sans jeter tout le reste de l’industrie sous le bus. Dans ce domaine, LG est un constructeur parmi d’autres, même s’il jouit d’une présence importante, grâce à la renommée de ses dalles. Gamers Nexus évoque ainsi un parc de 216 millions de téléviseurs connectés dans le monde.

Chez The Verge, John Higgins est spécialisé dans les tests de TV et de matériel audio. Pour notre confrère, la situation est claire : « Ce n’est pas seulement LG. Toutes les chaînes de télévision vous espionnent ». L’une des clés selon lui pour comprendre le problème est la concurrence féroce que se livrent les constructeurs. Elle a entrainé une chute constante des prix des TV, « au point que certaines entreprises les vendent à perte », affirme John Higgins.

Il rappelle que les techniques d’ACR sont en place depuis longtemps, ces empreintes étant d’ailleurs utilisées pour d’autres buts que la publicité, par exemple les études d’audience par des entreprises comme Nielsen. Ces mécaniques sont omniprésentes dès que l’on parle d’un téléviseur connecté. Il indique d’ailleurs procéder toujours de la même manière pour ses tests : une adresse Gmail jetable, la désactivation de tout ce qui peut l’être pour la publicité, l’acceptation des conditions pour la reconnaissance que lorsqu’il veut tester la fonction, etc.

Dans une utilisation quotidienne, il recommande globalement la même approche, voire davantage : « Pour aller plus loin, coupez le Wi-Fi, débranchez le câble Ethernet de la télévision et utilisez-le essentiellement comme une télévision simple ». Il recommande alors de passer par un appareil de streaming dédié. Dans son cas, une Apple TV 4K : « Non pas parce que je pense qu’Apple ne récolte pas de données, mais parce qu’elle n’utilise pas ACR et que je fais plus confiance à ses protocoles de sécurité qu’à n’importe quel fabricant de téléviseurs ou Google ».

Un petit avertissement contre Gamers Nexus

Pour John Higgins, « il n’y a vraiment aucun moyen de se protéger complètement contre la collecte de données de votre télévision, de votre appareil de streaming ou des services de streaming ». Il estime qu’il y a tout simplement trop d’argent « gagné au détriment des consommateurs », le changement ne pouvant venir que des gouvernements.

Interrogé par le journaliste, Thorin Klosowski, de l’Electronic Frontier Foundation (EFF), abonde : « Nous avons besoin d’une loi fédérale complète sur la vie privée qui couvre ce type de collecte et d’utilisation abusive de données. Plus précisément, un appareil nécessitant un consentement volontaire, sans astuces de conception trompeuses pour obtenir ce consentement, et une exigence de minimisation des données, ce qui limiterait les entreprises à n’utiliser les données que pour ce qui est nécessaire à la fourniture du service ». En Europe, ces questions sont régies par le RGPD.

Si John Higgins regrette que les consommateurs doivent se « protéger activement des entreprises » vendant les produits, il regrette aussi le ton employé parfois par Gamers Nexus. Il note par exemple que les reproches les plus graves faits à LG sont basés sur l’exploitation d’une faille permettant l’obtention d’un accès root.

Le constructeur peut être critiqué sur ces problèmes de sécurité, selon lui, mais pas sur les usages faits de ces failles, puisqu’un accès root permet de réaliser pratiquement n’importe quelle opération. En Europe, ces questions sont justement à la source du Cyber Resilience Act, qui entrera pleinement en vigueur en décembre 2027. En outre, s’il ne remet pas en cause les découvertes « accablantes » réalisées par la chaîne, John Higgins regrette l’emploi d’expressions comme « ça pourrait » ou « nous pensons ».

Reste que les vidéos de la chaîne et la couverture médiatique au sens large auront remis au goût du jour le sujet. « À moins de se déconnecter complètement et de vivre dans une cabane en forêt avec une simple télévision et une collection de blu-rays, le mieux que nous puissions faire est de limiter autant d’informations partagées que possible », conclut The Verge.

Ce 19 septembre, Flock avait justement un mot à dire sur le sujet.

  •  

☕️ Paramount obtient finalement le feu vert pour avaler Warner


Paramount Skydance vient de lever un gros obstacle sur le long chemin vers l’acquisition de Warner Bros. Discovery. Le groupe de David Ellison a trouvé un accord avec la Californie et plusieurs autres États qui tentaient de bloquer l’opération en justice. Le dirigeant, fils de Larry Ellison le cofondateur d’Oracle, a annoncé à ses troupes que la transaction devrait être finalisée dans les deux semaines.

Au terme d’une négociation de plusieurs jours, le groupe Paramount a arraché un accord avec le procureur général de Californie, qui agissait en son nom et celui des procureurs généraux de onze autres États, ainsi qu’avec la Writers Guild of America. « Nous avons obtenu toutes les autorisations nécessaires à cette fusion et pouvons désormais avancer vers sa finalisation », se réjouit-il en annonçant que les studios resteront à Hollywood – il avait en effet menacé de quitter la Californie.

Le château d’eau de Warner Bros, par Silas Lundquist, Licence Unsplash

Le projet d’accord judiciaire entre les deux entreprises et les procureurs, que la juge Araceli Martínez-Olguín doit encore valider, contient un certain nombre d’engagements de la part de Paramount qui s’appliqueront pendant cinq ans (PDF). La nouvelle entité devra sortir en salles au moins 30 films par an, avec une fenêtre d’exclusivité de 45 jours minimum. Si le nombre minimal de sorties n’est pas atteint, le groupe pourrait être obligé de céder Miramax et verser 30 millions de dollars pour chaque film manquant à l’appel.

Ce volume sera difficile à tenir, mais pas impossible : les deux studios prévoient en effet une quinzaine de films de cinéma chacun cette année, contre 19 en 2025.

Un conseil éditorial pas si indépendant

En ce qui concerne l’indépendance de CBS News et de CNN, Paramount créera un conseil de surveillance éditoriale composé de cinq journalistes qui seront nommés par… le conseil d’administration du groupe. En termes d’indépendance, on a probablement fait mieux. Ce conseil pourra définir de grands principes éditoriaux, arbitrer les différends entre journalistes et direction, examiner les questions de biais éditoriaux, et surveiller l’indépendance des rédactions vis-à-vis de la direction, des propriétaires et des actionnaires.

Les premiers pas de ce conseil seront très intéressants à suivre : les Ellison sont des proches de Trump, qui vient d’interdire à CNN l’accès à la salle de presse de la Maison-Blanche au mépris de liberté d’expression inscrite au Premier amendement de la Constitution du pays.

Quoi qu’il en soit, ce conseil de surveillance est une des raisons qui ont convaincu les États américains de mettre fin à leur offensive judiciaire. Sans accord, un procès aurait dû avoir lieu en mars prochain. Cette résolution à l’amiable est une bonne nouvelle pour les finances de Paramount, qui s’était engagé à verser des pénalités de 7 millions de dollars par jour à compter du 1er octobre si l’opération à 110 milliards de dollars (!) traînait en longueur.

La fusion va déboucher sur la création d’un des principaux studios de production audiovisuel au monde. Il contrôlera en effet Paramount et Warner, ainsi que Skydance, Miramax, Nickelodeon, New Line, les studios DC (et bien d’autres actifs), sans oublier l’activité jeux vidéo qui fait partie de la dot sans être une priorité du groupe.

  •  

SpaceXAI lance son modèle Grok 4.7, dont les performances déçoivent

Overhyped
SpaceXAI lance son modèle Grok 4.7, dont les performances déçoivent

SpaceXAI a lancé son nouveau modèle Grok 4.7 ce 21 septembre. Si Elon Musk vantait l’arrivée de cette version, les résultats indépendants ne semblent pas à la hauteur des attentes. En revanche, le LLM garde pour lui l’avantage d’une tarification plus douce que certains des gros modèles lancés ces derniers mois.

Mise à jour du 23 septembre : Dans la version originale de l’article, nous avons mentionné les prix sans évoquer la consommation de tokens à l’usage. Nous avons modifié cette partie, Grok 4.7 se révélant nettement plus verbeux que son prédécesseur, avec des conséquences sur la facture.

Article original du 22 septembre :

La version 4.7 de Grok repose sur un nouveau modèle de base, plus grand que pour Grok 4.6. Dans son annonce, SpaceXAI indique qu’il a été entraîné par renforcement plus longtemps, sur des tâches plus difficiles, avec un accent sur les problèmes qui demandent plusieurs heures de travail. L’entreprise affirme que le modèle vérifie mieux son propre travail et gère mieux les contextes longs. Le modèle a aussi été entraîné pour fonctionner nativement dans l’environnement Grok Bot.

Dans la documentation fournie, on peut lire que le modèle grok-4.7 dispose d’une fenêtre de 500 000 jetons (tokens), ses connaissances s’arrêtant en mai 2026. Sans surprise, le LLM est multimodal (texte et images en entrée) et produit du texte en sortie. On retrouve en outre les quatre mêmes niveaux de raisonnement : bas, moyen, haut (par défaut) ou très haut (xhigh). Appel de fonctions, recherche web ou sur X, ou encore exécution de code sont autant de possibilités mises en avant par SpaceXAI.

La société d’Elon Musk met en avant de nombreuses qualités en phase avec les discussions actuelles autour de la sécurité. Elle évoque par exemple « de solides capacités de défense cyber » tout en gardant « de faibles taux de refus d’utilisation légitime ». Grok 4.7 aurait obtenu le score le plus élevé sur HackberBench 0.3 et n’aurait autorisé que 3,3 % des prompts risqués. En outre, le nouveau LLM se montrerait plus robuste face aux tentatives de jailbreak.

Des performances en deçà des attentes

Sur le chapitre des performances, la situation est plus complexe. Selon les chiffres avancés par l’entreprise, Grok 4.7 se débrouille bien sûr très bien. Cependant, on remarque vite que le tableau donné par SpaceXAI ne compare pas toujours les mêmes éléments. Par exemple, Grok 4.7 est testé en mode de raisonnement xHigh alors que Grok 4.6 est testé en High.

Source : SpaceXAI

Cela n’empêche pas l’entreprise de revendiquer de très bonnes performances, surtout face à son modèle précédent et dans des domaines particuliers. « Grok 4.7 est meilleur pour créer des documents et des présentations. Dans GDPval et AA Briefcase, l’IA est sollicitée pour travailler sur des tâches réalisées par des professionnels tels que des avocats, des infirmiers et des analystes financiers. Grok 4.7 améliore Grok 4.6 sur les deux benchmarks et se comporte de manière comparable à d’autres modèles Frontier », affirme ainsi SpaceXAI.

Sur X, on trouve déjà de nombreux commentaires et tests réalisés, plus ou moins spécifiques. Côté positif, on note par exemple le tweet d’Auggie qui relève un taux de 100 % sur son test de « détection d’erreurs » sur la musique, un score que seul avait atteint Astra. Le même testeur a en revanche été moins enthousiasmé sur Bach Benchmark (qui demande aux LLM de composer des chorals à quatre voix dans le style de Bach). Si l’on en croit Artificial Analysis, les revendications de SpaceXAI sur la création de documents sont avérées, avec en particulier un bond significatif sur le test Analytical Quality Elo.

Toutefois, les retours négatifs sont plus nombreux. Pour Jose Antonio Lanz par exemple, Grok 4.7 n’a rien d’un mauvais modèle, mais il est derrière la concurrence, particulièrement Astra ou même Sonnet 5 selon les essais réalisés. Il souligne d’ailleurs qu’Elon Musk avait lui-même cherché à diminuer les attentes autour de son modèle, en indiquant dans un tweet le 14 septembre que Grok 4.7 serait davantage à comparer à Opus 5 que 5.1. Il en profite pour annoncer que Grok 4.8 sera une « amélioration notable », que Grok 4.9 sera « probablement » au niveau d’Astra et Fable et que Grok 5 sera « peut-être meilleur que tout le reste ». Plusieurs personnes ont alors fait remarquer qu’OpenAI et Anthropic allaient eux aussi lancer de nouveaux modèles pendant ces laps de temps.

Selon The Decoder, Grok 4.7 obtient 46 à l’indice Artificial Analysis (v4.3.2), qui agrège dix tests. Il se place ainsi en milieu de peloton, derrière Claude Fable 5.1 et GPT-6, à 53 chacun. Sur Terminal-Bench 4.0, l’évaluation donne 26 %, bien en dessous des 38 % annoncés par xAI, et très loin des 60 % atteints par Astra et des 55 % de Fable 5.1.

Tarifs identiques, mais plus gourmand en tokens

Si les performances semblent globalement décevantes, Grok 4.7 se débrouille mieux que son prédécesseur dans la quasi-totalité des scénarios, sans toucher aux prix. On reste donc sur 2 dollars par million de jetons en entrée et 6 dollars par million en sortie. Une variante Fast est disponible, servie par une infrastructure plus rapide, avec une facturation doublée. Elle n’est cependant disponible que via Cursor et Grok Build, pas sur l’API publique. Sur cette dernière, tous les cas d’usage passant par Grok 4.6 ont automatiquement basculé sur le nouveau modèle.

SpaceXAI joue d’ailleurs la carte du rapport performances/prix en comparant sa grille tarifaire à celles de concurrents. GPT-5.6 Sol et Claude Fable 5.1 sont dans la ligne de mire, avec respectivement 4/20 dollars et 10/50 dollars.

Cependant, cette grille tarifaire ne raconte pas toute l’histoire. Selon des tests réalisés par Artificial Analysis, Grok 4.7 est plus gourmand en tokens que son prédécesseur. L’écart est a priori significatif : 81 000 jetons de sortie par tâche Intelligence Index pour Grok 4.7 xHigh, contre 38 000 pour Grok 4.6 xHigh et 27 000 pour GPT-6 Astra Max. Selon Artificial Analysis, Grok 4.7 est particulièrement verbeux, avec 240 millions de tokens générés pendant ses tests, contre une médiane de 88 millions.

Le positionnement général est ainsi celui d’un modèle faisant mieux que Grok 4.6 pour le même prix par tokens, mais possiblement plus lourd sur la facturation et l’usage des quotas. Il n’y a donc pas de rupture, et on reste sur l’interrogation classique du choix du modèle en fonction du scénario d’usage envisagé. Grok 4.7 illustre la manière dont un LLM peut s’avérer plus cher à l’utilisation que son prédécesseur, même quand le prix par token ne bouge pas ou diminue, comme nous l’avions montré avec Opus 4.7 d’Anthropic.

Enfin, on notera que le calendrier des sorties des prochaines versions ne semble pas ralentir, puisque Grok 4.8 serait proposé dans un mois. Une affirmation à prendre avec des pincettes, Grok 4.7 ayant été repoussé plusieurs fois. Le rythme cadre mal cependant avec le positionnement d’Elon Musk sur la nécessité de ralentir le développement des modèles de frontière. Il a publiquement soutenu l’idée de Dario Amodei, CEO d’Anthropic, de calmer le jeu et de réfléchir à un cadre clair pour mesurer l’alignement des modèles. Comme nous l’avions relevé toutefois, ces déclarations d’intentions ne semblent pas suivies d’actions concrètes.

  •  

Petal de Meta : 1 000 Tb/s entre les États-Unis et la France grâce à des fibres à deux cœurs

Toujours plus de vidéos de chats par seconde !
Petal de Meta : 1 000 Tb/s entre les États-Unis et la France grâce à des fibres à deux cœurs

Au lieu de doubler les fibres dans les câbles sous-marins, Meta double le nombre de cœurs dans chaque fibre. Résultat des courses, en 2029, un nouveau câble transatlantique de 7 000 km avec 24 paires de fibre optique proposera une bande passante de 1 Pb/s (ou 1 000 Tb/s).

Ce nouveau câble sous-marin de 7 000 km va relier les États-Unis à la France, avec Orange aux commandes pour l’atterrissement sur les côtes atlantiques. Le réseau social affirme que c’est « le premier câble sous-marin d’une capacité de pétabits à être déployé à travers un océan », soit le double de « la capacité des câbles transocéaniques les plus avancés d’aujourd’hui ».

Meta explique qu’il s’agit du « premier système de câble utilisant la technologie des fibres multicœurs déployé sur des distances transocéaniques ». Il faut comprendre en creux que ce n’est pas la première fois que plusieurs cœurs sont intégrés dans une fibre, pas plus que c’est une première dans un câble sous-marin. Idem, il existe déjà, au moins en laboratoire, des fibres avec plus de deux cœurs, voire des dizaines de cœurs. La différence ici : le procédé est industrialisé et sera opérationnel en 2029, selon Meta.

Deux cœurs dans un brin de 125 μm de diamètre


Il reste 82% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Europe : menace sur le consentement pour entrainer des IA sur des données personnelles

Le consentement, c'est sexy pourtant !
Europe : menace sur le consentement pour entrainer des IA sur des données personnelles

L’Irlande a proposé de nouvelles modifications au texte européen du « digital omnibus » qui doit « simplifier » le droit numérique européen. Le pays qui préside actuellement le Conseil veut que l’Europe considère comme « légitime » l’entraînement des IA sur les données personnelles ainsi que le dépôt de cookies pour mesurer l’efficacité de la publicité en ligne sans avoir besoin d’obtenir le consentement explicite des utilisateurs.

En prenant la présidence du Conseil de l’Union européenne, l’Irlande a aussi pris en main la rédaction de la proposition du texte « digital omnibus ». Le pays, qui héberge nombre de sièges sociaux européens d’entreprises du numérique, a ajouté au brouillon en cours deux modifications qui permettraient aux entreprises d’IA d’une part et de publicité d’autre part de se passer du consentement explicite des utilisateurs.

Nos confrères de Politico ont obtenu la version du document datée du 3 septembre élaborée par la présidence irlandaise du Conseil de l’UE [PDF].

L’entraînement de l’IA, intérêt légitime ?


Il reste 84% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  
❌