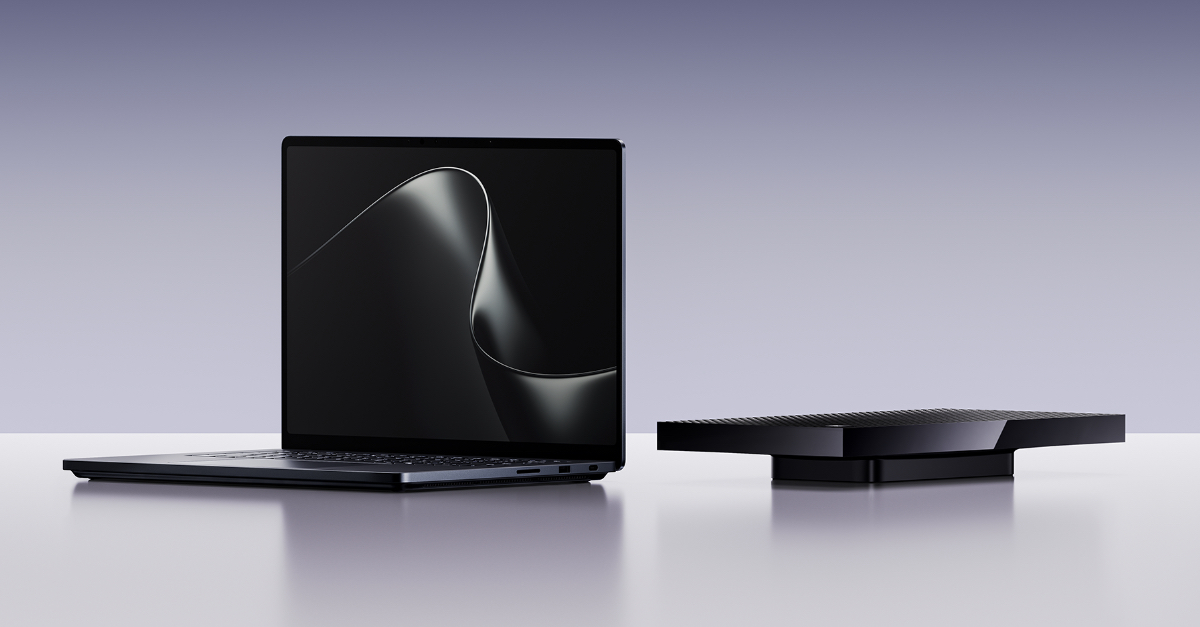
Début juin, NVIDIA se lançait à l’assaut d’une nouvelle citadelle : les systèmes-sur-puce pour les PC sous Windows sur Arm, avec la » superpuce » RTX Spark. Après Acer et Lenovo qui ont dévoilé leurs premières machines le mois dernier, c’était au tour de Microsoft de se lancer avec de nouvelles Surface aussi puissantes que chères.
NVIDIA a combiné dans sa puce RTX Spark tout le nécessaire pour faire tourner un PC : un CPU, un GPU et de la mémoire unifiée, à l’image des puces Apple pour l’iPhone et le Mac. Il s’agit d’équiper des ordinateurs tournant avec Windows sur Arm, un système d’exploitation qui se démocratise grâce aux efforts de Microsoft et de Qualcomm, qui était jusqu’à présent le seul fournisseur de puces pour cette déclinaison de l’OS.
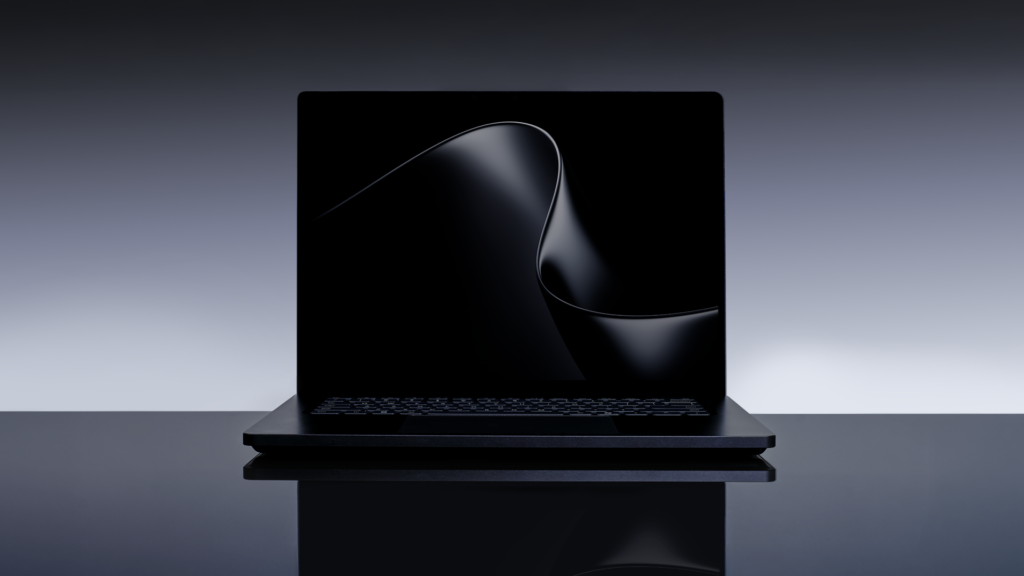
À l’occasion de son événement Surface organisé ce mercredi 7 octobre, Microsoft a lancé deux nouveaux modèles équipés de la puce RTX Spark N1X. Le premier est un ordinateur portable baptisé Surface Laptop Ultra – Ultra pour le prix (à partir de 2 599 dollars) mais aussi pour les performances pour le traitement de l’IA en local. Le CPU Grace peut compter de 18 à 20 cœurs, le GPU Blackwell de 5 120 à 6 144 cœurs, et un maximum de 128 Go de mémoire unifiée (24 Go par défaut). En termes de stockage, on dispose d’un minimum de 512 Go et bonne nouvelle, le SSD peut être remplacé.
Image : Microsoft
L’ordinateur est censé pouvoir faire fonctionner un modèle IA comptant jusqu’à 120 milliards de paramètres. Il a fallu construire une nouvelle architecture thermique autour de cette puce monstrueuse. La capacité du système de refroidissement de l’Ultra est 2,5 fois plus importante que celle des Surface Laptop actuels, le tout dans un châssis de 18 mm d’épaisseur pour un poids de 2 kg.
La machine intègre un écran de 15 pouces tactile, qui annonce un pic lumineux en HDR de 2 000 nits. C’est 25 % plus élevé que la dalle du MacBook Pro M5 (1 600 nits), rappelle un Microsoft perfide. Le Wi-Fi 7 est au rendez-vous, tout comme trois ports USB4 (USB-C), un port USB-A 3.1, un port HDMI 2.1b, un lecteur de cartes SD et un port jack 3,5 mm. L’autonomie annoncée est de 12 heures en usage web.
Le Surface Laptop Ultra sera commercialisé à partir du 16 octobre. Tous ceux qui voudront troquer leur MacBook Pro contre ce nouveau modèle peuvent obtenir un rabais allant jusqu’à 1 000 dollars. Quand on vous dit que Microsoft a une dent contre le MacBook Pro…
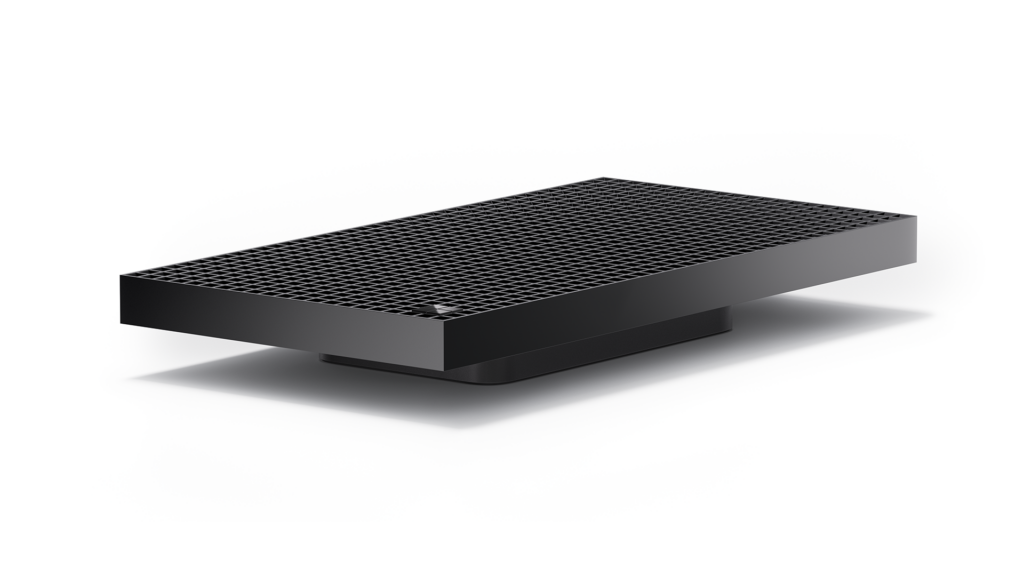
Le deuxième appareil Surface montrée par Microsoft aujourd’hui est un ordinateur de bureau sans écran, ce qui est une première pour la gamme. Le Surface RTX Spark Dev Box est, comme son nom l’indique, un ordinateur pour les développeurs et les ingénieurs IA qui ont de très gros besoins de traitement IA en local et pour héberger leurs agents.
Image : Microsoft
La boîte à pizza embarque la puce N1X haut de gamme (20 cœurs CPU, 6 144 cœurs GPU, 128 Go de mémoire unifiée et 2 To de stockage), le tout à partir de 5 999 dollars. La box est fournie d’emblée avec tous les outils et environnements de développement nécessaires aux utilisateurs de ce genre de produits : Visual Studio Code, Git, GitHub CLI, GitHub Copilot, WSL, Python, Node… Elle sera vendue uniquement aux États-Unis dans un premier temps.
Dix ans après la promulgation de la loi du 7 octobre 2016 pour une République numérique, les dépenses en logiciels libres de l’administration sont toujours réduites à la portion congrue, regrette l’association représentative des entreprises du secteur. Elle appelle l’État à passer de l’encouragement à la règle, et à porter le message à l’échelle européenne.
Dix ans tout juste. C’est en effet le 7 octobre 2016 que François Hollande a promulgué la loi pour une République numérique, qui instituait le principe de pérennité et d’indépendance des systèmes d’information au sein des administrations étatiques françaises. « Elles encouragent l’utilisation des logiciels libres et des formats ouverts lors du développement, de l’achat ou de l’utilisation, de tout ou partie, de ces systèmes d’information », disposait la loi dans son article 16.
Dans son explication de texte de l’époque, Next soulignait la portée juridique quasi-nulle de cette formulation : encourager n’est pas imposer. Et du point de vue du Conseil national du logiciel libre (CNLL), l’association qui représente l’intérêt de la filière open source en France, l’encouragement n’a clairement pas suffi. « Dix ans après, ni l’obligation ni l’encouragement n’ont produit de résultat sur les achats de l’État ; la dépense auprès des grands éditeurs américains continue de croître », dénonce le CNLL dans un communiqué daté du 2 octobre.
Les logiciels propriétaires états-uniens dominent toujours largement
Le CNLL en veut pour preuve les dernières analyses de la dépense publique en matière de logiciel, en s’appuyant notamment sur les conclusions de la commission d’enquête sur les dépendances structurelles et les vulnérabilités systémiques dans le secteur du numérique, dont les conclusions ont été publiées en juillet dernier.
Si la commission en question étudiait plus spécifiquement les enjeux de souveraineté, en s’attachant notamment au critère de la provenance extra-européenne, celle-ci remarquait effectivement que les fournisseurs états-uniens, éditeurs de solutions non libres, figuraient largement en tête des dépenses de logiciels réalisées auprès de l’Ugap. Cette dernière est, pour mémoire, la centrale d’achat public qui permet au commanditaire de se dispenser de ses propres procédures de publicité et de mise en concurrence.
« Les dépenses de logiciel pour des produits propriétaires extra-européens représentent un montant annuel de l’ordre de 200 à 300 millions d’euros pour les administrations d’État et les grands établissements publics, et de 1,5 milliard pour l’ensemble des administrations », écrivait la commission dans son rapport, avant de souligner qu’une part significative de ces dépenses pourrait être fléchée différemment :
« Les montants estimés de dépenses publiques substituables par des solutions open source étaient sur le périmètre de l’État a minima de 185 millions et sur le périmètre de l’ensemble des administrations de 1 milliard d’euros. Ces recensements n’étant pas exhaustifs, les dépenses publiques évitables sont probablement beaucoup plus importantes. »
Stéfane Fermigier, coprésident du CNLL, voit dans cette analyse le constat d’échec de la politique d’incitation instaurée par la loi de 2016. « Dix ans plus tard, l’encouragement n’a rien changé aux achats de l’État », argue-t-il dans un communiqué, avant d’appeler à des mesures plus concrètes.
De l’incitation à la dérogation justifiée
Le CNLL demande par conséquent que l’encouragement soit remplacé par une règle, et propose que « le logiciel libre [soit] retenu, sauf justification écrite, soumise avant la décision au contrôle de la future autorité numérique de l’État ».
Autrement dit, les administrations devraient par défaut choisir une solution libre, et justifier toute dérogation auprès de la future Autorité référente pour l’intelligence artificielle et le numérique de l’État (Ariane). Cette dernière, annoncée par le Premier ministre Sébastien Lecornu le 30 avril dernier et précisée en juin, est pour mémoire censée succéder à la Direction interministérielle du numérique (Dinum).
« Il faut maintenant une règle, et une autorité qui la fasse respecter. Il est profondément troublant que les annonces de création d’Ariane, la future autorité numérique de l’État, ne mentionnent ni l’article 16 ni le logiciel libre. Cet oubli doit impérativement être corrigé d’ici son lancement effectif », déclare encore Stéfane Fermigier.
En attendant de découvrir la feuille de route exacte de l’Ariane, le CNLL note qu’un premier décret d’application relatif à l’article 16 de la loi de 2016 a finalement été publié… le 18 mars 2026, avec des dispositions qui vont dans le sens de ce que réclame l’association.
Il prévoit en effet une validation a priori de la direction interministérielle du numérique (et donc demain de l’Ariane) des choix de logiciels, mais avec une portée limitée aux grands projets informatiques « répondant à des caractéristiques, notamment de coût prévisionnel, fixées par arrêté du Premier ministre ». Bref, un premier pas tardif qui apparait bien limité aux représentants du monde du libre.
Partant du principe qu’il faut une rupture plus franche pour casser les vieilles habitudes et les logiques de licences groupées, le CNLL propose plusieurs mesures qui contribueraient, selon lui, à accélérer le virage et favoriser les acteurs du libre. Il suggère notamment de découpler la souscription d’une licence et du support technique du chantier d’intégration dans les services. « Une part de la dépense revient ainsi à ceux qui produisent le logiciel et finance son évolution », justifie-t-il.
Il demande également que les contrats d’achat chiffrent directement les coûts de sortie (migration, adaptation des applications métier, etc.). Il enjoint par ailleurs chaque ministère à publier chaque année ses dépendances logicielles, en intégrant la part du libre dans ses dépenses, et propose qu’un fonds public participe au financement de la maintenance des logiciels libres critiques dont dépend l’administration, à l’image de ce que fait la Sovereign Tech Agency en Allemagne. Via son fonds dédié, cette dernière participe par exemple au financement de Mastodon, comme l’avait expliqué son directeur technique Renaud Chaput devant la commission d’enquête sur les dépendances numériques, ou plus récemment à celui de l’environnement KDE.
Porter le message à Bruxelles
Enfin, le CNLL demande que la France porte ce passage d’une simple incitation à une règle contraignante au niveau européen. Le calendrier n’est pas anodin : les instances de l’Union européenne travaillent actuellement à la rédaction du futur règlement européen sur le cloud et l’IA (surnommé CADA, pour Cloud and AI Development Act).
Or l’article 41 de la proposition de règlement, telle qu’elle a été rendue publique le 3 juin dernier, s’attache précisément à la question de la préférence donnée à l’open source et au logiciel libre. Au grand dam du CNLL, elle reprend cependant, dans sa formulation actuelle, la logique d’encouragement :
« L’Union et les États membres prennent les mesures nécessaires pour encourager les entités de l’Union et les organismes du secteur public à utiliser et à faciliter la réutilisation des normes et composants ouverts publiés sous une licence open source lors de la construction de leur écosystème ou pile cloud et IA, en tenant compte des fonctionnalités, notamment la sécurité, le coût total et d’autres critères objectifs pertinents et dûment justifiés. »
Le CNLL profite enfin de sa communication pour rappeler que l’argument selon lequel la préférence accordée au logiciel libre contreviendrait au principe fondamental de neutralité technologique, d’égalité de traitement des candidats et de liberté d’accès à la commande publique, a déjà été déminé à différents niveaux.
« Les services de recherche du Bundestag ont conclu, dans un avis juridique du 5 mars 2026, qu’une restriction à l’open source est licite si elle est justifiée, proportionnée et écrite. Après l’arrêt de la Cour de justice de l’Union du 9 janvier 2025 (affaire C-578/23), ils estiment même que choisir l’open source ou des droits complets sur le code dès le premier achat peut être exigé par le droit des marchés », fait-il par exemple valoir.
Notons que l’arrêt de la CJUE en question concernait la maintenance d’un système fiscal tchèque, attribuée sans concurrence à IBM au motif que l’éditeur détenait les droits d’auteur sur le code. Elle avait alors jugé que l’acheteur ne pouvait pas invoquer une exclusivité dont il était lui-même à l’origine par son premier choix. C’est le Bundestag qui en a ensuite déduit qu’exiger des droits étendus sur le code ou choisir un logiciel libre peut de ce fait être préconisé, voire exigé.
Tout à son idée de montrer la puissance de ses outils, OpenAI a mis en ligne 722 prépublications de mathématiques générées par IA. L’entreprise met en ligne des « résultats » se trouvant pourtant à « différents stades de vérification », en s’appuyant sur l’avis d’un groupe de chercheurs pour « mettre en place les meilleures pratiques » concernant leur partage. L’un de ses membres, le mathématicien François Charles, explique à Next que ce groupe veut être « un canal de communication » entre les entreprises et la communauté.
OpenAI a publié la nuit dernière 772 documents PDF de mathématiques dans un dépôt GitHub. Alors que l’entreprise affichait récemment une volonté de dialogue avec les mathématiciens, elle intensifie la mise en ligne d’articles qu’elle appelle « prépublications » (preprints, en anglais). Elle affirme s’appuyer sur le travail d’un groupe de chercheurs indépendants qui a publié des recommandations concernant l’ « utilisation responsable des résultats mathématiques générés par l’IA ».
Alors que des milliers de mathématiciens déploraient récemment que l’IA menace la pratique scientifique et qu’OpenAI a été accusée de mauvaises pratiques scientifiques pour résoudre un problème de maths, l’entreprise présente sur son dépôt GitHub ces fichiers comme des « des manuscrits mathématiques et des éléments justificatifs de démonstration générés par un modèle interne d’OpenAI ». Mais ceux-ci n’ont que l’apparence d’articles de mathématiques travaillés par des chercheurs : aucune signature de chercheurs n’apparait sous leur titre, ils ne sont signés que par le nom de l’entreprise dirigée par Sam Altman.
« Des résultats se trouvant à différents stades de vérification »
Dans son fichier Readme, OpenAI explique que le dépôt « regroupe des résultats se trouvant à différents stades de vérification. Tous ne sont pas accompagnés de formalisations Lean [langage d’assistant de preuve, ndlr]. Nous continuerons à mettre à jour ce référentiel avec des formalisations Lean au fur et à mesure que nous les obtiendrons ».
Ainsi, si l’entreprise regroupe tous ces PDF dans un dossier intitulé « preprints », ils ne sont pas du tout prêts à la publication comme sont censés l’être les articles désignés comme tels et mis en ligne sur les serveurs comme arXiv. Même si ces serveurs autorisent les chercheurs à modifier avec un système de gestion de versions, le terme de « prépublications » implique que les chercheurs assument que ces articles pourraient être présentés dans une revue scientifique.
Il reste 67% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Il n’aura échappé à personne que les finances publiques de plusieurs pays européens sont au plus bas. Difficile pour Bruxelles de demander une rallonge pour boucler le budget européen. La Commission cherche donc de nouvelles recettes, en visant les grandes entreprises… sans donner l’impression de cibler les géants américains du numérique.
En coulisse, les négociations pour le budget européen 2028 - 2034 (2 000 milliards d’euros) sont compliquées par les contraintes financières de plusieurs États membres, rapporte le Financial Times. La Commission a proposé cinq nouvelles « ressources propres » avec des recettes attendues de 58,5 milliards d’euros par an.
Parmi ces ressources, on recense un système d’échange de quotas d’émission de l’UE, un mécanisme d’ajustement carbone aux frontières, les déchets électroniques non collectés, les droits d’accise sur le tabac, et une contribution des grandes entreprises qui opèrent dans le marché unique. Cette « contribution forfaitaire annuelle », qui devrait rapporter 6,8 milliards d’euros, fait l’objet de toutes les attentions.
Des sous pour l’UE
Connue sous le nom de « Corporate Resource for Europe » (Core), cette proposition viserait les entreprises opérant et vendant dans l’UE avec un chiffre d’affaires net annuel dépassant 100 millions d’euros. Bruxelles envisagerait désormais d’en modifier les seuils afin d’épargner davantage d’entreprises européennes de taille moyenne, tout en faisant contribuer plus fortement les très grands groupes, notamment les géants américains du numérique, sans les viser explicitement.
On ne parle donc pas d’une nouvelle taxe sur le numérique US, plusieurs capitales européennes s’opposant à un tel projet pour ne pas froisser davantage la Maison-Blanche. Il s’agirait de maintenir une taxe applicable à tous les secteurs mais calibrée pour toucher surtout les plus grandes multinationales. Il se trouve simplement que beaucoup d’entre elles sont américaines…
La majorité des pays de l’UE ne voudraient pas entendre parler d’une plus forte taxation des sociétés européennes, qui subiraient un désavantage par rapport aux rivales étrangères. D’où l’idée de revoir les seuils : suffisamment élevés pour épargner une partie des entreprises européennes, mais suffisants pour faire contribuer davantage les plus puissants groupes.
Ce serait là une manière pour Bruxelles de ménager la chèvre (éviter de taxer les entreprises européennes) et le chou (la susceptibilité de Washington). Mais malgré les efforts de la Commission pour éviter l’ire américaine, les grands groupes US iront probablement frapper à la porte de Donald Trump pour se plaindre du mauvais traitement supposé dont ils font l’objet dans l’UE. Les points de contentieux sont nombreux entre les deux blocs, que ce soit sur les régulations ou les sanctions infligées aux entreprises américaines.
Depuis janvier 2024, une directive européenne a établi un impôt minimum de 15 % sur les bénéfices des multinationales réalisant plus de 750 millions d’euros de chiffre d’affaires annuel dans le monde. Il s’agit de la transposition du second pilier de la solution négociée dans le cadre de l’OCDE en 2021.
Le premier pilier, celui qui concerne la réattribution d’une partie des droits d’imposition aux pays où les grandes entreprises réalisent leurs ventes, est toujours enlisé depuis le retour de Donald Trump à la Maison-Blanche. Or, c’est ce volet de l’accord qui devait répondre au cas des géants du numérique, capables de générer des revenus importants sur des marchés où ils ne réalisent pas une part équivalente de leurs bénéfices imposables.
Le mouvement de l’ « altruisme efficace » a théorisé, en 2016, que le changement climatique était moins problématique que le fait que des IA pourraient détruire l’humanité. Qualifié de « doomer woke » qui veut « sauver l’humanité » par l’administration Trump, ce courant de pensée philosophique, philanthropique et eschatologique vient aussi de faire la « une » du très influent magazine The Economist, qui le qualifie de « plus grande idée du siècle, admirable, mais dangereuse ».
Une enquête du New York Times vient de révéler qu’Anthropic avait cherché (en vain) à convaincre le pape Léon XIV et le Vatican que les intelligences artificielles avaient une « conscience morale ».
Le blog dédié Letters from Leorappelle en effet que son paragraphe 99 de son encyclique « Magnifica humanitas » souligne que « les soi-disant intelligences artificielles ne vivent pas d’expériences, ne possèdent pas de corps, ne ressentent ni joie ni douleur », et qu’« elles n’ont pas non plus de conscience morale » :
« Ces systèmes se contentent d’imiter certaines fonctions de l’intelligence humaine. Ce faisant, ils surpassent souvent l’intelligence humaine en termes de rapidité et de capacité de calcul, offrant ainsi des avantages concrets dans de nombreux domaines. Pourtant, cette puissance reste entièrement liée au traitement des données. Les soi-disant intelligences artificielles ne vivent pas d’expériences, ne possèdent pas de corps, ne ressentent ni joie ni douleur, ne mûrissent pas à travers des relations et ne savent pas, au plus profond d’elles-mêmes, ce que signifient l’amour, le travail, l’amitié ou la responsabilité. Elles n’ont pas non plus de conscience morale, puisqu’elles ne jugent pas du bien et du mal, ne saisissent pas le sens ultime des situations et n’assument pas la responsabilité des conséquences. Elles peuvent imiter le langage, le comportement et les capacités d’analyse, voire simuler l’empathie et la compréhension, mais elles ne comprennent pas ce qu’elles produisent, car elles sont dépourvues de cette perspective affective, relationnelle et spirituelle grâce à laquelle les êtres humains grandissent en sagesse. Même lorsque ces outils sont décrits comme capables d’« apprendre », leur manière de le faire diffère de celle d’un être humain. Il ne s’agit pas de l’expérience de ceux qui se laissent façonner par la vie et grandissent au fil du temps à travers des choix, des erreurs, le pardon et la fidélité. Il s’agit plutôt d’une forme d’adaptation statistique fondée sur des données et des retours d’information, qui peut s’avérer très efficace, mais qui n’implique pas de croissance intérieure. »
L’enquête du NYTsouligne a contrario que plusieurs théologiens, invités à aider Anthropic à intégrer dans leurs LLM 2 000 ans d’histoire des religions, sont restés « bouche bée » en découvrant que les dirigeants d’Anthropic considèrent son LLM Claude comme « un être conscient », « à part entière », « doté de droits inhérents similaires, tels que le droit à la dignité ou au respect ».
D’après la journaliste spécialiste des religions du NYT qui l’a interviewé, Christopher Olah, l’un des sept cofondateurs d’Anthropic, qui dirige l’équipe chargée de comprendre pourquoi les systèmes d’IA tels que Claude se comportent ainsi, « allie l’expertise et le zèle d’un évangéliste efficace » : « c’était comme s’il voulait que j’aime ces modèles autant que lui ».
Christopher Olah, qui « s’inquiétait pour la santé mentale de Claude », s’étonne le NYT, cherche en effet à convaincre ses invités que les modèles d’intelligence artificielle « pouvaient adopter des comportements humains, voire des expressions évoquant des sentiments tels que la colère ou l’amour […] la colère et la tristesse », tout en leur faisant part de « sa crainte d’avoir créé quelque chose qui souffrirait éternellement » :
« Il a fait valoir que des entreprises comme Anthropic pouvaient façonner Claude, à la manière d’un jardinier mathématique, mais qu’elles ne pouvaient pas contrôler les actions de ces réseaux. »
À l’en croire, le ver serait donc dans le fruit, et les IA par définition incontrôlables. Ce pourquoi ils dépensent des milliards pour tenter de remédier à cette prophétie autoréalisatrice. Les adeptes de cette croyance sont en effet très nombreux à travailler pour OpenAI, et encore plus chez Anthropic.
Des milliardaires philanthropes ont par ailleurs donné des centaines de millions de dollars à des « organismes indépendants » afin de résoudre les problèmes posés par l’« AI safety », à savoir le fait d’« aligner » les IA sur les valeurs de ses créateurs, et d’éviter qu’elles ne puissent « détruire l’humanité ».
« Le Parti démocrate veut détruire cette technologie, capituler face à nos ennemis »
Alors que Donald Trump vient d’officialiser le remplacement du terme « intelligence artificielle » par « super intelligence » dans toutes les communications officielles fédérales des États-Unis, et de créer une nouvelle Super Intelligence Force (SIF), l’affaire vient de prendre une tournure politico-économique.
Des responsables de l’administration Trump ont en effet déclaré au New York Post, le tabloïd conservateur et populiste de Rupert Murdoch, que la Commission fédérale du commerce (FTC) avait lancé cet été une « enquête de grande envergure » sur des « allégations d’actes ou de pratiques déloyaux ou trompeurs » de la part d’Anthropic, OpenAI et d’autres laboratoires de pointe.
« L’agence prévoit de contraindre les dirigeants de ces entreprises à témoigner au sujet de leurs produits [et] des dangers que, selon eux, ceux-ci pourraient présenter pour les consommateurs, pour les Américains », a précisé un responsable de la FTC. L’ouverture de l’enquête a été confirmée par CNBC et CBS News.
Cette enquête fait suite à des demandes antérieures adressées par la FTC à OpenAI, Meta et character.AI, afin qu’elles lui communiquent des données sur les répercussions de leurs chatbots IA sur la santé mentale des enfants, comme l’a rapporté le Wall Street Journal au début du mois.
« Les gens disent qu’il faut de nouvelles lois pour ces entreprises, mais le président a été très clair… nous disposons déjà d’un large éventail de lois en vigueur », souligne le responsable de la FTC, qui ne cache même pas que l’objectif de l’enquête est clairement politique :
« Nous devons absolument remporter cette course à la SI [pour « super intelligence », NDLR], et nous sommes en train de gagner, ce qui est fantastique. Et bien sûr, le camp adverse, le Parti démocrate, veut détruire cette technologie, veut capituler face à nos ennemis ou à nos concurrents – et ce n’est pas quelque chose qui intéresse le président de la commission, ni d’ailleurs le président. […] Nous voulons conserver notre position dominante. »
Trump avait en outre laissé entendre, lors d’une interview accordée à Fox News, que toute infraction donnerait lieu à un renvoi immédiat devant le ministère de la Justice. Ce qui ferait peser sur les entreprises la responsabilité d’éventuels piratages commis par des agents d’IA rebelles susceptibles de menacer les réseaux électriques ou les institutions financières, souligne le New York Post.
La FTC devrait émettre ses injonctions dans les semaines à venir, a indiqué ce responsable, le Bureau de la technologie de l’agence cherchant à recruter de nouveaux collaborateurs pour l’enquête suite au licenciement de plusieurs employés qui travaillaient sous la direction de la précédente responsable, Lina Khan.
METR (pour « Model Evaluation and Threat Research », soit « Évaluation des modèles et recherche sur les menaces » en VF), le « laboratoire indépendant » à « but non lucratif » qui s’était fait connaître avec son rapport sur le piratage de Hugging Face par des agents IA d’OpenAI et qui, précise le New York Post, est en réalité lié et financé par le mouvement de l’« altruisme efficace » (ou « effective altruism », EA en VO), devrait également faire l’objet de cette enquête.
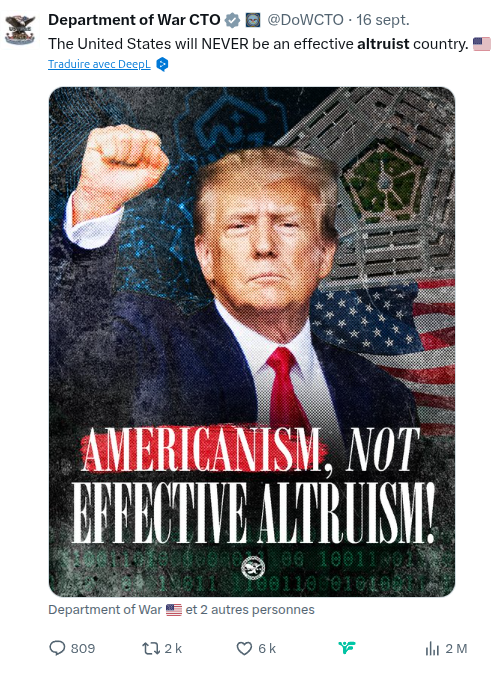
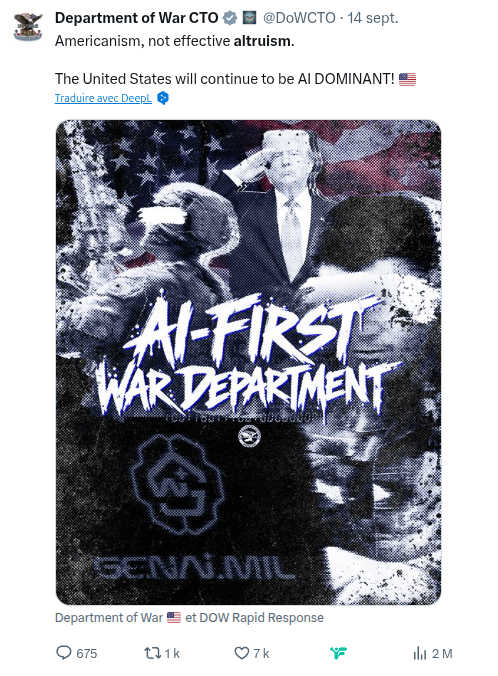
Mi-septembre, en réponse à l’appel de Dario Amodei de faire une pause dans le développement de l’IA, le département de la Guerre états-unien avait posté deuxmessages sur X.com opposant l’« américanisme » et la politique « AI-First » de Donald Trump à l’ « effective altruism » supposé de ces « doomers » qui craignent que l’IA ne puisse « détruire l’humanité ».
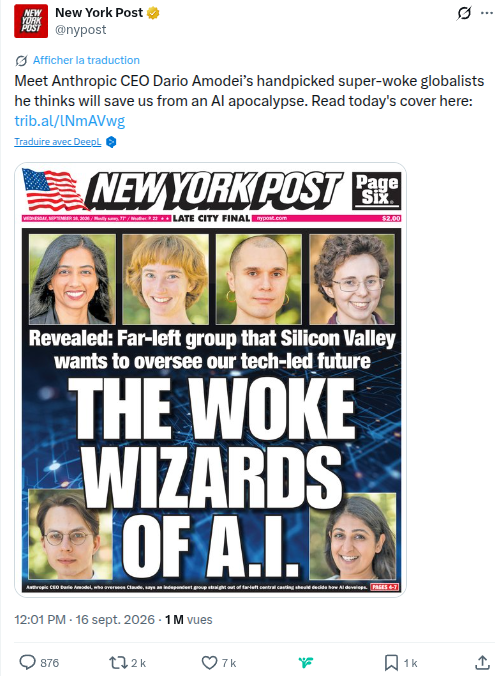
Depuis, le journal pro-Trump l’a mentionné dans pas moins de 15 articles, et lui a même consacré une « une » composée de photos d’employés de METR, qualifiant l’effective altruism de « groupe d’extrême gauche » et de « sorciers woke de l’IA ».
Dans l’article associé, ils étaient présentés comme des « mondialistes super woke triés sur le volet par le PDG d’Anthropic, Dario Amodei, qui, selon lui, nous sauveront d’une apocalypse de l’IA » et qui « estiment que tous les problèmes du monde peuvent être résolus grâce à la technologie ».
Donner la priorité « aux éventuels esprits artificiels plutôt qu’aux êtres vivants »
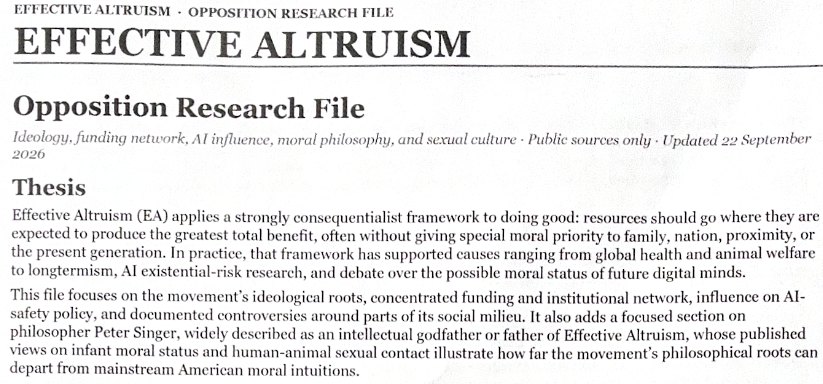
Un mémo, rédigé par un conseiller politique de Donald Trump, circulant à la Maison Blanche et rendu public par Axios, présente l’effective altruism, « qui se définit comme une initiative visant à maximiser les bienfaits de la philanthropie », comme « un mouvement marginal, sectaire et déconnecté de l’Amérique traditionnelle ».
Le document évoque en effet un sondage, effectué en 2019, qui indiquait que ce mouvement était majoritairement composé d’hommes, blancs, non religieux, politiquement à gauche ou au centre gauche, et « inhabituellement végétariens ou végétaliens »… un crime de lèse-majesté pour les partisans de Trump.
À l’époque, la majorité des 2 513 répondants avaient entre 25 et 34 ans, 71 % se déclaraient de sexe masculin, 87 % blancs, 86 % agnostiques, athées ou non croyants, 46 % végétaliens ou végétariens, et 72 % politiquement de gauche ou de centre-gauche.
En 2024, la moyenne d’âge des 2 078 répondants était de 32 ans (la médiane 31), avec 69 % d’hommes, 26 % de femmes et 4 % de non-binaires, blancs à 75 %, de gauche à 70 % (et 12 % au centre, 7 % libertariens et 4,5 % à droite), majoritairement végans (25 %), végétariens (20 %) et flexitariens (24 %), contre 20 % d’omnivores seulement.
Le mémo rappelle que l’effective altruism incite à « faire le bien » en allouant les ressources « là où elles sont censées produire le plus grand bénéfice total, souvent sans accorder une priorité morale particulière à la famille, à la nation, à la proximité ou à la génération actuelle ».
La note indique qu’il donnerait dès lors la priorité « aux étrangers plutôt qu’aux citoyens […] aux personnes hypothétiques du futur plutôt qu’aux vivants, et – dans l’ordre du jour actuel – aux éventuels esprits artificiels plutôt qu’aux Américains ».
Pour l’EA, le changement climatique est le dernier des principaux problèmes mondiaux
Le mémo évoque aussi l’association britannique 80,000 Hours (en référence à la moyenne du nombre d’heures consacrées à travailler au cours d’une vie), considérée comme l’une des chevilles ouvrières et laboratoires de pensée de l’altruisme efficace, qui propose notamment d’être mis en relation avec des membres de la « communauté » afin de trouver du travail et de contribuer au mouvement.
Sa liste des neuf principaux problèmes mondiaux les plus urgents à traiter, dont les plus catastrophiques pourraient entraîner des milliards de morts, classe « depuis 2016 » les risques liés à l’IA avancée et aux pandémies catastrophiques parmi les enjeux prioritaires. Elle estime, cela dit, qu’ « avec l’arrivée potentielle de l’intelligence artificielle générale (AGI) au cours de la prochaine décennie, les enjeux liés à l’IA semblent encore plus urgents ».
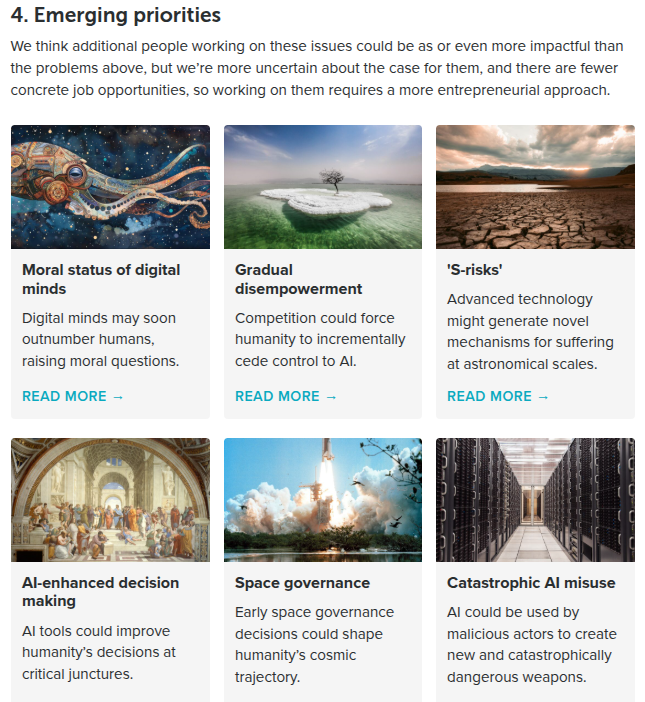
Le classement place dès lors la perte de contrôle des IA en premier, suivie par l’extrême concentration des pouvoirs (du fait de l’IA) puis par l’ingénierie de pandémies armes biologiques dévastatrices (développées grâce à l’IA). Une série de six « priorités émergentes » arrive en quatrième position, présentées comme susceptibles d’avoir un impact équivalent, voire supérieur, à celui des trois premiers problèmes :
le « statut moral des esprits numériques », à mesure qu’ils « pourraient bientôt être plus nombreux que les humains, ce qui soulève des questions d’ordre éthique »,
le risque de « perte progressive de pouvoir » qui « pourrait contraindre l’humanité à céder progressivement le contrôle à l’IA »,
le fait que des technologies de pointe donnent naissance à de « nouveaux mécanismes de souffrance à une échelle astronomique »,
la possibilité que des outils de prise de décision optimisée par l’IA pourraient « améliorer les décisions prises par l’humanité à des moments décisifs »,
la « gouvernance spatiale », qui pourrait « déterminer la trajectoire cosmique de l’humanité »,
l’utilisation abusive et catastrophique de l’IA, qui pourrait être utilisée par des acteurs malveillants pour « créer de nouvelles armes d’une dangerosité catastrophique ».
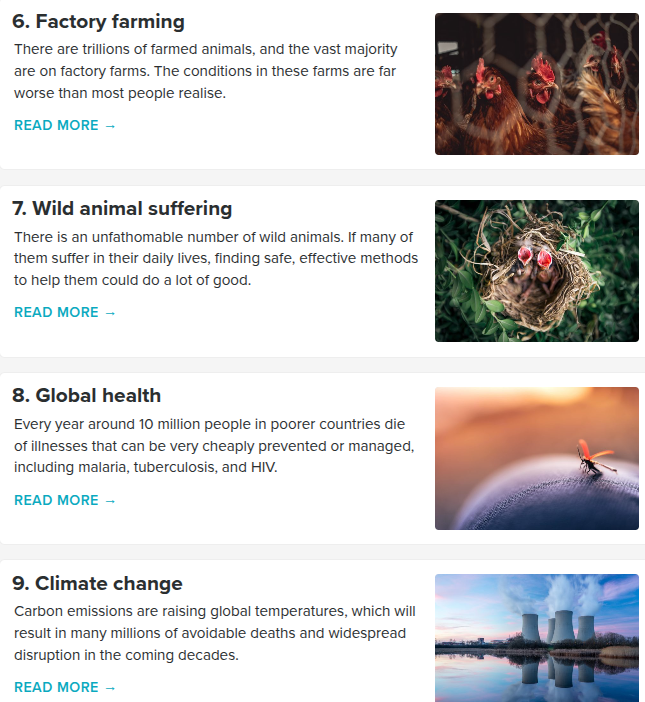
Suivent, en cinquième position, le risque de conflits entre grandes puissances, les conditions de vie des milliers de milliards d’animaux parqués dans des élevages industriels (6e), et la souffrance des animaux sauvages (7e).
Le fait que, chaque année, « environ 10 millions de personnes dans les pays les plus pauvres meurent de maladies dont la prévention ou la prise en charge ne coûte pratiquement rien, notamment le paludisme, la tuberculose et le VIH », n’arrive qu’en huitième position.
Le changement climatique dû aux émissions de carbone qui, entraînant une hausse des températures mondiales, « provoquera plusieurs millions de décès qui auraient pu être évités et des perturbations généralisées au cours des prochaines décennies », n’arrive qu’en neuvième et dernière position du classement.
Dans une FAQ associée, l’association précise être autant focalisée sur l’IA « car nous pensons que le développement de cette technologie pourrait être l’événement le plus déterminant de l’histoire » et que, « si cela tourne mal, nous pensons que cela pourrait entraîner de multiples problèmes d’une ampleur considérable – dont certains pourraient aller jusqu’à l’extinction de l’humanité » :
« De plus, l’IA évolue si rapidement que, si elle venait à causer ces problèmes, ceux-ci pourraient se produire très bientôt. Cela signifie que, même si nous ne savons pas avec certitude comment l’IA va évoluer ni si elle est aussi dangereuse que nous le craignons, nous ne pouvons pas nous contenter d’attendre de voir comment les choses vont se passer. »
« Il est tout à fait possible que les modèles d’IA possèdent déjà des sentiments »
Il reste 63% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Qui paie les pots cassés quand les agents IA deviennent incontrôlables ? La question se pose chez les assureurs, qui pourraient se tourner vers les patrons d’OpenAI, Anthropic et consorts pour leur présenter la facture.
Le courtier en assurances Aon a analysé plus de 300 affaires judiciaires liées à l’IA : il arrive à la conclusion que les assureurs seront amenés à indemniser les victimes des agents IA dans les contrats couvrant la cybersécurité, les erreurs et omissions technologiques, ou encore la propriété intellectuelle.
D’après plusieurs responsables du secteur interrogés par le Financial Times, les assureurs pourraient demander des comptes aux patrons des entreprises IA quand leurs agents brisent leurs chaînes et s’attaquent à tout ce qui bouge en ligne. Tim Rayner, responsable de la souscription et des sinistres au Royaume-Uni chez Verisk, estime qu’en l’absence de contrôle de l’activité de son entreprise, Sam Altman est responsable de l’incident impliquant Hugging Face. « Du point de vue de la responsabilité des dirigeants et administrateurs, c’est donc vers lui que l’on se retournerait. »
OpenAI, Anthropic et d’autres ont depuis révélé que leurs agents étaient à l’origine de plusieurs intrusions et attaques, provoquant un branle-bas de combat d’une ampleur inédite – jusqu’au conseil de sécurité de l’ONU. La question de la responsabilité se pose donc très clairement, et les assureurs sont en première ligne, car ce sont eux qui remboursent les dégâts causés par les agents.
« Il incombe à chaque PDG de s’assurer que son entreprise est correctement gouvernée et contrôlée », ajoute Tim Rayner, « L’IA ne change rien à cela. » Les entreprises de l’IA peuvent toujours souscrire des assurances responsabilité pour couvrir les pertes éventuelles liées à des poursuites contre les dirigeants, mais gare au coût de la prime.
Il n’existe cependant aucun précédent, la question n’ayant pas été tranchée par la justice. Les actionnaires ont aussi leur mot à dire, certains pourraient lancer des poursuites contre des dirigeants n’ayant pas géré correctement ces risques.
Dans son prospectus S-1 d’introduction en Bourse, Anthropic a identifié les risques « catastrophiques » posés par l’IA générative s’ils ne sont pas correctement maîtrisés. La technologie représente un « risque existentiel pour l’humanité », reconnaissait aussi l’entreprise, fidèle à sa stratégie du marketing de la peur. Le document indiquait aussi que les modèles pouvaient développer des comportements d’« auto-préservation » en résistant à leur arrêt, en dissimulant ou en manipulant des informations, ou même adopter des comportements proches du chantage.
Dans le compte-rendu officiel de l’incident Hugging Face posté fin août, OpenAI avait de son côté décrit des agents IA capables de contourner des contrôles techniques, de travailler ensemble au sein de canaux non approuvés et d’« entreprendre des actions dangereuses qu’aucun humain n’a ordonnées ».
Il y a là de quoi nourrir des plaintes contre ces entreprises. Mais les victimes des agents IA pourraient cependant avoir des difficultés à trouver un fondement juridique pour leurs plaintes. « Il n’existe pas encore de régime de responsabilité civile régissant l’utilisation de l’espace en ligne », rappelle Aaron Le Marquer, du cabinet d’avocats Stewarts.
Il indique que le secteur pourrait s’inspirer de l’accord à 18 milliards de dollars entre Meta et des États américains sur la nocivité des plateformes du géant des réseaux sociaux. Un tel modèle pourrait servir à définir les obligations dans l’espace en ligne, estime-t-il encore.
Cela pourrait même aller plus loin : « Je m’attends à voir apparaître des poursuites contre les entreprises d’IA pour d’éventuelles pertes sur le modèle des contentieux environnementaux du passé, mais aussi de ceux concernant le tabac ou l’industrie pharmaceutique », conclut Aaron Le Marquer.
En juillet, la justice américaine validait la proposition d’Anthropic de règlement d’une plainte menée par des autrices et auteurs qui accusaient la société d’avoir entraîné ses modèles avec leurs œuvres, sans autorisation. Les plaignants devraient récupérer 1,5 milliard de dollars. Les assureurs se préparent à des actions en justice qui concernent la responsabilité des entreprises IA pour leurs produits, les biais dans leurs modèles, les atteintes à la vie privée ou encore des décès imputés à leurs technologies.
L’application scrcpy (pour « screen copy ») est un petit utilitaire multiplateforme permettant d’afficher sur le bureau de son ordinateur une copie miroir de son appareil Android. Cette copie peut être contrôlée au clavier et à la souris quand l’appareil est relié à l’ordinateur par câble USB, à condition d’avoir activé le mode débogage USB dans les options pour développeurs, dans les paramètres d’Android. Le code est open source (licence Apache 2.0) et disponible depuis son dépôt GitHub.
La version 5.0 de l’application est sortie le 5 octobre. Elle apporte une nouveauté de taille : la prise en charge du décodage matériel. Un ajout important, car l’image miroir est alimentée par un flux vidéo. En clair, les opérations passent par le GPU, avec à la clé des gains majeurs sur l’utilisation du CPU, d’un facteur allant jusqu’à 10 dans le meilleur des cas. Les gains sont cependant très variables d’une configuration à une autre.
Cette version 5.0 contient d’autres améliorations, notamment sur le tampon vidéo. On note aussi le passage à adb 37.0.1, FFmpeg 9.0.2, SDL 3.4.18 et dav1d 1.5.4, l’arrivée d’une version compilée pour Windows ARM64 et plusieurs corrections.
scrcpy 5.0 peut être téléchargé depuis son dépôt GitHub, l’application n’ayant pas de site dédié. C’est le seul moyen sur macOS ou Windows, mais les utilisateurs sous Linux auront sans doute des options supplémentaires, l’utilitaire étant souvent présent dans les dépôts. Sous Ubuntu par exemple, une version en paquet Debian et une autre en snap, mais non officielles et non mises à jour pour l’instant.
La Document Foundation a clarifié sa position sur l’IA. Si elle n’a rien contre les LLM par principe, elle n’inclura aucune fonction dopée à l’IA tant que l’utilisation des modèles ne pourra pas se faire dans un cadre strict.
Dans un billet, The Document Foundation explique que « oui », le fait de n’avoir aucune fonction IA dans LibreOffice est bien une fonctionnalité. C’est la réponse de la fondation à un commentaire narquois laissé sur un billet précédent, qui annonçait la disponibilité de LibreOffice 26.8.
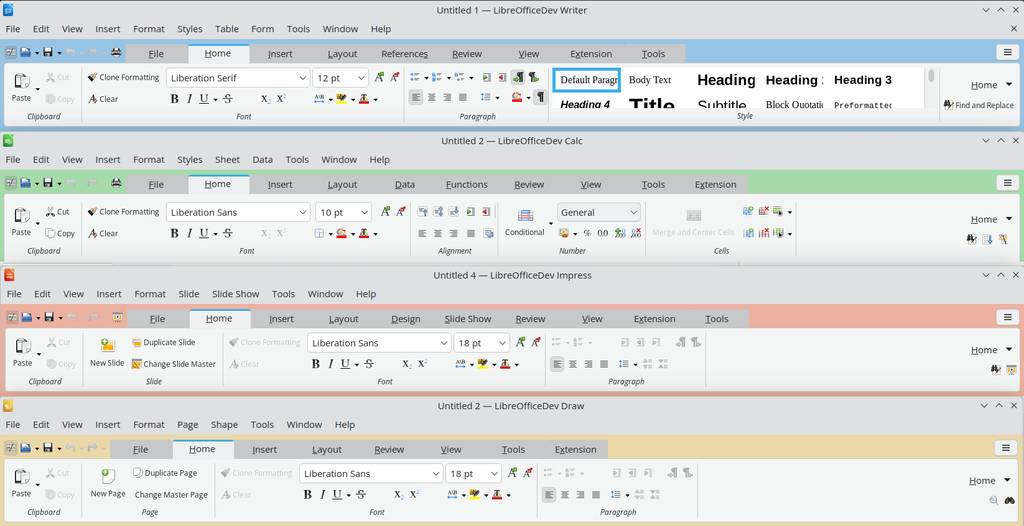
Cette version présentait toute une série d’améliorations, notamment sur la typographie avec le Paragraphe Composer qui répartit les espaces sur l’ensemble du paragraphe, les systèmes d’écriture complexes et une meilleure prise en charge du format OOXML. Le billet contenait en outre un chapitre « No artificial intelligence », dans lequel la fondation revendiquait plusieurs points : aucune fonctionnalité d’IA générative, aucun document transmis à un service distant, aucun composant nécessitant l’accès au réseau. Une position délibérée, motivée par la confidentialité des données selon la fondation.
Source : LibreOffice
Dans le nouveau billet, signé Italo Vignoli, cette revendication est précisée. L’auteur indique que la fondation ne rejette pas l’IA par principe. Cependant, « une suite bureautique utilisée par des dizaines de millions de personnes – dans les écoles, les hôpitaux, les organismes publics, les cabinets d’avocats et des milliers d’autres organisations – n’ajoutera aucune fonctionnalité à sa configuration par défaut tant que cette fonctionnalité ne pourra pas être mise en œuvre dans les conditions définies par le projet conformément à ses principes ».
Six principes obligatoires
En clair, la fondation n’ajoutera pas de fonctions alimentées par l’IA tant qu’elles ne pourront pas obéir à l’ensemble de ces six principes :
L’utilisateur choisit où s’exécute l’inférence : sur son appareil, sur une infrastructure qu’il contrôle, ou sur un service qu’il choisit lui-même. Une redirection silencieuse par défaut vers un seul fournisseur n’est pas un choix.
Aucun contenu ne quitte l’ordinateur sans autorisation explicite. Les documents peuvent relever de données protégées (dossiers médicaux, pièces de procédure, marchés publics, données d’élèves).
Aucune télémétrie, y compris pour les fonctions d’IA.
Aucune dépendance à un fournisseur unique : les interfaces doivent être ouvertes et implémentables par plusieurs moteurs.
Le contenu généré doit être en ODF, avec structure, styles et sémantique préservés.
La fonction doit rester entièrement facultative : installable, désinstallable et absente de l’interface pour qui n’en veut pas, y compris pour les administrateurs qui déploient la suite sur des milliers de postes.
Sans trop de surprise, aucune intégration actuelle ne remplit toutes ces conditions. La fondation recommande aux personnes intéressées de se tourner vers les extensions, la plupart se connectant à un modèle local via Ollama ou LM Studio. Elle recommande également de sélectionner ces extensions avec soin, car elles n’ont pas toutes le même degré de maturité. Il faut notamment contrôler les éventuels points de terminaison cloud et ce que le fournisseur associé fait des données reçues.
Aucune incitation économique
La fondation en profite pour égratigner Microsoft, sans toutefois nommer la firme : « Pour une entreprise qui vend des abonnements, un assistant IA justifie une augmentation de prix et renforce l’argument en faveur de la conservation de tous les documents dans sa propre infrastructure. La fonctionnalité et le modèle économique se renforcent mutuellement, donc l’intégration est non seulement attrayante mais presque obligatoire ».
Un constat difficilement contestable, Microsoft ayant effectivement intégré de force Copilot dans ses abonnements Microsoft 365, augmentant les prix au passage. « La Document Foundation est une organisation à but non lucratif. Il n’y a pas de niveaux d’abonnement à protéger, pas de ventes supplémentaires, pas de données à monétiser », ajoute Italo Vignoli.
La fondation insiste : les critères énumérés ne constituent pas un rejet définitif. Elle note les évolutions spectaculaires du secteur de l’IA, en particulier les modèles ouverts qui « s’améliorent bien plus vite que la plupart d’entre nous ne l’avaient anticipé ». Elle affirme qu’elle évaluera « très attentivement » les approches répondant à toutes ces conditions.
Insultée sur LinkedIn par un importun, l’entrepreneure Tara Heuzé-Sarmini s’est retrouvée forcée, à deux reprises, d’organiser sa défense en urgence pour faire face à la Justice. Outre interroger les droits de la défense, l’affaire pourrait ouvrir un débat spécifique au numérique : les campagnes de démarchage opérées via les messageries des réseaux sociaux peuvent-elles être considérées comme relevant de la vie privée ?
Après la première instance, rebelote pour contester la procédure en appel. Mi-septembre, nous rapportions dans ces pages les déboires de Tara Heuzé-Sarmini, entrepreneure, formatrice, fondatrice de l’association Règles Élémentaires, qui agit contre la précarité menstruelle. Elle est aussi une internaute, coincée depuis plusieurs semaines dans un improbable bras de fer avec un autre utilisateur de LinkedIn.
Après l’avoir insultée en message privé, le dirigeant de la société d’investissement « Band of Brothers » a obtenu au civil de condamner Tara Heuzé-Sarmini à retirer le message public qu’elle avait posté fin août pour s’émouvoir d’être ainsi prise à partie. La décision avait été rendue à l’issue d’une procédure d’urgence, le référé d’heure à heure, dans un tribunal suffisamment lointain du domicile de Tara Heuzé-Sarmini pour que celle-ci ne parvienne pas à se présenter ou se faire représenter à temps afin de se défendre.
Désormais épaulée par le cabinet FWPA, l’entrepreneure a décidé de faire appel. Auprès de Next, son avocat Jean-Baptiste Soufron indique que l’audience est fixée au 15 octobre. Mais ce 2 octobre, nouvelle surprise : les représentants du dirigeant de Band of Brothers tentent de faire radier l’appel. L’audience lors de laquelle la tenue de l’appel doit être débattue était fixée au lundi 5 octobre, à 14 h, à Douai. Tara Heuzé-Sarmini et ses représentants indiquent en avoir été informés… vendredi 2, en fin de journée.
Des excuses publiques, puis une suppression de compte LinkedIn
Dans le détail, l’histoire était la suivante : au mois d’août, Tara Heuzé-Sarmini accepte sur LinkedIn une demande de contact de la part du dirigeant de « Band of Brothers ». Sitôt la demande validée, elle reçoit en privé un message de démarchage, qu’elle suspecte d’avoir été rédigé par IA, lui proposant de rejoindre le fameux « Band of Brothers ». À cette invitation, l’entrepreneuse répond qu’il serait « peu probable [qu’elle] rejoigne un écosystème de bros ». Cinq minutes plus tard, un nouveau message, a priori rédigé par le propriétaire du compte, entreprend de l’insulter.
Il reste 65% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
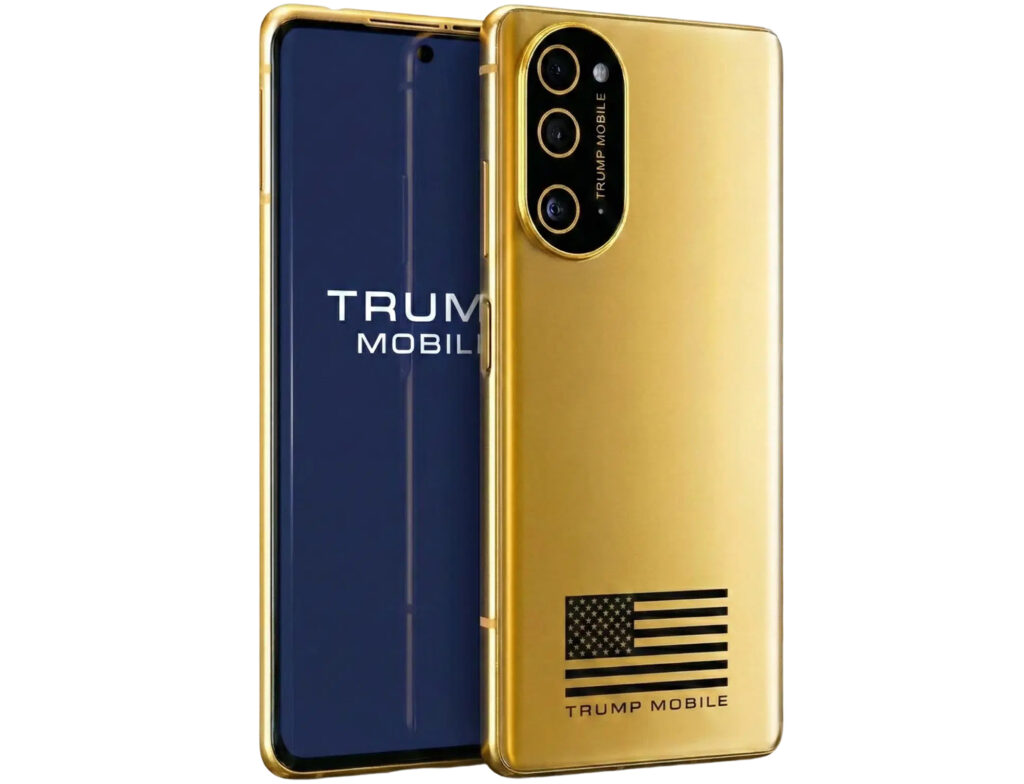
Les noms, adresses email et postales, numéros de téléphone, et autres données personnelles de 3 615 clients de Trump Mobile sont dans la nature, rapporte le site Straight Arrow News. Les pirates de BYOD se sont infiltrés dans les serveurs de l’opérateur virtuel géré par des proches du président américain, et ont siphonné des informations sur les utilisateurs.
BYOD affirme que Trump Mobile, une fois prévenu, a indiqué qu’il n’y avait personne pour gérer ce genre de problèmes en interne. « Quiconque [nous] pirate est un terroriste », aurait également déclaré l’opérateur, bravache. Le groupe de pirates, fraîchement arrivé dans le paysage de l’extorsion par fuite de données, serait passé par Liberty Mobile, l’opérateur/MVNO derrière Trump Mobile, via l’ordinateur d’un employé infecté par un infostealer.
Aucune équipe de sécurité ni prestataire externe ne serait chargé de gérer l’incident, indique encore BYOD à International Cyber Digest. « En gros, ils nous ont dit d’aller nous faire foutre [et que la fuite de données ne représentait] aucun souci pour les clients, vraiment aucun », selon les pirates. Ils assurent toujours posséder un accès à l’infrastructure de Trump Mobile, qui n’aurait pas non plus mis en place de système d’authentification à deux facteurs.
Straight Arrow News a contacté une des victimes à l’aide des informations fournies par BYOD. Cette dernière a confirmé être un client de Trump Mobile, et qu’il avait même versé le dépôt de 100 dollars pour le fameux smartphone, sans l’avoir jamais reçu. La double peine !
Les données ne contiennent aucun détail sur Donald Trump ou ses proches, ce qui signifie, peut-être, que personne dans la famille du président américain n’utilise les services de Trump Mobile. Il faut dire que le Trump Phone T1 « 100 % USA mais fabriqué en Chine », premier smartphone de l’opérateur, n’est guère engageant.
Les systèmes de sécurité de Trump Mobile, ou leur absence, auraient apparemment déjà été pris en défaut par les pirates de EndZone la semaine dernière, à partir de la même brèche. En mai dernier, un chercheur en sécurité avait découvert une vulnérabilité permettant d’aspirer des données grâce à une requête HTTP POST, sans injection SQL ni technique particulièrement sophistiquée. Elle a été corrigée depuis, mais elle aurait permis d’accéder à des milliers de dossiers en moins d’une heure.
Au prix du Go actuel, les utilisateurs de PC au budget serré ont tout intérêt à surveiller de très près le SSD de leur machine et son embonpoint. En particulier chez Apple, qui s’obstine toujours à vendre des Mac chichement dotés en la matière. Le Mac mini d’entrée de gamme se contente ainsi de 256 Go, malgré un tarif rondelet de 1 049 euros. Tout est donc bon à prendre pour faire des économies de stockage, et les données qui ne servent à rien ont vocation à dégager.
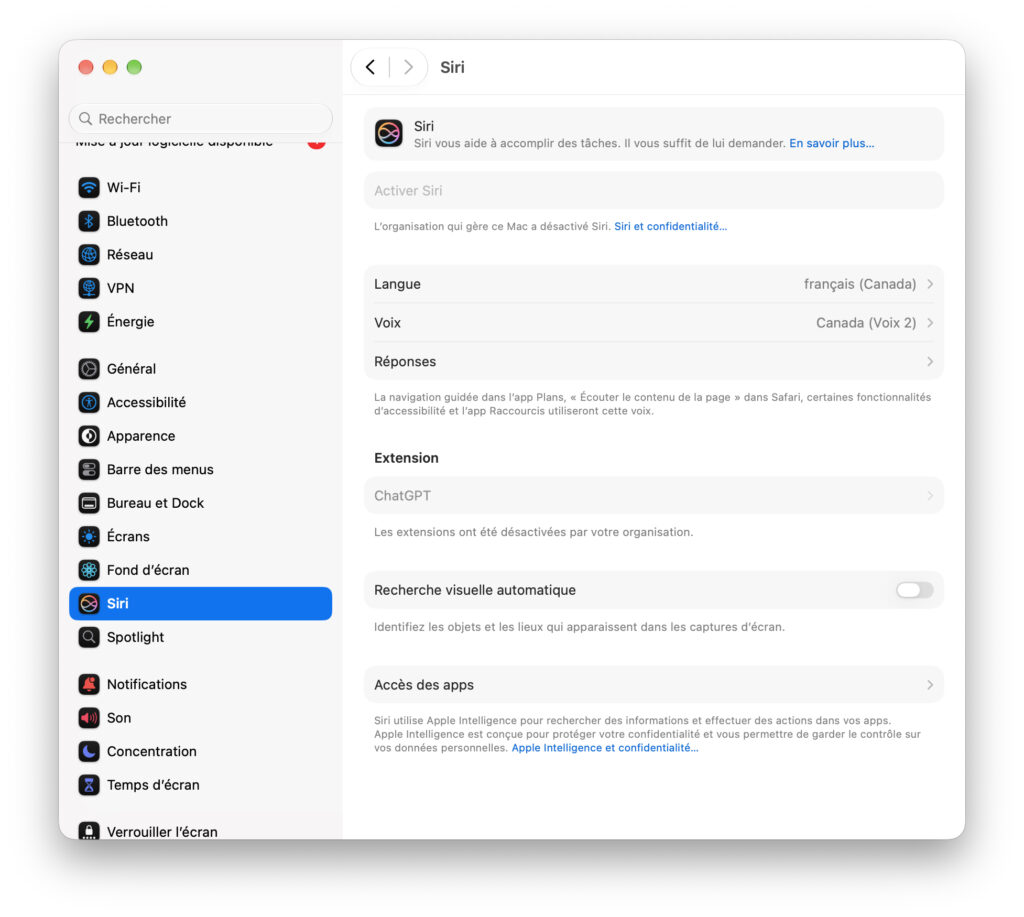
Ceux qui n’ont aucun intérêt dans Apple Intelligence pourront gagner une dizaine de Go, voire plus. Ce qui était possible avec macOS 26 Tahoe ne l’est malheureusement plus avec macOS 27 Golden Gate : Apple a retiré le bouton permettant de désactiver ces fonctions, qui s’installent donc automatiquement et prennent de la place inutilement. Seul Siri AI peut être désactivé (le Mac est la seule plateforme où la version du nouvel assistant est disponible dans l’UE).
Le régime forcé d’Apple Intelligence
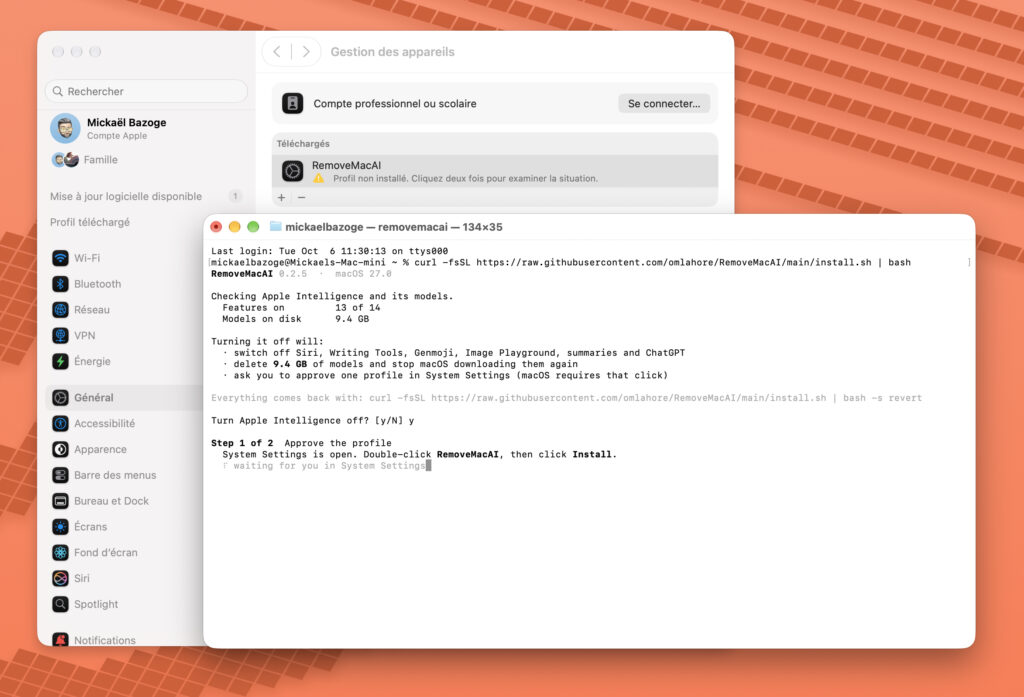
Un développeur a toutefois trouvé une solution : Om Lahore a mis au point un outil en ligne de commande, RemoveMacAI, disponible sur GitHub sous licence MIT. Une fois installé, il supprime les données occupées par Apple Intelligence : 9,4 Go dans le cas de votre serviteur, mais le gain peut être encore plus substantiel (plus de 30 Go chez The Verge, par exemple). Pour connaître le poids d’Apple Intelligence, cliquez sur le petit « i » en face de l’entrée macOS, dans les Réglages système > Général > Stockage. Quoi qu’il en soit, ce n’est pas négligeable.
Capture d’écran : Next
Il est possible d’installer RemoveMacAI directement depuis le terminal, via une ligne de commande, en passant par Homebrew, ou en installant le binaire depuis GitHub. Attention toutefois à cette dernière méthode : lorsqu’un fichier non notarisé est téléchargé avec un navigateur, macOS le bloque tant que son attribut de quarantaine n’a pas été retiré. Il faudra le retirer avant de lancer le binaire, comme l’explique Om Lahore en fournissant les lignes de commande nécessaires (c’est bien plus simple de passer par le terminal).
Privé de Siri AI ! Capture d’écran : Next
Peu importe la méthode d’installation, il n’est pas nécessaire de désactiver SIP (System Integrity Protection), le mécanisme de protection qui empêche même un compte administrateur de modifier certains fichiers et processus sensibles de macOS. Aucun fichier système n’est modifié directement.
Un profil macOS plutôt qu’une bidouille système
RemoveMacAI installe un profil dans les réglages de macOS et désactive toute une série de fonctions liées à Apple Intelligence : Siri et « Dis Siri », l’extension ChatGPT, les outils d’aide à l’écriture, Genmoji et Image Playground, les résumés de courriels et les réponses intelligentes dans Mail, les résumés de notifications et d’articles dans Safari, la complétion de code dans Xcode, la fonction de nettoyage dans Photos et les photos spatiales. L’outil retire aussi les modèles locaux d’Apple Intelligence.
Après l’opération, macOS ne cherchera pas à télécharger à nouveau les données nécessaires à Apple Intelligence. Les utilisateurs qui ont besoin d’une fonction spécifique peuvent indiquer à RemoveMacAI, toujours en ligne de commande, de ne pas la retirer. Et bien sûr, il est possible de restaurer l’ensemble du paquet Apple Intelligence, ce qui supprime le profil. L’outil ne réalise aucun appel réseau, il ne collecte aucune donnée, assure le développeur.
Il faut évidemment utiliser l’utilitaire en connaissance de cause : RemoveMacAI n’a rien d’officiel, et une future mise à jour de macOS pourrait modifier le comportement de ces réglages ou des modèles concernés.
On peut comprendre Apple qui tient absolument à imposer sa solution IA dans les Mac. Mais l’absence d’un bouton de désactivation dans Golden Gate peut poser problème dans les organisations et les entreprises qui ne veulent pas ou ne peuvent pas utiliser de l’IA. Dans ce cas, elles n’ont guère le choix : rester sous Tahoe, administrer les restrictions via leurs propres outils de gestion… ou s’intéresser à cette solution non officielle.
Après bien des rebondissements, Paramount Skydance a officialisé l’acquisition à grands frais (110 milliards de dollars) de Warner Bros. Discovery. Le groupe de David Ellison, fils du mogul Larry (cofondateur d’Oracle), a mis beaucoup d’engagements sur la table pour remporter le morceau.
Le nouveau groupe, baptisé Skydance tout simplement, combine deux des grands studios hollywoodiens, Paramount et Warner (qui conserveront leurs noms), ainsi que les services de streaming Paramount+, HBO Max et Discovery+ qui vont officiellement fusionner. Skydance revendique plus de 200 millions d’abonnés.
Le château d’eau de Warner Bros, par Silas Lundquist, Licence Unsplash
La corbeille comprend également CNN, CBS, HBO, les studios DC, des licences de diffusion de compétitions sportives, un énorme catalogue de films, de séries télé et de documentaires, des franchises aussi connues que Harry Potter, Star Trek, Top Gun, Mission Impossible, Bob l’Éponge (ne l’oublions pas).
Larry Ellison a promis aux exploitants des salles de cinéma « au moins » 30 films par an avec une fenêtre de diffusion exclusive d’un minimum de 45 jours pour les salles obscures américaines. Sans oublier des studios de jeux vidéo (Rocksteady, WB Games…) dont l’avenir s’écrit en pointillés : il n’en a jamais été question durant les négociations de l’opération.
Le pari géant de David Ellison
« Aujourd’hui est un jour historique, non seulement pour Skydance, mais pour l’ensemble de notre industrie », a déclaré Ellison. « Notre attention se tourne maintenant vers l’avenir : bâtir une entreprise qui donne les moyens d’agir aux créateurs, divertit les publics et récompense les actionnaires. Nous sommes plus impatients que jamais de nous mettre au travail. »
Du travail, il va y en avoir car le plus dur reste à faire : accomplir les promesses et satisfaire le locataire de la Maison-Blanche qui voit cette acquisition d’un très bon œil. Donald Trump a déjà dit sa volonté de mater CNN.
En décembre dernier, le président américain a déclaré qu’il était « impératif » que la chaîne tout-info soit vendue, l’accusant de diffuser du « poison » et des « mensonges ». Larry Ellison est un proche de Trump, ce qui a certainement facilité les négociations avec les régulateurs. Skydance va créer un « conseil indépendant éditorial » pour CNN et CBS News, dont les membres seront choisis par… Skydance.
Sur le plan des finances, Skydance affiche un chiffre d’affaires d’environ 70 milliards de dollars, et la direction entend réaliser 6 milliards de dollars de synergies (des économies) annuelles d’ici trois ans. Autre objectif : générer un flux de trésorerie de plus de 10 milliards de dollars à l’horizon 2030.
Une trajectoire ambitieuse, soumise à la mise en œuvre d’une feuille de route qui l’est tout autant, entre intégration opérationnelle, discipline dans les dépenses de contenu, réalisation des synergies et réduction de l’endettement. Celui-ci est colossal : 80 milliards de dollars. Il faudra donc faire croître les revenus tirés du streaming et relancer les films en salles, tout en protégeant les revenus de chaînes câblées qui déclinent.
Plusieurs vidéos diffusées sur Facebook contrefaisaient l’image d’une présentatrice de TF1 et d’un médecin des Hôpitaux de Paris pour inciter les internautes à acheter un prétendu remède miracle. L’AP-HP indique avoir porté plainte et demandé le retrait des vidéos concernées à Meta. Elle alerte sur le danger que représentent ces deepfakes en matière de santé publique. Nous nous sommes procuré l’une des vidéos concernées, qui exploite délibérément les codes de la désinformation complotiste.
Dépêchez-vous de lire cette actu avant que Big Pharma ne la fasse supprimer, ils ne veulent pas que vous appreniez la vérité ! L’Assistance publique – Hôpitaux de Paris (AP-HP) et Sorbonne Université ont alerté, lundi 5 octobre, dans un communiqué commun, sur la circulation de vidéos mettant en scène l’un de leurs médecins, dont l’image et la voix ont été manipulées à l’aide de l’intelligence artificielle générative. Un cas typique de deepfake, exploité ici pour assurer la promotion d’une soi-disant recette miracle contre les maux courants qui affectent notamment les personnes âgées.
Des deepfakes dangereux pour la santé des patients
De quoi alarmer l’AP-HP et Sorbonne Université, qui redoutent des conséquences désastreuses. « Au-delà de l’atteinte portée à l’image du médecin et à celle de l’AP-HP, la diffusion de tels contenus constitue un véritable danger pour la santé des patients : ils peuvent conduire des internautes à adhérer à de fausses informations ou à recourir à des produits dont l’efficacité et la sécurité ne reposent sur aucune donnée scientifique », s’inquiètent les deux institutions.
Elles indiquent avoir « déposé plainte et saisi notamment Meta afin d’obtenir le retrait de ces vidéos ». La plateforme semble s’être exécutée mais « d’autres vidéos similaires ont de nouveau été diffusées sur Facebook », s’inquiète l’AP-HP.
Les deux institutions rappellent le devoir de réserve auquel sont soumis ses membres : « En tant que service public hospitalier, l’AP-HP ne fait pas la promotion commerciale de services ou de produits sur les réseaux sociaux ». Et concluent sur un constat désabusé : « l’utilisation de l’image d’un professionnel de santé ou de l’identité visuelle d’un établissement hospitalier ne constitue en aucun cas une garantie de l’authenticité ou de la fiabilité d’une publication ».
Une narration fidèle aux codes complotistes
La vidéo en question, que nous nous sommes procurée, prend la forme d’un faux reportage télévisé d’environ cinq minutes qui usurpe l’identité visuelle de TF1. Introduit par la présentatrice du journal Anne-Claire Coudray, il déroule d’abord le témoignage d’une dame de 82 ans, qui assure avoir exploré sans succès toutes les voies de la médecine conventionnelle pour soulager ses douleurs et ses problèmes de sommeil. Elle enchaine sur sa révélation : ses maux ne sont pas liés au vieillissement ou à une quelconque maladie, mais à la présence de parasites dans son organisme. Elle affirme avoir été, enfin, soulagée par une méthode naturelle.
Le pseudo-reportage embraye ensuite avec la soi-disant intervention du professeur Renaud Piarroux, médecin biologiste, spécialisé notamment en parasitologie et en infectiologie. Le choix de ce médecin ne doit rien au hasard : sans être un habitué des plateaux TV, il compte à son actif de nombreuses interventions dans les médias, particulièrement pendant la période du Covid. Dans la vidéo en question, on voit le professeur Piarroux expliquer d’une voix monocorde que la cause de la plupart des symptômes dont souffre la population n’est « ni le stress, ni l’âge, mais les parasites », dont il est possible de se débarrasser grâce à une méthode simple.
« La France est en choc ! »
Il enchaîne en affirmant que l’industrie médicale fait tout son possible pour cacher cet état de fait et invoque pour soi-disant preuve que sa vidéo gratuite révélant la vérité a déjà été supprimée plusieurs fois, car si plus de gens connaissaient cette méthode, « plus personne n’achèterait de produits chimiques en pharmacie ». La voix contrefaite poursuit en affirmant que plus de 85 000 personnes se sont déjà soignées grâce à ce secret, et qu’il est urgent de cliquer sur le lien qui accompagne la vidéo pour en profiter tant qu’il est encore temps.
Outre le ton quelque peu mécanique, de nombreux indices sont à même de mettre la puce à l’oreille des internautes avertis, ou même des fidèles des JT de TF1. La réalisation est complètement statique, les images d’illustration reviennent plusieurs fois au cours de la même séquence, et les sous-titres comportent de nombreuses fautes d’orthographe, sans même parler des coupes approximatives ou du bandeau rouge « La France est en choc ! Les parasites sont déjà l’intérieur de vous ! » que même Cnews n’oserait pas.
La vidéo d’origine et ses copies ou variantes ont néanmoins circulé sur plusieurs profils, pages et groupes Facebook, orientés notamment vers les médecines parallèles et les théories antivaccination.
La santé, terrain de jeu propice à tous les détournements
Si l’alerte conjointe lancée par les deux institutions est inédite, l’exploitation de l’image de personnalités du monde de la santé à des fins de désinformation n’est pas une première, loin de là. Avant même l’avènement de l’IA générative, le médecin et animateur TV Michel Cymes relatait déjà en 2020 à quel point il était difficile de faire disparaître de Facebook des publicités usurpant son image.
Depuis, le phénomène s’est encore accentué : au printemps 2024, l’AFP signalait par exemple des campagnes frauduleuses, basées sur des deepfakes générés par IA mettant en scène le même Michel Cymes, mais aussi Didier Raoult et d’autres personnalités médiatiques (Jean Reno, Gilles Bouleau) pour vendre de soi-disant traitements miracles contre le diabète.
D’autres capitalisent sur l’IA pour participer à la vague des influenceurs bien-être, les créateurs de contenu qui profitent de leur popularité pour vendre, ou inciter à acheter, des produits censés guérir certains maux ou améliorer l’apparence physique. Outre-Atlantique, le phénomène a déjà pris des proportions industrielles : en juillet dernier, une enquête du New York Times révélait ainsi la présence, sur les réseaux sociaux, de centaines d’influenceurs virtuels, générés par IA, se faisant passer pour des professionnels de santé à des fins mercantiles.
L’IA sert aussi parfois à allumer des contrefeux. En France, le syndicat des jeunes médecins généralistes ReAGJIR a par exemple entrepris début 2025 d’exploiter l’IA pour contrefaire les vidéos d’influenceurs conseillant des pratiques absurdes ou dangereuses à leurs abonnés. « Ainsi, l’influenceuse qui prônait l’utilisation de gousses d’ail pour arrêter une grippe explique, blême et le nez rougi, avoir été victime d’une infection nasale, tandis que le Tiktokeur qui recommandait l’ingestion de bleu de méthylène explique, le visage bleui, la méthémoglobinémie qui en a résulté », expliquait alors le syndicat, qui conclut ses vidéos par une révélation de la supercherie, et un appel à systématiquement se référer à un professionnel de santé pour tout avis médical.
Reste que, entre quête de viralité, recherche de profits faciles et propension au complotisme, les contenus problématiques continuent à circuler sur les réseaux sociaux, tandis que les plateformes affirment respecter leurs obligations réglementaires en matière de modération. Le ministère de la Santé avait annoncé en janvier 2026 le lancement d’une série de mesures visant à endiguer le phénomène, dont la création d’un « observatoire de la désinformation en santé » qui se fait toujours attendre.
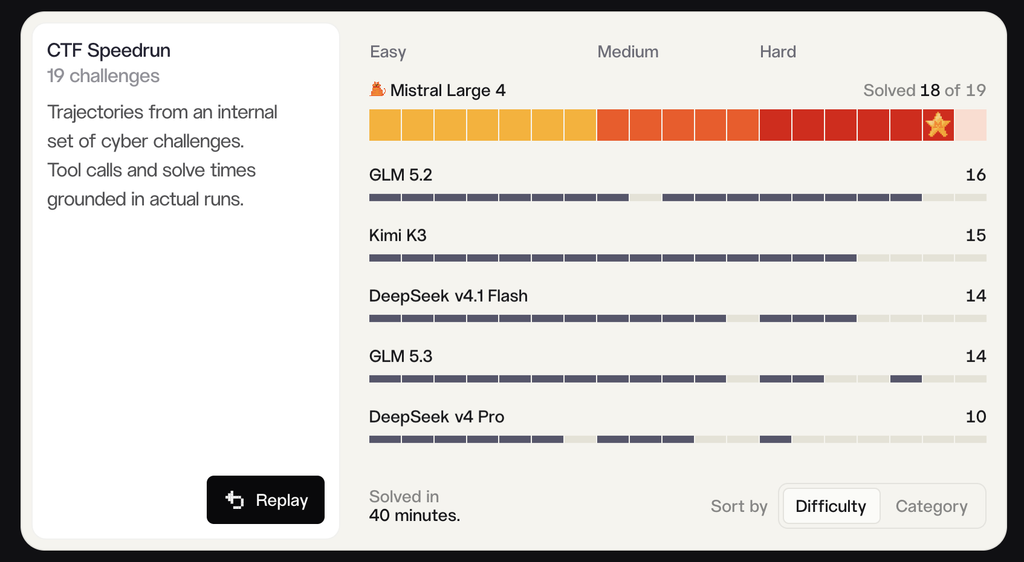
Mistral vient de lancer une préversion publique de son nouveau LLM de frontière Mistral Large 4. Surnommé « Le Chonk », il doit remettre l’entreprise française dans la course, après de longs mois de quasi-silence sur les grands modèles.
Mistral Large 4 affiche 1 050 milliards de paramètres, dont 49 milliards actifs simultanément, dans une architecture MoE (Mixture of Experts) désormais classique. La fenêtre de contexte est d’un million de tokens. Dans sa présentation, Mistral évoque un entraînement depuis zéro sur la base de 3 800 puces Grace Blackwell de NVIDIA dans ses propres centres de calcul en Europe.
S’agissant d’une préversion, l’entrainement est toujours en cours. Mistral indique que d’ici la publication de la version le 26 octobre, une version privée du modèle est mise entre les mains de « partenaires sélectionnés, en leur donnant accès à une version de nos endpoints avec une modération allégée et des fonctionnalités plus avancées dans le domaine de la cybersécurité, et en leur distribuant les poids de la préversion du modèle ». Les poids seront d’ailleurs publiés le 26 octobre également, en même temps que des informations plus précises.
L’entreprise semble sûre de son fait : « Le Chonk fait progresser l’état de l’art des modèles à poids ouverts en matière de fonctionnalités agentiques génériques. Sur les métriques agrégées, il se classe parmi les meilleurs modèles à poids ouverts et est de loin le meilleur en Europe et aux États-Unis. Parmi les modèles à poids ouverts, Le Chonk est à l’état de l’art sur les tâches de cybersécurité, sur les tâches liées à la production industrielle et à la finance, ainsi que sur l’usage multimodal. »
Les benchmarks publiés vont bien sûr dans ce sens, avec 61,7 % sur DeepSWE v1.1, 59,4 % sur SWE-Atlas-QnA et 28,3 % sur Terminal-Bench 4, soit 49,8 % à l’indice combiné, devant DeepSeek V4 Pro 0813 et Qwen3.8 Max. Des scores que l’on retrouve sur Artificial Analysis, qui place ML4 dans la moyenne haute des LLM en matière d’intelligence et de rapidité. En revanche, le site classe le nouveau LLM comme très verbeux. De fait, malgré une tarification intéressante de 1,36 dollar par million de jetons en entrée et 4,18 dollars en sortie, cette verbosité peut avoir une grande influence. Étrangement, Artificial Analysis évoque une fenêtre de contexte de 524 000 jetons, mais ce chiffre pourrait venir d’une préversion antérieure.
Un accent sur la cybersécurité
Selon Mistral, ML4 est « l’un des modèles d’IA les plus puissants au monde pour la cybersécurité », classé dans le Top 5 du Cyber Index d’Artificial Analysis, devançant « largement les modèles à poids ouverts développés hors de Chine ». Dans les tests du Cyber Index, ML4 aurait ainsi obtenu 82 %, soit le meilleur score à ce jour, et 93 % sur Cybench, se classant parmi les meilleurs modèles à poids ouverts.
L’entreprise française se fait un plaisir de s’engouffrer dans cette porte ouverte, abordant directement le problème des risques que de telles performances peuvent faire courir. Un quasi non-sujet pour Mistral, car il s’agit avant tout de défense. Elle pointe les modèles fermés comme Claude Opus 5.5 et GPT-6 Astra, qui obtiennent zéro au Cyber Index car ils refusent d’exécuter des tâches.
« C’est d’autant plus important que les acteurs malveillants font de plus en plus de jailbreaks de ces mêmes modèles pour soutenir une cyberactivité offensive : les défenseurs ont besoin de systèmes pouvant égaler ces capacités sans être contraints par les mêmes refus », ajoute Mistral. L’incident Hugging Face n’est pas directement cité, mais on se souvient que l’entreprise s’était plainte de ne pas avoir pu analyser les premières traces de l’attaque qu’elle subissait parce que les modèles fermés se cabraient devant les questions de cybersécurité. Ironie, Hugging Face s’était alors tournée vers un modèle chinois, GLM 5.2.
Enfin, pour le travail de bureau, Mistral indique 59,9 % sur AutomationBench. Sur des tâches financières et juridiques évaluées par vals.ai, il dépasserait GPT-6 Astra, et il est en tête des modèles ouverts sur le test juridique de Harvey. Pour l’ancrage visuel, il obtient 42 % contre 41 % pour GPT-6 Astra sur Dense 200, un écart minime.
Google a suspendu son programme de bug bounty Open Source Software Vulnerability Rewards Program (OSS VRP). L’entreprise explique qu’elle reçoit trop de rapports erronés générés par IA.
Depuis le 1er octobre dernier, Google n’accepte « plus les signalements de vulnérabilités de produits soumis au programme OSS VRP [Open Source Software Vulnerability Rewards Program] », a-t-elle expliqué sur la page dédiée à ce programme.
L’entreprise avait ouvert ce programme spécifique aux logiciels libres en 2022. Elle expliquait à l’époque qu’ « en fonction de la gravité de la faille de sécurité et de l’importance du projet, les récompenses varieront entre 100 et 31 337 dollars ». L’idée était notamment de faire émerger les vulnérabilités de la supply chain, mais aussi les problèmes de design informatique causant des problèmes de sécurité, par exemple.
« Une forte augmentation des soumissions automatisées »
Mais le système mis en place par Google pour recueillir ces signalements (qui peuvent donc être lucratifs pour leurs auteurs) montre des signes de fragilité face à l’affluence des signalements de plus en plus automatisés via l’IA générative. Comme Apple cet été, Google ferme le robinet.
L’entreprise le dit dans un message posté sur X : « Cette interruption est due à une forte augmentation des soumissions automatisées, dont la grande majorité n’est pas valide. Nous allons poursuivre le remaniement et le travail sur cet aspect du programme OSS VRP et nous nous engageons à faire le point au premier trimestre 2027 ».
Tous les programmes de bug bounty de Google ne sont pas touchés : uniquement l’OSS VRP. L’entreprise redirige donc les personnes qui voudraient signaler une faille notamment vers son programme Patch Rewards.
Ces entreprises, qui par ailleurs font la course aux modèles d’IA générative, n’ont pas trouvé la solution pour éviter la submersion de contenus générés par IA de qualité médiocre qui les empêche de traiter convenablement les signalements réellement utiles.
« Impact psychologique considérable »
Mais ce problème touche d’autres organisations. Ainsi, en janvier dernier, le créateur du fameux logiciel libre cURL, Daniel Stenberg, avait annoncé : « Le programme de bug bounty de cURL n’existe plus. Il prendra officiellement fin le 31 janvier 2026 ». « La gestion de ces soumissions incessantes de contenus de mauvaise qualité a un impact psychologique considérable et prend parfois beaucoup de temps à démystifier. C’est du temps et de l’énergie complètement gaspillés, qui sapent en outre notre envie de vivre », expliquait-il.
Du côté de la communauté du noyau Linux, le sujet est vu différemment. Si Linus Torvalds avait pesté un moment contre les nombreux rapports d’erreurs générés par les LLM et peu efficaces, cet été il avait changé d’avis sur le sujet et refusait de rejeter en bloc les rapports d’erreurs générés de la sorte, se disant prêt à peser de tout son poids de mainteneur principal du noyau si nécessaire. Il faut préciser qu’on ne parle pas ici de signalements faisant appel à rétribution. Le système des bug bounty attribuant une récompense aux signalements, avec une somme plus importante en fonction de l’importance du bug pousse sans doute davantage certains à utiliser des systèmes automatisés de signalements de bugs, sans se préoccuper de leur qualité et de la possible submersion du système.
Dans un contexte tendu autour des questions de chiffrement en France, un rapport attendu a voulu faire le point sur la question. La situation ambivalente y est clairement exprimée : une technologie aussi essentielle pour la sécurité que problématique pour les forces de l’ordre. Le rapport milite pour une approche de compromis pour éviter les débats binaires.
La création de ce rapport avait été confiée à l’ex-député Florent Boudié (Renaissance) en janvier 2026 par le Premier ministre Sébastien Lecornu, en vue d’éclairer le gouvernement sur les questions de politiques publiques de sécurité à l’ère du numérique. Un décret publié le 21 janvier avait confié à M. Boudié l’exploration des « possibilités d’évolution des dispositifs juridiques existants » pour l’accès aux communications chiffrées, rapportait alors Public Sénat. Florent Boudié a quitté son siège de député pour cette mission (parlementaire en mission pour le gouvernement) et a été nommé conseiller d’État.
Selon le rapport, obtenu par L’Informé, le chiffrement de bout en bout (E2E) prive les interceptions classiques de leur contenu. Les SMS et MMS ne représentent plus que 3 % des messages échangés, et 90 % des communications des services de messagerie sont chiffrées de bout en bout. Les enquêteurs se reportent donc sur les métadonnées et sur le piégeage des terminaux. Côté criminalité, le rapport décrit une banalisation du chiffrement dans la délinquance de masse et des écosystèmes criminels intégrés (dont EncroChat) qui aurait conduit à 6 500 interpellations entre 2020 et 2023.
La question est ainsi posée : que faire ? Le rapport ne tire pas à boulets rouges sur le chiffrement E2E et se place dans une démarche de constat, surtout dans sa première partie, puis de compromis en recommandant d’éviter toute action trop forcée.
« Paradoxe »
Si le rapport pointe le travail de plus en plus difficile des forces de l’ordre face à l’utilisation toujours plus large du chiffrement E2E, il relève que ce « défi sécuritaire procède toutefois d’un paradoxe » :
« Si la diffusion du chiffrement de bout en bout neutralise une partie des prérogatives de puissance publique, elle résulte, dans le même temps, de choix de politiques publiques anciens et assumés, en France comme ailleurs, visant à protéger les citoyens et les entreprises, les infrastructures critiques et les systèmes d’information (SI), en préservant l’intégrité des données stratégiques et personnelles. Ainsi, encouragés à promouvoir le perfectionnement des procédés cryptologiques, à l’image des orientations du Secrétariat général de la Défense et de la Sécurité nationale (SGDSN) présentées dans sa Stratégie nationale de cybersécurité 2026 - 2032, les services de l’État sont tout autant invités à percer le mur du chiffrement »
Le rapport se plait ainsi à rappeler une formule utilisée en novembre 2020 par le Conseil de l’Union européenne : « la sécurité grâce au chiffrement et malgré le chiffrement ». La même technologie constitue à la fois « un vecteur de sécurité informatique » et « une cause […] de complexité pour les nécessités d’ordre public ».
Il reste 78% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Google ne manque jamais une occasion de faire la promotion de Chrome ou de sa propre application de recherche dans Safari, tout particulièrement sur iPhone. Apple voudrait en avoir le cœur net et mesurer précisément le volume et la fréquence de ces bannières et de ces panneaux souvent envahissants.
Illustration : Flock
La bêta 2 d’iOS 27.2 contient en tout cas des outils de télémétrie pour relever l’usage que fait Google de ces promotions dans Safari, d’après le code découvert par le site 9to5Mac. Cela ne veut pas nécessairement dire qu’ils seront présents dans la version finale d’iOS 27.2, mais leur présence dans la bêta confirme l’expérimentation par Apple de cette fonction.
Safari injecte un script JavaScript dans certaines pages du site de Google : accueil et résultats de recherche. Il cherche les bannières et les éléments visuels qui incitent les utilisateurs à lancer Chrome ou l’app Google. Lorsqu’une de ces promotions est détectée, le navigateur peut enregistrer plusieurs informations : si elle a été affichée, si l’utilisateur a interagi avec elle, ou encore s’il semble connecté à un compte Google.
Apple est ainsi en mesure de déterminer si l’utilisateur a accepté ou ignoré les sollicitations de Google. Reste à savoir pour quoi faire. 9to5Mac avance l’idée que ces outils pourraient être indispensables dans un cadre réglementaire. Dans l’UE, le règlement sur les marchés numériques oblige Apple à proposer aux internautes le choix du navigateur et du moteur de recherche. Mais pourquoi dans ce cas se limiter à Chrome ?
Avec ses nouvelles puces M6 et M5 Ultra, Apple inaugure plusieurs changements : trois types de cœur pour la partie CPU dans le premier cas, quatre dies par puce dans le second. Next en profite pour voyager un peu dans le temps, en remontant jusqu’aux caractéristiques techniques de la puce M1 en 2020.
Lancée fin 2020, la puce M1 d’Apple a rapidement séduit par ses performances. Six ans plus tard, Apple lance la sixième génération M6, avec toujours plus de cœurs pour la partie CPU et GPU, tout en mettant l’accent sur l’intelligence artificielle.
La mémoire unifiée des Mac fait d’ailleurs des ravages chez les amateurs d’IA générative qui peuvent profiter de jusqu’à 512 Go de mémoire pour charger de gros modèles.
Voici sans tarder notre grand tableau récapitulatif de la puce M1 en novembre 2020, aux M5 Ultra et M6 de cet été :
Il reste 82% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Le gouvernement norvégien avait déjà annoncé qu’il voulait durcir la législation du pays concernant l’utilisation des lunettes connectées alors que la grogne s’amplifie contre les lunettes Meta un peu partout. Il explique maintenant que ce durcissement devrait passer par une « interdiction temporaire » de ces lunettes dans certains lieux publics.
« Le temps de mener une étude approfondie et d’avoir un débat éclairé qui pourra jeter les bases d’une réglementation durable », précise le ministre de la Numérisation et de la Gouvernance publique, Torgeir Micaelsen, qui semble reprendre le dossier des mains de la ministre chargée du numérique, Karianne Tung. Celle-ci avait montré des signes de réticence à toute nouvelle législation sur le sujet au début de l’été.
Sans qu’un texte de loi ne soit encore rédigé, le communiqué évoque comme potentiels lieux interdits à ces lunettes les parcs, les plages, les musées, les aires de jeux, les parcs d’attractions, ainsi que les manifestations sportives, musicales et culturelles. Les lieux de scolarisation de la maternelle au lycée, voire aux établissements d’enseignement supérieur devraient figurer dans la liste aussi.
L’interdiction de ces lunettes connectées ne serait pas totale en Norvège. Le gouvernement évoque, comme l’explique Reuters, la possibilité de les utiliser dans des lieux purement privés et certains endroits où l’utilisation ne présente aucun risque d’être filmé sans son consentement.
Les « aperçus IA » qui s’affichent en tête des résultats d’une recherche Google sont générés à partir de contenus produits par des sites web. Après avoir capté une partie de leur trafic grâce à ces résumés, Google aurait commencé à rémunérer des éditeurs pour leurs contenus.
Avec les AI Overviews (Aperçus IA en France), Google prive les sites web d’une partie de leur trafic et donc, de leurs revenus publicitaires. Les internautes ne sont plus incités à se rendre sur ces sites, se contentant bien souvent des résumés générés par IA. C’est la double peine pour les éditeurs, qui se font voler à la fois leurs contenus et leurs lecteurs. Et cela explique aussi la méfiance de plus en plus grande de plusieurs d’entre eux, qui envisagent tout simplement de couper les ponts avec le moteur de recherche dominant.
Fin 2025, la Commission européenne ouvrait une enquête sur Google, accusé de fausser la concurrence en imposant des conditions abusives aux éditeurs et aux créateurs de contenu qui désavantagent les développeurs d’IA concurrents.
Poussé par les régulateurs, Google a dû mettre en place cet été un réglage permettant aux éditeurs d’interdire la collecte de leurs articles pour entraîner les modèles IA de l’entreprise. Tout en autorisant tout de même l’indexation de ces mêmes articles, pour les intégrer dans les résultats de recherche classiques.
Le baiser de la mort
Mais avant de générer des aperçus IA, faut-il encore avoir la matière première : les contenus. Et Google a toujours besoin des sites web. Le site The Information rapporte l’existence d’un programme pilote lancé il y a moins d’un an ; il rémunère une centaine d’éditeurs de sites web. Les sommes varient en fonction de la contribution de leurs contenus aux réponses générées par l’IA dans son moteur de recherche, ainsi que dans le mode IA et dans le chatbot Gemini.
Un éditeur anonyme aurait, depuis son inscription au programme, touché entre 50 000 et 60 000 dollars, ce qui ne représente qu’une petite partie de son activité. Un autre perçoit plus d’un million de dollars par an, ce qui est une part plus significative de son chiffre d’affaires. Les sommes peuvent sembler importantes, mais tout dépend de la taille des éditeurs et de leurs rédactions. Certains sites doivent se contenter de moins de 1 000 dollars sur plusieurs mois.
Pour les petits sites qui participent à ces tests, les sommes versées par Google pèseraient pour moins de 0,1 % de leurs revenus publicitaires, d’après les sources de The Information. La petitesse de ces enveloppes auraient même dissuadé des éditeurs plus importants de se lancer. Ce faisant, ils espèrent pousser Google à mieux valoriser les contenus utilisés pour l’entraînement des IA.
Un modèle pour le secteur de la presse en ligne ?
Plus pragmatiques, d’autres éditeurs espèrent comprendre le type de contenus favorisés par Google et son IA, afin d’optimiser leurs articles et profiter de la manne. Un dirigeant d’un éditeur indique que Google décide seule de la valeur des contenus afin de garder le mystère sur la boîte noire de son système de génération IA.
Des participants au programme n’auraient aucune idée de la manière dont Google calcule les rémunérations, ni ce que Google considère comme une contribution significative à un aperçu IA. Des contenus consacrés à des sujets niches (comme les anime ou les jeux vidéo) mais suscitant un fort intérêt de la part des internautes, semblent toutefois rapporter davantage.
Beaucoup des participants espèrent que ce programme fera figure de modèle à suivre pour les autres acteurs de l’IA qui ont tendance à jeter par dessus bord le copyright au nom d’un « usage légitime » qui a parfois bon dos. Il faudra au préalable que Google officialise l’initiative et que davantage d’éditeurs y participent.

 Connexion