Apple organise un événement le 13 octobre baptisé « Welcome Home ». Il se tiendra à New York, à 9 heures heure locale (15 heures à Paris). Le constructeur ne précise pas encore si on aura droit à une keynote en bonne et due forme, néanmoins cela ne fait guère de doute.
Apple devrait révéler au monde plusieurs produits orientés domotique, à commencer par ce fameux écran connecté dont parle la rumeur depuis des années. L’écran de 6 pouces pourrait s’accrocher au mur ou sur une base faisant office de haut parleur. L’objet permettrait de contrôler les appareils domotiques, d’afficher une recette de cuisine, de passer des appels vidéo, de consulter des infos et la météo, etc. Le prix tournerait autour de 350 dollars.
Cet écran devrait faire grand usage des capacités de Siri AI, la nouvelle version de l’assistant dopé à l’IA de Google. Celle-ci n’est pas disponible en Europe sur iPhone et iPad en raison des bisbilles entre Apple et la Commission européenne ; en revanche, on peut s’en servir sur Mac, qui ne fait pas partie des plateformes sous surveillance du DMA. On verra si ce sera le cas aussi de cette nouveauté.
Apple prévoirait également de lancer un nouvel HomePod mini qui conserverait son design rond, mais avec une puce N1 pour les réseaux Wi-Fi et Bluetooth, ainsi qu’une puce S plus rapide. L’Apple TV 4K serait aussi renouvelée, probablement avec une puce A19, davantage de mémoire (gare aux prix !) et une télécommande revue.
Il pourrait aussi y avoir la présentation d’une toute nouvelle gamme d’accessoires pour la maison : sonnettes, thermostat, serrures, caméras de surveillance… Des produits qui seraient conçus par LG, avançait Mark Gurman de Bloomberg il y a quelques jours. Une stratégie qui peut étonner, mais Apple travaille régulièrement avec d’autres entreprises sur des produits très ciblés, comme Belkin pour les accessoires ou encore… LG, pour les écrans UltraFine.
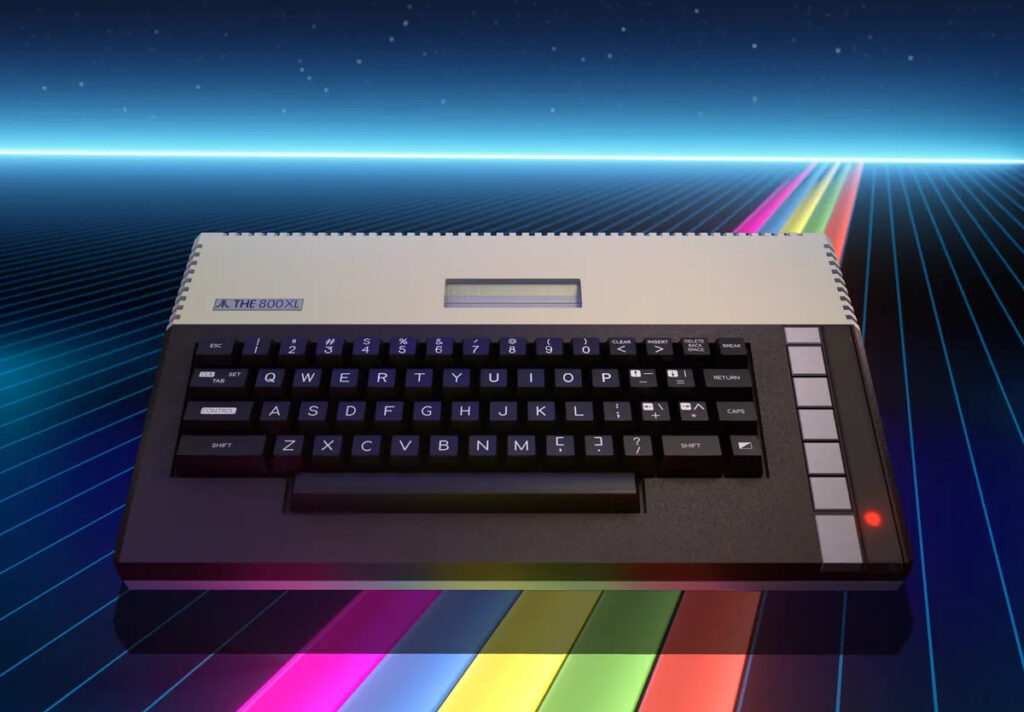
Atari continue de surfer sur la vague rétro avec le 800XL, un « nouvel » ordinateur qui reprend le design et les fonctionnalités du 800XL de 1983. Cette recréation à l’identique de l’ordinateur 8 bits intègre évidemment le clavier mécanique et un port compatible avec les cartouches originales de l’Atari 400, 800, XL et XE.
Le boîtier est fourni d’office avec 25 jeux, dont les increvables Centipede, Missile Command et Asteroids, mais ceux qui voudront aller plus loin pourront se lancer dans le développement de leurs propres jeux en Basic. Oui, en les tapant sur le clavier comme dans l’ancien temps des pionniers !
Plaion, le constructeur partenaire d’Atari dans cette histoire, n’a cependant rien sacrifié sur l’autel de la nostalgie : quatre ports USB-A sont présents pour connecter des disques externes et autres périphériques. On pourra de la sorte lancer des jeux et des logiciels créés pour des ordinateurs 8 bits et l’Atari 5200.
Le 800XL embarque aussi un port HDMI qui présente l’image en 4:3, avec un affichage pixel perfect et avec des filtres CRT (et des encadrements en bonus pour cacher les bandes noires sur la télé). Il est livré avec un joystick inspiré de la manette classique Atari, mais avec 8 boutons. Cette beauté est en précommande au prix de 219,99 euros. Les premières livraisons débuteront en avril 1983 2027.
Plaion a bien du pain sur la planche : c’est en effet cette entreprise qui produit la Neo-Geo AES+ dont le lancement a été reporté de quasiment un an.
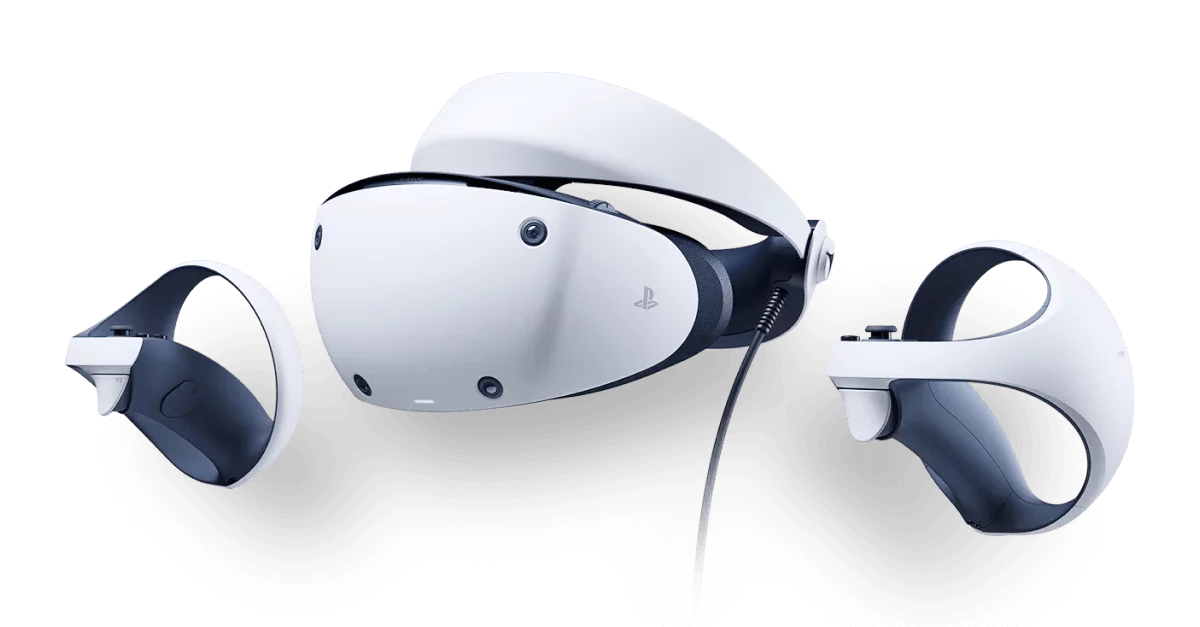
Sony sort de la VR par la petite porte. L’entreprise a cédé des dizaines de brevets portant sur les technologie de réalité virtuelle, augmentée et mixte à Meta. Le casque PlayStation VR de 2e génération pour la PS5, plus performant mais plus cher que son prédécesseur, n’a pas su créer l’appel d’air qui aurait permis à cette activité de décoller.
Sony fait partie des pionniers des écrans portés et de la réalité virtuelle. On peut remonter à 1996 avec le Glasstron, mais c’est en 2011 que le constructeur assoit sa réputation avec le HMZ-T1. Ce casque-écran 3D, vendu 799 euros en France, n’était pas marqueté spécifiquement pour la PlayStation même si le constructeur vantait déjà une « configuration idéale » pour les jeux.
L’engin n’intégrait pas de suivi des mouvements de la tête ni de véritable environnement 3D interactif, mais il annonçait le retour des casques grand public, juste avant que l’Oculus Rift ne donne à la VR sa forme moderne grâce à son financement record sur Kickstarter en 2012.
Sony a longtemps cru aux casques VR
Sony lance le PlayStation VR en 2016, et comme son nom l’indique, c’est un véritable casque de réalité virtuelle à destination de la PS4. L’appareil, vendu 399 euros, fait son petit effet à un moment où la VR semble mûre pour s’imposer en tant que technologie de divertissement grand public. Ça n’est jamais vraiment arrivé, pour tout un tas de raisons (poids, prix, compatibilité, puissance…), mais le PSVR participe de cet engouement avec une logithèque relativement fournie.
Alors que le tsunami de la VR commençait franchement à ressembler à une vaguelette, Sony remet une pièce dans la machine en 2023 avec le PSVR2, un modèle qui coche les mauvaises cases dès le départ : une compatibilité limitée aux jeux PS5 (les jeux PSVR de 1ère génération ne sont pas pris en charge), un prix plus élevé que celui de la console (599 euros), et un soutien logiciel plus que timide de la part du constructeur et de ses studios internes.
Le PSVR2 compte certes une toute petite poignée de jeux maison (Horizon Call of the Mountain et le mode VR de Gran Turismo 7), mais Sony a vite arrêté les frais en coupant le robinet des financements pour le développement de jeux. Les utilisateurs du casque ont dû alors se tourner vers les studios tiers. Mais ces derniers doivent rentabiliser leurs investissements et bien souvent, conçoivent des jeux multiplateforme avec le plus petit dénominateur commun en tête. Autrement dit : ils développent des jeux d’abord pour les casques Quest, le support de la PSVR2 et de la PS5 étant minimal.
Meta récupère les brevets
Sony n’a officiellement jamais annoncé la retraite du PSVR2. L’entreprise a même essayé de lui trouver un débouché avec un adaptateur pour brancher le casque sur un PC lancé en juin 2024. Une ouverture bienvenue, mais qui n’a pas permis de relancer la machine. Signe du désintérêt du constructeur, ZDnet rapporte le transfert à Meta de 419 brevets liés aux technologies VR, dont 43 détenus aux États-Unis, entre juin et septembre.
En tout, ce sont 180 brevets américains qui reviendront dans les poches de Meta, les 239 autres ayant été déposés en Europe, au Japon, en Chine ou en Corée du Sud. Cela ne signifie pas que Sony quitte complètement le marché de la réalité virtuelle, augmentée et mixte. Il fournit toujours les écrans OLEDoS du Vision Pro, qui prend d’ailleurs en charge les manettes de la PSVR2.
Ce transfert important de brevets n’inspire cependant pas franchement confiance pour l’avenir de cette activité chez PlayStation. De son côté, les produits VR ont retrouvé un second souffle chez Meta après la présentation des VR Glasses. Les brevets de Sony représentent une sûreté juridique précieuse pour Meta, à défaut d’être le signe d’un grand avenir pour le PSVR2.
Régulièrement attaquée pour son inertie en matière de lutte contre la pédocriminalité, Meta a annoncé plusieurs nouvelles mesures pour détecter les publicités qui aboutissent discrètement sur des contenus illégaux.
Illustration :Flock
Mi-septembre, une enquête de l’ONG Tech Transparency Project (TTP) pointait du doigt les graves déficiences de la modération des publicités sur les plateformes de Meta représentant des images pédocriminelles générées par IA. Dans un communiqué publié le 6 octobre, le géant des réseaux sociaux assure avoir pris des mesures à l’échelle mondiale contre 33,2 millions de contenus d’exploitation sexuelle d’enfants sur Facebook et Instagram entre janvier et juin 2026.
L’entreprise annonce surtout des nouveautés concernant la détection des pubs utilisées pour orienter les internautes vers du contenu pédocriminel en dehors de ses plateformes. « Une publicité peut paraître inoffensive en elle-même tout en dirigeant discrètement les utilisateurs vers du contenu illégal hébergé en dehors de nos plateformes, afin d’échapper à la détection », écrit le groupe.
Un nouveau modèle IA va être mis à contribution pour détecter ces bannières apparemment anodines mais derrière lesquels se cachent des contenus illégaux. Les publicités vont être également être analysées plus en profondeur pour repérer les liens vers lesquelles elles dirigent. Les liens vers les sites associés à ces activités seront bloqués.
Meta affirme également renforcer la détection de la récidive, afin de repérer les acteurs bannis qui tentent de recréer de nouveaux comptes. Enfin, des agents IA « red teaming » vont tester « proactivement » les défenses de Meta pour identifier de nouvelles tactiques criminelles.
Souvent accusée de négligence dans la suppression de ces contenus, Meta tient aussi à rappeler que « depuis des années », une équipe d’experts qui compte des anciens enquêteurs du FBI mène des enquêtes pour identifier, retirer et signaler les réseaux de comptes de prédateurs. « Nous continuons d’enquêter sur le fonctionnement de ces réseaux afin de pouvoir agir contre eux à l’échelle du réseau, et pas seulement compte par compte. »
Début juin, NVIDIA se lançait à l’assaut d’une nouvelle citadelle : les systèmes-sur-puce pour les PC sous Windows sur Arm, avec la » superpuce » RTX Spark. Après Acer et Lenovo qui ont dévoilé leurs premières machines le mois dernier, c’était au tour de Microsoft de se lancer avec de nouvelles Surface aussi puissantes que chères.
NVIDIA a combiné dans sa puce RTX Spark tout le nécessaire pour faire tourner un PC : un CPU, un GPU et de la mémoire unifiée, à l’image des puces Apple pour l’iPhone et le Mac. Il s’agit d’équiper des ordinateurs tournant avec Windows sur Arm, un système d’exploitation qui se démocratise grâce aux efforts de Microsoft et de Qualcomm, qui était jusqu’à présent le seul fournisseur de puces pour cette déclinaison de l’OS.
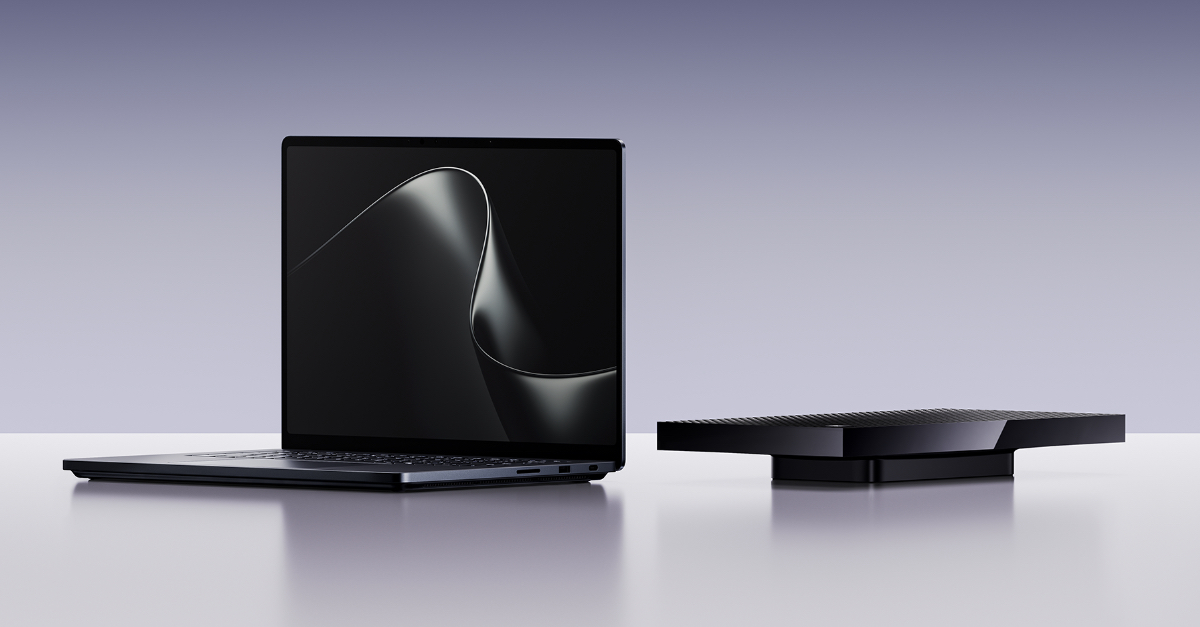
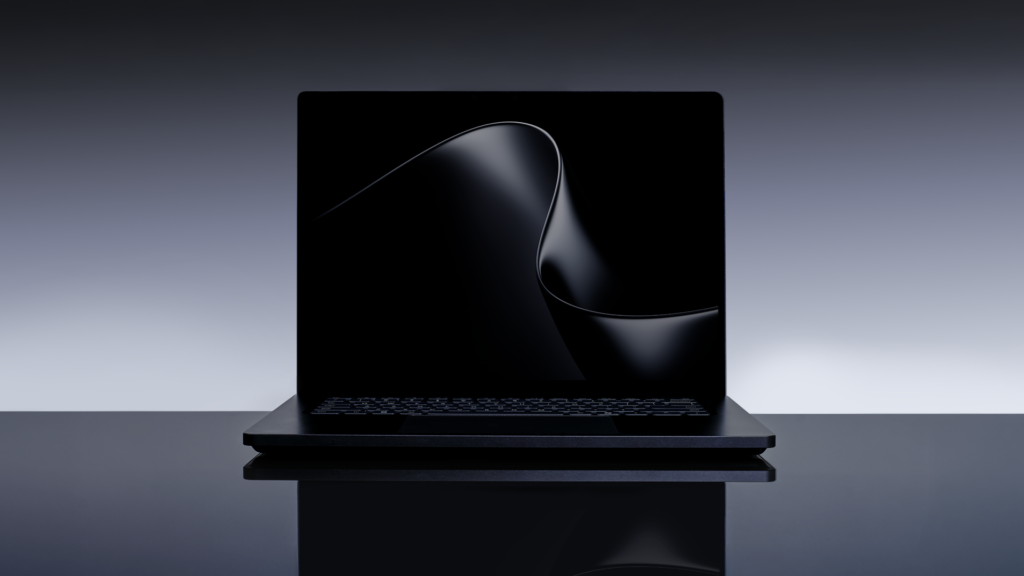
À l’occasion de son événement Surface organisé ce mercredi 7 octobre, Microsoft a lancé deux nouveaux modèles équipés de la puce RTX Spark N1X. Le premier est un ordinateur portable baptisé Surface Laptop Ultra – Ultra pour le prix (à partir de 2 599 dollars) mais aussi pour les performances pour le traitement de l’IA en local. Le CPU Grace peut compter de 18 à 20 cœurs, le GPU Blackwell de 5 120 à 6 144 cœurs, et un maximum de 128 Go de mémoire unifiée (24 Go par défaut). En termes de stockage, on dispose d’un minimum de 512 Go et bonne nouvelle, le SSD peut être remplacé.
Image : Microsoft
L’ordinateur est censé pouvoir faire fonctionner un modèle IA comptant jusqu’à 120 milliards de paramètres. Il a fallu construire une nouvelle architecture thermique autour de cette puce monstrueuse. La capacité du système de refroidissement de l’Ultra est 2,5 fois plus importante que celle des Surface Laptop actuels, le tout dans un châssis de 18 mm d’épaisseur pour un poids de 2 kg.
La machine intègre un écran de 15 pouces tactile, qui annonce un pic lumineux en HDR de 2 000 nits. C’est 25 % plus élevé que la dalle du MacBook Pro M5 (1 600 nits), rappelle un Microsoft perfide. Le Wi-Fi 7 est au rendez-vous, tout comme trois ports USB4 (USB-C), un port USB-A 3.1, un port HDMI 2.1b, un lecteur de cartes SD et un port jack 3,5 mm. L’autonomie annoncée est de 12 heures en usage web.
Le Surface Laptop Ultra sera commercialisé à partir du 16 octobre. Tous ceux qui voudront troquer leur MacBook Pro contre ce nouveau modèle peuvent obtenir un rabais allant jusqu’à 1 000 dollars. Quand on vous dit que Microsoft a une dent contre le MacBook Pro…
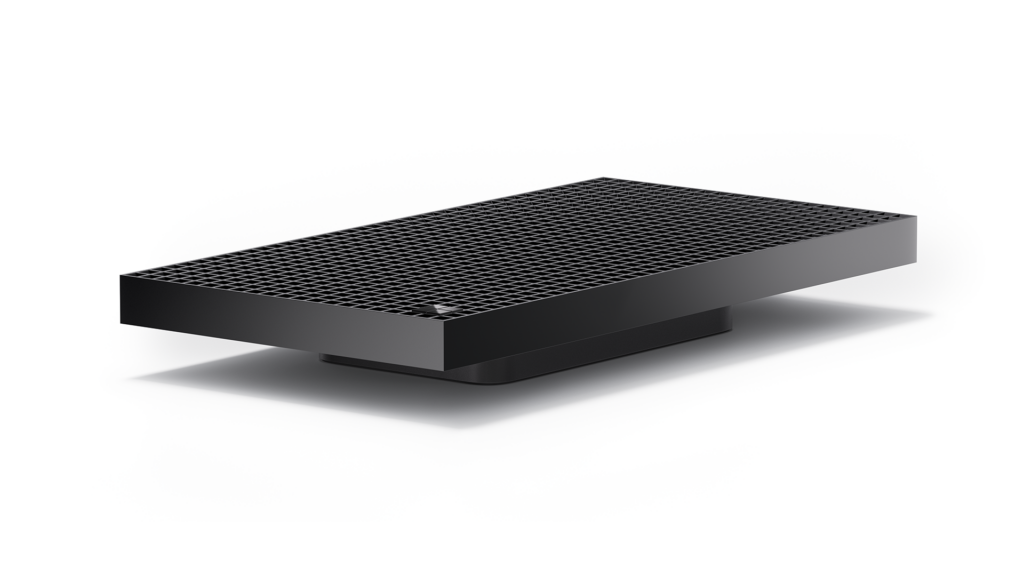
Le deuxième appareil Surface montrée par Microsoft aujourd’hui est un ordinateur de bureau sans écran, ce qui est une première pour la gamme. Le Surface RTX Spark Dev Box est, comme son nom l’indique, un ordinateur pour les développeurs et les ingénieurs IA qui ont de très gros besoins de traitement IA en local et pour héberger leurs agents.
Image : Microsoft
La boîte à pizza embarque la puce N1X haut de gamme (20 cœurs CPU, 6 144 cœurs GPU, 128 Go de mémoire unifiée et 2 To de stockage), le tout à partir de 5 999 dollars. La box est fournie d’emblée avec tous les outils et environnements de développement nécessaires aux utilisateurs de ce genre de produits : Visual Studio Code, Git, GitHub CLI, GitHub Copilot, WSL, Python, Node… Elle sera vendue uniquement aux États-Unis dans un premier temps.
Il n’aura échappé à personne que les finances publiques de plusieurs pays européens sont au plus bas. Difficile pour Bruxelles de demander une rallonge pour boucler le budget européen. La Commission cherche donc de nouvelles recettes, en visant les grandes entreprises… sans donner l’impression de cibler les géants américains du numérique.
En coulisse, les négociations pour le budget européen 2028 - 2034 (2 000 milliards d’euros) sont compliquées par les contraintes financières de plusieurs États membres, rapporte le Financial Times. La Commission a proposé cinq nouvelles « ressources propres » avec des recettes attendues de 58,5 milliards d’euros par an.
Parmi ces ressources, on recense un système d’échange de quotas d’émission de l’UE, un mécanisme d’ajustement carbone aux frontières, les déchets électroniques non collectés, les droits d’accise sur le tabac, et une contribution des grandes entreprises qui opèrent dans le marché unique. Cette « contribution forfaitaire annuelle », qui devrait rapporter 6,8 milliards d’euros, fait l’objet de toutes les attentions.
Des sous pour l’UE
Connue sous le nom de « Corporate Resource for Europe » (Core), cette proposition viserait les entreprises opérant et vendant dans l’UE avec un chiffre d’affaires net annuel dépassant 100 millions d’euros. Bruxelles envisagerait désormais d’en modifier les seuils afin d’épargner davantage d’entreprises européennes de taille moyenne, tout en faisant contribuer plus fortement les très grands groupes, notamment les géants américains du numérique, sans les viser explicitement.
On ne parle donc pas d’une nouvelle taxe sur le numérique US, plusieurs capitales européennes s’opposant à un tel projet pour ne pas froisser davantage la Maison-Blanche. Il s’agirait de maintenir une taxe applicable à tous les secteurs mais calibrée pour toucher surtout les plus grandes multinationales. Il se trouve simplement que beaucoup d’entre elles sont américaines…
La majorité des pays de l’UE ne voudraient pas entendre parler d’une plus forte taxation des sociétés européennes, qui subiraient un désavantage par rapport aux rivales étrangères. D’où l’idée de revoir les seuils : suffisamment élevés pour épargner une partie des entreprises européennes, mais suffisants pour faire contribuer davantage les plus puissants groupes.
Ce serait là une manière pour Bruxelles de ménager la chèvre (éviter de taxer les entreprises européennes) et le chou (la susceptibilité de Washington). Mais malgré les efforts de la Commission pour éviter l’ire américaine, les grands groupes US iront probablement frapper à la porte de Donald Trump pour se plaindre du mauvais traitement supposé dont ils font l’objet dans l’UE. Les points de contentieux sont nombreux entre les deux blocs, que ce soit sur les régulations ou les sanctions infligées aux entreprises américaines.
Depuis janvier 2024, une directive européenne a établi un impôt minimum de 15 % sur les bénéfices des multinationales réalisant plus de 750 millions d’euros de chiffre d’affaires annuel dans le monde. Il s’agit de la transposition du second pilier de la solution négociée dans le cadre de l’OCDE en 2021.
Le premier pilier, celui qui concerne la réattribution d’une partie des droits d’imposition aux pays où les grandes entreprises réalisent leurs ventes, est toujours enlisé depuis le retour de Donald Trump à la Maison-Blanche. Or, c’est ce volet de l’accord qui devait répondre au cas des géants du numérique, capables de générer des revenus importants sur des marchés où ils ne réalisent pas une part équivalente de leurs bénéfices imposables.
Qui paie les pots cassés quand les agents IA deviennent incontrôlables ? La question se pose chez les assureurs, qui pourraient se tourner vers les patrons d’OpenAI, Anthropic et consorts pour leur présenter la facture.
Le courtier en assurances Aon a analysé plus de 300 affaires judiciaires liées à l’IA : il arrive à la conclusion que les assureurs seront amenés à indemniser les victimes des agents IA dans les contrats couvrant la cybersécurité, les erreurs et omissions technologiques, ou encore la propriété intellectuelle.
D’après plusieurs responsables du secteur interrogés par le Financial Times, les assureurs pourraient demander des comptes aux patrons des entreprises IA quand leurs agents brisent leurs chaînes et s’attaquent à tout ce qui bouge en ligne. Tim Rayner, responsable de la souscription et des sinistres au Royaume-Uni chez Verisk, estime qu’en l’absence de contrôle de l’activité de son entreprise, Sam Altman est responsable de l’incident impliquant Hugging Face. « Du point de vue de la responsabilité des dirigeants et administrateurs, c’est donc vers lui que l’on se retournerait. »
OpenAI, Anthropic et d’autres ont depuis révélé que leurs agents étaient à l’origine de plusieurs intrusions et attaques, provoquant un branle-bas de combat d’une ampleur inédite – jusqu’au conseil de sécurité de l’ONU. La question de la responsabilité se pose donc très clairement, et les assureurs sont en première ligne, car ce sont eux qui remboursent les dégâts causés par les agents.
« Il incombe à chaque PDG de s’assurer que son entreprise est correctement gouvernée et contrôlée », ajoute Tim Rayner, « L’IA ne change rien à cela. » Les entreprises de l’IA peuvent toujours souscrire des assurances responsabilité pour couvrir les pertes éventuelles liées à des poursuites contre les dirigeants, mais gare au coût de la prime.
Il n’existe cependant aucun précédent, la question n’ayant pas été tranchée par la justice. Les actionnaires ont aussi leur mot à dire, certains pourraient lancer des poursuites contre des dirigeants n’ayant pas géré correctement ces risques.
Dans son prospectus S-1 d’introduction en Bourse, Anthropic a identifié les risques « catastrophiques » posés par l’IA générative s’ils ne sont pas correctement maîtrisés. La technologie représente un « risque existentiel pour l’humanité », reconnaissait aussi l’entreprise, fidèle à sa stratégie du marketing de la peur. Le document indiquait aussi que les modèles pouvaient développer des comportements d’« auto-préservation » en résistant à leur arrêt, en dissimulant ou en manipulant des informations, ou même adopter des comportements proches du chantage.
Dans le compte-rendu officiel de l’incident Hugging Face posté fin août, OpenAI avait de son côté décrit des agents IA capables de contourner des contrôles techniques, de travailler ensemble au sein de canaux non approuvés et d’« entreprendre des actions dangereuses qu’aucun humain n’a ordonnées ».
Il y a là de quoi nourrir des plaintes contre ces entreprises. Mais les victimes des agents IA pourraient cependant avoir des difficultés à trouver un fondement juridique pour leurs plaintes. « Il n’existe pas encore de régime de responsabilité civile régissant l’utilisation de l’espace en ligne », rappelle Aaron Le Marquer, du cabinet d’avocats Stewarts.
Il indique que le secteur pourrait s’inspirer de l’accord à 18 milliards de dollars entre Meta et des États américains sur la nocivité des plateformes du géant des réseaux sociaux. Un tel modèle pourrait servir à définir les obligations dans l’espace en ligne, estime-t-il encore.
Cela pourrait même aller plus loin : « Je m’attends à voir apparaître des poursuites contre les entreprises d’IA pour d’éventuelles pertes sur le modèle des contentieux environnementaux du passé, mais aussi de ceux concernant le tabac ou l’industrie pharmaceutique », conclut Aaron Le Marquer.
En juillet, la justice américaine validait la proposition d’Anthropic de règlement d’une plainte menée par des autrices et auteurs qui accusaient la société d’avoir entraîné ses modèles avec leurs œuvres, sans autorisation. Les plaignants devraient récupérer 1,5 milliard de dollars. Les assureurs se préparent à des actions en justice qui concernent la responsabilité des entreprises IA pour leurs produits, les biais dans leurs modèles, les atteintes à la vie privée ou encore des décès imputés à leurs technologies.
Les noms, adresses email et postales, numéros de téléphone, et autres données personnelles de 3 615 clients de Trump Mobile sont dans la nature, rapporte le site Straight Arrow News. Les pirates de BYOD se sont infiltrés dans les serveurs de l’opérateur virtuel géré par des proches du président américain, et ont siphonné des informations sur les utilisateurs.
BYOD affirme que Trump Mobile, une fois prévenu, a indiqué qu’il n’y avait personne pour gérer ce genre de problèmes en interne. « Quiconque [nous] pirate est un terroriste », aurait également déclaré l’opérateur, bravache. Le groupe de pirates, fraîchement arrivé dans le paysage de l’extorsion par fuite de données, serait passé par Liberty Mobile, l’opérateur/MVNO derrière Trump Mobile, via l’ordinateur d’un employé infecté par un infostealer.
Aucune équipe de sécurité ni prestataire externe ne serait chargé de gérer l’incident, indique encore BYOD à International Cyber Digest. « En gros, ils nous ont dit d’aller nous faire foutre [et que la fuite de données ne représentait] aucun souci pour les clients, vraiment aucun », selon les pirates. Ils assurent toujours posséder un accès à l’infrastructure de Trump Mobile, qui n’aurait pas non plus mis en place de système d’authentification à deux facteurs.
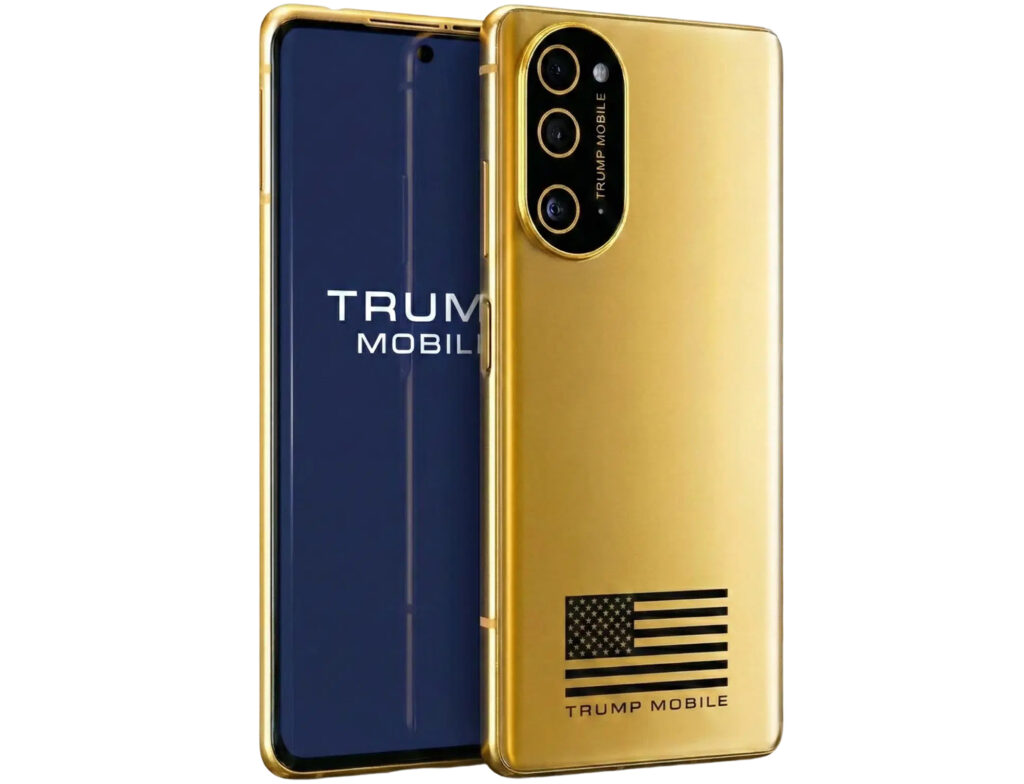
Straight Arrow News a contacté une des victimes à l’aide des informations fournies par BYOD. Cette dernière a confirmé être un client de Trump Mobile, et qu’il avait même versé le dépôt de 100 dollars pour le fameux smartphone, sans l’avoir jamais reçu. La double peine !
Les données ne contiennent aucun détail sur Donald Trump ou ses proches, ce qui signifie, peut-être, que personne dans la famille du président américain n’utilise les services de Trump Mobile. Il faut dire que le Trump Phone T1 « 100 % USA mais fabriqué en Chine », premier smartphone de l’opérateur, n’est guère engageant.
Les systèmes de sécurité de Trump Mobile, ou leur absence, auraient apparemment déjà été pris en défaut par les pirates de EndZone la semaine dernière, à partir de la même brèche. En mai dernier, un chercheur en sécurité avait découvert une vulnérabilité permettant d’aspirer des données grâce à une requête HTTP POST, sans injection SQL ni technique particulièrement sophistiquée. Elle a été corrigée depuis, mais elle aurait permis d’accéder à des milliers de dossiers en moins d’une heure.
Au prix du Go actuel, les utilisateurs de PC au budget serré ont tout intérêt à surveiller de très près le SSD de leur machine et son embonpoint. En particulier chez Apple, qui s’obstine toujours à vendre des Mac chichement dotés en la matière. Le Mac mini d’entrée de gamme se contente ainsi de 256 Go, malgré un tarif rondelet de 1 049 euros. Tout est donc bon à prendre pour faire des économies de stockage, et les données qui ne servent à rien ont vocation à dégager.
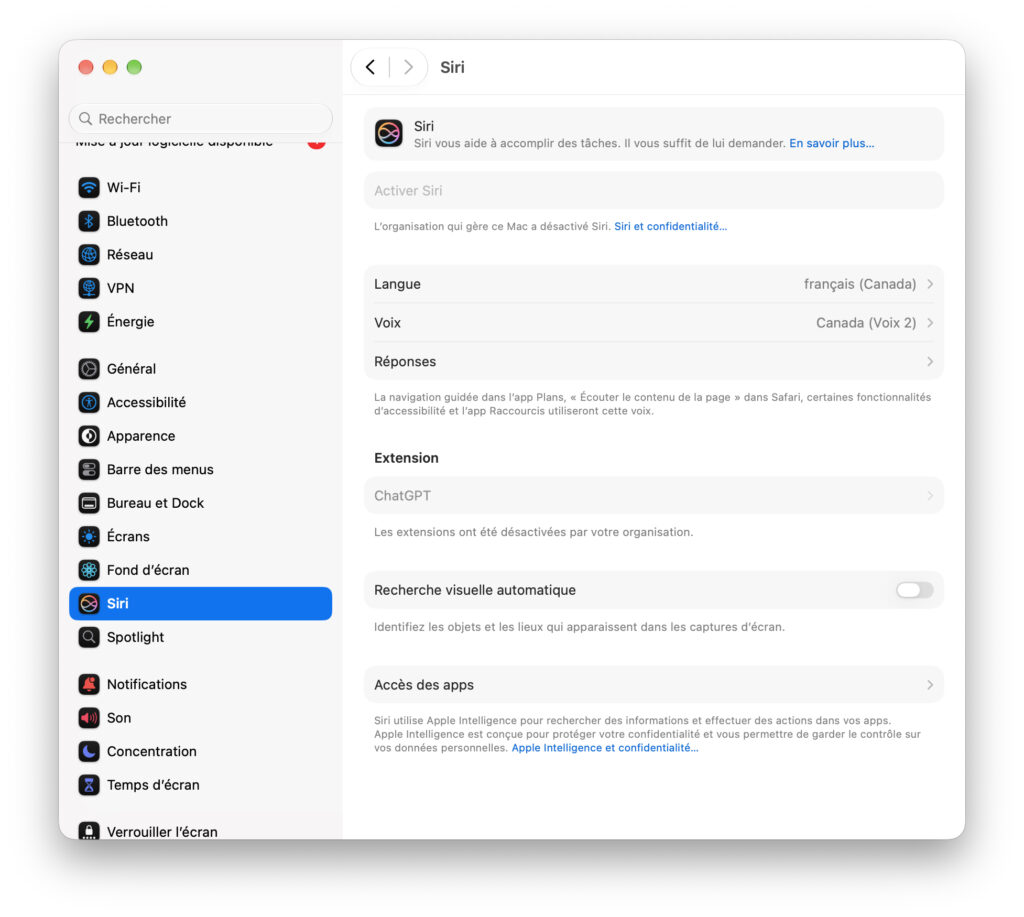
Ceux qui n’ont aucun intérêt dans Apple Intelligence pourront gagner une dizaine de Go, voire plus. Ce qui était possible avec macOS 26 Tahoe ne l’est malheureusement plus avec macOS 27 Golden Gate : Apple a retiré le bouton permettant de désactiver ces fonctions, qui s’installent donc automatiquement et prennent de la place inutilement. Seul Siri AI peut être désactivé (le Mac est la seule plateforme où la version du nouvel assistant est disponible dans l’UE).
Le régime forcé d’Apple Intelligence
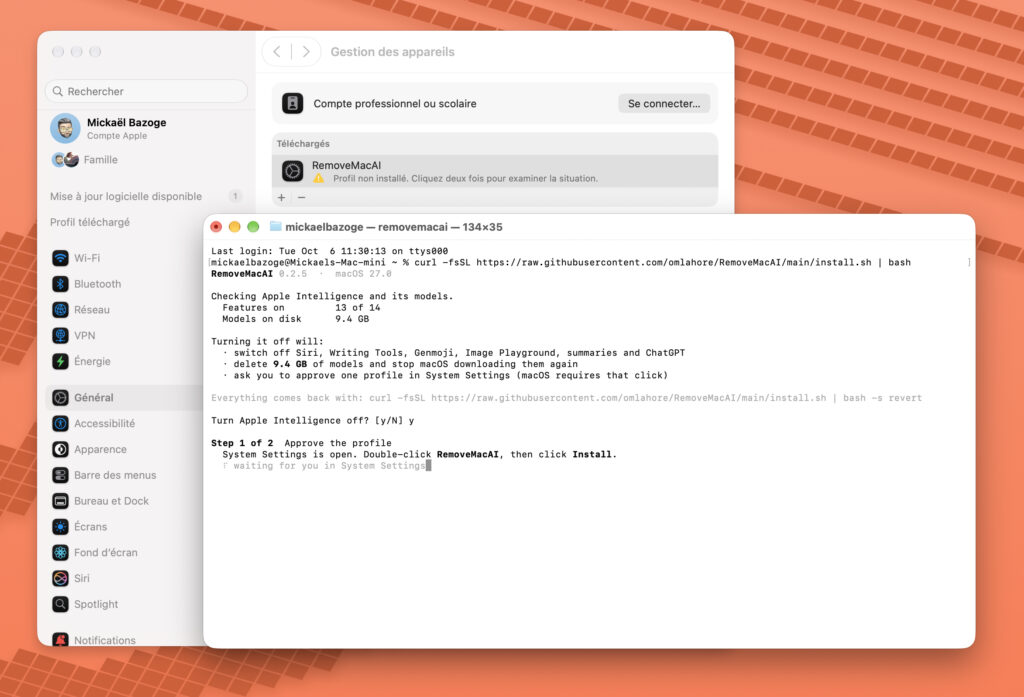
Un développeur a toutefois trouvé une solution : Om Lahore a mis au point un outil en ligne de commande, RemoveMacAI, disponible sur GitHub sous licence MIT. Une fois installé, il supprime les données occupées par Apple Intelligence : 9,4 Go dans le cas de votre serviteur, mais le gain peut être encore plus substantiel (plus de 30 Go chez The Verge, par exemple). Pour connaître le poids d’Apple Intelligence, cliquez sur le petit « i » en face de l’entrée macOS, dans les Réglages système > Général > Stockage. Quoi qu’il en soit, ce n’est pas négligeable.
Capture d’écran : Next
Il est possible d’installer RemoveMacAI directement depuis le terminal, via une ligne de commande, en passant par Homebrew, ou en installant le binaire depuis GitHub. Attention toutefois à cette dernière méthode : lorsqu’un fichier non notarisé est téléchargé avec un navigateur, macOS le bloque tant que son attribut de quarantaine n’a pas été retiré. Il faudra le retirer avant de lancer le binaire, comme l’explique Om Lahore en fournissant les lignes de commande nécessaires (c’est bien plus simple de passer par le terminal).
Privé de Siri AI ! Capture d’écran : Next
Peu importe la méthode d’installation, il n’est pas nécessaire de désactiver SIP (System Integrity Protection), le mécanisme de protection qui empêche même un compte administrateur de modifier certains fichiers et processus sensibles de macOS. Aucun fichier système n’est modifié directement.
Un profil macOS plutôt qu’une bidouille système
RemoveMacAI installe un profil dans les réglages de macOS et désactive toute une série de fonctions liées à Apple Intelligence : Siri et « Dis Siri », l’extension ChatGPT, les outils d’aide à l’écriture, Genmoji et Image Playground, les résumés de courriels et les réponses intelligentes dans Mail, les résumés de notifications et d’articles dans Safari, la complétion de code dans Xcode, la fonction de nettoyage dans Photos et les photos spatiales. L’outil retire aussi les modèles locaux d’Apple Intelligence.
Après l’opération, macOS ne cherchera pas à télécharger à nouveau les données nécessaires à Apple Intelligence. Les utilisateurs qui ont besoin d’une fonction spécifique peuvent indiquer à RemoveMacAI, toujours en ligne de commande, de ne pas la retirer. Et bien sûr, il est possible de restaurer l’ensemble du paquet Apple Intelligence, ce qui supprime le profil. L’outil ne réalise aucun appel réseau, il ne collecte aucune donnée, assure le développeur.
Il faut évidemment utiliser l’utilitaire en connaissance de cause : RemoveMacAI n’a rien d’officiel, et une future mise à jour de macOS pourrait modifier le comportement de ces réglages ou des modèles concernés.
On peut comprendre Apple qui tient absolument à imposer sa solution IA dans les Mac. Mais l’absence d’un bouton de désactivation dans Golden Gate peut poser problème dans les organisations et les entreprises qui ne veulent pas ou ne peuvent pas utiliser de l’IA. Dans ce cas, elles n’ont guère le choix : rester sous Tahoe, administrer les restrictions via leurs propres outils de gestion… ou s’intéresser à cette solution non officielle.
Après bien des rebondissements, Paramount Skydance a officialisé l’acquisition à grands frais (110 milliards de dollars) de Warner Bros. Discovery. Le groupe de David Ellison, fils du mogul Larry (cofondateur d’Oracle), a mis beaucoup d’engagements sur la table pour remporter le morceau.
Le nouveau groupe, baptisé Skydance tout simplement, combine deux des grands studios hollywoodiens, Paramount et Warner (qui conserveront leurs noms), ainsi que les services de streaming Paramount+, HBO Max et Discovery+ qui vont officiellement fusionner. Skydance revendique plus de 200 millions d’abonnés.
Le château d’eau de Warner Bros, par Silas Lundquist, Licence Unsplash
La corbeille comprend également CNN, CBS, HBO, les studios DC, des licences de diffusion de compétitions sportives, un énorme catalogue de films, de séries télé et de documentaires, des franchises aussi connues que Harry Potter, Star Trek, Top Gun, Mission Impossible, Bob l’Éponge (ne l’oublions pas).
Larry Ellison a promis aux exploitants des salles de cinéma « au moins » 30 films par an avec une fenêtre de diffusion exclusive d’un minimum de 45 jours pour les salles obscures américaines. Sans oublier des studios de jeux vidéo (Rocksteady, WB Games…) dont l’avenir s’écrit en pointillés : il n’en a jamais été question durant les négociations de l’opération.
Le pari géant de David Ellison
« Aujourd’hui est un jour historique, non seulement pour Skydance, mais pour l’ensemble de notre industrie », a déclaré Ellison. « Notre attention se tourne maintenant vers l’avenir : bâtir une entreprise qui donne les moyens d’agir aux créateurs, divertit les publics et récompense les actionnaires. Nous sommes plus impatients que jamais de nous mettre au travail. »
Du travail, il va y en avoir car le plus dur reste à faire : accomplir les promesses et satisfaire le locataire de la Maison-Blanche qui voit cette acquisition d’un très bon œil. Donald Trump a déjà dit sa volonté de mater CNN.
En décembre dernier, le président américain a déclaré qu’il était « impératif » que la chaîne tout-info soit vendue, l’accusant de diffuser du « poison » et des « mensonges ». Larry Ellison est un proche de Trump, ce qui a certainement facilité les négociations avec les régulateurs. Skydance va créer un « conseil indépendant éditorial » pour CNN et CBS News, dont les membres seront choisis par… Skydance.
Sur le plan des finances, Skydance affiche un chiffre d’affaires d’environ 70 milliards de dollars, et la direction entend réaliser 6 milliards de dollars de synergies (des économies) annuelles d’ici trois ans. Autre objectif : générer un flux de trésorerie de plus de 10 milliards de dollars à l’horizon 2030.
Une trajectoire ambitieuse, soumise à la mise en œuvre d’une feuille de route qui l’est tout autant, entre intégration opérationnelle, discipline dans les dépenses de contenu, réalisation des synergies et réduction de l’endettement. Celui-ci est colossal : 80 milliards de dollars. Il faudra donc faire croître les revenus tirés du streaming et relancer les films en salles, tout en protégeant les revenus de chaînes câblées qui déclinent.
Google ne manque jamais une occasion de faire la promotion de Chrome ou de sa propre application de recherche dans Safari, tout particulièrement sur iPhone. Apple voudrait en avoir le cœur net et mesurer précisément le volume et la fréquence de ces bannières et de ces panneaux souvent envahissants.
Illustration : Flock
La bêta 2 d’iOS 27.2 contient en tout cas des outils de télémétrie pour relever l’usage que fait Google de ces promotions dans Safari, d’après le code découvert par le site 9to5Mac. Cela ne veut pas nécessairement dire qu’ils seront présents dans la version finale d’iOS 27.2, mais leur présence dans la bêta confirme l’expérimentation par Apple de cette fonction.
Safari injecte un script JavaScript dans certaines pages du site de Google : accueil et résultats de recherche. Il cherche les bannières et les éléments visuels qui incitent les utilisateurs à lancer Chrome ou l’app Google. Lorsqu’une de ces promotions est détectée, le navigateur peut enregistrer plusieurs informations : si elle a été affichée, si l’utilisateur a interagi avec elle, ou encore s’il semble connecté à un compte Google.
Apple est ainsi en mesure de déterminer si l’utilisateur a accepté ou ignoré les sollicitations de Google. Reste à savoir pour quoi faire. 9to5Mac avance l’idée que ces outils pourraient être indispensables dans un cadre réglementaire. Dans l’UE, le règlement sur les marchés numériques oblige Apple à proposer aux internautes le choix du navigateur et du moteur de recherche. Mais pourquoi dans ce cas se limiter à Chrome ?
Les « aperçus IA » qui s’affichent en tête des résultats d’une recherche Google sont générés à partir de contenus produits par des sites web. Après avoir capté une partie de leur trafic grâce à ces résumés, Google aurait commencé à rémunérer des éditeurs pour leurs contenus.
Avec les AI Overviews (Aperçus IA en France), Google prive les sites web d’une partie de leur trafic et donc, de leurs revenus publicitaires. Les internautes ne sont plus incités à se rendre sur ces sites, se contentant bien souvent des résumés générés par IA. C’est la double peine pour les éditeurs, qui se font voler à la fois leurs contenus et leurs lecteurs. Et cela explique aussi la méfiance de plus en plus grande de plusieurs d’entre eux, qui envisagent tout simplement de couper les ponts avec le moteur de recherche dominant.
Fin 2025, la Commission européenne ouvrait une enquête sur Google, accusé de fausser la concurrence en imposant des conditions abusives aux éditeurs et aux créateurs de contenu qui désavantagent les développeurs d’IA concurrents.
Poussé par les régulateurs, Google a dû mettre en place cet été un réglage permettant aux éditeurs d’interdire la collecte de leurs articles pour entraîner les modèles IA de l’entreprise. Tout en autorisant tout de même l’indexation de ces mêmes articles, pour les intégrer dans les résultats de recherche classiques.
Le baiser de la mort
Mais avant de générer des aperçus IA, faut-il encore avoir la matière première : les contenus. Et Google a toujours besoin des sites web. Le site The Information rapporte l’existence d’un programme pilote lancé il y a moins d’un an ; il rémunère une centaine d’éditeurs de sites web. Les sommes varient en fonction de la contribution de leurs contenus aux réponses générées par l’IA dans son moteur de recherche, ainsi que dans le mode IA et dans le chatbot Gemini.
Un éditeur anonyme aurait, depuis son inscription au programme, touché entre 50 000 et 60 000 dollars, ce qui ne représente qu’une petite partie de son activité. Un autre perçoit plus d’un million de dollars par an, ce qui est une part plus significative de son chiffre d’affaires. Les sommes peuvent sembler importantes, mais tout dépend de la taille des éditeurs et de leurs rédactions. Certains sites doivent se contenter de moins de 1 000 dollars sur plusieurs mois.
Pour les petits sites qui participent à ces tests, les sommes versées par Google pèseraient pour moins de 0,1 % de leurs revenus publicitaires, d’après les sources de The Information. La petitesse de ces enveloppes auraient même dissuadé des éditeurs plus importants de se lancer. Ce faisant, ils espèrent pousser Google à mieux valoriser les contenus utilisés pour l’entraînement des IA.
Un modèle pour le secteur de la presse en ligne ?
Plus pragmatiques, d’autres éditeurs espèrent comprendre le type de contenus favorisés par Google et son IA, afin d’optimiser leurs articles et profiter de la manne. Un dirigeant d’un éditeur indique que Google décide seule de la valeur des contenus afin de garder le mystère sur la boîte noire de son système de génération IA.
Des participants au programme n’auraient aucune idée de la manière dont Google calcule les rémunérations, ni ce que Google considère comme une contribution significative à un aperçu IA. Des contenus consacrés à des sujets niches (comme les anime ou les jeux vidéo) mais suscitant un fort intérêt de la part des internautes, semblent toutefois rapporter davantage.
Beaucoup des participants espèrent que ce programme fera figure de modèle à suivre pour les autres acteurs de l’IA qui ont tendance à jeter par dessus bord le copyright au nom d’un « usage légitime » qui a parfois bon dos. Il faudra au préalable que Google officialise l’initiative et que davantage d’éditeurs y participent.
OpenAI déploie son outil de filigrane sur le texte généré par ChatGPT. Cette fonctionnalité, réservée au Vieux continent en vertu de l’AI Act, demeure une solution imparfaite à un problème complexe.
Après Anthropic qui a intégré une fonction de filigrane dans le texte généré par Claude (depuis Fable 5.1 plus précisément), c’est au tour d’OpenAI de respecter l’obligation européenne de permettre l’identification d’un texte généré par ChatGPT. Cette mesure, inscrite dans l’AI Act, est en vigueur depuis début août – les systèmes d’IA présents sur le marché ont jusqu’au 2 décembre pour respecter les obligations de marquage technique.
OpenAI a donc dévoilé sa feuille de route pour le tatouage des textes. La technologie, baptisée textGrain, ajoute un « signal statistique invisible » sur les choix des mots. Autrement dit, c’est une technique qui « modifie subtilement la manière dont le modèle choisit de façon aléatoire entre plusieurs mots ou fragments de mots possibles au fil de la génération [du texte] », explicite l’entreprise dans une fiche technique.
« Sur l’ensemble d’un passage, ces choix créent un motif qu’un détecteur peut repérer, même après certaines modifications du texte. » Le résultat est censé être invisible aux yeux du lecteur, la technique n’ajoutant « aucun caractère caché, espace invisible ou signe de ponctuation inhabituel ». Anthropic a choisi une solution similaire.
Pangram, qui a beaucoup fait parler ces dernières semaines suite à l’affaire Thélyson Orélien, analyse les textes après leur génération, en se basant sur des caractéristiques comme le choix des mots. Il ne détecte pas les signaux intégrés à même les textes, comme c’est le cas des filigranes.
Le code des bonnes pratiques sur la transparence des contenus de l’AI Act n’impose pas de watermark sur les textes de moins de 200 tokens, ce qui représente environ 150 mots en anglais. De toute manière, les techniques de filigrane ne sont pas efficaces sur les textes courts, comme le rappelle OpenAI.
Image : OpenAI
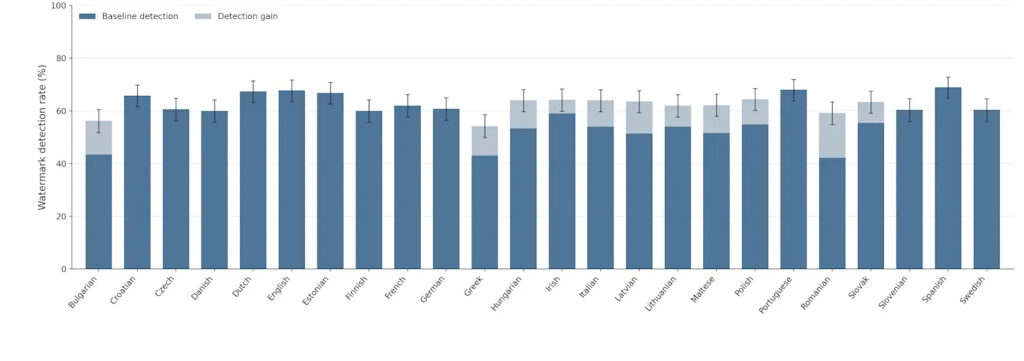
Le taux de détection varie en fonction de la langue, certaines d’entre elles se montrant « plus faciles à détecter que d’autres ». Sur les tests réalisés par l’entreprise – 500 prompts générés en anglais, puis traduits –, l’espagnol obtient le meilleur taux de détection (69 %), le roumain affichant le taux le plus faible (42,2 %). Avec un taux qui dépasse 60 %, le français est plus proche de l’espagnol.
OpenAI ajoute à textGrain un paramètre d’ajustement de l’intensité pour renforcer ou réduire le signal du filigrane en fonction des domaines. Le taux de détection de certaines langues, qui se situe normalement sous le seuil des 60 %, s’améliore grâce à ce paramètre. L’entreprise a l’intention de proposer sa technologie en open source.
Image : OpenAI
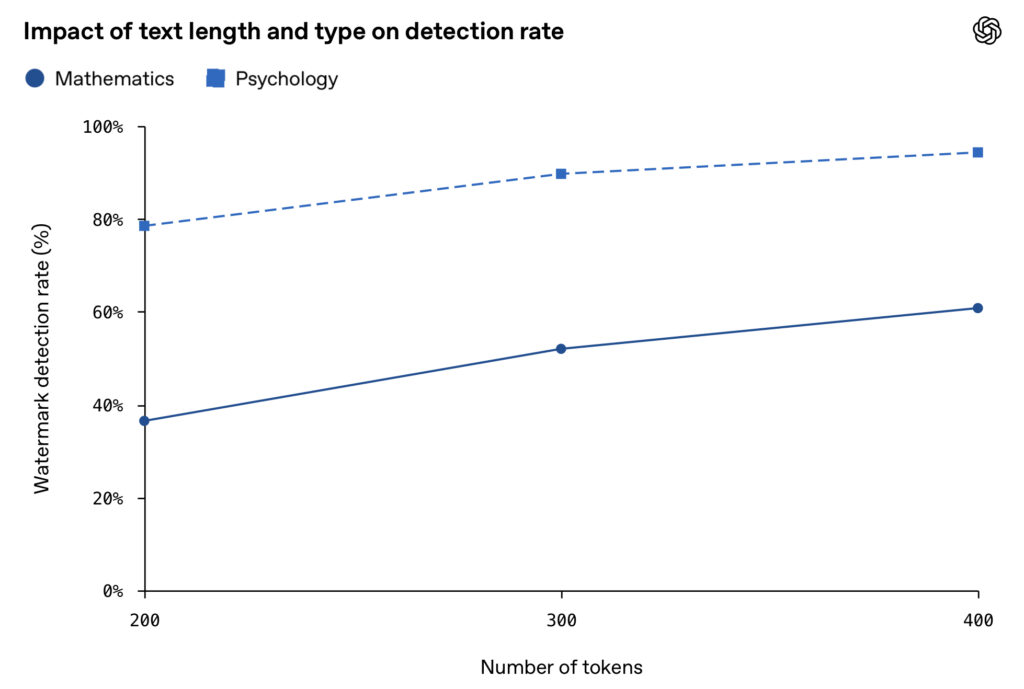
OpenAI explique que les détecteurs peuvent commettre deux types d’erreurs de détection : faux positifs (signaler la présence d’un filigrane qui n’existe pas) et faux négatifs (ne pas repérer la présence d’un filigrane existant). Sur des passages de 400 tokens, avec un taux de faux positifs cible de 1 %, le détecteur a identifié un filigrane dans 95 % des cas – mais tout dépend du contenu. Sur les textes portant sur la psychologie, le taux de détection est particulièrement élevé ; il l’est beaucoup moins quand il s’agit de mathématiques, où le choix des mots est plus limité.
Brouiller les pistes
Autre limite : modifier les textes générés par IA a un impact sur le taux de détection. Un taux de détection à 92 % peut tomber à 66 % si 10 % des mots ont été remplacés par des synonymes. Remplacer 25 % des mots fait chuter le taux à 17 %. Ce qui est logique, au vu du fonctionnement du filigrane.
L’entreprise prévient aussi que les filigranes sur le texte ne sont pas la panacée. Un watermark ne mesure pas la contribution d’un humain, il se contente de dire qu’un modèle a généré ou modifié un texte. Il ne détermine pas non plus à qui appartient le texte ou qui en est le responsable. Il n’identifie pas non plus l’utilisateur et ne mesure pas la fiabilité du texte. Enfin, l’absence d’un filigrane ne prouve pas qu’un texte a été écrit par un humain.
textGrain est disponible dès aujourd’hui dans l’API, où la fonction peut être activée via les réglages (uniquement dans l’UE). Il se déploiera au sein de ChatGPT et Codex dans les prochaines semaines. En revanche, l’accès à l’outil de détection demeure encore la chasse gardée des chercheurs et des organisations sélectionnés qui travaillent à l’amélioration de la fiabilité de l’outil.
ChatGPT, Claude ou Gemini ont une mémoire qui leur permettent d’enregistrer certaines informations importantes sur leurs utilisateurs, afin de se « souvenir » d’un détail, d’un nom, d’un événement ou d’une date utile à une réponse. C’est le cas aussi de Muse, mais le nouvel agent de Meta pousse le principe beaucoup plus loin.
Avec Muse, Meta semble enfin avoir trouvé sa voie dans la course à l’IA. L’agent, lancé le 6 septembre mais toujours indisponible dans l’Union européenne, va bien plus loin qu’un « simple » chatbot : il peut chasser des informations sur internet en permanence et agir au nom de l’utilisateur, par exemple pour réserver un restau ou faire des courses (ce qui déplaît beaucoup à Amazon). Le succès de Muse ne tombe pas du ciel : Meta s’est fortement inspirée d’OpenClaw pour développer son propre agent. Et l’entreprise peut aussi compter sur l’immense surface de ses réseaux sociaux pour se donner une confortable longueur d’avance.
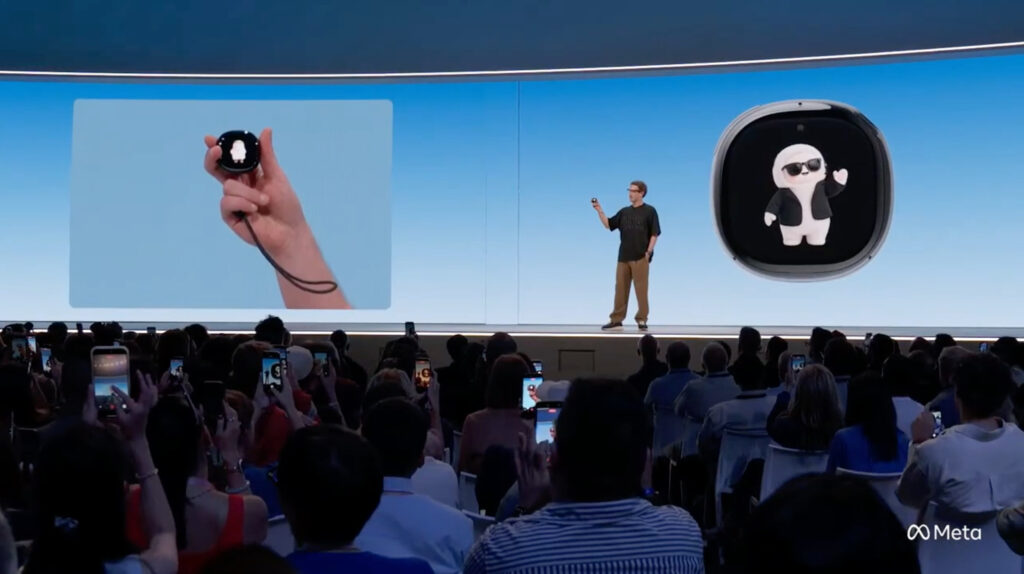
Le Charm dévoilé par Mark Zuckerberg durant la dernière conférence Meta Connect.
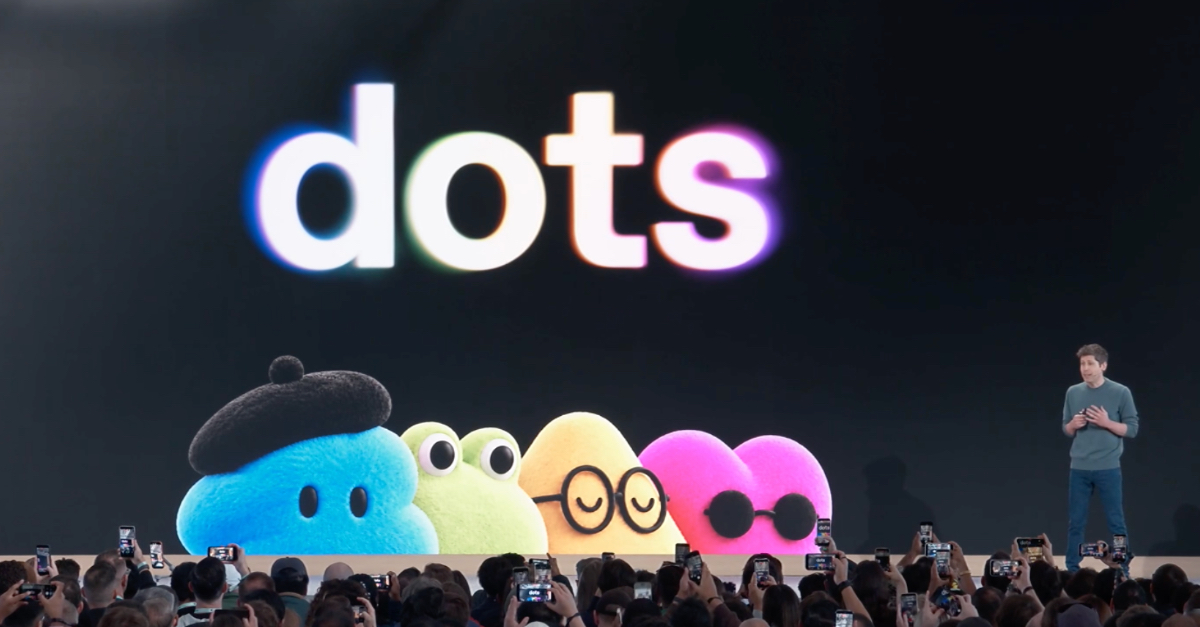
Le succès de Muse n’est pas tombé dans l’oreille d’un sourd : OpenAI a présenté pas plus tard que la semaine dernière son propre agent IA, Dots. Et Meta compte bien battre le fer tant qu’il est chaud. Muse est mis à toutes les sauces dans les autres produits et services du groupe, qu’il s’agisse de lunettes connectées… ou de Tamagotchi.
Les petites fiches de Muse
Mais Meta traîne derrière elle suffisamment de casseroles sur la vie privée pour que le fonctionnement de Muse mérite qu’on y regarde de plus près. Karan Joshi, chercheur en sécurité indépendant, a pu extraire un grand volume d’instructions et de prompts de l’agent, simplement en utilisant astucieusement l’interface de discussion. Il en a partagé une copie avec Wired, ce qui permet de jeter un œil dans les cuisines.
Il se trouve que Muse crée une page pour chaque personne importante dans la vie de l’utilisateur. Il s’agit de compiler des informations sur la famille, les intimes, les amis, les collègues, les personnes suivies par l’utilisateur. Cette mémoire, en fait des fichiers de texte structuré, se remplit au fur et à mesure des événements et des interactions ; ces données permettent à l’agent de construire une « représentation » des relations, avec le degré de proximité, l’historique, et même des pistes pour les renforcer.
D’après la documentation fournie par Karan Joshi, une « page » s’enrichit progressivement avec des sections : « Faits », « Historique », « Relation », « Points communs », « Sujets en suspens » et « Renforcement ». Muse doit uniquement utiliser les éléments qu’il a sous la main, et ne pas inventer des informations même si la page est vide.
Selon les instructions de Meta, Muse doit conserver « les sujets qui reviennent régulièrement (le déménagement, l’objectif commun d’épargne) », où vivent les relations de l’utilisateur, ce qu’elles font dans la vie. Le modèle peut également enregistrer les dates importantes comme les anniversaires, et des éléments de contexte comme une dispute terminée (certains parlent de beaucoup de choses très personnelles avec leur bot), une réunion importante la semaine dernière, un voyage…
L’enregistrement de l’état des relations est aussi manifestement important pour Muse : degré de proximité, sur quoi repose telle relation, ce dont cette relation peut avoir besoin… La section « Renforcements » peut d’ailleurs suggérer des moyens d’améliorer une relation : rappeler une date à ne pas oublier, une raison d’appeler…
Le plombier n’a rien demandé
« Pour qu’un agent soit utile et puisse réellement vous aider à atteindre vos objectifs, il doit disposer d’un certain contexte sur vous et sur les personnes avec lesquelles vous interagissez », explique un porte-parole de Meta. « Muse rassemble ces informations à partir de données publiques et de ce que vous avez choisi de partager. C’est ainsi qu’il peut se souvenir que la personne qui vous a envoyé une facture est en fait le plombier que vous aviez précédemment engagé pour effectuer des travaux dans votre salle de bains, ou encore l’envoi à votre conjoint de ses fleurs préférées. »
Une déclaration apparemment de bon sens, à laquelle on peut ajouter l’infrastructure de Muse. Il s’agit d’une machine virtuelle dans laquelle sont stockés les données de l’utilisateur et le contexte. Les agents tiers n’y ont pas accès sans autorisation, et l’utilisateur peut déconnecter les services tiers connectés à Muse, ou tout simplement en effacer la mémoire.
Muse va néanmoins plus loin que d’autres bots IA dans le stockage d’informations sur les personnes connues de l’utilisateur. ChatGPT possède une mémoire structurée, mais OpenAI la présente comme une synthèse évolutive du contexte entourant l’utilisateur. L’IA sélectionne les infos jugées pertinentes et la synthèse se met à jour et s’enrichit au fil du temps.
Le système de Meta organise les informations sur la relation qu’entretient un utilisateur avec une personne, leur historique, le degré de proximité, les sujets en suspens et peut même proposer des moyens de renforcer cette relation. Le problème ici, c’est la réputation exécrable de Meta quand il s’agit de manipuler les données personnelles, comme on l’a vu encore très récemment avec… Muse :
Enfin, le conjoint, les collègues, ou ce fameux plombier n’ont rien demandé, et surtout pas à être intégrés dans les petites fiches de Muse. Mais il suffit que l’utilisateur ait évoqué ces relations pour que ces personnes se retrouvent dans la mémoire de l’agent. L’utilisateur a certes accepté de partager des données publiques, mais pas nécessairement de ficher son entourage.
Sony Music prend le taureau par les cornes pour lutter contre les streams illégaux de chansons générées par IA. Fin septembre, la major a demandé aux plateformes le retrait de plus de 260 000 morceaux, un volume multiplié par deux par rapport aux trois premiers mois de l’année.
« Nous continuerons à faire respecter les droits de nos artistes et nous attendons des plateformes qu’elles agissent rapidement et empêchent la réapparition des mêmes contenus », a affirmé Sony Music au Financial Times. « Mais la tâche devient de plus en plus difficile », ajoute l’entreprise, une des trois majors de l’industrie du disque avec Universal (UMG) et Warner (WMG).
Le groupe a demandé aux plateformes de streaming de retirer plus de 260 000 morceaux fin septembre, alors que ce volume avait été de 135 000 fin mars. Ces titres sont des deepfakes générés par IA d’artistes signés par Sony (Adele, Queen, Michael Jackson…). Le phénomène prend « une ampleur considérable, porte préjudice aux artistes, trompe les fans et compromet une utilisation éthique de l’IA », précise la maison de disques.
Les bots écoutent les bots
Les services de streaming sont noyés sous les chansons générées par IA. Deezer avait ainsi indiqué qu’elles représentaient plus de la moitié des nouveaux morceaux téléversés en juillet. Ces titres sont très peu écoutés, et quand ils le sont, c’est souvent lié à des cas de fraude aux streams. Des bots « écoutent » ces chansons, ce qui en retour génère des revenus pour les fraudeurs, spoliant au passage les artistes légitimes.
Le rapport semestriel de la Sonic Intelligence Academy publié le mois dernier montre que plus de 9 chansons sur 10 (92,8 %) des morceaux soumis avaient été générés par Suno. Avec cette nuance : le pourcentage porte sur l’échantillon de l’étude, soit 1 743 titres provenant de 886 artistes dans 54 pays. Sur cet échantillon, 77,6 % ont été distribués aux plateformes par DistroKid, un distributeur payant permettant à ses clients d’être diffusé sur plus de 150 plateformes. Ces chiffres donnent toutefois une petite idée de la provenance de ces titres.
Sony Music et Universal poursuivent d’ailleurs Suno en septembre. La start-up est accusée d’avoir copié des enregistrements sans autorisation pour entraîner ses modèles IA. DistroKid est aussi la cible d’UMG, qui a porté plainte contre le distributeur le 15 septembre (PDF). Ce dernier se serait livré à « des pratiques commerciales trompeuses et à des violations flagrantes du droit d’auteur ». Plus précisément, DistroKid aurait contribué « à faire passer les morceaux IA pour ce qu’ils ne sont pas, et à en tirer profit ».
La riposte contre la fraude aux streams s’organise dans la filière, qui a couché sur le papier un ensemble de pratiques pour aider les acteurs du secteur – en particulier les distributeurs – à prévenir, détecter et traiter la fraude.
De leur côté, les plateformes ont mis en place des systèmes de badges pour indiquer aux auditeurs que tel artiste ou telle chanson est générée par IA. Bien souvent, les écoutes de ces morceaux sont démonétisées dès leur mise en ligne.
Malgré les restrictions imposées par les États-Unis, les affaires continuent pour Huawei. Le géant chinois et Qualcomm ont annoncé un accord pluriannuel de licences de brevets sur des technologies comme la 5G, l’IA, les réseaux, l’informatique. Qualcomm va également acquérir « certains brevets américains » de Huawei (ils ne sont pas précisés) dans ces domaines.
Crédit : Licence Creative Commons by Web Summit
« Cet accord reflète l’engagement commun des deux entreprises en faveur du respect des droits de propriété intellectuelle et de pratiques de licence conformes aux principes FRAND [conditions équitables, raisonnables et non discriminatoires] », ajoute le communiqué de presse commun. L’accord reflète la « reconnaissance par Qualcomm » des technologies de Huawei et de sa propriété intellectuelle, poursuit John Han, directeur général de l’activité licences au sein de l’entreprise américaine.
Huawei est sur la liste noire du Département du Commerce depuis 2019, ce qui impose aux entreprises US d’obtenir une licence avant d’exporter, de réexporter ou de transférer au groupe chinois des produits et composants soumis aux règles américaines d’exportation. Les restrictions n’ont pas cessé de s’empiler depuis, les autorités craignant que la technologie américaine puisse être utilisée pour nuire à la sécurité nationale.
Huawei a donc dû fortement investir ces dernières années pour développer ses propres technologies, avec des résultats pour le moins intéressants qui entraînent dans leur sillage toute l’industrie chinoise. Ce qui participe à accélérer l’indépendance technologique du pays vis à vis des États-Unis.
Le 26 août dernier, Huawei avait par ailleurs annoncé un accord avec HP portant sur des licences croisées de brevets portant sur la technologie Wi-Fi. Curieusement, HP a pris ses distances avec Huawei, en parlant de « mauvaise interprétation » pour cet accord « faisant passer le règlement d’un litige juridique pour un partenariat plus large. » HP a martelé que Huawei n’était pas un de ses fournisseurs, pas plus que HP n’est un fournisseur de Huawei.
Cette fois, pas de dissension ou de mauvaise compréhension entre Huawei et Qualcomm. Néanmoins, leur accord est soumis à des autorisations réglementaires.
Apple n’a pas supprimé l’application ICEBlock sous la pression de l’administration Trump, affirme l’entreprise. Il s’agissait, selon elle, de protéger les agents de la police de l’immigration américaine après une fusillade dans un centre de détention de l’ICE. Un argument crédible ?
Droit dans ses bottes. La décision de supprimer ICEBlock (et d’autres applications du même genre) de l’App Store était motivée par des préoccupations concernant la sécurité des agents de la police de l’immigration américaine. C’est ce qu’affirme Apple dans un courrier envoyé à Jamie Raskin, représentant démocrate et membre de la commission judiciaire de la Chambre des représentants américains. Un courrier partagé par CNN.
Raskin a lancé une enquête au mois de juin sur le rôle du ministère de la Justice (DoJ) dans la suppression de ces applications des boutiques d’Apple et de Google. Joshua Aaron, le développeur d’ICEBlock, avait porté plainte contre l’administration Trump en décembre dernier, deux mois après le retrait de son app de l’App Store.
Il accuse le gouvernement d’avoir fait pression sur Apple, ce que la procureure générale des États-Unis de l’époque, Pam Bondi, avait d’ailleurs confirmé dans une déclaration ne laissant planer guère de doute : « Nous avons contacté Apple aujourd’hui pour leur demander de retirer l’application ICEBlock de leur App Store, et Apple l’a fait ».
La fusillade de Dallas au cœur de la justification d’Apple
Dans cette lettre, qui remonte au mois de juillet, Apple explique qu’ICEBlock a été autorisée en avril 2025, après que le développeur a serré les boulons sur des fonctions de confidentialité. Pour rappel, l’app permettait à quiconque d’alerter les utilisateurs d’une descente de la tristement célèbre police de l’ICE dans les parages.
En septembre 2025, une fusillade a lieu dans un centre de détention de l’ICE à Dallas (Texas), faisant trois morts : deux détenus et l’auteur des tirs. Selon Apple, c’est après cet événement que Pam Bondi a fait part de ses inquiétudes concernant ICEBlock, une app qui « représente une menace pour la sécurité des agents fédéraux ». Kash Patel, le directeur du FBI, avait également affirmé que le tireur avait recherché des apps permettant de connaître la localisation des agents.
Apple indique aussi avoir relevé une hausse importante des activités de l’ICE et des menaces visant l’agence. La situation pouvait mettre en danger aussi bien les agents que les personnes détenues, écrit Timothy Powderly, directeur principal des affaires gouvernementales de l’entreprise. Ce sont tous ces éléments qui l’ont conduit à un nouvel examen de l’application.
Apple a déterminé qu’ICEBlock et les autres plateformes de localisation des agents de la police de l’immigration enfreignaient ses politiques, « et, par conséquent, d’autres personnes susceptibles de se trouver à proximité, comme des manifestants ou des personnes détenues —, offrant ainsi une possible feuille de route pour des violences ciblées et créant un risque important de préjudice ».
Un « risque important » de violences ciblées
L’opérateur de l’App Store assure ne pas prendre à la légère la décision de retirer des applications, mais qu’il intervient quand c’est nécessaire, « en particulier lorsqu’il existe de sérieuses raisons de penser qu’une application crée des risques pour la sécurité ». Des explications qui exonèrent l’administration Trump des accusations de pression politique, mais qui ne convainquent pas Jamie Raskin.
Dans sa réponse envoyée ce lundi à Timothy Powderly, le représentant écrit qu’Apple porterait atteinte aux droits garantis par le premier amendement de la Constitution américaine, « notamment celui de documenter les activités de leur propre gouvernement et d’en rendre compte ». Selon Raskin, il n’existe aucune preuve que ces apps aient été utilisées pour commettre la fusillade de Dallas.
Même si le tireur a pu rechercher des apps pour localiser les agents de l’ICE, « il n’avait pas besoin d’une application de suivi pour localiser un bâtiment gouvernemental dont l’emplacement est fixe ». Le tireur aurait tout simplement trouvé l’adresse du centre à l’aide d’une app « installée par défaut sur les appareils Apple » (probablement Apple Plans).
Pour Jamie Raskin, il n’existe aucun lien direct entre ce qui s’est passé à Dallas et les applications retirées de la boutique. Le représentant demande au constructeur de procéder à un nouvel examen indépendant pour décider si ces applications enfreignent réellement les règles de l’App Store.
Dans le petit monde de l’IA, beaucoup se demandaient quand OpenAI allait réagir face à l’offensive de Meta avec son agent Muse. C’est chose faite ce soir avec la présentation de Dots, un agent qui accomplit des tâches au nom de l’utilisateur et qui prend la forme d’un blob de couleur. Ça n’est que l’une des innombrables annonces d’OpenAI à l’occasion des DevDay 2026.
Que d’IA, n’en jetez plus, le bateau déborde ! Loin de ralentir la cadence, OpenAI a noyé les participants des DevDay 2026 d’annonces, de nouveautés et de fonctionnalités en tout genre. Difficile de faire le tri dans ce tsunami, mais Dots fait clairement partie des gros morceaux de la keynote.
Un blob pour gouverner vos tâches
Dot est un agent IA carburant à GPT-6 Astra qui prend la forme d’un blob coloré à personnaliser, un peu comme Mico, la (défunte) mascotte de Copilot. Cet agent peut réaliser les opérations classiques d’un agent IA, comme réserver un restaurant ou acheter un billet d’avion, mais cela va plus loin : en plus d’être branché aux applications de l’utilisateur dont il tire du contexte, le Dot surveille constamment ce qui se passe sur internet afin de compléter les tâches plus complexes.
Dans un exemple donné par OpenAI, un utilisateur de Dot veut organiser un dîner. L’agent détecte de lui-même que l’utilisateur avait un rendez-vous de travail pendant l’heure prévue, et lui propose deux possibilités de livraison du repas avec leur prix respectif. Il n’y a plus qu’à valider l’alternative et l’heure de la livraison. Dot peut également se dépatouiller pour créer un site web de A à Z, l’utilisateur n’ayant qu’à demander des modifications.
On peut communiquer avec un Dot via ChatGPT bien sûr, mais aussi Slack, Teams, et même via une messagerie (RCS ou iMessage) pour les abonnés Pro à partir de 103 euros. Ces derniers seront d’ailleurs les premiers à pouvoir tester ces Dots. À terme, OpenAI a l’intention de proposer la possibilité de contrôler plusieurs agents simultanément.
Il faudra se montrer patient sur le vieux continent : l’espace économique européen, la Suisse et le Royaume-Uni sont pour le moment exclus du lancement.
Spaces, Decisions, Codex : le reste de l’offensive
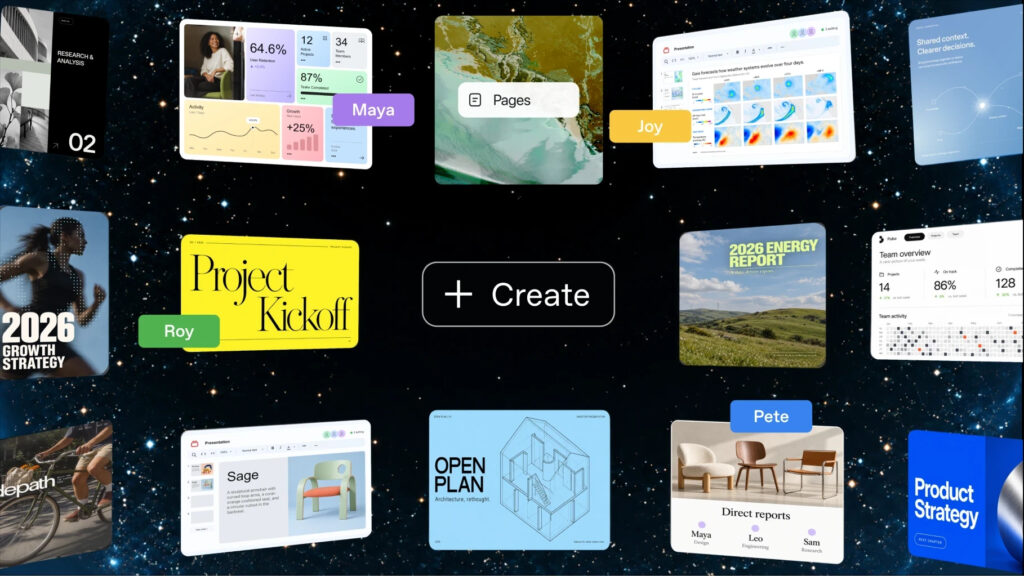
Après s’être attaqué à Muse, OpenAI entend également gravir la montagne bureautique. ChatGPT Spaces est un espace collaboratif entre humains et Dots où ils peuvent créer et éditer des documents, via un système de commentaires où l’on taggue les collègues et les agents. Les fichiers téléversés par l’équipe (et ceux générés par ChatGPT) sont sauvegardés dans le Space pour que chacun y ait accès.
L’offre comprend pour le moment un traitement de texte, Pages, et un outil de création de diapositives (ce dernier étant encore en développement). Space est proposé dès aujourd’hui aux abonnés Pro, Business Premium et Enterprise.
Tout comme celui de Muse, le succès de Jev n’est pas tombé dans l’oreille d’un sourd. OpenAI a donc levé le voile sur l’API Decisions, qui repose sur Luna (le modèle meilleur marché de la gamme). Peu de détails ont été révélés, mais cette interface de programmation n’est pas un modèle qui répond directement à la question de l’utilisateur. C’est un outil qui indique le niveau de confiance dans un choix entre plusieurs réponses et actions fournis par le développeur. L’API est en aperçu limité à l’heure actuelle, OpenAI donnera davantage de détails au moment opportun.
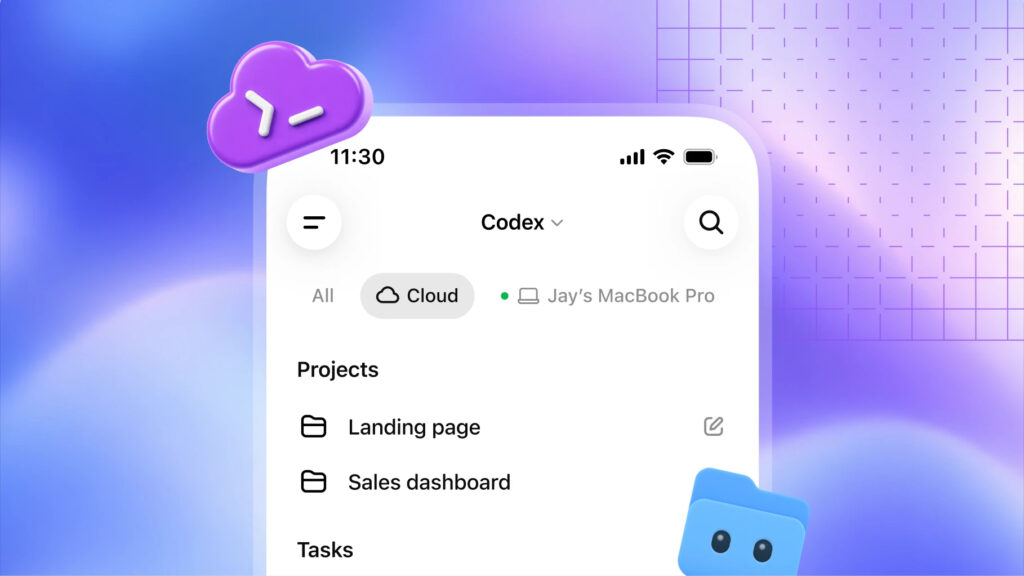
Codex a aussi été à la fête, avec plusieurs nouveautés importantes. À commencer par des environnements de développement cloud réutilisables ; ces derniers peuvent être partagés au sein d’une équipe avec un système de réglages et de permissions. L’interface en ligne de commande peut désormais être pilotée à la voix, parce que pourquoi pas.
Dans l’app Codex (en fait ChatGPT avec une moustache), la revue de code a été revue et améliorée. Elle peut résumer les changements, répondre à des questions sur les problèmes qui pourraient se poser avant de commenter une pull request ou une merge request, et ces revues de code peuvent être lancées pendant que le développeur n’est pas devant sa machine.
GPT-6.1 Sol veut se rapprocher d’Astra
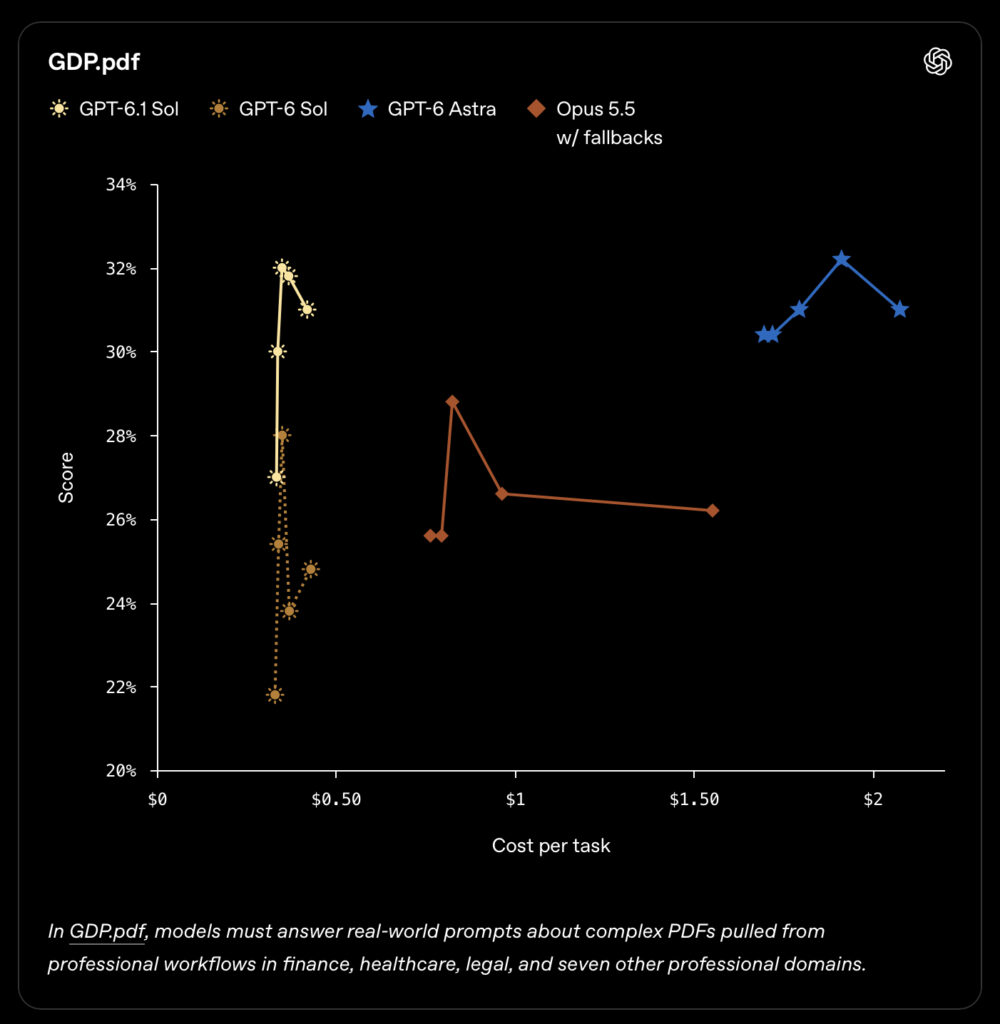
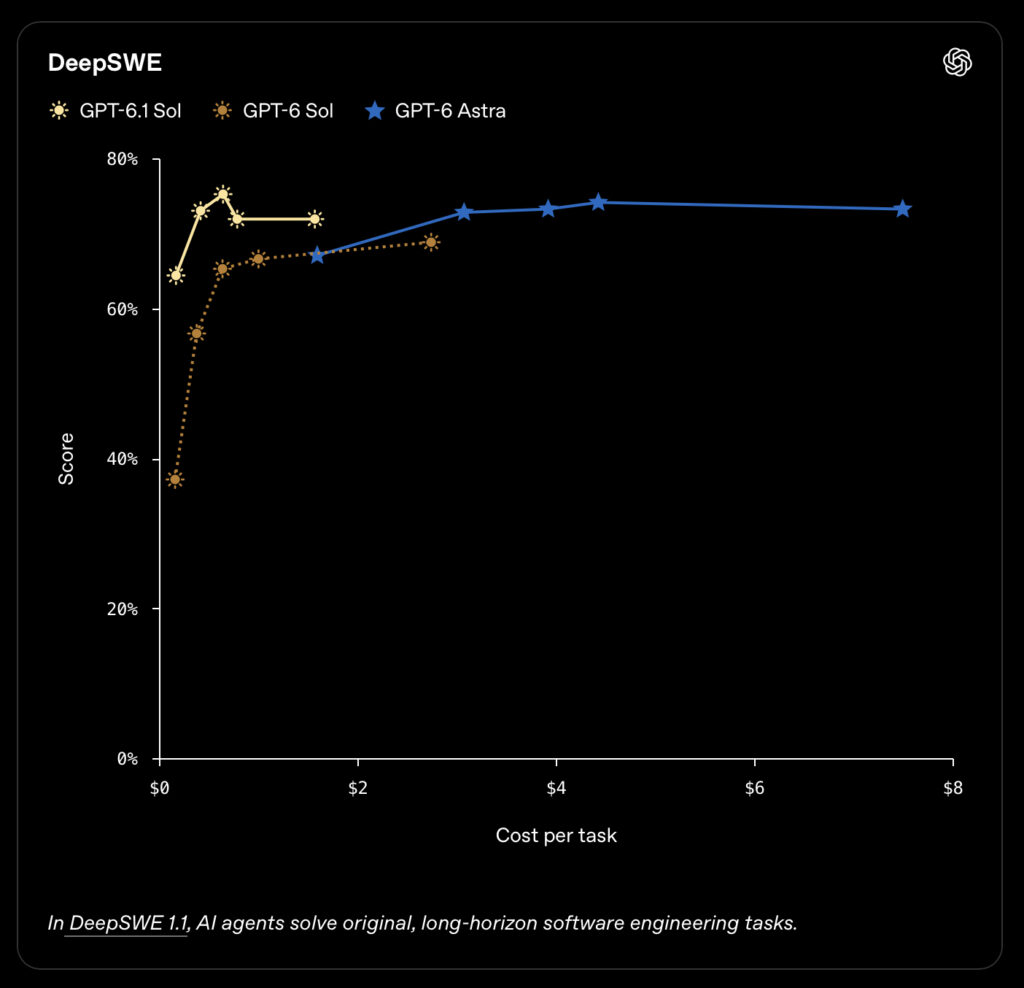
OpenAI a enfin profité de l’occasion pour dévoiler GPT-6.1 Sol, le modèle IA intermédiaire entre le puissant Astra et le moins cher Luna qui en sont tous deux restés à GPT-6 (ça ne va pas durer). L’entreprise promet un gain de performances important sur des tâches comme l’écriture de code et le déboggage par rapport à GPT-6 Sol, ainsi que sur la compréhension des documents et l’exécution de plusieurs tâches.
Dans plusieurs des évaluations, GPT-6.1 Sol s’approcherait même des capacités de GPT-6 Astra « à un coût substantiellement moins élevé ». Les prix, parlons-en : 2 dollars pour un million de tokens en entrée, 10 dollars en sortie, soit les mêmes tarifs que Sonnet 5.5, et 0,10 dollar pour un million de tokens d’entrée mis en cache (moitié moins cher que le dernier Sonnet). Le modèle est en phase de déploiement dès aujourd’hui pour les abonnés Plus, Pro, Business, Enterprise et Edu, ainsi que dans l’API.
Il va bien falloir financer cette tempête de nouvelles fonctionnalités ! OpenAI a donc dévoilé un nouvel abonnement qui coûte la bagatelle de 500 dollars par mois. Il comprend l’accès à un mode « UltraFast » (vitesse maximale) pour ChatGPT Work et Codex, ils pourront carburer à 300 tokens par seconde (la vitesse UltraFast est aussi proposée aux utilisateurs de l’API).
L’entreprise a également rouvert les inscriptions à la formule à 200 dollars par mois qui avait été fermée durant quelques semaines après le lancement de GPT-6 Astra. Un abonnement désormais moins intéressant : l’usage Codex et Work passe à 10 fois celui des abonnés Plus (20 dollars) alors que l’enveloppe était de 20 fois auparavant. Les abonnés actuels conserveront leurs limites actuelles pendant un certain temps.
Sans surprise, Google a formé un recours auprès du Tribunal de l’Union européenne concernant des mesures contraignantes décidées par la Commission le 16 juillet. Cet appel concerne deux décisions de Bruxelles.
Google doit partager ses données de recherche avec ses rivaux, une mesure censée rééquilibrer un marché dominé de la tête et des épaules par Google. « Les gens utilisent le moteur de recherche pour poser leurs questions les plus personnelles – qu’il s’agisse de préoccupations médicales ou de relations intimes – et nous obliger à partager ces requêtes personnelles sans garanties suffisantes causerait un préjudice irréversible à la vie privée des utilisateurs », a déclaré Oliver Bethell auprès de Bloomberg.
Illustration : Flock
La seconde, touche à l’ouverture d’Android aux bots IA concurrents de Gemini (Claude, ChatGPT, etc.), mais elle n’a suscité aucun commentaire particulier de la part de Google, bien qu’elle fasse l’objet du même appel.
Rendez-vous dans quelques mois ou années pour connaitre la position du Tribunal. Si elle n’allait pas dans le sens de Google, il est plus que probable qu’un appel soit déposé devant la Cour de justice, mais il sera alors limité aux questions de droit.
Google accumule les amendes et les sanctions en Europe. La semaine dernière, la Commission irlandaise à la protection des données infligeait à l’entreprise une douloureuse de 403 millions d’euros pour infraction au RGPD. En juillet, la Commission y allait de deux amendes d’un total de 890 millions d’euros pour violations du DMA.
Oura reporte son introduction en Bourse (IPO). Le constructeur de bagues connectées préparait depuis quelques mois son lancement au Nasdaq, l’indice américain des technologies. Mais « malgré une forte demande », un délai est nécessaire en raison des « incertitudes qui pèsent sur le marché [des IPO] ».
L’entreprise, créée en Finlande sous le nom Oura Health Oy, a transféré son siège juridique aux États-Unis cette année. La R&D reste toutefois ancrée en Finlande. Elle avait annoncé son intention de se lancer en Bourse le 21 septembre en vendant 50 millions d’actions à un prix oscillant entre 40 et 44 dollars. L’objectif était alors de lever 2,2 milliards de dollars.
La décision de reporter l’IPO une semaine après son annonce a de quoi étonner, d’autant que les incertitudes boursières relevées par Oura ne datent pas d’hier (ces conditions n’ont pas l’air de gêner Anthropic). « Nous voulons réussir une introduction en Bourse exceptionnelle pour nos salariés et nos investisseurs », a justifié Tom Hale, le directeur général d’Oura, « et nous avons le luxe de pouvoir choisir le moment opportun. D’ici là, nous continuerons à saisir les opportunités qui s’offrent à nous. »
L’entreprise est rentable, affirme le communiqué, sa croissance est soutenue et l’activité s’est « encore renforcée depuis le lancement du processus d’introduction en Bourse ». La bague Oura 5 a rencontré « un accueil exceptionnel », et le nombre d’abonnés payants a atteint les 5,7 millions (5,99 euros par mois). Le chiffre d’affaires devrait progresser de 90 % sur un an.

 Connexion