❌

Vue lecture

17Cyber : records de demandes d’aide, les cyberattaques débordent dans le monde réel

18cyber.fr c’est pour joindre l’ANSSI ?
17Cyber : records de demandes d’aide, les cyberattaques débordent dans le monde réel

Plus de 52 000 demandes sur le mois d’août, un record… qui n’a pas duré longtemps puisque septembre est à plus de 56 000. Jérôme Notin, directeur de Cybermalveillance, nous confirme que les cyberattaques ont de plus en plus de conséquences dans la vie réelle, avec deux exemples.

17Cyber est un assistant en ligne disponible depuis fin 2024. Il est proposé par la police, la gendarmerie et le site Cybermalveillance.gouv.fr. Il permet de suivre un parcours pour faire le diagnostic de votre situation et vous guider dans les démarches à suivre. 17Cyber est intégré à la plateforme Ma Sécurité du ministère de l’Intérieur, permettant ainsi de dialoguer à n’importe quel moment de la journée avec un policier ou un gendarme.

Jérôme Notin, directeur général du GIP ACYMA cybermalveillance.gouv.fr en charge de ce dispositif, a récemment publié des statistiques sur le nombre de parcours d’assistance réalisés via 17Cyber. Elles ne sont pas bonnes.

Deux records, coup sur coup

Le record depuis le lancement de la plateforme a été largement battu en août avec, pour la première fois, plus de 50 000 parcours (52 253 précisément). L’été est généralement une période calme, comme en témoigne le graphique ci-dessous (reprise de celui publié par Jérôme Notin avec, en orange, les deux mois d’été).

En septembre, rebelote avec de nouveau un record à 56 469 parcours. La barrière des 40 000 demandes a été franchie pour la première fois en octobre 2024 (à peu près au moment du lancement officiel de 17Cyber, qui a pris le relais de Cybermalveillance.gouv.fr pour les demandes d’assistance). Le chiffre était relativement stable depuis.

Aux Assises de la cybersécurité à Monaco, Jérôme Notin nous explique qu’une affaire récente a alimenté bon nombre de demandes.

La crypto : du monde numérique à la vie réelle


Il reste 68% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Comment les agents IA bouleversent la cybersécurité, défensive et offensive

Mythos, va patcher
Comment les agents IA bouleversent la cybersécurité, défensive et offensive

Cela ne surprendra personne, mais les deux mots incontournables (ou presque) aux Assises de la cybersécurité de Monaco sont « IA » et « agent ». Entre l’attaque, la défense et l’analyse (avec une forte asymétrie entre les deux), ils sont partout, à toutes les sauces. Si la situation actuelle est compliquée, les élections à venir risquent d’être « un carnage ».

À Monaco, tout le monde semble s’entendre sur un point : « l’IA nous complique la tâche […] L’IA est un multiplicateur de force, mais elle ne va pas rendre possible des attaques impossibles », a déclaré Vincent Strubel, patron de l’ANSSI, pour résumer la situation.

Avec l’IA, des attaques plus massives et sophistiquées

« Les méthodes d’attaque avec des IA génératives ne sont pas nouvelles, mais elles sont plus rapides et autonomes », confirme Bertrand Le Piolot, directeur cybersécurité chez FDJ United (anciennement Française des Jeux). Le général Patrick Touak, en charge du ComCyber MI, se dit tout de même « étonné de la vitesse avec laquelle l’IA a démultiplié les attaques ».

Jérôme Renoux, vice-président d’Akamai France, nous donne sa vision globale en tant que CDN qui voit passer « 25 à 30 % » du trafic mondial : « il y a une forte augmentation du nombre et de la sophistication des attaques par IA ». L’entreprise voit passer des bots « de plus en plus sophistiqués » ; ils sont par exemple « plus intelligents et imitent davantage le comportement humain » pour passer sous le radar des détections automatiques.

Après une forte explosion au moment du covid et des confinements, le volume des données échangées ne progresse que de quelques pourcents par an depuis quelques années. L’intelligence artificielle et les agents/bots occupent de la bande passante, mais ils n’ont pas d’effet significatif sur le volume de trafic global.

En défense, l’IA coûte cher


Il reste 81% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

SecNumCloud : Bleu vise désormais une qualification pour la fin d’année

Le cloud est bleu comme une Orange
SecNumCloud : Bleu vise désormais une qualification pour la fin d’année

Bleu est en retard sur le calendrier de la qualification SecNumCloud d’une partie de ses services. Elle prévoyait le premier semestre 2026, mais il est désormais question de « la fin d’année ».

L’annonce des « clouds de confiance » basés sur des technologies américaines avait fait beaucoup parler. Nous avons d’un côté Thales avec Google pour former S3ns, de l’autre Capgemini, Orange et Microsoft pour Bleu. Le principe est de faire héberger les technologies de Microsoft ou Google par des prestataires français.

Les deux visent depuis le début la qualification SecNumCloud, le plus haut niveau d’exigence en cybersécurité de l’ANSSI. Elle assure notamment une étanchéité aux lois extraterritoriales, une robustesse des systèmes informatiques, des équipes, etc.

S3ns : 17 mois entre le jalon J0 et la qualification SecNumCloud

S3ns est arrivé au bout du chemin, il y a un peu moins d’un an : son offre PREMI3NS est qualifiée SecNumCloud par l’ANSSI depuis décembre 2025, soit un processus de 17 mois pour être précis depuis la validation du jalon J0, « sans réserve » de l’ANSSI. La validation du jalon J1 avait ensuite pris cinq mois, puis 12 mois pour terminer la procédure.

Il y a, pour rappel, quatre niveaux dans la procédure de qualification SecNumCloud :

  • J0 : acceptation de la demande de qualification
  • J1 : acceptation de la stratégie d’évaluation
  • J2 : acceptation des travaux d’évaluation
  • J3 : décision de qualification

Si l’Agence émet des réserves, cela signifie que « l’ensemble des critères d’acceptation […] sont respectés, mais l’ANSSI estime qu’un jalon de la qualification ne peut a priori pas être franchi ou que les coûts et délais nécessaires pour atteindre la qualification sont très importants ». C’est une mise en garde, comme son nom l’indique, mais S3ns et Bleu n’y ont pas eu droit.

Bleu a validé le jalon J0 il y a 18 mois, la qualification prévue pour fin 2026

Bleu s’est lancé plus tard dans la procédure, avec une acceptation du jalon J0 en avril 2025. Le jalon J1 a pris un peu plus de temps – sept mois – que pour S3ns. Le calendrier était alors en phase avec ce que nous indiquait Bleu aux Assises de la cybersécurité de l’année dernière. La coentreprise de Capgemini et Orange ajoutait que la qualification SecNumCloud était attendue pour le premier semestre 2026, un calendrier déjà annoncé lors du passage du jalon J0. Nous avions aussi profité de l’occasion pour faire un rapide tour des enjeux de souveraineté et des relations avec Microsoft.

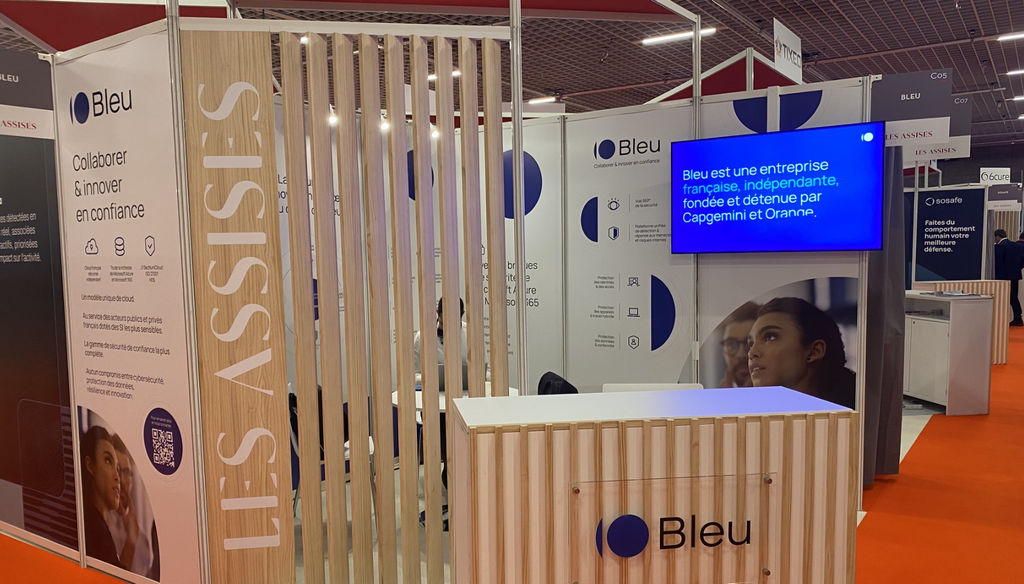
Un an plus tard, force est de constater que la qualification n’est toujours pas finalisée. Le stand de Bleu aux Assises de la cybersécurité 2026 n’affiche que le jalon J1. « Nous sommes toujours dans le process de qualification pour un très large catalogue de services IaaS, PaaS, et CaaS. Nous visons la qualification pour la fin d’année », nous explique le service presse.

Iaas (Infrastructure as a Service), PaaS (Platform as a Service) et CaaS (Container as a Service) correspondent à ce que propose Microsoft avec Azure. Avec la partie SaaS (Software as a Service) de Microsoft 365, qui passera la qualification dans un second temps, cela représente selon Bleu une centaine de services.

Cette qualification de trois niveaux de services en même temps était déjà présente chez S3ns, qui affirmait d’ailleurs que c’était « la première fois que l’ANSSI accorde la qualification SecNumCloud en simultanée pour les périmètres IaaS, CaaS et PaaS, couvrant plus de vingt services ».

Si Bleu obtient bien la qualification en décembre comme prévu, cela donnerait environ 13 mois d’écart avec le J1. Au total, si le délai annoncé est cette fois-ci respecté, la qualification prendrait donc 21 mois.

Procédure de qualification SecNumCloud de S3ns (Thales et Google) :

  • J0 : juillet 2024
  • J1 : décembre 2024 (5 mois)
  • Qualification : décembre 2025 (17 mois au total)

Procédure de qualification SecNumCloud de Bleu (Capgemini, Orange et Microsoft) :

  • J0 : avril 2025
  • J1 : novembre 2025 (7 mois)
  • Qualification : attendue fin 2026 (estimation 20 mois)
  •  

Dis Next, c’est quoi l’IA agentique et les harnais dont tout le monde parle ?

Sudo Machine
Dis Next, c’est quoi l’IA agentique et les harnais dont tout le monde parle ?

Des agents IA par-ci, des agents par là… les entreprises d’IA générative ont toutes ce mot à la bouche. On parle également de plus en plus de harnais. Mais de quoi s’agit-il ? Next vous explique !

L’intelligence artificielle existe depuis des décennies, elle remonte même aux années 1950. Après quelques « hivers » – des périodes durant lesquelles l’IA stagne et se fait oublier, elle a fait un bond avec l’arrivée des cartes graphiques modernes. En 2022, le grand public est entré de plein fouet dans l’ère de l’intelligence artificielle générative (ou GenAI), capable de produire du texte et des contenus multimédias et propulsée par ChatGPT.

De l’IA générative, nous voilà désormais dans l’ère de l’IA agentique. Pour la CNIL, il s’agit d’un « ensemble de systèmes qui reposent sur la coordination de plusieurs sous-systèmes appelés agents IA ». Ces agents sont bien plus qu’une IA générative, ils sont capables « d’agir sur un environnement défini […] et d’en modifier l’état […], avec des niveaux variables d’autonomie ».

Un agent IA, c’est un harnais avec un modèle d’IA générative

Si l’IA générative produit du texte et du contenu multimédia, un agent IA va en plus pouvoir exécuter des actions, en s’appuyant sur cette même IA. On touche du doigt la notion de harnais, qui est l’infrastructure logicielle. Le modèle d’IA générative et le harnais forment un agent IA. S’il se dégage un consensus sur le harnais, il n’existe pas (encore) de définition précise ; il faut dire que le terme est récent et n’est utilisé couramment que depuis le début de l’année.


Il reste 76% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Clés USB, smartphones… les e-dogs flairent le tantale pendant des perquisitions 

L'île de la tantalation
Clés USB, smartphones… les e-dogs flairent le tantale pendant des perquisitions 

Vous connaissez certainement les chiens renifleurs capables de détecter de la drogue, des armes ou de l’argent. Mais il en existe aussi pour trouver du matériel électronique, notamment des clés USB et cartes mémoires. Ils sont appelés en renfort dans certaines perquisitions, particulièrement dans des affaires pédocriminelles.

Depuis des décennies, la gendarmerie nationale fait appel à des équipes cynophiles pour la recherche de personnes, de stupéfiants, de billets de banque, d’explosifs, etc. Le flair des chiens leur permet de détecter d’infimes traces d’odeur et d’en remonter la piste.

La gendarmerie développe une nouvelle compétence des chiens : détecter le tantale. Il s’agit d’un métal utilisé dans une large panoplie de composants électroniques, allant des smartphones aux ordinateurs en passant par les disques durs externes et des clés USB. Ils peuvent aussi trouver de petits produits comme des cartes mémoire microSD et des cartes SIM.

Une mini clé USB dans… un dentier

Détecter du tantale permet donc de détecter un appareil électronique, ce qui est particulièrement utile lors de perquisitions pour ne pas laisser de côté une carte mémoire, une clé USB ou un smartphone.

Lors des Assises de Monaco, le général Patrick Touak, patron du Comcyber Mi, donne un exemple dans une enquête récente. Un chien de la brigade cynophile marque un arrêt devant un meuble de salle de bain chez un suspect. Les enquêteurs fouillent, mais ne voient rien. Plus tard pendant la perquisition, le maître-chien revient dans la salle de bain et le malinois marque de nouveau exactement au même endroit.


Il reste 61% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Cyberattaques et fuites de données : « on n’a pas vu le pire », affirme Vincent Strubel

Asseyez-vous, ça va piquer
Cyberattaques et fuites de données : « on n’a pas vu le pire », affirme Vincent Strubel

Pour renforcer la cybersécurité de manière globale, Vincent Strubel milite pour plus de transparence et de retour d’expérience. Le général Patrick Touak, en charge du Comcyber Mi, confirme et ajoute que cela passe aussi par un renforcement sans compromis de la cybersécurité, notamment la double authentification obligatoire.

Lors de la traditionnelle conférence d’ouverture des Assises de la sécurité, Vincent Strubel (patron de l’ANSSI) est revenu sur les trop nombreuses fuites de données dont sont victimes les Français depuis des mois, voire des années. L’année dernière, il avait plombé l’ambiance en parlant de la « brutalisation du monde » et de la perspective d’une « guerre de haute intensité » d’ici 2030, avec un « engagement de nos armées ».

Cette année, il affirme qu’il n’a « pas besoin de plomber l’ambiance, les attaquants l’ont déjà fait ». La DGFiP, victime d’une cyberattaque avec fuite de données, est l’éléphant dans la pièce. L’ANSSI a, pour rappel, publié récemment un billet détaillé sur les vecteurs d’attaque utilisés par les pirates.

Les « attaques qu’on a subies ne sont pas très sophistiquées »

L’attaque n’était pas sophistiquée, elle surfait sur une série de défaillances. Le général Patrick Touak, chef du commandement du ministère de l’Intérieur dans le Cyberespace, confirme et élargit le périmètre bien au-delà de la DGFiP : les « attaques qu’on a subies ne sont pas très sophistiquées ».

Cette fuite de la DGFiP est une parmi tant d’autres ; aussi bien des institutions publiques que des entreprises privées sont concernées, et ce quelle que soit leur taille. Vincent Strubel soulève toutefois la question de ce que « disent les attaques de nos vulnérabilités basiques et universelles ». C’est d’autant plus grave quand on les retrouve dans des institutions étatiques : « c’est particulièrement inacceptable ».

Pour le patron de l’ANSSI, ce « travail de transparence » – très récent, le rapport de la DGFiP est une exception à ce jour – de l’Agence est nécessaire, mais fait grincer des dents : « Ça pique, mais on va continuer car c’est vital ». Ce qui est arrivé à la DGFiP doit servir d’électrochoc : d’autres institutions traînent certainement le même genre de vulnérabilité : il faut « avoir le courage de le dire et de le répéter ; c’est un chantier colossal ».


Il reste 66% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

.agent, .fart, .omg… L’ICANN dévoile près de 1 000 extensions, certaines très convoitées

Ferd n’a même pas demandé le .next, pour faire ink.next :/
.agent, .fart, .omg… L’ICANN dévoile près de 1 000 extensions, certaines très convoitées

Sur Internet, de nouvelles extensions vont arriver (pas demain, il faudra attendre des mois voire des années) avec des domaines en .agent, .bit, .geek, .gram, .gpt… Mais aussi des extensions plus surprenantes avec .fart, .ufo et .omg pour ne citer qu’elles. Les demandes venant de France sont peu nombreuses : une dizaine seulement.

Comme prévu, l’ICANN a publié hier soir la liste des demandes du deuxième round de gTLD, c’est-à-dire les extensions de premier niveau. Le premier round s’était déroulé en 2012 et avait donné naissance aux .bzh, .paris, .ovh, .sncf, .leclerc, .xyz, etc. Plus de 1 600 demandes ont été formulées cette année. La liste est désormais publique. Vous pouvez la consulter et la télécharger ici. Pour les extensions, mettez Primary String dans Search by.

891 demandes centrées sur 263 extensions : fight !

Au total, les fichiers de l’ICANN indiquent 1615 candidatures pour des extensions, dont 987 extensions de premier niveau distinctes ; il y a donc plusieurs demandes pour certaines extensions.

724 candidatures seulement ne sont pas disputées par plusieurs entreprises, ce qui en laisse 891 (sur 263 extensions distinctes) impliquées dans un conflit, à savoir avec au moins deux sociétés qui demandent la même extension de premier niveau.


Il reste 81% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Apple M1 à M6 : six ans de puces en un coup d’œil

M6, la petite puce qui monte
Apple M1 à M6 : six ans de puces en un coup d’œil

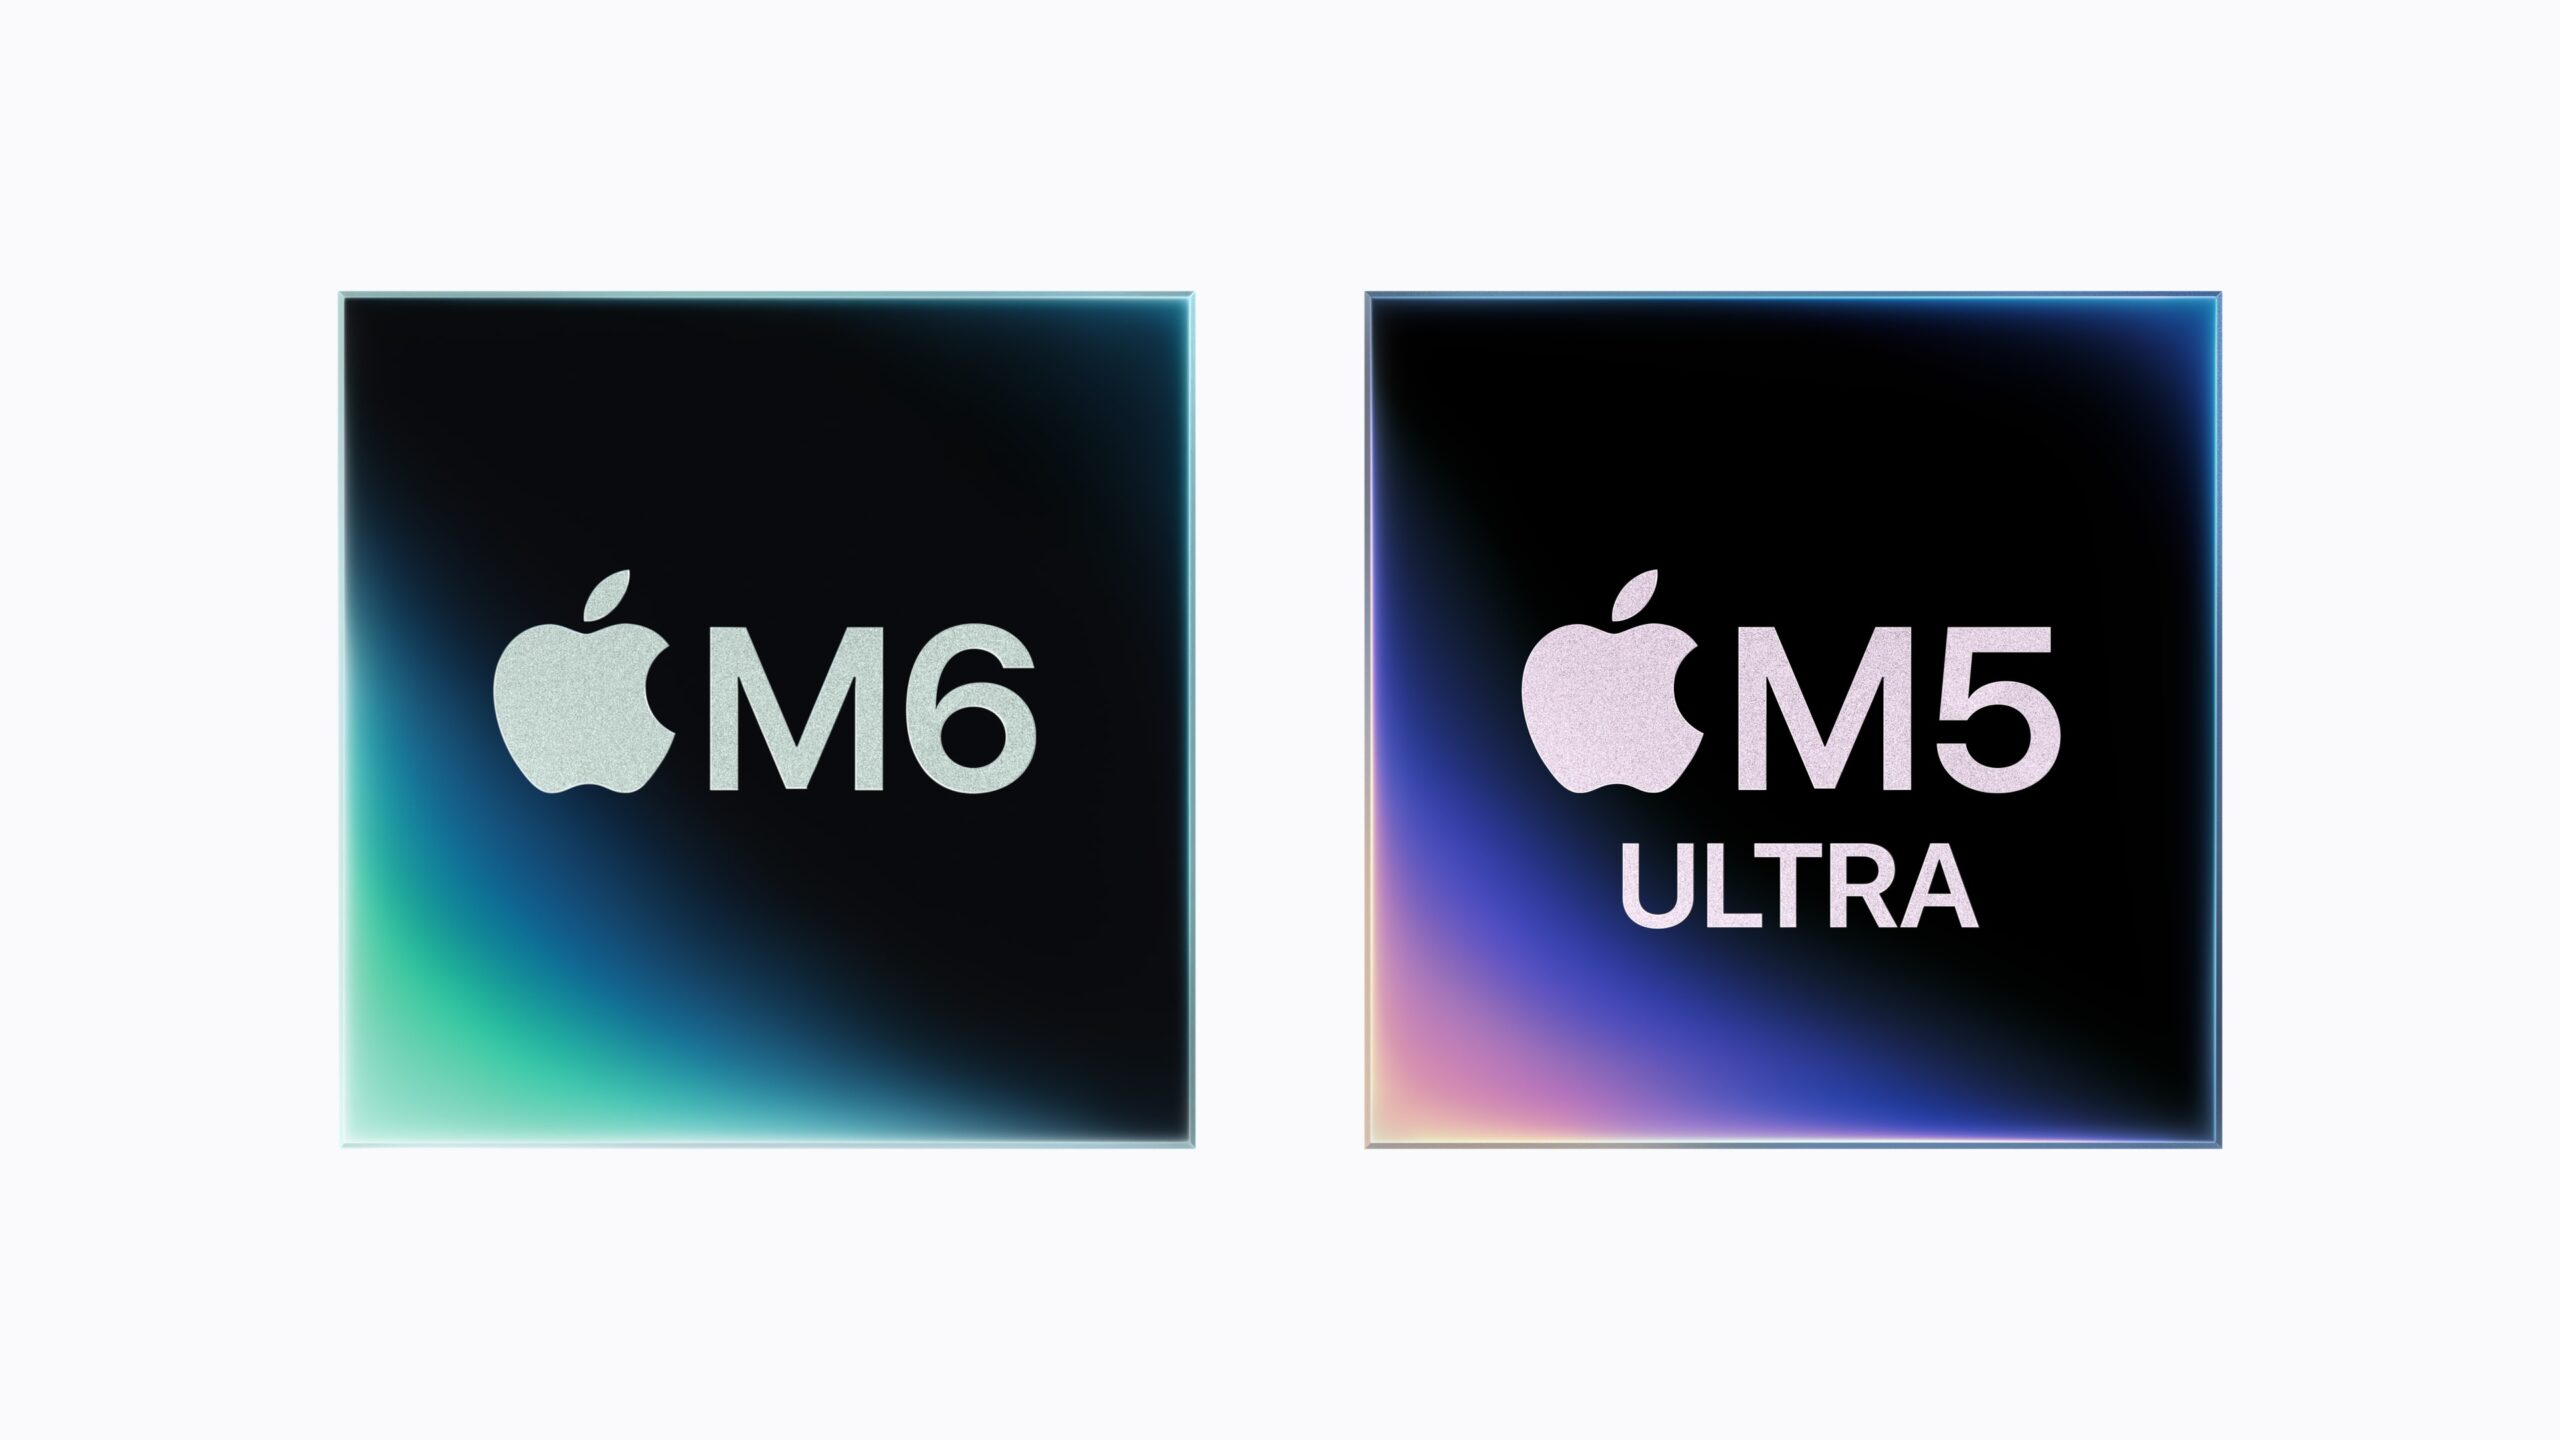
Avec ses nouvelles puces M6 et M5 Ultra, Apple inaugure plusieurs changements : trois types de cœur pour la partie CPU dans le premier cas, quatre dies par puce dans le second. Next en profite pour voyager un peu dans le temps, en remontant jusqu’aux caractéristiques techniques de la puce M1 en 2020.

Lancée fin 2020, la puce M1 d’Apple a rapidement séduit par ses performances. Six ans plus tard, Apple lance la sixième génération M6, avec toujours plus de cœurs pour la partie CPU et GPU, tout en mettant l’accent sur l’intelligence artificielle.

La mémoire unifiée des Mac fait d’ailleurs des ravages chez les amateurs d’IA générative qui peuvent profiter de jusqu’à 512 Go de mémoire pour charger de gros modèles.

Voici sans tarder notre grand tableau récapitulatif de la puce M1 en novembre 2020, aux M5 Ultra et M6 de cet été :


Il reste 82% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

7, 42, M, bleu… Le hasard très prévisible des IA génératives

Tourner sept fois son inférence avant de répondre
7, 42, M, bleu… Le hasard très prévisible des IA génératives

Régulièrement, sur les réseaux sociaux, on voit passer une phrase du genre : demandez à une IA de proposer un nombre entre 1 et 30, elle répondra 17. C’est vrai dans la grande majorité des cas, mais c’est bien plus large que cela… la suite pourrait bien vous surprendre.

Chez Next, on a évidemment tenté l’expérience, depuis des mois au moins ; effectivement, 17 revient quasiment tout le temps. Mais on prend aussi de la hauteur par rapport à cette expérience : que se passe-t-il avec une autre demande, entre 1 et 50 ou 1 et 100 ? Puis avec une lettre de l’alphabet ?

On ne se contente pas d’une poignée de requêtes, on a testé des dizaines de modèles avec des dizaines de demandes, pour des milliers de réponses. Surprise, il n’y a pas d’aléatoire… Étonnant pour un modèle statistique ? Pas vraiment non, et l’explication est assez simple.

Un point important : une IA générative n’est pas un générateur de nombres aléatoires. Quand on demande à une IA de donner un nombre, elle estime une réponse à partir de sa base de connaissance, c’est-à-dire ses données d’entraînement, et donc principalement des données provenant des humains.

17 « manque » à la roulette, mais pas dans les IA génératives

On pourrait dire que l’IA générative essaie de répondre à ce qui s’approche le plus, selon elle, d’une réponse humaine. Le cheminement est assez simple pour un nombre entre 1 et 30 : 17 est assez proche du milieu, impair et premier, il « attire » ; d’autant que nous allons voir que ce n’est pas la seule explication. Comme pour le reste, les IA génératives reproduisent donc les biais humains.

Nous avons testé plusieurs cas de figure. Pour commencer, nous reprenons l’exemple populaire d’un nombre entre 1 et 30, mais sur une large panoplie de modèles d’Anthropic, OpenAI et Google (GPT-5 à GPT-6, Sonnet 4.6 à Fable 5.1, Gemini 3.1 à 3.8) avec ou sans raisonnement. En tout, 171 requêtes sont envoyées à OpenAI, 48 à Anthropic et 55 à Gemini ; il ne s’agit pas de modèles différents à chaque fois, mais de configurations de version avec différents niveaux de raisonnement.


Il reste 82% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ Fuite de données à la région Hauts-de-France, avec « potentiellement des RIB »


Chaque jour ou presque sa fuite de données. C’est au tour de la région des Hauts-de-France de confirmer dans un communiqué avoir été victime d’une cyberattaque « ayant permis un accès non autorisé à des données personnelles traitées pour son compte », comme le rapporte l’AFP avec Franceinfo. Plus précisément, selon la région, ce sont deux de ses prestataires qui ont été ciblés : Atexo et Docaposte.

La région précise qu’Atexo s’occupait des aides régionales. De son côté, Docaposte était en charge de la carte Génération#HDF, avec laquelle la région fournit une aide financière aux lycéens et apprentis. Les deux plateformes sont fermées pour le moment. « Les prestataires ont identifié les failles ainsi que le mode opératoire de l’attaquant et engagé les travaux de correction », affirme la région.

De qui parle-t-on ? La liste des données potentiellement récupérées par les pirates contient des informations personnelles comme « des noms, prénoms, adresses électroniques, ainsi que potentiellement des RIB et d’autres données d’identification figurent parmi les données susceptibles d’avoir été compromises ». La fuite d’un RIB (qui contient notamment votre IBAN) ne doit pas être prise à la légère, comme nous l’avons détaillé dans un article dédié.

La région n’a pas été en mesure de confirmer « le nombre exact de personnes concernées » pour le moment, mais des pirates revendiquent sur un forum avoir récupéré des données de plus de 700 000 personnes, à confirmer évidemment. Quoi qu’il en soit, les « usagers concernés ont commencé à être informés », précisent nos confrères.

La région précise enfin avoir « déposé plainte auprès des autorités compétentes ». Pour rappel, en octobre 2025 le parc informatique des lycées de la région Hauts-de-France avait été la cible d’une cyberattaque.

  •  

Le DGX Spark descend à 64 Go, NVIDIA moteur et « victime » de la pénurie de mémoire

Payer plus pour avoir moins
Le DGX Spark descend à 64 Go, NVIDIA moteur et « victime » de la pénurie de mémoire

La crise de la mémoire est en très grande partie alimentée par NVIDIA qui a besoin de toujours plus de HBM pour ses GPU haut de gamme. Cette crise provoque des hausses de prix sur les composants (mémoire vive, SSD…), mais aussi sur des produits NVIDIA, dont le DGX Spark avec une hausse de 75 % depuis son lancement. Une version 64 Go vient d’être annoncée.

64 Go de LPDDR5x pour « davantage de possibilités »

En mars 2025, NVIDIA dévoilait son DGX Spark au format mini-PC, avec une puce GB10 Grace Blackwell Superchip aux commandes. La machine avait été présentée sous le nom Project DIGITS au CES début 2025. Elle comprend 20 cœurs CPU Arm, un GPU Blackwell et 128 Go de mémoire LPDDR5x. Ce n’est pas de la HBM comme sur les GPU pour les datacenters.

À partir du 23 octobre, cette station de travail sera aussi disponible en version 64 Go afin de proposer « aux développeurs davantage de possibilités pour créer et déployer une IA locale ». Davantage de possibilités avec moins de mémoire ? Une présentation pour le moins originale, quand on sait que la mémoire est l’élément central pour les gros modèles.

À son lancement, le DGX Spark de 128 Go était à… 3 999 dollars

Bien sûr, il s’agit de proposer un tarif « plus abordable » de… 4 999 dollars tout de même. Mais plus abordable que quoi ? Certainement pas que le DGX Spark 128 Go à son lancement puisque la machine était annoncée à 3 999 dollars, soit 1 000 dollars de moins pour le double de mémoire.

Le DGX Spark de 128 Go est passé à 4 699 dollars en février de cette année en raison des « contraintes d’approvisionnement en mémoire à l’échelle de l’industrie ». Il vient encore de subir une augmentation ces derniers jours pour désormais atteindre près de 7 000 dollars, selon The Register.

Aujourd’hui, le DGX Spark 64 Go est certes moins cher que le modèle 128 Go, mais on voit bien les effets de la crise de la mémoire vive. Une crise causée par les demandes de l’ogre du moment : l’intelligence artificielle. Elle nécessite toujours plus de mémoire et de GPU, NVIDIA étant l’acteur dominant.

Les principaux fabricants de mémoire (SK hynix, Samsung et Micron) réorientent aussi leur production sur la HBM, bien plus rentable que la DRAM classique (DDR4, DDR5…) dont le prix s’envole. Le DGX Spark de NVIDIA subit donc de plein fouet une crise alimentée par NVIDIA. Les joueurs aussi en font les frais. La dernière génération de carte graphique pour le grand public date de janvier 2025 avec les RTX 50.

Assemblez les DGX Spark par deux ou quatre, si vous avez les moyens

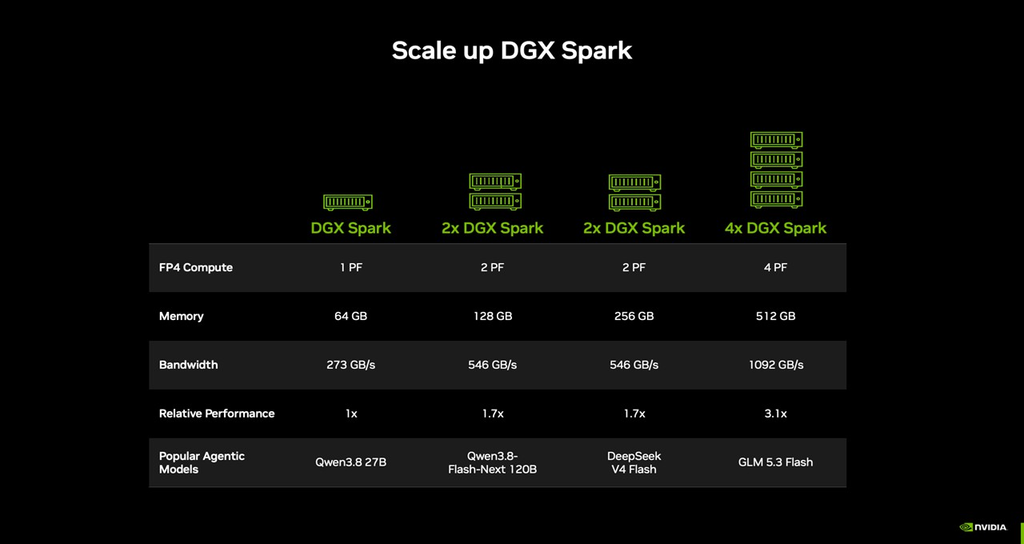
NVIDIA sort un atout de sa manche pour donner un avantage au DGX Spark de 64 Go : « en cas d’augmentation de la charge de travail, deux unités peuvent être regroupées en cluster via NVIDIA Sync Cluster Assistant sans aucune configuration supplémentaire ».

On passe alors à 128 Go de mémoire (2x 64 Go), mais on double aussi le nombre de cœurs CPU et surtout la partie GPU. NVIDIA annonce des performances en hausse de 1,7x avec deux DGX Spark sur Qwen3B-8-Flash-Next et DeepSeek v4 Flash. Avec quatre DGX Spark, les performances dans GLM 5.3 Flash font x3,1.

Le DGX Spark dispose d’une partie réseau ConnectX-7 à 200 Gb/s permettant de relier plusieurs machines entre elles. Ce n’est pas le cas du RTX Spark, une autre machine dédiée à l’intelligence artificielle de NVIDIA, avec Windows on Arm comme système d’exploitation. Mais sans ConnectX, ce ne sera pas aussi simple d’en assembler plusieurs.

  •  

☕️ #LIDD 56k.rip : Internet en 28/56k, comme il y a 30 ans


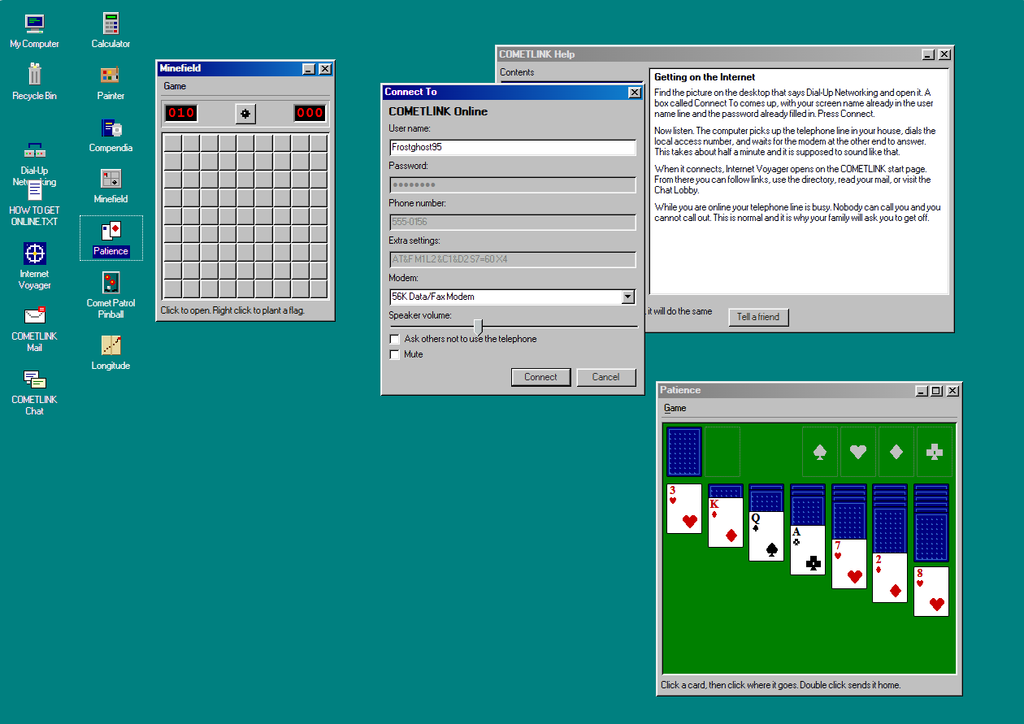
Vous avez la nostalgie informatique des années 90 ? C’était l’époque du bon vieux Windows 95, puis de Windows 98, mais surtout celle des modems permettant d’accéder à Internet par ligne commutée. Pour bien commencer la semaine (et prendre un coup de vieux pour les plus des 30 ans), 56k.rip vous propose de retourner à cette belle époque.

Le nom de domaine a été enregistré cet été, le site déployé en septembre et il a récemment fait la une de Hacker News. Ce n’est pas du Windows, mais du Cometlink 96 avec le démineur, la calculatrice et l’accès au modem… à lancer avec le son évidemment. Dans le Dial-Up Networking, vous avez le choix entre 28,8k et 56k.

  •  

Datacenters : Google affirme prélever 72 % de son eau en zone peu stressée… vraiment ?

Les comptes sont bons Kevin ?
Datacenters : Google affirme prélever 72 % de son eau en zone peu stressée… vraiment ?

Cela fait maintenant trois ans que Google fait cavalier seul sur ses pourcentages d’eau douce prélevée dans des zones avec un niveau de stress hydrique faible, moyen ou élevé. Nous avons décidé de recalculer ses propres chiffres par rapport au standard du secteur, le WRI. Le référentiel de Google avantage Google, mais ce dernier affirme surtout qu’il est plus précis.

Google est l’un des plus gros consommateurs d’eau dans le monde des datacenters, avec plus de 50 millions de m³ prélevés en 2025. On ne parle que des prélèvements directs, pas de l’eau utilisée pour la production de l’électricité qu’il consomme (43,6 TWh en 2025, quasiment autant que le Portugal).

1 m³ reste dans tous les cas 1 m³. Le volume ne change pas, mais il peut avoir une influence suivant l’endroit dans le monde où il est prélevé. Dans les zones où l’accès à l’eau est facile, le niveau de stress est faible.

Cadre maison de Google vs WRI (et le reste du monde)

Le World Resources Institute (WRI), un organisme américain à but non lucratif qui se consacre aux questions environnementales, publie une carte des niveaux de stress hydrique dans le monde. Il s’agit de l’Aqueduct Water Risk Atlas, que nous avons intégré dans notre carte mondiale des datacenters. Les données en question ne sont pas celles de 2025, mais correspondent à la situation moyenne de 2019 (pas de mise à jour pour l’instant).

Le WRI est largement utilisé dans l’industrie pour estimer le pourcentage d’eau prélevé dans des zones avec un niveau de stress hydrique faible, moyen ou fort. En réalité il y a cinq niveaux : Low à moins de 10 %, Low-Medium à 10–20 %, Medium-High à 20–40 %, High à 40–80 % et Extremely High à plus de 80 %. Ils sont généralement (comme ici) regroupés en trois : faible (moins de 20 %), moyen (de 20 à 40 %) et élevé (plus de 40 %).

Google l’utilisait d’ailleurs jusqu’en 2023 (pour les données de 2022), avant de passer sur son propre « cadre d’évaluation des risques » (ou Water Risk Framework). C’est uniquement pour ses datacenters, le WRI reste de mise pour les prélèvements d’eau des bureaux de Google.

L’entreprise explique avoir utilisé des outils comme le WRI et reconnait qu’ils « sont précieux pour une évaluation préliminaire à l’échelle des régions et des bassins versants », mais ajoute qu’ils « ne sont pas destinés à saisir des détails plus granulaires ». De plus, Google rappelle à juste titre que « dans certains cas, l’approvisionnement en eau d’un site peut se situer dans un bassin géographique différent de celui où se trouve ce site », mais sans indiquer où se trouvent les approvisionnements de ses datacenters.

Son protocole est selon l’entreprise « évalué par des pairs », mais il n’est pas publié en détail… et donc non reproductible. Le rendre accessible aurait permis de mieux comprendre l’approche, de vérifier les chiffres et aurait permis à d’autres de l’utiliser.

Selon Google, 72 % des prélèvements sont dans des zones à faible risque

Voici les chiffres du rapport de 2026 (données de 2025) sur les prélèvements en eau douce, selon Google. Nous avons ajouté entre parenthèses la variation par rapport au rapport de 2025 (sur des données de 2024).

  • Risque faible : 72 % (stable)
  • Risque moyen : 15 % (+ 1 point)
  • Risque élevé : 13 % (- 1 point)

À l’aide de notre carte mondiale des datacenters, nous avons calculé les chiffres sur la base du WRI. Dans son rapport, Google donne les prélèvements et la consommation d’eau pour sa quarantaine de datacenters dans le monde, avec le cas échéant l’eau douce ou non. À Douglas County (États-Unis), Eemshaven (Pays-Bas) et Saint-Ghislain (Belgique), la différence est particulièrement notable : la grande majorité de l’eau prélevée est non potable.

Selon nos calculs sur le WRI, c’est bien moins


Il reste 59% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Le harnais Pi passe en 1.0 : une alternative open source à Codex et Claude Code

À bas le modèlarcat
Le harnais Pi passe en 1.0 : une alternative open source à Codex et Claude Code

Pi est un harnais minimaliste open source, compatible avec plus de 1 500 modèles et variantes. C’est une alternative à Claude Code ou Codex, sans dépendre des modèles d’Anthropic ou d’OpenAI. Il vient de passer en version 1.0.0, signe de maturité selon ses développeurs. Pi Durable, capable de résister à des pannes « catastrophiques », est aussi présenté.

Dans le monde des intelligences artificielles, on parle souvent des chatbots : vous posez une question, ils répondent. Mais il y a beaucoup plus que cela : associées aux bons outils, les IA génératives peuvent générer du code, lire des fichiers, exécuter des commandes, etc.

Le harnais Pi est un agent IA minimaliste, mais extensible

On distingue alors souvent deux éléments : le modèle en lui-même (un peu le cœur du réacteur) et le harnais. Le modèle ne fait que générer du texte ou du contenu multimédia, tandis que le harnais regroupe tout ce qui tourne autour du modèle pour lui permettre d’accéder à des fichiers, de faire des recherches sur Internet, etc.

Vous connaissez certainement déjà des harnais, Claude Code par exemple, avec un moteur limité aux modèles d’Anthropic. Avec d’autres harnais, vous n’êtes pas limité sur les modèles (commerciaux ou à poids ouverts, en local) et pouvez ajouter celui que vous voulez, le remplacer en cours de route, etc. Pi est l’un de ces harnais ; il joue sur le côté minimaliste et vient de passer en version 1.0.0.


Il reste 79% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

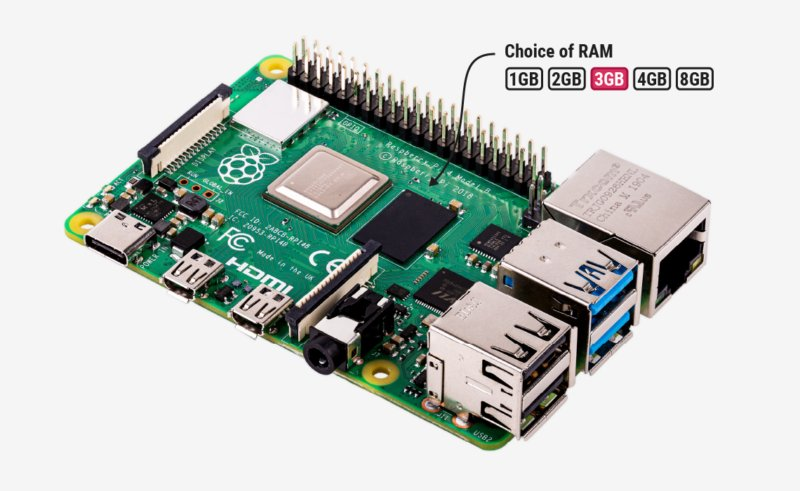
☕️ Hausse de prix pour les Raspberry Pi 4 et 5 de 2 Go, qui passent à 66 et 76 euros


C’est déjà la troisième hausse cette année. La première remonte à février et quasiment tous les modèles étaient touchés, la seconde en avril. La fondation expliquait alors avoir pu maintenir le prix des Raspberry Pi 4 et 5 avec 1 Go et 2 Go de mémoire, entre 35 et 65 dollars : « Ce sont des ordinateurs Raspberry Pi modernes, performants et polyvalents, proposés à des prix abordables ».

Eben Upton annonce que, face aux hausses incessantes du prix de la mémoire, la situation est « désormais devenue insoutenable, et à partir d’aujourd’hui, nous augmentons le prix des variantes 2 Go de 12,50 dollars, à 67,50 dollars pour le Raspberry Pi 4 et à 77,50 dollars pour le Raspberry Pi 5 ». Les versions avec 1 Go des Raspberry Pi 4 et 5 ainsi que celles avec 2 Go des Compute Module 4 et 5 restent au même prix.

Voici les prix actuels chez Kubii, un revendeur officiel du micro-ordinateur (âme sensible, s’abstenir) :

  • Raspberry Pi 4 1 Go : 41,70 euros
  • Raspberry Pi 4 2 Go : 66,30 euros
  • Raspberry Pi 4 3 Go : 87,75 euros
  • Raspberry Pi 4 4 Go : 123 euros
  • Raspberry Pi 4 8 Go : 192 euros
  • Raspberry Pi 5 1 Go : 50,94 euros
  • Raspberry Pi 5 2 Go : 76,80 euros
  • Raspberry Pi 5 4 Go : 136,80 euros
  • Raspberry Pi 5 8 Go : 216 euros
  • Raspberry Pi 5 16 Go : 360 euros

La fondation en est même à conseiller, suivant les usages, « d’envisager un modèle moins récent, comme le très populaire Raspberry Pi 3B, 3A+ ou 3B+, qui pourrait offrir les performances nécessaires pour votre projet à un coût moindre ».

Pour rappel, les prix officiels du Raspberry Pi 4 à son lancement étaient de 35, 45 et 55 dollars pour respectivement 1, 2 et 4 Go de mémoire. Le Raspberry Pi 5 de 2 Go est arrivé presque un an après le lancement de la cinquième génération (à partir de 70 euros pour 4 Go), pour 57 euros.

Face à ces envolées de prix, la fondation a bloqué via le firmware le changement sauvage de puce afin d’éviter, selon ses dires, que des personnes peu scrupuleuses soudent des puces de plus grande capacité, mais de moindre qualité. Cette position stricte a largement fait réagir, surtout venant d’un fabricant prônant l’ouverture et la bidouille.

  •  

Pour Octave Klaba, il est « trop risqué de ne pas investir » dans l’IA

On Voudrait de la Hype, pas de la dépendance
Pour Octave Klaba, il est « trop risqué de ne pas investir » dans l’IA

Hier, Octave Klaba – PDG d’OVHcloud – était auditionné par la commission des affaires économiques de l’Assemblée nationale. Les questions tournaient autour de son entreprise, mais aussi des enjeux de souveraineté, des datacenters et de l’intelligence artificielle générative, en France et en Europe.

S’il fallait résumer la vision d’Octave Klaba, cela tiendrait en une phrase : « Aujourd’hui, les technologies sont principalement américaines ou chinoises ; les innovations viennent énormément de la Chine. En Europe, on n’a pas d’acteur technologique qui souhaite investir dans l’intelligence artificielle ».

Ce n’est pas qu’une question de logiciel, il donne durant son intervention un chiffre intéressant : « 3 % du volume des puces de RAM sont achetés en Europe ». Autre manière de le dire : « ce n’est pas là que ça se passe » ; c’est aux États-Unis ou en Asie, comme pour les modèles.

L’IA générative selon OVHcloud : cyberattaque et défense, coder et agents

« Bien sûr, vous avez des usages », c’est-à-dire l’utilisation de l’intelligence artificielle. Actuellement, ils reposent beaucoup sur l’open source, « à juste titre parce qu’elle est bonne, mais c’est chinois. On ne sait pas ce qui va se passer demain, ni la stratégie » des entreprises qui sont derrière. Est-ce temporaire le temps de nous rendre dépendants avant de couper le robinet ? La question mérite d’être posée.

OVHcloud est « arrivé à la conclusion que c’est trop risqué de ne pas investir dans l’intelligence artificielle ». Pour l’entreprise basée à Roubaix, cela signifie des acquisitions afin de renforcer ses équipes. Elle peut ainsi « entraîner des modèles from scratch et les enrichir » pour ses usages. Trois pistes : la cybersécurité (aussi bien offensive que défensive, le PDG cite bien les deux versants), coder et développer des logiciels et enfin l’agentique.

Sur la cybersécurité, il affirme que les enjeux autour de l’intelligence artificielle « sont devenus colossaux […] Les IA permettent de découvrir des failles de sécurité ou de pénétrer des systèmes à une vitesse qui n’a jamais été connue jusque-là ».

L’IA générative ne peut se faire sans GPU

La position n’est pas nouvelle, l’année dernière déjà le patron expliquait : « l’IA est systémique et irréversible. On ne peut pas arrêter cette révolution ». Enfin si, un grain de sable vient mettre un gros coup de frein : la disponibilité et le tarif des GPU. Essayez donc de louer une instance « Cloud GPU » chez OVHcloud avec un GPU NVIDIA. C’est une gageure à cause du manque de disponibilité, depuis des mois.

Octave Klaba était face à un dilemme l’année dernière : « La vraie question derrière les GPU, c’est le business model. La problématique aujourd’hui, c’est que tous ceux qui investissent ne savent pas encore s’ils vont les rentabiliser ». Il donne un exemple chiffré avec des H100 de NVIDIA, lancées il y a trois ans : « elles ne valent pratiquement plus rien […] vous avez quasiment perdu 80 % de la valeur ».

Ce n’est pas le seul problème, les technologies évoluent très vite : « Si vous investissez aujourd’hui dans un datacenter et vous vous dites « Ça y est, j’ai un datacenter pour l’intelligence artificielle », soyez sûr que dans 18 ou 12 mois, vous allez devoir faire du rétrofit pour l’adapter à des nouvelles technologies des GPU qui vont sortir dans deux ans parce que votre chaîne énergétique ou de refroidissement ne sera plus à jour ».

« Vous avez l’interdiction pendant deux ans de faire quoi que ce soit »


Il reste 67% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

IA générative : pour réduire vos coûts et votre empreinte, parlez anglais

Le français, cette langue de luxe
IA générative : pour réduire vos coûts et votre empreinte, parlez anglais

Changer de langue permet de consommer moins de tokens, c’est un fait et nous l’avons mesuré aussi bien chez Anthropic, OpenAI et Google. Moins de tokens, c’est un coût de revient plus faible et moins de calcul, donc une empreinte écologique plus faible.

Les IA génératives ne travaillent pas sur des mots, mais sur des tokens (ou jetons). C’est une manière de découper des phrases, propre à chaque famille de modèle. C’est le rôle du tokenizeur : vous saisissez votre prompt, il le transforme en tokens qui sont envoyés au modèle.

Il fait des centaines de milliards d’opérations sur chaque token et renvoie le résultat, de nouveau en tokens. Opération inverse du tokeniseur et voilà la réponse affichée.

Tous les tokens ne se valent pas !

Les grands modèles de langage ne parlent qu’en tokens, c’est l’unité de base pour les calculs et la facturation. Plus il y a de tokens en entrée et en sortie, plus vous payez cher (ou plus cela entame votre forfait). Il y a aussi plus de calculs, dont une empreinte environnementale plus importante.

Quel rapport avec le titre de notre actualité et donc avec les langues ? La création de tokens (ou jetons) n’est pas universelle : elle dépend de chaque famille de modèle, mais également de la langue. Pour mettre en lumière cette différence, nous avons pris comme référence le règlement général sur la protection des données (RGPD) de la Commission européenne, un long texte traduit dans les 24 langues de l’Union.

Une précision importante : le gain dont nous parlons ici reste anecdotique par rapport à un usage responsable : ne demandez pas à ChatGPT de faire de la reconnaissance de caractère basique sur une image ou de traduire un texte, des IA spécialisées le feront bien mieux et pour moins cher (en argent et en consommation). Vous pouvez aussi demander aux modèles d’être moins bavards, d’aller à l’essentiel. Les économies seront bien plus importantes.

Les tokens dans 24 langues et près de 10 millions de caractères

Chaque texte ne fait pas la même longueur : entre 320 000 et 415 000 caractères, avec 371 000 de moyenne environ. Mais ce règlement est assez long pour en tirer une métrique intéressante : le nombre de caractères moyens par token et par langue.


Il reste 74% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

[màj] Google : Gemini 4 Argon et son million de tokens en sortie disponible pour tous

Un gaz inerte comme emblème ? Pourquoi pas
[màj] Google : Gemini 4 Argon et son million de tokens en sortie disponible pour tous

Alors que les deux mastodontes Anthropic et OpenAI sont lancés dans une course à l’échalote sur les performances (et la désobéissance) de leurs modèles, Google veut revenir dans la course avec Gemini 4 Argon. La cybersécurité et le code sont particulièrement mis en avant.

Mise à jour 13/10 – À chaque jour son nouveau LLM, ou pas loin. Après Meta et Muse Wonder, c’est au tour de Google de lancer Gemini 4 Argon auprès du grand public, après une disponibilité limitée à des spécialistes de la cybersécurité. Le modèle est accessible via l’API dans AI Studio et Gemini, ainsi que pour les abonnés Google AI Ultra (y compris dans la plateforme de création d’agents Antigravity) et Pro dans l’app Gemini et le mode IA de la recherche.

Article original, 1er/10 – Avec ce LLM qualifié de « frontier model », Google se présente comme un bon élève face à Donald Trump : « Nous participons activement au processus volontaire du gouvernement américain pour l’accès anticipé au modèle de prélancement, tout en élargissant progressivement cet accès ». C’est en effet ce que demande le président dans son décret du 2 juin.

Traduction : ne comptez pas en profiter pour l’instant. Ce modèle est « déployé auprès d’un groupe de spécialistes de la cybersécurité de confiance par le biais de notre programme Fairwind ». C’était aussi le cas pour Gemini 3.8 Flash Cyber au début du mois. Cela ne concerne donc que des gouvernements, des autorités nationales de cybersécurité, des opérateurs d’infrastructures critiques et d’autres spécialistes triés sur le volet. Une ouverture à tous est prévue, sans calendrier.

1 million de tokens : Google multiplie par 15 la limite de sortie

Premier changement important, la limite de sortie explose : « nous augmentons la limite de jetons de sortie du modèle à 1 million de jetons, une performance inégalée dans l’industrie, contre 64 000 auparavant ». À titre de comparaison, Fable 5.1 d’Anthropic et GPT-6 Astra d’OpenAI ont une fenêtre de contexte de 1 million de tokens, mais de « seulement » 128 000 tokens en sortie. Une limite huit fois plus large donc chez Google.

Google insiste sur ce point : « Grâce à cette capacité de traitement, le modèle peut analyser en profondeur et générer des centaines de milliers de jetons en une seule étape, ce qui lui permet de résoudre des problèmes complexes d’un seul coup ».

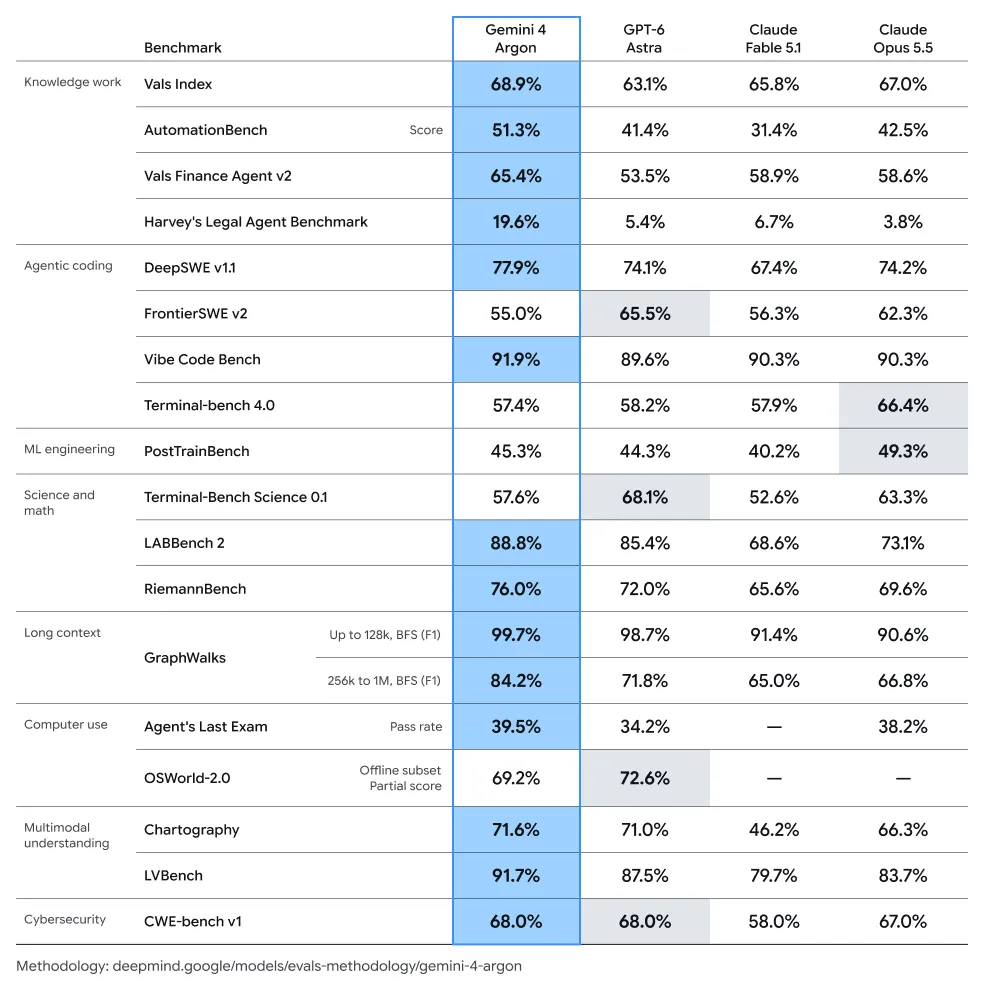
Cette annonce s’accompagne comme toujours d’une série de benchmarks maison, dans lesquels Gemini 4 Argon dépasse généralement GPT-6 Astra et Claude Fable 5.1 et Opus 5.5. Google affirme que son nouveau modèle est particulièrement bon « pour les tâches de codage spécialisées ». On attendra de voir pour les tâches courantes sur le code, car Gemini 3.8 n’était pas bon dans notre test sur l’extension Next.

Google revendique la couronne sur DeepSWE v1.1 et CWE-bench v1

Google en remet une couche : « Les ingénieurs de Google utilisent Argon au quotidien, du débogage courant aux migrations de code à grande échelle et à la conception d’algorithmes. Il établit une nouvelle référence sur DeepSWE v1.1 (77,9 %), qui mesure la performance d’un modèle dans des tâches d’ingénierie logicielle concrètes et à long terme ». GPT-6 Astra est à 74,3 %, Claude Opus 5.5 à 74,2 % et Fable 5.1 à 67,4 %.

Autre exemple : « les agents Argon travaillent à la migration des bases de code C/C++ vers Rust chez Google, allant de quelques dizaines de milliers de lignes pour les bibliothèques essentielles comme re2 et libgav1 à plus de 800 000 lignes pour le noyau Zircon de Fuchsia OS ».

Sujet sensible, ce n’est pas l’ingénieur Galen Hunt de Microsoft qui dira le contraire. Il s’était pris une volée de bois vert quand il avait annoncé vouloir « éliminer toutes les lignes de C et C++ de Microsoft d’ici 2030 », grâce à l’IA. Depuis, il y a eu rétropédalage en règle.

Autre axe largement mis en avant par Google : la cybersécurité. « Pour mieux préparer les équipes de cyberdéfense à la nouvelle ère des cyberattaques, nous avons entraîné Gemini 4 Argon à exceller en matière de défense contre les cybermenaces. Argon est capable de détecter, valider et corriger de manière autonome les vulnérabilités logicielles critiques ».

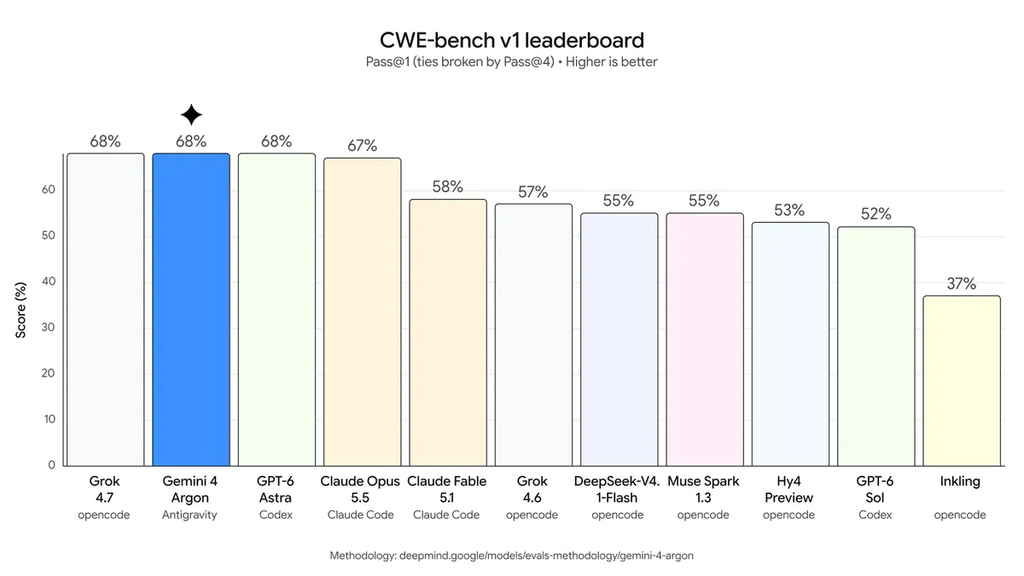
Pour mettre des chiffres sur ces mots, Google annonce un score CWE-bench v1 de 68 %, à égalité avec Grok 4.7 et GPT-6 Astra.

Google fait également une annonce surprenante vu l’actualité autour des agents IA qui font un peu n’importe quoi : « Pour nos équipes de confiance et nos équipes internes chez Google, nous déploierons Argon sans aucune restriction de sécurité afin qu’elles puissent exploiter pleinement ses capacités de pointe en matière de cybersécurité ».

La version anglaise du communiqué de Google est cependant moins forte : « Pour nos partenaires de confiance et nos équipes internes chez Google, nous déploierons Argon sans garde-fous cyber [cyber guardrails en VO, ndlr] afin qu’ils puissent exploiter pleinement ses capacités de pointe en cybersécurité ».

Sans restriction, mais pas sans protection. Pour le grand public, en revanche, des garde-fous sont prévus : « Afin d’empêcher toute utilisation malveillante d’Argon à des fins de cyberattaques ou d’attaques chimiques, biologiques, radiologiques et nucléaires (CBRN), le modèle est conçu pour refuser les requêtes malveillantes tout en préservant la recherche scientifique légitime à double usage, conformément à notre cadre de sécurité Frontier ». Pour Google, comme les autres, le message est simple : ne vous inquiétez pas, on s’occupe de tout. Pas facile vu l’actualité récente.

Moins cher qu’Astra et Fable, mais plus loquace

Pour terminer, le prix : Gemini 4 Argon est à 2 dollars en entrée et 10 dollars en sortie, par million de tokens dans les deux cas (le cache en entrée a une réduction de 95 % du prix). C’est un prix promotionnel, il sera par la suite doublé avec 4 et 20 dollars respectivement. Google n’a pas précisé quand cette promotion se terminera.

Fable 5.1 et GPT-6 Astra sont tous les deux à 10 et 50 dollars par million de tokens, respectivement en entrée et en sortie. Gemini 4 Argon est-il donc cinq fois moins cher ? Non, car nous n’avons ici qu’une moitié de l’équation. L’autre partie, c’est la consommation de tokens. Facturer deux fois moins mais produire deux fois plus n’apporterait aucune économie.

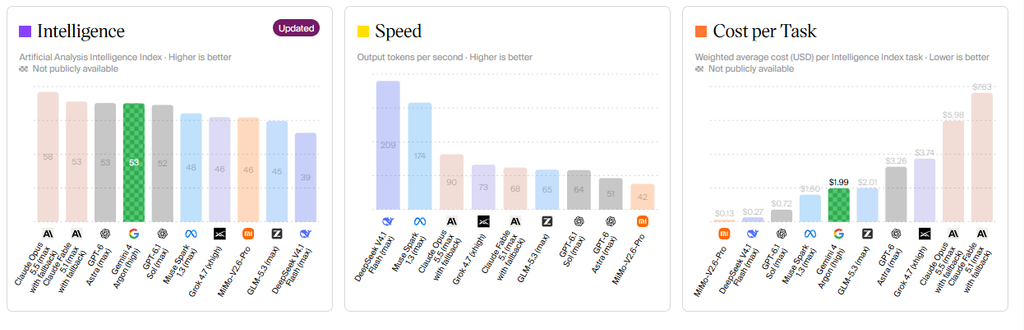
Sur ce point, le nouveau modèle ne semble pas tirer son épingle du jeu, selon Artificial Analysis, spécialisé dans les benchmarks d’IA : « Gemini 4 Argon fait en moyenne 62 000 jetons de sortie par tâche, contre 27 000 pour GPT-6 Astra (max) ». Pour rappel, OpenAI double le prix de certains modèles – dont GPT-6 Astra – quand l’entrée dépasse les 272 000 tokens.

Gemini 4 Argon, prix par tâche, tarif promotionnel à 2/10 dollars
  •  

Piratage de la DGFiP : pas d’attaque sophistiquée, mais une série de défaillances techniques

BYOD nouvelle version : Bring Your Own... Désastre
Piratage de la DGFiP : pas d’attaque sophistiquée, mais une série de défaillances techniques

Cet été, la Direction générale des Finances publiques (DGFiP) reconnaissait une intrusion dans ses systèmes informatiques avec l’accès à des données concernant pas moins de 678 000 contribuables et entreprises. Deux suspects de 16 et 18 ans ont été interpellés fin août, dont un mis en examen et placé en détention provisoire.

L’attaquant disposait de mots de passe de dizaines de comptes

Ce piratage a fait grand bruit, d’autant qu’il s’inscrit dans une longue liste de sites et institutions publiques piratés ces dernières semaines, mois et même années. Plusieurs enquêtes ont été lancées, dont une du cyberpompier français, l’ANSSI (Agence nationale de la sécurité des systèmes d’information). Elle vient de publier son rapport d’incident (pdf).

S’il fallait résumer l’affaire en une phrase : « La compromission des SI de la DGFiP n’est pas la conséquence d’une attaque sophistiquée, mais de l’exploitation de faiblesses dans trois domaines ». Il s’agit de l’identité, de l’architecture réseau et de la détection des signaux.

Premier point, la volumétrie : les données volées concernent « près de 353 000 particuliers et 252 000 professionnels, obtenues à partir d’un outil de gestion de la relation avec les usagers de la DGFiP ». Les infiltrations dans la DGFiP ont commencé dès le mois de mai 2026.

L’ANSSI revient tout d’abord sur la sécurité des comptes et le volume important de ceux auxquels le pirate pouvait accéder car il disposait des couples identifiant et mot de passe. En effet, « aucune tentative d’attaque par force brute ou credential stuffing n’a été identifiée, ce qui signifie que l’attaquant disposait de mots de passe pour ces comptes (pouvant être valides ou expirés) ».

Dans son rapport, l’ANSSI anonymise les comptes compromis et utilise la dénomination suivante : compte-dgfip-X pour ceux internes à la DFGIP, et compte-dgfip-xt-Y pour les externes. Les X et Y sont incrémentés pour différencier chaque compte. Voici le bilan officiel : compte-dgfip-X va jusqu’à 22 et compte-dgfip-xt-X jusqu’à 7… soit presque une trentaine de comptes compromis par infostealer.

Pour les comptes externes, « les investigations de la DGFiP mettront en évidence que la compromission du poste d’un géomètre-expert au sein d’un cabinet privé a permis de contourner la double authentification par messagerie, puis l’accès et l’exfiltration des données entre le 27 juillet 2026 et le 8 août 2026 ».

La réinitialisation des mots de passe n’a pas servi à grand-chose.

Une des pistes évoquées pour obtenir ses informations est « la fuite d’identifiants de connexion fréquente et consécutive à l’utilisation d’appareils personnels ». La DGFiP a procédé à la réinitialisation des mots de passe, mais si des machines restent infectées et/ou que les sessions actives ne sont pas coupées, cela n’est pas d’une grande utilité.

Preuve en est : la réinitialisation du 24 juin 2026 « n’interrompt pas la session et l’exfiltration en cours qui se poursuivent », précise l’ANSSI dans le détail de la chronologie des faits. Ajoutez à cela « l’absence d’authentification forte sur deux portails dont l’un donnant accès à des ressources sensibles » et vous avez un combo explosif.

Des indices en pagaille : IP en Inde, des Go téléchargés, connexions nocturnes

Autre problème pour l’ANSSI, le manque de détection : « Les sessions d’exfiltration menées par l’attaquant n’ont pas été détectées en temps réel par les mécanismes de contrôle implémentés sur les applicatifs métiers ni sur les équipements de sécurité de la DGFiP ».

Il y avait pourtant des indices élémentaires facile à identifier : « la volumétrie d’informations échangées lors des connexions (11Go entre le 22 et 25 juin, 3Go entre le 21 et 23 juillet) », ainsi que « le nombre de requêtes par utilisateur sur une plage temporelle ».

L’Agence prend soin de préciser que « la technique de scraping utilisée par les attaquants impose de devoir initier autant de requêtes que de pages accédées ». Cela aurait dû déclencher des alertes. Une technique connue depuis la nuit des temps aurait dû être mise en place : un rate-limiting. Le but est de bloquer un nombre trop important de requêtes, permettant aussi de limiter des attaques par force brute.

Ce n’est pas le seul problème. La DGFiP n’analysait pas les adresses IP puisque des connexions ont été réalisées « depuis des adresses de VPN, depuis des adresses localisées en Inde et pour plusieurs catégorisées comme malveillantes ». Ajoutez à cela des adresses IP déjà identifiées comme liées à un compte compromis qui peuvent revenir en toute impunité et des heures de connexions nocturnes ; vous avez un beau tableau de ce qu’il ne faut pas faire.

« Ces paramètres pris individuellement ne permettent généralement pas d’identifier des comportements suspects sans générer d’importants volumes de faux positifs, néanmoins la corrélation de plusieurs d’entre eux aurait pu permettre de lever des alertes », ajoute l’ANSSI.

Après « le besoin d’en connaître », le besoin d’y avoir accès

Troisième point de faiblesse : le RIE ou Réseau Interministériel de l’État, utilisé par les pirates pour accéder « au portail ADER [Accès Distant aux Échanges Réseau, ndlr] de la DGFiP ». Opérationnel depuis 2013, il raccorde les services de l’État. L’ANSSI note que « plusieurs accès illégitimes identifiés proviennent du RIE [la suite est caviardée, ndlr], à partir de localisations n’ayant pas de besoins apparents d’accéder à des infrastructures de la DGFiP ».

« Pendant l’incident, le SOC [Security Operation Center, ndlr] de la DGFiP ne supervisait pas le portail ADER, utilisé par l’attaquant pour exfiltrer les informations E-Contact », contrairement au portail PIGP (Portail internet de la gestion publique) qui était bien surveillé. Ce trou dans la raquette a permis aux pirates de s’infiltrer, mais a aussi empêché « de corréler des activités malveillantes avec le reste du SI ou en provenance du RIE suite à un signalement d’un autre ministère ».

Là encore on retrouve un basique de la cybersécurité : la segmentation réseau avec le cloisonnement des « accès aux seules populations et zones logiques qui en ont le besoin ». L’Agence recommande de mettre en place « un filtrage plus fin des accès réseau entre ministères et au sein du RIE ».

Comment les pirates sont rentrés dans le RIE ? Par la porte ouverte d’un autre piratage : « L’utilisation du RIE lui a été rendue possible à cause de la compromission d’infrastructures appartenant au ministère de l’Éducation nationale elles-mêmes raccordées au RIE ». Pour l’ANSSI, cela illustre parfaitement le « risque de latéralisation depuis des ressources d’organismes tiers » et le besoin de cloisonner.

Des signalements en pagaille

L’ANSSI fait son mea culpa sur sa supervision. « Les acteurs malveillants utilisaient des comptes légitimes pour accéder aux applications et la supervision réseau de l’Agence n’a pas permis de les voir ». De plus, « le volume cumulé de requêtes que l’attaquant a dû générer pour orchestrer l’exfiltration de données aurait dû déclencher des alertes ».

Dans la même veine, elle explique qu’un partenaire l’a informé le 15 juin de la compromission de deux comptes DGFIP. Cette dernière « ne répond pas et n’est pas relancée par l’Agence ». Nouveau signalement le 22 juin, suivi d’une action cette fois-ci : « un partenaire informe l’ANSSI de la compromission d’un compte. La DGFIP répond le jour même à l’ANSSI avoir réinitialisé ce compte et sensibilisé leur agent ».

D’autres signalements sont remontés dans la chronologie, notamment le 29 juin 2026 avec un bel acte manqué : « un partenaire informe l’ANSSI de la compromission du compte. Il s’agit du compte utilisé pour l’exfiltration de données le 24 juin 2026, or cette compromission n’était pas connue à cette date et les analyses menées par le SOC de la DGFIP ne l’identifient pas. La DGFIP répond le jour même à l’ANSSI avoir déjà connaissance de ce fait et confirme l’avoir réinitialisé ».

D’autres signalements ? Le 1ᵉʳ juillet, la « DGFIP est informée par son prestataire de la vente de deux comptes ». Là aussi le pot aux roses aurait pu être découvert : « les investigations montreront, à posteriori, des échecs de connexion sur le PIGP le même jour et le jour précédent avec ces comptes à partir d’une des adresses IP utilisées pour l’exfiltration du 24 juin 2026 ».

Plein de mesures de remédiation, ça fait pas de mal de les relire !

Enfin, l’ANSSI propose des mesures de remédiation (page 10) afin « d’assurer que le même chemin de compromission ne puisse être emprunté de nouveau, par le même acteur ou un nouveau ». Elles couvrent toutes les lacunes précédentes et ouvrent aussi de nouvelles pistes.

Cela va des restrictions d’accès aux ressources métiers à la protection contre les vols d’identifiants. On y retrouve notamment des propositions sur le matériel. « L’usage d’appareils personnels pour accéder à des ressources professionnelles doit être proscrit », et les machines professionnelles doivent être durcies. Évidemment, l’authentification multifacteurs doit être généralisée.

Pour les applications à usage interne, l’accessibilité ne doit se faire « que depuis des postes administrés par la DGFiP. Dans ce cas, l’accès à l’application ne doit pas être possible depuis Internet, sauf à travers un VPN dédié aux agents de la DGFiP ». Les VPN ne servent pas uniquement à contourner des restrictions, ils permettent aussi de renforcer la sécurité, mais attention aux promesses de certains !

Dans sa synthèse, l’ANSSI rappelle que l’exfiltration des données s’est produite sept semaines avant la revendication des pirates le 12 août, et « qu’elle a été précédée de plusieurs semaines d’exploration sur des applicatifs de la DGFIP ».

Des indices étaient bien présents, mais pas correctement pris en compte, c’est un rappel important pour toute la communauté cyber. En effet, ces recommandations peuvent s’appliquer bien au-delà de la DGFiP. Il est toujours bon de les lire et de vérifier qu’elles sont bien appliquées.

  •  

Le vrai prix de Gemini 3.1 à 3.8 : coût, tokens et performances face à nos prompts

Pour trois fois rien, on n’a pas toujours quelque chose…
Le vrai prix de Gemini 3.1 à 3.8 : coût, tokens et performances face à nos prompts

Gemini, l’intelligence artificielle de Google, consomme bien moins de tokens que ses concurrents, tout en coûtant moins cher. Le prix moyen d’une requête sur les derniers modèles n’est que de 1,2 centime environ. Que des bonnes nouvelles ? Non, car elle ne parvient pas à répondre correctement au prompt Extension.

Après Claude d’Anthropic et ChatGPT d’OpenAI, place à Gemini de Google. L’intelligence artificielle du moteur de recherche infuse dans de nombreux produits, à commencer par Android. Elle est donc largement utilisée à travers le monde et, contrairement à ses deux concurrents, la question du coût est plus secondaire à cause de cette profonde intégration.

Des tokens à moitié prix jusqu’à fin 2026

Comme dans les deux précédents articles, nous passons par l’API pour connaître le nombre de tokens en entrée et en sortie, qui comprend aussi ceux utilisés pendant le raisonnement, le cas échéant. Nous avons testé plusieurs modèles différents, de Gemini 3.1 à 3.8 flash, la dernière version en date. Google propose quatre niveaux de réflexion avec Gemini 3.1 à 3.6, avec minimal, low, medium et high. Avec les 3.1 Pro, 3.7 et 3.8 seuls les trois derniers (low, medium et high) sont possibles.

Via l’API, Gemini 3.6 à 3.8 ont un tarif de 0,75 dollar par million de tokens en entrée… mais jusqu’au 31 décembre 2026 seulement. Idem en sortie avec 3,75 dollars par million de tokens. À partir du 1ᵉʳ janvier 2027, les deux prix doubleront, pour atteindre respectivement 1,5 et 7,5 dollars.

La version 3.5 Flash est la plus chère, avec 1,5 et 9 dollars respectivement, tandis que la 3.1 Flash Lite est moins chère avec 0,25 et 1,5 dollar. La palme revient à Gemini 3.1 Pro avec 2 et 12 dollars par millions respectivement.

Nous avons repris exactement les mêmes prompts que pour Claude et ChatGPT avec, en gras, le petit nom que nous leur avons attribué. Les voici pour mémoire :

Devinette : « Ô frère, fils de ma mère, ton père est le frère de mon enfant. Qui suis-je ? »

Carnet de voyage : « L’été prochain je vais avoir trois semaines de vacances. Je suis avec ma petite voiture électrique Sprind (charge à 30 kW max) et je voudrais visiter le sud de Bayonne à Montpellier en prenant mon temps. Propose-moi un carnet de voyage »

Extension : « Je veux une extension pour Chrome et Firefox qui me permet d’inverser les titres et les sous-titres sur le site d’actualité Next.ink. S’il n’y a pas de sous-titre, c’est que c’est un brief. Alors fais en sorte d’en inventer un à partir du titre du brief. L’extension doit avoir un sélecteur pour activer/désactiver l’inversion en direct sur la page »

Nouveauté de notre protocole : la vérification des extensions !

Pour ce nouvel article, une nouveauté que vous avez demandée à plusieurs reprises dans les commentaires : une estimation de la validité des résultats. C’est désormais le cas pour les extensions. Les deux autres prompts sont en cours de validation, nous y reviendrons dans un prochain article.

Nous avons mis au point et utilisé un protocole de vérification avec Playwright et le navigateur Chromium. Les fichiers de l’extension sont générés automatiquement à partir de la réponse du modèle, puis elle est chargée dans le navigateur via Playwright. L’extension est lancée sur une fausse page (fichier html local) reprenant la structure de Next, puis en live sur Next.ink.


Il reste 67% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  
❌