❌

Vue lecture

Face aux chansons générées par IA, Sony Music multiplie les demandes de retrait

Faux tubes, vrais retraits
Face aux chansons générées par IA, Sony Music multiplie les demandes de retrait

Sony Music prend le taureau par les cornes pour lutter contre les streams illégaux de chansons générées par IA. Fin septembre, la major a demandé aux plateformes le retrait de plus de 260 000 morceaux, un volume multiplié par deux par rapport aux trois premiers mois de l’année.

« Nous continuerons à faire respecter les droits de nos artistes et nous attendons des plateformes qu’elles agissent rapidement et empêchent la réapparition des mêmes contenus », a affirmé Sony Music au Financial Times. « Mais la tâche devient de plus en plus difficile », ajoute l’entreprise, une des trois majors de l’industrie du disque avec Universal (UMG) et Warner (WMG).

Le groupe a demandé aux plateformes de streaming de retirer plus de 260 000 morceaux fin septembre, alors que ce volume avait été de 135 000 fin mars. Ces titres sont des deepfakes générés par IA d’artistes signés par Sony (Adele, Queen, Michael Jackson…). Le phénomène prend « une ampleur considérable, porte préjudice aux artistes, trompe les fans et compromet une utilisation éthique de l’IA », précise la maison de disques.

Les bots écoutent les bots

Les services de streaming sont noyés sous les chansons générées par IA. Deezer avait ainsi indiqué qu’elles représentaient plus de la moitié des nouveaux morceaux téléversés en juillet. Ces titres sont très peu écoutés, et quand ils le sont, c’est souvent lié à des cas de fraude aux streams. Des bots « écoutent » ces chansons, ce qui en retour génère des revenus pour les fraudeurs, spoliant au passage les artistes légitimes.

Le rapport semestriel de la Sonic Intelligence Academy publié le mois dernier montre que plus de 9 chansons sur 10 (92,8 %) des morceaux soumis avaient été générés par Suno. Avec cette nuance : le pourcentage porte sur l’échantillon de l’étude, soit 1 743 titres provenant de 886 artistes dans 54 pays. Sur cet échantillon, 77,6 % ont été distribués aux plateformes par DistroKid, un distributeur payant permettant à ses clients d’être diffusé sur plus de 150 plateformes. Ces chiffres donnent toutefois une petite idée de la provenance de ces titres.

Sony Music et Universal poursuivent d’ailleurs Suno en septembre. La start-up est accusée d’avoir copié des enregistrements sans autorisation pour entraîner ses modèles IA. DistroKid est aussi la cible d’UMG, qui a porté plainte contre le distributeur le 15 septembre (PDF). Ce dernier se serait livré à « des pratiques commerciales trompeuses et à des violations flagrantes du droit d’auteur ». Plus précisément, DistroKid aurait contribué « à faire passer les morceaux IA pour ce qu’ils ne sont pas, et à en tirer profit ».

La riposte contre la fraude aux streams s’organise dans la filière, qui a couché sur le papier un ensemble de pratiques pour aider les acteurs du secteur – en particulier les distributeurs – à prévenir, détecter et traiter la fraude.

De leur côté, les plateformes ont mis en place des systèmes de badges pour indiquer aux auditeurs que tel artiste ou telle chanson est générée par IA. Bien souvent, les écoutes de ces morceaux sont démonétisées dès leur mise en ligne.

  •  

7, 42, M, bleu… Le hasard très prévisible des IA génératives

Tourner sept fois son inférence avant de répondre
7, 42, M, bleu… Le hasard très prévisible des IA génératives

Régulièrement, sur les réseaux sociaux, on voit passer une phrase du genre : demandez à une IA de proposer un nombre entre 1 et 30, elle répondra 17. C’est vrai dans la grande majorité des cas, mais c’est bien plus large que cela… la suite pourrait bien vous surprendre.

Chez Next, on a évidemment tenté l’expérience, depuis des mois au moins ; effectivement, 17 revient quasiment tout le temps. Mais on prend aussi de la hauteur par rapport à cette expérience : que se passe-t-il avec une autre demande, entre 1 et 50 ou 1 et 100 ? Puis avec une lettre de l’alphabet ?

On ne se contente pas d’une poignée de requêtes, on a testé des dizaines de modèles avec des dizaines de demandes, pour des milliers de réponses. Surprise, il n’y a pas d’aléatoire… Étonnant pour un modèle statistique ? Pas vraiment non, et l’explication est assez simple.

Un point important : une IA générative n’est pas un générateur de nombres aléatoires. Quand on demande à une IA de donner un nombre, elle estime une réponse à partir de sa base de connaissance, c’est-à-dire ses données d’entraînement, et donc principalement des données provenant des humains.

17 « manque » à la roulette, mais pas dans les IA génératives

On pourrait dire que l’IA générative essaie de répondre à ce qui s’approche le plus, selon elle, d’une réponse humaine. Le cheminement est assez simple pour un nombre entre 1 et 30 : 17 est assez proche du milieu, impair et premier, il « attire » ; d’autant que nous allons voir que ce n’est pas la seule explication. Comme pour le reste, les IA génératives reproduisent donc les biais humains.

Nous avons testé plusieurs cas de figure. Pour commencer, nous reprenons l’exemple populaire d’un nombre entre 1 et 30, mais sur une large panoplie de modèles d’Anthropic, OpenAI et Google (GPT-5 à GPT-6, Sonnet 4.6 à Fable 5.1, Gemini 3.1 à 3.8) avec ou sans raisonnement. En tout, 171 requêtes sont envoyées à OpenAI, 48 à Anthropic et 55 à Gemini ; il ne s’agit pas de modèles différents à chaque fois, mais de configurations de version avec différents niveaux de raisonnement.


Il reste 82% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ Apple annonce un renforcement des autorisations d’accès au disque dans macOS


Le 2 octobre, Apple a fait savoir par une courte note destinée aux développeurs que des changements allaient être introduits pour renforcer l’accès complet au disque dans macOS.

L’entreprise indique que de nombreux contrôles ont été mis en place avec le temps sur son système, mais que l’autorisation d’accès complet au disque permet largement de les contourner. Le fonctionnement était voulu pour « permettre aux applications de sauvegarde de fonctionner correctement sur Mac ».

Cependant, des « développeurs utilisent l’accès complet au disque de manières qui pourraient mettre les utilisateurs en danger, exposant tout ce qui se trouve sur leurs systèmes – y compris les fichiers, les courriels, les messages, et même l’historique de navigation – sans que les utilisateurs en aient pleinement connaissance et compréhension », indique Apple. L’entreprise ajoute que dans les applications de communication, la confidentialité des personnes en contact pourrait également être menacée.

L’entreprise ne compte pas supprimer l’accès disque complet, dont de nombreuses applications ont besoin, par exemple pour de la prise de contrôle à distance via Anydesk ou Teamviewer. En revanche, elle va introduire « des contrôles supplémentaires pour garantir que les utilisateurs qui souhaitent réellement accorder à une application ce niveau d’accès extraordinaire ne puissent le faire qu’avec une action très explicite ». Apple estime ce chantier « crucial », car « les agents IA deviennent de plus en plus capables et autonomes », l’entreprise semblant craindre que les risques associés augmentent « considérablement ».

La note est courte et ne contient aucun détail. Apple ne dit même pas quand ces changements vont être introduits. L’actuelle version 27.2 bêta de macOS ne contient pas ces modifications, mais on peut imaginer que le nouveau contrôle sera présent dans la mouture 27.3.

Le calendrier est également particulier. Comme le souligne TechCrunch, l’annonce survient quelques jours après que le journaliste Jason Aten a affirmé que Muse (Meta) avait lu ses conversations privées. Il assure qu’il n’a jamais donné à Muse l’accès au disque complet, mais que ce dernier lui a quand même suggéré un sujet sur la base d’éléments n’apparaissant que dans l’application Messages sur son Mac. Meta conteste cette version, affirmant que la lecture des conversations dans Messages exige non seulement l’accès complet au disque, mais aussi l’activation du connecteur spécifique Muse pour l’application d’Apple.

  •  

☕️ IA et copyright : en appel, Thomson Reuters gagne de nouveau contre Ross Intelligence


En février 2025, déjà, la société d’information financière Thomson Reuters gagnait un premier procès contre la start-up d’IA juridique Ross Intelligence. Pour entraîner ses systèmes, cette dernière était accusée d’avoir utilisé la base de données Westlaw, dont Thomson Reuters possède le copyright.

Le juge avait alors qualifié cet usage de non « transformateur ». Il précisait alors que seule une forme d’IA « non générative » était à l’examen – si ses déboires judiciaires se sont poursuivis depuis, Ross Intelligence a mis la clé sous la porte en 2021, soit avant la sortie des principaux modèles génératifs.

Balance de la justice

En appel, les représentants de la société défunte argumentaient que son recours aux données de Thomson Reuters relevait du « fair use », ou usage raisonnable. En 2020, la société d’information financière avait accusé Ross Intelligence d’avoir utilisé tous les chapôs des articles de la base de données Westlaw, c’est-à-dire les quelques lignes résumant les décisions de justice détaillées dans leur version intégrale et payante, pour entraîner ses modèles.

D’après la juge Tamika Montgomery-Reeves, qui vient de trancher en appel, cet usage est de nouveau estimé « non transformateur ». À ce titre, y recourir pour développer un produit concurrent ne permet pas de recevoir l’argument du fair use.

Ni les avocats ni un porte-parole de Ross Intelligence n’ont souhaité commenter. Un porte-parole de Thomson Reuters indique en revanche qu’une « protection forte du copyright est essentiel pour promouvoir l’innovation et protéger la propriété intellectuelle qui alimente » ses propres outils d’IA.

  •  

☕️ Huawei et Qualcomm font affaire malgré les restrictions américaines


Malgré les restrictions imposées par les États-Unis, les affaires continuent pour Huawei. Le géant chinois et Qualcomm ont annoncé un accord pluriannuel de licences de brevets sur des technologies comme la 5G, l’IA, les réseaux, l’informatique. Qualcomm va également acquérir « certains brevets américains » de Huawei (ils ne sont pas précisés) dans ces domaines.

Logo de Huawei sur un drap
Crédit : Licence Creative Commons by Web Summit

« Cet accord reflète l’engagement commun des deux entreprises en faveur du respect des droits de propriété intellectuelle et de pratiques de licence conformes aux principes FRAND [conditions équitables, raisonnables et non discriminatoires] », ajoute le communiqué de presse commun. L’accord reflète la « reconnaissance par Qualcomm » des technologies de Huawei et de sa propriété intellectuelle, poursuit John Han, directeur général de l’activité licences au sein de l’entreprise américaine.

Huawei est sur la liste noire du Département du Commerce depuis 2019, ce qui impose aux entreprises US d’obtenir une licence avant d’exporter, de réexporter ou de transférer au groupe chinois des produits et composants soumis aux règles américaines d’exportation. Les restrictions n’ont pas cessé de s’empiler depuis, les autorités craignant que la technologie américaine puisse être utilisée pour nuire à la sécurité nationale.

Huawei a donc dû fortement investir ces dernières années pour développer ses propres technologies, avec des résultats pour le moins intéressants qui entraînent dans leur sillage toute l’industrie chinoise. Ce qui participe à accélérer l’indépendance technologique du pays vis à vis des États-Unis.

Le 26 août dernier, Huawei avait par ailleurs annoncé un accord avec HP portant sur des licences croisées de brevets portant sur la technologie Wi-Fi. Curieusement, HP a pris ses distances avec Huawei, en parlant de « mauvaise interprétation » pour cet accord « faisant passer le règlement d’un litige juridique pour un partenariat plus large. » HP a martelé que Huawei n’était pas un de ses fournisseurs, pas plus que HP n’est un fournisseur de Huawei.

Cette fois, pas de dissension ou de mauvaise compréhension entre Huawei et Qualcomm. Néanmoins, leur accord est soumis à des autorisations réglementaires.

  •  

Union européenne : 138 députées victimes de deepfakes pornographiques

Et 9 de leurs collègues hommes
Union européenne : 138 députées victimes de deepfakes pornographiques

7,3 % des femmes élues au sein d’une Assemblée nationale européenne sont visées par des deepfakes pornographiques, calcule l’ONG Agora Digitale Transformation. Plus de deux fois plus nombreux au sein de ces chambres de représentation politique, leurs homologues masculins sont 0,2 % à subir ce type de désagrément qui peut servir à entacher la réputation ou alimenter des cyberharcèlements.

Les femmes parlementaires européennes encourent 33 fois plus de risques de retrouver leurs images manipulées ou associées à des deepfakes sexistes ou sexuels que leurs collègues masculins. Tel est le résultat auquel aboutit le think tank allemand Agora Digitale Transformation, après avoir répertorié le nombre d’élus au sein de parlements de pays européens dont l’image avait été utilisée pour générer des deepfakes pornographiques ou associées, d’une manière ou d’une autre, à ce type d’imagerie générée par IA.

Concrètement, sur 5 872 membres de parlements européens, l’ONG a identifié 138 femmes parlementaires victimes de ce type de manipulation d’images. Ces dernières sont issues de 22 des 27 États membres. Parmi leurs collègues hommes, pourtant plus de deux fois plus nombreux, neuf sont visés par ce type de manipulation.

Dans le détail, Agora Digitale Transformation établit que l’exposition à ce type de violence numérique touche plus fréquemment les femmes – comme c’est le cas pour diverses autres professions exposées, ou pour le grand public –, mais aussi celles et ceux qui bénéficient d’une plus grande visibilité institutionnelle.

Le fait que leurs pays d’origine aient passé des lois spécifiquement dédiées à lutter contre les deepfakes pornographiques, comme c’est le cas en France ou en Italie, ne semble pas influer sur ces risques. Députée France Insoumise au Parlement européen, la Française Emma Fourreau s’est par exemple émue au mois de juillet de voir son image manipulée par IA par des comptes d’opposants politiques.

Élus dans les parlements monocaméraux ou les chambres basses européennes

Au total, Agora Digitale Transformation s’est penché sur les cas de 6 218 membres des chambres basses (l’Assemblée nationale en France) ou des parlements nationaux, lorsqu’ils sont constitués d’une chambre unique, dans les 27 États membres de l’Union. Après exclusion des sièges vacants, des personnes non-binaires et des membres non-attachés à un parti, elle a testé les noms de 94,4 % de ces représentants élus sur 160 noms de domaines connus pour leur hébergement de deepfake pornographique, de « celebrity leaks », c’est-à-dire des images publiques ou intimes de célébrités, et d’autres images sexistes ou sexuelles de femmes dans l’espace public.

En s’appuyant sur des requêtes vers l’API de Google, elle a ensuite classifié les résultats positifs selon six catégories : est-ce que des deepfakes NCII (non-consensual intimate images, images sexuelles non-consenties) étaient hébergés de manière active par le site web ? Est-ce qu’un outil de génération d’image était lié aux informations biographiques d’une personne dont le nom était explicitement cité ? Est-ce que le résultat incluait des images brutes ? Est-ce qu’il existait des traces de précédentes recherches pour le même type de contenu lié à la personne étudiée ?

Constat principal : les noms de 7,3 % des 1 888 députées femmes ainsi testés ont renvoyé des résultats positifs, contre ceux de 0,2 % des 3 837 hommes députés. Cela signifie qu’une élue sur quatorze risque de voir son image détournée à des fins sexistes ou sexuelles, contre un élu sur 500.

Des applications de « nudification » liées aux comptes de personnes réelles

Agora Digitale Transformation constate par ailleurs que les femmes aux postes à responsabilités – dirigeantes de parti, membres de cabinets ministériels – sont surreprésentées dans ces manipulations d’images. « Atteindre une plus grande visibilité médiatiques a un coût pour les femmes que les hommes atteignant des statuts similaires n’ont pas à payer », note le think tank. Les membres de partis de droite et de gauche sont par ailleurs légèrement surexposés par rapport à leurs collègues de partis centristes.

L’ONG relève par ailleurs l’existence de sites web qu’elle qualifie de « portails ». Ces derniers consistent à proposer du contenu officiel représentant un ou une parlementaire, et à y accoler des liens vers des applications dédiées à générer de l’imagerie sexualisée ou dénudée.

Dans son échantillon, elle indique que 61 sites web agissent de cette manière, en fournissant directement les images initiales susceptibles d’être détournées, tandis que 36 suggèrent de dénuder divers parlementaires, sans fournir les images initiales. Chaque fois, en revanche, ils fournissent des éléments biographiques pour reconnaître facilement la personne, et ses comptes sur les réseaux sociaux. Ces portails incluent des représentations sexistes ou sexuelles générées par IA pour trois parlementaires. Ils fournissent quelquefois des « notations » des corps des femmes ainsi visées.

Des productions de sites suspendus par les autorités restent indexées

Autre enjeu : au cours de l’enquête, le site CFake a été suspendu par une action conjointe des forces de l’ordre françaises et états-uniennes. En juillet 2026, son administrateur, un informaticien niçois de 47 ans, a été condamné à deux ans de prison avec sursis, à 10 000 euros d’amende, à la confiscation d’une partie de ses cryptoactifs et au versement de 83 000 euros d’indemnisation aux parties civiles

Agora Digitale Transformation est parvenue, dans certaines configurations, à retrouver plusieurs dizaines d’index de recherche liant des noms de parlementaires à des contenus supprimés de CFake. Ces derniers apparaissaient toujours dans l’API Google Custom Search plus d’un mois après leur suppression par les autorités. Si cela ne signifie pas que ces résultats soient simplement reproductibles via l’interface utilisateur du moteur de recherche, ce constat fait écho au récent article des universitaires Sarah Morgan, Sophie J. Nightingale et Hany Farid, dans lequel ces derniers pointent les dysfonctionnements du déréférencement de contenu illégal par des acteurs comme Google, Cloudflare ou Namecheap.

Aux traditionnels appels à mettre des garde-fous en place dans les systèmes d’IA, pour les empêcher de générer des contenus non consentis, et à étendre le recours à la norme C2PA, qui permet de tracer les contenus, Agora Digitale Transformation enjoint donc à travailler sur la persistance des index de recherche. Tant que ceux-ci continuent de lier des noms de personnes réels à des contenus sexistes ou sexuels, quand bien même devenus inaccessibles, ils participent à perpétuer dans le temps les risques réputationnels et les éventuels effets psychologiques subis par les victimes.

Plus qu’à la multiplication de législation, l’ONG appelle enfin à mettre en œuvre les textes déjà existants. Aux Pays-Bas, par exemple, il n’existe pas de lois visant spécifiquement les deepfakes, mais ceux-ci sont activement poursuivis en s’appuyant sur des textes plus généraux, relatifs aux manipulations d’images ou à la protection de la vie privée. L’enjeu est d’autant plus important que dans divers pays, dont la France, les échéances électorales approchant risquent de multiplier les cas de manipulation de l’image de personnalités politiques.

  •  

☕️ Le navigateur Orion pour Mac abandonne ses versions Linux et Windows


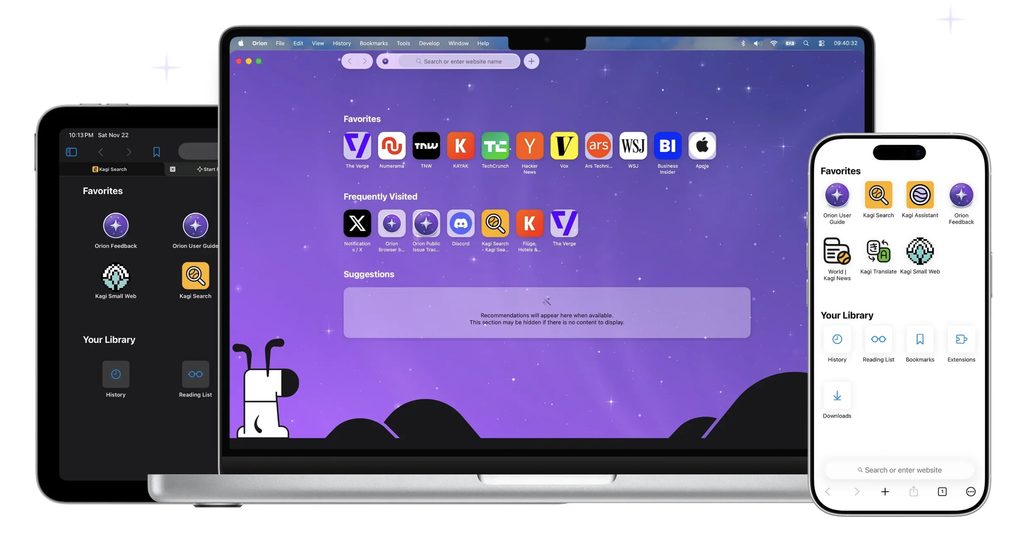
Orion est un navigateur conçu d’abord pour macOS. Après une version 1.0 sortie en novembre 2025 et une 1.1 en juin, Orion s’est fait un petit nom dans le domaine des butineurs.

Orion est bâti autour de WebKit, le moteur utilisé par Safari, avec l’idée bien sûr d’une intégration poussée dans l’écosystème Apple. L’équipe de développement met largement l’accent sur la vie privée : aucune télémétrie par défaut, un blocage intégré des traqueurs et publicités, des fonctions avancées comme des conteneurs multi-comptes, ou encore la compatibilité avec les extensions Chrome et Firefox. Celle-ci n’est pas toujours parfaite, mais elle a le mérite d’exister.

Il était également prévu qu’Orion arrive sur Linux et Windows, mais les plans ont changé. Dans un billet daté du 2 octobre, son éditeur Kagi renonce en effet à ces versions. La raison principale est la petite taille de l’équipe face au défi immense de maintenir trois bases de code. Contrairement à Chromium, WebKit n’a pas l’avantage d’être « prêt à l’emploi » sur plusieurs plateformes.

Screenshot

En conséquence, la bêta actuelle pour Linux ne sera plus mise à jour, même si on peut encore l’utiliser. La version Windows, qui devait sortir avant la fin de l’année, est elle aussi abandonnée. Kagi promet que tout le code travaillé pour ces deux plateformes sera prochainement rendu open source, afin que la communauté le récupère si elle souhaite poursuivre le travail de son côté. Des détails seront publiés au cours des 30 prochains jours à ce sujet.

L’éditeur évoque en outre des craintes de certains utilisateurs, selon lesquelles la société pourrait se disperser en tentant l’aventure du multiplateforme. L’entreprise semble donc leur donner raison et annonce que les versions macOS et iOS seront désormais les seules : « L’équipe et les ressources réparties sur les plateformes se concentrent à rendre Orion plus rapide, plus stable [et avec plus de capacités] sur les appareils Apple. Attendez-vous à des améliorations régulières dans les mois à venir ».

  •  

☕️ Sept ans après son lancement, la NVIDIA Shield TV Pro voit son prix grimper à 299 euros


Toujours vaillante en dépit de son architecture vieille de dix ans, la console NVIDIA Shield TV compte au rang des nouvelles victimes des tensions liées à l’approvisionnement en mémoire provoquées par la course à l’IA.

NVIDIA, qui ne commercialise plus que la version Shield TV Pro, lancée en 2019, vient en effet de majorer son prix de 100 dollars aux États-Unis, comme l’a remarqué Ars Technica. Initialement facturé 199,99 dollars, le boîtier est désormais affiché au prix public de 299,99 dollars, soit une hausse brutale de 50 %.

Un porte-parole de l’entreprise a confirmé le changement de prix, acté au 2 octobre. Sans surprise, il invoque l’augmentation générale du coût des composants, qui affecte toute l’industrie.

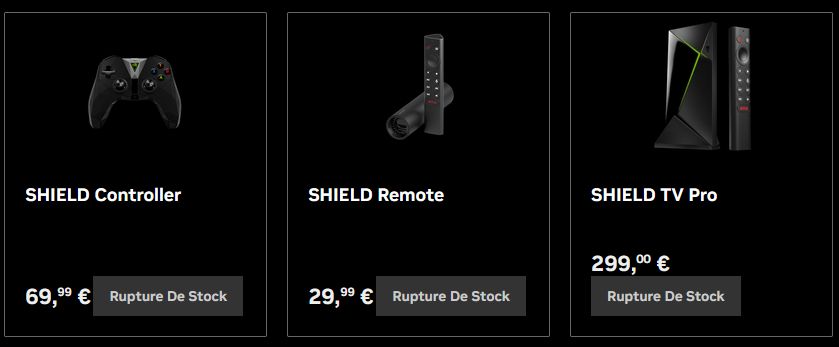
Le changement a été répercuté au niveau européen, constate iGeneration : le site de NVIDIA référence désormais le boîtier à 299 euros, alors que la plupart des revendeurs l’affichaient, ou l’affichent encore, à son précédent tarif de 220 euros.

Bien qu’en rupture de stock, la Shield TV Pro voit son prix s’envoler de 80 euros – capture d’écran

Bien que la Shield soit toujours suivie sur le plan logiciel par NVIDIA, on peut toutefois observer que la console est affichée en rupture de stock chez le fabricant, mais aussi chez la plupart des revendeurs, des deux côtés de l’Atlantique.

Pourquoi dans ce contexte réviser son prix à la hausse, alors même que la production de nouvelles Shield ne semble pas être une priorité ? « Augmenter son prix de 50% permet à la fois de ne pas inciter les gens à l’achat et donc d’éloigner la pression d’un éventuel revendeur réclamant des stocks. Tout en couvrant le coût de production en cas de demande » analyse Pierre Lecourt de Minimachines.

La Shield TV Pro embarque pour mémoire une puce Tegra X1 avec 3 Go de mémoire vive et associée, dans la version lancée en 2019, à 16 Go de stockage sur mémoire flash (le modèle initial embarquait un disque dur de 500 Go).

Si l’offre en matière de boîtier TV sous Android s’est largement développée depuis, la Shield a connu un certain succès (voire un succès certain) pour ses capacités à avaler sans broncher les vidéos 4K, servies par exemple depuis un NAS ou un serveur domestique, avec prise en charge du Dolby Vision et du HDR10.

  •  

☕️ Android : la vérification des développeurs tiers débute dans quatre pays


En mars 2026, Google a annoncé de profondes modifications pour le « sideloading » des applications sur Android. Le sideloading désigne la possibilité d’installer des applications en passant par d’autres moyens que le Play Store ou même les boutiques tierces. C’est une marque de fabrique d’Android jusqu’ici et un facteur de différenciation face à l’iPhone et son « jardin fortifié ».

Les annonces de Google n’enterraient pas le sideloading. En revanche, les règles allaient être bouleversées, et plusieurs sont entrées en vigueur le 30 septembre dans quatre pays : Brésil, Indonésie, Singapour et Thailande.

Sur les appareils encore supportés et disposant d’Android 7 ou d’une version ultérieure, les applications distribuées via les boutiques participantes doivent avoir un développeur vérifié. Traduction : une personne enregistrée auprès de Google, avec ses coordonnées et une preuve d’identité, généralement le scan d’une pièce d’identité officielle. C’est ce programme, Android Developer Verification, qui est entré en vigueur il y a quelques jours.

Si cette vérification est limitée à quatre pays, Google a annoncé que la généralisation aura lieu en 2027 pour l’ensemble des marchés. Le mécanisme de vérification n’appose pas seulement un badge de vérification, il lie l’identité du développeur à ses applications et ses clés de signature. Pour Google, c’est une question de traçabilité et de sécurité.

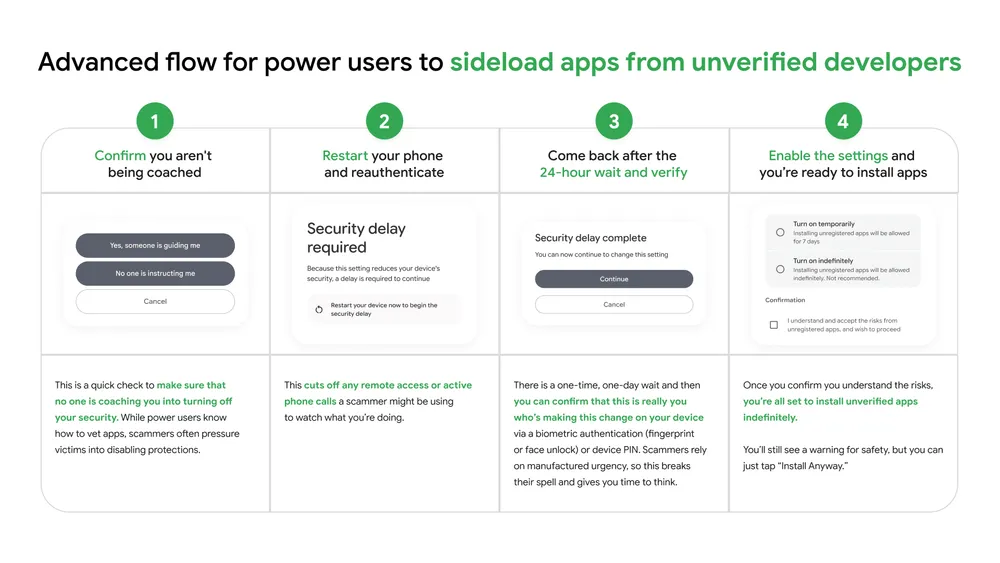
Quand la transition sera terminée, le sideloading deviendra nettement plus complexe. Quand vous souhaiterez installer une application récupérée depuis un site, sans passer par une boutique, il faudra en effet activer le mode Développeur dans les options de l’appareil.

Ensuite, après un redémarrage, Google réclamera un délai de 24 heures. Comment l’entreprise justifie-t-elle ce délai ? Par la nécessité de lutter contre les arnaques reposant sur l’ingénierie sociale et la pression en temps réel. Précisons que le délai n’intervient qu’une fois pour toutes les installations, pas pour chacune. En outre, ADB (Android Debug Bridge) reste en place pour les développeurs.

Source : Google

Si cette mesure casse en effet certains scénarios malveillants, elle risque d’avoir un impact lourd pour les boutiques non agréées et le sideloading en général, car la motivation peut vite disparaître devant une telle procédure. La liste initiale des boutiques agréées comprend le Play Store, le Galaxy Store, l’App Market d’HONOR, l’App Market d’OPPO, GetApps de Xiaomi, le V-Appstore de Vivo et le Palm Store de Transsion. Notons que la vérification des développeurs n’est pas forcément un gage de sécurité.

Ce changement fait partie d’un mouvement plus large de restrictions autour d’Android. Google semble en effet serrer la vis sur de nombreux aspects, plusieurs étant pointés du doigt par GrapheneOS, qui critique largement les changements intervenus dans la gestion des correctifs pour AOSP (Android Open Source Program).

  •  

Facturation électronique : fuite d’informations chez VosFactures à cause d’un prestataire

Quelque part en Pologne
Facturation électronique : fuite d’informations chez VosFactures à cause d’un prestataire

Alors que l’obligation de facturation électronique est entrée en vigueur le 1ᵉʳ septembre, une première plateforme agréée annonce une fuite de données. Elle n’a pas été directement attaquée, la brèche venant d’un prestataire polonais. Le problème a cependant été assez sérieux pour que l’administration coupe temporairement ses échanges avec la plateforme.

Une plateforme agréée par l’État, VosFactures, a vu une partie des données de ses utilisateurs consultée après le piratage de son prestataire polonais Fakturownia. L’intrusion a été détectée le 27 septembre et l’accès a été coupé le 28. Le lendemain, la plateforme VosFactures a été avertie. Les 500 000 clients que revendique la plateforme ont alors commencé à être contactés.

Dans le courrier envoyé, affiché par FuitesInfos, on apprend qu’une « personne non autorisée » est parvenue à exploiter une vulnérabilité dans un mécanisme de génération de fichiers PDF à partir de modèles de factures. Cette exploitation a ensuite permis au pirate d’accéder à certains fichiers de configuration sur des serveurs du prestataire, dont des clés applicatives et des identifiants. À partir de ces informations, le pirate a réussi à déclencher des commandes arbitraires sur plusieurs serveurs applicatifs et à accéder à une copie miroir de la base de données de production.

Dans le courrier, VosFactures insiste sur plusieurs points, dont le fait que ses serveurs n’ont pas été directement attaqués. « Toutefois, certaines données relatives aux utilisateurs de VosFactures étaient traitées par ce prestataire dans le cadre de la fourniture de services techniques à FACTUALI SAS [l’opérateur de VosFactures, ndlr]. Une personne non autorisée a ainsi pu accéder à certaines données relatives aux comptes VosFactures, au clients et fournisseurs de nos utilisateurs ainsi qu’à une partie des documents générés au moyen du service », indique la plateforme dans ses e-mails.

L’entreprise rappelle également que sa propre infrastructure bénéficie de la qualification SecNumCloud de l’ANSSI, rappelant ses obligations en matière de protection des systèmes, de sécurité des données et de maitrise de leur hébergement. « À ce stade, aucun élément dont nous disposons ne révèle une compromission directe de l’environnement SecNumCloud propre à FACTUALI SAS », ajoute le courriel.

Une portée des risques encore floue

VosFactures prévient des risques habituels dans ce type de cas : les éternelles tentatives d’hameçonnage (phishing) par e-mail ou SMS, d’usurpation d’identité, de fraude au changement de coordonnées bancaires ou aux faux fournisseurs, d’accès non autorisé à d’autres services en cas de réutilisation du même mot de passe, ou encore de prise de contact frauduleuse en se faisant passer par VosFactures. Sans surprise, la plateforme recommande la plus grande prudence, avec les règles élémentaires d’hygiène numérique.

Selon FuitesInfos, l’entreprise a envoyé un deuxième e-mail pour avertir que l’ensemble des codes API fournis jusqu’à présent étaient invalidés au 1ᵉʳ octobre. Pour les clients concernés, cela signifie une rupture dans les intégrations, par exemple dans des logiciels de comptabilité. Il faut donc générer de nouveaux codes et mettre à jour les connexions concernées.

Fakturownia a également communiqué sur l’incident le 1ᵉʳ octobre, l’entreprise polonaise indiquant elle aussi avoir contacté ses clients, corrigé la faille et averti le Bureau de protection des données personnelles et le CERT polonais. Toutefois, les données dérobées sont beaucoup plus nombreuses chez le prestataire, avec notamment les mots de passe hachés, les numéros IBAN, le détail des factures ou encore les historiques des paiements. Les courriels de VosFactures étant peu précis sur ce point, nous avons contacté l’entreprise pour obtenir plus de détails et mettrons à jour cette actualité en cas de réponse.

Selon la presse polonaise, un pirate se faisant appeler Fingerprint a revendiqué l’attaque. Il dit être en possession d’une base de données de 6 To, mais ce chiffre n’a pas pu être vérifié.

Suspension temporaire des échanges avec l’AIFE

L’information a en tout cas fortement déplu à l’AIFE, l’Agence pour l’informatique financière de l’État. Sur son portail Chorus Pro (service de réception des factures fournisseurs pour les administrations publiques), on peut voir encore à l’heure actuelle un bandeau rouge. Il a été mis en place le 1ᵉʳ octobre pour avertir d’une suspension provisoire des échanges entre la plateforme agréée concernée et l’AIFE.

« À l’issue de l’examen des éléments techniques communiqués par la PA concernant cet incident, il apparaît que la situation opérationnelle des services de la PA et les mesures de sécurité prises ne justifient pas le maintien de la suspension. Les échanges entre la PA et les services opérés par l’AIFE ont donc été rétablis et restent naturellement sous surveillance comme pour l’ensemble des partenaires », indique cependant le bandeau, mis à jour pendant le week-end.

L’information tombe mal quoi qu’il en soit. L’arrivée de la facturation électronique ne s’est pas faite en douceur, de nombreuses petites entreprises se sentant lésées par ce passage forcé. L’obligation augmente mécaniquement la pression sur la sécurité des données puisque toute entreprise doit passer par l’une des plateformes agréées, dont la liste est fournie par le ministère de l’Économie et des Finances.

  •  

Donald Trump nomme un tsar de l’IA et crée une Super Intelligence Force

Epilation requise
Bruxelles cherche à taxer les grandes entreprises américaines du numérique sans les nommer

Donald Trump a annoncé dimanche que Jay Clayton, directeur du renseignement national, devenait son nouveau tsar de l’IA, en charge du pilotage d’une nouvelle Super Intelligence Force (SIF). Cette dernière est chargée de rendre d’ici 120 jours un rapport sur les risques et les opportunités de l’intelligence artificielle.

Nommé directeur du renseignement national en juin dernier, Jay Clayton vient de gagner une nouvelle casquette : celle de « tsar de l’IA », c’est-à-dire conseiller spécial du président des États-Unis sur les sujets liés à l’intelligence artificielle.

À ce titre, qui se cumule à ses fonctions de supervision du renseignement à l’échelle nationale, Jay Clayton se voit confier le pilotage d’une mission baptisée Super Intelligence Force, ou SIF, chargée de coordonner l’action fédérale en matière d’encadrement et de développement de l’intelligence artificielle, que Donald Trump préfère désormais appeler « super intelligence ».

Une Super Intelligence Force pour coordonner l’action fédérale

Trump a annoncé la création de cette nouvelle entité dimanche sur son réseau social :

« La Super Intelligence Force a pour mission de coordonner les efforts du gouvernement fédéral afin de garantir que l’Amérique conserve son leadership mondial dans le domaine de la super intelligence, considéré par beaucoup comme plus important que la révolution industrielle et Internet, et qui protégera les intérêts et améliorera la vie de tous les Américains ».

Pour conduire cette mission, Jay Clayton sera entouré de trois vice-présidents : Andrew Ferguson, patron de la FTC (droit des consommateurs) ; Scott Kupor, le directeur de l’Office of Personnel Management, l’agence fédérale chargée de la fonction publique ; et Emil Michael, sous-secrétaire à la Défense chargé de la recherche et de l’ingénierie. Le quatuor rendra compte directement au président des États-Unis (« MOI! », écrit Trump) et à sa cheffe de cabinet, Susie Wiles.

Jay Clayton avait révélé le projet quelques heures plus tôt au Wall Street Journal. Il précise à ce dernier disposer d’une fenêtre de 120 jours pour formuler ses premières recommandations, extensible en cas de besoin.

Consulté par le quotidien économique, le document qui sert de socle à la création de la SIF prévoit que ce comité travaille à « des plans de réponse aux menaces que les technologies de l’information permettent de faire peser sur notre société, tout en prévenant la surréglementation et la mainmise des autorités sur le système, qui étoufferaient l’innovation et la concurrence ».

Il évoque notamment un modèle d’évaluation des risques élaboré en coordination avec les entreprises du secteur, un peu sur le modèle de ce que font déjà la SEC, le gendarme de la bourse, et la Réserve fédérale dans le domaine financier.

Rassurer sans réguler ?

En pratique, ce sont donc les acteurs de l’IA qui seront chargés de concevoir les outils dédiés à cette gestion du risque, la task force intervenant à la fois comme un interlocuteur et comme une courroie de transmission vers d’éventuelles actions gouvernementales ou fédérales visant à prévenir les risques en question. Autrement dit, la Super Intelligence Force n’a rien d’un régulateur : son rôle devrait se borner à la formulation de recommandations à l’issue de la fenêtre initiale de 120 jours.

Cette capacité d’intervention limitée s’inscrit dans le prolongement des annonces formulées par Donald Trump à l’issue d’un dîner organisé le 29 septembre avec les dirigeants des principales entreprises d’IA des États-Unis. La rencontre a abouti sur la signature d’un accord non contraignant, selon lequel les acteurs du secteur s’engagent à mettre en œuvre des contrôles renforcés pour surveiller les risques soulevés par leurs modèles de pointe et à ouvrir leurs portes à des auditeurs externes.

Tout ça pour ça ? S’il maintient qu’il ne faut pas réguler le secteur, notamment pour que les États-Unis conservent leur rang dans la course à l’IA de pointe face à la Chine, Trump admet peut-être à demi-mots que l’opinion publique américaine a besoin de garanties quant à une forme de contrôle gouvernemental sur le développement du secteur.

D’après le Wall Street Journal, plusieurs de ses conseillers, dont sa cheffe de cabinet Susie Wiles et le secrétaire au Trésor Scott Bessent défendent cette idée, notamment pour contrer l’impopularité grandissante de l’IA aux États-Unis.

Cette dernière s’incarne au niveau local par les protestations contre l’implantation de nouveaux datacenters, devenues un véritable sujet électoral, mais elle infuse aussi plus largement, avec des craintes liées à la cybersécurité, ou à l’avènement de nouvelles formes d’attaques (chimiques, biologiques, etc.), elles-mêmes alimentées par le marketing de la peur des entreprises d’IA.

En attendant de voir si la création du SIF rassure l’électeur moyen, la double casquette de Jay Clayton risque de réveiller certaines défiances chez les défenseurs de la vie privée, remarque Politico : treize ans après les révélations d’Edward Snowden, elle crée en effet une proximité inédite entre renseignement national et politique fédérale en matière d’IA.

  •  

☕️ Fuite de données à la région Hauts-de-France, avec « potentiellement des RIB »


Chaque jour ou presque sa fuite de données. C’est au tour de la région des Hauts-de-France de confirmer dans un communiqué avoir été victime d’une cyberattaque « ayant permis un accès non autorisé à des données personnelles traitées pour son compte », comme le rapporte l’AFP avec Franceinfo. Plus précisément, selon la région, ce sont deux de ses prestataires qui ont été ciblés : Atexo et Docaposte.

La région précise qu’Atexo s’occupait des aides régionales. De son côté, Docaposte était en charge de la carte Génération#HDF, avec laquelle la région fournit une aide financière aux lycéens et apprentis. Les deux plateformes sont fermées pour le moment. « Les prestataires ont identifié les failles ainsi que le mode opératoire de l’attaquant et engagé les travaux de correction », affirme la région.

De qui parle-t-on ? La liste des données potentiellement récupérées par les pirates contient des informations personnelles comme « des noms, prénoms, adresses électroniques, ainsi que potentiellement des RIB et d’autres données d’identification figurent parmi les données susceptibles d’avoir été compromises ». La fuite d’un RIB (qui contient notamment votre IBAN) ne doit pas être prise à la légère, comme nous l’avons détaillé dans un article dédié.

La région n’a pas été en mesure de confirmer « le nombre exact de personnes concernées » pour le moment, mais des pirates revendiquent sur un forum avoir récupéré des données de plus de 700 000 personnes, à confirmer évidemment. Quoi qu’il en soit, les « usagers concernés ont commencé à être informés », précisent nos confrères.

La région précise enfin avoir « déposé plainte auprès des autorités compétentes ». Pour rappel, en octobre 2025 le parc informatique des lycées de la région Hauts-de-France avait été la cible d’une cyberattaque.

  •  

Le DGX Spark descend à 64 Go, NVIDIA moteur et « victime » de la pénurie de mémoire

Payer plus pour avoir moins
Le DGX Spark descend à 64 Go, NVIDIA moteur et « victime » de la pénurie de mémoire

La crise de la mémoire est en très grande partie alimentée par NVIDIA qui a besoin de toujours plus de HBM pour ses GPU haut de gamme. Cette crise provoque des hausses de prix sur les composants (mémoire vive, SSD…), mais aussi sur des produits NVIDIA, dont le DGX Spark avec une hausse de 75 % depuis son lancement. Une version 64 Go vient d’être annoncée.

64 Go de LPDDR5x pour « davantage de possibilités »

En mars 2025, NVIDIA dévoilait son DGX Spark au format mini-PC, avec une puce GB10 Grace Blackwell Superchip aux commandes. La machine avait été présentée sous le nom Project DIGITS au CES début 2025. Elle comprend 20 cœurs CPU Arm, un GPU Blackwell et 128 Go de mémoire LPDDR5x. Ce n’est pas de la HBM comme sur les GPU pour les datacenters.

À partir du 23 octobre, cette station de travail sera aussi disponible en version 64 Go afin de proposer « aux développeurs davantage de possibilités pour créer et déployer une IA locale ». Davantage de possibilités avec moins de mémoire ? Une présentation pour le moins originale, quand on sait que la mémoire est l’élément central pour les gros modèles.

À son lancement, le DGX Spark de 128 Go était à… 3 999 dollars

Bien sûr, il s’agit de proposer un tarif « plus abordable » de… 4 999 dollars tout de même. Mais plus abordable que quoi ? Certainement pas que le DGX Spark 128 Go à son lancement puisque la machine était annoncée à 3 999 dollars, soit 1 000 dollars de moins pour le double de mémoire.

Le DGX Spark de 128 Go est passé à 4 699 dollars en février de cette année en raison des « contraintes d’approvisionnement en mémoire à l’échelle de l’industrie ». Il vient encore de subir une augmentation ces derniers jours pour désormais atteindre près de 7 000 dollars, selon The Register.

Aujourd’hui, le DGX Spark 64 Go est certes moins cher que le modèle 128 Go, mais on voit bien les effets de la crise de la mémoire vive. Une crise causée par les demandes de l’ogre du moment : l’intelligence artificielle. Elle nécessite toujours plus de mémoire et de GPU, NVIDIA étant l’acteur dominant.

Les principaux fabricants de mémoire (SK hynix, Samsung et Micron) réorientent aussi leur production sur la HBM, bien plus rentable que la DRAM classique (DDR4, DDR5…) dont le prix s’envole. Le DGX Spark de NVIDIA subit donc de plein fouet une crise alimentée par NVIDIA. Les joueurs aussi en font les frais. La dernière génération de carte graphique pour le grand public date de janvier 2025 avec les RTX 50.

Assemblez les DGX Spark par deux ou quatre, si vous avez les moyens

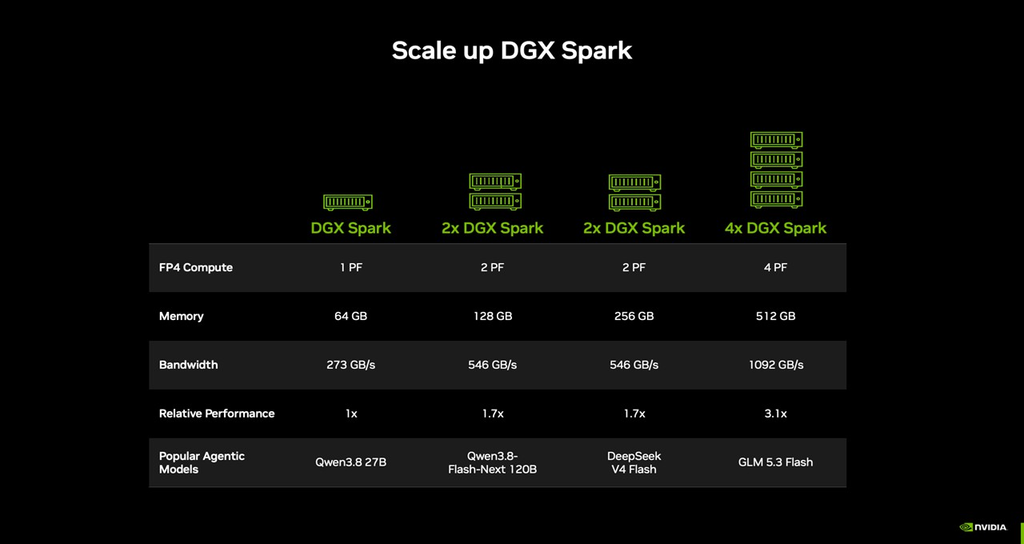
NVIDIA sort un atout de sa manche pour donner un avantage au DGX Spark de 64 Go : « en cas d’augmentation de la charge de travail, deux unités peuvent être regroupées en cluster via NVIDIA Sync Cluster Assistant sans aucune configuration supplémentaire ».

On passe alors à 128 Go de mémoire (2x 64 Go), mais on double aussi le nombre de cœurs CPU et surtout la partie GPU. NVIDIA annonce des performances en hausse de 1,7x avec deux DGX Spark sur Qwen3B-8-Flash-Next et DeepSeek v4 Flash. Avec quatre DGX Spark, les performances dans GLM 5.3 Flash font x3,1.

Le DGX Spark dispose d’une partie réseau ConnectX-7 à 200 Gb/s permettant de relier plusieurs machines entre elles. Ce n’est pas le cas du RTX Spark, une autre machine dédiée à l’intelligence artificielle de NVIDIA, avec Windows on Arm comme système d’exploitation. Mais sans ConnectX, ce ne sera pas aussi simple d’en assembler plusieurs.

  •  

☕️ #LIDD 56k.rip : Internet en 28/56k, comme il y a 30 ans


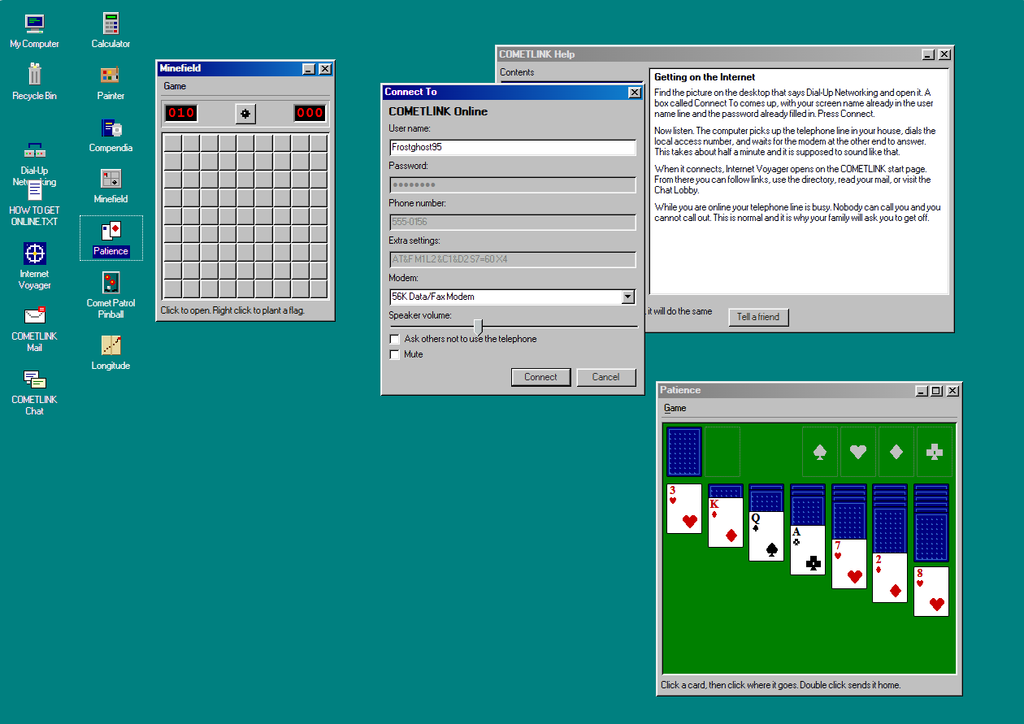
Vous avez la nostalgie informatique des années 90 ? C’était l’époque du bon vieux Windows 95, puis de Windows 98, mais surtout celle des modems permettant d’accéder à Internet par ligne commutée. Pour bien commencer la semaine (et prendre un coup de vieux pour les plus des 30 ans), 56k.rip vous propose de retourner à cette belle époque.

Le nom de domaine a été enregistré cet été, le site déployé en septembre et il a récemment fait la une de Hacker News. Ce n’est pas du Windows, mais du Cometlink 96 avec le démineur, la calculatrice et l’accès au modem… à lancer avec le son évidemment. Dans le Dial-Up Networking, vous avez le choix entre 28,8k et 56k.

  •  
❌