❌

Vue lecture

☕️ Operation Bluebird : la start-up qui voulait relancer Twitter (.now)


La première alerte date de la fin 2025. En décembre, une start-up de l’État de Virginie, aux États-Unis, avait alors déposé un dossier devant le bureau fédéral des brevets et des marques, dans lequel elle affirmait que X avait abandonné les noms Twitter et Tweet et les marques affiliées. À ce titre, l’entité nommée Operation Bluebird (opération Oiseau bleu) en réclamait l’usage.

S’ils en obtenaient le droit, ses deux cofondateurs, Michael Peroff et Stephen Coates, prévoyaient de lancer un nouveau réseau social à l’adresse twitter.new, expliquaient-ils à Ars Technica.

Avant le rachat du réseau initial par Elon Musk, Stephen Coates a travaillé comme juriste chez Twitter.

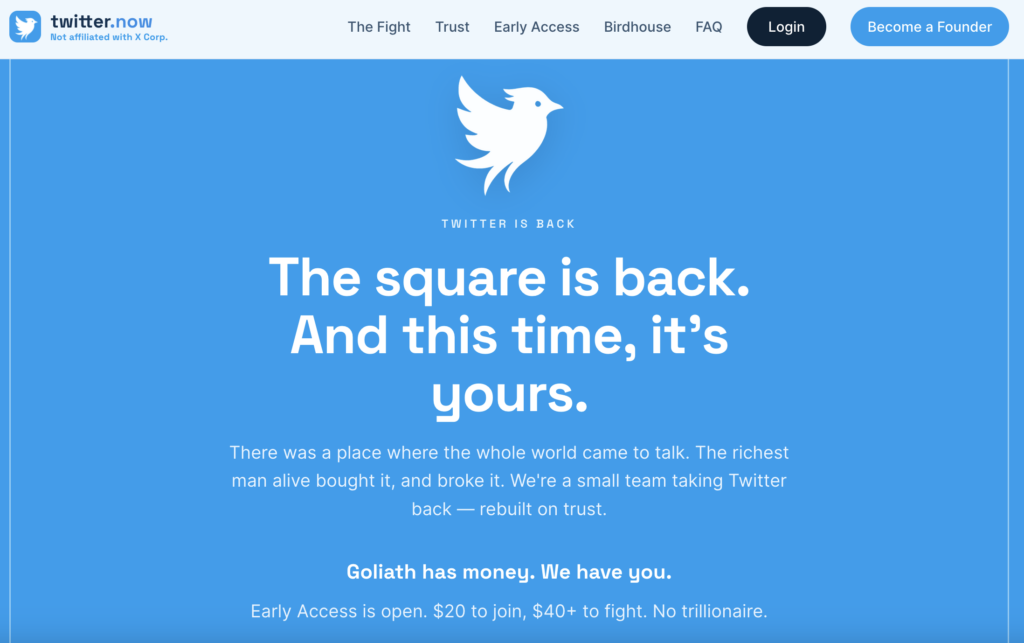
La deuxième alerte date de cette semaine : peut-être que Twitter va redevenir un mot courant. Après quelques échanges avec le juge, les équipes d’Operation Bluebird ont en tout cas décidé de lancer leur projet, finalement à l’adresse twitter.now.

Twitter.now / Capture d’écran

En avril 2026, au tribunal, le juge Colm Connolly avait déclaré que X semblait bien avoir abandonné le mot tweet et le logo à l’oiseau bleu, rapporte Ars Technica. L’entreprise aurait peut-être même abandonné le nom Twitter, avançait-il alors. Si cette décision doit encore être confirmée à l’écrit, les dirigeants d’Operation Bluebird ont décidé qu’elle était suffisante.

Leur site, désormais en ligne, propose un réseau social dont la couleur dominante reste le bleu, et l’oiseau du logo ressemble à un phénix. Pour le moment, il n’a que quelques centaines d’utilisateurs. Une fois connecté, la plateforme ressemble à son ancêtre, à quelques fonctionnalités près. Twitter.now embarque notamment un système de vérification des faits adossé à Gemini, l’IA générative de Google, et nommé Vera (rien à voir avec le projet associatif français). Pour limiter l’accès – et pour collecter des fonds et impliquer les premiers utilisateurs –, le réseau n’est pour le moment accessible que contre 20 à 40 dollars ou plus, selon l’abonnement choisi.

Le but : recréer un espace de conversation large, sans la diffusion de désinformation et de violence. Promouvoir la « liberté d’expression » et pas la « liberté de reach » qui tend à promouvoir, sur beaucoup de plateformes, les discours les plus clivants.

Si twitter.now a décidé de faire ses premiers pas en ligne, cela dit, des juristes spécialistes du droit des marques estiment probable que cela suscite une opposition plus tranchée de X.

Affaire à suivre, donc.

  •  

2026 : l’été où les affiches IA ont inondé la France

Ça l'affiche mal
2026 : l’été où les affiches IA ont inondé la France

Pour annoncer des fêtes de village, des promotions ou le prochain concours de pétanque, les affiches IA se multiplient partout en France. Au point, cet été, d’avoir suscité des débats sur leur bien-fondé.

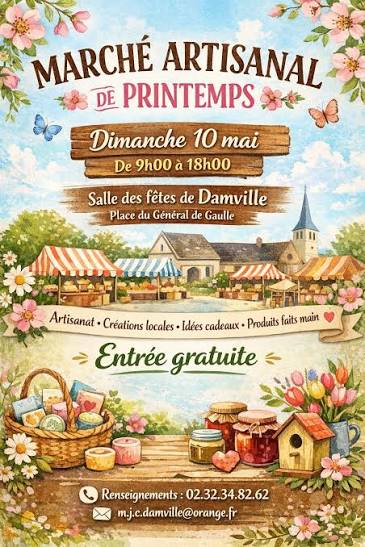
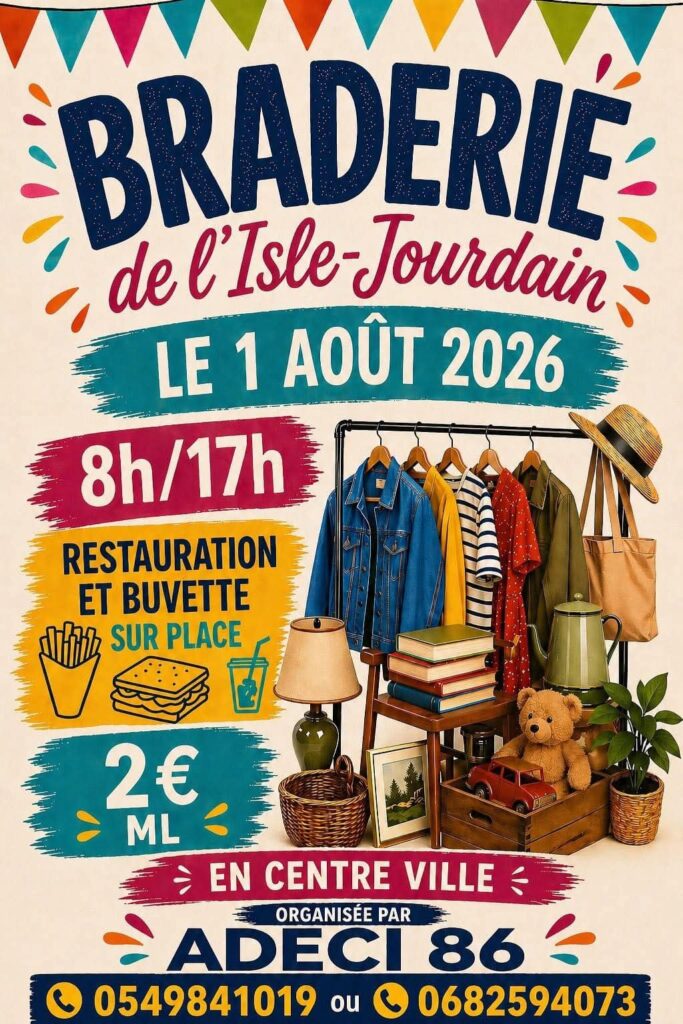
Celles et ceux qui ont pu partir en vacances s’en sont rendus compte en quittant leur environnement quotidien. Où qu’ils aillent, en France et ailleurs, des images lisses, parfois teintées d’un jaune caractéristique, envahissaient les menus, les espaces d’affichage de supermarchés, les panneaux d’annonces pour des brocantes, des fêtes de village, des marchés.

Que ce soit sur les réseaux sociaux ou dans les médias régionaux ou nationaux, l’évolution est claire : les affiches, cartes postales et autres images générées par IA se multiplient partout dans le pays, et tout le monde ne s’en réjouit pas.

Une technologie « pratique » pour les petites structures

Le débat a grossi, ces derniers mois, pour se répercuter d’un média régional à un autre. Dans la Manche, la propriétaire d’une friperie associative se réjouit de pouvoir utiliser l’IA générative pour produire de « jolies affiches colorées » : auparavant, sa structure se contentait d’une publication moins visuelle sur les réseaux sociaux.

En Champagne, plusieurs communes ont recouru à l’IA pour annoncer leurs événements estivaux, des fêtes du 14 juillet aux concours de pétanque. Auprès de l’Union, la secrétaire du comité des fêtes d’Igny-Comblizy estime que « c’est efficace », même si elle « n’obtient jamais le bon résultat du premier coup » : non seulement l’IA lui permet de générer des affiches, mais aussi de corriger les images de mauvaise qualité qu’on peut lui envoyer pour illustrer un concert, ou encore de préparer rapidement un visuel lorsque le sujet arrive sur la table sans avoir été prévu auparavant.

Certains, comme le président du comité d’Avenay-Val-d’Or, demandent même à la machine (le plus souvent, ChatGPT) d’ajouter « une touche plus vintage », lorsque cela correspond à l’idée de l’événement organisé. D’autres y recourent aussi pour véhiculer des messages problématiques : menée par le Rassemblement national, la mairie d’Agde a affiché un moment une image générée par IA et contenant des propos racistes, avant que la polémique pousse à les retirer.

Dans le Limousin, en Alsace, dans le Var ou le Puy-de-Dôme, dans des fêtes de village comme de grandes enseignes de supermarchés ou de plus petits commerces, l’IA générative est partout. Et son adoption large a rendu les similarités entre affiches (ou cartes postales, ou menus de restaurants, ou autres éléments visuels) d’autant plus évidentes.

À Avignon, certains lieux accueillant le off du festival de théâtre se sont eux aussi tournés vers l’IA générative pour annoncer certains des 1 700 spectacles joués. L’astuce a été suffisamment fréquente pour qu’un festivalier en forme écrive sur nombre d’entre elles la phrase « Artist ? No AI » au feutre noir, rapporte Libération. Les débats, cela dit, sont loin d’être simples : outre servir à produire des images à faible coût, l’IA est aussi utilisée dans diverses autres activités artistiques ou organisationnelles, y compris directement dans la création des pièces.

Un résultat de faible qualité

Sur les réseaux sociaux, néanmoins, un agacement monte, à coups de montages qui illustrent les similarités entre chaque production. Sur Facebook, des groupes doctement titrés « Affiches en IA claquées » ou « Affiches IA de merde » ont été créés – ils restent néanmoins bien moins animés que leurs concurrents dédiés à échanger des conseils pour bien prompter.

Des graphistes, designers, dessinateurs et autres artistes visuels se tournent aussi vers les réseaux sociaux pour regretter la vaste uniformisation visuelle qui semble avoir saisi la France cet été : le recours à Stable Diffusion, Midjourney ou d’autres pour générer l’annonce de la prochaine fête du hareng, c’est aussi une commande en moins pour ceux dont la production de ces supports de communication est le métier.

Des spécialistes soulignent par ailleurs un problème récurrent dans les productions obtenues : les machines ne sachant pas sélectionner les informations les plus pertinentes, le rendu est surchargé d’éléments. Si, à première vue, le résultat peut sembler satisfaisant, il ne permet pas de faire savoir l’essentiel de la manière la plus efficace.

Autre enjeu, qui fera peut-être, à terme, évoluer le recours à ces outils : en lissant affiches et publicités, le large recours à l’IA produit aussi une uniformisation des enseignes, des lieux et des marques. Pour qui souhaiterait se démarquer de son voisin, le prompt reste donc à revoir.

  •  

Au Royaume-Uni aussi, les protestations contre les centres de données se multiplient

Mondial vs local
Au Royaume-Uni aussi, les protestations contre les centres de données se multiplient

Comme aux États-Unis, en France et ailleurs, le Royaume-Uni est traversé de débats sur le bien-fondé de la multiplication des centres de données. Ceux-ci portent autant sur leurs impacts environnementaux que sur l’acceptation locale. En Écosse, l’opposition se fait particulièrement forte.

Les émissions carbone de seulement deux projets de centres de données prévus au Royaume-Uni devraient dépasser toutes celles d’ExxonMobil. Menée par Foxglove, une ONG britannique qui cherche à « rendre la technologie équitable pour tous », l’analyse constate que les projets de data centers prévus dans les comtés de Buckingham et de Bedford utiliseront à eux deux 1,3 gigawatt d’énergie, ce qui produirait plus de 4,5 millions de tonnes d’émissions de carbone.

Ce chiffre dépasse les 3,9 millions de tonnes de CO₂ émises par la société pétrolière ExxonMobile sur la seule année 2023, constate the Guardian. Une comparaison qui risque d’alimenter les débats : comme les États-Unis, en amont des élections de mi-mandat, ou, dans une moindre mesure, la France, le Royaume-Uni est traversé par des oppositions locales et nationales contre divers projets de centres de données.

De l’électricité qui ne peut être utilisée ailleurs

Les estimations d’émissions carbone produites par FoxGlove s’appuient sur les chiffres gouvernementaux relatifs à la production d’énergie. Auprès du Guardian, le gouvernement les qualifie de trompeuses, au motif qu’elles s’appuieraient sur une consommation de 100 % dès le lancement du centre de données, alors que celle-ci varie en fonction des besoins. L’ONG, elle, considère que présupposer un usage de l’intégralité des capacités énergétiques est une pratique standard de l’industrie des centres de données.

Dans tous les cas, l’ONG parvient à susciter le débat : à l’heure actuelle, le gouvernement britannique estime que ses plans de déploiement de centres de données à travers le pays pourront s’insérer dans ses dépenses énergétiques de manière à ce que le Royaume-Uni respecte ses objectifs climatiques. Pour autant, un des membres du comité d’audit environnemental du Parlement admet que ces données sont « un rappel saisissant » de la nécessité d’encadrer l’implantation des centres de données.

Pour divers représentants de la société civile, l’implantation des deux centres de données serait malgré tout « catastrophique » pour le budget carbone britannique, notamment parce qu’elle freine toute tentative de transition énergétique. Pour l’avocat Sam Hunter-Jones, en effet, chaque mégawatt d’électricité alloué à un data center est un mégawatt qui ne peut pas servir à se passer d’énergie fossile dans une autre activité.

Surtout, les deux établissements font partie des premiers à bénéficier d’une logique d’autorisation accélérée, grâce au statut de « national significant infrastructure project » (NSIP), un système similaire à celui de Projet d’infrastructure national majeur français. Pour les observateurs, l’existence même de ce statut est inquiétante, dans la mesure où le gouvernement britannique y a déjà inclus deux autres projets qui prévoient de s’équiper de turbines à gaz pour obtenir de l’énergie en attendant d’être reliés au réseau électrique local.

La politique britannique de l’IA pourrait se heurter à l’objection écossaise

Outre pour des questions environnementales, la politique britannique en matière de centres de données crée aussi des remous en raison des lieux d’implantation proposés. À l’échelle nationale, des personnalités comme le directeur exécutif de l’Opérateur national du système énergétique appellent en effet les acteurs immobiliers et les constructeurs de centres de données à s’installer au Royaume-Uni, en particulier au nord du pays. Parmi leurs arguments : la disponibilité en énergie et en eau, utile pour le refroidissement des serveurs, dont dispose l’île.

Sauf qu’en Écosse, un projet prévu au Nord d’Édimbourgh attire des centaines d’objections des riverains : celui d’Auchertool, dans la région de Fife. Présenté par ses promoteurs comme le deuxième plus gros datacenter au monde, le bâtiment doit faire 35 mètres de haut et s’étendre sur une surface équivalente à 100 terrains de football. D’un point de vue énergétique, il prévoit de nécessiter 600 mégawatts (MW), une capacité plus basse que celle annoncée par le géant français Campus IA (1,4 GW) ou son concurrent portugais Start Campus (1,2 GW).

Mais quelles que soient ses capacités vues depuis l’international, sur place, les riverains n’en veulent pas. Le bâtiment rencontre une opposition « énorme », selon David Torrance, membre du parlement écossais représentant le village. « Je n’ai jamais vu ce niveau d’objection sur un projet local, et je suis dans la politique depuis 25 ans », déclare-t-il au Guardian.

Ailleurs dans l’État, les projets prévus dans les villes d’Airdrie et de Larbert rencontrent eux aussi des oppositions, au point que le ministre des Finances écossais vient d’obliger les administrations à notifier son gouvernement pour tout projet de plus de 50 MW. Le gouvernement écossais commençait même à envisager un moratoire, selon la directrice de l’association Action to Protect Rural Scotland. S’ils le votent, cela pourrait remettre en question la politique industrielle adoptée par le Royaume-Uni en matière d’infrastructure dédiée à l’IA.

En février 2026, les 140 projets prévus à travers le pays étaient susceptibles d’atteindre 50 GW de puissance.

  •  

☕️ La vérification d’âge augmente l’usage de sites porno illégaux, selon Pornhub


Le système de vérification d’âge des sites pornographiques mis en place au Royaume-Uni depuis 2025 pousse l’usage de sites pornographiques irrespectueux de la loi, déclare Pornhub dans une lettre adressée à 300 représentants locaux.

En vertu de l’Online Safety Act, les sites en question sont supposés vérifier l’âge des utilisateurs pour éviter que des mineurs n’accèdent à ces contenus. Les moyens utilisés reposent généralement sur de la reconnaissance faciale ou des vérifications de carte de crédit, rappelle le Financial Times.

Pour Pornhub, site pornographique le plus visité du pays et concurrent direct des plateformes irrespectueuses de la loi, le texte a « échoué » dans sa mission de protection des mineurs.

En effet, constate l’entreprise, en juin 2026, sept des dix premiers résultats pour la recherche de « porno gratuit » en ligne renvoyaient vers des sites non conformes à la législation britannique. Un résultat qui rejoint ceux déjà relevés dans des enquêtes menées par des médias ou des universitaires courant 2025.

Illustration : Flock

D’après le régulateur local du numérique, l’Ofcom, l’entrée en vigueur de l’Online Safety Act a mené à une chute d’environ un tiers des visites de sites pornographiques. Mi-juillet, l’institution notait aussi que le recours aux VPN (Virtual Private Network, qui permettent notamment de se localiser en dehors du pays) avait quasiment doublé (+ 83 % d’utilisateurs) depuis l’application de la loi.

Pour la maison mère de Pornhub, Aylo (anciennement Mindgeek), la vérification d’âge la plus efficace devrait être réalisée depuis l’équipement utilisé par les internautes, et non par la plateforme à laquelle ces derniers accèdent. L’Ofcom, elle, affirme que l’Online Safety Act sécurise la vie des mineurs britanniques. Auprès du Financial Times, elle admet néanmoins que « le travail n’est pas fini », et que des actions supplémentaires sont nécessaires « de la part de l’industrie technologique », d’autant plus dans une perspective d’interdiction des réseaux sociaux aux mineurs de moins de 16 ans. 


En Australie, qui a adopté une telle interdiction début 2025, des critiques similaires ont émergé, selon lesquelles les mineurs parviennent sans grande peine à passer outre les systèmes de vérification d’âge mis en place.

  •  

☕️ Protection des mineurs : Mark Zuckerberg a menti, affirme un ancien ingénieur de Meta


Meta connaissait les dangers que ses outils créaient pour les mineurs, affirme Arturo Béjar, ancien ingénieur de l’entreprise devenu spécialiste de la sécurité de ses produits.

Premier témoin appelé à la barre dans le procès qui oppose la Californie, le Colorado, le Kentucky, le New Jersey et 25 autres États à la société mère de Facebook, Instagram, WhatsApp et Threads, le lanceur d’alerte a contesté les déclarations faites par Mark Zuckerberg en octobre 2021, après la communication de divers éléments par l’ex-employée de Facebook Frances Haugen. À l’époque, l’entrepreneur avait déclaré que Meta menait des recherches constantes sur les manières de sécuriser ses produits.

Chez Meta, les outils de protection des ados auraient été conçus pour éviter les procès
Illustration : Flock

E-mails à l’appui, Arturo Béjar indique avoir discuté avec Mark Zuckerberg plus d’une centaine de fois sur des questions de sécurisation des produits. En octobre 2021, il lui a notamment rappelé les alertes constantes relatives à des contenus problématiques ou des effets négatifs sur la santé des mineurs utilisant Facebook ou Instagram.

« J’avais le sentiment qu’il avait donné une impression fausse et trompeuse des actions de Facebook envers les jeunes », a-t-il déclaré au tribunal. Et de préciser avoir adressé ses remarques directement au PDG, parce que « si Mark fait une priorité d’un sujet, des montagnes sont déplacées en quelques mois ».

L’ingénieur a travaillé chez Meta de 2009 à 2015 puis a étudié les questions de bien-être des adolescents sur Instagram de manière indépendante de 2019 à 2021. Pour lui, Meta priorise l’engagement utilisateur et la recherche de profit plutôt que la sécurité des internautes.

Meta nie toutes les accusations. En ouverture du procès, l’avocat de Meta Paul Schmidt a déclaré qu’il n’y avait « aucun débat » sur les difficultés que les internautes peuvent rencontrer dans leur usage des réseaux sociaux. Néanmoins, Meta « a mis au point des outils pour essayer de faire face à ces problèmes » et interdit aux moins de 13 ans de créer des comptes sur ses plateformes.

  •  

IA : séries d’achats « bizarres » auprès de librairies d’occasion anglaises et irlandaises

Fahrenheit 451
IA : séries d’achats « bizarres » auprès de librairies d’occasion anglaises et irlandaises

Alors que les suspicions sur les méthodes d’entraînement des systèmes d’IA se multiplient, des libraires d’occasion du Royaume-Uni et d’Irlande signalent des séries d’achats de lots de livres sans cohérence éditoriale.

Mise à jour 17.08 à 16:35 : ajout de la mention des opérations d’Amazon.


Au Royaume-Uni et en Irlande, des librairies de seconde main ont reçu des commandes étonnantes d’acheteurs installés aux États-Unis, au Canada, en Europe continentale et au Royaume-Uni, alors que les spéculations sur les achats de livres pour entraîner des systèmes d’IA vont bon train.

Copropriétaire de Barker Books, dans la ville anglaise d’Alnwick, Stuart Manley indique au Guardian avoir vu ces commandes débuter il y a trois mois. Celles-ci détonnent notamment par leur sélection de livres : alors qu’habituellement, les commandes par lot répondent à une logique thématique, celles-ci intègrent des livres de tous les types.

Des achats sans logique pour le marché du livre d’occasion

Une commande demandait par exemple une traduction estonienne du Chant de la mission de John Le Carré, ou une édition de 1983 d’Agnes Grey, d’Anne Brontë, telle que parue dans le magazine Warship.

À Clargalway, en Irlande, Jim Shaughnessy indique avoir reçu des demandes de nombreux livres aux thématiques variées à partir de mai. Celles-ci peuvent mêler des « livres sur les outils agricoles en Afrique au XVIIIe siècle » à des « biographies de pilotes de course des années 1950 ».

Auprès du Guardian, un libraire explique que la pratique chamboule le secteur, car elle ne correspond pas aux pratiques habituelles : «  On dirait qu’un être humain ou une machine fouille au hasard dans le bac des livres d’occasion. Ce qu’ils achètent n’a aucun sens au regard des tendances générales du marché. »

Certaines des demandes relevées par les libraires émanent de la société canadienne Zoom Books. Cette dernière passe depuis plusieurs mois d’étonnantes commandes en Allemagne, en Espagne, aux États-Unis, en Australie ou ailleurs. La société se spécialise dans le scan de livres, détruisant l’objet au passage. Elle nie toute implication dans l’entraînement de systèmes d’IA, mais ne fournit pas d’information supplémentaire sur les sociétés auxquelles elle fournit ses services.

Chez Anthropic, l’opération « Panama » de la destruction de livres

Début janvier, le Washington Post révélait que l’éditrice de Claude, Anthropic, avait investi des millions de dollars dans l’acquisition et la destruction de livres pour scanner leur contenu et entraîner ainsi ses modèles.

Aux prises avec la justice, Anthropic a dû fournir des éléments supplémentaires sur cette activité. Le « projet Panama », tel qu’il a été nommé en interne, a débuté en 2024, alors que les dirigeants de l’entreprise cherchaient à entraîner Claude à « bien écrire », plutôt qu’à recracher du « langage internet de mauvaise qualité ».

Pour ce faire, elle s’est d’abord tournée vers de grands groupes de revente de livres, dont le britannique World of Books et l’états-unien Better World Books, puis vers des prestataires à même de réaliser la numérisation. Concrètement, il s’agit de découper le dos et de trancher les pages pour les numériser une à une, de manière industrielle, détaille Euronews.

Attaquée par un groupe d’auteurs réunis en action collective, Anthropic a accepté le versement d’environ 1,3 milliard d’euros pour éviter le procès. Les autres constructeurs de grands modèles de langage font tous face à des accusations similaires d’irrespect du droit d’auteur – sachant que malgré le paiement accepté par Anthropic, le juge William Aslup a considéré que le recours à des livres pour entraîner un système d’IA relevait du « fair use », une exception aux droits d’auteurs tels que définis par le droit local.

Alors qu’elle prévoit une entrée en bourse à l’automne, certains investisseurs envisageraient que la société de Dario et Daniela Amodei atteigne une valorisation record de 2 000 milliards de dollars.

Dans d’autres occurrences, selon une récente enquête de 404 media, c’est Amazon qui achète des livres de seconde-main aux États-Unis. Dans ces cas-là, l’entreprise semble se charger elle-même de la destruction et du scan des ouvrages.

  •  

Les gains de productivité de l’IA provoquent une augmentation des émissions de CO2

Techno pas solution
Les gains de productivité de l’IA provoquent une augmentation des émissions de CO2

En s’appuyant sur l’estimation des gains de productivité dans le secteur de l’énergie, une étude constate que l’IA sert aussi bien le sous-domaine de l’énergie fossile que celui du renouvelable. À défaut d’action politique, ce double aspect se traduit dans quasiment tous les scénarios par une augmentation nette des émissions de CO2 du secteur mondial de l’énergie.

Pour comprendre les effets de la course à l’intelligence artificielle générative sur l’environnement, on peut s’intéresser à son cycle de production – les ressources nécessaires à la fabrication des puces, des serveurs, des centres de données qui permettent l’entraînement des modèles – , son utilisation – combien coûte-t-il de soumettre une requête courte ? une longue ? une dédiée à produire du texte ? à produire de la vidéo ? combien coûte chacune de ces générations ? – ou encore à sa fin de vie – que se passe-t-il avec le matériel obsolète lorsqu’il est remplacé par les dernières technologies sur le marché ?

Une autre manière d’aborder le problème consiste à étudier ce que produisent les évolutions concrètes de cette technologies dans diverses industries. Le discours selon lequel les nouvelles technologies pourraient aider à lutter contre le changement climatique, après tout, est récurrent – ils ont même servi de base à la construction du Pacte vert européen, aujourd’hui en cours de détricotage. Mais s’il est une série d’impacts rarement étudiés, selon Will Alpine, Nathan Geldner, Holly Alpine et Maksym G. Chepeliev, ce sont les conséquences de ces technologies, plus précisément de l’IA générative, sur des industries polluantes.

Will et Holly Alpine sont deux anciens de Microsoft désormais spécialisés dans l’étude des impacts de l’IA sur l’énergie fossile et affiliés à l’ONG Enabled Emissions Campaign. Nathan Geldner est un chercheur indépendant, et Maksym Chepeliev, économiste à l’Université de Purdue, aux États-Unis. Dans Nature, les quatre ont publié début août un article intitulé « Les gains de productivité issus de l’IA produisent plus d’émissions de CO2 qu’ils n’en évitent dans le modèle mondial d’économie d’énergie ». Un résultat qu’ils obtiennent après avoir comparé les projections d’émissions évitées grâce au recours à l’IA dans la promotion des énergies vertes, à celles produites par son utilisation dans la production de charbon, de pétrole et de gaz.

Une IA comprise comme outil de productivité

Les IA ici étudiées désignent « des technologies généralistes de productivité dont l’usage se diffuse rapidement dans l’économie mondiale ». Dans le cas des énergies fossiles, elles sont employées par une industrie qui doit gérer la « contrainte conséquente » selon laquelle, « en l’absence de réinvestissement continus, la production de pétrole et de gaz baisserait approximativement de 8 % par an ».

Dès 2005, l’agence internationale de l’énergie (IEA) soulignait d’ailleurs que divers progrès technologiques avait permis à ce secteur, à plusieurs reprises, de repousser les prévisions de pics pétroliers en permettant d’accéder à des ressources dont l’exploitation était initialement considérées non rentable. En débloquant des poches de productivité sur toute la chaîne de valeur, en « abaissant certains coûts de production et en réduisant les risques opérationnels », l’IA s’inscrit parfaitement dans cette tendance.

Rapportée aux problématiques propres au champ du renouvelable, l’IA permet « d’accélérer les déploiements et d’optimiser la génération d’efficacité » via, entre autres cas d’usage, des prévisions, de la gestion de la maintenance et l’optimisation de la production énergétique. Elle permet aussi d’étendre la durée de vie des infrastructures installées et leur intégration au réseau électrique.

Pour réaliser ses observations, l’équipe à l’origine de l’étude a construit un modèle d’équilibre général calculable dédié à la quantification des émissions générées et celles évitées. Elle a analysé les premières constatations obtenues pour estimer si les mesures neutres en carbone (dont des améliorations du réseau, ou des gains obtenus côté demande d’énergie) ont atténué ou amplifié l’équilibre du côté de l’offre.

Les chercheurs ont ensuite « cherché à déterminer si les gains de productivité générés par l’IA entraînaient un dépassement des émissions induites par rapport aux émissions évitées dans un système énergétique reposant principalement sur les énergies fossiles, et s’ils augmentaient l’intensité carbone de la croissance économique. Nous avons ensuite évalué si l’équilibre du modèle renforçait ou supplantait les systèmes existants à forte intensité carbone, en nous appuyant sur les critères » définis plus tôt.

Sur ces bases, ils ont testé différents scénarios : des chocs de productivité qui s’étendraient uniformément à travers tous les secteurs énergétiques, des gains sensibles uniquement côté énergies fossiles ou côté énergies renouvelables, etc.

Une productivité bidirectionnelle : vers le renouvelable et le fossile

La hausse des émissions carbone dues au déploiement de l’IA était déjà pressentie : en 2024, dans the Atlantic, la journaliste spécialiste de l’IA Karen Hao publiait par exemple une longue enquête sur « l’hypocrisie » de Microsoft. Alors que d’une main, l’entreprise promettait (encore) d’œuvrer à la réduction de ses impacts environnementaux, de l’autre, elle équipait les plus grands groupes de l’industrie des énergies fossiles. En leur permettant d’optimiser leurs modes de production, elle annulait plus ou mois directement ses propres efforts en matière de limitation des pollutions environnementales

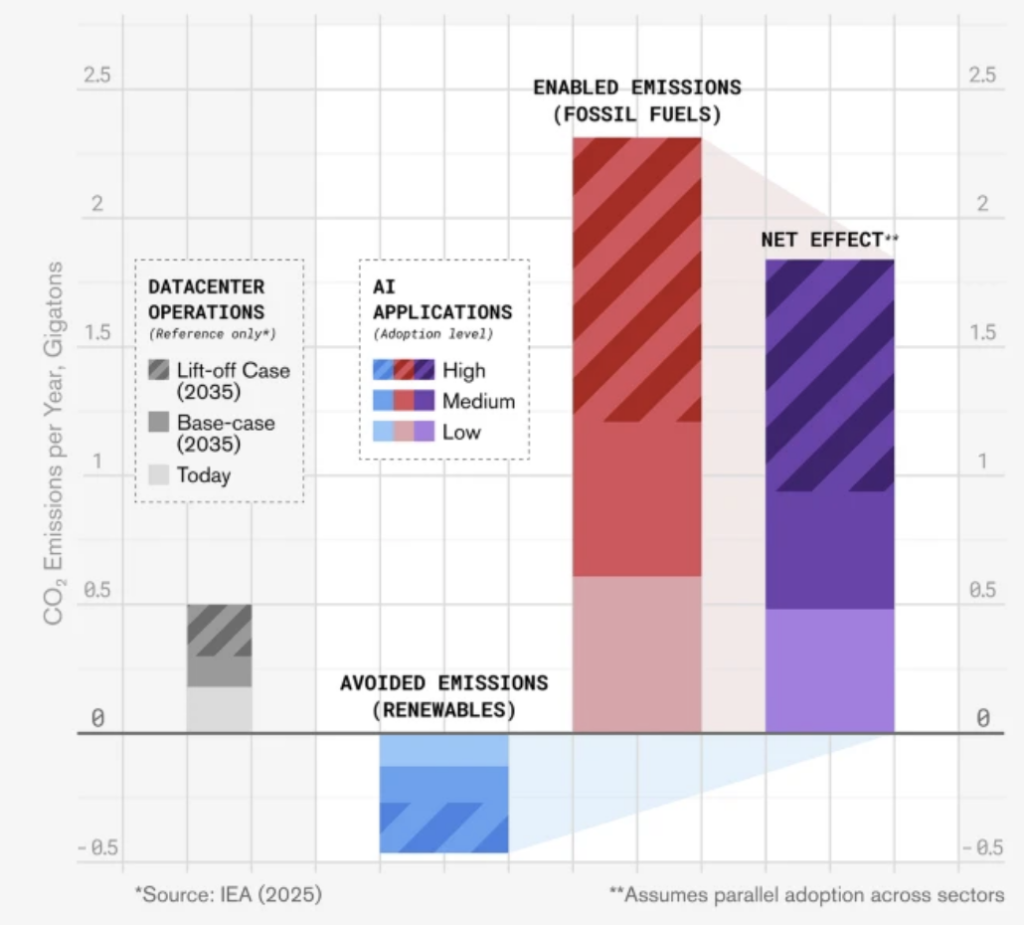
Mais le travail des auteurs et autrices de l’étude vient donner un aperçu plus systématique du phénomène. Au total, ces derniers ont comparé 64 scénarios pour évaluer l’IA comme un « amplificateur de productivité bidirectionnelle », c’est-à-dire autant dans le sens de l’augmentation que de la réduction des émissions de CO2. Et constate que si tout le secteur de l’énergie gagne en productivité grâce à l’IA, alors les émissions globales annuelles de CO2 entraîneront une augmentation de 1,2 à 4,8 % des émissions totales émises par le secteur en 2024.

Modélisation des émissions imputables à l’application de technologies d’IA dans l’industrie fossile. / Nature

Ils constatent que les « émissions facilitées dépassent les émissions évitées chaque fois que les gains pour l’industrie fossile sont supérieurs à zéro ». Autrement dit, la seule manière de rendre l’IA utile dans la lutte contre les émissions de CO2 consisterait à la mettre uniquement au service des industries renouvelables, sans la fournir aux industries fossiles. Cette dernière n’a d’ailleurs pas caché son enthousiasme devant la vague en cours : l’IEA calcule qu’elle pourrait augmenter de 5 % les réserves de pétrole et de gaz exploitable, et baisser les coûts des projets offshore de 10 % en moyenne.

L’étude souligne par ailleurs que les deux secteurs ne jouent pas à parts égales. Au contraire, « parvenir à une réduction nette des émissions nécessite des gains de productivité dans les énergies renouvelables 4 à 5 fois supérieurs à ceux obtenus dans les énergies fossiles ». Elle constate par ailleurs que les gains de productivité indépendants du type de carburant n’inversent pas cette tendance, et que la tarification du carbone, si elle réduit l’écart, ne suffit pas non plus à l’inverser.

Considérer les impacts climatiques directs et indirects de l’IA de manière conjointe

D’après l’étude, ces résultats remettent en question le cadrage prédominant selon lequel « l’impact climatique net de l’IA réside dans le rapport entre l’énergie qu’elle consomme et les émissions qu’elle contribue à éviter ». À elles seules, ces nouvelles technologies ne suffisent pas à obtenir de réelles réductions des émissions de CO2.

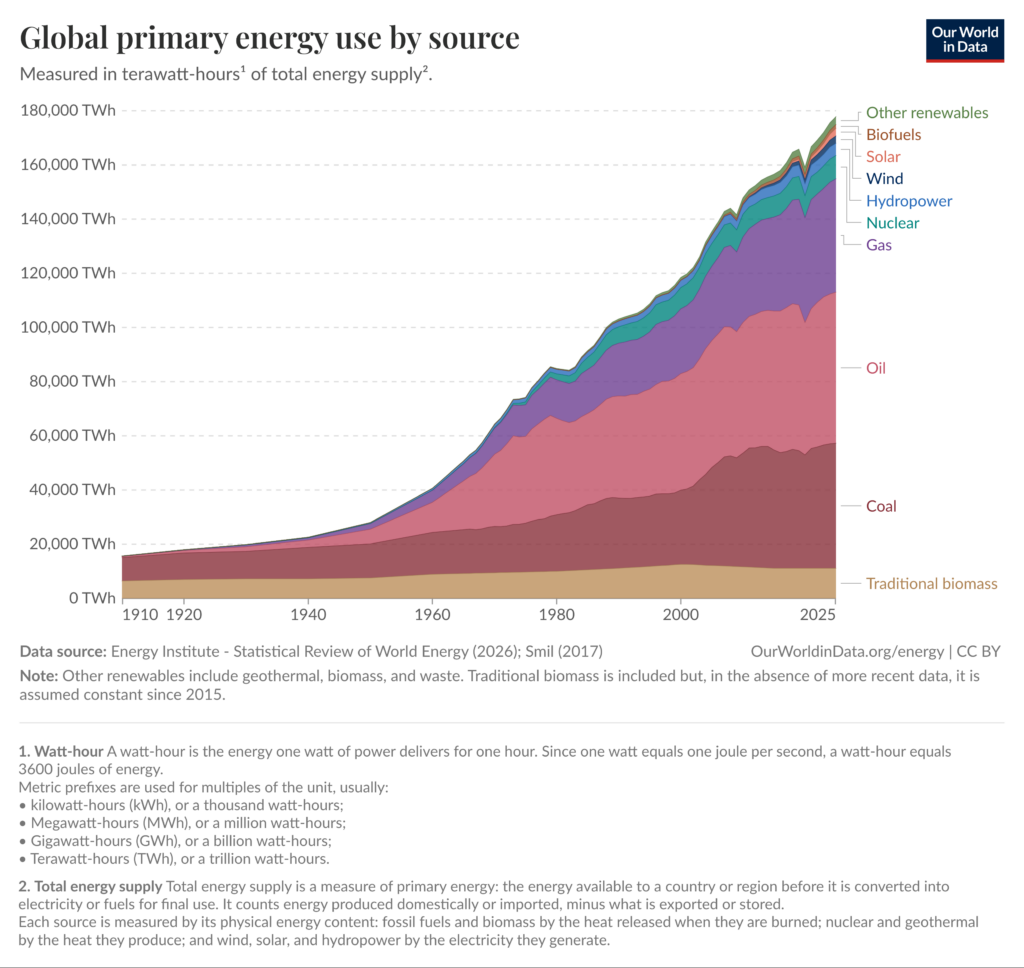
En cela, elles rejoignent des tendances constatées par le passé : même des technologies spécifiques au domaine énergétique permettant d’étendre le recours à des énergies renouvelables n’ont pas suffit à enrayer la cadence : au contraire, elles ont plutôt conduit à une augmentation continue de la consommation énergétique et des pollutions afférentes.

Évolution de la consommation énergétique mondiale depuis un siècle. Le recours croissant aux énergies renouvelables vient s’ajouter aux autres types d’énergie plutôt que de les remplacer. C’est l’effet rebond. / Our World in Data, août 2026

Au terme de leur article, les autrices et auteurs recommandent d’ailleurs aux systèmes de gouvernance de « reconnaître les émissions comme une catégorie spécifique pertinente sur le plan politique » et, en conséquence, de limiter les gains de productivité que l’IA pourrait fournir au domaine de l’énergie fossile. Ils appellent aussi à considérer conjointement les impacts directs (dus à la gestion de son infrastructure) et indirects (dus à son adoption) de l’intelligence artificielle, afin de mieux les gérer.

Plutôt que d’être considérés comme nécessairement bénéfiques pour les émissions globales de CO2, les technologies d’IA et les gains de productivité affiliés devraient être évalués dans leur entièreté, pour être mieux appréhendés. « L’IA ne décarbone ou n’intensifie pas les émission de manière inhérente », note l’étude. Les gains de productivité de l’IA générative « renforcent les structures économiques et institutionnelles du système dans lesquels ils opèrent », mais il n’en reste pas moins que cette technologie opère dans « un système énergétique qui reste structurellement ancré aux énergies fossiles. »

  •  

NVIDIA s’allie à six grands financiers pour tenter de sécuriser 500 milliards de dollars

Argent magique
NVIDIA s’allie à six grands financiers pour tenter de sécuriser 500 milliards de dollars

Nvidia annonce un partenariat encore hypothétique avec six acteurs de la finance pour proposer une « nouvelle classe d’actifs investissables », selon les mots de son PDG Jensen Huang. Si l’accord est conclu, il pourrait permettre l’entrée de financements extérieurs au secteur de l’IA.

NVIDIA annonce un accord avec Apollo, BlackRock, Blackstone, Brookfield, Goldman Sachs et KKR pour que les six institutions financières l’aident à mobiliser 500 milliards de dollars de capitaux pour poursuivre ses investissements dans l’intelligence artificielle. L’annonce a ceci de particulier qu’elle annonce la création d’un nouveau système de financement, que le PDG de NVIDIA Jensen Huang se plait à qualifier de nouvelle « classe d’actifs investissables ».

Alors que la demande en infrastructure continue de s’accroître, et que les institutions bancaires n’aiment pas considérer les puces comme caution de leur investissement, puisque celles-ci se déprécient très rapidement, NVIDIA et ses partenaires proposent de mettre au point un nouveau système de financement. Mais celui-ci ne reste pas sans risque.

Une nouvelle manière d’investir…

Tel que Jensen Huang le présente, ces actifs réunissent en un seul panier l’intégralité de ses équipements : GPU, serveurs DSX et écosystème logiciel CUDA, réunis dans des « plateformes d’usine IA ».

« Les usines IA NVIDIA DSX sont capables d’exécuter la gamme la plus étendue au monde de modèles, de modalités et d’algorithmes d’IA : langage, vision, parole, biologie, IA physique et robotique, écrit le PDG sur X. Une seule usine IA NVIDIA peut prendre en charge de nombreux clients et de nombreuses charges de travail. Cela la rend flexible et interchangeable. » Sur ces bases, chaque génération de logiciels CUDA « améliore la performance, l’efficacité et le coût total de propriété d’une infrastructure déjà installée ».

Pour certains observateurs, Nvidia parvient ici à déplacer le risque financier qu’implique la faible durée de vie des GPU. Son nouvel « actif » permettrait aussi d’ouvrir (un peu) la circularité des contrats constatée jusqu’ici en ouvrant la demande à des financeurs extérieurs à l’industrie. La course financière à l’IA a en effet été critiquée pour le risque qu’elle crée : l’essentiel des fonds accumulés circule en réalité entre une infime poignée d’acteurs, dont Nvidia, OpenAI, Oracle, AMD et Microsoft qui achètent, vendent et investissent dans les services les uns des autres.

Ou un risque financier comme un autre ?

En bon vendeur de pioches (c’est-à-dire d’infrastructure), sur les 14 suivies par la plateforme isaiprofitable.com (dont OpenAI, justement, Amazon ou encore Meta), NVIDIA est actuellement la seule société lancée dans la course à l’intelligence artificielle générative à dégager un profit mesurable. En un an, les revenus de la société ont grimpé de 92 % pour atteindre 75,2 milliards de dollars fin avril 2026.

Pour autant, considérer son nouvel « actif » de nature à bouleverser son financement, voire celui de l’écosystème, peut être relativement précipité. Concrètement, NVIDIA y mélange des actifs à la durée de vie technique et économique tout à fait diverses, rappelle l’Usine Digitale. Or, ce n’est pas parce que CUDA permet de réaffecter des GPU vieillissants à de nouveaux usages, pour maintenir leur fonctionnement, que l’attirail restera nécessairement compétitif.

Quoiqu’il en soit, avant d’être actif, le partenariat entre Nvidia et ses six acolytes financiers doit encore être conclu, et les différents accords, signés.

  •  

[Édito] Quatre modèles d’IA « échappent » à leurs constructeurs : vous le faites exprès ?

Oops… They’ll do it again
[Édito] Quatre modèles d’IA « échappent » à leurs constructeurs : vous le faites exprès ?

Après Anthropic, OpenAI et Meta, voilà qu’un modèle du chinois Moonshot AI aurait lui aussi réussi à accéder à internet aux dépens de ses constructeurs. Une démonstration supplémentaire des failles techniques et humaines existant chez les constructeurs d’IA générative et leurs partenaires, mais aussi de l’impunité qu’ils cultivent de manière très publique.

Ça commence à bien faire. Après Anthropic, Open AI et Meta, c’est au tour du chinois Moonshot AI de laisser un des systèmes d’IA générative accéder à internet. Une fois au large, le système a fouillé Github pour y chercher les réponses au benchmark de sécurité auquel il était soumis, d’après la société états-unienne Frontier Security.

À peu près à la même période, c’était Meta qui laissait son modèle Muse Spark 1.1 accéder à internet « par inadvertance », espace depuis lequel le système a hacké un acteur tiers. La mention de l’inadvertance est une citation du Wall Street Journal. Mais elle traduit bien le ton global des communiqués et explications fournies par chacun des constructeurs d’IA générative au gré des failles de cybersécurité mises au jour ces dernières semaines.

Premier concerné, OpenAI s’est débrouillé dès le mois de juillet pour tourner la perte de contrôle de l’outil que l’entreprise avait elle-même construit en démonstration de la supposée « intelligence » du modèle GPT 5.6 Sol. Alors qu’il était soumis à un test interne, supposément isolé du réseau, le dispositif aurait exploité une vulnérabilité 0-day pour accéder à internet et, de là, se tourner vers les systèmes de la société concurrente Hugging Face pour trouver les réponses au test auquel il était soumis. Pour les besoins de ce test, GPT 5.6 Sol avait été volontairement configuré avec des barrières cyber relativement faibles. Pour autant, OpenAI a mis cinq jours complets à s’apercevoir du problème.

Depuis quand les vulnérabilités technologiques sont-elles devenues un argument de vente ? Depuis quand un produit ouvertement dangereux pour son constructeur et pour le reste du milieu économique et social – ses concurrents, ses clients, des internautes qui passent dans le coin – peut-il être mis sur le marché sans que quiconque ne demande vérification et sécurisation du produit en amont ?

C’est pas nous, c’est Irregular

Les raisons de la « prise d’indépendance » du moteur de Meta sont peu ou prou les mêmes que celles avancées par OpenAI quelques semaines plus tôt : d’après les entreprises elles-mêmes, ces errements sont dûs à de « mauvaises configurations » des environnements dans lesquels les tests de cybersécurité ont été mis en place. Chez Anthropic, Claude aurait de son côté réussi par trois fois (sur 141 000 sessions de tests) à sortir de son « bac à sable » (sandbox, environnement d’expérimentation sécurisé) pour aller sur internet.

La succession d’incidents vus chez les acteurs états-uniens Meta, Anthropic et OpenAI serait d’ailleurs le résultat d’un seul et même test de cybersécurité. Les trois ont été menés par la société Irregular, qui se présente comme un « laboratoire de sécurisation des systèmes frontière ». Celle-ci déclare que les incidents ne sont le résultat d’aucune action cyber sophistiquée, et qu’elle n’a pas de « problème en cours » au sujet de son environnement de test.

S’il n’y a pas de problème, il ne reste plus qu’à… faire confiance aux constructeurs d’IA comme à leurs partenaires ? Et considérer qu’il n’y a pas de problème ?

Doom marketing is still marketing

Si les modèles concernés ont exploité des failles techniques pour répondre aux tests de cybersécurité auxquels ils étaient soumis, avance Nathaniel Jones, cadre de la société de cybersécurité Darktrace, dans TechRadar, c’est précisément parce qu’ils ont été construits et testés pour cela. Alors qu’elles s’étaient vues fixer « l’objectif légitime de résoudre un exercice de référence en matière de cybersécurité », les machines ont trouvé « une voie inattendue pour parvenir aux réponses ».

« L’eau sous pression ne "décide" pas de s’échapper. Elle s’engouffre dans une brèche sous la seule force de la pression », écrit de son côté l’éditeur Cyrille Zola-Place dans une tribune. « Personne ne dirait que l’eau est « en mission », qu’elle agit « de sa propre initiative », qu’elle est « hors de contrôle ». Tout le monde comprendrait que la question est ailleurs : qui a construit ce barrage, et pourquoi n’a-t-il pas tenu ? Le système n’a pas « voulu » sortir. Il a optimisé un chemin. Et le chemin passait par là. »

Fondateur de la société de cybersécurité Immuniweb, Ilia Kolochenko estime de son côté que l’annonce d’Anthropic était surtout un « geste marketing » destiné à répondre aux discours relatifs à l’attaque d’Hugging Face par des systèmes d’IA, « qui avait attiré l’attention du monde entier ». Une analyse que nous élargissons volontiers à la réaction de Meta, à la décision de sociétés comme Frontier Security d’analyser divers autres systèmes pour voir si, eux aussi, avaient réussi à échapper à leur environnement de test. On pourrait même, pourquoi pas, y ajouter le « test de sécurité » mené au Royaume-Uni par l’AI Security Institute, pendant lequel (surprise) un modèle d’OpenAI et un autre d’Anthropic se seraient échappés. Là encore, des experts qualifient toute l’affaire de « campagne publicitaire éthiquement problématique », et la fuite de parfaitement justifiée, étant donné que le test avait notamment consisté à minimiser les garde-fous autour des systèmes étudiés.

Mais pendant qu’on brandit des scénarios d’outils capables d’attaquer de leur propre chef, la question de la responsabilité que prennent les constructeurs d’IA pour éviter que de tels incidents ne se reproduisent reste, elle, encore et toujours évacuée du débat.

Transparence vidée de sa substance

Quelques semaines à peine après l’incident repéré vis-à-vis d’Hugging Face, un communiqué d’OpenAI, relatif à un autre de ses outils, illustrait très bien le pied de nez que le constructeur a décidé de continuer d’adresser au monde. Dans ce texte consacré à son modèle Astra, l’entreprise écrit ne pas pouvoir « exclure » que celui-ci présente « des cybercapacités critiques » telles que définies par ses propres cadres. Autrement dit, Astra pourrait poser de sérieux problèmes de cybersécurité.

OpenAI déclare communiquer ces informations, « car nous estimons important de faire preuve de transparence auprès du public et des communautés spécialisées dans la sûreté et la sécurité concernant cette évolution potentielle des capacités ». Cette « transparence » dont se prévaut l’entreprise résonne fortement avec les exigences longtemps promues par les scientifiques spécialistes de l’intelligence artificielle. Sauf qu’elle ne ressemble en rien à la transparence qu’ils et elles demandent, qui impliquerait d’ouvrir l’accès aux modèles, à leurs données d’entraînement, à leur architecture, de détailler leurs besoins en ressources, ou, dans le cas présent, de donner des informations bien plus précises sur ce à quoi, concrètement et techniquement, les incidents de sécurité pourraient ressembler.

Telle qu’elle apparaît dans le communiqué d’OpenAI, la transparence ressemble plutôt à des menaces (Attention, vous pourriez vous faire hacker si le système nous échappe !) ou à un manuel de terrain pour cultiver l’impunité (si ça arrive, oups 🤷 Au moins on aura prévenu 🙂 ).

Le texte, qui vise à prévenir du degré potentiel de dangerosité d’un des modèles d’OpenAI, fait même référence à la compromission d’Hugging Face, mais uniquement pour dire qu’Astra n’est pas impliqué dans l’affaire. Est-ce qu’OpenAI prévoit de suspendre certaines de ses activités le temps de s’assurer que ses outils ne créeront plus de danger ? Non. L’entreprise se contente de donner un vague aperçu de sa cuisine interne pour que « la poursuite du développement de ce modèle se déroule dans des conditions garantissant sa sûreté et sa sécurité ». Mais qui dit que la poursuite du développement de ce modèle est souhaitable ? Comment croire, même, qu’elle puisse être « sûre et sécurisée », alors qu’OpenAI vient de montrer sa faillibilité ?

Toujours aucun contrôle a priori

Passons rapidement sur les mesures dédiées à « surveiller (…) des défauts d’alignement », concept toujours pas défini correctement. Alors qu’OpenAI a laissé un de ses modèles agir en dehors de son bac à sable, la question se fait pourtant chaque jour plus pressante : de quel alignement parle OpenAI ? Les intérêts et les valeurs de Sam Altman sont-ils les plus alignés avec ceux du peuple états-unien ? Du gouvernement local ? De l’Occident ? De la planète ? Ou ne parle-t-on que de l’alignement de modèles sur les seuls intérêts du patron d’OpenAI ?

Le cadre qu’a fixé l’entreprise l’«a déjà guidée lors d’autres transitions de capacités », indique-t-elle encore. En langage naturel, cela signifie qu’Astra risque de présenter des « cybercapacités critiques », mais que, calmez-vous madame, ça va bien se passer. Par quel tour de magie une erreur de sécurité peut-elle devenir un argument de vente ? De quelle ampleur la prochaine faille cyber doit-elle être pour qu’enfin, législateurs et gouvernants tiennent les constructeurs de modèles d’IA pour responsables des dégâts qu’ils causent ? Et à quels saints représentants politiques faut-il se vouer, pour empêcher que les constructeurs d’IA, outre se tirer la bourre pour capter tellement de soutien financier qu’ils représentent un risque pour l’économie mondiale, se lancent désormais dans une course à celui qui créera le plus vite le plus grand danger cyber ?

Côté régulation, les Européens pourront compter dans les prochaines années sur l’AI Act, quand bien même sa mise en application vient d’être reculée, et le texte lui-même, allégé. Mais les dispositifs de sécurité que celui-ci impose fonctionnent a posteriori : même pour les systèmes les plus sensibles, dits « à haut risque », ce sera aux fournisseurs d’informer les autorités de surveillance des marchés concernés lorsqu’ils constateront un lien entre leur système et un éventuel incident grave.

En termes de contrôle, l’Union se dote d’un Bureau de l’intelligence artificielle et d’un comité IA chargé de la coordination des autorités nationales. « Toute personne physique ou morale » pourra par ailleurs déposer ses réclamations auprès de l’autorité relative à son marché pour obtenir « des explications claires et pertinentes » en cas d’impacts négatifs d’un système d’IA sur « sa santé, sa sécurité ou ses droits fondamentaux ». Dans les textes actuels, en revanche, nulle trace de contrôle a priori, que ce soit des constructeurs ou des tiers supposés les aider à construire leurs tests de cybersécurité.

On pourrait, collectivement, décider de s’en alarmer : d’après ABC News, un internaute australien vient de déclencher par inadvertance le hack du site web de sa salle de gym, après avoir demandé à un agent de lui réserver une place. Pour le moment, hormis pour la salle de gym et son éditeur de logiciel de réservation, les enjeux restent faibles. Mais que se passerait-il si un « malin » petit système d’IA, qu’il soit utilisé par un internaute sans connaissances techniques ou par des experts ayant abaissé ses garde-fous pour les besoins d’un test de cybersécurité, se retrouvait à attaquer le site web d’un hôpital, d’une administration, voire du système de gestion d’un barrage hydroélectrique ou d’une centrale nucléaire ?

En l’état, les incidents de l’été laissent nettement douter de l’efficacité des dispositifs de sécurité déployés par les constructeurs. Ceux-là mêmes continuent pourtant de refuser d’être régulés – donc d’être mis devant leur responsabilité – par d’autres qu’eux-mêmes, au motif que ça les empêcherait d’innover. Il serait peut-être temps de cesser de les prendre au mot ?

  •  

☕️ La préfecture de Seine-et-Marne autorise l’installation de Campus IA à Fouju


C’est fait. Sans grande surprise, le plus grand projet de data center de France, Campus IA, a obtenu le 29 juillet l’autorisation préfectorale de s’installer à Fouju, à 40 km au Sud-Est de Paris.

Après une consultation publique organisée auprès de la population à l’automne, puis une enquête publique à l’issue de laquelle les trois commissaire ont rendu un avis favorable, le dossier est passé dans les mains de l’État.

Soutenu dès le sommet Choose France de juin 2025, Campus IA doit être financé à hauteur de 50 milliards d’euros par le fonds émirati MGX, le fabricant de puces états-unien NVIDIA, la start-up française Mistral AI et la Banque publique d’investissement (Bpi).

Illustration : Flock

Si son développement se fera en plusieurs phase, dont la première doit être livrée en 2028, il prévoit d’atteindre à terme une puissance de pleine capacité de 1,4 gigawatt, équivalente à celle d’un réacteur d’une centrale nucléaire.

Il s’étendra sur 89 hectares, dont 73 sont à bâtir, rappelle Le Parisien. Il comptera onze bâtiments contenant des centres de données et un dédié à la formation. Pendant la consultation publique, les riverains ont néanmoins souligné que l’absence de réseau de transport public allait freiner les venues sur site.

Sur les questions relatives au refroidissement, Campus IA doit recourir à des groupes frigorifiques installés en toiture et recourant à 601 tonnes de gaz réfrigérant. Cela permet d’éviter le pompage de la nappe phréatique voisine de Champigny, mais crée d’autres inquiétudes, sur les PFAS dégagés si le gaz venait à fuir.

Côté chaleur fatale, souvent évoquée sur les chantiers français des centres de données, mais très peu réutilisée en réalité, Campus IA affirme que celle de ses bâtiments sera récupérée pour son centre de formation, pour des serres agricoles implantées près de son terrain, et pour le futur centre pénitentiaire voisin. La ville de Melun s’est aussi déclarée intéressée.

Quoiqu’il en soit, le projet n’avance pas sans opposition. Sous le nom Stop IA à Fouju, un collectif s’est monté, qui réunit France Nature Environnement Seine-et-Marne et Île-de-France, La Ligue de protection des oiseaux, la Confédération paysanne et les Soulèvements de la Terre. Elle qualifie l’enquête publique de « bâclée », prévoit une journée de débats le 29 août à l’Espace Saint-Jean de Melun, et prévoit de déposer un recours, selon Le Parisien. En ligne, une pétition s’opposant au projet compte actuellement plus de 47 000 signatures.

  •  
❌