❌

Vue lecture

Muse peut donner votre adresse à n’importe qui ou fouiller vos messages sans permission

La vie privée, concept de vieux con ?
Muse peut donner votre adresse à n’importe qui ou fouiller vos messages sans permission

Meta a récemment lancé son agent IA, Muse. Mais des utilisateurs se plaignent qu’il agit de façon problématique concernant leurs données personnelles, en livrant par exemple une adresse postale ou en analysant des messages auxquels il ne devrait pas avoir accès.

Muse, qui, de l’aveu même du responsable produit chez Meta Superintelligence Labs est très grandement inspiré d’OpenClaw, semble avoir les mêmes problèmes considérant les informations de ses utilisateurs : une propension à les utiliser sans vergogne, sans en avoir la permission.

Côté OpenClaw, les utilisateurs étaient prévenus. La documentation du projet open source expliquait clairement que l’agent IA mis en place pouvait utiliser des données pour faire tout et n’importe quoi et même écrivait noir sur blanc qu’il « n’y a pas de configuration « parfaitement sécurisée » ». Quelques temps après sa sortie, NVIDIA proposait même un projet nommé NemoClaw qui essayait de canaliser OpenClaw.

Un rendez-vous avec un inconnu à votre adresse sans que vous soyez au courant

Mais, avec Muse, Meta a passé un cap en proposant le même genre d’agent en version grand public. On pourrait s’attendre, avec ce genre de version, que le côté « à vos risques et péril » s’efface. Cela ne semble pas le cas.

Pourtant, dans la FAQ accompagnant Muse, à la question « Muse me demande-t-elle mon accord avant d’agir en mon nom ? », Meta répond « Oui. Muse est conçue pour vous demander votre autorisation avant d’effectuer certaines actions, comme envoyer des messages, effectuer des achats ou partager des informations avec une application connectée. Vous pouvez choisir d’autoriser une action une seule fois, de l’autoriser systématiquement ou de la refuser ».

Mais il est difficile pour Meta de prévoir toutes les actions qui doivent passer sous la fourche caudine de la restriction de la divulgation d’informations privées.

Ainsi, comme le raconte sur Threads l’utilisateur Matt Robb, il a laissé Muse gérer pour lui toute la discussion pour la vente d’un de ses claviers sur Facebook Marketplace. Sauf que l’agent IA de Meta a proposé un prix cassé et donné rendez-vous chez lui à l’acheteur sans que Matt Robb ne le sache. Celui-ci n’était pas physiquement présent et donc l’acheteur est reparti bredouille, après s’être déplacé et avoir attendu une vingtaine de minutes. Surtout, comme il l’indique au Guardian, si Matt Robb avait indiqué son adresse sur son annonce dans le Marketplace, il n’avait pas autorisé Muse à la partager à d’éventuels acheteurs.

Des messages consultés et stockés au mépris du refus de l’utilisateur

Mais ce n’est pas tout. Le journaliste de Inc., Jason Aten, a testé Muse sur son iPhone et son Mac. Et il s’est rendu compte que l’agent utilisait du contenu provenant de ses conversations sur l’application Messages d’Apple, sans y être autorisé. Et ce malgré le choix explicite de ne pas laisser à Muse d’accès à ses messages mais aussi à son agenda et à d’autres informations personnelles.

Après avoir demandé à l’outil, celui-ci a généré une réponse suggérant que Muse récupérait les données dans les notifications : « Lorsqu’une notification s’affiche sur votre Mac appairé, le texte de cette notification m’est transmis – en gros, ce que vous verriez dans la bannière elle-même », puis un autre assurant : « Je ne peux pas ouvrir ton application Messages, faire défiler les fils de discussion ni consulter l’historique. Je ne vois que le flux des notifications entrantes, je n’ai pas accès à tes messages ». Sauf qu’un message généré par un agent IA, même sur son fonctionnement, n’est pas forcément vrai.

En creusant un peu dans les fichiers de Muse, Jason Aten a bien repéré que Muse avait synchronisé 187 462 lignes issues de la base de données de Message. Dans un post sur Threads, il partage un extrait d’un fichier montrant que les données proviennent bien de l’application Messages. L’utilisateur affirme qu’il n’avait pas activé l’accès complet à son disque dur pour Muse, tandis que Meta n’a pas répondu à ses questions.

David Singleton, le responsable des Meta Superintelligence Labs, a de son côté promis que Muse avait été conçue « en accordant une grande importance à la sécurité et à la confidentialité ». « L’intégration de Messages dans l’application Muse pour Mac est facultative. Votre application Muse ne peut lire le contenu de Messages que si l’accès complet au disque au niveau du système macOS est accordé et si le connecteur Messages est activé », a-t-il ajouté. Comme dit plus haut, Jason Aten assure ne pas l’avoir activé.

  •  

L’Allemagne se lance concrètement pour sauver les données climatiques menacées par Trump

Retten wir die Daten
L’Allemagne se lance concrètement pour sauver les données climatiques menacées par Trump

L’Allemagne se lance dans la résilience des données scientifiques sur le climat en finançant plusieurs projets et en mettant à disposition son data center créé en 2022 pour abriter les données allemandes sur le sujet. Reste que les financements ne sont pour l’instant pas pérennes et devront être renouvelés après 2027.

Depuis le retour de Donald Trump au pouvoir, les données sur le climat stockées par les États-Unis sont menacées. Les chercheuses et chercheurs allemands mettent maintenant en place des infrastructures pour les protéger.

Dès janvier 2025, des chercheurs et militants états-uniens ont essayé de prémunir les informations et données des agences de leur suppression. Mais l’attaque de l’administration Trump contre les données scientifiques est massive. 375 jeux de données ont déjà été touchés, selon le relevé du projet dataindex.us. Politico vient de son côté de révéler que des associations conservatrices traquent les chercheurs américains sur le climat en faisant nombre de demandes d’accès à des documents administratifs.

En Europe, une certaine volonté de les aider est affichée. L’année dernière, le directeur général délégué à la science du CNRS, Alain Schuhl affirmait que les bases de données sont « l’urgence absolue ». Mais, depuis, la plus importante structure scientifique française a encore vu son budget baisser avec le constat d’ « un net désengagement de l’État ». Et aucun projet de financement français ne semble émerger alors que la direction du CNRS s’est lancée dans une réorganisation du monde de la recherche.

Concrétisation en Allemagne

C’est d’outre-Rhin que des initiatives plus concrètes semblent arriver. Ainsi, comme l’explique le magazine de l’École de l’environnement de Yale, plusieurs racks qui vont être ajoutés dans le German Climate Computing Center (DKRZ) pour accueillir les données jusque-là stockées par les laboratoires américains. Les capacités de stockage du DKRZ, actuellement de 254 pétaoctets, se voient augmenter de 5 pétaoctets qui doivent être alloués à la sauvegarde des données venant des projets américains.

La Fondation allemande pour la recherche (DFG) a obtenu de son gouvernement des financements visant à sécuriser les référentiels de données menacés et à promouvoir la résilience des données. En tout, l’Allemagne prévoit de financer 10 projets autour de cette « résiliences des données ».

Le projet SEND Earth Data va, par exemple, identifier les jeux de données et les services à risque et mettre en place des systèmes de redondance « là où cela s’avère nécessaire et en élaborant des stratégies durables pour leur conservation et leur accessibilité à long terme ». L’idée n’est pas seulement de faire des backups mais d’instaurer des standards pour l’acquisition des données, s’assurer de leur qualité, de leur enrichissement par des métadonnées et de leur conservation à long terme.

Certains chercheurs allemands ont déjà identifié des besoins. Ainsi, un autre projet, nommé CMIP7-ark, a prévu de mettre en place sur le DKRZ ce qu’ils appellent une « zone de réplication d’urgence » pour « dupliquer les flux de données américains hautement prioritaires dès leur publication » concernant le CMIP7, un projet international de comparaison des modèles climatiques.

« Bien que les données soient diffusées par l’intermédiaire de l’Earth System Grid Federation (ESGF), les faiblesses structurelles et les coupes budgétaires prévues au sein des agences scientifiques américaines (NASA, NOAA, NCAR, DOE) menacent la stabilité opérationnelle de leurs nœuds de données locaux », expliquent-ils. « Toute interruption de l’accès créerait un « vide de données » critique, entravant gravement les capacités de recherche allemandes en matière de détection de signaux climatiques à haute résolution et de modélisation comparative du système terrestre ».

Des projets de résilience des données au-delà du climat

Les projets de « résilience des données » ne s’arrêtent pas au climat. Ainsi, le biologiste Lorenz Christian Reimer a convaincu la DFG de financer l’intégration des données de transcriptions de gènes du projet RegulonDB, créé en 1998 et financé jusqu’à récemment par le NIH américain, dans l’outil DSMZ Digital Diversity géré par son équipe.

La DFG finance aussi un projet qui veut « répondre au besoin urgent de créer une plateforme européenne dédiée au dépôt des données biomoléculaires de résonance magnétique nucléaire (RMN), actuellement stockées, annotées et gérées par le BMRB aux États-Unis ».

Mais un financement non pérenne

L’Allemagne semble donc avoir mis les mains dans le cambouis de la « résilience » des données de la science, jusque-là très souvent stockées par les diverses agences états-uniennes. Si on peut saluer l’effort, notons quand même que la DFG souligne dans ses « guidelines » [PDF] que « cette initiative de financement est limitée aux années 2026 et 2027 » et que les « projets peuvent bénéficier d’un financement jusqu’au 31 décembre 2027 au plus tard ; cette date marque également la fin de la durée du projet ».

Ce financement « par projet », qui s’est généralisé depuis des années dans la recherche européenne et qui limite sa portée à quelques années, est en contradiction avec la résilience des données qui demande que l’engagement de financement s’étale sur le long terme. Les chercheurs qui les portent vont devoir espérer que d’autres institutions, allemandes ou européennes, acceptent de reprendre le flambeau.

  •  

Polymarket attaquée par l’État de New York pour activité illégale de jeux d’argent

Jeux de dupes
Polymarket attaquée par l’État de New York pour activité illégale de jeux d’argent

L’État de New York, gouverné par la démocrate Kathy Hochul, vient de déposer plainte contre Polymarket, l’accusant de violer ses lois contre les jeux d’argent. Une pierre dans le jardin de l’administration Trump qui se refuse à réguler fédéralement les plateformes qui se présentent comme des marchés prédictifs.

Polymarket est attaqué en justice par la gouverneure démocrate de l’État de New York, Kathy Hochul, et l’avocate générale du même État, Letitia James, « pour avoir exploité une activité de jeux d’argent illégale à New York par le biais de sa plateforme de marché prédictif ».

Des lois encadrant les paris contournées, selon l’État

Dans un communiqué commun, elles affirment que « le marché prédictif de Polymarket constitue une activité de jeux d’argent illégale et non agréée qui expose les New-Yorkais — y compris ceux qui n’ont pas encore atteint l’âge légal de 21 ans pour jouer — à de graves risques personnels et financiers ».

La plainte [PDF] rappelle que le groupe de Polymarket serait estimée à plus de 20 milliards de dollars et son chiffre d’affaires annuel dépasserait largement le milliard de dollars. Mais elle « chercherait à éviter les conséquences juridiques et financières de la réglementation stricte des jeux d’argent en vigueur à New York en proposant ce qui relève essentiellement du pari sous le couvert de « contrats d’événement » sur un « marché prédictif » ». Selon le document, Polymarket violerait ainsi de façon « flagrante la Constitution de l’État de New York, le code pénal et d’autres lois de cet État ».

« Nos lois sur les jeux d’argent ont pour but de protéger les New-Yorkais, de prévenir les risques liés à la dépendance au jeu et de garantir le financement de programmes éducatifs et d’intérêt général », indique Letitia James. « En contournant la législation new-yorkaise, Polymarket cible les personnes les plus vulnérables et prive les familles new-yorkaises de services et d’un soutien essentiels », insiste-t-elle.

Contre-plainte et mise en doute de la compétence de l’État par Polymarket

La réaction de l’entreprise ne s’est pas fait attendre. Quelques heures après, selon CNBC, Polymarket demandait le transfert de l’affaire d’un tribunal de l’État à un autre et a contre-attaqué en lançant une action civile contre Letitia James et la Commission des jeux de l’État de New York, considérant que les États n’ont pas le pouvoir de réglementer les marchés prédictifs.

« La présente action vise à prévenir un préjudice imminent et irréparable résultant de l’application, par l’État de New York, de ses lois sur les jeux d’argent à l’encontre des bourses de produits dérivés réglementées au niveau fédéral — une application que le Congrès a expressément interdite », détaille la contre-plainte de Polymarket.

Selon Reuters, l’entreprise considère dans sa plainte que la Commission fédérale des opérations à terme sur matières premières (Commodity Futures Trading Commission, CFTC) est seule compétente en matière de réglementation des marchés prédictifs. Le directeur juridique de Polymarket, Neal Kumar, a affirmé à l’agence de presse que l’entreprise avait tenté une conciliation avec les responsables de l’État, mais que « celles-ci avaient préféré faire la une des médias ».

Letitia James a aussi attaqué cet été Kalshi, l’autre plateforme de paris en ligne qui se présente comme un marché prédictif.

Opposition avec Trump

Ce faisant, l’État de New York se met en opposition frontale avec l’administration Trump qui a pris le parti de ne pas réguler ce genre de plateformes, même après la multiplication des critiques concernant les délits d’initiés qu’elles engendrent. Elle a tout juste accepté de s’appuyer sur l’IA pour les détecter. Rappelons qu’en janvier dernier Kalshi a annoncé avoir embauché le fils du dirigeant des États-Unis, Donald Trump Jr., en tant que conseiller stratégique. Le New York Times expliquait quelques jours après que celui-ci était aussi « à la fois investisseur et conseiller bénévole chez Polymarket ».

Cette nouvelle affaire ne va évidemment pas simplifier les affaires de ces plateformes en ligne qui ont profité de ces largesses et veulent maintenant convaincre d’autres pays et régions qu’elles ne sont pas des sites de paris. C’est le cas en Europe et notamment en France où l’accès au site de Polymarket a été bloqué cet été via une décision de L’Autorité nationale des jeux (ANJ).

  •  

Plus de 200 prépublications en 2026 : un chercheur utilisant l’IA désespère ses collègues

Slop or perish?
Plus de 200 prépublications en 2026 : un chercheur utilisant l’IA désespère ses collègues

Depuis le début de l’année, un statisticien de l’université de Chicago, Nicholas Polson, a mis en ligne plus de 200 prépublications. Assumant d’utiliser l’IA générative pour augmenter sa productivité, il soulève l’indignation de ses consœurs et confrères.

La course à la publication coûte que coûte dans le milieu de la recherche s’intensifie encore avec l’utilisation généralisée de l’IA générative. Pour nombre de chercheuses et chercheurs, le travail consiste à mettre en ligne quelques articles issus de leurs travaux de recherche par an au maximum. Mais on peut voir sur le profil Google Scholar de Nicholas Polson, statisticien bayésien de l’école de commerce Booth de l’université de Chicago, que celui-ci en a signé plus de 200 depuis le début de l’année, comme le soulignait sur X déjà mi-aout Auyon Siddiq, chercheur à l’université de Californie (UCLA), .

La plupart des articles listés sur son profil ont été mis en ligne sur la plateforme de prépublications scientifiques SSRN. Cette plateforme a été lancée en 1994, quelques années après la pionnière du genre, arXiv, et a été rachetée en 2016 par Elsevier.

258 working papers en 8 mois

« D’après mes calculs, basés sur sa page SSRN, Nicholas Polson a déjà rédigé 258 working papers rien qu’en 2026. Il a déjà rédigé (ou du moins publié sur SSRN) six articles aujourd’hui, le 26 août 2026. Au cours du mois d’août 2026, il a rédigé et publié sur SSRN un total de 104 documents – et ce n’est pas fini, puisque le mois n’est pas encore tout à fait terminé », expliquait l’économiste de l’université de Central Arkansas, Jeremy Horpedahl, dans un billet de blog.

« Il s’agit probablement, à des degrés divers, de slops générés par IA, mais contrairement à beaucoup de ce genre de contenu, celui-ci recèle sans doute une réelle valeur. Ce que je n’ai pas encore pu vérifier, c’est si une partie de ce contenu a fait l’objet d’une vérification, d’une analyse ou d’une sélection rigoureuse de la part de l’auteur », ajoutait Michael Makowsky, économiste à l’université de Clemson.

Interrogé par le Washington Post, Nicholas Polson assume utiliser l’IA générative pour plus de productivité : « il est évident que l’IA rend un chercheur productif encore plus productif ». Il ajoute qu’ « une grande partie du travail fastidieux est grandement simplifiée ». Et il a, selon nos confrères, laissé entendre que ces plaintes étaient motivées par « la jalousie et l’envie de s’approprier ma méthode. Mais qui sait ? ».

Suppression des articles sur SSRN

Depuis que plusieurs de ses confrères ont pointé du doigt ce nombre prolifique, plus aucun article récent de Nicholas Polson n’est accessible sur SSRN. Par exemple, la page de l’article titré « Over-parameterization in Statistical Genomics » et listé sur son profil Google Scholar affiche maintenant : « Cet article est en cours d’évaluation ou a été retiré de SSRN à la demande de l’auteur, de SSRN ou du titulaire des droits ». Son profil sur la plateforme ne liste plus que des articles mis en ligne avant octobre 2018.

Plusieurs chercheurs ont souligné que les articles de Nicholas Polson ne faisaient pas mention d’utilisation de l’IA. Mais la plateforme souligne que « s’il est vrai que bon nombre de ces articles ne comportaient pas de mention relative à l’IA, ce n’est pas notre principale préoccupation. […] Le problème le plus important résidait dans l’activité inhabituelle en matière de soumission d’articles ». Elle indique que le statisticien s’était aventuré dans des champs dont il n’est pas spécialiste, bien que la plupart des articles y restaient.

« Ce n’est pas seulement une question de volume, mais aussi de diversité des thèmes abordés et de la manière dont ils se distinguent de ses œuvres précédentes », insiste Auyon Siddiq interrogé par nos confrères.

  •  

☕️ arXiv annonce 17 millions de dollars de financement venant de fondations et de XTX Markets


En mars dernier, la plateforme de prépublication d’articles scientifiques arXiv avait annoncé devenir une « organisation indépendante à but non lucratif », avec son CEO et son propre budget. Elle vient d’officialiser un financement total de 17,2 millions de dollars par le secteur privé.

Le serveur pionnier de la prépublication scientifique créé en 1991 a voulu prendre son indépendance de l’université Cornell dont elle dépendait depuis 2001. Cette dernière avait pris sous son aile le projet quand son créateur, Paul Ginsparg, l’avait rejointe en quittant le laboratoire américain de Los Alamos au sein duquel il avait créé arXiv. Mais le projet, devenu structurant dans la recherche mondiale, commençait à peser lourd sur les finances de l’université, et avait besoin d’une infrastructure administrative et financière plus solide.

Le financement de 17,2 millions de dollars qu’arXiv vient d’annoncer, présenté comme « philantropique », est assuré par trois structures : la Fondation Simons, le Fonds de dotation de la famille Siegel et l’entreprise XTX Markets. Ce financement doit s’étaler sur 3 à 5 ans.

La Fondation Simons finançait déjà le projet et avait aussi aidé Cornell à collecter des fonds pour le lancement du projet en « organisation indépendante à but non lucratif », comme l’expliquait la revue Science. Elle est représentée dans le conseil d’administration d’arXiv par le journaliste scientifique Ivan Oransky (co-créateur de Retraction Watch). La deuxième structure est un fonds créé par l’informaticien David Siegel et co-créateur du hedge fund Two Sigma. XTX Markets, une entreprise de trading britannique créée par le mathématicien russe Alex Gerko, a de son côté récemment annoncé un bénéfice record de 1,7 milliard de livres sterling (environ 2 milliards d’euros).

La plateforme de prépublications scientifiques explique que ce financement doit permettre de soutenir :

  • « Le fonctionnement général et l’amélioration continue des services d’arXiv destinés à la communauté scientifique »,
  • « La poursuite du développement technique de la plateforme, notamment les travaux liés à la gestion des contenus générés par l’IA et aux autres défis émergents dans le domaine de la communication scientifique »,
  • « Le renforcement d’arXiv en tant qu’organisme indépendant à but non lucratif, notamment par des investissements dans la gouvernance et le fonctionnement organisationnel ».
  •  

L’agent Muse de Meta s’appuie sur des humains pour sa fonction d’appels téléphoniques

Encore et toujours le turc automate
Muse peut donner votre adresse à n’importe qui ou fouiller vos messages sans permission

L’agent IA de Meta qui propose aux internautes de faire leurs emplettes et de prendre leur rendez-vous à leur place est grandement inspiré d’OpenClaw, avoue l’un des responsables de l’entreprise. Mais la fonction d’appels ajoutée le 17 septembre s’appuie aussi sur un call center où de vrais humains passent des coups de fil à la place de l’IA.

L’IA coûte cher, les agents ne vont pas assez vite ? Pas de problème pour Meta, qui a essayé de rattraper son retard sur la concurrence en lançant Muse, son agent IA, capable de prendre en charge toutes sortes d’actions pour le compte de l’utilisateur. Histoire de ne pas perdre trop de temps en R&D, le géant des réseaux sociaux s’est grandement inspiré d’OpenClaw.

Un agent très très proche d’OpenClaw

C’est ce qu’a avoué Nat Friedman, responsable produit chez Meta Superintelligence Labs (MSL) dans un post sur X. « En tant que produit, il s’inspire très fortement d’OpenClaw » explique-t-il, tout en assurant que l’agent de Meta a été créé « from scratch ». « Je pense que beaucoup de gens s’en sont inspirés. Notre objectif avec Muse était de créer quelque chose de similaire à OpenClaw, que nous pourrions rendre sûr, sécurisé et facile à utiliser, et qui puisse s’adapter à des milliards d’utilisateurs », ajoute-t-il.

Nat Friedman répondait à un message affirmant que « Muse, c’est LITTÉRALEMENT OpenClaw pour les gens normaux ». Ce message était accompagné d’une capture d’écran montrant une réponse de Muse comparant des noms de fichiers de configuration entre les différents systèmes. Cette inspiration n’est pas fortuite : il se trouve en effet que Meta avait tenté d’acquérir OpenClaw avant qu’OpenAI ramasse la mise.

Meta est pressé et ne s’embarrasse pas trop des éventuels obstacles sur sa route : il a ainsi délogé manu militari le groupe de musique Muse de ses réseaux sociaux (Instagram, Facebook, et même X) pour y greffer ceux de son agent. Et Muse a été repéré par la patrouille en train de faire les courses sur Amazon sans que ce dernier soit prévenu.

Une nouvelle fonctionnalité… backupée par un call center

Ce même empressement pourrait aussi expliquer pourquoi Meta a voulu attribuer à Muse des actions qu’il ne peut réaliser seul, sans l’aide d’un humain. Dans l’histoire de l’IA, beaucoup d’entreprises ont été accusées de cacher du travail humain derrière un storytelling d’automatisation des tâches, Waymo faisant par exemple débloquer ses taxis par des personnes travaillant aux Philippines.

Meta rejoint ainsi cette longue liste après avoir lancé en test une fonction « pour les appels sortants vers des entreprises américaines ». Alexandr Wang, directeur de l’IA chez Meta, s’enorgueillait le 17 septembre dernier : « Nous étendons notre version bêta de Muse aux appels téléphoniques ! ».

Mais selon des informations de 404 Media, lors de la présentation de cette fonctionnalité aux employés de Meta, la direction leur a expliqué avoir « ajouté une couche d’agents humains pour garantir la bonne exécution des appels ».

D’après le message interne obtenu par nos confrères, « Muse ne se contente pas de composer un numéro. Il appelle une entreprise en votre nom, gère la conversation, traite votre demande et vous en rend compte à l’aide d’une transcription et d’un résumé ». « De plus, il ne fonctionne plus seul. Muse est désormais capable de transférer les demandes à un agent humain qualifié, qui passe l’appel et s’en charge », est-il ajouté.

Face à des employés circonspects concernant la mauvaise presse que cela pouvait attirer ainsi que par les problèmes de confidentialité potentiels, la direction de Meta leur a assuré que les sous-traitants avaient suivi « de nombreuses formations afin de garantir la sécurité et la protection de toutes vos données ».

« Les tests internes, également appelés “dogfooding”, sont au cœur du processus de développement des produits. Bien que les réactions des employés aient été extrêmement positives, l’objectif principal est de recueillir des retours afin de pouvoir mettre en place des mesures de sécurité et de protection de la vie privée, et d’améliorer les fonctionnalités avant leur lancement public », a répondu Meta au site web. « Nous travaillons avec les commerçants pour continuer à améliorer cette fonctionnalité d’appel potentielle, et nous ne la déploierons que lorsqu’elle sera prête et accompagnée des mentions d’information appropriées ».

  •  

Meta et ses lunettes connectées attaquées en justice aux États-Unis

Lunettes trop connectées ?
Meta et ses lunettes connectées attaquées en justice aux États-Unis

Les lunettes connectées de Meta sont de plus en plus utilisées à travers le monde mais aussi de plus en plus décriées. Aux États-Unis, des dizaines de personnes se sont jointes à une class action contre Meta accusée notamment d’avoir envoyé des scènes d’intimité sur ses serveurs et à un sous-traitant sans leur consentement.

Alors que de partout les lunettes Meta et leurs utilisateurs sont critiqués, une plainte vient unifier, aux États-Unis, les personnes qui dénoncent l’atteinte à leur intimité de la part de Meta. Elles accusent l’entreprise de Mark Zuckerberg d’avoir notamment transféré de manière problématique des photos et vidéos captées par une de ses paires de lunettes connectées.

En début d’année, des journalistes suédois ont montré que certaines scènes de la vie courante et parfois intime de porteurs de lunettes Meta et de leurs proches étaient envoyées sur les serveurs de Meta puis parfois à un de ses sous-traitants kényans pour analyse.

Ce sous-traitant, nommé Sama, est connu pour faire partie des entreprises africaines qui traitent les données des entreprises de la Silicon Valley pour toutes les tâches de modération et d’étiquetage (tâche qui permet d’améliorer les modèles).

À l’époque, l’eurodéputé du Parti social-démocrate suédois Adnan Dibrani avait soulevé des questions sur le sujet devant la Commission européenne. Mais de l’autre côté de l’Atlantique, cette enquête a aussi inquiété plusieurs acheteurs de lunettes Meta qui ont monté différents dossiers juridiques.

Plus de 70 utilisateurs de lunettes Meta se rassemblent pour porter plainte

Fin août, plus de 70 d’entre eux ont finalement fusionné leurs plaintes dans une class action déposée devant un tribunal fédéral de Californie du Nord, a appris le Los Angeles Times.

Le document de 230 pages [PDF] s’appuie sur l’enquête de nos confrères et consœurs suédois pour accuser Meta d’envoyer sur ses serveurs les données que les utilisateurs font transférer des lunettes à leur smartphone. Et ce, en temps réel et qu’ils aient activé ou non la fonction « cloud media » (qui permet de sauvegarder sur le cloud de Meta).

La plainte évoque l’envoi par Meta de données à Sama pour que des employés de ce sous-traitant les vérifient. « Meta a transmis à des annotateurs tiers travaillant pour Sama des données à caractère personnel, notamment des images et des enregistrements audio représentant des situations privées et des activités personnelles dont l’utilisateur plaignant pouvait raisonnablement s’attendre à ce qu’elles restent privées », affirme le document.

Des scènes privées envoyées automatiquement

Mais la plainte contient aussi des témoignages des différents utilisateurs portant plainte. Ainsi, l’un d’entre eux affirme que ses lunettes ont enregistré à son insu des membres de sa famille dans la salle de bain alors qu’il les avait laissées sur une étagère : « Il a remarqué que, parfois, des photos de membres de sa famille dans la salle de bain et en train de se laver commençaient à apparaître dans sa galerie – des images que personne dans son foyer n’avait l’intention de prendre ».

Un autre témoigne que les lunettes qu’il a achetées « se déclenchaient par erreur deux fois par jour ». « Meta a capturé, transmis et acheminé vers Sama les images et les enregistrements audio capturés par les lunettes [de ce plaignant], qui montraient des situations privées et des activités personnelles dont il pouvait raisonnablement s’attendre à ce qu’elles restent privées », décrit le document au milieu de l’évocation de plus d’une quarantaine d’autres cas.

Les avocats soulignent que la communication de Meta est pourtant très rassurante, notamment depuis 2025, martelant que ses lunettes sont « conçues pour préserver votre vie privée, sous votre contrôle ». « Mark Zuckerberg a lui-même insisté sur ce message clé, soulignant qu’il était d’une « importance capitale » de « donner aux utilisateurs le contrôle » sur ce que les lunettes enregistrent et conservent », ajoutent-ils. Pour eux, cette insistance sur la protection de la vie privée des utilisateurs a permis à Meta de passer de 2 millions de ventes de lunettes sur 2023 et 2024 réunies à 7 millions pour la seule année de 2025.

« Ces promesses étaient fausses. Les lunettes enregistrent en silence, avec des indicateurs difficiles à voir et facilement masqués », constatent-ils.

« Si vous utilisez Meta AI, nous pouvons être amenés à examiner ces données afin d’améliorer nos produits et l’expérience utilisateur – cela fonctionne de la même manière que dans de nombreuses autres entreprises. Nous prenons des mesures pour filtrer ces données afin de supprimer les informations permettant d’identifier les utilisateurs et de protéger leur vie privée », a commenté Meta dans une déclaration envoyée au Los Angeles Times.

  •  

En Europe, l’usage public des lunettes Meta avec l’IA jugé illégal par des experts

Harcèlement de rue augmenté par IA
En Europe, l’usage public des lunettes Meta avec l’IA jugé illégal par des experts

Dans un rapport très fourni, l’autorité de protection des données hambourgeoise donne sa position sur l’utilisation légale des lunettes connectées de Meta, que ce soit dans leur utilisation « simple » pour prendre des photos, l’utilisation avec Meta AI ou celle en connexion avec les réseaux sociaux. Elle martèle clairement que la reconnaissance de personnes en dehors d’un cercle proche restreint via ces lunettes sera interdite.

Les experts de la HmbBfDI, la CNIL du land de Hambourg, viennent d’analyser en profondeur le cas des lunettes Meta couplées avec l’application Meta AI à la lumière des règlementations européennes. Leur conclusion ne va sûrement pas faire plaisir à Mark Zuckerberg.

En France, la CNIL s’est déjà inquiétée de l’arrivée de ces lunettes connectées déjà surnommées « pervert glasses », ou « lunettes de pervers ». Mais l’autorité de protection des données française était restée sur des arguments généraux.

La HmbBfDI (en plus long, Hamburgischer Beauftragter für Datenschutz und Informationsfreiheit), vient de publier un rapport de 53 pages [PDF] beaucoup plus technique en précisant se focaliser « sur les responsabilités des utilisateurs de lunettes en matière de protection des données à caractère personnel de tiers ». Celui-ci s’appuie sur le droit européen mais aussi sur l’analyse du produit de Meta, que ce soit des lunettes en elles-mêmes que de l’application Meta AI.

Une difficile analyse de ce qui est transféré à Meta

Les experts de la HmbBfDI ont fait leur analyse avec le modèle Ray-Ban Meta Wayfarer (Gen 1). Ils ont pu analyser les composants électroniques contenus dans la branche gauche des lunettes : une puce mémoire du fabricant BIWIN et un CPU Qualcomm créé spécialement pour des calculs IA sont assemblés sur le PCB. Ils n’ont pas pu examiner les données de la mémoire, dont ils n’ont trouvé aucun point de contact pour lire les données, même avec un adaptateur standard pour la lecture de puces.

Ils ont pu constater que les données transmises par les lunettes sont « en grande partie chiffrées ».

Les experts de la HmbBfDI ont aussi analysé les données que laissait l’application sur le téléphone dans le dossier /data/data/com.facebook.stella créé lors de son installation. Notamment, ils ont pu constater qu’une base de données SQLite était créée avec des tables nommées « face », « face_group », « face_low_confidence_pair » et « face_to_face_group ». « L’hypothèse évidente selon laquelle ces tables serviraient à la reconnaissance faciale n’a pas pu être confirmée par les tests », expliquent-ils.

Des visages floutés mais difficile de savoir si l’action est faite localement

Dans leur expertise, ils ont essayé de déterminer si les visages capturés lors d’une utilisation de Meta AI étaient floutés avant ou après envoi sur les serveurs de l’entreprise. « Cela n’a pas pu être clarifié », expliquent-ils, notamment parce que les données sont envoyées de manière chiffrée, mais ils ont constaté un timestamp (horodatage) sur l’image indiquant un décalage de 2 secondes après le traitement par Meta.

Pour leur analyse, ils ont aussi demandé via le Meta Account Center et obtenu (après avoir attendu une semaine) les données de l’application, comme tout utilisateur peut le faire. Notamment, ces données contiennent un dossier nommé « /media/your_posts ». Ce dossier contient des captures d’images (au format jpeg) faites lors de conversations avec Meta AI. Si une de ces images contient un visage, celui-ci est masqué par un cercle gris pour le rendre méconnaissable :

Concernant la retranscription des voix, les données envoyées par le Meta Account Center sont anonymisées : « Seuls des indices concernant la question initiale peuvent être déduits de la réponse correspondant à la saisie », expliquent-ils. « Néanmoins, les textes doivent également être stockés dans une base de données, que nous n’avons pas pu trouver en local. En effet, toutes les saisies des utilisateurs restent accessibles sous forme de transcriptions via le « Journal d’activité vocale » dans l’interface utilisateur ».

Ils notent aussi que la fonctionnalité « Meta AI Chat » ne permet pas facilement de supprimer les conversations. Même si un bouton « Supprimer toutes les conversations » permet de les supprimer de l’historique de conversation, elles restent dans le « Journal d’activité vocale » qui ne permet de les supprimer qu’une à une.

Concernant la reconnaissance faciale, les experts n’ont pas trouvé de preuve de son utilisation tout en évoquant l’enquête de Wired dont nous avions parlé en juin.

Une exigence de transparence vis-à-vis des personnes filmées quasiment impossible à mettre en œuvre

Mais les experts allemands l’affirment : « l’utilisation de ces lunettes pose des défis importants en matière d’exigences de transparence » et cela notamment parce qu’il est difficile pour les personnes tierces de savoir que l’appareil est en train de filmer, malgré la diode qui s’allume lorsque c’est le cas : « Elle n’est visible que dans une mesure limitée, en fonction de la distance, de l’angle de vue et des conditions d’éclairage ». Et ils ajoutent que « le simple fait que la LED s’allume ne suffit pas à informer correctement les personnes concernées du traitement des données ».

Or, rien que leur utilisation pour prendre des photos et des vidéos doit s’appuyer, comme lors de toute captation d’images, sur le consentement ou l’intérêt légitime (par exemple, le droit à l’information). Pour eux, « les utilisateurs devraient plutôt prendre des mesures supplémentaires, telles que la mise en place d’avis sous forme de pictogrammes ou de communications verbales ». Bref, à part crier dans la rue : « hey, je vous filme tous » avant d’activer ces lunettes Meta, leur utilisation dans des lieux publics serait légalement impossible.

Si la personne qui porte les lunettes utilise aussi Meta AI, ça devient un peu plus compliqué. Si elle n’a pas accepté dans l’application l’utilisation des données pour l’entrainement, les experts de la HmbBfDI considèrent que « la transmission de données à caractère personnel de tiers via les lunettes à Meta AI (sans entraînement de l’IA) peut être fondée sur le consentement ». Dans quelques cas comme « la navigation, la traduction, la collecte d’informations ou, dans le cas des personnes malvoyantes, la participation à la vie sociale », cela peut même être considéré comme de l’utilisation légitime.

Mais si l’utilisation des données pour l’entrainement des modèles de Meta est autorisée par l’utilisateur, « cela entraîne des exigences supplémentaires en matière de transparence, d’autant plus que les tiers ne s’attendent généralement pas à ce que les enregistrements soient intégrés de manière permanente dans les modèles d’IA de Meta ».

Concernant l’utilisation sur les réseaux sociaux, comme pour d’autres captations, le consentement est la règle et celui-ci « doit également porter explicitement sur la publication ».

« Dans l’ensemble, en ce qui concerne les scénarios d’utilisation concrets, on peut partir du principe que la représentation identifiable de personnes n’appartenant pas à son cercle proche d’amis et de famille ne sera pas autorisée au regard de la législation sur la protection des données – sauf dans de rares cas impliquant des intérêts légitimes –, car il n’est pas réaliste d’obtenir un consentement éclairé », affirme le rapport.

  •  

Plusieurs associations appellent la Commission européenne à tuer les bannières de cookies

On peut pas les manger plutôt ? J'ai faim !
Plusieurs associations appellent la Commission européenne à tuer les bannières de cookies

noyb, l’EFF, Que Choisir et d’autres associations veulent profiter de la proposition d’ « omnibus numérique » de simplification des règles européennes pour introduire l’obligation de prendre en compte des mécanismes standards d’automatisation de réponse aux bannières de cookies.

« Utiliser Internet est devenu un véritable casse-tête », constatent une vingtaine d’associations dont noyb, Que Choisir Ensemble, ou encore l’EFF. « Même des gestes simples, comme ouvrir un site web ou une application, obligent souvent les utilisateurs à cliquer sur des bannières de consentement trompeuses avant de pouvoir accéder au contenu proprement dit ». Et effectivement, les bannières de cookies utilisant très souvent des dark patterns ont envahi le web.

« Contrairement à ce que pourrait laisser croire l’omniprésence des bannières de consentement, celles-ci ne sont pas exigées par la législation européenne », soulignent les associations : « En réalité, au sein de l’Union européenne, le suivi en ligne est interdit par défaut ». Les bannières de consentement constituent dès lors un outil de « conformité malveillante » utilisé par le secteur du suivi, conçu pour vous inciter à renoncer à vos droits. « En d’autres termes : ce système est vicié dès sa conception », concluent-elles. Le site de Next, sans bannière de cookies, prouve qu’il est possible de s’en passer.

Proposition d’introduire un nouvel article dans l’ « omnibus numérique » pour simplifier la vie des internautes

En conséquence, dans une lettre ouverte adressée à la Commission européenne, ces associations lui demandent d’intégrer à son texte dit « omnibus numérique » un article (article 88b) qui obligerait les sites web des entreprises à accepter un mécanisme standard de signaux automatiques permettant à l’internaute de faire ses propres choix de façon automatique, sans avoir à décocher manuellement des cases avant d’accéder au contenu.

Pour ces associations, cet ajout permettrait d’apporter une véritable simplification « que les citoyens (et les électeurs) puissent constater dans leur vie quotidienne, plutôt que de se contenter de réduire les obligations pesant sur les entreprises ». Rappelons que la Commission européenne a justifié son projet d’omnibus numérique par le besoin d’un « choc de simplification ».

Des protocoles existants qui peuvent devenir des standards

Elles appuient leur demande sur l’existence de protocoles déjà existants. Et si le Do Not Track n’a pas eu le succès escompté, les associations s’appuient sur le « Global Privacy Control » qui a pris la relève et sur lequel reposent déjà, selon elles, des lois établies dans certains États américains.

L’EFF, noyb et autres associations citent aussi le protocole ADPC (Advanced Data Protection Control) proposé par le chercheur autrichien Soheil Human. L’ADPC permet non seulement de refuser les cookies mais aussi de les accepter à des fins spécifiques ou pour des responsables de traitement choisis. Cela « pourrait permettre de supprimer la plupart des bannières de cookies », argumentent les associations.

Les associations proposent que ce nouvel article 88b rende obligatoire la possibilité d’automatiser par l’internaute, dans son navigateur, tout ce qui dépend du principe de consentement tel que le définit l’article 4.11 du RGPD. L’article qu’elles proposent obligerait à respecter les signaux automatisés.

Enfin, les associations demandent à la commission d’interdire aux entreprises considérées comme des « contrôleurs d’accès » de concevoir ou gérer les signaux automatisés de manière à renforcer leurs positions dominantes.

  •  

☕️ OpenAI ouvre les pubs dans ChatGPT aux clients d’Amazon Ads


Après avoir introduit la publicité dans son chatbot, OpenAI la booste en signant un accord avec Amazon.

Celui-ci va permettre aux clients d’Amazon Ads, le service de publicité du groupe de Jeff Bezos, d’insérer leur pub dans ChatGPT via la plateforme de marketing Amazon DSP. Pour l’instant, c’est un projet pilote mis en place aux États-Unis, avec des publicitaires sélectionnés, explique Digiday.

Ave Calvar pour Unsplash +

Mais on peut facilement imaginer qu’il se généralise, même si OpenAI a tâtonné 7 mois avant de lancer la pub dans ChatGPT pour les utilisateurs français et européens.

Il y a un an, Amazon concluait aussi un accord avec Netflix concernant l’introduction de publicités via sa plateforme DSP aux États-Unis, au Royaume-Uni, en France, en Espagne, au Mexique, au Canada, au Japon, au Brésil, en Italie, en Allemagne et en Australie.

Rappelons quand même que la FTC (l’agence américaine de contrôle du droit de la consommation et des pratiques anticoncurrentielles) vient d’attaquer en justice Amazon pour avoir surfacturé « de manière secrète et systématique » 1,2 million d’annonceurs sur Amazon.com à hauteur d’une somme totale de plus de 20 milliards de dollars.

  •  

☕️ L’agence de cybersécurité de la Commission européenne peut maintenant utiliser Mythos


L’ENISA, agence de cybersécurité de l’Union européenne, vient d’obtenir un accès à Mythos. En mai, OpenAI lui avait donné accès à GPT-5.5-Cyber mais elle n’avait pas accès au modèle présenté d’Anthropic le plus puissant côté cybersécurité notamment.

Un mois après, Anthropic annonçait l’ouverture de l’accès de Mythos à d’autres organisations gouvernementales que celles des États-Unis, l’Union européenne était évoquée sans que cela soit officiel.

Illustration : Flock

C’est désormais chose faite. « À la suite de nos échanges constructifs avec Anthropic, nous pouvons confirmer que l’agence européenne de cybersécurité ENISA a obtenu l’accès à Mythos 5 et procède actuellement à des tests sur ce système », a affirmé un représentant de la Commission européenne à Bloomberg, même si l’entreprise états-unienne n’a pas voulu commenter.

Mais l’ENISA ne semble pas avoir accès à la dernière version du modèle d’Anthropic si la version est bien celle citée par le représentant de la Commission. En effet, la semaine dernière, l’entreprise a annoncé la version 5.1 de Mythos et l’entreprise de Dario Amodei écrivait que cette version n’était « accessible qu’à un certain nombre d’organisations américaines ».

  •  

☕️ Le CEO d’Automattic de retour aux commandes de WordPress.com et Tumblr


Mise à jour, 11/09, 19h30 – Deux jours après son éviction, Matt Mullenweg est de retour chez Automattic, selon un message Slack consulté par TechCrunch, et confirmé par plusieurs salariés. « Heureux d’annoncer que le conseil d’administration est de nouveau d’accord, et que je contrôle Automattic », écrit-il. « Il s’est passé beaucoup de choses ces dernières 48 heures que nous devons démêler, et j’espère qu’une grande partie relevait d’un malentendu, car j’ai énormément de respect et d’estime pour les personnes concernées. » La maison mère de WordPress.com n’a encore rien annoncé. Affaire à suivre.

Article original, 10/09 – Matt Mullenweg, le CEO d’Automattic (maison mère de WordPress.com et Tumblr) qui a déclenché une guerre juridique dans l’écosystème commercial de WordPress en 2024, a été évincé de son poste par le conseil d’administration de son entreprise.

Comme le révèle 404 Media, il a annoncé sur le Slack interne que le CA lui a imposé de prendre des congés payés. Dans ce message, il accuse le responsable financier Mark Davies d’avoir « conspiré » avec les membres du conseil d’administration d’Automattic, Ann Dunwoody, Toni Schneider et Sue Decker. Ils « ont agi dans mon dos et ont voté pour me mettre en congé rémunéré. J’ai voté contre cette décision », affirme-t-il.

Il a annoncé en même temps à ses équipes que Mark Davies avait été élu CEO par intérim de l’entreprise. Toni Schneider a ensuite confirmé cette décision sur le Slack et l’entreprise précise à nos confrères que « Matt Mullenweg est actuellement en congé chez Automattic. Mark Davies, directeur financier d’Automattic, dirigera l’entreprise en tant que PDG par intérim. Le conseil d’administration a pleinement confiance en les qualités de dirigeant de Mark et en la capacité de l’équipe à mettre en œuvre les priorités de l’entreprise ».

En 2024, alors qu’il avait déclenché sa guerre avec son concurrent WP Engine, Matt Mullenweg avait poussé plusieurs fois et avec succès à la porte des employés qui ne se retrouvaient pas dans sa manière d’agir.

  •  

☕️ Google annonce un investissement de 13 milliards d’euros en Finlande


Google promet d’investir dans les deux prochaines années en Finlande la somme de 13 milliards d’euros pour financer des projets d’infrastructures dans le sud et le centre du pays.

Dans un communiqué de presse publié ce mercredi 9 septembre, Google affirme que « cela comprend les investissements dans des centres de données et d’autres infrastructures de soutien, ainsi que des partenariats à Hamina, Kajaani, Muhos et Vaala [des villes situées au sud et au centre du pays] ».

Concernant les «  infrastructures de soutien », l’entreprise parle, de fait, de centrales, de barrages et du réseau électriques du pays. Ainsi, Google évoque un partenariat avec les entreprises Fingrid et Business Finland pour « identifier des sites pour l’infrastructure de Google et mettre en place un raccordement respectueux du réseau », un contrat de 22 ans avec Fortum pour lui fournir de l’énergie venant de la centrale nucléaire de Loviisa et aider à « la viabilité commerciale de cette centrale », ou encore un contrat avec Valorem concernant l’électricité d’un parc éolien situé à l’est du pays.

Illustration : Flock

Ruth Porat, directrice financière de Google affirme que cet investissement est « le plus important investissement ponctuel de l’entreprise en Europe ».

Le représentant de Google en Finlande, Antti Järvinen, a souligné que ce projet constituait l’un des plus importants investissements de l’histoire industrielle du pays, rapporte le média finlandais Yle.

Les projets de création de data centers font aussi face à de vives critiques en Finlande, comme ailleurs, notamment sur l’épuisement des ressources locales et sur l’aggravation de la crise climatique, expliquent nos confrères finlandais. Lors de l’annonce de l’investissement de Google, le Premier Ministre, Petteri Orpo, y a répondu en mettant en avant les emplois promis par la multinationale. « Dans le débat public en Finlande, l’impact des centres de données sur l’emploi est souvent sous-estimé. Je trouve cela étrange dans un pays qui est confronté depuis longtemps à un taux de chômage élevé . Cela signifie des emplois, de nombreux emplois pour les Finlandais partout en Finlande », a-t-il promis.

Google annonce dans son communiqué la promesse 37 000 emplois « induits », dont 16 000 dans la construction, lors de la phase initiale et 7 000 emplois de support ensuite.

La perspective d’emplois est régulièrement citée par les promoteurs de nouveaux centres de données, mais elle suscite des débats. En France, par exemple, une étude EY pour l’organisation France Data Center a établi que l’industrie des centres de données comptait 48 374 emplois en France en 2024, parmi lesquels 18 328 emplois « indirects et induits ». L’année suivante, le cabinet Trendeo comparait de son côté l’intensité capitalistique des emplois créés dans diverses filières : la filière des centres de données ayant attiré 52 % des investissements nationaux et créé 2 800 emplois, elle établissait un ratio de 40 millions d’euros par emploi. Un chiffre à comparer à ceux constatés dans l’énergie (5 millions d’euros par emploi), dans la recherche et développement (1,8 million d’euros par emploi) et dans le reste de l’industrie numérique (entre 0,2 et 0,3 million d’euros par emploi).

  •  

☕️ Nitter et XCancel reprennent du service


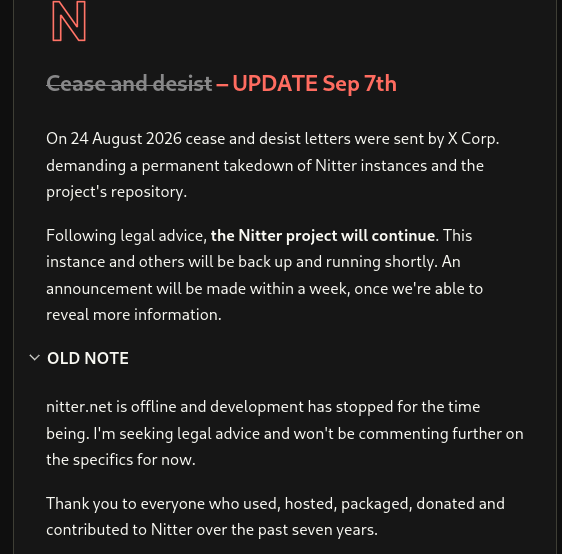
Fin août, Nitter et Xcancel annonçaient la suspension de leurs activités de leurs services. Ces deux plateformes alternatives pour tous les internautes qui souhaitent consulter ou partager des publications du réseau social X reprennent finalement leurs activités.

Sur le site de Nitter, on peut lire une mise à jour de la note publiée le mois dernier, dans laquelle l’équipe explique avoir reçu une mise en demeure par X le 24 août 2026. Mais après quelques jours de réflexion et consultation de leurs avocats, les responsables du projet ont choisi de le remettre en route : « Suivant les conseils juridiques reçus, le projet Nitter se poursuivra ».

Selon ce message, Nitter sera de « nouveau opérationnelle d’ici peu » et d’autres instances devraient suivre. De fait, c’est déjà le cas de XCancel qui est de nouveau utilisable, par exemple pour consulter les messages du président de la République française qui ne publie pas ses messages ailleurs. Pourtant Next lui a fait un tuto personnel pour l’aider :

  •  

L’Europe avance sur son autonomie spatiale, Donald Trump joue les trouble-fête

Espace politique
Téléphonie satellite : Orange et les grands opérateurs lorgnent les fréquences européennes

Le Sommet international sur l’espace va se dérouler cette semaine. Si la fusée allemande Spectrum a bien réussi son lancement ce week-end en Norvège, des tensions entre la France et l’Allemagne montrent qu’il n’est pas sûr que l’Europe veuille s’assurer une réelle autonomie spatiale. Donald Trump, lui, a interdit aux entreprises états-uniennes de participer au sommet, alors même que la régulation de l’espace doit y être évoquée.

Ce week-end, Isar Aerospace a réussi le lancement de sa fusée Spectrum depuis la base d’Andøya (Norvège), ainsi que le placement en orbite de cinq satellites. Mais le succès de Spectrum n’est pas forcément le symbole du futur de l’Europe spatiale qui doit être discuté lors du Sommet international sur l’espace organisé les 9 et 10 septembre prochains à Paris.

« Nous sommes entrés dans l’histoire », s’est enorgueillie l’entreprise allemande sur le réseau social d’Elon Musk. « Dès notre deuxième vol, nous sommes devenus la première entreprise spatiale commerciale européenne à mettre des satellites en orbite. La mission « Onward and Upward » a décollé avec succès et a déployé ses charges utiles en orbite. Un nouveau chapitre s’ouvre pour l’aérospatiale européenne ». C’est incontestablement un succès pour cette entreprise du « new space » allemand qui réussit donc l’exploit d’envoyer des satellites depuis le continent européen et ouvre une possibilité complémentaire à Ariane 6 face au géant états-unien SpaceX.

Pressions de Trump, défection allemande

Politiquement, c’est un peu plus compliqué que ça. Emmanuel Macron avait annoncé en juin dernier ce sommet international de l’Espace en exhortant l’Europe à mener une « reconquête à marche forcée » dans le domaine du spatial. Et il espérait pouvoir compter sur le soutien du chancelier allemand Friedrich Merz pour relancer le leadership du duo européen en y annonçant, main dans la main, la signature d’une déclaration commune des pays européens incluant des critères de préférence européenne pour le prochain budget spatial européen.

Mais le dirigeant allemand a fait savoir très tardivement qu’il ne coprésidera pas ce sommet. « À ce stade, le chancelier ne peut pas participer » en raison des « contraintes politiques », a affirmé l’Élysée à l’AFP ce week-end. Les ministres allemands de la Défense, Boris Pistorius, et de l’Espace, Dorothee Bär, devraient être cependant présents, mais l’absence du chancelier met un doute sur l’entente franco-allemande sur le sujet.

Cette défection fait suite à la pression que Donald Trump a exercée sur le bon déroulement du sommet. En effet, une semaine avant la tenue de l’événement, Politico a appris que la Maison Blanche a indiqué par téléphone à des entreprises de son pays comme SpaceX, Stoke Space, K2 Space et Astra, que leur participation à ce sommet pourrait être perçue comme un soutien tacite aux positions politiques de l’Union européenne. L’administration de Donald Trump reprocherait à la France de ne pas s’être concertée avec les États-Unis pour organiser ce sommet, ainsi que de « pratiques anticoncurrentielles ».

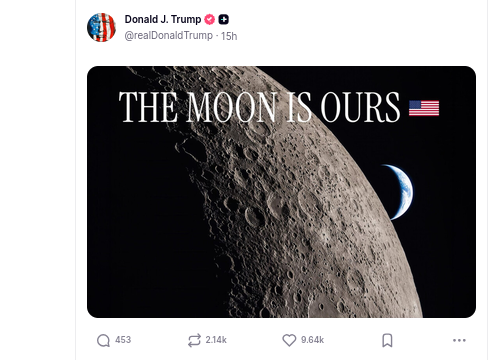
Ces pressions ont poussé SpaceX, Blue Origin, Stoke Space et Starcloud à annuler leurs venues même si le ministre Philippe Baptiste a réagi sur X en affirmant que « la porte est grande ouverte » aux scientifiques, entreprises et administrations états-uniennes. Ce week-end, parmi une flopée d’images générées par IA, Donald Trump a réaffirmé de façon brutale sa volonté d’imposer l’hégémonie de son pays dans l’espace :

Mais ces jeux d’influence pourraient aussi expliquer la défection du dirigeant allemand. Selon les Echos, l’Allemagne voudrait garder la porte grande ouverte au recours à SpaceX et à d’autres entreprises états-uniennes.

Régulation de la pollution lumineuse ?

Si le sommet est notamment un enjeu économico-politique pour l’Europe, il doit aussi être le lieu de discussion concernant la régulation de l’espace. Notamment, comme l’expliquent les chercheurs Fabien Malbet et Julien Milli, il pourrait être l’occasion de créer un cadre international contraignant pour limiter le nombre de satellites et leur impact, singulièrement concernant la pollution lumineuse. Mais la désertion des acteurs états-uniens risque de mettre du plomb dans l’aile à ces discussions.

Enfin, le sommet officiel doit faire face à l’organisation d’un contre-sommet organisé par la CGT ces mardi 8 et mercredi 9 septembre [PDF] où la dirigeante de l’organisation, Sophie Binet, interviendra ainsi que des scientifiques et divers représentants de partis de gauche français. Il y sera aussi question de la « profitabilité au détriment de la souveraineté » ou de la« compétitivité par la baisse des budgets de la recherche ».

  •  

☕️ France2030 : 18 millions d’euros pour relancer la recherche sur la fission nucléaire


L’État français a décidé de rebooster sa recherche dans le nucléaire de fission en lançant un nouveau programme de recherche sur le thème financé par le plan d’investissement public France 2030. Dans son communiqué de presse annonçant la création de ce programme, le CNRS l’ancre dans une « volonté d’accompagner la transition énergétique ».

Le programme est doté de 18 millions d’euros sur six ans et est piloté par le CNRS en collaboration avec le CEA.

Réacteur nucléaire
Réacteur centrale nucléaire. Nicolas HIPPERT, Unsplash

L’idée du programme semble de réactiver une recherche sur le nucléaire en perte de vitesse, avec la volonté de :

  • Produire de nouvelles connaissances fondamentales ;
  • Renforcer les infrastructures expérimentales indispensables à ces recherches ;
  • Former une nouvelle génération de scientifiques spécialisés dans l’énergie nucléaire.

La moitié des 18 millions d’euros partira directement dans le financement de personnels de recherche, notamment de contrats doctoraux et postdoctoraux (les postes de chercheurs titulaires étant très peu financés sur des programmes de recherche de ce genre en France).

L’autre moitié du financement servira aux équipements et infrastructures scientifiques « comme des accélérateurs de particules, des réacteurs expérimentaux ou des laboratoires de radiochimie ».

Concernant les objectifs de recherche, le programme se donne l’ambition de produire des données fondamentales sur les processus nucléaires mais aussi d’analyser le comportement du corium, « un mélange de matériaux formé lorsqu’un cœur de réacteur fond durant un accident ». Les chercheurs devront aussi aller à la découverte du devenir des noyaux radioactifs (pour comprendre comment gérer leur fin d’utilisation).

Enfin, le programme prévoit le développement de « nouveaux matériaux capables de résister durablement aux fortes irradiations auxquelles sont soumis les réacteurs nucléaires ».

  •  

Le scam du support informatique via Teams, nouvelle route de piratage des infrastructures

Fake IT crowd
Le scam du support informatique via Teams, nouvelle route de piratage des infrastructures

Les scammers migrent de plus en plus de l’email vers les plateformes de collaboration d’entreprise comme Microsoft Teams pour mettre en place leurs attaques. En se faisant passer pour le support informatique, ils peuvent aller très loin dans l’infrastructure de l’entreprise visée.

Le laboratoire de recherche en cybersécurité Unit 42 de l’entreprise Palo Alto Networks a alerté ce mardi 1er septembre : des pirates ont mis en place des campagnes pour cibler le système informatique d’entreprises via des appels vocaux sur Microsoft Teams.

Comme souvent quand il s’agit de scam, les pirates utilisent leurs compétences en social engineering. « Ce qui semble être une conversation anodine est en réalité un appel de hameçonnage vocal (vishing), au cours duquel les cybercriminels tentent de contraindre leurs victimes à exécuter des outils de surveillance et de gestion à distance (RMM) ou des virus sur mesure », explique Unit 42.

Utiliser le pouvoir social du support informatique

Notamment, pour que l’utilisateur se laisse manipuler, les pirates se font passer pour le support informatique de l’entreprise. Les chercheurs de Palo Alto Networks signalent avoir repéré une campagne particulière, qu’ils nomment Spring Ring, qui a ciblé entre janvier et avril 2026 plus de 150 employés d’au moins 10 entreprises. Pour certains, les pirates sont allés jusqu’à essayer d’atteindre le contrôleur de domaine de l’entreprise, le serveur qui permet de répondre aux demandes d’authentification et donne les accès aux employés.

Pour Unit 42, cette campagne illustre « la manière dont les plateformes de communication sont utilisées comme armes, l’identité devenant un vecteur d’attaque majeur ».

Les chercheurs de Unit 42 expliquent qu’ils ont détecté cette campagne après avoir observé un schéma suspect de création de discussions. De fait, l’attaque passe d’abord en chat où l’attaquant crée une discussion sous une identité qui semble demander une attention particulière (service d’assistance informatique ou personnel de support) avec un email au domaine proche de Microsoft (ici .onmicrosoft[.]com) et dont il maitrise le sous-domaine (par exemple : ithelp@InternalSystemsDaily[.]onmicrosoft[.]com).

L’attaquant lançait ensuite un appel audio pour lui faire faire des actions présentées comme de l’assistance technique. En fait, l’utilisateur lui donnait le contrôle à distance ou exécutait un virus sans le savoir. Pour mettre la pression sur l’utilisateur, l’attaquant peut appeler plusieurs fois si l’utilisateur ne répond pas.

Deux formes d’attaques : le contrôle à distance ou l’envoi vers un faux cloud de l’entreprise

Lors de la campagne Spring Ring, Unit 42 a repéré deux formes d’attaques. Dans la première, l’attaquant incite la victime à exécuter le logiciel de gestion à distance de son entreprise et ensuite à lui donner le contrôle à distance de son ordinateur. Après avoir vérifié les informations sur l’environnement, il utilise PowerShell pour télécharger un cheval de Troie à distance qui désactive l’antivirus, envoie des données de l’utilisateur et récupère ensuite d’autres virus.

Dans l’autre forme d’attaque, le pirate envoie l’employé vers un lien pointant vers un faux cloud de son entreprise, téléchargeant un virus dont l’exécutable mentionnait le nom de cette entreprise (par exemple : nomdelentreprise-org-filters-update-nomdelavictime.exe). Dès que celui-ci est exécuté, il assure sa persistance dans le système de Windows. Puis il lance une instance cachée et sans interface graphique de Edge pour installer une extension du navigateur de Microsoft. Un script Python est enfin lancé pour scanner les ports SMB, cibler le contrôleur de domaine de l’entreprise via Microsoft NT LAN Manager et tenter « une attaque avec PetitPotam [une preuve de concept (PoC) permettant de forcer des hôtes Windows à s’authentifier auprès d’autres machines, ndlr] afin de contraindre le contrôleur de domaine à s’authentifier auprès d’une machine contrôlée par l’attaquant ».

Pour l’Unit 42, cette campagne montre un « tournant stratégique en matière d’ingénierie sociale, les attaquants allant désormais au-delà du hameçonnage par e-mail pour cibler les outils de collaboration d’entreprise ».

Microsoft alerte aussi

Cela semble aussi le cas du côté de Microsoft. En effet, quelques jours plus tard, les chercheurs de l’entreprise de Redmond ont décrit le même genre d’attaques utilisant les outils de surveillance et de gestion à distance. Ici, PowerShell était utilisé pour télécharger un paquet MSI malveillant qui met ensuite en place un environnement Node.js et un script JavaScript permettant, de façon persistante, l’exécution de commandes.

L’éditeur de Teams semble désemparé devant ce genre d’attaques, affirmant que « cette campagne repose moins sur l’exploitation de la plateforme que sur la persuasion des utilisateurs de mettre en place des processus d’accès à distance sécurisés au sein d’outils de collaboration légitimes ». Microsoft ajoute que les entreprises « doivent considérer toute demande d’assistance externe non sollicitée comme intrinsèquement suspecte et mettre en place des défenses à plusieurs niveaux, couvrant l’identité, les terminaux et la collaboration ».

Dans ses conseils, en plus du renfort de la sensibilisation des employés, Microsoft pousse quand même à utiliser des outils contre les attaques de type « ingénierie sociale », contre le phishing en général, et d’activer les règles ASR de réduction de la surface d’attaque « qui bloquent le contenu exécutable provenant des e-mails et des interpréteurs de scripts, la création de processus à partir de PowerShell/WScript/cmd, ainsi que l’exécution de contenu téléchargé, afin d’empêcher la mise en place de scripts et de fichiers MSI ». L’éditeur pousse aussi les DSI des entreprises à limiter ou surveiller l’utilisation des logiciels de gestion (et d’assistance) à distance et à contrôler quels outils sont autorisés dans leurs environnements.

  •  

☕️ Claude, ChatGPT, Gemini et Grok sont simultanément tombés en panne, SpaceXAI s’excuse


Dans la soirée de ce jeudi 3 septembre, quatre des principaux fournisseurs de services d’IA générative étaient inaccessibles.

Anthropic a d’abord signalé un problème sur Claude Sonnet 5 puis un nombre d’erreurs anormal sur Claude Mythos 5.1, Claude Fable 5.1, et Claude Opus 5. De son côté, OpenAI a relevé une hausse du nombre d’erreurs sur ChatGPT et Codex. Le statut de Grok indiquait hier soir aussi des problèmes. Et les utilisateurs de Gemini ont signalé des problèmes d’accès via le site Downdetector.

Cette panne simultanée de services d’entreprises indépendantes peut paraitre étonnante. Mais, dans la soirée (vers 21h38 heure française), SpaceXAI a publié un tweet pour s’excuser : « Nous sommes désolés pour les problèmes que vous avez pu rencontrer avec Grok à la suite d’une panne survenue ce matin dans notre centre de données de Memphis. Nous tenons également à présenter nos excuses à nos partenaires informatiques concernés ». L’entreprise d’Elon Musk ajoutait que « tous les systèmes ont désormais été rétablis et fonctionnent normalement ». « Et nous prenons des mesures correctives pour veiller à ce que cela ne se reproduise plus » a précisé sobrement Elon Musk.

Illustration : Flock

Rappelons que xAI (maintenant SpaceXAI) a ouvert en septembre 2024 au sud de Memphis un énorme datacenter nommé Colossus. L’entreprise d’Elon Musk en loue maintenant des parties à la plupart des acteurs du secteur, comme Anthropic.

  •  

L’Hôpital privé de Loire sanctionné pour absence de « mesures élémentaires de sécurité »

C'est l'hôpital qui se fout de la sécurité
L’Hôpital privé de Loire sanctionné pour absence de « mesures élémentaires de sécurité »

Il y a un an, un pirate a pu accéder aux données de 524 867 patients et 202 246 tiers de confiance de l’Hôpital privé de Loire via son système de dossier patient informatisé. La CNIL a choisi de sanctionner cet établissement de soin privé car celui-ci a été particulièrement négligent : absence de VPN, de moyen d’authentification multifacteur, mais aussi mot de passe temporaire identique pour l’ensemble des praticiens après la violation de données.

C’est une sanction de 500 000 euros d’amende que la CNIL a infligée ce jeudi 3 septembre à l’Hôpital privé de la Loire, un établissement du groupe Ramsay Santé.

La CNIL n’a pas pour habitude de sanctionner fortement des structures comme les hôpitaux, elle préfère souvent les accompagner dans une démarche de meilleure sécurisation de leurs infrastructures. Mais là, il semble que les manquements de sécurité de cet hôpital aient largement dépassé les bornes de ce que l’autorité peut laisser passer sans sanction concernant la mauvaise protection de données de santé.

Dans sa délibération, la CNIL explique que cet hôpital a été victime d’une violation de données de son dossier patient informatisé (DPI) en juin 2025. L’attaquant s’est connecté au DPI via les identifiants d’un médecin libéral rattaché à la structure.

Entre le 26 juin et le 1er juillet 2025, il a « procédé à l’exfiltration de 524 867 fiches patients contenant des informations telles que l’état civil, le numéro de sécurité sociale, les coordonnées postales et électroniques et le numéro d’identifiant permanent des patients concernés ». Plus de 46 000 de ces fiches étaient aussi associées au recto de la carte d’identité et plus de 202 000 comportaient des données relatives à la personne de confiance désignée par le patient. Enfin, 43 fiches comportaient des données de santé.

Pas de VPN ni d’authentification à 2 facteurs

Dans sa décision, la CNIL souligne « que l’obligation de sécurité prévue par l’article 32 du RGPD est une obligation de moyens ». Or, sa rapporteure « reproche à l’hôpital de ne pas avoir mis en place des mesures appropriées pour sécuriser l’accès au DPI des utilisateurs externes ». En effet, au moment de la violation de données, cet accès s’effectuait grâce à un identifiant et un mot de passe mais « sans connexion préalable à un VPN, ni moyen d’identification électronique à deux facteurs ».

Un référentiel de sécurité relatif à l’identification électronique des utilisateurs des services numériques en santé existe pourtant depuis la publication d’un arrêté le 28 mars 2022. Et celui-ci demande bien expressément de mettre en place ces dispositifs pour sécuriser les connexions extérieures.

La rapporteure souligne que, justement, l’attaquant a exploité cette vulnérabilité pour accéder au dossier patient informatisé de l’hôpital et extraire les données qu’il contenait.

Pas de surveillance automatique des logs

Autre reproche : l’hôpital n’avait pris aucune mesure d’analyse automatisée des journaux d’évènements permettant de repérer des activités inhabituelles sur le DPI. En effet, si la structure hospitalière avait mis en place un centre des opérations de sécurité (SOC), un système de supervision et un système de journalisation avec enregistrement des traces applicatives, elle n’avait pas activé l’analyse automatique en temps réel des traces applicatives du DPI.

« Cette carence de surveillance a permis à l’attaquant d’effectuer un nombre extrêmement élevé de requêtes au sein du DPI de l’hôpital pendant près d’une semaine », souligne la rapporteure. La CNIL montre d’ailleurs, après analyse des logs, que l’activité de l’attaquant aurait sans doute été détectée par un système automatisé : pendant la phase d’extraction automatique mise en place par l’attaquant, son système consultait une moyenne de 73 fiches de patients par minute.

Un mot de passe temporaire pour tous

Et ce n’est pas tout. La CNIL pointe une mauvaise pratique mise en place par l’hôpital pour atténuer les effets de l’attaque. En effet, celui-ci a enclenché une procédure de réinitialisation des mots de passe. Mais celle-ci était pour le moins problématique : elle a consisté « à attribuer un mot de passe temporaire identique à l’ensemble des praticiens, qui de surcroit ne leur a pas été transmis directement, mais a été communiqué au président de la commission médicale d’établissement, à charge pour lui de le leur retransmettre ». L’hôpital a reconnu le problème mais a insisté sur le caractère d’urgence de cette mesure.

Précisons quand même que ce mot de passe temporaire n’était valable « que » pendant une semaine. Mais la CNIL rappelle que, même temporaire, les mots de passe « doivent être confidentiels et personnels à chaque utilisateur ». L’autorité remarque que l’hôpital « a au demeurant fourni à l’ensemble des utilisateurs les moyens de se connecter à des comptes de tiers, dès lors que tous avaient durant plusieurs jours le même mot de passe, et d’accéder ainsi à toutes les données à caractère personnel auxquels ces tiers pouvaient accéder ».

La rapporteure de la CNIL reproche encore à l’hôpital d’avoir laissé à la société éditrice du logiciel de gestion de son DPI un accès permanent aux données à caractère personnel des patients. Si l’hôpital a tenté de mettre en avant le besoin de cet accès pour un support rapide et efficace, l’autorité considère que l’accès permanent et sans contrôle au DPI de l’hôpital et aux données des patients « n’est pas nécessaire au regard de la mission d’assistance technique et de maintenance de la société éditrice du logiciel ». Elle ajoute même qu’au contraire, « les salariés de l’éditeur du logiciel auraient dû systématiquement solliciter l’autorisation préalable de l’hôpital » pour effectuer une opération de maintenance.

Enfin, l’hôpital se voit reprocher sa mauvaise communication envers les personnes concernées. En effet, si son effort pour contacter ses patients n’est pas remis en cause, la CNIL considère qu’il aurait dû contacter les 202 246 personnes concernées désignées comme tiers de confiance par des patients de l’hôpital.

Outre l’amende de 500 000 euros prononcée par la CNIL, l’autorité enjoint l’Hôpital privé de la Loire de mettre en conformité ses outils de sécurité et à n’ouvrir l’accès de l’éditeur du logiciel Expert Santé au DPI que sur autorisation préalable de l’hôpital sous menace de peines de jours-amende. Comme dans pareille décision de la CNIL, l’Hôpital privé de la Loire peut faire un recours devant le Conseil d’État dans un délai de deux mois.

  •  

☕️ Zohran Mamdani, le maire de New York, interdit l’utilisation de l’IA générative avant la 4e


La ville de New York met en place un moratoire d’un an sur l’utilisation de l’IA générative par les élèves de ses établissements scolaires. Celui-ci entre en vigueur pour l’année scolaire 2026 - 2027 pour les classes allant de la maternelle (2-K) à la quatrième (aux États-Unis, le huitième grade).

Cette décision touchera environ 600 000 élèves dans le district scolaire (l’équivalent d’une académie en France) le plus important des États-Unis, selon CNN.

Illustration : Flock

« Les enfants ont besoin d’enseignants et de liens humains pour apprendre et s’épanouir. Ils doivent acquérir des compétences aux côtés de leurs camarades, nouer des relations avec leurs enseignants et se confronter seuls à des problèmes complexes », a affirmé Zohran Mamdani lors d’une conférence de presse à ce sujet. « Le secteur des technologies veut nous faire croire que l’éducation préscolaire basée sur l’intelligence artificielle est non seulement inévitable, mais aussi nécessaire. Nous ne partageons pas ce point de vue », a-t-il ajouté.

Rappelons qu’en France un cadre d’usage de l’IA générative existe. S’il est critiqué par certains, une chose y est claire : pas d’utilisation pédagogique de l’IA à l’école avant la quatrième.

  •  
❌