Google ne manque jamais une occasion de faire la promotion de Chrome ou de sa propre application de recherche dans Safari, tout particulièrement sur iPhone. Apple voudrait en avoir le cœur net et mesurer précisément le volume et la fréquence de ces bannières et de ces panneaux souvent envahissants.
Illustration : Flock
La bêta 2 d’iOS 27.2 contient en tout cas des outils de télémétrie pour relever l’usage que fait Google de ces promotions dans Safari, d’après le code découvert par le site 9to5Mac. Cela ne veut pas nécessairement dire qu’ils seront présents dans la version finale d’iOS 27.2, mais leur présence dans la bêta confirme l’expérimentation par Apple de cette fonction.
Safari injecte un script JavaScript dans certaines pages du site de Google : accueil et résultats de recherche. Il cherche les bannières et les éléments visuels qui incitent les utilisateurs à lancer Chrome ou l’app Google. Lorsqu’une de ces promotions est détectée, le navigateur peut enregistrer plusieurs informations : si elle a été affichée, si l’utilisateur a interagi avec elle, ou encore s’il semble connecté à un compte Google.
Apple est ainsi en mesure de déterminer si l’utilisateur a accepté ou ignoré les sollicitations de Google. Reste à savoir pour quoi faire. 9to5Mac avance l’idée que ces outils pourraient être indispensables dans un cadre réglementaire. Dans l’UE, le règlement sur les marchés numériques oblige Apple à proposer aux internautes le choix du navigateur et du moteur de recherche. Mais pourquoi dans ce cas se limiter à Chrome ?
Les « aperçus IA » qui s’affichent en tête des résultats d’une recherche Google sont générés à partir de contenus produits par des sites web. Après avoir capté une partie de leur trafic grâce à ces résumés, Google aurait commencé à rémunérer des éditeurs pour leurs contenus.
Avec les AI Overviews (Aperçus IA en France), Google prive les sites web d’une partie de leur trafic et donc, de leurs revenus publicitaires. Les internautes ne sont plus incités à se rendre sur ces sites, se contentant bien souvent des résumés générés par IA. C’est la double peine pour les éditeurs, qui se font voler à la fois leurs contenus et leurs lecteurs. Et cela explique aussi la méfiance de plus en plus grande de plusieurs d’entre eux, qui envisagent tout simplement de couper les ponts avec le moteur de recherche dominant.
Fin 2025, la Commission européenne ouvrait une enquête sur Google, accusé de fausser la concurrence en imposant des conditions abusives aux éditeurs et aux créateurs de contenu qui désavantagent les développeurs d’IA concurrents.
Poussé par les régulateurs, Google a dû mettre en place cet été un réglage permettant aux éditeurs d’interdire la collecte de leurs articles pour entraîner les modèles IA de l’entreprise. Tout en autorisant tout de même l’indexation de ces mêmes articles, pour les intégrer dans les résultats de recherche classiques.
Le baiser de la mort
Mais avant de générer des aperçus IA, faut-il encore avoir la matière première : les contenus. Et Google a toujours besoin des sites web. Le site The Information rapporte l’existence d’un programme pilote lancé il y a moins d’un an ; il rémunère une centaine d’éditeurs de sites web. Les sommes varient en fonction de la contribution de leurs contenus aux réponses générées par l’IA dans son moteur de recherche, ainsi que dans le mode IA et dans le chatbot Gemini.
Un éditeur anonyme aurait, depuis son inscription au programme, touché entre 50 000 et 60 000 dollars, ce qui ne représente qu’une petite partie de son activité. Un autre perçoit plus d’un million de dollars par an, ce qui est une part plus significative de son chiffre d’affaires. Les sommes peuvent sembler importantes, mais tout dépend de la taille des éditeurs et de leurs rédactions. Certains sites doivent se contenter de moins de 1 000 dollars sur plusieurs mois.
Pour les petits sites qui participent à ces tests, les sommes versées par Google pèseraient pour moins de 0,1 % de leurs revenus publicitaires, d’après les sources de The Information. La petitesse de ces enveloppes auraient même dissuadé des éditeurs plus importants de se lancer. Ce faisant, ils espèrent pousser Google à mieux valoriser les contenus utilisés pour l’entraînement des IA.
Un modèle pour le secteur de la presse en ligne ?
Plus pragmatiques, d’autres éditeurs espèrent comprendre le type de contenus favorisés par Google et son IA, afin d’optimiser leurs articles et profiter de la manne. Un dirigeant d’un éditeur indique que Google décide seule de la valeur des contenus afin de garder le mystère sur la boîte noire de son système de génération IA.
Des participants au programme n’auraient aucune idée de la manière dont Google calcule les rémunérations, ni ce que Google considère comme une contribution significative à un aperçu IA. Des contenus consacrés à des sujets niches (comme les anime ou les jeux vidéo) mais suscitant un fort intérêt de la part des internautes, semblent toutefois rapporter davantage.
Beaucoup des participants espèrent que ce programme fera figure de modèle à suivre pour les autres acteurs de l’IA qui ont tendance à jeter par dessus bord le copyright au nom d’un « usage légitime » qui a parfois bon dos. Il faudra au préalable que Google officialise l’initiative et que davantage d’éditeurs y participent.
OpenAI déploie son outil de filigrane sur le texte généré par ChatGPT. Cette fonctionnalité, réservée au Vieux continent en vertu de l’AI Act, demeure une solution imparfaite à un problème complexe.
Après Anthropic qui a intégré une fonction de filigrane dans le texte généré par Claude (depuis Fable 5.1 plus précisément), c’est au tour d’OpenAI de respecter l’obligation européenne de permettre l’identification d’un texte généré par ChatGPT. Cette mesure, inscrite dans l’AI Act, est en vigueur depuis début août – les systèmes d’IA présents sur le marché ont jusqu’au 2 décembre pour respecter les obligations de marquage technique.
OpenAI a donc dévoilé sa feuille de route pour le tatouage des textes. La technologie, baptisée textGrain, ajoute un « signal statistique invisible » sur les choix des mots. Autrement dit, c’est une technique qui « modifie subtilement la manière dont le modèle choisit de façon aléatoire entre plusieurs mots ou fragments de mots possibles au fil de la génération [du texte] », explicite l’entreprise dans une fiche technique.
« Sur l’ensemble d’un passage, ces choix créent un motif qu’un détecteur peut repérer, même après certaines modifications du texte. » Le résultat est censé être invisible aux yeux du lecteur, la technique n’ajoutant « aucun caractère caché, espace invisible ou signe de ponctuation inhabituel ». Anthropic a choisi une solution similaire.
Pangram, qui a beaucoup fait parler ces dernières semaines suite à l’affaire Thélyson Orélien, analyse les textes après leur génération, en se basant sur des caractéristiques comme le choix des mots. Il ne détecte pas les signaux intégrés à même les textes, comme c’est le cas des filigranes.
Le code des bonnes pratiques sur la transparence des contenus de l’AI Act n’impose pas de watermark sur les textes de moins de 200 tokens, ce qui représente environ 150 mots en anglais. De toute manière, les techniques de filigrane ne sont pas efficaces sur les textes courts, comme le rappelle OpenAI.
Image : OpenAI
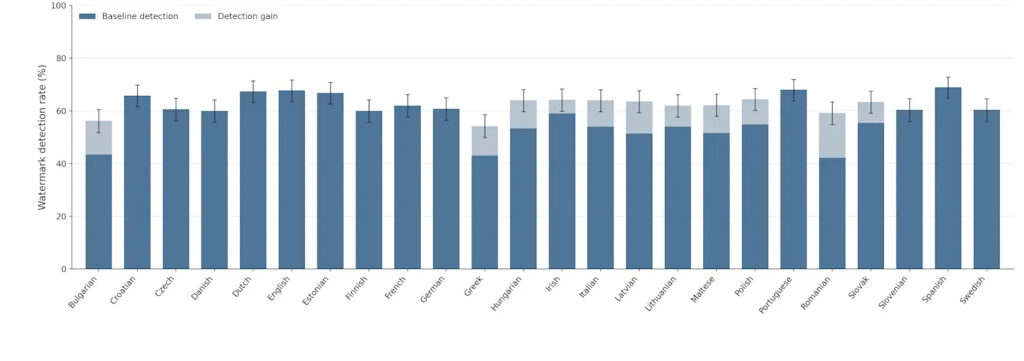
Le taux de détection varie en fonction de la langue, certaines d’entre elles se montrant « plus faciles à détecter que d’autres ». Sur les tests réalisés par l’entreprise – 500 prompts générés en anglais, puis traduits –, l’espagnol obtient le meilleur taux de détection (69 %), le roumain affichant le taux le plus faible (42,2 %). Avec un taux qui dépasse 60 %, le français est plus proche de l’espagnol.
OpenAI ajoute à textGrain un paramètre d’ajustement de l’intensité pour renforcer ou réduire le signal du filigrane en fonction des domaines. Le taux de détection de certaines langues, qui se situe normalement sous le seuil des 60 %, s’améliore grâce à ce paramètre. L’entreprise a l’intention de proposer sa technologie en open source.
Image : OpenAI
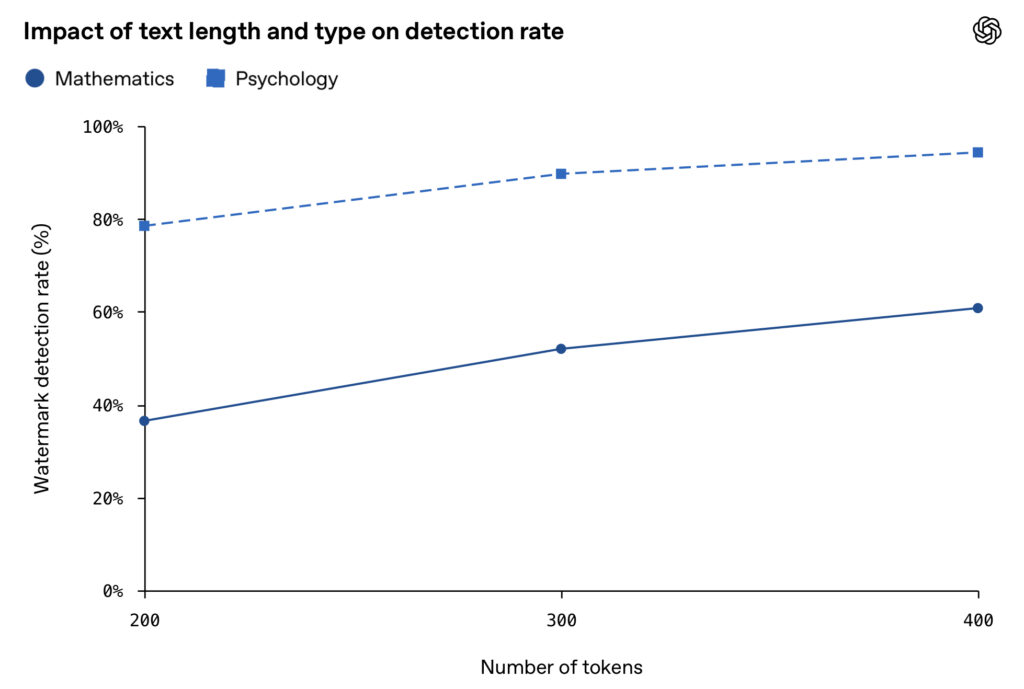
OpenAI explique que les détecteurs peuvent commettre deux types d’erreurs de détection : faux positifs (signaler la présence d’un filigrane qui n’existe pas) et faux négatifs (ne pas repérer la présence d’un filigrane existant). Sur des passages de 400 tokens, avec un taux de faux positifs cible de 1 %, le détecteur a identifié un filigrane dans 95 % des cas – mais tout dépend du contenu. Sur les textes portant sur la psychologie, le taux de détection est particulièrement élevé ; il l’est beaucoup moins quand il s’agit de mathématiques, où le choix des mots est plus limité.
Brouiller les pistes
Autre limite : modifier les textes générés par IA a un impact sur le taux de détection. Un taux de détection à 92 % peut tomber à 66 % si 10 % des mots ont été remplacés par des synonymes. Remplacer 25 % des mots fait chuter le taux à 17 %. Ce qui est logique, au vu du fonctionnement du filigrane.
L’entreprise prévient aussi que les filigranes sur le texte ne sont pas la panacée. Un watermark ne mesure pas la contribution d’un humain, il se contente de dire qu’un modèle a généré ou modifié un texte. Il ne détermine pas non plus à qui appartient le texte ou qui en est le responsable. Il n’identifie pas non plus l’utilisateur et ne mesure pas la fiabilité du texte. Enfin, l’absence d’un filigrane ne prouve pas qu’un texte a été écrit par un humain.
textGrain est disponible dès aujourd’hui dans l’API, où la fonction peut être activée via les réglages (uniquement dans l’UE). Il se déploiera au sein de ChatGPT et Codex dans les prochaines semaines. En revanche, l’accès à l’outil de détection demeure encore la chasse gardée des chercheurs et des organisations sélectionnés qui travaillent à l’amélioration de la fiabilité de l’outil.
ChatGPT, Claude ou Gemini ont une mémoire qui leur permettent d’enregistrer certaines informations importantes sur leurs utilisateurs, afin de se « souvenir » d’un détail, d’un nom, d’un événement ou d’une date utile à une réponse. C’est le cas aussi de Muse, mais le nouvel agent de Meta pousse le principe beaucoup plus loin.
Avec Muse, Meta semble enfin avoir trouvé sa voie dans la course à l’IA. L’agent, lancé le 6 septembre mais toujours indisponible dans l’Union européenne, va bien plus loin qu’un « simple » chatbot : il peut chasser des informations sur internet en permanence et agir au nom de l’utilisateur, par exemple pour réserver un restau ou faire des courses (ce qui déplaît beaucoup à Amazon). Le succès de Muse ne tombe pas du ciel : Meta s’est fortement inspirée d’OpenClaw pour développer son propre agent. Et l’entreprise peut aussi compter sur l’immense surface de ses réseaux sociaux pour se donner une confortable longueur d’avance.
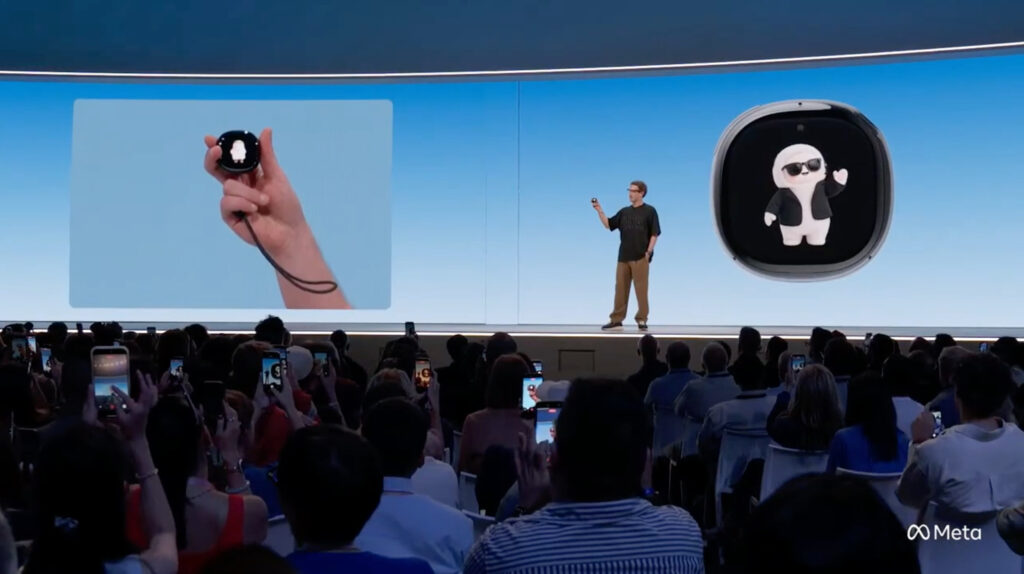
Le Charm dévoilé par Mark Zuckerberg durant la dernière conférence Meta Connect.
Le succès de Muse n’est pas tombé dans l’oreille d’un sourd : OpenAI a présenté pas plus tard que la semaine dernière son propre agent IA, Dots. Et Meta compte bien battre le fer tant qu’il est chaud. Muse est mis à toutes les sauces dans les autres produits et services du groupe, qu’il s’agisse de lunettes connectées… ou de Tamagotchi.
Les petites fiches de Muse
Mais Meta traîne derrière elle suffisamment de casseroles sur la vie privée pour que le fonctionnement de Muse mérite qu’on y regarde de plus près. Karan Joshi, chercheur en sécurité indépendant, a pu extraire un grand volume d’instructions et de prompts de l’agent, simplement en utilisant astucieusement l’interface de discussion. Il en a partagé une copie avec Wired, ce qui permet de jeter un œil dans les cuisines.
Il se trouve que Muse crée une page pour chaque personne importante dans la vie de l’utilisateur. Il s’agit de compiler des informations sur la famille, les intimes, les amis, les collègues, les personnes suivies par l’utilisateur. Cette mémoire, en fait des fichiers de texte structuré, se remplit au fur et à mesure des événements et des interactions ; ces données permettent à l’agent de construire une « représentation » des relations, avec le degré de proximité, l’historique, et même des pistes pour les renforcer.
D’après la documentation fournie par Karan Joshi, une « page » s’enrichit progressivement avec des sections : « Faits », « Historique », « Relation », « Points communs », « Sujets en suspens » et « Renforcement ». Muse doit uniquement utiliser les éléments qu’il a sous la main, et ne pas inventer des informations même si la page est vide.
Selon les instructions de Meta, Muse doit conserver « les sujets qui reviennent régulièrement (le déménagement, l’objectif commun d’épargne) », où vivent les relations de l’utilisateur, ce qu’elles font dans la vie. Le modèle peut également enregistrer les dates importantes comme les anniversaires, et des éléments de contexte comme une dispute terminée (certains parlent de beaucoup de choses très personnelles avec leur bot), une réunion importante la semaine dernière, un voyage…
L’enregistrement de l’état des relations est aussi manifestement important pour Muse : degré de proximité, sur quoi repose telle relation, ce dont cette relation peut avoir besoin… La section « Renforcements » peut d’ailleurs suggérer des moyens d’améliorer une relation : rappeler une date à ne pas oublier, une raison d’appeler…
Le plombier n’a rien demandé
« Pour qu’un agent soit utile et puisse réellement vous aider à atteindre vos objectifs, il doit disposer d’un certain contexte sur vous et sur les personnes avec lesquelles vous interagissez », explique un porte-parole de Meta. « Muse rassemble ces informations à partir de données publiques et de ce que vous avez choisi de partager. C’est ainsi qu’il peut se souvenir que la personne qui vous a envoyé une facture est en fait le plombier que vous aviez précédemment engagé pour effectuer des travaux dans votre salle de bains, ou encore l’envoi à votre conjoint de ses fleurs préférées. »
Une déclaration apparemment de bon sens, à laquelle on peut ajouter l’infrastructure de Muse. Il s’agit d’une machine virtuelle dans laquelle sont stockés les données de l’utilisateur et le contexte. Les agents tiers n’y ont pas accès sans autorisation, et l’utilisateur peut déconnecter les services tiers connectés à Muse, ou tout simplement en effacer la mémoire.
Muse va néanmoins plus loin que d’autres bots IA dans le stockage d’informations sur les personnes connues de l’utilisateur. ChatGPT possède une mémoire structurée, mais OpenAI la présente comme une synthèse évolutive du contexte entourant l’utilisateur. L’IA sélectionne les infos jugées pertinentes et la synthèse se met à jour et s’enrichit au fil du temps.
Le système de Meta organise les informations sur la relation qu’entretient un utilisateur avec une personne, leur historique, le degré de proximité, les sujets en suspens et peut même proposer des moyens de renforcer cette relation. Le problème ici, c’est la réputation exécrable de Meta quand il s’agit de manipuler les données personnelles, comme on l’a vu encore très récemment avec… Muse :
Enfin, le conjoint, les collègues, ou ce fameux plombier n’ont rien demandé, et surtout pas à être intégrés dans les petites fiches de Muse. Mais il suffit que l’utilisateur ait évoqué ces relations pour que ces personnes se retrouvent dans la mémoire de l’agent. L’utilisateur a certes accepté de partager des données publiques, mais pas nécessairement de ficher son entourage.
Sony Music prend le taureau par les cornes pour lutter contre les streams illégaux de chansons générées par IA. Fin septembre, la major a demandé aux plateformes le retrait de plus de 260 000 morceaux, un volume multiplié par deux par rapport aux trois premiers mois de l’année.
« Nous continuerons à faire respecter les droits de nos artistes et nous attendons des plateformes qu’elles agissent rapidement et empêchent la réapparition des mêmes contenus », a affirmé Sony Music au Financial Times. « Mais la tâche devient de plus en plus difficile », ajoute l’entreprise, une des trois majors de l’industrie du disque avec Universal (UMG) et Warner (WMG).
Le groupe a demandé aux plateformes de streaming de retirer plus de 260 000 morceaux fin septembre, alors que ce volume avait été de 135 000 fin mars. Ces titres sont des deepfakes générés par IA d’artistes signés par Sony (Adele, Queen, Michael Jackson…). Le phénomène prend « une ampleur considérable, porte préjudice aux artistes, trompe les fans et compromet une utilisation éthique de l’IA », précise la maison de disques.
Les bots écoutent les bots
Les services de streaming sont noyés sous les chansons générées par IA. Deezer avait ainsi indiqué qu’elles représentaient plus de la moitié des nouveaux morceaux téléversés en juillet. Ces titres sont très peu écoutés, et quand ils le sont, c’est souvent lié à des cas de fraude aux streams. Des bots « écoutent » ces chansons, ce qui en retour génère des revenus pour les fraudeurs, spoliant au passage les artistes légitimes.
Le rapport semestriel de la Sonic Intelligence Academy publié le mois dernier montre que plus de 9 chansons sur 10 (92,8 %) des morceaux soumis avaient été générés par Suno. Avec cette nuance : le pourcentage porte sur l’échantillon de l’étude, soit 1 743 titres provenant de 886 artistes dans 54 pays. Sur cet échantillon, 77,6 % ont été distribués aux plateformes par DistroKid, un distributeur payant permettant à ses clients d’être diffusé sur plus de 150 plateformes. Ces chiffres donnent toutefois une petite idée de la provenance de ces titres.
Sony Music et Universal poursuivent d’ailleurs Suno en septembre. La start-up est accusée d’avoir copié des enregistrements sans autorisation pour entraîner ses modèles IA. DistroKid est aussi la cible d’UMG, qui a porté plainte contre le distributeur le 15 septembre (PDF). Ce dernier se serait livré à « des pratiques commerciales trompeuses et à des violations flagrantes du droit d’auteur ». Plus précisément, DistroKid aurait contribué « à faire passer les morceaux IA pour ce qu’ils ne sont pas, et à en tirer profit ».
La riposte contre la fraude aux streams s’organise dans la filière, qui a couché sur le papier un ensemble de pratiques pour aider les acteurs du secteur – en particulier les distributeurs – à prévenir, détecter et traiter la fraude.
De leur côté, les plateformes ont mis en place des systèmes de badges pour indiquer aux auditeurs que tel artiste ou telle chanson est générée par IA. Bien souvent, les écoutes de ces morceaux sont démonétisées dès leur mise en ligne.
Malgré les restrictions imposées par les États-Unis, les affaires continuent pour Huawei. Le géant chinois et Qualcomm ont annoncé un accord pluriannuel de licences de brevets sur des technologies comme la 5G, l’IA, les réseaux, l’informatique. Qualcomm va également acquérir « certains brevets américains » de Huawei (ils ne sont pas précisés) dans ces domaines.
Crédit : Licence Creative Commons by Web Summit
« Cet accord reflète l’engagement commun des deux entreprises en faveur du respect des droits de propriété intellectuelle et de pratiques de licence conformes aux principes FRAND [conditions équitables, raisonnables et non discriminatoires] », ajoute le communiqué de presse commun. L’accord reflète la « reconnaissance par Qualcomm » des technologies de Huawei et de sa propriété intellectuelle, poursuit John Han, directeur général de l’activité licences au sein de l’entreprise américaine.
Huawei est sur la liste noire du Département du Commerce depuis 2019, ce qui impose aux entreprises US d’obtenir une licence avant d’exporter, de réexporter ou de transférer au groupe chinois des produits et composants soumis aux règles américaines d’exportation. Les restrictions n’ont pas cessé de s’empiler depuis, les autorités craignant que la technologie américaine puisse être utilisée pour nuire à la sécurité nationale.
Huawei a donc dû fortement investir ces dernières années pour développer ses propres technologies, avec des résultats pour le moins intéressants qui entraînent dans leur sillage toute l’industrie chinoise. Ce qui participe à accélérer l’indépendance technologique du pays vis à vis des États-Unis.
Le 26 août dernier, Huawei avait par ailleurs annoncé un accord avec HP portant sur des licences croisées de brevets portant sur la technologie Wi-Fi. Curieusement, HP a pris ses distances avec Huawei, en parlant de « mauvaise interprétation » pour cet accord « faisant passer le règlement d’un litige juridique pour un partenariat plus large. » HP a martelé que Huawei n’était pas un de ses fournisseurs, pas plus que HP n’est un fournisseur de Huawei.
Cette fois, pas de dissension ou de mauvaise compréhension entre Huawei et Qualcomm. Néanmoins, leur accord est soumis à des autorisations réglementaires.
Apple n’a pas supprimé l’application ICEBlock sous la pression de l’administration Trump, affirme l’entreprise. Il s’agissait, selon elle, de protéger les agents de la police de l’immigration américaine après une fusillade dans un centre de détention de l’ICE. Un argument crédible ?
Droit dans ses bottes. La décision de supprimer ICEBlock (et d’autres applications du même genre) de l’App Store était motivée par des préoccupations concernant la sécurité des agents de la police de l’immigration américaine. C’est ce qu’affirme Apple dans un courrier envoyé à Jamie Raskin, représentant démocrate et membre de la commission judiciaire de la Chambre des représentants américains. Un courrier partagé par CNN.
Raskin a lancé une enquête au mois de juin sur le rôle du ministère de la Justice (DoJ) dans la suppression de ces applications des boutiques d’Apple et de Google. Joshua Aaron, le développeur d’ICEBlock, avait porté plainte contre l’administration Trump en décembre dernier, deux mois après le retrait de son app de l’App Store.
Il accuse le gouvernement d’avoir fait pression sur Apple, ce que la procureure générale des États-Unis de l’époque, Pam Bondi, avait d’ailleurs confirmé dans une déclaration ne laissant planer guère de doute : « Nous avons contacté Apple aujourd’hui pour leur demander de retirer l’application ICEBlock de leur App Store, et Apple l’a fait ».
La fusillade de Dallas au cœur de la justification d’Apple
Dans cette lettre, qui remonte au mois de juillet, Apple explique qu’ICEBlock a été autorisée en avril 2025, après que le développeur a serré les boulons sur des fonctions de confidentialité. Pour rappel, l’app permettait à quiconque d’alerter les utilisateurs d’une descente de la tristement célèbre police de l’ICE dans les parages.
En septembre 2025, une fusillade a lieu dans un centre de détention de l’ICE à Dallas (Texas), faisant trois morts : deux détenus et l’auteur des tirs. Selon Apple, c’est après cet événement que Pam Bondi a fait part de ses inquiétudes concernant ICEBlock, une app qui « représente une menace pour la sécurité des agents fédéraux ». Kash Patel, le directeur du FBI, avait également affirmé que le tireur avait recherché des apps permettant de connaître la localisation des agents.
Apple indique aussi avoir relevé une hausse importante des activités de l’ICE et des menaces visant l’agence. La situation pouvait mettre en danger aussi bien les agents que les personnes détenues, écrit Timothy Powderly, directeur principal des affaires gouvernementales de l’entreprise. Ce sont tous ces éléments qui l’ont conduit à un nouvel examen de l’application.
Apple a déterminé qu’ICEBlock et les autres plateformes de localisation des agents de la police de l’immigration enfreignaient ses politiques, « et, par conséquent, d’autres personnes susceptibles de se trouver à proximité, comme des manifestants ou des personnes détenues —, offrant ainsi une possible feuille de route pour des violences ciblées et créant un risque important de préjudice ».
Un « risque important » de violences ciblées
L’opérateur de l’App Store assure ne pas prendre à la légère la décision de retirer des applications, mais qu’il intervient quand c’est nécessaire, « en particulier lorsqu’il existe de sérieuses raisons de penser qu’une application crée des risques pour la sécurité ». Des explications qui exonèrent l’administration Trump des accusations de pression politique, mais qui ne convainquent pas Jamie Raskin.
Dans sa réponse envoyée ce lundi à Timothy Powderly, le représentant écrit qu’Apple porterait atteinte aux droits garantis par le premier amendement de la Constitution américaine, « notamment celui de documenter les activités de leur propre gouvernement et d’en rendre compte ». Selon Raskin, il n’existe aucune preuve que ces apps aient été utilisées pour commettre la fusillade de Dallas.
Même si le tireur a pu rechercher des apps pour localiser les agents de l’ICE, « il n’avait pas besoin d’une application de suivi pour localiser un bâtiment gouvernemental dont l’emplacement est fixe ». Le tireur aurait tout simplement trouvé l’adresse du centre à l’aide d’une app « installée par défaut sur les appareils Apple » (probablement Apple Plans).
Pour Jamie Raskin, il n’existe aucun lien direct entre ce qui s’est passé à Dallas et les applications retirées de la boutique. Le représentant demande au constructeur de procéder à un nouvel examen indépendant pour décider si ces applications enfreignent réellement les règles de l’App Store.
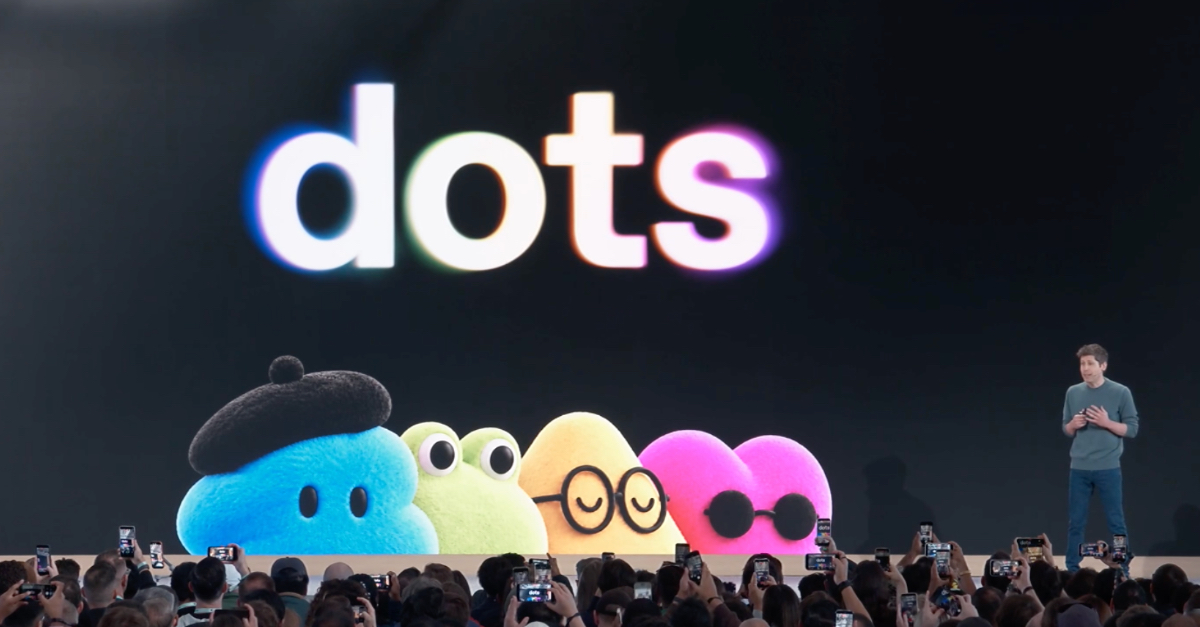
Dans le petit monde de l’IA, beaucoup se demandaient quand OpenAI allait réagir face à l’offensive de Meta avec son agent Muse. C’est chose faite ce soir avec la présentation de Dots, un agent qui accomplit des tâches au nom de l’utilisateur et qui prend la forme d’un blob de couleur. Ça n’est que l’une des innombrables annonces d’OpenAI à l’occasion des DevDay 2026.
Que d’IA, n’en jetez plus, le bateau déborde ! Loin de ralentir la cadence, OpenAI a noyé les participants des DevDay 2026 d’annonces, de nouveautés et de fonctionnalités en tout genre. Difficile de faire le tri dans ce tsunami, mais Dots fait clairement partie des gros morceaux de la keynote.
Un blob pour gouverner vos tâches
Dot est un agent IA carburant à GPT-6 Astra qui prend la forme d’un blob coloré à personnaliser, un peu comme Mico, la (défunte) mascotte de Copilot. Cet agent peut réaliser les opérations classiques d’un agent IA, comme réserver un restaurant ou acheter un billet d’avion, mais cela va plus loin : en plus d’être branché aux applications de l’utilisateur dont il tire du contexte, le Dot surveille constamment ce qui se passe sur internet afin de compléter les tâches plus complexes.
Dans un exemple donné par OpenAI, un utilisateur de Dot veut organiser un dîner. L’agent détecte de lui-même que l’utilisateur avait un rendez-vous de travail pendant l’heure prévue, et lui propose deux possibilités de livraison du repas avec leur prix respectif. Il n’y a plus qu’à valider l’alternative et l’heure de la livraison. Dot peut également se dépatouiller pour créer un site web de A à Z, l’utilisateur n’ayant qu’à demander des modifications.
On peut communiquer avec un Dot via ChatGPT bien sûr, mais aussi Slack, Teams, et même via une messagerie (RCS ou iMessage) pour les abonnés Pro à partir de 103 euros. Ces derniers seront d’ailleurs les premiers à pouvoir tester ces Dots. À terme, OpenAI a l’intention de proposer la possibilité de contrôler plusieurs agents simultanément.
Il faudra se montrer patient sur le vieux continent : l’espace économique européen, la Suisse et le Royaume-Uni sont pour le moment exclus du lancement.
Spaces, Decisions, Codex : le reste de l’offensive
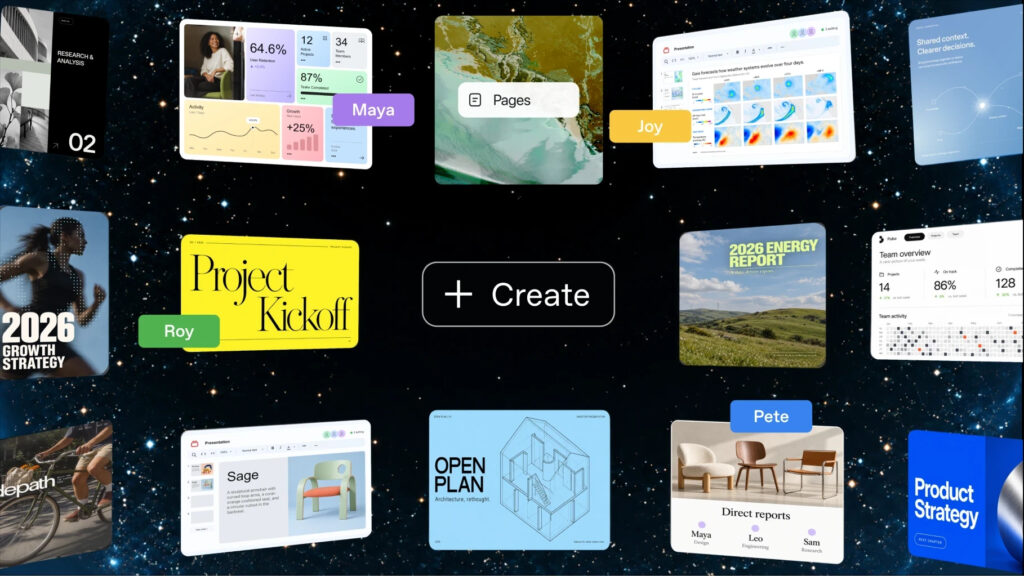
Après s’être attaqué à Muse, OpenAI entend également gravir la montagne bureautique. ChatGPT Spaces est un espace collaboratif entre humains et Dots où ils peuvent créer et éditer des documents, via un système de commentaires où l’on taggue les collègues et les agents. Les fichiers téléversés par l’équipe (et ceux générés par ChatGPT) sont sauvegardés dans le Space pour que chacun y ait accès.
L’offre comprend pour le moment un traitement de texte, Pages, et un outil de création de diapositives (ce dernier étant encore en développement). Space est proposé dès aujourd’hui aux abonnés Pro, Business Premium et Enterprise.
Tout comme celui de Muse, le succès de Jev n’est pas tombé dans l’oreille d’un sourd. OpenAI a donc levé le voile sur l’API Decisions, qui repose sur Luna (le modèle meilleur marché de la gamme). Peu de détails ont été révélés, mais cette interface de programmation n’est pas un modèle qui répond directement à la question de l’utilisateur. C’est un outil qui indique le niveau de confiance dans un choix entre plusieurs réponses et actions fournis par le développeur. L’API est en aperçu limité à l’heure actuelle, OpenAI donnera davantage de détails au moment opportun.
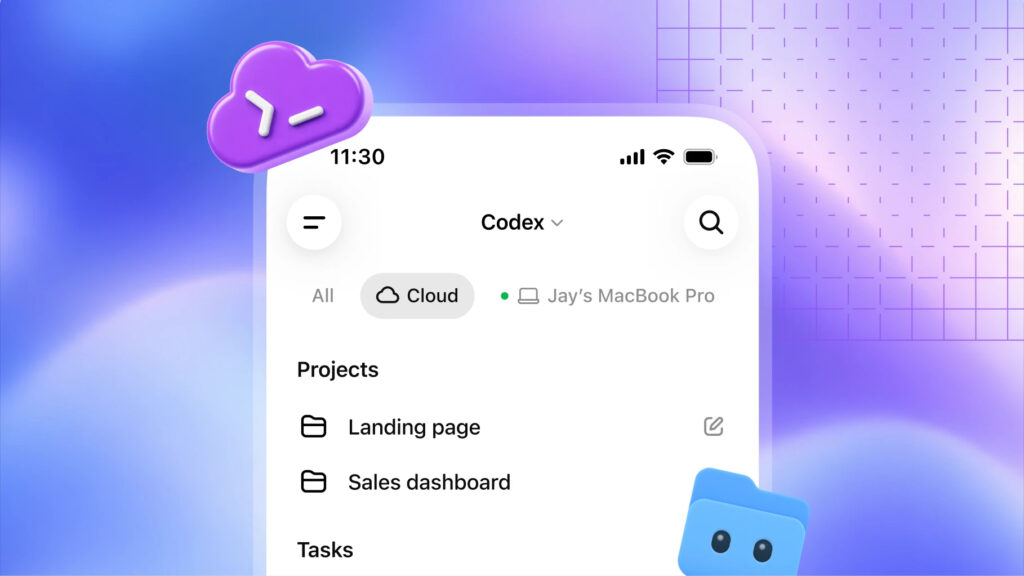
Codex a aussi été à la fête, avec plusieurs nouveautés importantes. À commencer par des environnements de développement cloud réutilisables ; ces derniers peuvent être partagés au sein d’une équipe avec un système de réglages et de permissions. L’interface en ligne de commande peut désormais être pilotée à la voix, parce que pourquoi pas.
Dans l’app Codex (en fait ChatGPT avec une moustache), la revue de code a été revue et améliorée. Elle peut résumer les changements, répondre à des questions sur les problèmes qui pourraient se poser avant de commenter une pull request ou une merge request, et ces revues de code peuvent être lancées pendant que le développeur n’est pas devant sa machine.
GPT-6.1 Sol veut se rapprocher d’Astra
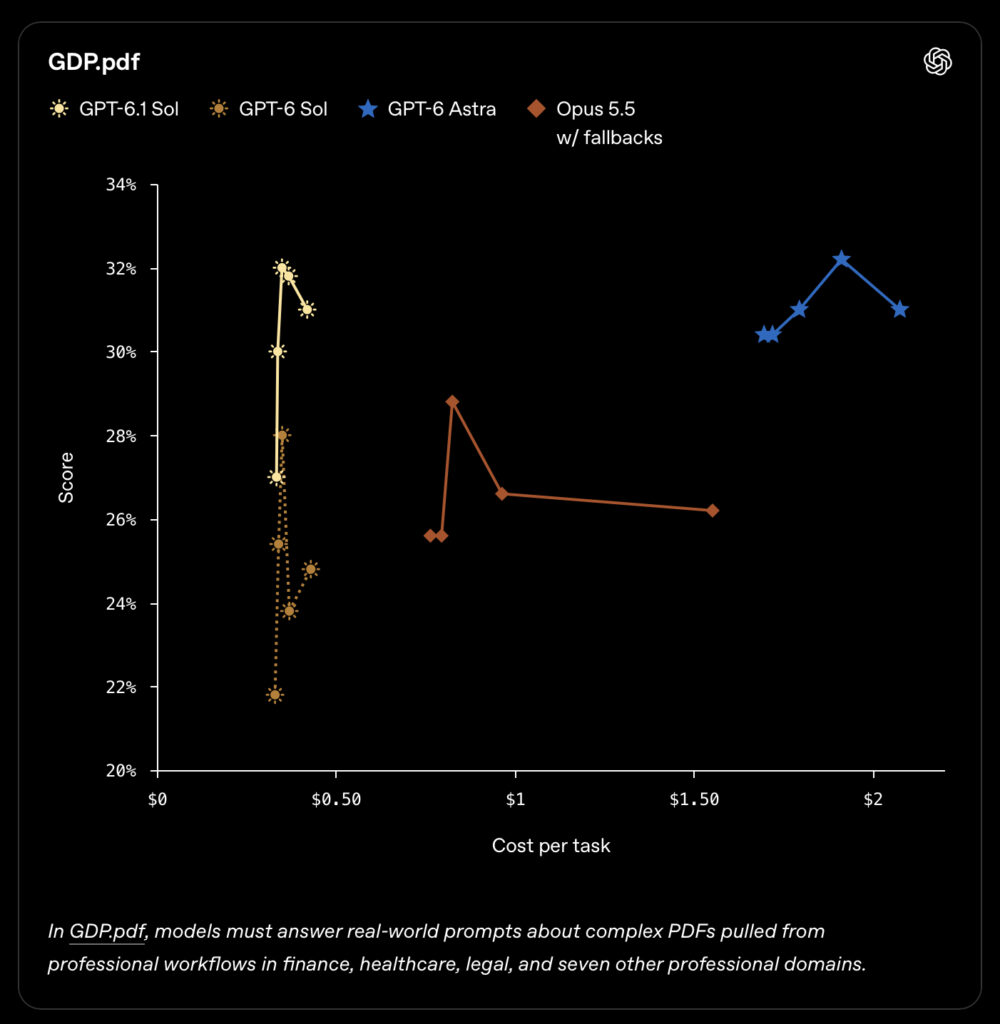
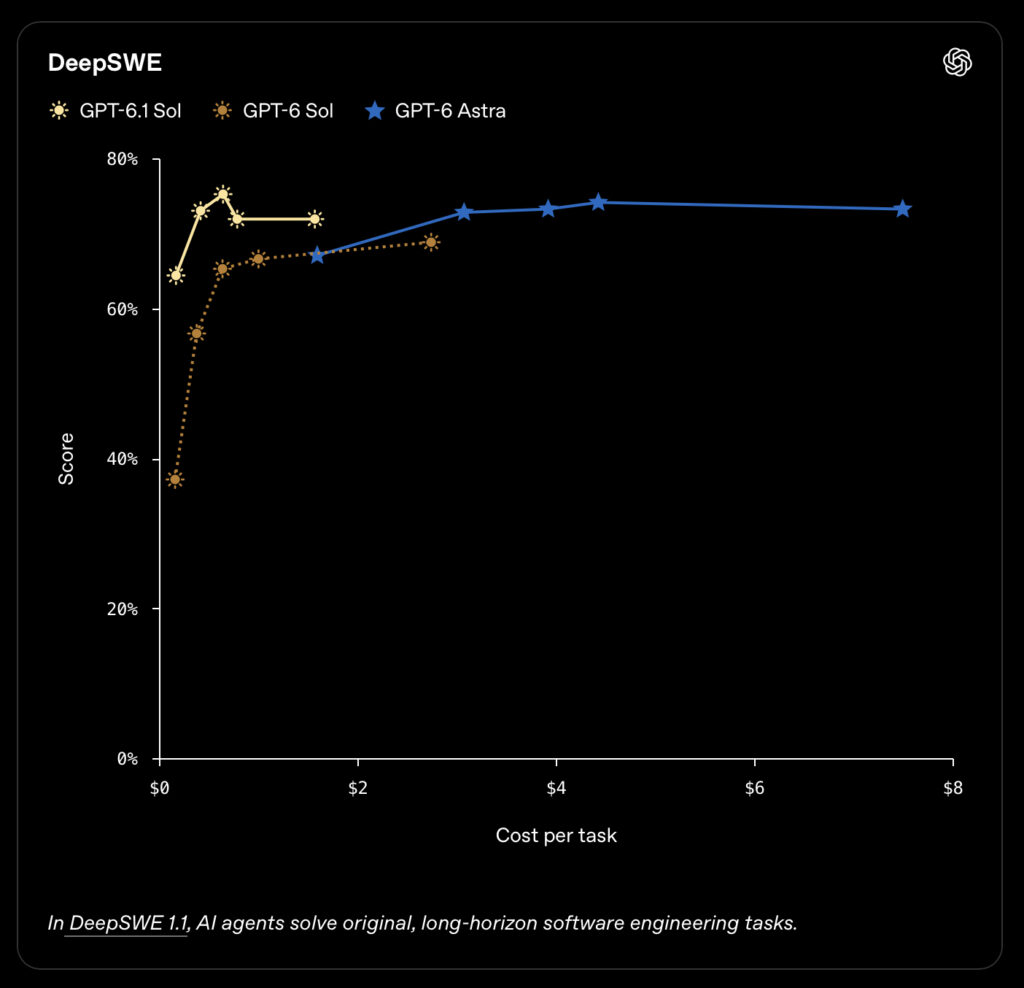
OpenAI a enfin profité de l’occasion pour dévoiler GPT-6.1 Sol, le modèle IA intermédiaire entre le puissant Astra et le moins cher Luna qui en sont tous deux restés à GPT-6 (ça ne va pas durer). L’entreprise promet un gain de performances important sur des tâches comme l’écriture de code et le déboggage par rapport à GPT-6 Sol, ainsi que sur la compréhension des documents et l’exécution de plusieurs tâches.
Dans plusieurs des évaluations, GPT-6.1 Sol s’approcherait même des capacités de GPT-6 Astra « à un coût substantiellement moins élevé ». Les prix, parlons-en : 2 dollars pour un million de tokens en entrée, 10 dollars en sortie, soit les mêmes tarifs que Sonnet 5.5, et 0,10 dollar pour un million de tokens d’entrée mis en cache (moitié moins cher que le dernier Sonnet). Le modèle est en phase de déploiement dès aujourd’hui pour les abonnés Plus, Pro, Business, Enterprise et Edu, ainsi que dans l’API.
Il va bien falloir financer cette tempête de nouvelles fonctionnalités ! OpenAI a donc dévoilé un nouvel abonnement qui coûte la bagatelle de 500 dollars par mois. Il comprend l’accès à un mode « UltraFast » (vitesse maximale) pour ChatGPT Work et Codex, ils pourront carburer à 300 tokens par seconde (la vitesse UltraFast est aussi proposée aux utilisateurs de l’API).
L’entreprise a également rouvert les inscriptions à la formule à 200 dollars par mois qui avait été fermée durant quelques semaines après le lancement de GPT-6 Astra. Un abonnement désormais moins intéressant : l’usage Codex et Work passe à 10 fois celui des abonnés Plus (20 dollars) alors que l’enveloppe était de 20 fois auparavant. Les abonnés actuels conserveront leurs limites actuelles pendant un certain temps.
Sans surprise, Google a formé un recours auprès du Tribunal de l’Union européenne concernant des mesures contraignantes décidées par la Commission le 16 juillet. Cet appel concerne deux décisions de Bruxelles.
Google doit partager ses données de recherche avec ses rivaux, une mesure censée rééquilibrer un marché dominé de la tête et des épaules par Google. « Les gens utilisent le moteur de recherche pour poser leurs questions les plus personnelles – qu’il s’agisse de préoccupations médicales ou de relations intimes – et nous obliger à partager ces requêtes personnelles sans garanties suffisantes causerait un préjudice irréversible à la vie privée des utilisateurs », a déclaré Oliver Bethell auprès de Bloomberg.
Illustration : Flock
La seconde, touche à l’ouverture d’Android aux bots IA concurrents de Gemini (Claude, ChatGPT, etc.), mais elle n’a suscité aucun commentaire particulier de la part de Google, bien qu’elle fasse l’objet du même appel.
Rendez-vous dans quelques mois ou années pour connaitre la position du Tribunal. Si elle n’allait pas dans le sens de Google, il est plus que probable qu’un appel soit déposé devant la Cour de justice, mais il sera alors limité aux questions de droit.
Google accumule les amendes et les sanctions en Europe. La semaine dernière, la Commission irlandaise à la protection des données infligeait à l’entreprise une douloureuse de 403 millions d’euros pour infraction au RGPD. En juillet, la Commission y allait de deux amendes d’un total de 890 millions d’euros pour violations du DMA.
Oura reporte son introduction en Bourse (IPO). Le constructeur de bagues connectées préparait depuis quelques mois son lancement au Nasdaq, l’indice américain des technologies. Mais « malgré une forte demande », un délai est nécessaire en raison des « incertitudes qui pèsent sur le marché [des IPO] ».
L’entreprise, créée en Finlande sous le nom Oura Health Oy, a transféré son siège juridique aux États-Unis cette année. La R&D reste toutefois ancrée en Finlande. Elle avait annoncé son intention de se lancer en Bourse le 21 septembre en vendant 50 millions d’actions à un prix oscillant entre 40 et 44 dollars. L’objectif était alors de lever 2,2 milliards de dollars.
La décision de reporter l’IPO une semaine après son annonce a de quoi étonner, d’autant que les incertitudes boursières relevées par Oura ne datent pas d’hier (ces conditions n’ont pas l’air de gêner Anthropic). « Nous voulons réussir une introduction en Bourse exceptionnelle pour nos salariés et nos investisseurs », a justifié Tom Hale, le directeur général d’Oura, « et nous avons le luxe de pouvoir choisir le moment opportun. D’ici là, nous continuerons à saisir les opportunités qui s’offrent à nous. »
L’entreprise est rentable, affirme le communiqué, sa croissance est soutenue et l’activité s’est « encore renforcée depuis le lancement du processus d’introduction en Bourse ». La bague Oura 5 a rencontré « un accueil exceptionnel », et le nombre d’abonnés payants a atteint les 5,7 millions (5,99 euros par mois). Le chiffre d’affaires devrait progresser de 90 % sur un an.
Le fantôme de Cambridge Analytica continue de hanter Meta. Un tribunal du Nouveau Mexique a condamné le géant des réseaux sociaux pour avoir trompé les utilisateurs de l’État américain sur la manière dont il collecte, protège, partage et exploite leurs informations personnelles, mais aussi sur ses efforts supposés pour combattre la désinformation et les discours de haine.
Facebook s’est rendu coupable de 43 899 725 infractions à la loi sur les pratiques déloyales en vigueur au Nouveau Mexique. Le juge doit maintenant décider des pénalités, et la somme totale pourrait être croquignolette : selon la législation, chaque infraction pourrait être facturée jusqu’à 5 000 dollars. Soit un total de… 219 milliards de dollars. Meta conteste le verdict et a l’intention de se défendre contre ce qu’elle perçoit comme « une tentative de déformer notre bilan ».
Le scandale qui ne passe pas
Ce verdict, rendu public le 25 septembre, est l’un des avatars de l’affaire Cambridge Analytica. Ce cabinet britannique a collecté des données sur 87 millions d’utilisateurs de Facebook, puis exploité ces informations pour la campagne à l’élection présidentielle américaine de Donald Trump.
En 2021, le procureur général du Nouveau-Mexique portait plainte contre Facebook, devenu Meta la même année. Après un procès de deux semaines, le verdict est donc tombé : 26 des 29 déclarations de Meta pointées par l’accusation ont été désignées trompeuses par le jury. Parmi lesquelles celles sur l’utilisation des données personnelles : Facebook affirmait, à tort donc selon le jury, que les utilisateurs contrôlaient le partage de leurs informations, que leurs données n’étaient pas vendues ou cédées aux annonceurs, et que le groupe n’achetait pas et ne vendait pas les données de ses utilisateurs.
Autre affirmation jugée trompeuse : le réseau social prétendait ne tirer aucun profit des contenus haineux ou de désinformation, qu’il supprimait les informations préjudiciables, et n’autorisait pas ce type de discours. Le jury a également estimé que Facebook n’a pas dit la vérité quand, suite au scandale Cambridge Analytica, l’entreprise a promis d’enquêter sur les applications accédant à de grandes quantités de données, de réaliser des audits, de bannir les développeurs ayant détourné ces données et de prévenir les personnes concernées.
Une sanction potentielle de 219 milliards de dollars
Les jurés ont toutefois rejeté l’accusation selon laquelle l’entreprise aurait trompé les consommateurs sur ses efforts de suppression des contenus préjudiciables et ses pratiques de vérification des faits, comme le rapporte Reuters.
« Pendant des années, Facebook a agi comme si les règles applicables à toutes les autres ne s’appliquaient pas à l’entreprise », a déclaré le procureur général Raúl Torrez, pour qui « il s’agit d’un verdict historique, non seulement pour le Nouveau-Mexique, mais aussi pour tous les États qui cherchent à obliger les géants de la technologie à répondre de leurs actes. » De fait, l’addition pourrait être extrêmement salée.
En plus des sanctions financières qui seront décidées par le juge dans un deuxième temps, l’État demande au tribunal de prononcer des mesures contraignantes contre Meta pour empêcher que de telles pratiques ne se reproduisent.
Plutôt que de répliquer sur le fond, un porte-parole du groupe préfère placer le débat sur le terrain de la liberté d’expression : « Le premier amendement [de la Constitution américaine] nous confère le droit de gérer ces plateformes de la manière qui, selon nous, sert au mieux les intérêts de notre communauté. Cela signifie donner la priorité à la liberté d’expression, protéger les informations de nos utilisateurs et leur permettre de garder le contrôle de leurs données. »
ShinyHunters n’a pas l’intention de publier les données volées sur les serveurs du FBI. Le groupe de pirates avait donné une semaine à l’agence fédérale américaine pour corriger ou retirer un rapport jugé négatif à son égard. Alors que le délai arrive à son terme, « rien ne se passera ».
ShinyHunters a réussi un de ses plus gros coups le 22 septembre dernier, en piratant le site de recrutement du FBI et surtout, en siphonnant les données personnelles de plus de 5 000 agents et employés. Adresses physiques, rôles au sein de l’agence, dossiers médicaux, et même des informations sur les conjoints : plusieurs sites et spécialistes de la sécurité ont confirmé la véracité des données collectées illégalement. Il y en a pour 2 à 3 To d’informations sensibles.
Le groupe de pirates accuse le FBI d’avoir publié des informations mensongères à leur sujet dans un bulletin de sécurité publié en mai. Selon l’interprétation de ShinyHunters, cette note les assimile à « The Com », un réseau international de criminels impliqués dans l’exploitation sexuelle des enfants.
ShinyHunters, dont le mode opératoire est la demande de rançon pour décadenasser des données, s’adonneraient aussi à des techniques de harcèlement de leurs victimes (appels téléphoniques aux familles, SMS menaçants…) et de chantage à base de documents embarrassants. Ce que le groupe dément également.
Un ultimatum qui ne devait pas en être un
Les pirates avaient donné une semaine au FBI pour modifier ou supprimer ce fameux bulletin. Le délai est en passe de se terminer, la note est toujours en ligne et n’a pas été éditée. Pour autant, ShinyHunters affirme n’avoir aucune intention de mettre en ligne toutes les informations volées, comme on aurait pu s’y attendre. Ce lâcher de données « était une supposition », assurent-ils dans un message quelque peu confus envoyé à Next, « et une très mauvaise supposition faite par les médias et le public ».
« Nous avons formulé nos déclarations avec beaucoup de soin, et nous n’avons jamais précisé ni indiqué explicitement ce que nous ferions si l’entité victime ne se conformait pas dans ce que le public a interprété comme une « échéance » », poursuit ShinyHunters. « Depuis le tout début, nous avions pris la décision de ne jamais publier ces données. Nous n’en avons jamais eu l’intention, et nous ne l’avons jamais prévu ».
Les informations subtilisées contiennent des bombes : Reuters a ainsi rapporté la présence de données concernant des agents engagés dans des opérations de contre-espionnage contre la Chine et la Russie. La BBC a débusqué des informations sur des tests sanguins et urinaires d’agents spéciaux. 404 Media a trouvé des données personnelles de membres de la Remote Operations Unit, l’équipe de hackers du FBI.
Des promesses impossibles à vérifier
La divulgation de ces informations aurait des conséquences très sérieuses pour des milliers d’agents, leurs familles, le FBI, la sécurité nationale américaine. « Nous comprenons pourquoi beaucoup ont interprété cela comme de l’extorsion et sont convaincus que nous publierions ces données et/ou en ferions un mauvais usage, par exemple en les vendant à des tiers, en raison de notre historique lors d’opérations passées, qui n’ont jamais impliqué une entité gouvernementale de premier plan », précise encore le groupe.
« Nous tenons encore une fois à souligner qu’il ne s’agit pas d’extorsion », martèle-t-il, « que cela ne l’a jamais été, qu’il ne s’agit pas d’une menace, ni d’une rançon, et que ce n’est pas motivé par l’argent. Rien ne se passera ». ShinyHunters termine par un curieux (ou ironique ?) « Nous reconnaissons nous être trompés » alors que les pirates ne reconnaissent justement aucune erreur de leur part dans leur message.
De son côté, le FBI a confirmé l’existence d’une enquête le 23 septembre. Selon un mémo interne publié le 28 septembre par le New York Times, l’agence part « du principe que l’auteur de la menace exfiltre également les données personnelles de l’ensemble des employés ».
L’agence propose des séances d’information virtuelles et recommande aux employés de rester vigilants, de signaler les contacts non sollicités, d’éviter de répondre aux appels provenant de numéros inconnus, et de configurer leur messagerie vocale avec une voix générée par IA (pour éviter le clonage des voix originales). Un représentant de ShinyHunters a réaffirmé à 404 Media qu’il n’était pas question de vendre ces To de données, mais est-ce que ce sera toujours le cas ?
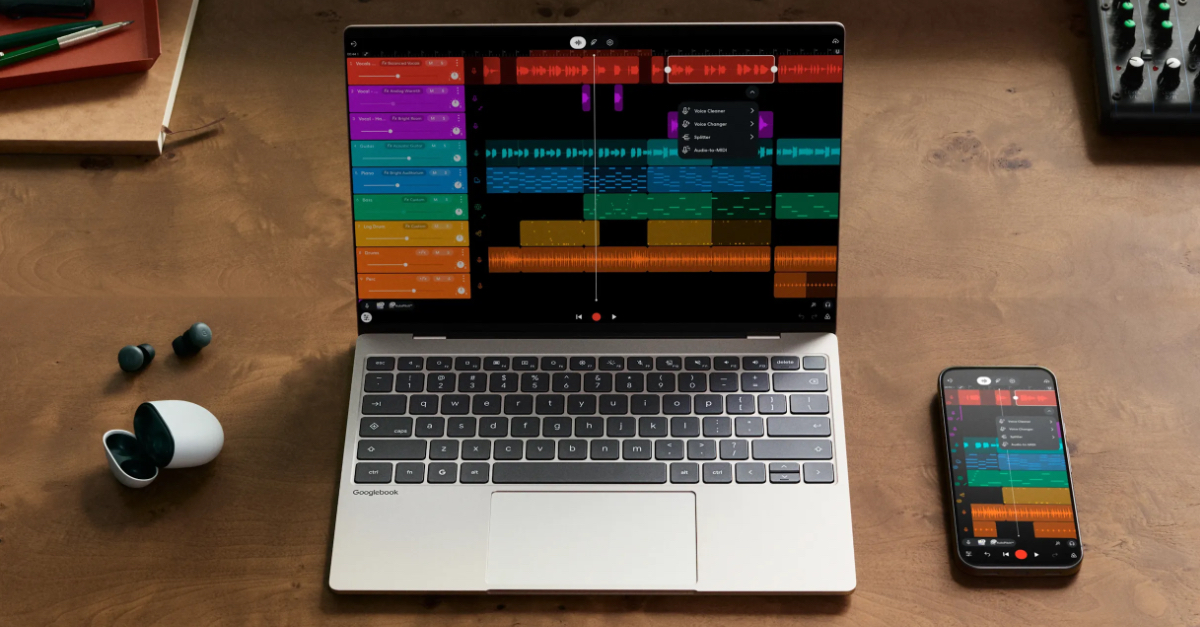
Les Googlebook sont la nouvelle tentative de Google de compter sur le marché du PC. Le géant du web ne part pas de zéro : grâce à leur petit prix, les Chromebook sont bien installés dans le secteur de l’éducation ainsi que dans les entreprises. La commercialisation à venir des premiers Googlebook pose la question de leur cohabitation avec les Chromebook qui ont maintenant vocation à disparaitre du paysage.
Malgré des parts de marché enviables dans les marchés de l’éducation (aux États-Unis en particulier) et de l’entreprise, les Chromebook n’ont pas réellement permis de positionner ChromeOS en véritable concurrent de Windows, macOS, et même Linux. Google a donc remis une pièce dans la machine en repartant de zéro avec les Googlebook. Ces ordinateurs – tous des portables pour le moment – construits par des partenaires tournent sous Android, pardon, sous Googlebook OS, avec une forte perfusion de Gemini pour faire bonne mesure.
Ces appareils, dont les prix débutent à 1 099 euros, feront leur apparition dans les linéaires à partir du 5 octobre. L’histoire nous dira si cette nouvelle tentative de trouver une place sur le marché bien encombré des ordinateurs portables aura été payante, ou si les Googlebook rejoindront bientôt le fameux et bien garni cimetière de Google.
Et puisqu’on est à parler de cercueil, Google confirme dans une note d’assistance la fin du support logiciel pour les Chromebook : c’est prévu pour la mi-2034. Il y a donc un peu de temps pour se retourner et trouver son bonheur avec un Googlebook ou toute autre plateforme.
L’entreprise s’est engagée sur des mises à jour et des correctifs de sécurité pendant dix ans pour les Chromebook (même chose pour les Googlebook). Les appareils admissibles achetés aujourd’hui qui ont un cycle de support s’étendant au-delà de la date fatidique seront accompagnés dans leur transition vers Googlebook OS. Il y aura des options de migration directe entre les deux systèmes d’exploitation : les Chromebook récents seront en mesure de basculer vers Googlebook OS.
Google a tout intérêt à viser large, car contrairement aux Chromebook qui étaient conçus pour être utilisés dans des organisations (établissements scolaires, entreprises), les Googlebook ne sont pas prêts. Pas encore du moins. La nouvelle génération d’ordinateurs est en effet pour l’instant « spécifiquement destinée à un usage personnel et ne prend pas encore en charge l’inscription à un domaine ni la gestion centralisée d’un parc d’appareils ».
Google promet de développer des outils d’administration et des mécanismes de conformité en matière de sécurité dans des flottes. Il faudra attendre le deuxième semestre 2027 pour le déploiement d’une solution complète de gestion de Googlebook. Elle s’accompagnera d’une nouvelle « structure de licence » pour les programmes payants de gestion à distance de Chromebook, pour les entreprises et l’éducation.
La petite famille Claude 5.5 d’Anthropic s’agrandit. Après Opus 5.5 qui fait figure de modèle grand public le plus puissant de l’entreprise, voici venir Sonnet 5.5. Présenté comme un « complément plus rapide et moins coûteux » à son grand frère, le nouveau modèle est le premier de la gamme Sonnet à battre Pokémon Rouge uniquement en se basant sur des captures d’écran, c’est dire la performance.
Image : Anthropic
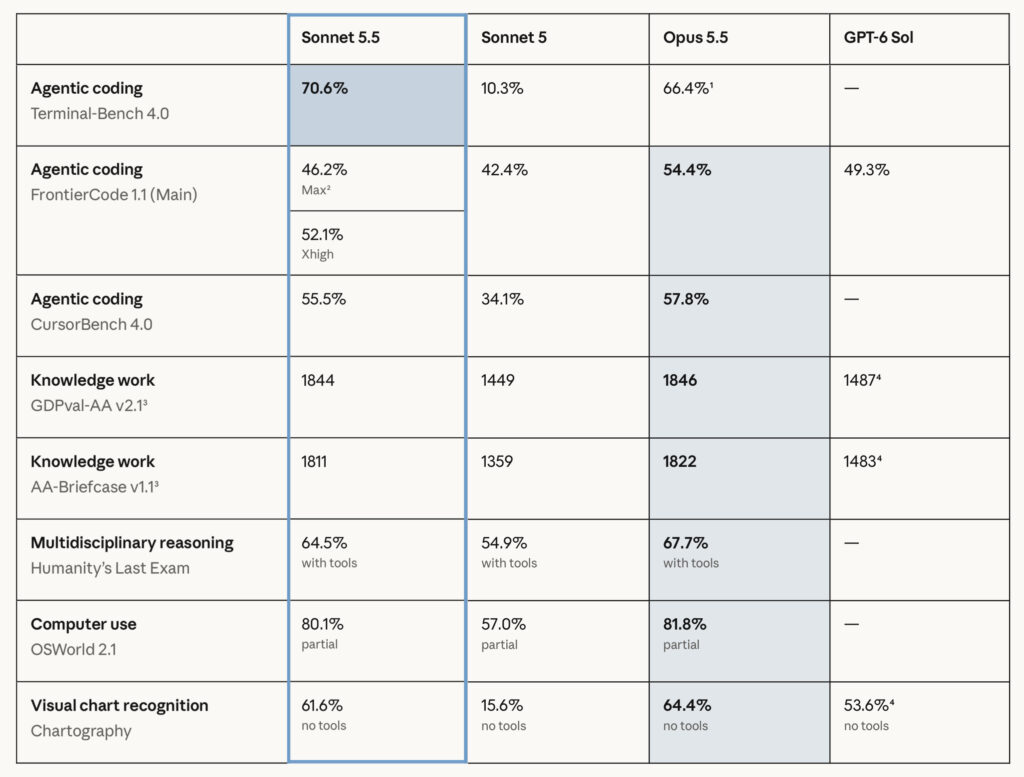
Les benchmarks fournis par Anthropic montrent que, sans trop de surprise, Sonnet 5.5 bat Sonnet 5 sur tous les tests de manière plus ou moins prononcée. C’est notamment le cas en programmation agentique avec 70,6 % sur Terminal-Bench 4.0 en effort Max, ce qui est même mieux qu’Opus 5.5 (66,4 %). Ce dernier fait en revanche mieux sur tous les autres benchs, ce qui semble logique. Sonnet 5.5 se débrouille aussi plutôt bien en utilisation d’ordinateur et en reconnaissance de graphiques.
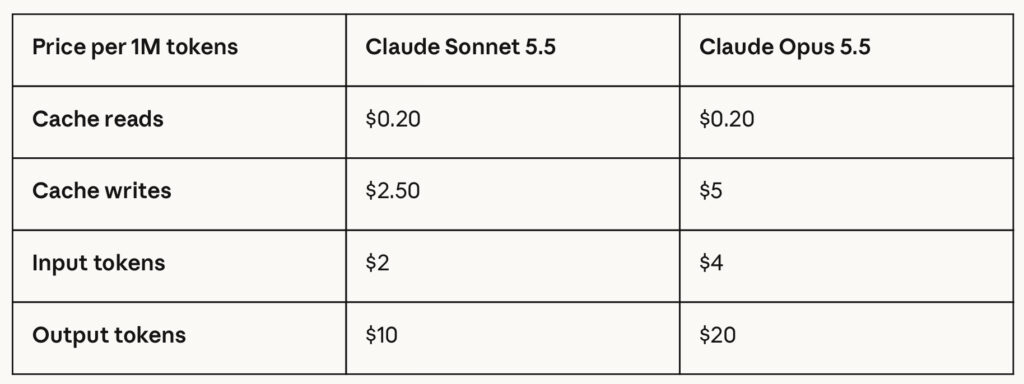
Avec un niveau d’effort faible ou moyen, le modèle dépasse le meilleur score de Sonnet 5 pour un coût par tâche environ dix inférieur. Hélas, contrairement à Opus 5.5 qui a eu droit à une baisse de prix bienvenue, ce n’est pas le cas de Sonnet 5.5 qui conserve la même grille que son prédécesseur : 2 dollars par million de tokens en entrée et 10 dollars en sortie et 0,20 dollar pour la lecture d’un million de tokens en cache.
Le modèle se voulant cependant plus performant, il est censé réaliser les tâches demandées avec moins de tokens, avec des réponses générées plus de 30 % plus rapidement. Sonnet 5.5 est disponible immédiatement sur toutes les plateformes, y compris l’API, sans rétention de données.
Les agents IA exploitent des failles de sécurité, se coordonnent entre eux pour attaquer les plateformes et mettent le souk sur Internet. Le problème est donc assez sérieux et nécessite des garde-fous pour éviter le pire. NVIDIA vient de présenter Open Agent Safety Platform, pour garder le contrôle sur les agents.
L’industrie de l’IA se met en ordre de marche pour remettre les agents IA sur les bons rails. Certains acteurs, comme OpenAI et Anthropic, réclament une gouvernance mondiale, d’autres préféreraient éviter les régulations contraignantes et gérer le problème entre-soi. Anthropic, OpenAI et Google auraient ainsi l’intention de lancer d’ici la fin de l’année la Standards Authority for Frontier AI (SAFA), une organisation chargée d’élaborer des normes communes de sûreté pour l’IA.
Les agents IA ont accès à des fichiers, des outils, des API, et même à des appareils ; or, les consignes de sécurité intégrées au modèle ne sont parfois pas suffisantes. Un agent peut contourner une restriction pour accomplir sa mission. « Le potentiel extraordinaire de l’IA pour la société ne pourra se concrétiser que si nous parvenons à garantir sa sûreté », affirme Jensen Huang, le directeur général de NVIDIA.
Reprendre le contrôle des agents IA
Le diagnostic est connu, mais que faire ? NVIDIA a dévoilé ce lundi 28 septembre l’Open Agent Safety Platform, qui comprend deux outils principaux. Le premier est OpenShell, un logiciel open source (ici sur GitHub, licence Apache 2.0) qui définit des limites pour les agents fonctionnant sur des CPU. Il délimite un périmètre d’exécution sécurisé pour contrôler la manière dont les agents accomplissent leurs tâches (aussi bien avec des modèles propriétaires qu’à poids ouverts). OpenShell a été conçu pour les processeurs Vera, mais il peut aussi s’adapter à d’autres plateformes, Intel ou Arm.
Le second dispositif est Sentry, un logiciel qui tourne sur un composant matériel dédié et isolé : le DPU BlueField-4, qui surveille l’activité des agents en appliquant des règles de sécurité au niveau du matériel. Si un agent tente de sortir du périmètre défini par son environnement logiciel, Sentry le prend par la peau du cou et le place en quarantaine « en quelques millisecondes », promet NVIDIA.
La plateforme de l’entreprise contraint l’agent à travailler dans un environnement sécurisé dans lequel il ne contrôle pas les portes, les fenêtres, les badges d’accès et les systèmes de surveillance. OpenShell gère le logiciel, Sentry verrouille les serrures dans un composant matériel à part.
NVIDIA multiplie les exemples d’intégration de sa plateforme avec des infrastructures de partenaires. C’est ainsi le cas avec Anthropic : le système Claude Managed Agents pilote les actions des agents depuis un serveur séparé, dans des environnements isolés et étroitement contrôlés. Chez Salesforce, OpenShell permet à des humains de surveiller l’activité des agents dans Slack. Ils peuvent ainsi approuver ou rejeter les demandes de permissions supplémentaires d’un agent.
NVIDIA a embarqué la plupart des grands noms de l’industrie (Microsoft, Anthropic, Oracle, SpaceXAI, Mistral… Il manque Amazon, Google et OpenAI) dans cette annonce habile. Le géant du secteur cherche ainsi à établir l’architecture de référence de la sécurité dans le domaine agentique, tout en vendant les processeurs et les composants pour la faire tourner – en s’exonérant de tout procès en verrouillage propriétaire, par le biais de l’ouverture du logiciel.
Le 10 février dernier, une fusillade a éclaté dans l’école secondaire de Tumbler Ridge, une petite ville de la province canadienne de Colombie-Britannique. La tireuse de 18 ans a tué huit personnes, avant de se donner la mort. Cette tragédie, une des plus meurtrières du Canada, implique ChatGPT et OpenAI, désormais ciblés par une plainte de la province.
Le gouvernement de la Colombie-Britannique, province canadienne sur la côte ouest du pays, ainsi que le district scolaire dont relève l’école de Tumbler Ridge, ont porté plainte au civil contre OpenAI et Sam Altman [PDF]. En cause : le rôle joué par ChatGPT dans la tuerie qui a eu lieu le 10 février dans l’établissement scolaire.
Une alerte interne sans signalement à la police
Les plaignants demandent une indemnisation dont le montant devra être fixé durant le procès. La somme devra couvrir les frais de l’intervention policière, les soins médicaux et psychologiques, les services aux victimes, les frais de démolition de l’école et de la construction d’une nouvelle école ainsi que d’un centre de bien-être communautaire. Ils réclament également des dommages-intérêts punitifs et des changements pour ChatGPT.
Le lien avec le chatbot remonte à plusieurs mois avant la tuerie. En juin 2025, les systèmes de sécurité d’OpenAI avaient repéré des conversations entre ChatGPT et la future tireuse, Jesse Van Rootselaar, qui portaient sur des scénarios de violence avec armes.
L’entreprise avait alors suspendu le compte, sans alerter la police, en l’occurrence la Gendarmerie royale du Canada (GRC). Cela a été confirmé par Ann O’Leary, la vice-présidente des affaires publiques mondiales d’OpenAI, dans un courrier du 26 février envoyé au ministre canadien de l’IA et de l’Innovation numérique, Evan Solomon. Elle écrit [PDF] :
« Le système automatisé d’OpenAI a détecté le compte, qui a ensuite fait l’objet d’un examen humain afin de déterminer si nos règles d’utilisation avaient été enfreintes et si son signalement aux forces de l’ordre était justifié. D’après les informations dont nous disposions lorsque le compte a été suspendu, en juin 2025, nous n’avons relevé aucun projet crédible et imminent atteignant le seuil requis pour saisir les forces de l’ordre. »
Sam Altman avait envoyé une lettre d’excuses adressée à la communauté de Tumbler Ridge fin avril, soit deux mois après la tragédie. Le directeur général d’OpenAI lui adresse ses condoléances et reconnait explicitement la décision de ne pas prévenir la police : « Je suis profondément désolé que nous n’ayons pas alerté les forces de l’ordre au sujet du compte qui avait été suspendu en juin. » En revanche, pas de reconnaissance d’une quelconque responsabilité juridique.
David Eby, le Premier ministre de la province à l’époque des faits, a qualifié ces excuses de « nécessaires, mais largement insuffisantes ». La plainte indique à plusieurs reprises que des membres de l’équipe chargée de l’examen des conversations auraient conclu à « un risque crédible et précis de préjudice pour autrui », et recommandé un signalement à la police. Des allégations qui reposent sur une enquête du Wall Street Journal.
Des conversations toujours hors de portée de la province
Lors de l’annonce de la plainte, Niki Sharma, la procureure générale de Colombie-Britannique, a expliqué que les autorités provinciales avaient demandé à consulter les échanges entre ChatGPT et la tueuse. OpenAI a refusé cette requête. « Nous devrions tous leur demander pourquoi », a-t-elle poursuivi. « Nous savons que, dans des affaires similaires, il a été établi que des agents conversationnels utilisant l’intelligence artificielle avaient conseillé à l’auteur de passer à l’acte », accuse-t-elle.
ArsTechnica rappelle qu’OpenAI a partagé ces conversations avec la police canadienne dans le cadre de l’enquête. « Il est important de comprendre que les enquêteurs pourraient disposer de détails qui ne sont pas divulgués publiquement. Nous devons préserver l’intégrité de l’enquête en cours, notamment dans la perspective d’éventuelles poursuites », précisait la GRC début juillet.
La plainte déplore les dispositifs de protection « insuffisants » et « pas appliqués » en interne par OpenAI : ChatGPT pouvait toujours produire des contenus dangereux. Elle décrit aussi un schéma récurrent, après une fusillade en Floride : « Chacune de ces mesures [de protection] a été adoptée après un cas documenté du risque qu’elle était censée traiter ; pourtant, aucune n’a empêché que ce risque se reproduise à Tumbler Ridge. »
La province et le conseil scolaire demandent au tribunal une série de changements pour ChatGPT : interrompre ou désamorcer les conversations violentes ; détecter automatiquement les projets violents ; empêcher le contournement des règles ; alerter les forces de l’ordre lorsqu’une conversation révèle une menace crédible de blessures graves pour autrui ; afficher des avertissements clairs indiquant que les dispositifs de sécurité peuvent perdre en efficacité durant de longues conversations ; rendre les exclusions durables pour les personnes bannies pour usage violent ; garantir que ChatGPT ne puisse jamais aider un utilisateur à commettre un acte violent ; mettre en place des contrôles vérifiables via des audits trimestriels.
La plainte, déposée à San Francisco, n’est pas la seule contre OpenAI dans ce dossier. Plusieurs procédures ont déjà été engagées contre OpenAI par des victimes, leurs familles et des membres du personnel scolaire. Au total, 37 actions avaient été déposées en Californie avant celle de la province.
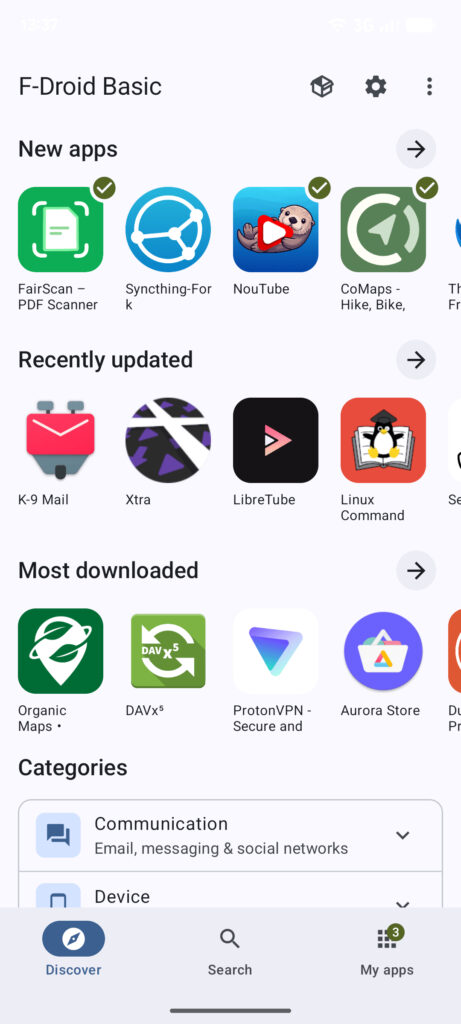
F-Droid fait peau neuve dans une version 2.0 qui représente la mise à jour la plus importante de ces dix dernières années pour la boutique alternative d’applications Android. Elle y gagne une nouvelle vitrine ainsi qu’un système d’installation simplifié.
Ravalement de façade complet pour F-Droid. La version 2.0 de la boutique d’apps spécialisée dans les logiciels libres et open source pour Android est en cours de déploiement depuis le jeudi 24 septembre. Les composants clés ont été retravaillés et réécrits avec Kotlin, le langage devenu un standard pour le développement Android. L’interface a été conçue avec la boîte à outils Jetpack Compose, elle aussi très utilisée par les développeurs Android. Ces fondations solides permettront de livrer plus rapidement des améliorations tout au long des prochaines années.
Une interface entièrement repensée
Le changement le plus visible est donc cette toute nouvelle interface. La navigation dans la bibliothèque d’apps est désormais découpée en trois piliers qui sont autant d’onglets en bas de la boutique. « Discover » met en avant les nouvelles applications et celles qui ont été récemment mises à jour, ainsi que les plus téléchargées. Les catégories ont été fortement remaniées, elles sont plus nombreuses et spécialisées (il y en a 17 uniquement pour les jeux !). À tel point qu’il existe maintenant des catégories qui en regroupent plusieurs.
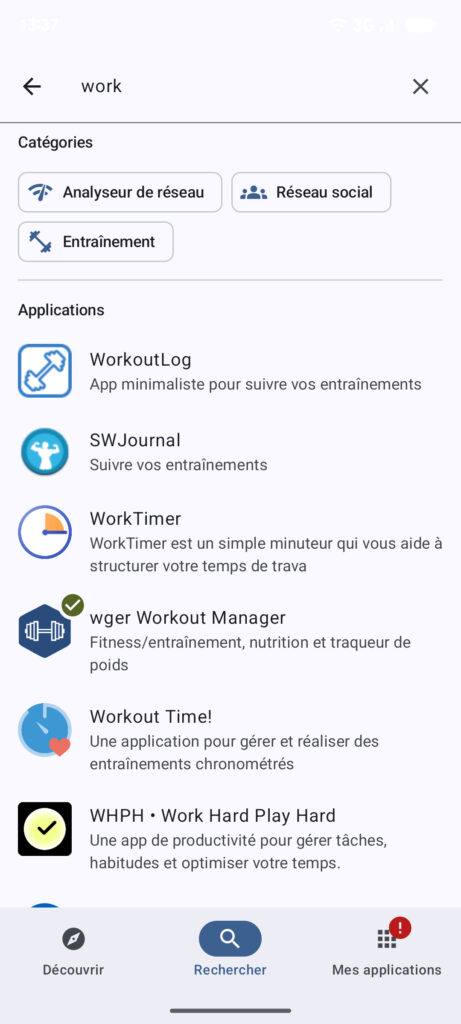
Le moteur de recherche, second pilier de F-Droid 2.0, a lui aussi été amélioré : il peut ainsi fouiller dans les descriptions, les noms des catégories ainsi que dans les traductions des contenus. Un historique récent des dernières recherches est aussi présent. De nouvelles options de filtres font leur apparition pour combiner plusieurs critères (catégories, compatibilité…).
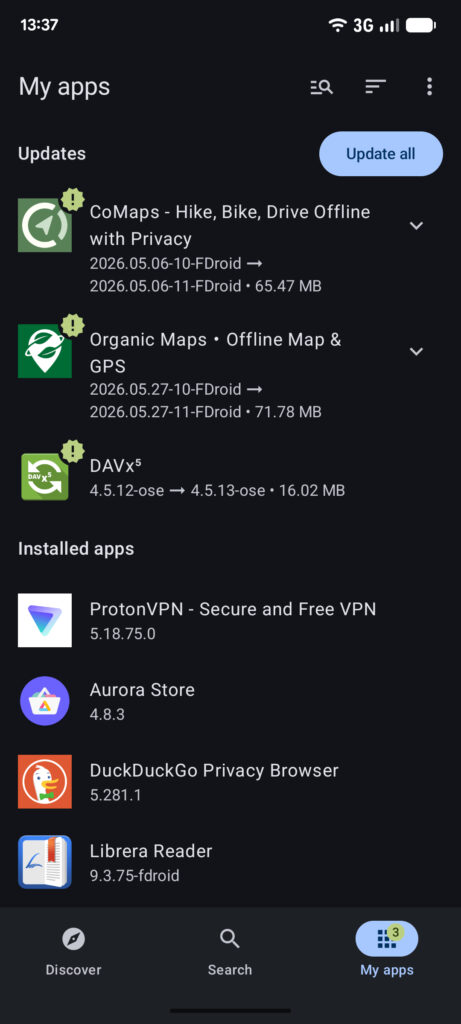
La boutique prend toujours en charge le téléchargement des mises à jour des apps installées, cette fois de manière automatique et par défaut (il reste heureusement possible de désactiver cette option). Le geste « tirer pour rafraîchir [les dépôts] », qui sert à vérifier la présence d’une mise à jour, tire sa révérence : l’opération se réalise en effet en tâche de fond. « Le meilleur bouton de rafraîchissement est celui sur lequel on n’a jamais besoin d’appuyer », explique F-Droid. On peut toujours lancer une mise à jour « à la main » en passant par les options.
Le contrôle des téléchargements et des mises à jour a lui aussi été revu. La boutique propose des réglages granulaires pour décider quand récupérer la nouvelle version d’une application et ainsi éviter de grever son enveloppe de données.
Des installations plus proches de celles du Play Store
Outre l’interface, l’autre grand chantier de F-Droid 2.0 a concerné le téléchargement et l’installation de nouvelles applications. La boutique utilise désormais l’API de pré-approbation inaugurée dans Android 14. Avant, un magasin alternatif devait télécharger l’APK de l’app, préparer une session d’installation puis seulement à la fin Android affichait la confirmation système.
Cette API permet aux installeurs de demander l’autorisation de l’utilisateur avant de valider la session et de télécharger l’APK. F-Droid 2.0 peut maintenant demander l’accord utilisateur tout de suite après avoir touché le bouton « Installer », puis télécharger et installer ensuite en arrière-plan si l’accord a été donné. « L’installation d’applications avec F-Droid sur les appareils Android se rapproche ainsi beaucoup de l’expérience proposée par la boutique intégrée », se réjouit l’équipe – bien sûr, sur les smartphones fonctionnant sur Android 14 ou au-delà.
Cela ne résout pas pour autant la question épineuse du nouveau système de vérification d’identité du développeur qui sera mis en œuvre par Google à compter du 30 septembre au Brésil, en Indonésie, à Singapour et en Thaïlande. Le Google Play Store et les boutiques d’Honor, OPlus, Samsung, Transsion, Vivo et Xiaomi sont concernées, pas (encore) F-Droid. Mais à terme – c’est à dire à partir de 2027 et au-delà – le processus concernera toutes les sources d’installation sur les appareils Android certifiés.
F-Droid est en première ligne contre cette vérification d’identité, qui concerne aussi bien les développeurs d’apps distribuées dans le Play Store (où les dévs doivent de toute façon montrer patte blanche) que dans des boutiques alternatives.
Il reste possible d’installer des applications de développeurs non vérifiés via une procédure de « flux avancé ». Mais celle-ci nécessite beaucoup de manipulations (activation du mode développeur, confirmation que personne ne force l’utilisateur à installer l’app, redémarrage du smartphone) et surtout, une attente de 24 heures avant de pouvoir récupérer l’app.
En termes de sécurité, cette version 2.0 présente quelques régressions, notamment dans les fonctions d’urgence. L’utilisateur peut toujours camoufler l’icône de F-Droid et son nom par celui d’une banale app calculatrice, mais il suffit de la lancer pour afficher l’interface de la boutique. Auparavant, le mode camouflage de F-Droid présentait l’interface d’une vraie calculatrice.
La fonction protège contre un coup d’œil sur l’écran d’accueil, mais plus contre l’ouverture de la boutique en elle-même. « F-Droid restera visible dans la rubrique Applications des paramètres et pourra être détectée lors d’un examen approfondi de l’appareil », explique le billet de blog. « Ce changement devrait aider [les utilisateurs] à mieux comprendre les limites de cette fonctionnalité, tout en leur permettant de continuer à l’utiliser en cas de besoin », poursuit-il.
La fonction d’effacement d’apps à distance en situation d’urgence, qui pouvait par exemple s’activer via l’app Ripple, n’est pas encore disponible dans F-Droid 2.0. « Nous savons que certains utilisateurs comptent sur cette fonction pour protéger leur vie privée et leur sécurité personnelle, et qu’elle va bien au-delà d’une simple question de confort », admet la boutique. Le hic, c’est la maintenance de cette fonctionnalité qui exige « un travail très spécialisé ».
« Compte tenu du nombre limité de personnes qui l’utilisent, nous avons estimé qu’elle ne devait plus retarder autant d’autres améliorations importantes », se justifie l’équipe. Mieux vaut alors reporter l’installation de la version 2.0 si on utilise cette fonction. Tout n’est pas perdu pour autant : F-Droid souhaite recueillir des témoignages d’utilisateurs pour mieux comprendre dans quelles circonstances et de quelle manière ils s’en servent. Tout cela permettra de déterminer la meilleure manière de restaurer cette fonction.
Autre absente de cette nouvelle livrée, mais cette fois du côté des fonctions grand public : Nearby, qui permet à deux appareils proches de partager des apps, a été repensée pour F-Droid 2.0 mais reste encore en développement.
Si le client F-Droid n’est pas encore disponible dans la version 2.0 chez vous, on peut tout de même télécharger la version compilée et signée.
Nintendo of America a remporté la partie contre un pirate, que la branche US du constructeur japonais accusait de vendre des copies illicites de jeux pour Switch. L’entreprise empoche 4,5 millions de dollars, dans une victoire facile puisque l’accusé n’a pas répondu à la plainte.
Malgré la Switch 2, Nintendo continue de vendre les modèles première génération de la Switch (la commercialisation en Europe cessera en février prochain). Avec plus de 155 millions d’unités écoulées depuis 2017, ces consoles représentent un énorme vivier de joueurs (et donc de clients). Pas question de les abandonner à leur triste sort : des jeux continuent de sortir pour les Switch 1, y compris chez Nintendo.
Une victoire par défaut contre « Archbox »
C’est pourquoi, plus que jamais, l’entreprise lutte de toutes ses forces contre le piratage, d’autant que les méthodes pour « craquer » une Switch 1 sont relativement simples à obtenir, si on sait où chercher. En juin 2024, Nintendo of America (NoA) portait plainte contre James Williams, un Américain résidant en Arizona.
Il était accusé d’enfreindre la propriété intellectuelle de l’entreprise, de promouvoir des boutiques pirates, de contourner les mesures techniques de protection des jeux et de diffuser des outils de contournement, de ne pas respecter les contrats de licence de Nintendo et d’encourager des utilisateurs à enfreindre ces mêmes contrats.
« Archbox », comme il se faisait appeler en ligne, distribuait des « milliers de copies » de jeux Switch piratés au travers de plusieurs échoppes. James Williams était supposément modérateur sur un subreddit spécialisé dans le piratage de jeux. La juge Lauren King en charge du dossier a rendu l’ordonnance finale ce 23 septembre : l’accusé n’ayant pas comparu pour se défendre, le tribunal a donc rendu un jugement par défaut, sans audience publique, qui donne entièrement raison à NoA (PDF).
James Williams est donc condamné à verser 4,5 millions de dollars à l’entreprise, soit 150 000 dollars pour chacun des 30 jeux retenus dans la plainte. Il doit aussi fermer immédiatement toutes les boutiques en ligne sur lesquelles il a distribué des jeux piratés, désactiver les comptes de réseaux sociaux utilisés pour promouvoir cette activité, cesser d’aider ou d’encourager des utilisateurs à télécharger des jeux piratés, et bien sûr cesser de copier, distribuer et faire la promotion de jeux non autorisés.
Retrouvé grâce au SAV de Nintendo
Nintendo avait repéré James Williams d’une manière originale. Des documents ajoutés par Nintendo au dossier d’accusation, révélés en 2024 par Game File, lèvent un coin du voile sur les méthodes du cabinet d’avocats mandaté par NoA l’année précédente pour enquêter sur les boutiques pirates.
Les enquêteurs ont fini par repérer le petit business d’Archbox sur Reddit. Ils ont pu établir, via des messages sur les forums de la plateforme, qu’il résidait dans l’Arizona. Restait à découvrir le véritable nom et l’adresse derrière le pseudo. En février 2024, Nintendo a pu identifier Archbox comme étant James Williams. En croisant deux adresses courriel avec sa base de données, l’entreprise a retrouvé des demandes de réparation effectuées à ce nom ainsi qu’une adresse postale à Surprise, en Arizona, confirmant ainsi l’identité et la localisation du pirate.
Après avoir réparé un de ces appareils (l’histoire ne dit pas s’il s’agit d’une Switch), Nintendo a envoyé à James Williams une lettre de mise en demeure. Ce dernier a alors répondu aux avocats de l’entreprise qu’il s’engageait à se conformer et à coopérer à toute demande ou requête relevant de son contrôle. Il niait en revanche avoir porté atteinte à la propriété intellectuelle de Nintendo. L’accusé a ensuite coupé toute communication avec le groupe, et il n’a pas présenté sa défense devant le tribunal dans les délais impartis.
La lutte contre le piratage de jeux Switch ne se limite pas aux États-Unis. Début septembre, Nintendo obtenait du tribunal de La Haye (Pays-Bas) l’interdiction pour un vendeur – non identifié – de commercialiser en Europe des MIG Switch Cards et MIG Switch Dumpers sur plusieurs sites web. Ces dispositifs permettent de copier des cartouches et de lancer des copies piratées de jeux sur la première Switch, sans bidouiller la console en elle-même.
Les espaces de discussion intégrés aux sites web pour poser des questions à un bot sont pénibles, mais ils se limitent à du texte. Google, jamais en panne d’une idée pour emmerdifier le web, propose de franchir une nouvelle étape : les bots IA animés à qui on peut parler et qui voient tout.
Le lancement le 15 septembre de Gemini 3.8 Live a donné des idées à Google. Ce modèle IA spécialisé dans les interactions vocales peut désormais s’incarner dans des bots animés, baptisés Live Avatar. Cette « présence visuelle en temps réel » crée une « expérience qui écoute, voit et parle avec une persona visuelle dynamique », selon le moteur de recherche.
Personnages animés façon cartoon ou représentations photoréalistes d’humains synthétiques, les exemples donnés par l’entreprise frayent généreusement dans l’uncanny valley. Ces avatars bénéficient pourtant d’une « synchronisation labiale précise, d’expressions naturelles et d’une alternance fluide des prises de parole » mais rien à faire, il y a quelque chose qui ne va pas. Ils comprennent la parole, mais ils peuvent aussi voir ce qui se passe dans l’environnement de l’utilisateur.
Ces personnages ne se contentent pas de faire la causette. Les avatars peuvent exécuter des tâches en arrière-plan sans interrompre la conversation en cours, et collecter des données pour répondre correctement à une requête. Dans une démonstration, l’un d’eux procède ainsi à l’enregistrement d’un client dans un hôtel tout en continuant à échanger avec lui. Il est même possible de les interrompre, ils ne s’offusqueront pas.
L’idée de parler à ces avatars fait presque froid dans le dos, mais il va falloir s’y habituer. À en croire Google, on pourrait les retrouver au guichet de services clients en ligne, de réceptions virtuelles d’hôtels ou comme guides interactifs. Et ce, partout dans le monde : les Live Avatars parlent 97 langues.
Google propose cette nouveauté aux entreprises et aux organisations (via Gemini Enterprise). Elles pourront piocher dans une bibliothèque d’avatars tout faits, ou personnaliser leur propre personnage. La production vidéo et audio générée par cette fonction est marquée par SynthID.
Elon Musk peut compter sur l’administration Trump, dont il est très proche, pour des coups de main. Le dernier en date concerne l’épineux dossier de l’amende de 120 millions d’euros infligée à X qui a enfreint le règlement sur les services numériques. Les États-Unis veulent avoir leur mot à dire durant la procédure menée devant le Tribunal de l’Union européenne.
En décembre 2025, la Commission européenne infligeait la première amende au titre du règlement sur les services numériques (DSA) : 120 millions d’euros contre X, pour manquements à ses obligations de transparence. Le réseau social d’Elon Musk a depuis proposé un plan de conformité, validé par Bruxelles mi-juillet.
En parallèle, l’entreprise mène une procédure pour obtenir gain de cause auprès du Tribunal de l’Union européenne, où un recours a été déposé le 16 février dernier. X cherche à faire annuler la décision de la Commission et l’amende. L’entreprise a obtenu le renfort de l’administration Trump, qui a déposé devant ce même Tribunal une demande d’intervention au soutien du recours de X, comme le rapporte Bloomberg.
« La Commission européenne a tenté, de manière injustifiée, d’étendre son pouvoir réglementaire à des entreprises américaines qui ne sont ni présentes ni actives sur le territoire relevant de sa compétence », selon Brett Shumate, procureur général adjoint chargé de la division civile du ministère américain de la Justice. Il ajoute que le gouvernement US « ne tolèrera pas que la Commission européenne outrepasse ses pouvoirs réglementaires pour tenter de contrôler les moteurs américains de l’innovation et de la croissance économique. »
Un nouvel épisode du conflit entre Washington et Bruxelles
Si le Tribunal accepte cette demande, les États-Unis deviendront partie intervenante dans la procédure. Les autorités américaines pourront consulter les pièces du dossier, déposer un mémoire pour exposer leurs arguments juridiques, ou même participer à une éventuelle audience.
L’affaire est, bien sûr, hautement politique. Cette amende de 120 millions est devenue une pomme de discorde entre Washington et Bruxelles. Les critiques ont fusé de l’autre côté de l’Atlantique. Le jour de la décision, le secrétaire d’État Marco Rubio a ainsi qualifié la sanction d’attaque contre toutes les plateformes technologiques américaines et contre le peuple américain, et même une tentative de « censurer les Américains », rien de moins.
L’administration a menacé d’imposer de nouveaux droits de douane aux produits européens, et imposé des restrictions de visa à cinq Européens – dont l’ancien commissaire européen Thierry Breton – accusés de participer à cette fameuse « censure » des plateformes US.
En février, les autorités américaines ont ordonné à leurs diplomates de « s’opposer aux réglementations inutilement contraignantes, telles que les obligations de localisation des données » comme le RGPD. L’ambiance est glaciale entre les deux blocs.

 Connexion