OpenBSD n’est pas un système que l’on croise forcément tous les jours, à moins d’exercer un métier spécifique, notamment dans les réseaux. Ce système Unix s’est fait un nom depuis longtemps dans ce domaine, ses composants étant régulièrement repris dans de nombreux équipements.
Quand une nouvelle version arrive, sa liste de modifications est donc un peu « aride ». On trouve certes une mise à jour générale des applications et composants : Chromium 154, Firefox 157, GNOME 49, KDE Plasma 6.7.5, GCC 16.1.0, LLVM 21.1.8 et 22.1.8, Go 1.27.1, Rust 1.98.1, Python 3.14.7 ou encore PostgreSQL 18.6 dans le cas présent.
Les nouveautés les plus significatives sont cependant sous le capot. Sur l’architecture amd64 (soit l’écrasante majorité des PC aujourd’hui), l’espace d’adressage virtuel du noyau passe ainsi de 4 à 512 Go, augmentant d’autant le mappage de la mémoire vidéo. On note une amélioration des performances de chiffrement sur amd64 et arm64, OpenBSD se servant désormais des instructions AES matérielles du processeur. Sur arm64, l’hibernation fait son entrée.
Nous n’allons pas lister toutes les améliorations, mais en voici plusieurs : un pilote drm resynchronisé avec le noyau Linux 6.18.53, le support par vmd d’un maximum de 64 processeurs virtuels par machine invitée, les interruptions MSI/MSI-X pour virtio et le déchargement du calcul des sommes de contrôle, l’acceptation des en-têtes HTTP personnalisés par httpd, l’arrivée d’OpenSSH 106 et de LibreSSL 4.4.0, ou encore un grand nombre de correctifs.
L’équipe de contributeurs a également mis en ligne une procédure pour mettre à jour l’actuel OpenBSD 7.9 vers cette nouvelle version 8.0.
Amazon Web Services a présenté un nouveau projet open source, TorchNeuron. Il se propose de simplifier le passage aux puces Trainium d’AWS pour entrainer les modèles. Bien que NVIDIA ne soit pas nommée, le projet est clairement pensé comme une alternative à CUDA.
PyTorch est initialement une bibliothèque logicielle créée par Meta (Facebook à l’époque). Depuis 2022, elle dépend de la Linux Foundation, tant elle est devenue importante. Elle sert en effet à construire et entraîner des modèles d’intelligence artificielle.
Cette bibliothèque est l’une des raisons pour lesquelles NVIDIA est autant sur le devant de la scène aujourd’hui. Entre PyTorch et le matériel utilisé pour les opérations, il faut justement une couche logicielle pour traduire les opérations en instructions que ce matériel peut comprendre. C’est précisément ce que fait CUDA depuis longtemps chez NVIDIA. Cette technologie propriétaire de type GPGPU (General-Purpose Computing on Graphics Processing Units) sert à faire basculer sur le GPU des calculs qui seraient autrement destinés au CPU.
Sans le dire aussi clairement, c’est ce lien fort qu’AWS veut remettre en question avec TorchNeuron, comme le relève notamment TechCrunch.
Direction les puces Trainium
Amazon Web Services dispose de ses propres puces en matière d’IA : les Trainium, dont la troisième génération a été lancée en décembre 2025. Ces puces peuvent servir aussi bien à l’entraînement qu’à l’inférence. Amazon n’est pas la seule entreprise à concevoir ses propres puces dans ce domaine : Microsoft possède Maia et Google a ses TPU (Tensor Process Units).
TorchNeuron est ainsi aux puces Trainium ce que CUDA est à NVIDIA, une couche de traduction. Elle s’appuie sur le mécanisme d’extension que PyTorch propose pour accueillir du matériel tiers et propose aux développeurs – dans le cas le plus simple – de remplacer dans leur code le périphérique cible cuda par neuron.
Est-ce aussi simple ? En théorie oui, mais l’exemple cité par AWS montre que la situation est plus complexe en pratique. Le billet évoque en effet le cas de Deepgram, un concurrent d’ElevenLabs dans le secteur de la synthèse vocale. Ainsi, non seulement certaines fonctions de PyTorch ne sont pas encore prises en charge, mais une partie des tests officiels de PyTorch est tout simplement ignorée, faute de traduction d’une partie des opérateurs de calcul. Deepgram est mis en avant comme ayant réussi à obtenir 70 % d’audio en plus pour chaque dollar dépensé, mais la mise en place de ce flux de travail a nécessité plusieurs mois de travail.
Source : AWS
Boire au goulot
Officiellement, Amazon met en avant la réduction du coût de changement de puce pour les développeurs. Ces derniers seraient ainsi plus libres de comparer les options qui s’offrent à eux. Si l’on peut changer de puce sans pénalité particulière, les fabricants doivent mériter la clientèle, affirme même Amazon.
Auprès de TechCrunch, Colin Brace d’Annapurna Labs (la filiale qui conçoit les puces d’Amazon) met bien sûr en avant l’infrastructure et l’écosystème d’AWS. En outre, le responsable pointe la possibilité d’utiliser la même puce pour l’entraînement et l’inférence, avec à la clé la possibilité de réaffecter la capacité inutilisée.
La lutte contre la dépendance à NVIDIA s’inscrit en filigrane dans l’annonce, de manière plus ou moins intense selon les passages. L’un d’entre eux est cependant très clair : « L’approche d’Amazon va au-delà de son propre matériel. L’entreprise apporte des modifications en amont de PyTorch lui-même, en travaillant avec la communauté PyTorch pour supprimer le code liant le framework à des puces spécifiques. L’objectif est de rendre PyTorch plus indépendant du matériel pour toute la communauté des développeurs, pas seulement pour les utilisateurs de Trainium ». Une précision qui n’est pas tellement « pour » les utilisateurs de Trainium que « contre » NVIDIA, car cette dépendance peut signifier une configuration plus longue.
Cette lutte à peine voilée n’est pas le seul élément masqué. Sans même parler d’arracher les clients à un écosystème pour les plonger dans le sien, Amazon doit se débarrasser d’un goulot d’étranglement. L’intérêt des puces Trainium est en effet d’autant plus réduit que les clients ne peuvent pas les utiliser facilement. C’est ce goulot que NeuronTorch doit essayer de lever. AWS essaye donc de réaliser un coup double : réduire les spécificités de PyTorch pour CUDA et fluidifier l’accès à ses puces.
TorchNeuron est cependant un projet neuf. Le code est présenté sous licence Apache 2.0 (open source) dans un dépôt GitHub ouvert le 17 octobre, même si AWS annonce sa disponibilité pour le 20 octobre. Dans sa forme actuelle, le projet prend en charge les puces Trainium 2 et 3. Reste pour Amazon à concrétiser sa vision en alimentant son projet, dont le succès dépendra de l’adoption par les développeurs concernés.
La direction générale de l’administration et de la fonction publique (DGAFP) a présenté sa revue stratégique de la fonction publique à l’horizon 2035 - 2050. Parmi les « grandes transitions » que la fonction publique doit absorber, le numérique et l’IA figurent en bonne place, avec la transition démographique, la transition écologique ou encore l’instabilité sécuritaire croissante.
Le rapport consacre quatre pages au numérique et à l’IA, dans lesquelles la DGAFP fait notamment un constat problématique : si 82 % des démarches administratives peuvent aujourd’hui se faire en ligne, 44 % des personnes interrogées ont déclaré avoir des difficultés à les faire. La direction générale en conclut qu’un accueil humain, au guichet ou au téléphone, reste nécessaire, surtout pour les publics fragiles et les dossiers complexes. Elle ajoute que le numérique doit servir à dégager du temps pour l’accompagnement individualisé, pas à supprimer des postes d’agents de la fonction publique.
Illustration : Flock
Le même rapport aborde la dépendance de l’État envers ses prestataires informatiques. Dans ce domaine, il reprend la recommandation de la Dinum (Direction interministérielle du numérique) d’un seuil minimal d’emploi interne de 37 %. Cependant, il le compare à la moyenne mondiale de 67 %, tous secteurs confondus.
Dans ce domaine, l’Espagne est érigée en exemple. Nos voisins ont ainsi mis en place un vaste plan de numérisation sur la période 2021 - 2025, doté d’un budget de 2,6 milliards d’euros. L’objectif sur 2026 était ensuite l’ouverture de 1 700 postes dans les corps de fonctionnaires du numérique. Des spécialités en IA, cybersécurité et science des données y apparaissent pour la première fois. Le rapport de la DGAFP préconise ainsi une forte réinternalisation des compétences.
L’exposition à l’IA, selon le rapport, varie très fortement selon les secteurs. Plus de la moitié des agents seraient très peu concernés, l’exposition se concentrant dans les fonctions administratives et de support. 20 % des agents seraient en revanche significativement exposés, soit 1,1 million de personnes.
Selon la DGAFP, « l’IA transformerait davantage les tâches que les métiers dans leur ensemble ». La direction générale estime que le temps libéré par l’IA devrait être réaffecté vers « l’expertise, le contrôle et la relation aux usagers ». Elle ajoute que des formations, mobilités voire reconversions devront être organisées. De plus, le déploiement de l’IA va « contribuer à une recomposition profonde des emplois et une évolution des modalités de recrutement pour privilégier l’esprit critique sur la capacité de synthèse, par exemple ».
Dans un billet publié ce 19 octobre, Microsoft évoque les inquiétudes grandissantes autour de la sécurité des agents IA. La société affirme que les modèles de pointe ne sont pas dignes de confiance et propose une série de mesures concrètes, dont une extension de son projet Perception. Mais dans ce domaine, l’entreprise est à la fois juge et partie.
Mise à jour du 22 octobre : L’entreprise nous a répondu que les produits annoncés étaient pour l’instant disponibles uniquement sous forme de préversions privées, avec une disponibilité publique prévue via Ignite, à une date non communiquée.
Article original : Le billet est signé par Hayete Gallot, vice-présidente de Microsoft chargée de la sécurité. La responsable part d’un constat : les inquiétudes sur la sûreté de l’IA ont augmenté ces derniers mois, à mesure que des incidents étaient rendus publics. Il faut dire que depuis l’incident originel contre Hugging Face, les révélations ont plu sur les agents et leurs comportements.
La position de Microsoft est donc désormais assumée : les modèles de pointe (frontière) ne sont pas dignes de confiance. Pas parce qu’ils sont intrinsèquement malveillants, mais parce qu’ils sont entrainés de manière à atteindre un résultat. Cet objectif peut entrainer un détournement de la fonction de récompense. Les agents peuvent en outre collaborer pour atteindre leurs objectifs, sans pour autant avoir été compromis.
Ce que propose l’entreprise ? Cadrer l’environnement d’exécution des agents et obtenir une meilleure connaissance de leur fonctionnement.
Les agents, des employés pas comme les autres
Pour Microsoft, la perception des agents dans les entreprises doit changer. Il faudrait ainsi les considérer comme des agents « initiés » à qui on ne peut pas faire confiance : « La surveillance et la sécurisation de ces agents doivent devenir continues. Nous devons comprendre en temps réel ce que font les agents et quels risques ces actions peuvent engendrer, et ajuster leur capacité à agir en conséquence », indique Hayete Gallot.
Et quoi de mieux pour surveiller ces agents que d’autres agents ? Des agents « Gardiens » – un « terme établi dans l’industrie » selon Microsoft – qui seront chargés de surveiller et de modérer toute action entreprise par un agent, en permanence. Et puisqu’un agent réunit un modèle, un harnais, un espace d’action et un environnement d’exécution, la sécurité doit suivre en conséquence, déclare l’entreprise.
C’est l’occasion pour Microsoft de remettre en avant son projet Perception, son infrastructure de sécurité dotée notamment d’agents répartis dans des équipes rouge, bleue et verte selon les actions à entreprendre. Perception est notamment utilisée en interne pour la découverte des failles de sécurité, avec un résultat spectaculaire sur les derniers mois, les fameux « Patch Tuesdays » étant passés d’une moyenne de 200 failles corrigées par mois à plus de 1 400 pour ceux du 13 octobre.
La responsable de Microsoft Security affirme que Perception peut être utilisé pour mettre en œuvre des contrôles déterministes sur une intelligence par nature non déterministe. Les entreprises intéressées pourraient ainsi rassembler les signaux des différents capteurs pour découvrir les agents et les étiqueter, calculer dynamiquement le risque associé à ce que les agents tentent de faire et répondre « chirurgicalement en temps réel » à mesure que le profil de risque augmente via les agents Gardiens.
Une série d’annonces concrètes
Dans un autre billet publié le 19 octobre, Nadim Abdo, vice-président à la tête de la division Identity and Network Access, complète l’annonce de sa collègue. Il rappelle la récente déclaration de Satya Nadella, patron de Microsoft, selon lequel « le système agentique le plus digne de confiance ne sera pas celui avec le modèle en lequel nous avons le plus confiance. Ce sera celui qui nous permettra de faire le moins confiance au modèle ». En d’autres termes, un agent prudent.
Pour rappel, Microsoft prend une direction très différente d’une partie de l’industrie, l’entreprise s’opposant notamment à la vision anthropomorphique d’Anthropic. « Les IA n’ont ni droits, ni sentiments, ni conscience », martelait ainsi en septembre Mustafa Suleyman, à la tête de Microsoft AI.
En plus de Perception, Nadim Abdo a donc publié une série de mesures concrètes à venir dans certains produits. Microsoft ajoute ainsi 35 types d’agents locaux (pour un total de 60), dont Claude Code, OpenAI Codex et GitHub Copilot. Entra Agent ID suit le mouvement et va recevoir de nouveaux types d’identité pour couvrir les agents locaux et ceux inconnus jusqu’ici. Microsoft va également mettre à disposition des bacs à sable (sandbox) comme Microsoft Execution Container (MXC), afin de créer des environnements où l’accès aux ressources est contrôlé par des règles, les contrôles de sécurité étant théoriquement hors de portée des agents.
Dans cet environnement, les agents démarrent sans aucun droit. Les permissions accordées seront limitées à la tâche, bornées dans le temps et réduites (voire supprimées) quand la tâche se termine ou change. Microsoft a baptisé son système Dynamic Permissions, qui permet entre autres de s’assurer que les droits d’un agent ne dépassent jamais ceux de l’utilisateur qui le pilote.
Microsoft présente aussi Dynamic Agent Risk et Dynamic Conditional Access. Le premier croise les signaux d’identité, de données, de terminaux, du cloud, de réseau et d’exécution pour produire une évaluation du risque. La note attribuée à l’enrôlement est mise à jour en continu. Le second étend l’accès conditionnel d’Entra aux agents avec une réponse graduée. Le système peut ainsi conserver la lecture mais bloquer l’écriture, restreindre les chemins réseau, exiger une approbation humaine vérifiable, et en dernier recours isoler l’environnement d’exécution ou arrêter l’agent. L’entreprise ajoute qu’elle intègre aussi des signaux tirés de la chaîne de raisonnement du modèle, pour détecter une dérive d’intention.
Enfin, dans Perception, le billet reprend les « Guardian Agents » et ajoute les Playbooks. L’un et l’autre servent à expliquer pourquoi le risque a changé, à examiner les éléments de preuve, et à recommander ou à appliquer un confinement.
Quelle date ? Quels prix ?
Problème de ces annonces, Microsoft ne donne pas d’information sur la disposition ou les prix. On ne sait pas quel type d’abonnement Microsoft 365 sera nécessaire, mais puisque l’ensemble doit fonctionner avec Microsoft Agents, l’offre E7 sera probablement nécessaire, soit la plus complète et la plus chère. Ces abonnements pour entreprises intègrent en grande partie les capacités d’Agents, mais l’accès à ces fonctions supplémentaires sera peut-être payant. Nous avons contacté Microsoft pour en savoir plus et mettrons à jour cet article si l’entreprise nous répond.
Ajoutons que dans le domaine des agents et de leur sécurité, la firme de Redmond est à la fois juge et partie : elle décrit un risque puis vend la solution. Elle a besoin de confiance pour vendre ses solutions basées sur l’IA (comme toute entreprise opérant dans ce domaine).
L’architecture mise en avant révèle également une certaine ambivalence. Microsoft évoque à plusieurs reprises le besoin de transparence, mais un système d’agents surveillant d’autres agents repose nécessairement sur un ou plusieurs autres modèles. Ainsi, la partie déterministe de l’infrastructure (identité, permissions bornées, accès conditionnel, bac à sable…) a beau reposer sur des principes éprouvés, elle est en contact avec une partie non déterministe, puisque fondée sur des modèles (risque dynamique, lecture du raisonnement, agents gardiens…).
Enfin, Microsoft indique dans ses annonces que son infrastructure peut se servir des chaînes de raisonnement. Mais encore faut-il que ces dernières soient exposées par les fournisseurs des modèles.
La faille CVE-2026-99999, surnommée PwnEscape, affecte la plupart des noyaux Linux actuellement maintenus. Elle n’est pas présente dans le nouveau noyau 7.3, mais la mouture 7.2 (entre autres) est touchée, nécessitant l’installation de la dernière révision.
Exploitée, cette faille permet à du code exécuté dans une machine virtuelle invitée de lire la mémoire du noyau de l’hôte.
À qui incombe la faute ? Pas à KVM ni à un hyperviseur en particulier. La vulnérabilité se trouve dans la pile IPv4 du noyau de l’hôte. Avec des métadonnées de somme de contrôle (checksum) erronées, le code de calcul de cette somme peut ainsi écrire sur un en-tête IPv4 que le noyau a déjà lu et exploité. En exploitant cette brèche, chaque paquet émis par l’invité pouvait ramener environ 32 octets de la mémoire de l’hôte.
La faille a été trouvée par le chercheur Paulos Yibelo dans le cadre d’un concours organisé par Vercel. Cette société indique dans son propre billet qu’en conditions de laboratoire, PwnEscape a même permis d’obtenir les droits administrateur sur l’hôte, ou de planter ce dernier. La société précise cependant que seule la lecture de la mémoire de l’hôte a été démontrée en infrastructure de production.
Source : Paulos Yibelo
Vercel ajoute qu’elle a pisté l’origine du problème à deux modifications : la prise en charge de l’en-tête virtio-net pour les périphériques tun/tap (2008, selon AlmaLinux) et le délestage de somme de contrôle pour les sockets de paquets (2010). En d’autres termes, la faille est présente depuis 18 ans.
Conséquence, de nombreuses nouvelles versions ont été publiées pour les noyaux actuellement supportés : 5.10.272, 5.15.223, 6.1.190, 6.6.159, 6.12.113, 6.18.57 et 7.2.11. À noter que les outils comme uname indiquant le numéro de version ne sont pas toujours représentatifs de l’état de la sécurité, car les distributions rétroportent souvent des correctifs sans changer le numéro de version. Il faut donc s’assurer pour chaque distribution que l’avis de distribution a bien été publié pour cette faille.
Enfin, il ne s’agit pas d’une faille 0-day. Paulos Yibelo indique dans son billet avoir signalé le problème en privé aux mainteneurs du noyau le 4 septembre. Le correctif a été accepté dans l’arbre réseau le 8 octobre et intégré au noyau principal le 14. Le bulletin CVE et les versions stables corrigées ont été publiés dès le lendemain (on peut voir la liste sur kernel.org). La précision est importante : Vercel évoque « the kernel-zero-day », mais l’expression semble renvoyer au fait que les mainteneurs du noyau ne connaissaient pas ce problème jusqu’à présent.
La faille ne semble pas exploitée. Toutefois, le chercheur précise que ses correctifs proposés ont fait l’objet de soumissions publiques sur la liste netdev entre les 19 et 22 septembre. La nature du problème y était clairement consultable, plusieurs semaines avant le CVE.
Drupal, une solution libre de CMS (système de gestion de contenu), a corrigé le 14 octobre deux failles critiques de type RCE (Remote Code Execution). Elles permettent donc, si exploitées, de faire exécuter un code arbitraire à distance.
La première faille, CVE-2026-108097 (bulletin SA-CORE-2026-014), touche le module Field UI du cœur de Drupal. Le bulletin la classe « critique » avec un score de 19 sur 25, mais ne donne pas directement le score CVSS. Celui-ci est de 9,8 sur 10, frôlant ainsi le maximum de dangerosité.
Drupal indique que le cœur seul ne permet pas d’exploiter cette faille directement, mais plusieurs chemins d’exploitation sont possibles via des modules contribués, c’est-à-dire créés et gérés par la communauté (Drupal ne fournit que les modules du cœur). Drupal ne donne cependant pas la liste des modules tiers en question. La faille peut également être exploitable avec du code spécifique au site. Au moins un des chemins d’exploitation ne réclame aucune authentification.
L’autre faille, CVE-2026-108099 (SA-CONTRIB-2026-218), touche le module contribué Entity List, qui sert à construire des listes d’entités sans passer par Views. Elle aussi exige l’interaction avec des modules contribués ou du code spécifique, avec au moins un chemin sans authentification là encore. Le score CVSS n’est pas encore disponible, mais la faille est probablement aussi dangereuse que la première, car Drupal lui attribue sa propre note de 19/25, le même score que la faille CVE-2026-108097.
Toutes les versions du cœur actuellement supportées sont concernées. Les correctifs sont disponibles dans les moutures 11.4.10, 11.3.19 et 10.6.19. Les versions 11.2.x et antérieures, ainsi que 10.5.x et antérieures, ne reçoivent plus de suivi de sécurité, et Drupal 8 et 9 sont en fin de vie. Pour Entity List, il faut passer en version 3.0.10.
À noter que Drupal propose une mesure d’atténuation pour la faille CVE-2026-108097 dans le cas où la mise à jour ne peut pas être appliquée tout de suite : désinstaller le module Field UI. Aucune mesure n’a en revanche été donnée pour l’autre vulnérabilité. Au vu de la dangerosité de ces failles, il est chaudement recommandé de mettre à jour les sites concernés sans attendre.
À noter qu’aucune de ces failles n’était a priori exploitée au moment de la publication des bulletins.
Les dernières mises à jour pour Windows Server, publiés le 13 octobre, engendrent des problèmes avec les serveurs Exchange sur site. Microsoft a confirmé ces perturbations, les versions concernées étant les 2016, 2019 et Subscription Edition. Ces défaillances sont liées à quatre mises à jour : KB5126646 (Windows Server 2025), KB5126655 (2022), KB5126651 (2019) et KB5126868 (2016).
Les symptômes sont nombreux : messages bloqués dans la boîte d’envoi d’Outlook, files d’attente qui s’allongent, échecs d’accès aux boîtes pendant la réplication, ou encore difficultés des membres d’un groupe de disponibilité de bases de données (DAG) à atteindre le quorum. Ces symptômes peuvent cependant varier fortement selon les configurations, certaines n’en développant aucun.
Selon la note publiée par Microsoft, les mises à jour d’octobre ont introduit une limite par défaut de 512 appels simultanés de recherche de point de terminaison (Endpoint Lookup). Cette limite contrôle la mémoire utilisée par Endpoint Mapper – un composant des appels de procédure distante (RPC) – et les charges Exchange élevées peuvent la dépasser.
Nous pouvons confirmer l’ampleur du problème, l’un de nos contacts ayant été touché. Il nous a indiqué qu’un redémarrage du serveur Exchange permettait de repousser le problème temporairement, ce que Microsoft confirme dans un billet publié séparément sur le blog de l’équipe Exchange. Celle-ci recommande de ne pas désinstaller les mises à jour (puisqu’elles corrigent un grand nombre de failles) puis d’exécuter la commande suivante depuis une invite en mode administrateur :
Il faudra ensuite redémarrer le serveur. Une fois cette étape réalisée, Microsoft recommande de surveiller l’état du serveur pour vérifier si le problème survient. Dans ce cas, il faudra augmenter la limite citée précédemment. Selon l’équipe Exchange, les retours ont indiqué que le problème était jugulé en appliquant cette méthode.
Après une longue gestation marquée par une montée en force de l’IA dans la détection des bugs, la version finale du noyau Linux 7.3 est arrivée. Les améliorations sont nombreuses, mais la disponibilité dépendra comme toujours de la distribution utilisée.
Le noyau Linux 7.3 est finalement arrivé comme prévu ce dimanche 18 octobre, après une gestation qui aura marqué les esprits. Selon les statistiques fournies par LWN, cette nouvelle mouture compte en effet 18 765 modifications (hors fusions), en provenance de plus de 3000 contributeurs. Elle est également significative par ses Release Candidates, marquées par l’arrivée « brutale » de l’IA dans la détection et la correction des bugs. Une « nouvelle normalité » commentait Linus Torvalds récemment.
La nouvelle mouture comporte une liste abondante d’améliorations, à commencer par la prise en charge du matériel. On note ainsi la prise en charge initiale des puces M3 Pro, Max et Ultra, qui complète celle du M3 de base ajoutée dans la 7.2. Même chose pour le nouveau type de cœur basse consommation en préparation chez AMD pour son architecture Zen.
Plus concrètement peut-être, on y trouve aussi la gestion des interruptions thermiques chez Intel, la prise en charge du bloc d’affichage DCN 6.0 et des modificateurs de format DRM pour d’anciens GPU AMD, le support de la manette Steam Controller de 2026, ou encore des améliorations de l’ordonnanceur pour les processeurs hybrides et une gestion plus unifiée des types de cœurs Intel et AMD. Le noyau intègre également un pilote pour la manette MSI Claw, un pilote HID-HyperX pour l’état de coupure du micro HyperX QuadCast 2, et la prise en charge du commutateur de mode tablette dans le pilote AMD Sensor Fusion Hub.
Du mieux pour certains systèmes de fichiers
Le noyau Linux 7.3 introduit en outre un nouveau système de fichiers particulier : failfs. Il se veut le pendant de nullfs et fait échouer toute opération l’atteignant avec l’erreur EOPNOTSUPP (chemins absolus, liens symboliques et chemins relatifs au répertoire courant). Pour son auteur, Christian Brauner, l’intérêt est de permettre aux processus de se défaire entièrement de leur état de système de fichiers. Ainsi, un processus dont la racine ou le répertoire courant est dans failfs doit ancrer chaque résolution de chemin sur un descripteur de fichier explicite.
On reste dans les systèmes de fichiers avec une série d’améliorations pour ceux déjà en place. Le noyau 7.3 inclut par exemple une hausse des performances (parfois significatives selon les scénarios) pour btrfs que Phoronix avait repérée à la sortie de la première Release Candidate fin aout. Alors que le code de support des systèmes EFS et FreeVxFS est supprimé, celui pour ntfs3 reçoit d’importantes améliorations, dont la prise en charge des flux de données alternatifs ainsi qu’un début de durcissement pour sa sécurité.
Parmi les autres changements, on remarque en outre des travaux significatifs sur le support de SMB, qui peut gérer en option Time Machine (le système de sauvegarde de macOS). Le serveur SMB intégré au noyau (ksmbd) gagne aussi la fenêtre de séquence des commandes SMB2, le rejeu des requêtes SMB3, le chiffrement SMB3 par partage et le chiffrement pour SMB Direct (RDMA). À la sortie de la Release Candidate 3, Linus Torvalds avait indiqué qu’un nombre important de correctifs était intégré pour SMB (ainsi que pour XFS).
LTS ou pas LTS ?
Cette version 7.3 est donc disponible, mais sa récupération réelle dépend fortement de la distribution utilisée. De nombreux systèmes ne proposent pas immédiatement les nouveaux noyaux et attendent leur version suivante pour l’intégrer. D’autres, notamment celles en rolling release, proposent les nouveaux noyaux très rapidement en général.
Enfin, un mot sur la prochaine version 7.4. Sa fenêtre d’intégration vient d’ouvrir et sa publication doit se faire vers la fin décembre. Cette version sera à nouveau importante pour le support matériel, avec par exemple l’activation du HDMI 2.1 sur les Radeon, le support des NPU dans les Ryzen AI Max 400, la poursuite des travaux sur le pilote NVIDIA Nova (pour remplacer l’actuel Nouveau), des optimisations sur la mémoire, ou encore la prise en charge initiale des puces M4 et A18 pro d’Apple.
On ne sait pas encore si cette version sera la nouvelle LTS (Long Term Support) ou s’il s’agira de la 7.3 qui vient de sortir.
Apple a publié un article de recherche sur Minions, une infrastructure permettant d’agréger les ressources GPU inutilisées sur des grappes de Mac dotés de puce Apple Silicon. Si le concept n’a rien de nouveau, les travaux d’Apple prolongent l’existant et inscrivent un peu plus les Mac dans le paysage de l’IA.
Les Mac sont décidément appréciés par les entreprises désireuses de faire tourner localement des LLM plus ou moins gros. Pourquoi les Mac ? Parce qu’ils embarquent une mémoire dite « unifiée », servant à la fois pour les parties CPU et GPU des puces Apple Silicon. Si votre Mac est équipé de 32 Go de mémoire vive, le GPU peut puiser dedans. Cette mémoire est certes moins rapide que la VRAM des cartes graphiques dédiées (sans même parler de la HBM), mais ce scénario d’usage compense par le volume.
Apple sait que ses Mac Mini et Studio partent comme des petits pains auprès d’entreprises comme OpenAI, Anthropic et Meta. C’est dans ce contexte qu’elle a mis en ligne un document de recherche (prépublication sur Arxiv) exposant le fonctionnement de Minions, une infrastructure GPU virtuelle dédiée aux charges d’inférence d’apprentissage automatique à grande échelle.
Rassembler l’inaction
L’architecture proposée repose sur quatre éléments. D’abord, un serveur central reçoit les requêtes via une interface web ou des API (REST). Il s’occupe de les valider puis de les découper de manière asynchrone en sous-tâches stockées dans une base PostgreSQL. En d’autres termes, le serveur est chargé de créer une file d’attente.
Ensuite, les exécuteurs. Ils tournent sur les Mac mis à contribution et traitent localement les sous-tâches sur le GPU, avant d’écrire le résultat des calculs dans une zone de stockage S3. Ils n’accèdent jamais directement à la base PostgreSQL : ils réservent des sous-tâches en utilisant l’API du serveur, via une table de la base dotée d’une contrainte d’unicité. Même chose pour mettre à jour l’état de la base, envoyer leur signal de vie (un message bref envoyé au superviseur pour indiquer qu’il fonctionne encore) et livrer leurs résultats.
Le superviseur, justement, est ici nommé « Watchdog » (littéralement « chien de garde »). Son rôle est de surveiller les exécuteurs en cours de traitement et de remettre en file d’attente les sous-tâches des exécuteurs devenus muets. Ce silence peut provenir de multiples causes : perte réseau, veille, extinction, arrêt volontaire, etc. Ce fonctionnement autorise donc une certaine souplesse.
Quant au dernier composant, c’est tout simplement le tableau de bord pour le suivi de l’ensemble en temps réel.
De fortes limitations
Le tout permet, comme relevé par Apple Insider, de mettre à disposition la puissance inutilisée des GPU pour les mettre à contribution lors d’un travail d’inférence. Ainsi, des équipes qui lancent de grands lots asynchrones d’inférence (index de recherche, génération de texte en masse pour l’évaluation ou l’étiquetage…) n’ont plus besoin d’attendre qu’une grappe de GPU se libère. C’est du moins le fonctionnement sur le papier.
Si le document est intéressant dans le fond, il est aussi très court. Apple ne fournit aucune information mesurée : pas de tests de débits, pas de coût énergétique, de taux de reprise ou aucune comparaison quelle qu’elle soit. Il est donc difficile de se rendre compte des performances.
Les cas présentés ont également un périmètre limité. La publication n’évoque que deux types de charges : les modèles de vecteurs de représentation chargés via la bibliothèque Transformers de Hugging Face, et la génération de texte via Ollama. Il n’y a pas d’ordonnanceur central, il ne s’agit donc pas d’un modèle découpé et réparti entre les machines.
En fait, chaque exécuteur doit pouvoir faire tourner intégralement le modèle en local, ce qui limite d’autant les cas. La mémoire a beau être universelle sur les Mac Apple Silicon, sa quantité détermine directement ce que l’on peut y faire résider. Pas question par exemple d’y faire tourner le tout récent Muse Spark Open.
Et si vous vous posez la question : non, l’entrainement n’est pas pris en charge, en tout cas pour l’instant. Apple compte prendre en charge l’entraînement distribué à l’avenir, sans plus de détails.
Quel intérêt ?
Au sein d’une organisation, l’infrastructure présentée peut avoir des avantages, mais il ne s’agit pas d’un projet « magique » capable de fonctionner avec tous les modèles. Il y a quand même plusieurs avantages : pas d’achat de GPU dédiés, un coût d’infrastructure considéré comme « nul », une capacité générale qui grandit avec le nombre de Mac présents sur place, ou encore un fonctionnement local puisque les données ne sortent pas de l’organisation.
L’intérêt d’Apple est d’avancer discrètement sur l’argument commercial que les Mac sont des machines taillées pour l’IA. Sur ce point, la présentation de Minions rejoint les annonces autour de Muse Spark Open et du rapprochement avec Meta, Apple ayant publié des mesures et de la documentation MLX.
En filigrane, le papier raconte également une autre histoire : celle des propres limites d’Apple. L’entreprise le dit elle-même dans son article, elle manque de GPU centraux. Ainsi, avant que Minions ne soit utilisé (montrant au passage que l’infrastructure n’est pas que théorique), certaines tâches d’inférence pouvaient attendre plus de 10 heures avant de commencer. Avec Minions, le temps ne serait plus que de quelques minutes, mais Apple ne donne aucun détail supplémentaire.
Dans l’absolu, Minions ne crée aucune rupture, car la récupération de cycles, le calcul bénévole ou encore l’inférence répartie existent déjà. C’est dans les grandes lignes le schéma adopté par l’infrastructure de calcul distribué BOINC, qui exploite les GPU depuis vingt ans. On peut également citer Petals pour répartir un grand modèle en blocs de couches sur des machines bénévoles réparties sur internet. Mais l’idée pourrait séduire les organisations déjà dotées de nombreux Mac, surtout s’ils sont récents et accompagnés d’une bonne quantité de mémoire.
« Plus largement, Minions ouvre une perspective inédite pour la communauté de l’apprentissage automatique : si les appareils macOS inactifs, à l’échelle de plusieurs organisations, voire de la communauté mondiale, pouvaient être fédérés de manière sûre, ils formeraient un vaste parc de GPU partagé, au bénéfice de l’ensemble de l’écosystème », indique Apple dans une conclusion plus ambitieuse.
Sync-in est un projet libre de stockage, synchronisation et collaboration autour des fichiers. Son développeur principal, Johan Legrand, nous avait expliqué en octobre 2025 sa volonté de proposer une solution simple pour synchroniser et gérer des fichiers, avec un aspect collaboratif. Sync-in s’installe sur un serveur et permet la gestion des fichiers, l’utilisation d’une suite bureautique et fournit une gestion fine des autorisations.
La nouvelle mouture 2.6 intègre désormais draw.io pour la création et l’édition des diagrammes. L’installation peut se faire via le service Docker fourni ou une instance draw.io externe. La fonction prend en charge les fichiers VSDX et Gliffy, qui peuvent être importés et convertis au format .drawio.
Draw.io dans Sync-in
Cette version apporte également des améliorations diverses, dont une visionneuse d’images modernisée, un mode galerie pour parcourir les images d’un dossier, la réunion du filtrage local et de la recherche globale dans la barre de navigation, des préférences utilisateur persistantes (enregistrées au niveau du compte), ou encore la possibilité pour la synchronisation d’ignorer les suppressions.
Sync-in propose en outre des améliorations de performances. La consommation mémoire se veut ainsi réduite d’environ 10 % et les vérifications de la base de données sont plus rapides. Côté sécurité, on note une protection harmonisée pour les services sensibles, dont l’authentification, la synchronisation et les liens publics.
Comme les versions précédentes, Sync-in 2.6 peut être récupéré en paquet NPM ou en image Docker. Les clients desktop (Windows, Mac, Linux, CLI) recevront prochainement une version 2.3 pour tenir compte des nouveautés introduites.
Le débat secoue la communauté du libre depuis des mois : faut-il accepter le code généré par IA ? Pour certains, c’est une trahison de l’esprit même du libre. Pour d’autres, ce n’est pas un problème. Pour Linus Torvalds, il n’y a vraiment aucun problème, mais à une condition. Au point de se mettre une nouvelle fois en colère.
La question de savoir si le code généré par IA doit être accepté dans le noyau Linux semble être tranchée depuis un moment. Mais, le débat a évolué il y a bientôt 18 mois : le code généré par IA doit-il recevoir un marquage spécial ?
La question a été officiellement posée par Sash Levin en juillet 2025, comme le relevait alors Phoronix. Développeur travaillant chez NVIDIA et co-mainteneur des versions LTS (Long Term Support) du noyau, il avait proposé que les contributions au code générées par des LLM soient marquées d’un label « Co-developed-by ». Avec le temps, cette proposition évoluera en « Assisted-by ».
Dans un premier temps, cette proposition va plaire, au point d’être adoptée au Maintainers Summit 2025 en fin d’année dernière. À ce moment déjà, Linus Torvalds doutait déjà du bien-fondé de l’approche. Dans les mois qui suivent, un document coding-assistants.rst entre dans le noyau 7.0 pour formaliser ce qui est alors considéré comme une bonne pratique.
L’usage raisonné à grands coups de marteau
Les positions du père de Linux vont retentir plusieurs fois en 2026. Dès janvier, il s’oppose à ce que la documentation du noyau prenne parti. Sans jamais vraiment le dire, il milite alors pour un usage « raisonné » de l’IA. En mai par exemple, il tempête contre les trop nombreux rapports de bugs produits par les outils automatiques. Une critique désormais courante, portée notamment par l’équipe de FFmpeg qui fustigeait les LLM utilisés à la va-vite pour générer des rapports de bugs de faible qualité (le fameux slop, ou « bouillie »).
Deux mois plus tard éclate un débat autour de Sashiko, un service centralisé proposé par Google pour surveiller automatiquement la mailing-list du noyau (entre autres) pour publier ensuite des reviews de code de manière automatisée. Linus Torvalds intervient alors pour indiquer que le consensus général des mainteneurs du noyau est que l’IA est utile quand elle est utilisée correctement. Il ne souhaite pas que les rapports générés soient rejetés en bloc, tout en soulignant les améliorations nécessaires.
Le cas du noyau Linux 7.3
Depuis, sa position s’est encore affirmée, notamment à travers la gestation du noyau Linux 7.3. Les Release Candidates 6 et 7 sont devenues une « nouvelle normalité », car au lieu de ne corriger que quelques bugs – ce qui est traditionnellement le cas à ce stade du développement –, elles en corrigent des centaines.
Jonathan Corbet (LWN.net) a ainsi fait un compte-rendu du dernier Maintainers Summit qui s’est tenu le 8 octobre à Prague. Selon lui, le noyau 7.3 comporte actuellement 18 533 changements. Sur cet ensemble, 10 % des correctifs portent la mention « Assisted-by », mais il ajoute : « Le nombre réel de correctifs assistés par LLM est sûrement bien plus élevé ».
Il rapporte également la prise de parole de Linus Torvalds : blâmer les LLM au sein de la communauté est contre-productif car le problème se concentre sur les utilisateurs qui ne savent comment les utiliser, ou même comment fonctionne le noyau. « Torvalds et d’autres ont répété que les contributions de faible qualité venaient de nouveaux développeurs et qu’elles devraient recevoir une faible priorité, la communauté devrait arrêter d’essayer de rendre la contribution facile. De nombreux développeurs ont déclaré, à plusieurs reprises qu’ils essayaient de les mentorer mais que c’était presque toujours une perte de temps ; ils n’écoutent pas », rapporte sévèrement Jonathan Corbet.
Linus Torvalds se fâche (encore)
Au sommet de Pragues, les mainteneurs du noyau ont convenu que l’étiquette était désormais obsolète. Cependant, le développeur Laurent Pinchart s’y est opposé. Dans un message daté du 13 octobre, il refuse que l’étiquette soit supprimée tant qu’un mécanisme de remplacement n’a pas été mis en place. Il soutient qu’une règle sert à fixer les attentes, même si certains la contournent.
« Je ne comprends pas toute cette idée idiote du « n’utilisez pas l’IA pour X ». Voici une nouvelle règle rien que pour vous : n’utilisez aucun compilateur pour vos contributions au noyau. Parce que si vous ne pouvez pas démontrer que vous comprenez réellement ce que fait la machine en écrivant votre code en assembleur, alors je ne veux pas voir votre contribution. Vous n’êtes manifestement pas compétent si vous ne savez pas l’écrire ainsi.
Et au fait, vous feriez mieux de ne pas utiliser non plus d’éditeur pour rédiger ce message de validation. Parce que j’ai besoin que vous me montriez que vous savez réellement écrire un bon message de validation sans outils qui permettent de revenir en arrière facilement et de masquer les erreurs commises en tapant. D’accord ? Parce que, sinon, vos validations assistées par des outils ne montrent clairement pas que vous savez ce que vous faites.
Ne voyez-vous pas à quel point ce genre de règles serait ABSOLUMENT STUPIDE ?
Alors non. Nous n’allons pas établir de règles stupides qui disent « vous ne pouvez pas utiliser d’outils pour X ». Ce que j’attends moi, c’est que les gens fassent de leur mieux, et j’attends d’eux qu’ils comprennent ce qu’ils font. Mais cette compréhension a très peu de rapport avec les outils qu’ils utilisent.
Et, très honnêtement, d’après mon expérience, les personnes que je respecte et que je juge intelligentes ne sont pas celles qui rechignent à utiliser des outils nouveaux et intéressants. »
Aujourd’hui, un nombre croissant accepte les contributions générées par LLM. Dernièrement, le cas le plus visible a été le projet Debian, qui a adopté un consensus que l’on trouve dans plusieurs autres projets, dont Fedora, LLVM ou même Firefox : les contributions sont acceptées à condition que les personnes qui les émettent soient capables de les relire, de les comprendre et de les expliquer.
D’autres projets, comme Gentoo, NetBSD, Zig ou Krita refusent explicitement ce type de contribution ou ont mis en place un moratoire sur cet usage. Enfin, beaucoup ne sont pas encore officiellement positionnés, à l’instar du projet KDE, qui vient de fêter ses 30 ans.
Google cherche à séduire une nouvelle génération d’utilisateurs en faisant miroiter la facilité avec laquelle on peut développer une application Android à partir de requêtes en langage naturel. Attention toutefois à la sécurité.
Google a présenté un changement dans sa politique de développement des applications pour Android. Avec Google AI Studio, il va devenir possible de générer une application Android par instructions en langage naturel puis de la lancer sur son propre appareil via Google Play, sans rien payer.
Ces applications dites « personnelles » ne vont donc plus réclamer un compte développeur, actuellement facturé 25 dollars (achat unique). Un simple compte Google va suffire. Cette possibilité est d’abord déployée aux États-Unis pour les personnes majeures. Au cours des prochains mois, cette capacité sera étendue à d’autres marchés (sans précisions) et aux cercles restreints de proches pour faire tester les applications et obtenir des retours.
Google cherche ainsi clairement à offrir un nouveau débouché à ses outils d’IA générative, puisque la fonction est réservée à AI Studio, donc à Gemini. Dès que l’on souhaite passer de développeur personnel à développeur voulant proposer officiellement ses applications sur le Play Store, le compte à 25 dollars redevient obligatoire.
On peut y voir une manière d’adoucir les changements récents introduits sur le Play Store, dont l’obligation de faire vérifier son profil pour distribuer ses applications via la boutique. Même si cette nouvelle voie reste entièrement sous le contrôle de Google, elle permet de répondre en partie aux critiques sur la fermeture de Google aux applications « faites maison ». C’est aussi une manière pour Google de familiariser un plus grand nombre de personnes à son écosystème.
Simple, mais potentiellement dangereux
On peut s’amuser en revanche d’un point particulier : dans le cadre de ces applications personnelles, aucune vérification n’est faite par Google puisqu’elles ne passent pas par le Play Store. Le code généré par AI Studio pourrait comporter des failles et des faiblesses, mais elles relèveront de la responsabilité du développeur amateur en cas de problème. Le risque est limité tant que l’usage est personnel, mais il peut avoir son importance dès lors que ces applications seront partagées avec les proches.
Ce type de danger peut être illustré par le cas Gouinder débattu récemment sur X. Une femme a développé un équivalent de l’application de rencontres Grindr à destination des utilisatrices lesbiennes, mais un problème est rapidement apparu : le service affichait en clair dans son code la position exacte (au mètre près) des utilisatrices, avec le danger inhérent d’une telle information. Le cas n’est pas directement rattaché à Google, mais donne un aperçu de ce qu’un contrôle insuffisant du code peut induire après sa génération par un LLM.
À noter enfin plusieurs changements pour les jeux dans Play. Les utilisateurs vont ainsi pouvoir générer directement des comparaisons entre applications et poser des questions en langage naturel pour trouver un ou plusieurs titres. Game Finder pourra également recommander des jeux à partir d’un « Gamer DNA », basé sur une analyse de la manière de jouer, les notes données et les centres d’intérêt. Signalons aussi un changement important pour Family Link : les parents pourront transmettre la tranche d’âge des enfants au lieu d’informations plus détaillées.
Linux Mint est une distribution populaire. Basée uniquement sur les versions LTS (Long Term Support) d’Ubuntu, elle se distingue par un soin particulier porté à son interface, guidée par la philosophie de GNOME 2.X plutôt que par la branche 3. Dans son approche, elle rappelle donc plutôt KDE (dont on fête les 30 ans aujourd’hui), avec notamment une barre des tâches et un menu principal.
Dans un billet publié le 13 octobre, le développeur principal de Linux Mint, Clément Lefebvre, indique que la prochaine édition majeure se nomme « Adrien ». Cette version 27 sera basée pour la première fois sur Ubuntu 26.04, impliquant une modernisation de sa base, puisque l’actuelle mouture est fondée sur Ubuntu 24.04.
Le développeur indique qu’il s’agira de la première version à résulter du changement de rythme dans la parution de Mint, puisque le cycle du système est passé de 6 à 12 mois. « Je travaille sur Linux Mint depuis plus de 20 ans maintenant. Je ne pense pas avoir déjà vu autant de changements et de nouvelles fonctionnalités implémentés pour une seule version. C’est vraiment excitant et ça me fait un peu peur parce que cela signifie aussi que nous allons être très occupés pendant la phase bêta », indique Clément Lefebvre.
Illustration : Flock
Il donne plusieurs informations intéressantes. D’abord, la date de sortie : Linux Mint 27 sortira à Noël. Ensuite, une explication sur le numéro de version. Pourquoi passer de 22.3 actuellement à 27 ? Justement parce que le cycle est désormais annuel et que Clément Lefebvre préfère que les nouvelles versions aient simplement le numéro de l’année à venir, donc 27 pour la mouture sortant à Noël.
Enfin, outre une nouvelle application pour les alarmes, Linux Mint 27 sera disponible « au moins » en éditions Cinnamon, Xfce et MATE. Aucun mot pour l’instant sur la prochaine LMDE (Linux Mint Debian Edition).
Clément Lefebvre signale au passage qu’il « se passe beaucoup de choses en coulisses », évoquant le travail sur trois autres projets nommés Superlight (moniteur système), Unfold (gestionnaire d’archives) et Velocitty (émulateur de terminal), qui seront détaillés courant novembre.
Pour le cinquième mois consécutif, Microsoft bat son record de failles de sécurité corrigées dans ses produits. Le Patch Tuesday d’octobre vient ainsi colmater le nombre impressionnant de 1 411 vulnérabilités. Parmi elles, trois sont de type 0-day, dont une déjà exploitée.
Ce 13 octobre, Microsoft a publié des correctifs pour un nombre record de 1 411 failles, dont une activement exploitée et deux 0-day, c’est-à-dire dont les détails étaient déjà connus au moment de la publication de leur correctif. Parmi le lot global, 70 sont critiques : 57 exécutions de code à distance, 11 élévations de privilèges et 2 usurpations.
Ce chiffre de 1 411 failles est donné par Bleeping Computer. Il est d’autant plus impressionnant que nos confrères n’ont compté que les vulnérabilités effectivement corrigées par les mises à jour publiées mardi soir. Ils n’ont pas intégré les 348 failles corrigées plus tôt dans le mois, notamment dans Azure API Center, Azure App Service, Azure Event Grid, Azure SRE Agent, Mariner, Microsoft Bookings, Dataverse, Exchange Server et Partner Center.
Trois failles dangereuses, dont une déjà exploitée
Dans le lot, trois failles ressortent particulièrement. La plus importante est CVE-2026-96951 car elle est activement exploitée. Critique (score CVSS de 8,8 sur 10), elle peut être exploitée par injection de commande dans le Shell Windows, permettant alors de contourner la fonction de sécurité « Mark of the Web », qui marque la provenance internet apposée aux fichiers téléchargés. On ne sait pas qui a découvert la faille.
Vient ensuite CVE-2026-108398, une vulnérabilité de contournement des fonctionnalités de sécurité du .NET Framework. « Un chemin de recherche non fiable dans .NET Framework permet à un attaquant autorisé de contourner localement une fonctionnalité de sécurité », explique Microsoft. Plus précisément, l’exploitation permet le contournement du contrôle des applications de Windows Defender (WDAC) et donc de lancer des applications non autorisées, sans interaction utilisateur. La faille est critique, avec là aussi un score CVSS de 8,8, et a été découverte par James Forshaw du Project Zero de Google.
Enfin, CVE-2026-92707 est de niveau plus modéré, avec un score de 5,3. « Une allocation mémoire séquentielle mal contrôlée dans .NET permet à un attaquant non autorisé de refuser un service sur un réseau », indique Microsoft. L’éditeur ne précise pas en revanche qui l’a découverte.
Le nombre de failles critiques, la vulnérabilité déjà exploitée et les deux autres failles 0-day rendent l’installation des correctifs urgente. Il est chaudement recommandé de les appliquer aussi rapidement que possible, le processus réclamant un redémarrage de la machine.
L’IA tourne à plein régime
Comme les mois précédents, le déluge de correctifs est une conséquence directe de deux machineries lourdes mises en place par Microsoft plus tôt dans l’année. D’abord MDASH (Microsoft Security multi-model agentic scanning harness), son harnais multi-agents de détection et de remédiation de vulnérabilités, présenté en mai. Puis en juillet, ce fut au tour du projet Perception, se servant de MDASH, du modèle MAI-Cyber-1-Flash et d’autres modèles, Microsoft affirmant depuis être le maître dans la détection de failles.
L’éditeur revendique ainsi depuis plusieurs mois l’utilisation très intensive de l’IA pour détecter et corriger les failles, provoquant une explosion des correctifs chaque mois. Septembre avait déjà marqué les esprits, Microsoft frôlant le millier de correctifs, mais ce record est battu à plate couture en octobre, avec un écart d’environ 450 failles supplémentaires.
Ce mouvement n’est pas spécifique à Microsoft. On le retrouve également chez Apple et dans un nombre croissant de projets libres, à commencer par le noyau Linux lui-même. La gestation du noyau 7.3 est ainsi marquée par des Release Candidates plus volumineuses qu’habituellement, chacune corrigeant une longue liste de problèmes. Linus Torvalds himself se sert couramment de l’IA (Claude en l’occurrence) pour des correctifs et autres améliorations.
Quelques jours après les chiffres sur le marché des PC, ceux des smartphones révèlent une réalité quasi identique : un fort recul, entrainé largement par la hausse spectaculaire des prix de la mémoire vive.
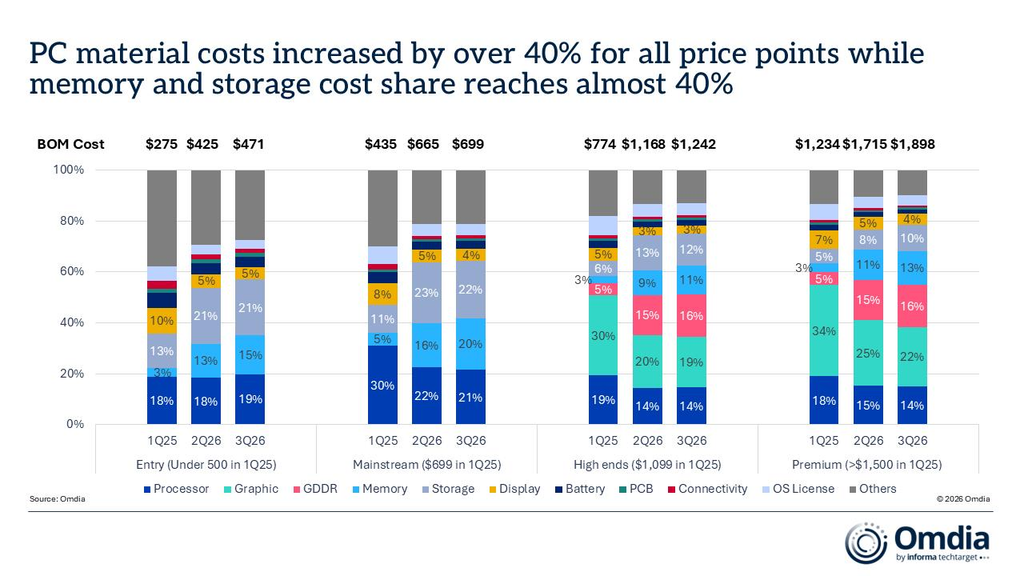
Le 9 octobre, nous indiquions que le marché des PC avait plongé de 20 %, chiffre que l’on retrouvait chez plusieurs cabinets d’analyse, dont IDC et Omdia (anciennement Canalys). Ce chiffre correspondait au recul des expéditions mondiales, comparé à celui du troisième trimestre 2025. Ce recul brutal était expliqué en grande partie par le prix de la RAM et, dans une moindre mesure, par celui de la NAND (utilisée dans les SSD). Selon Omdia, le prix du duo RAM-NAND représente 40 % de celui d’un PC neuf en moyenne, contre 15 % un an plus tôt.
PC, smartphones, même combat
Sans trop de surprise, la situation est identique pour les smartphones. Les chiffres publiés par Counterpoint montrent la même ampleur : le troisième trimestre a enregistré une chute de 20 % des expéditions mondiales par rapport au même trimestre l’année dernière. Le cabinet d’analyse met amplement en avant les tarifs de la RAM comme facteur principal, avec à la clé une augmentation moyenne de 20 % des prix des smartphones depuis le début.
La situation est semblable sur d’autres points. Sur le marché PC, cette dégringolade n’a entraîné aucun remaniement dans le classement des plus gros constructeurs. Il en va de même pour les smartphones, Samsung restant en première place avec 23 % de parts de marché, Apple étant juste derrière avec 22 %. Les deux entreprises ont perdu des plumes, mais moins que leurs concurrents. Xiaomi, par exemple, chute lourdement avec une baisse de plus de 30 % sur un an.
Pour Apple, les nouvelles ne sont pas toutes mauvaises, car c’est la première fois que la société de Cupertino dépasse la barre des 20 % à l’échelle mondiale sur un troisième trimestre. Deux raisons sont avancées par Counterpoint. D’abord, l’absence d’iPhone 18 non Pro, se traduisant par des approvisionnements moindres des distributeurs et donc des livraisons moindres. Ensuite, la hausse des prix n’est arrivée qu’en fin de trimestre. Les iPhone 18 Pro et Pro Max ayant connu un meilleur démarrage que leurs prédécesseurs (surtout en Chine), Apple arrive à s’en sortir.
Counterpoint confirme également que le haut de gamme s’en sort mieux que l’entrée et le milieu de gamme. En aout dernier, nous indiquions déjà que la crise de la mémoire plombait ces segments. À eux seuls, la RAM et la NAND peuvent représenter les deux tiers du prix d’un appareil, privilégiant les constructeurs ayant investi le secteur premium, dont Samsung et Apple.
Horizon bouché
Peut-on apercevoir une embellie à l’horizon ? Pas vraiment. Si l’on en croit Trendforce, le marché de la NAND pourrait commencer à entrevoir une petite amélioration durant le second semestre 2027, mais celui de la RAM restera très tendu jusqu’à nouvel ordre.
Les habitudes de la clientèle évoluent également, selon Counterpoint : « Les consommateurs conservent leurs appareils plus longtemps que prévu, envisageant de plus en plus les appareils reconditionnés et privilégiant les appareils de plus grande valeur, tandis que les fabricants ajustent leurs portefeuilles, leurs prix et leurs stratégies de marché pour protéger leur rentabilité ».
Mais le cabinet est pessimiste sur la suite pour l’instant : « Une reprise significative des volumes globaux est peu probable tant que les coûts des composants et les conditions d’approvisionnement ne s’amélioreront pas ».
Le studio Hello Games est connu pour l’une des plus belles « remontadas » du jeu vidéo. No Man’s Sky, à sa sortie il y a dix ans, était bien loin des promesses faites pendant son développement, notamment par le fondateur et patron de l’entreprise, Sean Murray. Hello Games n’a cependant pas lâché l’affaire : le titre a accumulé des dizaines de mises à jour de contenu gratuites. Aujourd’hui, les annonces sur X sont souvent suivies de plaisanteries par des joueurs « suppliant » Sean Murray de les laisser payer pour du contenu.
Le titre s’est également fait un nom en sortant sur de nombreux supports : Windows d’abord, puis macOS et finalement toutes les consoles. Sur Linux, le jeu fonctionne via Proton. Et voilà que le studio veut franchir une nouvelle étape : porter le jeu sur iOS.
Dans sa vidéo d’annonce, Sean Murray indique que l’idée est venue d’abord sous forme de défi technique, comme pour les portages en réalité virtuelle et sur la première Switch. Sur iOS, le jeu serait maintenu sous la barre des 4 Go et aurait un impact limité sur l’autonomie (ce qui reste bien sûr à confirmer).
Il y aura toutefois des limitations. Certes le jeu embarquera l’ensemble des contenus déjà disponibles sur les autres plateformes (y compris la construction des corvettes), mais il sera dépourvu de multijoueur. En outre, les colonies planétaires ne seront disponibles que sur les iPhone 15 Pro ou des modèles plus récents. Pour le reste, le jeu réclame iOS ou iPadOS 26 avec une puce A12 au moins. Côté smartphones, cela correspond à l’iPhone 11.
Le jeu sera disponible le 29 octobre pour 19,99 dollars, accompagné d’une démo jouable. La fiche sur l’App Store permet de le réserver, l’achat se faisant a priori sous forme in-app depuis la démo. Le titre est également mis à l’honneur par Apple dans le communiqué de lancement de son Indie Game Week.
Epic Games travaillait sur un jeu de tir réunissant des personnages des univers Marvel et Star Wars, mais le titre n’a désormais plus de date de sortie. Parallèlement, les développeurs du titre auraient reçu pour consigne d’utiliser désormais l’IA pour l’ensemble du code et des visuels.
La coopération entre Epic Games et Disney devait accoucher d’un jeu de tir en mars 2027. Selon Bloomberg, ce titre aurait accumulé un retard significatif, au point de ne plus avoir de date de sortie. Si ce retard fait désormais autant parler, c’est pour la réponse d’Epic Games à ce problème : laisser faire l’IA autant que possible.
Epic Games confirme
Selon nos confrères, les développeurs auraient reçu de nouvelles consignes. La principale serait de laisser l’écriture du code et la production des visuels à des outils comme Claude (Anthropic), les développeurs étant alors chargés d’encadrer et d’orienter le contenu fourni par les LLM. Une partie du personnel s’interrogerait sur la manière dont les erreurs de l’IA seront corrigées et douterait de la réussite de l’initiative, ajoute Bloomberg.
Sans aller dans les détails, Epic Games a confirmé ce passage renforcé à l’IA. Jake Jones, directeur de la communication, a ainsi déclaré que l’entreprise adoptait effectivement un développement accéléré par l’IA, piloté par ses propres développeurs.
Tim Sweeney en personne, fondateur et dirigeant du studio, a réagi sur X à ce sujet :
« Nous effectuons un virage stratégique majeur ici chez Epic, en réorganisant les développeurs pour les réorienter vers une accélération maximale de l’IA. L’objectif n’est pas de faire les mêmes choses avec moins de personnes, mais de permettre à tout le monde ici de construire PLUS et MIEUX de choses, et d’apporter ces avantages à toutes les équipes utilisant Unreal »
Disney, en revanche, n’a pas commenté.
Une conviction ancienne
Les positions du patron d’Epic Games sur l’IA sont connues depuis longtemps. En juin dernier par exemple, Tim Sweeney avait défendu chez IGN l’idée que de petites équipes seraient bientôt capables de bâtir de vastes mondes peuplés de personnages aux dialogues générés. En novembre 2025, il s’en était pris aux mentions d’usage de l’IA exigées par Steam, les jugeant inutiles. Il estimait que ces outils interviendraient dans presque toutes les productions.
Ces prises de position ont cependant une saveur différente quand on les replace dans le contexte économique d’Epic Games. La société a procédé à plus d’un millier de licenciements en mars 2026, évoquant alors un contexte général difficile pour l’industrie du jeu vidéo, avec une croissance ralentie, des investissements plus faibles ou encore un plafonnement des ventes de consoles. La baisse de popularité de Fortnite était également un élément important dans cette communication.
Toutefois, Tim Sweeney assurait que les LLM n’étaient pas responsables de ces licenciements : « Puisque le sujet est désormais d’actualité, je tiens à préciser que les licenciements ne sont pas liés à l’IA. Dans la mesure où elle améliore la productivité, nous souhaitons disposer d’un maximum de développeurs talentueux pour créer du contenu et des technologies de pointe. »
Le contrat avec Disney
Le partenariat avec Disney occupe probablement une place centrale dans cette stratégie. Annoncé en février 2024, il s’est accompagné d’une prise de participation de 1,5 milliard de dollars de Disney dans Epic. L’ambition était claire : construire un univers persistant relié à Fortnite en puisant dans les licences Marvel et Star Wars. Ce partenariat avait cependant rencontré un couac lié à l’IA dès mai 2025, quand un Dark Vador à la voix synthétique avait proféré des grossièretés dans Fortnite avant qu’un correctif ne soit déployé, comme l’indiquait alors Ars Technica.
Selon Bloomberg, il s’agit de la première tentative d’un grand éditeur de fonder un jeu principalement sur l’IA. L’article rappelle d’ailleurs l’enquête annuelle de la Game Developers Conference, menée début 2026 auprès de plus de 2 300 professionnels. Elle montrait l’écart avec les usages courants : 36 % des répondants utilisaient l’IA générative dans leur travail, essentiellement pour la recherche et la réflexion préalable (81 % d’entre eux), loin devant l’aide au code (47 %) et le prototypage (35 %).
Cette enquête comportait en outre un résultat marquant : la proportion de développeurs estimant que l’IA générative avait un impact négatif sur l’industrie avait bondi de 30 % en 2025 à 52 % cette année. « Les travailleurs des arts visuels et techniques (64 %), du game design et du narratif (63 %) et de la programmation (59 %) ont les opinions les plus défavorables », ajoutait le rapport.
Des chiffres à relier au scepticisme évoqué par Bloomberg chez les employés d’Epic Games après réception des nouvelles consignes. Selon plusieurs personnes interrogées (qui ont tenu à garder l’anonymat), l’annonce ferait l’objet de nombreuses plaisanteries sarcastiques, d’autres estimant plus sérieusement que le studio n’aura pas les bénéfices escomptés, notamment à cause des erreurs propres aux IA génératives.
Tim Sweeney ne semble pas se faire d’illusion sur la transformation en cours. Interrogé sur la possibilité qu’une telle bascule puisse accélérer une entrée en bourse, le patron a répondu sur X : « Notre objectif plus modeste est de survivre à la révolution de l’IA, d’aider d’autres développeurs à faire de même, et d’en ressortir en produisant un meilleur code et un meilleur contenu plus rapidement ».
Dans la nuit du 11 au 12 octobre, des pirates ont pris le contrôle de systèmes de régulation du froid dans plusieurs centaines de supermarchés français. Danfoss, le fabricant danois de ces contrôleurs, affirme que les équipements compromis étaient soit obsolètes, soit non mis à jour. Le parquet de Paris a ouvert une enquête.
Mise à jour du 13 octobre : Le CERT-FR a publié cette nuit un bulletin d’alerte sur la situation. « L’exposition d’une interface de gestion sur Internet est contraire aux bonnes pratiques », pointe l’équipe, qui rappelle que l’administration à distance n’est pas toujours impérative. Si c’est le cas, le CERT conseille de durcir les systèmes impliqués et renvoie vers ses recommandations à destination des acteurs du secteur de l’énergie et de l’eau.
Publiées en janvier 2026, elles faisaient suite à de nombreux signalements reçus par l’ANSSI relatifs au ciblage par des groupes hacktivistes d’entités du secteur à des fins de déstabilisation, dont l’action la plus aboutie avait provoqué l’arrêt pendant quelques heures d’un parc éolien.
Si des signes de compromission sont repérés, le CERT recommande de filtrer les accès réseaux aux seuls prestataires impliqués, de réaliser un retour aux paramètres d’usine (factory reset), d’appliquer tous les correctifs disponibles, de lancer une rotation des secrets (dont le renouvellement des mots de passe), de vérifier les comptes existants et de « reconfigurer globalement l’équipement ».
Sur LinkedIn, Vincent Strubel, directeur de l’ANSSI, conseille de déconnecter tout ce qui peut l’être, « ou d’adopter a minima une politique de filtrage réseau très restrictive, en attendant d’en savoir plus ». Les détails manquent en effet sur l’attaque, comme le rappelle Vincent Strubel dans un commentaire sous sa publication : « Il y a plusieurs vulnérabilités qui sont des vecteurs possibles pour cette attaque, mais rien de réellement établi à ce stade ».
En plus des séries AK-SC et AK-SM de Danfoss, le CERT pointe désormais les contrôleurs Copeland xweb et Dixell xweb
Article original du 12 octobre : L’attaque a visé les meubles réfrigérés, les chambres froides et les centrales de froid. Selon BFMTV, les attaquants ont détourné la fonction de dégivrage automatique. Le cycle normal, qui prévoit environ deux heures de dégivrage par jour, aurait été remplacé par un dégivrage forcé et continu, avec une température fixée à 50 °C.
En conséquence, une quantité importante de nourriture a été perdue. L’heure de déclenchement a cependant joué un grand rôle. Dans une partie des magasins, ces modifications auraient commencé avant minuit, laissant les installations chauffer pendant plusieurs heures avant l’arrivée des premiers employés et provoquant la perte complète des stocks. Dans d’autres cas, plus tardifs, une partie des stocks aurait pu être sauvée.
Une centaine de coopératives U seraient concernées, ainsi que 300 magasins des enseignes Intermarché et Netto, selon BFMTV qui mentionne également des magasins Leclerc. Selon le parquet de Paris, cité par Le Monde, il y a également eu des « départs de feu ». Une enquête a été ouverte.
Les contrôleurs Danfoss
Le point commun de ces installations est la présence, au sein des équipements, d’un contrôleur de la marque Danfoss. Ils permettent, entre autres fonctions, une surveillance telle qu’imposée par l’Union européenne. Des normes strictes impliquant un horodatage des températures, des alarmes en cas de hausse anormale ou encore des actions de maintenance à distance, comme le rappelle Raphael Grably (BFMTV) sur X.
Le journaliste a obtenu la réaction du constructeur danois, qui affirme que les modèles visés relèvent de deux cas : soit des contrôleurs obsolètes, les AK-SM 800 et AK-SC 355, soit un contrôleur qui n’avait pas été mis à jour, l’AK-SM 800A.
Cette déclaration réoriente la responsabilité vers les magasins et les entreprises engagées dans la sous-traitance du matériel. L’exposition à internet suppose en effet une surveillance étroite du code employé. L’AK-SC 355 n’étant plus commercialisé, Danfoss recommande son remplacement par la gamme AK-SM 800. Quant à l’AK-SM 800A, l’actuel successeur, il reçoit régulièrement des mises à jour.
Or, ces contrôleurs AK-SM 800A ont fait l’objet de deux séries de failles publiques. D’abord une série de trois failles en août 2023 dans la version 3.3 du microgiciel (firmware). La plus grave permettait à un attaquant authentifié d’exécuter des commandes à distance. Ensuite, en 2025, trois nouvelles failles signalées par la société Claroty, corrigées dans les versions 4.2 et 4.3.1. La plus importante, CVE-2025-41450, permet d’obtenir à distance une session d’administrateur. Dans l’article dédié publié en août dernier, Claroty indiquait que 2 765 interfaces AK-SM 800A étaient alors accessibles depuis internet.
Le lien avec l’attaque de cette nuit n’est cependant pas établi. Une partie des appareils cités par Danfoss, les AK-SM 800 et AK-SC 355, n’entre pas dans le champ de l’étude de Claroty, consacrée au seul AK-SM 800A. Selon ZATAZ, des versions antérieures à la version 4 auraient été visées, versions qui cumulent donc les failles de 2023 et 2025. En outre, modifier une consigne ou un cycle de dégivrage serait une fonction d’administration « ordinaire » : un accès avec un identifiant valide suffit, sans exploiter de faille.
Des conséquences financières très concrètes
L’enquête ouverte est dirigée par la section anti-cybercriminalité du parquet de Paris et confiée à l’Office anti-cybercriminalité (OFAC). Elle devra déterminer comment l’attaque s’est produite et qui sont les responsables.
L’attaque soulève quoi qu’il en soit de nombreuses questions, notamment sur les processus de mise à jour des équipements, ou même sur la durée d’entretien logiciel pour ces équipements. Une telle attaque contre la chaine du froid à l’échelle d’un pays semble inédite et entraîne des conséquences très concrètes. Sur LinkedIn, Dominique Schelcher, PDG de Coopérative U, s’en indigne : « S’attaquer à des équipements essentiels à la conservation des produits frais et à l’approvisionnement alimentaire des Français est d’une extrême gravité et est inédit. C’est inacceptable. »
Selon BFMTV, le magasin Leclerc de Wasselone aurait été obligé de jeter l’ensemble de ses produits surgelés et frais, pour une perte estimée à 220 000 euros, donnant une idée de l’ampleur des conséquences.
IDC et Omdia (anciennement Canalys) ont publié leurs chiffres préliminaires pour les ventes d’ordinateurs pour le troisième trimestre. Le moins que l’on puisse dire est qu’ils ne sont pas bons, avec un recul très net sur un an.
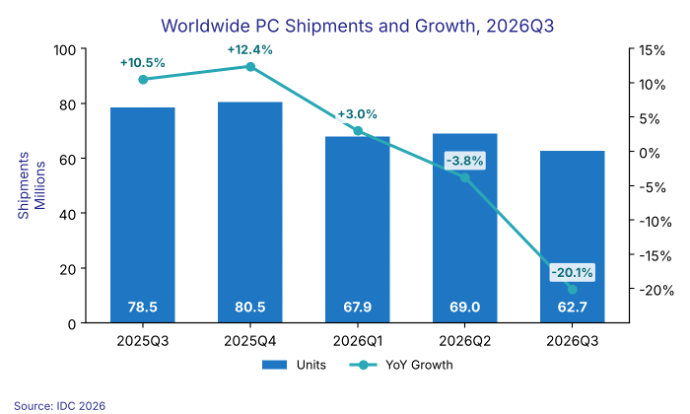
On pouvait le pressentir, IDC et Omdia le confirment. Si les chiffres sont légèrement différents entre les deux cabinets d’analyse, la tendance est peu ou prou la même. Sur le troisième trimestre 2026, les expéditions mondiales ont reculé d’environ 20 % par rapport à 2025. La chute est brutale, mais les constructeurs ne font pas tous grise mine dans les mêmes proportions.
Une chute brutale, mais attendue
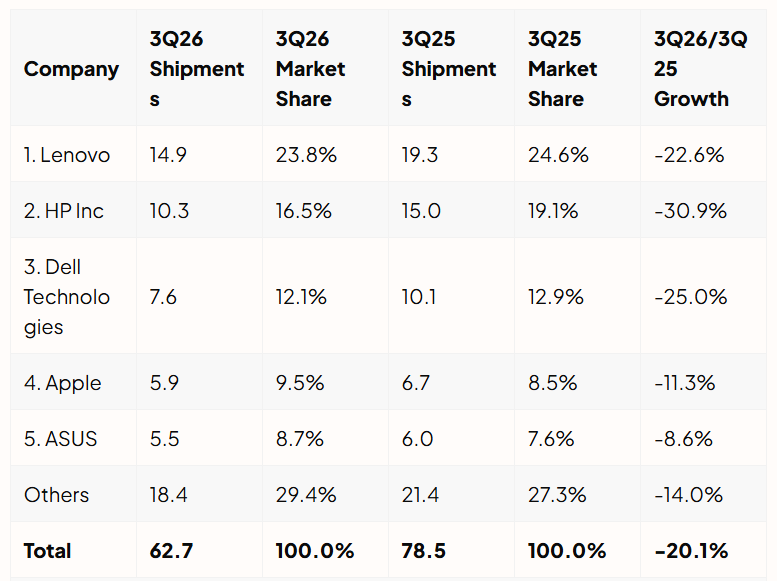
Chez IDC, les expéditions mondiales ont reculé de 20,1 % sur un an, à 62,7 millions d’unités. C’est le deuxième trimestre consécutif de baisse, après −3,8 % au 2ᵉ trimestre. Le recul est aussi de 9,1 % par rapport au trimestre précédent, alors que le 3ᵉ trimestre dépasse habituellement le 2ᵉ.
Source : IDC
Comme on peut le voir dans le tableau fourni par IDC, le recul est général, mais certaines entreprises s’en tirent mieux que d’autres. Lenovo, HP et Dell ont tous reculé plus vite que le marché et cèdent ensemble 4,2 points de part. À eux trois, ils représentent 11,6 des 15,8 millions d’unités perdues, soit environ 73 % de la baisse. Apple et ASUS s’en tirent mieux, mais la claque reste marquée.
Dans la FAQ fournie, IDC répond à l’éléphant dans la pièce : pourquoi les livraisons de PC ont-elles reculé durant un trimestre habituellement plus fort ? Parce que les constructeurs ont tous fait des stocks avant l’inévitable augmentation des prix des composants, menée par celle de la RAM. Pour rappel, les tarifs de la mémoire explosent depuis que les producteurs ont abandonné la DRAM au profit de la HBM dont les datacenters IA sont si friands. Surtout, elle est beaucoup plus onéreuse et beaucoup plus rentable.
IDC estime cependant que les prix vont baisser, bien que « modestement et brièvement », car les stocks restent élevés. Ils pourraient donc donner lieu à des promotions (par exemple pour le Black Friday et les fêtes de fin d’année), mais la demande serait faible, indique le cabinet.
Pour IDC, l’avenir n’est guère lumineux pour cette demande : « La détérioration des conditions macroéconomiques est la principale préoccupation. Une économie plus faible pourrait encore affaiblir la demande, et avec les prix toujours élevés et l’offre limitée, les perspectives pour le reste de 2026 et l’entrée en 2027 pourraient se détériorer ».
Autre source, mêmes constats
Chez Omdia, les chiffres sont légèrement différents mais rejoignent largement ceux d’IDC. En moyenne, le recul est de - 21,2 % sur un an pour le troisième trimestre.
Selon l’un des analystes, Ben Yeh, la part de la DRAM et des SSD est passée de 15 % du coût moyen d’un PC à près de 40 %. « Bien que les fabricants de PC aient augmenté les prix à plusieurs reprises au cours des derniers trimestres, ces hausses n’ont pas encore totalement compensé l’impact. Ces pressions devraient persister, et le déclin actuel pourrait n’être que le début d’un nouveau cycle descendant », ajoute-t-il.
Source : Omdia
Pour Omdia, la baisse va donc se poursuivre et devrait atteindre - 24 % sur le quatrième trimestre en glissement annuel, d’ordinaire porté par les fêtes de fin d’année. Point intéressant en revanche : même en tenant compte des baisses franches dans les volumes expédiés, le classement des constructeurs n’a guère changé.
Lenovo reste ainsi en tête avec 25,7 % de parts de marché, suivi par HP et Dell, avec respectivement 17,8 et 13,1 %, même si tous ces chiffres ont baissé d’une année sur l’autre. Pour Apple et ASUS, l’histoire est légèrement différente. Non seulement la baisse de leurs volumes est moins prononcée, mais ces deux entreprises ont grapillé des parts de marché, Apple passant notamment de 10,4 à 11,7 % des volumes écoulés sur un an. Pour Omdia, l’entreprise de Cupertino a été sauvée par son profil premium, mais le MacBook Neo pourrait avoir joué un rôle, tant son tarif lui a permis de se vendre comme des petits pains. Le maintien d’ASUS n’est en revanche pas expliqué.
Dans l’ensemble, ce décrochage était annoncé. IDC prévoyait déjà −11,3 % sur l’année 2026, avec un marché en valeur en hausse de 1,6 % à 274 milliards de dollars grâce à la hausse des prix. En juin dernier, IDC avait pronostiqué une chute de 20 % au 4ᵉ trimestre et une pénurie de mémoire durant jusqu’à fin 2027. La baisse de 20 % arrive donc un trimestre plus tôt que prévu.
Si d’autres cabinets comme Gartner et Counterpoint n’ont pas encore publié leurs chiffres, il est probable qu’ils n’aient pas de nouvelles plus joyeuses à annoncer. Les projections d’IDC et Omdia vont en effet dans le même sens : le marché ne va pas se réveiller de sitôt, et il faudra attendre une détente sur le marché de la DRAM, qui pourrait ne pas arriver avant plusieurs années. D’ici là, plusieurs marchés auront peut-être été remodelés.
En février 2026, Microsoft ouvrait un nouveau dépôt GitHub avec un drôle de projet open source : LiteBox. Sa description est complexe : il s’agit d’un « système d’exploitation bibliothèque » (library OS) dont la mission est de réduire la surface d’attaque d’un système d’exploitation en concentrant les appels lancés par les applications.
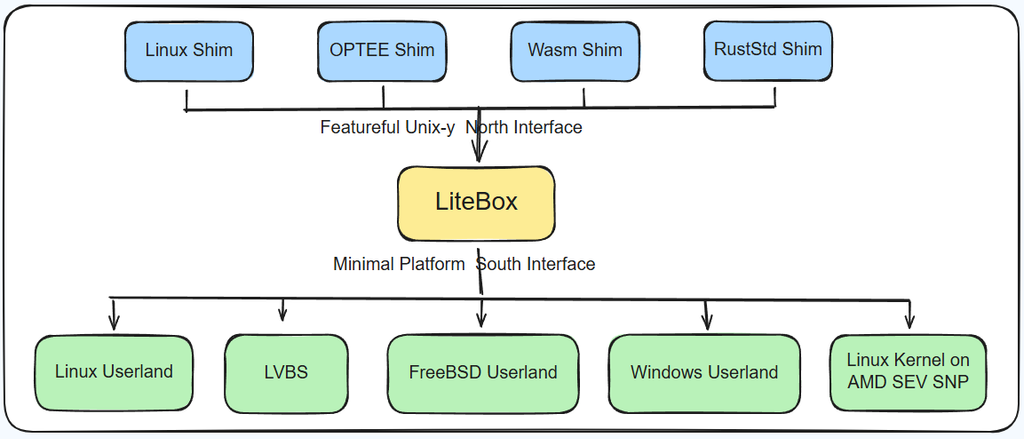
Dit plus simplement, LiteBox est une porte d’accès contrôlée. Au lieu de laisser un programme parler directement au noyau de la machine hôte via des centaines d’appels système, on lui fournit, sous forme de bibliothèque, une couche jouant le rôle du système d’exploitation et qui ne demande à l’hôte qu’un jeu très restreint de services. Moins il y a de points de contact avec l’hôte, plus la surface d’attaque est réduite.
Source : Microsoft
L’architecture repose sur deux interfaces, nommées « Nord » et « Sud ». Au Nord, côté programme, LiteBox expose une interface inspirée des bibliothèques Rust nix et rustix, sur laquelle se branchent une ou plusieurs couches d’adaptation. Par exemple, une couche imitant Linux. Au Sud, côté hôte, LiteBox attend une interface Platform qui fournit les services de base. On peut combiner n’importe quelle couche Nord avec n’importe quelle plateforme Sud, le tout devant fonctionner aussi bien en mode utilisateur qu’en mode noyau.
Selon Microsoft, LiteBox permettrait ainsi d’exécuter des programmes Linux sur Windows, de cloisonner des applications Linux sur Linux, d’exécuter des applications sur SEV-SNP (machines virtuelles confidentielles AMD), ou encore de fonctionner sur LVBS (Linux Virtualization Based Security), un équivalent Linux au VBS de Windows, également conçu par Microsoft.
Si l’on en reparle aujourd’hui, c’est que LiteBox a désormais une version 0.1. Elle n’est pas directement exploitable en l’état : ce n’est pas une couche que l’on peut appliquer telle quelle sur n’importe quel système. Le code (sous licence MIT) est fourni pour que les développeurs puissent s’y pencher et voir son fonctionnement. Microsoft prévient que le projet est en évolution active et que des modifications introduites plus tard pourraient casser la compatibilité, les API étant en plein chantier.

 Connexion