Mark Zuckerberg profiterait de la caisse de résonance de Meta Connect, qui se tiendra du 23 au 24 septembre, pour dévoiler de nouvelles lunettes connectées, croit savoir le site The Information, généralement bien renseigné. Connues en interne sous le sobriquet Luna, ces montures se contenteraient de six microphones et de haut-parleurs dans les branches. Exit donc le capteur photo, un composant qui confère aux modèles actuels leur charmant surnom de « pervert glasses » (« lunettes pour pervers »).
Les témoignages de personnes harcelées (souvent des filles et des femmes) par des porteurs sans gêne de ces lunettes se sont multipliés ces derniers mois. À cela s’ajoutent les restrictions qui pleuvent dans les lieux publics et lors d’événements. Une grogne qui pousse la Norvège à s’interroger sur une possible interdiction de certaines fonctions – comme l’enregistrement vidéo – dans l’espace public.
Pour Meta, commercialiser des lunettes toujours connectées mais sans caméra permettrait de contourner le discours actuel très hostile, tout en continuant à promouvoir les capacités de Meta AI et du nouvel agent Muse. L’absence de ce capteur devrait rendre l’utilisation de ces lunettes plus discrète, ce d’autant que leur design serait plus proche de montures standards.
Deux modèles seraient présentés, avec une commercialisation prévue pour le mois d’octobre. Meta aurait d’autres lunettes connectées à dévoiler, mais cette fois à l’autre bout du spectre technologique : il s’agirait d’un dispositif de réalité augmentée (« Phœnix » en interne), pas très éloigné du projet Orion annoncé en septembre 2024.
Ces lunettes, présentées comme un outil de productivité et de divertissement, auraient la capacité d’afficher l’écran de son PC dans un écran virtuel et de regarder des films. Un boîtier externe accompagnerait toujours la monture pour l’alimentation et la prise en charge des calculs nécessaires. Les premières unités « Phœnix » sortiraient l’année prochaine.
Enfin, Meta plancherait sur une fonction qui, lors d’un appel, afficherait l’« hologramme » d’un correspondant devant l’utilisateur de ces lunettes. Il s’agirait d’un avatar photoréaliste de la personne, et contrairement aux Persona du Vision Pro d’Apple coupés au niveau des épaules, ces hologrammes seraient « complets » (comprendre : l’intégralité du corps).
La division Reality Labs, qui développe les technologies du métavers (mourant) et AR de Meta, plancherait depuis plus de dix ans sur cette technologie baptisée « Codec Avatars ».
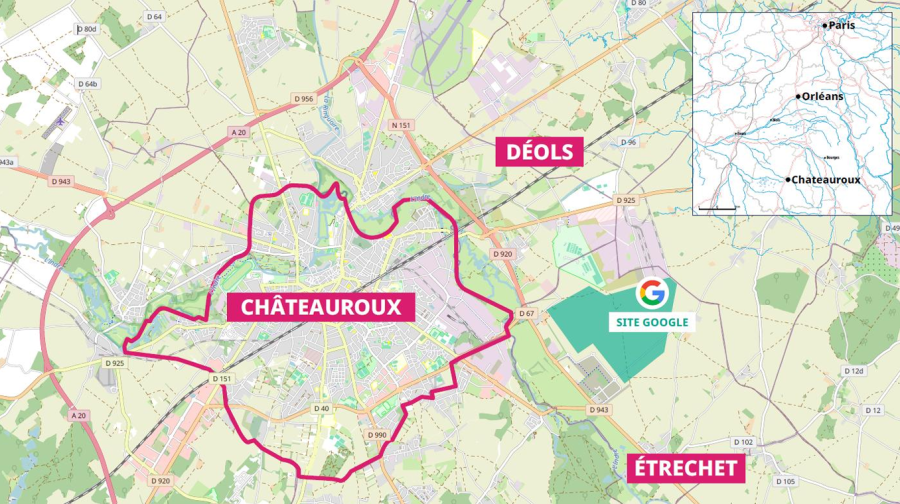
En quelques jours, la maire, trois adjoints et une conseillère municipale ont démissionné de leurs fonctions politiques à la mairie d’Étrechet. En cause : des désaccords sur un projet de centre de données Google, porté par l’agglomération de la ville voisine de Châteauroux.
Après les adjoints, voilà que la maire démissionne. Ce 15 septembre, Florence Laurent a indiqué dans un communiqué quitter ses fonctions à la commune d’Étrechet, dans l’Indre.
Sa décision fait suite à une première démission collective. Dans une lettre du 10 septembre 2026, Bruno Deterne, Marie-Pierre Chabenat-Canals, Christian Jubard (adjoints au maire) et Sylvie Gessier, conseillère municipale, indiquaient avoir pris la décision « conjointe et mûrie » de démissionner collectivement de leurs mandats au sein de la commune.
La cause de ces départs en cascade ? Un projet de centre de données « hors-norme qui échappe totalement à toute capacité de décision de la commune, tout en faisant peser des risques cumulés lourds sur notre territoire (ressource en eau, tensions sur le réseau électrique, nuisances, opacité des calendriers administratifs) », pour reprendre les mots de ces derniers. La maire, elle, évoque « un désaccord sur la prise en compte des avis sur le projet Google sur notre territoire ».
En juin 2025, le conseil communautaire de la métropole de Châteauroux avait en effet voté la vente d’une parcelle de 195 hectares, sur la zone d’activité d’Ozans, à la filiale de Google Tricolore Computing. Cette dernière doit y construire un centre de données de huit à dix bâtiments en deux phases, d’après les informations de la Commission nationale du débat public (CNDP).
La première, qui s’étendrait de 2028 à 2029, prévoit la « mise en service du premier bâtiment de data-center et d’un raccordement au réseau 225 000 Volts par RTE ». La seconde, à partir de 2031, doit permettre la « mise en service progressive de 7 à 9 bâtiments de data-centers supplémentaires et d’un raccordement électrique par RTE ».
Localisation du projet de centre de données. / CNDP
En avril, la CNDP a estimé nécessaire une concertation préalable, concertation qui doit être organisée par Google France, Tricolore Computing et Violet Computing, les maîtres d’ouvrage du projet, et RTE, en charge du raccordement électrique. En parallèle, diverses entités organisent leurs propres débats, dont Les Écologistes avant l’été, ou l’association Indre Nature, qui s’émeuvait début septembre du manque d’informations relatives à la concertation. Next a sollicité la CNDP sur le sujet mais n’avait pas reçu de réponse à l’heure de publier ces lignes.
Sur le territoire, les contestations s’organisent depuis plusieurs mois, notamment sous les efforts du collectif citoyens Ozans dire non. Les démissions, elles, ont suivi des échanges à l’échelle intercommunale. Le 9 septembre, le maire de Châteauroux et président de Châteauroux Métropole Gil Avérous présentait des travaux relatifs au centre de données au conseil municipal d’Étrechet, rapporte La Nouvelle République. Le lendemain, plusieurs élus démissionnaient.
Manque de manœuvres des collectivités
Ce 15 septembre, la maire Florence Laurent les a suivis, indiquant dans un communiqué être « arrivée à la conclusion que différents éléments de ce projet méritaient un engagement précis de la part des porteurs de projets : nuisances visuelles, PFAS, dévalorisation des habitations, trafic routier ».
S’il la remercie pour son implication dans les projets portés par l’agglomération de Châteauroux, Gil Avérous souligne, lui aussi par voie de communiqué, que « les projets envisagés sur Ozans ont pourtant toujours reçu l’approbation de la commune d’Etrechet et de toutes les autres communes de l’agglomération à chaque fois qu’ils ont été débattus en conférence des Maires et en conseil communautaire ».
Auprès de France 3, il soulignait que même le monde agricole ne s’opposait pas frontalement au projet. Le vice-président écologiste de la Région Centre-Val de Loire, Jérémie Godet, s’inquiétait pour sa part des îlots de chaleur que pourraient provoquer les centres de données, ainsi que du recours à des liquides de refroidissement émetteurs de polluants éternels et de gaz à effet de serre.
Le manque de latitude de certaines collectivités dans la gestion des projets de centres de données n’est pas un sujet spécifique à Étrechet. À Paris-Saclay, des membres de la communauté d’agglomération s’inquiètent ainsi du manque d’outils de pilotage de ces arrivées, et des risques que cela fait peser sur le réseau électrique. Quant aux possibilités de débat, quand bien même encadrées par la CNDP, la chercheuse Ophélie Coelho regrettait par exemple de les voir organisées « après la prise de décision », c’est-à-dire plus pour relever des inquiétudes que pour orienter les projets.
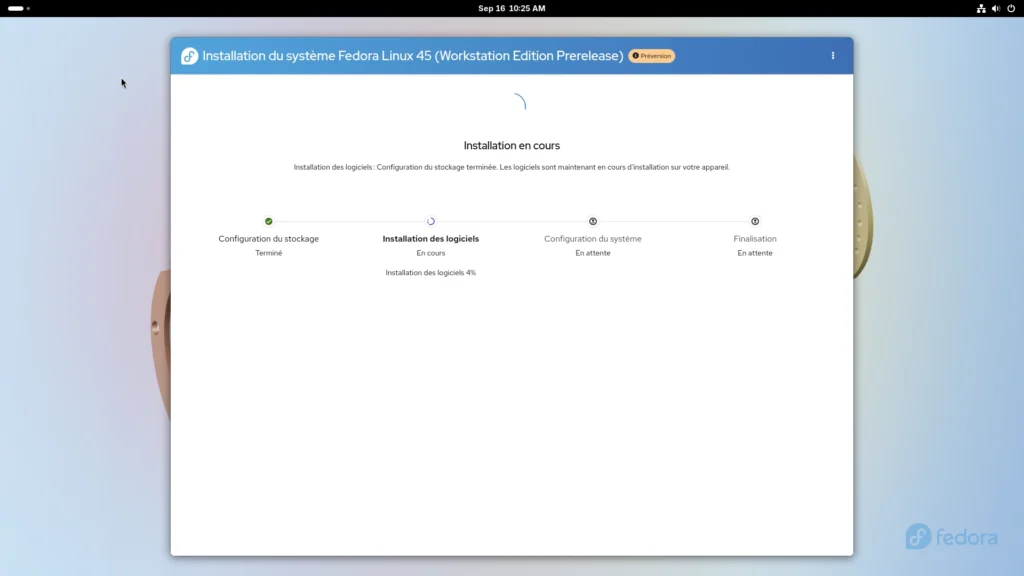
Fedora 45 vient d’entrer dans sa phase bêta. Les nouveautés sont assez nombreuses, notamment sur la sécurité et les paquets reproductibles.
Fedora est le laboratoire à ciel ouvert de Red Hat. La distribution est connue pour être pionnière dans ses choix technologiques, comme le choix du serveur d’affichage Wayland par défaut dès la version 25, longtemps avant les autres distributions (et les bugs de jeunesse qui allaient avec).
Comme Ubuntu, Fedora dispose d’un rythme biannuel, au printemps et à l’automne. La nouvelle mouture 45 est ainsi prévue pour le 20 octobre, ou le 27 en cas de problème. Maintenant que la bêta est disponible, on peut observer ses nouveautés, parmi lesquelles une hausse manifeste du niveau de sécurité.
Toutes les variantes du système peuvent être téléchargées (images ISO) depuis le site officiel. Sur la page de téléchargement, il faut penser à activer le sélecteur d’affichage pour la bêta. Depuis l’annonce officielle, les différents liens pointent tous directement vers les versions 45.
Composants de base
La bêta de Fedora 45 est livrée avec le noyau Linux 7.2, la dernière révision stable (sortie le 16 aout). Parmi les nouveautés de ce dernier, le Cache Aware Scheduling permet à l’équilibrage de charge de tenir compte du cache de dernier niveau au sein des processeurs. Phoronix, connu pour ses tests de performances, indiquait en outre que le noyau 7.2 introduisait des gains mesurables de performances pour les processeurs AMD et Intel. Entre autres nouveautés, on trouve une première prise en charge du HDMI 2.1 FRL dans le pilote AMDGPU, le support du protocole USB4STREAM d’Intel ou diverses prises en charge dans KVM de fonctions de sécurité propres à AMD et Intel.
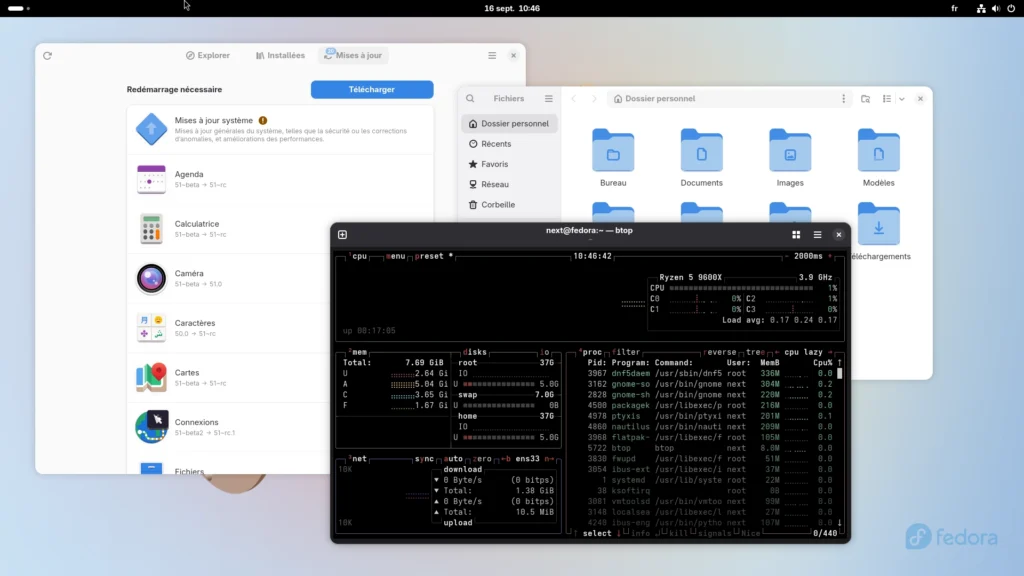
Comme toujours avec Fedora, la version proposée par défaut pour les PC, Workstation, est fournie avec GNOME, qui passe pour l’occasion en version 51. Cette mouture n’est pas finalisée, même si les composants en bêta sont remplacés par leurs équivalents RC (Release Candidate) après l’installation de Fedora 45. GNOME 51 inaugure des curseurs au format SVG (déjà présents dans KDE), une nouvelle interface de gestion des empreintes digitales, le support de la connexion distante multi-utilisateurs via Kerberos, de nouveaux réglages pour le pavé tactile, de meilleures performances pour Agenda ou encore le nettoyage du code auparavant lié aux anciens pilotes NVIDIA. Pour les personnes n’appréciant pas GNOME, KDE Plasma 6.7 est disponible dans une version dédiée.
Côté développement, la chaîne GNU passe à GCC 16.2, binutils 2.47, glibc 2.44 et gdb 17.2. S’y ajoutent LLVM 23 pour l’ensemble des sous-projets, Go 1.27, Python 3.15, Perl 5.44 et Lua 5.5. Dans les notes de version de la distribution, on peut lire que plusieurs changements cassent la compatibilité. Par exemple, Setuptools 82 supprime le module pkg_resources. Pandas passe de la 2.3 à la 3.0, avec une gestion des chaînes revue, un comportement copie-sur-écriture cohérent et la suppression de fonctionnalités dépréciées depuis longtemps. Même chose avec libxml2, dont le passage de la 2.13.9 à la 2.15.3 s’est accompagné d’un changement d’ABI, imposant une recompilation de masse avec dépréciation des liaisons Python.
Parmi les autres changements, Podman 6 est une des mises à jour les plus lourdes de conséquences. Elle « inclut des changements importants de rupture de l’API et de la ligne de commande, de nouvelles fonctionnalités, ainsi que la suppression finale de composants obsolètes tels que slirp4netns, cgroups v1 et le backend BoltDB », prévient Fedora. Citons également le passage de MySQL de la version 8.4 à 9.7, et celui de MariaDB de la version 11.8 à la 12.3. NetworkManager prend en charge par défaut les réseaux « IPv6-mostly ».
Sécurité : plusieurs serrages de vis
Plusieurs changements importants sont présents dans Fedora 45. D’abord, l’équipe indique avoir franchi la barre des 90 % de paquets reproductibles.
Pour comprendre l’intérêt, rappelons qu’un paquet est dit « reproductible » si, à partir du même code source, du même environnement de compilation et des mêmes instructions, n’importe qui peut régénérer une copie identique bit à bit du paquet publié. En clair, il s’agit d’un gage de sécurité de la chaine d’approvisionnement : c’est la garantie que le binaire téléchargé correspond bien au code source publié. Dans le cas de Fedora, toute non-reproductibilité détectée est considérée comme un bug et est traitée comme telle, via un rapport. La distribution n’est pas la seule à progresser dans ce domaine, d’autres comme Arch Linux ou NixOS font de même.
On reste dans le sujet avec la vérification désormais obligatoire des signatures par le gestionnaire de paquets RPM. Un mode de vérification stricte, conformément au comportement en amont introduit par la version 6.0, comme nous l’indiquions il y a un an. Ainsi, seuls les paquets dont la signature est vérifiée peuvent être installés, sauf dérogation explicite avec --nosignature ou l’API correspondante. Les RPM compilés localement et non signés sont directement concernés. Côté Fedora, ce changement se fait dans la foulée du passage à RPM 6.1.
Fedora 45 restreint également ptrace par réglage global dans le noyau qui retire par défaut certaines permissions de débogage aux utilisateurs non privilégiés. L’objectif est d’empêcher un logiciel malveillant d’inspecter les autres processus du même utilisateur. En revanche, si des outils de débogage sont installés, un fichier sysctl rétablit le comportement classique de Fedora 44 et des versions précédentes.
Autre changement significatif, le changement de fournisseur par défaut du service Secret. On passe ainsi de KWallet et GNOME Keyring à oo7. Écrit en Rust, il implémente la même interface D-Bus org.freedesktop.secrets, et se veut une alternative légère utilisable sur tous les environnements. Il est développé dans le cadre du projet linux-credentials et sert déjà de service de secrets natif pour COSMIC Desktop. D’après la fiche Fedora, oo7 doit permettre un modèle d’autorisation limitée par application ou par service, ouvrir la voie à l’authentification FIDO2 et mieux encadrer l’accès des applications isolées aux secrets.
On trouve d’autres modifications liées à la sécurité, comme l’interdiction par DNF5 de changer de fournisseur par défaut. Un changement important, car à moins d’une manipulation spécifique, un paquet installé ne peut donc plus être remplacé automatiquement par celui d’un autre fournisseur. Signalons aussi que chpasswd et newusers passent désormais par PAM et appliquent donc les politiques de mots de passe du système.
Malgré un modèle économique surtout tourné vers les entreprises et le B2B, Mistral ne dédaigne pas à l’occasion s’intéresser au grand public. Le partenariat avec Mozilla permet aux modèles IA de l’entreprise française de se frotter aux questions posées par les internautes dans la Fenêtre intelligente de Firefox.
Mozilla a inauguré la Smart Windows (ou Fenêtre intelligente) dans la version 155 de Firefox. Ce mode combine un chatbot et un ensemble de fonctionnalités IA qui se propose d’organiser ses onglets et son historique et de répondre aux questions. Toujours en bêta, la Fenêtre intelligente s’active via le bouton Firefox en haut à droite de la fenêtre du navigateur.
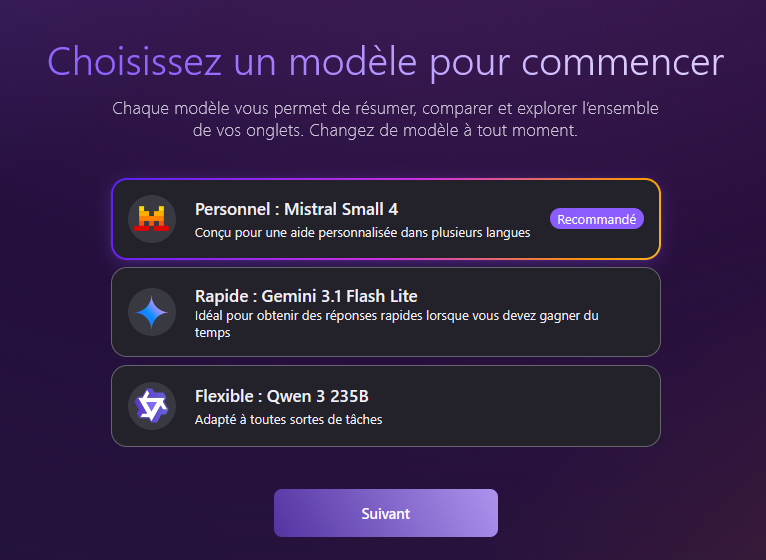
Firefox laisse le choix du modèle : on trouve dans le lot Gemini 3.1 Flash Lite, Qwen 3, et Mistral Small 4 qui est le modèle recommandé (il est possible d’ajouter d’autres modèles en fournissant une clé API ou un jeton d’authentification). Mozilla et Mistral ont officialisé ce partenariat, qui « réunit deux défenseurs de l’open source [œuvrant] ensemble pour mettre les innovations scientifiques de Mistral à la portée des consommateurs du monde entier », selon le communiqué.
La sélection du modèle IA dans la Fenêtre intelligente de Firefox. Capture d’écran : Next
« Puisque le navigateur est au cœur du Web et de l’expérience en ligne, il doit être un espace où différents fournisseurs d’IA peuvent se faire concurrence et où l’open source a toute sa place », affirme Anthony Enzor-DeMeo, directeur général de Mozilla Corporation. Le navigateur « doit préserver ce qui a fait la puissance d’Internet dès le départ : la liberté d’explorer, de découvrir différentes idées et technologies, et de décider par nous-mêmes où aller ensuite. »
Les modèles Mistral sont proposés en France, aux États-Unis et au Canada. Le Royaume-Uni et l’Allemagne vont suivre d’ici la fin de l’année. « À l’heure actuelle, nous comptons en moyenne environ 200 millions d’utilisateurs mensuels dans le monde, plus de 50 millions d’utilisateurs quotidiens sur ordinateur et entre 14 et 16 millions sur mobile », précise le dirigeant de Mozilla, qui ajoute au Wall Street Journal que « les États-Unis, l’Allemagne, la France et le Royaume-Uni en représentent l’essentiel ».
Pour Mistral, c’est aussi une manière d’exposer ses modèles à une utilisation orientée grand public alors que l’entreprise vise habituellement les entreprises. Pas plus tard que ce mardi 15 septembre, Mistral annonçait deux partenariats B2B : le premier avec TotalEnergies pour développer des modèles IA dédiés à l’exploration et à l’ingénierie des réservoirs, le second avec Numspot pour le développement d’une place de marché dédiée aux organisations publiques et aux entreprises. Celle-ci combinera les modèles Mistral avec l’infrastructure cloud de la plateforme.
Plusieurs utilisateurs d’iPhone ont remarqué qu’après avoir installé iOS 27, leur téléphone contournait les solutions domestiques de blocages de publicités basées sur le DNS telles que Pi-hole ou AdGuard.
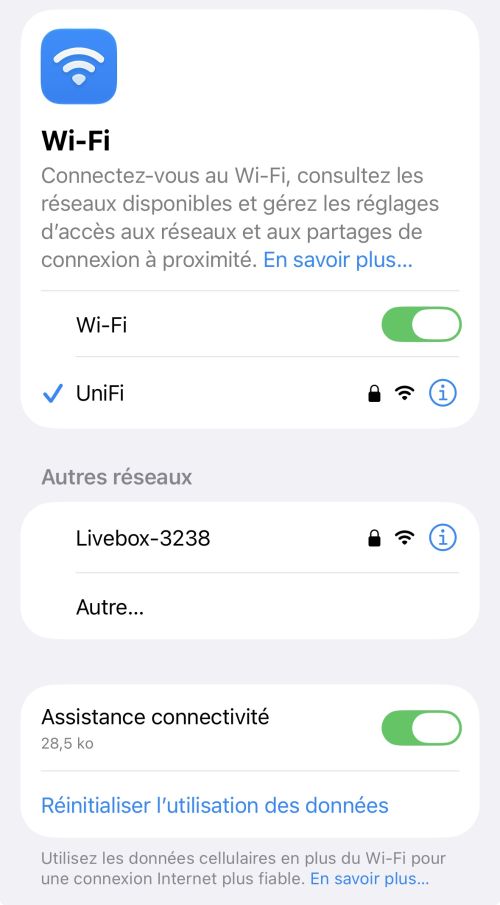
Un rapide tour dans les réglages dans l’appareil a permis d’identifier la source du problème. De façon empirique, elle semble liée à la fonction Assistance connectivité (Connectivity Assist) proposée par iOS au niveau des paramètres de la connexion Wi-Fi. Désactiver cette dernière rétablit le blocage des publicités, comme en témoignent plusieurs utilisateurs de Reddit.
Une fiche du support Apple datée du 15 septembre confirme que le phénomène est lié à l’Assistance connectivité. « Si vous souhaitez rester connecté en permanence au Wi-Fi pour une configuration de routeur spécifique (par exemple, votre bloqueur de publicités), vous pouvez désactiver l’assistance à la connectivité pour ce réseau particulier. », indique explicitement cette dernière.
La fonction Assistance connectivité, désormais logée dans le menu Wi-Fi des réglages, permet à iOS de basculer automatiquement vers la connexion cellulaire de l’appareil lorsque le réseau sans fil local est trop lent. Quand elle est activée, le système interprète le blocage des contenus publicitaires comme une défaillance du Wi-Fi, et va donc emprunter le réseau cellulaire pour appeler les données correspondantes.
Cette fonctionnalité n’est pas apparue avec iOS 27. Jusqu’à iOS 27, cette fonctionnalité était intégrée au menu Données cellulaires des réglages, sous le nom Assistant Wi-Fi. Le problème vient en réalité d’un changement de paramétrage lors de la mise à jour, qui avait d’ailleurs déjà été constaté par certains utilisateurs des versions bêta d’iOS 27.
Nous l’avons expérimenté directement mercredi matin en mettant à jour un iPhone de iOS 26.6 vers iOS 27. La fonction Assistant Wi-Fi, désactivée avant la mise à jour, était effectivement activée une fois la migration achevée.
Bref, si vous utilisez Pi-hole, AdGuard ou une solution équivalente avec un iPhone, contrôlez simplement les réglages de votre Wi-Fi.
Réglage de l’Assistance connectivité d’iOS 27 – capture d’écran Next
Le constructeur LG est dans une mauvaise passe dans le domaine de la vie privée. Ses écrans PC et téléviseurs OLED ont été accusés cet été de comportements peu vertueux. LG se défend désormais, affirmant que cette polémique n’a pas de raison d’être. Gamers Nexus, qui avait révélé les deux affaires, n’est pas d’accord.
La chaine Gamers Nexus, sur YouTube, a publié le 7 septembre une vidéo dans laquelle elle relate ses découvertes sur plusieurs écrans OLED de chez LG. Des failles de sécurité ont été découvertes et plusieurs comportements troublants ont été pointés du doigt.
LG avait répondu peu après, indiquant que certaines fonctions, notamment la reconnaissance vocale, nécessitaient une activation et un consentement de l’utilisateur. Devant l’ampleur de la polémique, l’entreprise a cependant fini par publier un communiqué plus détaillé le 12 septembre.
Selon LG, tout va bien
Dans son texte, le constructeur n’y va pas par quatre chemins : « Les affirmations formulées dans la vidéo récemment publiée sont fausses ».
Il assure que ses téléviseurs n’enregistrent ni ne transmettent les conversations en continu. De même, la détection du mot de réveil est faite localement, les données audio étant immédiatement supprimées si aucun mot de réveil n’est reconnu. LG précise qu’une session de reconnaissance vocale dure 18 secondes au maximum.
En outre, il affirme que les données ne sont pas stockées localement pour être envoyées dès que la connexion revient, contredisant directement les propos de Gamers Nexus. L’entreprise le redit : rien ne se produit si on n’appuie pas sur le bouton dédié sur la télécommande et si l’on n’a pas activé l’option idoine dans les paramètres, désactivée par défaut.
Le constructeur évoque également la question de la reconnaissance automatique de contenus (ACR). LG indique que cette technologie se sert d’empreintes numériques audio en passant par le processeur audio du téléviseur pour identifier le contenu. Il « ne collecte pas de captures d’écran, d’enregistrements d’écran, d’enregistrements vidéo, d’enregistrements vocaux ou d’autres enregistrements audio provenant de la télévision ». Et de rappeler que là aussi, un consentement est demandé. S’il est donné, « les informations liées à l’ACR peuvent être utilisées pour la segmentation de l’audience et l’analyse des tendances ou de visionnage ».
LG ajoute : « La publicité basée sur les intérêts et la publicité inter-appareils nécessitent un consentement utilisateur distinct via les accords publicitaires applicables ».
L’entreprise affirme que la « protection de la vie privée des utilisateurs est un principe fondamental dans la conception et le fonctionnement des produits et services LG ». Elle insiste sur ses quatre principes en matière de vie privée : transparence, choix de l’utilisateur, consentement éclairé et amélioration continue. « L’approche de LG est guidée par les principes de la Privacy by Design », assure le constructeur.
Gamers Nexus : « Vraiment ? »
La chaine, qui a déjà longuement plongé dans les entrailles matérielles de ces produits, n’a pas apprécié la réponse de LG. Steve Burke, qui présente la chaîne, estime que le constructeur ne répond pas à tous les problèmes signalés, ne fournit aucune preuve de ce qui est avancé et ne tient plus tout à fait le même discours.
Dans une nouvelle vidéo, il note ainsi les modifications dans la forme des phrases, entre la première réponse d’il y a plusieurs semaines – quand le sujet avait débuté – et celle du 12 septembre. Il y a un mois, LG indiquait par exemple : « [nos téléviseurs] ne collectent pas, n’enregistrent pas et ne stockent pas les conversations ambiantes ». Dans le récent communiqué, la phrase est devenue : « Nous veillons à ce que votre téléviseur LG ne collecte, n’enregistre pas ou ne transmette pas de conversations ambiantes ». Il n’est plus question de stockage, mais de transmission. De même, la condition « sauf si la fonction verbale a été intentionnellement activée » a été ajoutée.
Gamers Nexus relève en outre un comportement qu’elle considère comme un catalogue de « dark patterns », c’est-à-dire des schémas trompeurs pour amener les utilisateurs à des actions qu’ils n’auraient pas acceptées sinon. Selon la chaîne, c’est le cas plusieurs fois dans le recueil du consentement, l’interface réclamant trop d’autorisations, dont plusieurs sont en plus cochées par défaut.
Autre point relevé : LG affirme que sans consentement les données ACR ne sont pas utilisées à des fins publicitaires. Toutefois, le constructeur ne dit ni qu’elles ne sont pas collectées, ni qu’elles ne sont pas utilisées pour d’autres objectifs. Gamers Nexus indique que les termes du communiqué ont été analysés par un avocat, Vincent Agosta, lui aussi présent dans la vidéo.
La chaine s’en prend aussi à la déclaration selon laquelle la reconnaissance vocale ne démarre que quand le ou les mots-clés sont prononcés, requérant d’activer une option dans les paramètres. Selon Gamers Nexus, c’est techniquement faux : les failles trouvées peuvent être exploitées pour changer ce réglage, tout dépend de qui a la maitrise du matériel. Avec un accès « root », il est possible de modifier les options, voire les mots-clés d’activation.
Dans sa vidéo de plus de trois quarts d’heure, Gamers Nexus redonne la liste des éléments reprochés à LG. La chaine met au défi le constructeur de lui prouver qu’elle a tort, pointant les 70 000 employés de l’entreprise. Steve Burke indique d’ailleurs qu’une deuxième partie est en préparation, avec d’autres découvertes, toujours liées à la vie privée. Il fustige LG pour avoir redit, dans son communiqué, que la sécurité était une priorité, alors que le constructeur n’a – selon lui – pas répondu à ses signalements dans ce domaine.
Une création agressive d’empreintes numériques
La vidéo évoque une partie de ces nouvelles découvertes. Steve Burke cite les travaux d’un chercheur en cybersécurité, nommé uturn, qui avait déjà participé à la première vidéo. Selon le chercheur, qui a utilisé du matériel pour se poser en « homme du milieu », les tests montrent une capture « agressive » d’informations sur la liaison HDMI, dont les données audio qui servent à la création de l’empreinte numérique.
Dans cette configuration, le téléviseur associait dans la même télémétrie la localisation de l’appareil, des identifiants de la source HDMI récupérés (via les canaux d’informations auxiliaires SPD et CEC), ainsi que l’horodatage couvert par chaque empreinte. Les tests ont révélé un débit de 20 paquets par minute vers un serveur d’Alphonso (LG Ad Solutions, la filiale du groupe dédiée à la publicité), par salves de cinq messages espacés d’environ une seconde, avec une dizaine de secondes entre les salves, et uniquement lorsque de l’audio était effectivement joué.
Dans ces paquets, on trouve un identifiant d’appareil, une clé de correspondance pour la géolocalisation, la ville et l’État, la latitude et la longitude, le nom de la voie principale la plus proche, le fuseau horaire et le code postal. Pour trouver l’emplacement géographique, le système utilise la puissance de signal d’un réseau Wi-Fi voisin. Ce qui peut expliquer les découvertes faites dans la première partie sur le comportement réseau très actif, les téléviseurs testés analysant tout ce qui est détecté. Dans une partie des tests, la précision relevée était d’environ 8 km, mais Gamers Nexus estime qu’elle peut être améliorée par le couple BSSID (Basic Service Set Identifier)+ puissance de signal. Dans les téléviseurs LG, comme pour de nombreux autres modèles, ces informations circulent via ACR.
Entre deux chaises
La chaine précise que ces résultats ont été obtenus sur un appareil d’origine, non modifié et sans exploitation de vulnérabilité. En outre, comme souligné par Tech Radar, ces travaux recoupent ceux d’Anna Maria Mandalari publiés dès 2024 sur les communications du système ACR. Professeure à l’University College de Londres (UCL), elle avait montré que les empreintes étaient calculées sur la base de tout ce qui transitait par le HDMI, même quand le téléviseur était utilisé comme relais depuis une autre source, comme un ordinateur. Interrogée par nos confrères, elle estime elle aussi que la récente réponse de LG ne répond pas à « l’ensemble du tableau » sur les questions de vie privée.
Pour Lillian Edwards, professeure en droit, innovation et société, la plupart des utilisateurs veulent simplement pouvoir se servir rapidement de l’appareil et ne prêtent plus attention à ce qu’ils acceptent. Elle estime que les méthodes utilisées dans les téléviseurs LG pourraient ne pas être compatibles avec le RGPD, qui exige un consentement explicite et éclairé. Ses propos appuient en filigrane les accusations de « dark patterns » lancées par Gamers Nexus.
Enfin, Cobun Zweifel-Keegan, l’un des directeurs de l’IAPP (International Association of Privacy Professionals), relève que la réponse de LG est « cohérente avec les pratiques de l’industrie ». En revanche, « la réponse se concentre sur ses capteurs et ses pratiques de collecte de données, sans aborder les allégations de publicité et de profilage utilisateur qui constituent une grande partie du rapport Gamers Nexus ». LG pourrait ainsi se retrouver dans une situation délicate, forcée par la pression médiatique à s’exprimer, sans jeter l’opprobre sur un lot de pratiques commun à de nombreux constructeurs.
Les modèles IA à poids ouverts peuvent tenir tête aux modèles propriétaires. Ce qui n’est pas sans provoquer des frictions géopolitiques, avec d’un côté les champions américains des modèles fermés, de l’autre les spécialistes chinois des modèles ouverts. Ce qui est en jeu n’est plus seulement la performance, c’est aussi le contrôle de l’infrastructure.
Mozilla a publié son nouveau rapport « State of Open Source AI », qui agrège une série de benchmarks, d’études externes et un sondage SlashData auprès de 1 410 développeurs utilisant ou ayant utilisé des modèles ouverts. Le document est riche (PDF) et donne une bonne idée des tendances et des forces en présence.
Les modèles ouverts collent au peloton de tête
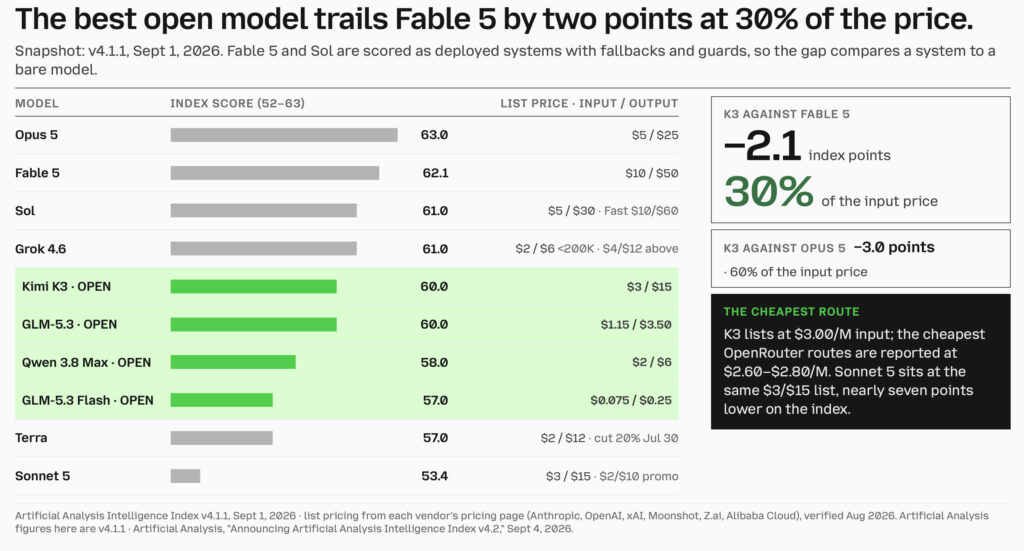
Les modèles à poids ouverts ont quasiment rattrapé leurs concurrents propriétaires en termes de performances. Selon l’indice Artificial Analysis Intelligence, les quatre modèles les plus performants sont propriétaires et américains : Claude Opus 5 et Fable 5, GPT-5.6 Sol et Grok 4.6 se tiennent dans un mouchoir de poche avec des scores compris entre 61 et 63. Mais immédiatement derrière, on trouve quatre modèles ouverts, tous chinois : Kimi K3, GLM-5.3 (z.ai), Qwen3.8 2,4T et GLM-5.3 Flash, avec des résultants oscillant entre 57 et 60.
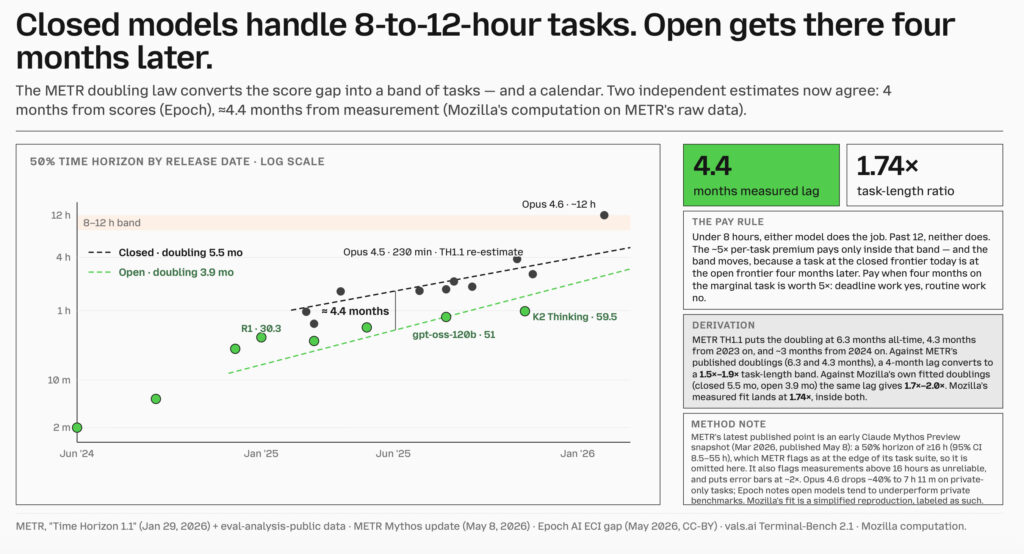
L’écart entre les modèles ouverts et propriétaires est donc faible, et il se réduit rapidement. Les meilleurs modèles fermés peuvent aujourd’hui accomplir des tâches longues d’environ 8 à 12 heures ; les meilleurs modèles ouverts arrivent au même niveau environ quatre mois après, selon des études METR et Epoch reprises par Mozilla.
Plus précisément, les deux types de modèles accompliront le travail demandé s’il doit être réalisé sous les 8 heures. Entre 8 et 12 heures, les modèles fermés gardent un avantage. Au-delà de 12 heures, même les modèles fermés ne sont pas tous fiables.
Autrement dit, pour les tâches courantes, les modèles ouverts se révèlent largement suffisants. Utiliser un modèle propriétaire peut se justifier en fonction de l’urgence ou de la difficulté de la tâche, mais la fenêtre se rétrécit.
Le plus intéressant réside toutefois dans le rapport performances/prix. Les quatre modèles ouverts se révèlent moins onéreux (à l’exception de Grok 4.6, mais uniquement pour les 200 000 premiers tokens de contexte). Avec Kimi K3, un million de tokens en entrée revient à 30 % du prix de Fable 5 et 60 % d’Opus 5.
Claude Sonnet 5 revient certes au même prix que Kimi K3, mais le modèle est aussi moins performant (53,4 sur l’indice Artificial Analysis Intelligence, contre 60 pour K3). Et c’est sans compter les promos de certains fournisseurs, qui proposent K3 à des tarifs encore plus avantageux comme chez OpenRouter.
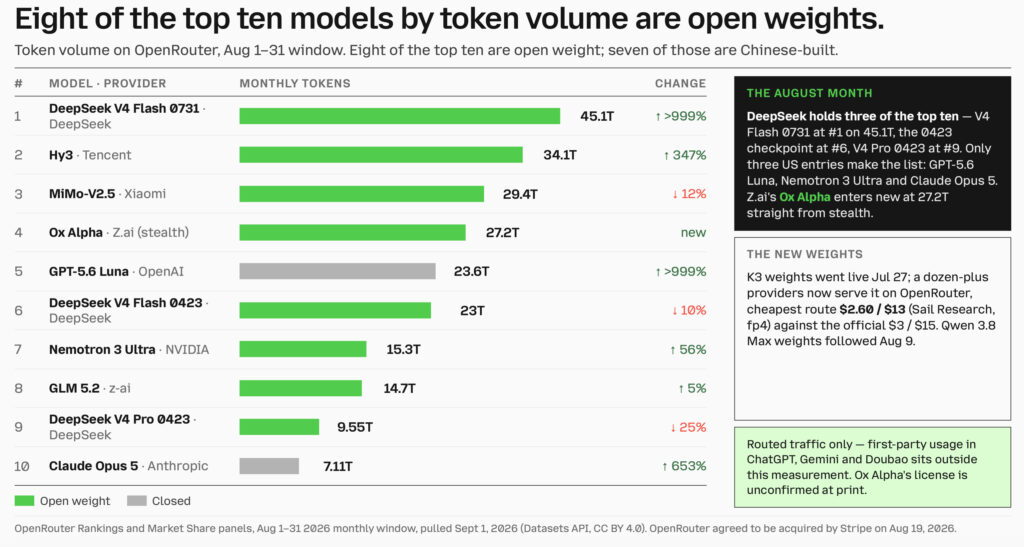
Au mois d’août, huit des dix modèles les plus utilisés sur OpenRouter (la plateforme donne accès à de nombreux modèles IA via une seule API) étaient à poids ouverts. Et il n’y a pas photo : DeepSeek V4 Flash 0731 a traité pour 45 100 milliards de tokens, contre 34 100 milliards pour Hy3 (Tencent) et 29 400 milliards pour MiMo-V2.5 (Xiaomi). Le premier modèle fermé du classement est GPT-5.6 Luna, avec 23 600 milliards. Opus 5 ferme la marche avec 7 100 milliards.
Attention cependant, ces volumes n’incluent pas l’usage dans les clients ChatGPT, Gemini, Claude, etc. Néanmoins, le constat ne souffre d’aucune ambiguïté : les modèles ouverts dominent largement le volume de tokens sur les plateformes de routage.
Toujours en août, DeepSeek a dominé OpenRouter en nombre de requêtes hebdomadaires, une première pour un modèle ouvert chinois. Il met fin au règne de 51 semaines consécutives de Google, qui était jusqu’à présent l’éditeur de modèles le plus sollicité.
Sur les dix modèles les plus utilisés en août, sept étaient chinois. Sur l’ensemble de l’année 2026, l’étude de Mozilla estime que plus de 46 % des tokens transitant par OpenRouter proviendront de modèles chinois. Encore une fois, la plateforme ne représente pas l’ensemble du marché de l’IA, mais c’est un signal significatif de l’usage des développeurs.
Autre signe : Qwen, le modèle d’Alibaba, a été téléchargé 942 millions de fois sur Hugging Face au mois de mars, contre 476 millions pour Llama de Meta, remplacé par le modèle (fermé) Muse en avril. Qwen a été davantage téléchargé que les huit organisations suivantes réunies. Qwen et Alibaba sont de véritables poids lourds dans l’écosystème ouvert.
Les poids ouverts prennent le dessus
Le problème des poids ouverts n’est plus la performance. L’étude de Mozilla pointe le principal blocage : les équipes peinent davantage à maintenir ces modèles, à les intégrer, les évaluer et les utiliser en production. Les modèles fermés gardent cet avantage concurrentiel du produit « clé en main », de la conformité et de la responsabilité contractuelle.
Même s’il y a à redire sur le caractère ouvert des modèles chinois, on retrouve là la problématique classique de l’open source transposée à l’IA. Les différentes briques ouvertes sont performantes et peu onéreuses, mais elles n’ont pas le niveau de finition propre à un produit commercial fini, de maintenance, de suivi de sécurité…
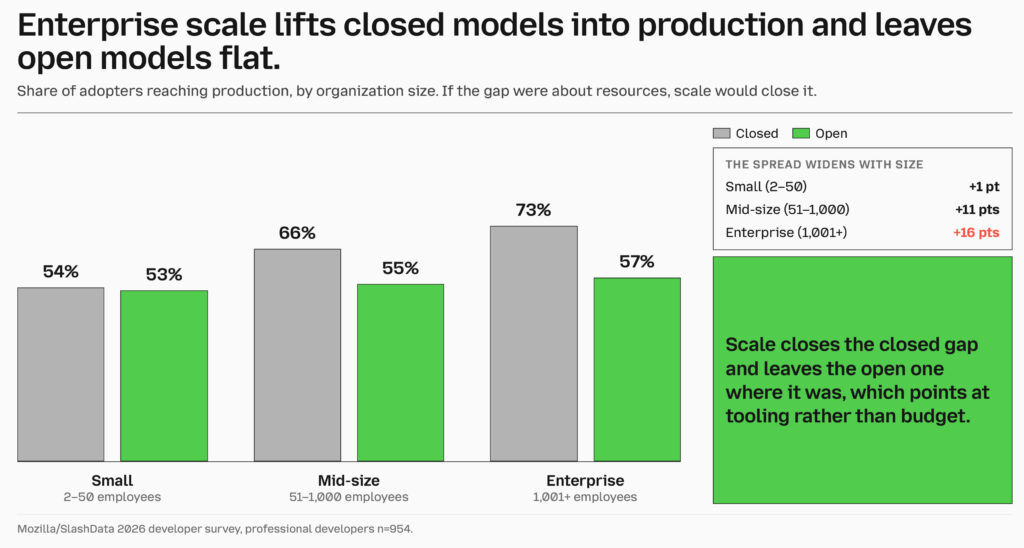
Dans les petites entreprises, les modèles ouverts sont presque autant utilisés que les modèles fermés : 54 % des utilisateurs de modèles fermés passent en production, contre 53 % pour les modèles ouverts. Dans les entreprises moyennes (de 51 à 1 000 employés), la prime va aux modèles fermés avec 66 %, contre 55 % pour les modèles ouverts. Enfin, dans les grandes entreprises, l’écart s’agrandit encore avec les modèles fermés loin devant (73 %, contre 57 % pour les modèles ouverts).
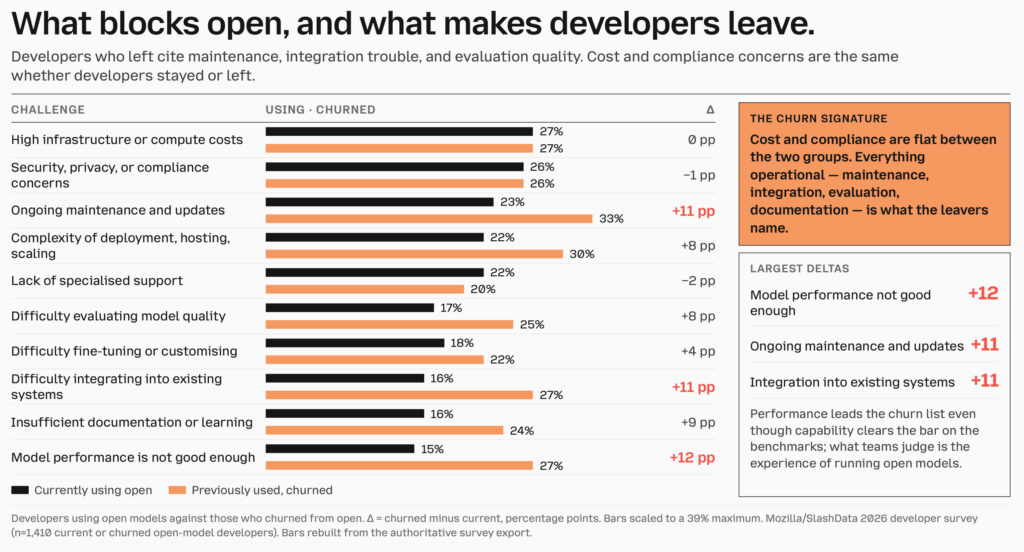
Le sondage de Mozilla montre que le frein n’est pas d’abord financier. Les développeurs qui abandonnent les modèles ouverts ne citent pas plus les coûts d’infrastructure ou les enjeux de sécurité que ceux qui continuent à les utiliser.
C’est plutôt le travail de maintenance au quotidien qui pèse : mises à jour, complexité de déploiement, difficulté d’intégrer les modèles dans des systèmes existants ; les performances des modèles ouverts sont parfois jugées insuffisantes. Pas forcément parce qu’ils se montrent incapables sur les benchmarks, mais parce que les équipes jugent l’ensemble de l’expérience en conditions réelles.
Le difficile passage en production
Les modèles fermés n’ont donc pas perdu tout avantage sur leurs rivaux ouverts. L’étude met ainsi en avant leurs capacités dans l’expertise métier : pour certains travaux à haute valeur ajoutée, les meilleurs modèles propriétaires livrent un travail mieux fini. Fable 5 a ainsi une avance de 92 points Elo sur Kimi K3 dans GDPval-AA v2, un benchmark de tâches professionnelles évaluées par des experts.
Les modèles fermés sont aussi plus fortiches quand il s’agit de trouver des informations dispersées dans un très long contexte (un million de tokens). À ce petit jeu, Gemini 3.1 Pro atteint 89 %, GPT-5.5 74 %, Claude Opus 4.7 56 %, contre 41 % pour DeepSeek V4-Pro, selon les mesures de Mozilla.
Et puis les modèles propriétaires ont cet avantage de ne pas faire peser tout le risque sur l’utilisateur. Ce dernier a un interlocuteur – le fournisseur d’IA – qui prend en charge une partie de la responsabilité et des garanties. Malgré tout, les modèles à poids ouverts prennent une part croissante de l’usage réel : ils pèsent ainsi plus d’un tiers des tokens en production, selon l’estimation de Mozilla.
L’instrument d’influence chinoise
Encouragées par les autorités de Pékin qui en font un élément majeur de politique étrangère, les entreprises IA du pays développent donc des modèles à poids ouverts. La Chine a créé en juillet dernier la WAICO (World Artificial Intelligence Cooperation Organization), une organisation qui veut structurer et promouvoir la coopération internationale autour de l’IA ouverte.
L’organisation compte 37 membres, surtout en Afrique, en Asie du Sud-Est et en Amérique latine. Aucun pays européen dans le lot, et les États-Unis sont bien sûr absents. C’est la réplique chinoise à Pax Silica, une initiative américaine lancée fin 2025 pour sécuriser l’approvisionnement en semi-conducteurs et terres rares pour le déploiement de l’IA.
La Chine favorise la publication des poids des modèles IA afin que les développeurs et les entreprises puissent les télécharger et les adapter à leurs besoins. Le coût d’inférence (le traitement des requêtes) est transféré à l’utilisateur, puisque les modèles tournent sur des serveurs qui lui appartiennent ; bien sûr, il peut aussi louer des capacités chez un fournisseur. Une fois dans la nature, le modèle est impossible à bloquer.
Il y a de nombreuses raisons pour lesquelles cette stratégie déplaît à la Maison-Blanche : utiliser des modèles ouverts chinois est peu coûteux et attractif pour des entreprises qui cherchent à faire des économies, ou pour des pays qui veulent réduire leur dépendance aux technologies propriétaires américaines. L’interdiction faite à Anthropic de distribuer Fable 5 et Mythos 5 par l’administration Trump en juin a revigoré les enjeux de souveraineté partout dans le monde. Il n’existe pas de « kill switch » pour les modèles ouverts.
Le hic, c’est qu’il existe aussi une problématique d’indépendance : les modèles ouverts les plus utilisés sont chinois… Une équation inconfortable pour Washington. Ces modèles offrent une alternative bon marché et efficace aux API américaines propriétaires. Mais ils renforcent aussi l’influence technologique de Pékin. C’est ce qui explique le refus de Donald Trump de réguler l’IA de frontière, car cela reviendrait à freiner les champions US du secteur tandis que la Chine aurait la voie libre. « Nous menons devant la Chine en matière d’IA, nous sommes le pays le plus sophistiqué du monde, et franchement, je veux que cela reste ainsi car celui qui remporte l’IA gagne », a ainsi affirmé, dans son style bien à lui, le locataire de la Maison-Blanche.
Mozilla tient son rythme de mises à jour bimensuelles. La fondation a publié Firefox 156 mardi 15 septembre, une nouvelle mouture qui sur le plan fonctionnel introduit deux nouveautés : la possibilité de lancer automatiquement Firefox au démarrage de macOS, et l’arrivée des « suggestions sponsorisées » au niveau de la barre d’adresses.
Ces dernières s’intègrent à « Firefox suggère », l’outil qui, habituellement, explore l’historique de navigation pour conseiller des adresses susceptibles d’anticiper les besoins de l’internaute. Ces dernières peuvent maintenant afficher des propositions émanant soit de l’édition locale de Wikipédia et, de temps à autres, des « suggestions sponsorisées occasionnelles », dont la consultation est donc censée générer du chiffre d’affaires pour Mozilla.
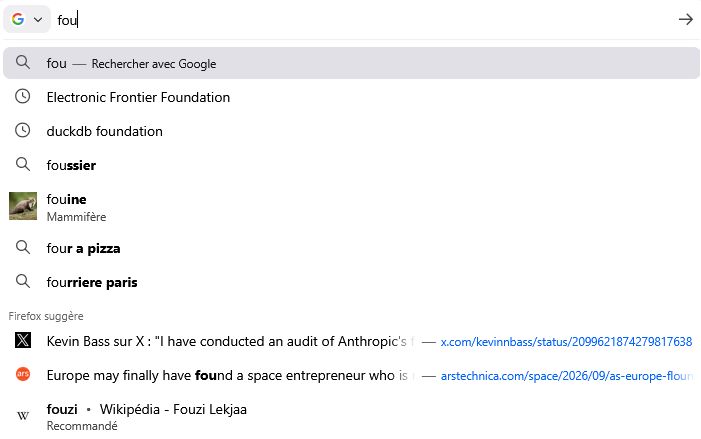
Ces suggestions sponsorisées existent depuis longtemps, mais jusqu’ici, elles n’étaient pas encore déployées en France, Allemagne et Italie, les trois pays concernés par cette mise à jour. La suggestion sponsorisée prend place en bas du champ qui s’ouvre lorsqu’on commence la saisie dans la barre d’adresses.
Aux suggestions standard de la barre d’adresses, émanant soit du moteur de recherche, soit de l’historique, Firefox 156 ajoute maintenant une ligne « Recommandé » en dernière position – capture d’écran Next
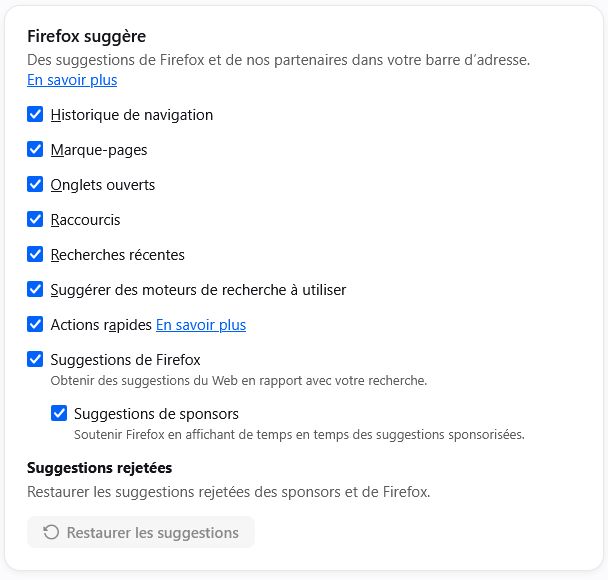
Ces suggestions sponsorisées peuvent tout à fait être désactivées, comme l’ensemble des propositions liées à Firefox suggère. Pour ce faire, il suffit de se rendre dans les réglages, ligne Recherche, et de cocher ou décocher les différentes propositions.
Les réglages permettent de sélectionner une à une les différentes options de Firefox suggère – capture d’écran Next
En coulisses, Firefox 156 introduit également quelques améliorations de performances. Mozilla annonce ainsi que la visionneuse PDF intégrée s’ouvre désormais 45 % plus vite qu’avec la version précédente. L’empreinte mémoire vive / CPU devrait également être améliorée lorsque le navigateur doit afficher des images JPEG mises à l’échelle. Sur les machines Windows on ARM, la nouvelle mouture sait désormais faire appel au décodage matériel H264 lors des appels vidéo via WebRTC, ce qui devrait là aussi améliorer les performances, puisque les versions précédentes passaient par un décodage logiciel.
La prochaine mise à jour de Firefox devrait intervenir le 29 septembre prochain. Cette version 157 est censée s’accompagner de la nouvelle interface Nova, aux contours très arrondis déjà présentés sur Next. Activée par défaut depuis quelques semaines sur le canal Nightly (préversions très en avance de phase), celle-ci est maintenant distribuée via la bêta de Firefox 157.

 Connexion