❌

Vue lecture

Google combine Android, ChromeOS et Gemini pour les portables Googlebook

Chromebook avec une moustache
Google combine Android, ChromeOS et Gemini pour les portables Googlebook

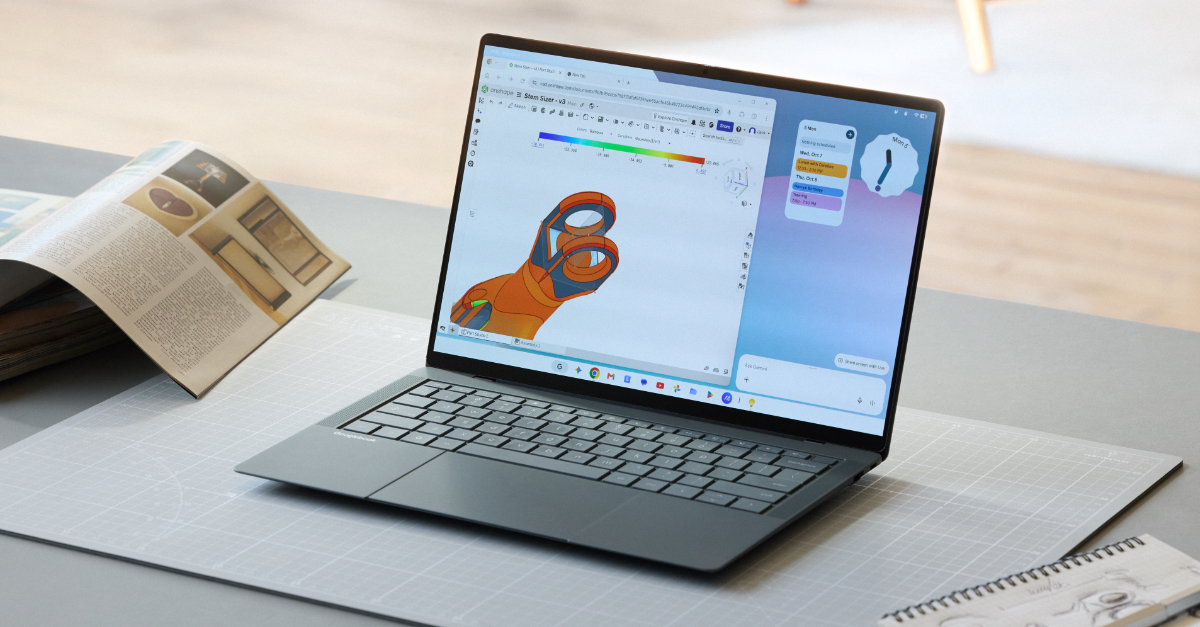
Après avoir échoué à imposer le Chromebook auprès du grand public – même si ces appareils restent populaires dans certains marchés comme celui de l’éducation –, Google remet donc une pièce dans la machine avec sa toute nouvelle famille Googlebook. Des portables fabriqués par des constructeurs partenaires, fonctionnant sur un système d’exploitation qui combine ChromeOS à Android, avec une bonne rasade d’IA par-dessus, le tout à des prix dignes d’un MacBook Air, à partir de 1 099 euros : c’est le pari du géant du web.

Google retente sa chance dans le secteur du portable. Après une première présentation mi-mai, le géant du web lance les premiers Googlebook et cette fois, pas question de vendre des machines au rabais comme le furent les premiers Chromebook. Ces appareils émargent dans la catégorie « haut de gamme », selon les propres mots de Google, avec des prix à l’avenant.

x86 ou Arm, pas de jaloux

Acer, Asus, Dell, HP et Lenovo sont les constructeurs partenaires de ce lancement, avec des modèles qui débutent à 1 099 euros. Au menu : « matériaux premium » (aluminium, alliage de magnésium, fibre de carbone), écrans tactiles OLED 2,8K pour les mieux dotés, trackpad en verre avec retour haptique ou mécanique, clavier rétroéclairé, barre lumineuse discrète sur le capot.
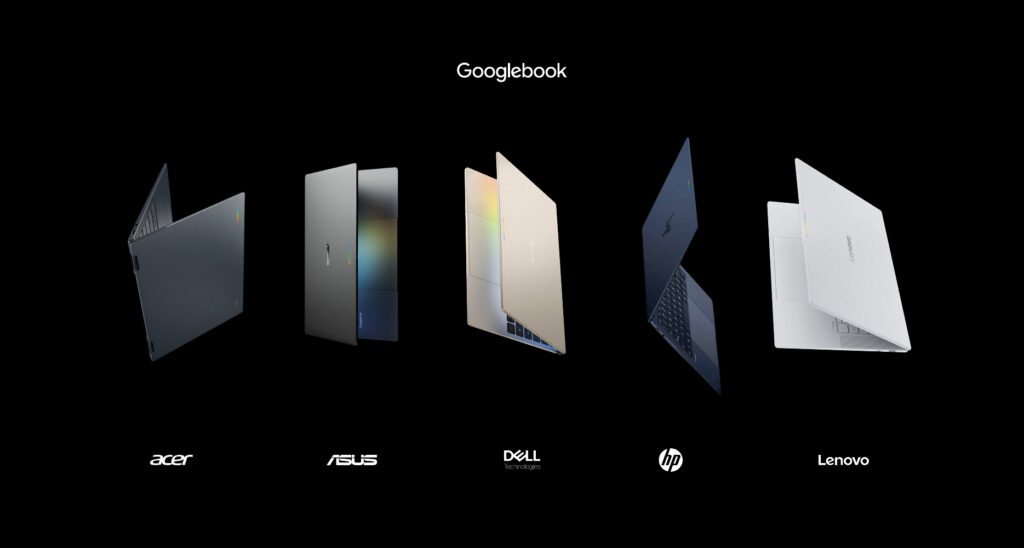
Sous le capot, les Googlebook ont le choix entre une puce Intel (Core Ultra Series 3 Panther Lake) et une puce Qualcomm (Snapdragon X Elite) ; des modèles avec du silicium MediaTek sont également prévus. Ils embarquent de 16 à 32 Go de mémoire unifiée, et de 256 Go à 1 To de stockage.

Il s’agit d’ordinateurs portables dans tous les cas (le Googlebook 14 d’Acer peut se transformer en tablette), mais d’autres formats ne sont pas exclus à l’avenir. Rick Osterloh, vice-président de Google en charge du matériel et des services, évoque rapidement chez The Verge la possibilité d’autres designs, et pourquoi pas des ordinateurs de bureau. L’équipe qui en interne s’occupe de la gamme Pixel pourrait proposer son propre Googlebook.

C’est surtout sur la partie logicielle que la gamme Googlebook sort du lot. Le système d’exploitation, baptisé Googlebook OS (pourquoi faire compliqué) repose sur un socle partagé entre ChromeOS et Android. L’idée générale est qu’un utilisateur de smartphone Android se sente comme chez lui sur un Googlebook.
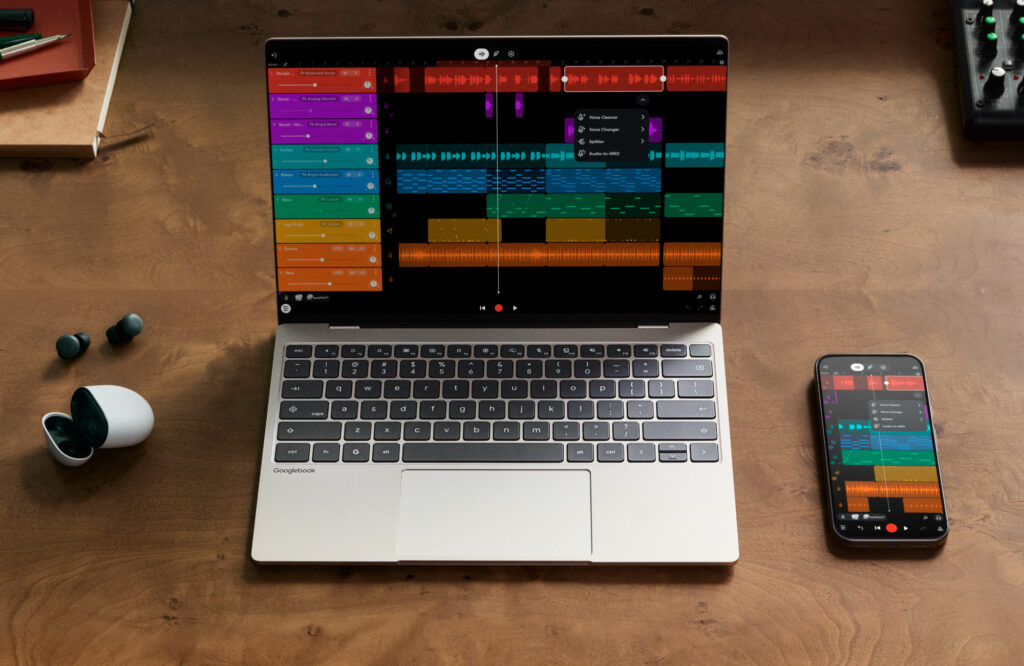
Image : Google

Ainsi, les paramètres Android, les mots de passe, les réseaux Wi-Fi et les messages sont synchronisés entre le portable et le téléphone. Une fonction de continuité permet de passer d’un appareil à l’autre et inversement. Google n’invente rien ici : les utilisateurs d’iPhone et de Mac connaissent ce type de fonctionnement transparent depuis des années.

Un petit air d’Apple

Les Googlebook ont accès au Play Store, donc à des millions d’applications Android et Google promet qu’ « un grand nombre est optimisé pour les grands écrans, le clavier et la souris ». L’entreprise évoque des logiciels comme Photoshop et Lightroom, mais il s’agit des versions mobiles.

Les jeux Android sont de la partie évidemment, tout comme le service GeForce Now de streaming de jeux. Il est aussi possible de projeter une app depuis son smartphone vers le portable, et d’accéder aux fichiers et documents stockés sur le téléphone ; il apparait en fait tout simplement dans la fenêtre de l’explorateur de fichiers.
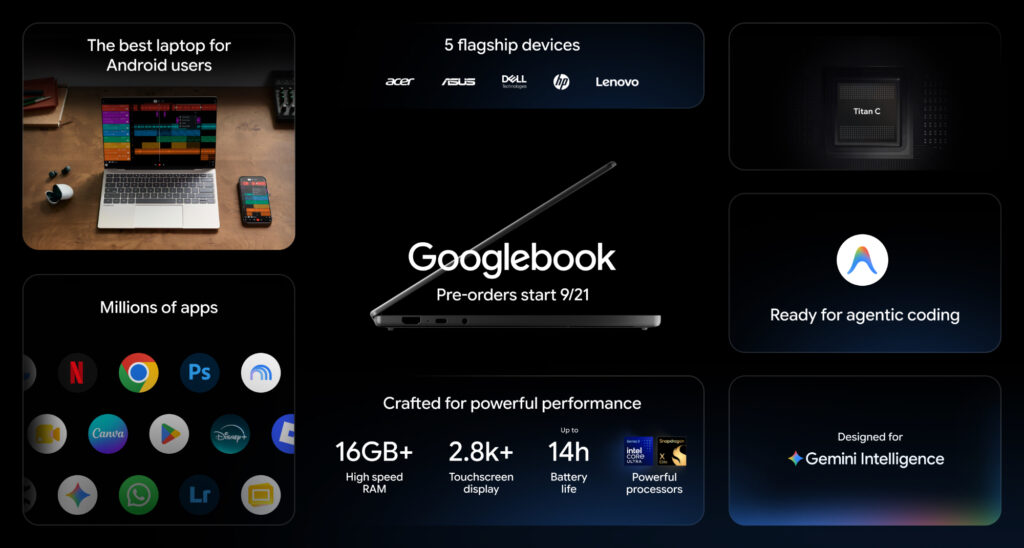
Googlebook a été « conçu pour Gemini Intelligence » – image : Google

L’autre grande affaire des Googlebook est l’intégration profonde de Gemini. Les portables intègrent un NPU jusqu’à 45 TOPS, de quoi leur assurer le traitement en local de fonctions d’IA regroupées sous la bannière « Gemini Intelligence ». Google met en avant le « Pointeur magique » qui permet à Gemini d’interagir avec le contenu affiché à l’écran en secouant le curseur de la souris.

Une fonction de dictée améliorée met en forme les mémos vocaux pour être partagés par écrit. Le bureau du Googlebook pourra être personnalisé avec des widgets créés par l’utilisateur. Les Googlebook intègrent également Antigravity, la plateforme maison qui permet de concevoir des agents IA et déployer des applications depuis la machine.

Les précommandes ont débuté auprès des distributeurs français, pour une disponibilité le 5 octobre. Pour l’occasion, Google livre 12 mois d’abonnements à sa formule IA Pro, 5 To de stockage en ligne, et surtout dix ans garantis de mises à jour logicielles.

  •  

IA : le nouveau modèle Jev se veut le champion des « décisions typées »

Ceci n'est pas un LLM
Claude Opus 5.5, GPT-6 Sol et Luna : Anthropic et OpenAI se battent sur les prix

La société TypeSafe AI a présenté il y a quelques jours un nouveau modèle d’IA. Baptisé Jev, il se propose de traiter certaines opérations bien plus rapidement que les LLM « traditionnels », pour beaucoup moins cher. La comparaison reste cependant délicate.

L’annonce a fait l’effet d’une petite bombe sur les réseaux sociaux, particulièrement sur X : la société TypeSafe AI, fondée par Diogo Almeida, a annoncé son nouveau modèle de frontière, Jev.

Diogo Almeida se présente comme co-inventeur de ChatGPT. Un titre un peu exagéré. Il a travaillé effectivement sur les méthodes qui ont rendu capables les modèles GPT de suivre des instructions et de converser avec les utilisateurs. Mais il serait plus juste de dire qu’il est le co-inventeur du RLHF (Reinforcement Learning from Human Feedback), c’est-à-dire l’apprentissage par renforcement à partir de rétroaction humaine. Il est effectivement l’un des auteurs d’un papier fondateur sur la question.

Jev, en tout cas, n’est pas un LLM : il ne peut pas créer de texte ni même aider à la programmation. Il est décrit comme le premier « System One Model », une nouvelle catégorie de modèles conçus pour prendre des décisions rapides et structurées, que des services ou applications peuvent ensuite utiliser directement.

Ce qu’est Jev

Le modèle est comparé par TypeSafe AI à un appel de fonction : un état non structuré en entrée, des décisions probabilistes typées en sortie. Concrètement, on lui envoie un état (le contexte) et des questions portant sur cet état. Les réponses possibles sont fixées à l’avance par un schéma. Jev répond ensuite via trois primitives : le choix d’une option dans un ensemble, une note sur une échelle ordonnée, et un oui ou non calibré.

Pour bâtir Jev, TypeSafe AI dit avoir construit une nouvelle architecture de modèle, un échantillonneur parallèle et une nouvelle méthode de renforcement baptisée RLCD, pour « Reinforcement Learning for Calibrated Decisions ». L’échantillonneur parallèle signifie que toutes les questions d’une requête sont évaluées en parallèle, contrairement à un LLM dont chaque nouvel élément dépend du précédent.

Plusieurs points forts sont mis en avant, notamment la calibration via RLCD. Selon l’entreprise, cet entrainement doit permettre des réponses assorties de probabilités « honnêtes ». Dans ce contexte, une confiance plus élevée (donnée sous forme de pourcentage) signifie une meilleure exactitude. En outre, TypeSafe affirme que Jev ne peut pas halluciner, puisque la sortie est contrainte par le schéma. Il faut cependant lire entre les lignes : dans ce contexte, Jev garantit le respect du format, pas la justesse du format. En d’autres termes, Jev ne peut rien « inventer », mais il peut se tromper de catégorie.

Vite, un exemple !

Pour mieux comprendre l’intérêt de ce nouveau modèle, mieux vaut un exemple. Imaginons un service client qui reçoit 10 000 e-mails par jour. Pour chacun, un programme doit prendre plusieurs décisions : le client est-il mécontent ? Faut-il envoyer le message au service facturation, technique ou commercial ? Est-ce urgent ?

Aujourd’hui, ce type de tâche est souvent confié à un LLM comme GPT ou Claude. On lui envoie l’e-mail avec une consigne du type « dis-moi si c’est urgent », et il répond par une phrase : « Oui, ce message semble urgent car le client menace de résilier ». Problème, un programme informatique ne « comprend » pas les phrases. Il faut donc un travail supplémentaire pour extraire le « oui » de cette phrase. De plus, le modèle peut répondre à côté, ajouter des commentaires inutiles ou inventer une catégorie qui n’existe pas. Enfin, écrire une phrase mot par mot prend du temps et coûte cher.

Jev ne fonctionne pas avec des phrases, mais avec trois primitives. On applique une liste de questions dont les réponses sont fixées à l’avance :

  • Le client est-il mécontent ? Oui/Non
  • Quel service doit traiter cet e-mail ? Facturation/Technique/Commercial
  • Quelle urgence sur une note de 1 à 5 ?

Si on continue dans cet exemple, on obtiendra une réponse du type : « oui (92 % de certitude), facturation (85 %), urgence 4 (70 %) ». Cela revient à donner un formulaire à remplir pour répondre à une question plutôt que demander son avis à une personne.

Les données émises par Jev sont formatées et peuvent être reprises telles quelles par d’autres éléments de traitement de la chaine. Quand TypeSafe affirme que son modèle ne peut pas halluciner, cela signifie que Jev ne peut pas répondre par exemple « Juridique » pour le service à contacter. En revanche, rien ne l’empêche de se tromper sur le service à effectivement contacter. On peut alors appliquer un filtre pour automatiser l’envoi à une équipe humaine pour toutes les réponses dont le score de confiance est inférieur à 80 %.

L’efficacité mise en avant

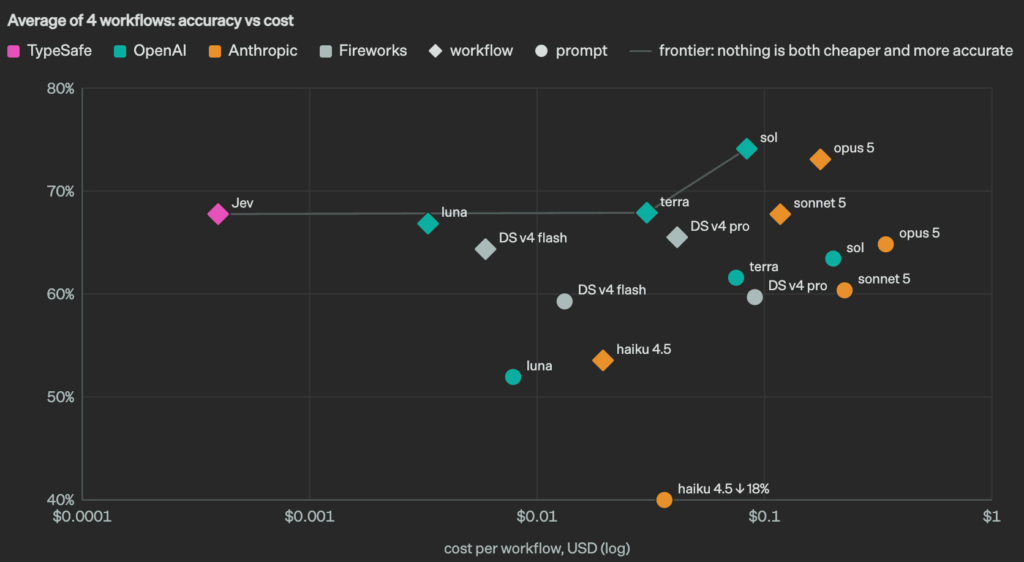
L’un des éléments les plus repris par la presse est l’efficacité du modèle. Sur les tâches pour lesquelles il a été pensé, le temps de réponse annoncé va de 70 à 500 ms, soit 40 à 200 fois plus rapide que les modèles de pointe pour des requêtes de ce type. Le prix est de 0,042 dollar par million de jetons en entrée, et la sortie est gratuite. À titre de comparaison, GPT-5.6 Terra coûte 2 dollars par million de jetons en entrée et 12 dollars en sortie.

Dans sa présentation, TypeSafe donne des chiffres mais émet elle-même des réserves. Ainsi, les gains maximaux peuvent être très précisément de x193,6 sur les performances et x444,6 moins cher. Ces chiffres viennent de quatre chaines de traitement interne : réponse aux incidents de sécurité, observation de traces d’agents, traitement de factures et service client.

Même si TypeSafe évoque une certaine prudence, il est difficile pour l’instant de jauger des performances réelles comme de la facture finale, car le modèle n’est disponible pour tout le monde que depuis le 20 septembre, sans liste d’attente. Si l’on en croit certains retours d’entreprises ayant testé le modèle, le gain semble avéré.

En outre, l’annonce de Jev est déjà contestée. Selon Nandakishor Mukkunnoth, fondateur de ConvAI Innovations, l’idée n’est pas nouvelle. Dans un billet, il indique être à l’origine des recherches qui ont mené à cette technique, dont il revendique la paternité. Il ne reproche pas à TypeSafe d’avoir copié du code, mais de ne pas avoir cité des travaux antérieurs. Sur Hacker News, plusieurs personnes notent que ce type de mésaventure est malheureusement courant, mais que l’apport de TypeSafe est surtout d’avoir réussi à en faire un produit concret.

Ce qui n’a pas empêché Nandakishor Mukkunnoth de publier une alternative libre, nommée Laya. D’autres modèles libres sont apparus en quelques jours. Si l’on en croit les premiers tests réalisés indépendamment, tous les modèles affichent des performances moindres que Jev. Si l’on donne un score de référence de 1 à ce dernier, les 78 tests effectués font ressortir des notes alternant entre 0,5 et 0,7, Laya étant dans la moyenne.

  •  

Google enfreint le RGPD et écope d’une amende de 403 millions d’euros

Un suivi à la trace qui coûte cher
Google enfreint le RGPD et écope d’une amende de 403 millions d’euros

Google essuie une nouvelle amende en Europe. La Commission à la protection des données irlandaise inflige une sanction financière de 403 millions d’euros au géant du web pour infraction au RGPD. Le régulateur ordonne également à l’entreprise de se conformer au règlement européen sur la protection des données dans les six mois.

La Commission à la protection des données irlandaise (DPC) n’a pas peur des gros chiffres. En 2023, elle infligeait une amende record de 1,2 milliard d’euros à Meta pour infraction au RGPD. Rebelote aujourd’hui, cette fois contre Google qui écope donc d’une douloureuse de 403 millions.

La DPC remonte la piste de Google

En sa qualité d’autorité de contrôle pour Google (le siège européen du groupe est installé en Irlande), la DPC menait l’enquête depuis début 2020. Deux ans plus tôt, des plaintes avaient été déposées par huit organisations de défense des consommateurs regroupées au sein du BEUC (Bureau européen des unions de consommateurs).

La décision de la DPC était donc attendue depuis un bon moment. Elle porte sur le traitement des données de localisation dans trois fonctions spécifiques : l’activité sur le web et les applications (historique de navigation, recherches et certaines données de localisation), l’historique de localisation (enregistrement des lieux visités et déplacements de l’utilisateur) et la précision de la localisation (amélioration de la géolocalisation de l’appareil au-delà des seules données GPS). Le tout sur la période comprise entre la mise en œuvre du RGPD en mai 2018 et février 2020.

Google a enfreint le règlement européen sur ces trois points. En ce qui concerne l’activité sur le web et les apps, ainsi que sur l’historique de localisation, l’entreprise a traité les données de localisation sans fondement juridique valable, et d’une manière déloyale envers les utilisateurs. Google a aussi démontré son incapacité à prouver que les données personnelles recueillies par la fonctionnalité de précision de la localisation étaient traitées légalement, loyalement et en toute transparence.

La DPC a également conclu que le groupe n’a pas respecté ses obligations de transparence concernant les trois fonctions en question, et qu’il a enfreint les principes de conservation des données de localisation pour les fonctionnalités d’activité sur le web et les apps, ainsi que pour l’historique de localisation.

Une décision longue à venir

« Les données de localisation peuvent être extrêmement sensibles, car elles révèlent beaucoup de choses sur notre vie privée : l’école fréquentée par nos enfants, le nombre de visites d’une personne à l’hôpital, voire ses lieux de culte. Il s’agit d’une pratique extrêmement intrusive, qui porte atteinte au droit fondamental à la vie privée et enfreint le RGPD », rappelle Agustín Reyna, directeur général du BEUC.

Ce dernier se réjouit de la décision de la DPC, mais regrette « le temps nécessaire pour parvenir à cette conclusion » jugé « disproportionné au regard de la gravité de l’infraction ». Pour Agustín Reyna, « Une application tardive de la loi peut être aussi préjudiciable qu’une absence totale d’application. Les droits fondamentaux des consommateurs doivent être protégés plus rapidement et plus efficacement. »

Google a maintenant six mois pour se mettre en règle… même si cela semble déjà être le cas. L’entreprise a en effet rappelé à Bloomberg que le dossier porte sur d’anciennes règles de confidentialité mises à jour depuis. « Depuis 2019, nous avons considérablement fait évoluer nos pratiques et lancé des outils performants qui simplifient la gestion des données de localisation », ajoute-t-elle.

Dix organisations membres du BEUC, dont Que Choisir Ensemble (à l’époque, UFC-Que Choisir) ont déposé une seconde plainte contre Google en 2022. Elle porte sur la manière dont le groupe pousse les utilisateurs, lors de la création d’un compte, à accepter une collecte et une exploitation étendues de leurs données personnelles via des méthodes d’interfaces manipulatrices (dark patterns). La DPC a ouvert une enquête en 2023.

  •  

Meta et ses lunettes connectées attaquées en justice aux États-Unis

Lunettes trop connectées ?
Meta et ses lunettes connectées attaquées en justice aux États-Unis

Les lunettes connectées de Meta sont de plus en plus utilisées à travers le monde mais aussi de plus en plus décriées. Aux États-Unis, des dizaines de personnes se sont jointes à une class action contre Meta accusée notamment d’avoir envoyé des scènes d’intimité sur ses serveurs et à un sous-traitant sans leur consentement.

Alors que de partout les lunettes Meta et leurs utilisateurs sont critiqués, une plainte vient unifier, aux États-Unis, les personnes qui dénoncent l’atteinte à leur intimité de la part de Meta. Elles accusent l’entreprise de Mark Zuckerberg d’avoir notamment transféré de manière problématique des photos et vidéos captées par une de ses paires de lunettes connectées.

En début d’année, des journalistes suédois ont montré que certaines scènes de la vie courante et parfois intime de porteurs de lunettes Meta et de leurs proches étaient envoyées sur les serveurs de Meta puis parfois à un de ses sous-traitants kényans pour analyse.

Ce sous-traitant, nommé Sama, est connu pour faire partie des entreprises africaines qui traitent les données des entreprises de la Silicon Valley pour toutes les tâches de modération et d’étiquetage (tâche qui permet d’améliorer les modèles).

À l’époque, l’eurodéputé du Parti social-démocrate suédois Adnan Dibrani avait soulevé des questions sur le sujet devant la Commission européenne. Mais de l’autre côté de l’Atlantique, cette enquête a aussi inquiété plusieurs acheteurs de lunettes Meta qui ont monté différents dossiers juridiques.

Plus de 70 utilisateurs de lunettes Meta se rassemblent pour porter plainte

Fin août, plus de 70 d’entre eux ont finalement fusionné leurs plaintes dans une class action déposée devant un tribunal fédéral de Californie du Nord, a appris le Los Angeles Times.

Le document de 230 pages [PDF] s’appuie sur l’enquête de nos confrères et consœurs suédois pour accuser Meta d’envoyer sur ses serveurs les données que les utilisateurs font transférer des lunettes à leur smartphone. Et ce, en temps réel et qu’ils aient activé ou non la fonction « cloud media » (qui permet de sauvegarder sur le cloud de Meta).

La plainte évoque l’envoi par Meta de données à Sama pour que des employés de ce sous-traitant les vérifient. « Meta a transmis à des annotateurs tiers travaillant pour Sama des données à caractère personnel, notamment des images et des enregistrements audio représentant des situations privées et des activités personnelles dont l’utilisateur plaignant pouvait raisonnablement s’attendre à ce qu’elles restent privées », affirme le document.

Des scènes privées envoyées automatiquement

Mais la plainte contient aussi des témoignages des différents utilisateurs portant plainte. Ainsi, l’un d’entre eux affirme que ses lunettes ont enregistré à son insu des membres de sa famille dans la salle de bain alors qu’il les avait laissées sur une étagère : « Il a remarqué que, parfois, des photos de membres de sa famille dans la salle de bain et en train de se laver commençaient à apparaître dans sa galerie – des images que personne dans son foyer n’avait l’intention de prendre ».

Un autre témoigne que les lunettes qu’il a achetées « se déclenchaient par erreur deux fois par jour ». « Meta a capturé, transmis et acheminé vers Sama les images et les enregistrements audio capturés par les lunettes [de ce plaignant], qui montraient des situations privées et des activités personnelles dont il pouvait raisonnablement s’attendre à ce qu’elles restent privées », décrit le document au milieu de l’évocation de plus d’une quarantaine d’autres cas.

Les avocats soulignent que la communication de Meta est pourtant très rassurante, notamment depuis 2025, martelant que ses lunettes sont « conçues pour préserver votre vie privée, sous votre contrôle ». « Mark Zuckerberg a lui-même insisté sur ce message clé, soulignant qu’il était d’une « importance capitale » de « donner aux utilisateurs le contrôle » sur ce que les lunettes enregistrent et conservent », ajoutent-ils. Pour eux, cette insistance sur la protection de la vie privée des utilisateurs a permis à Meta de passer de 2 millions de ventes de lunettes sur 2023 et 2024 réunies à 7 millions pour la seule année de 2025.

« Ces promesses étaient fausses. Les lunettes enregistrent en silence, avec des indicateurs difficiles à voir et facilement masqués », constatent-ils.

« Si vous utilisez Meta AI, nous pouvons être amenés à examiner ces données afin d’améliorer nos produits et l’expérience utilisateur – cela fonctionne de la même manière que dans de nombreuses autres entreprises. Nous prenons des mesures pour filtrer ces données afin de supprimer les informations permettant d’identifier les utilisateurs et de protéger leur vie privée », a commenté Meta dans une déclaration envoyée au Los Angeles Times.

  •  

Suno veut faire la paix avec l’industrie musicale, Sony et Universal attaquent de nouveau

Les majors sortent les dossiers
Suno veut faire la paix avec l’industrie musicale, Sony et Universal attaquent de nouveau

La quête de respectabilité de Suno est décidément un long chemin pas très tranquille. La start-up qui développe des outils de génération IA de musique est la cible d’une nouvelle plainte des majors Sony et Universal.

Dévoilé le 9 septembre, le modèle v6 de Suno a été développé en partenariat avec des représentants de la filière musicale, dont Warner, BMG et Believe. Ce modèle IA est présenté comme un moyen de montrer « comment l’IA et l’industrie musicale peuvent se renforcer mutuellement et créer des expériences entièrement nouvelles pour les artistes, les fans et, plus largement, toute la communauté musicale. »

Ce travail en commun avec une partie de la filière permet aussi et surtout à Suno de se rapprocher des acteurs traditionnels de l’industrie musicale et de montrer qu’elle entend désormais composer avec eux, plutôt que contre eux. À l’instar de son rival Udio, la start-up a mauvaise réputation dans le milieu.

Sony et Universal remettent une pièce

Malgré v6, Suno n’est pas au bout de ses peines. Sony Music et Universal Music (UMG) ont ainsi déposé plainte contre l’entreprise ce vendredi 18 septembre (PDF). Les deux majors lui reprochent d’avoir copié sans autorisation des dizaines de milliers d’enregistrements protégés pour l’entraînement de ses modèles. On parle de 60 202 enregistrements, et il ne s’agit là que d’une partie du corpus effectivement utilisé.

La deuxième accusation est que Suno aurait obtenu une partie des fichiers en les aspirant depuis YouTube, avec l’aide d’outils bien connus des pirates pour contourner les protections techniques de la plateforme vidéo. L’entreprise l’avait d’ailleurs admis :

Enfin, et c’est peut-être l’élément le plus saillant de la plainte, Sony et UMG veulent empêcher Suno de présenter v6 comme un nouveau départ. Les plaignantes affirment que le modèle aurait encore utilisé des copies de leurs enregistrements pour son entraînement, sans autorisation.

Le lourd passif des anciens modèles

Jack Brody, le directeur produit de Suno, avait affirmé au site MBW que l’entraînement de v6 s’est réalisé « à partir de zéro », avec « des données différentes de celles utilisées pour les modèles précédents ». Surtout, ces données n’incluent rien provenant de Sony et d’UMG.

Mais voilà : lorsqu’un utilisateur crée un morceau avec Suno, ce sont en fait deux titres qui sont générés. Ces données de préférence servent ensuite à améliorer les modèles. Les majors estiment que, puisque ces préférences portent sur des morceaux générés par les anciens modèles, elles ont permis de transmettre à v6 une partie de ce que ces modèles avaient appris à partir d’enregistrements utilisés sans autorisation. Autrement dit, du blanchiment de données.

Sony et Universal réclament une injonction pour faire cesser les pratiques de Suno, ainsi que des dommages et intérêts qui pourraient se monter jusqu’à 150 000 dollars par œuvre. On sent que la porte n’est pas fermée pour une entente à l’amiable. Dans leur plainte, les deux sociétés expliquent en effet qu’il existe un marché pour des licences qui permettraient d’obtenir légalement des données d’entraînement, la preuve : Suno a signé avec Warner, BMG et Believe…

C’est la deuxième action en justice menée par UMG et Sony contre Suno. La première remonte à juin 2024, qui portait sur l’utilisation présumée, sans autorisation, d’enregistrements protégés pour l’entraînement d’anciens modèles. Une procédure amendée au mois d’août, en ajoutant au lot l’accusation de contournement des protections anti-téléchargement de YouTube.

  •  

L’hallucination d’une IA a failli provoquer un affrontement entre les États-Unis et la Chine

« ChatGPT peut faire des erreurs »
L’hallucination d’une IA a failli provoquer un affrontement entre les États-Unis et la Chine

L’humanité est passée à un cheveu, ou plutôt à une hallucination près, de partir en lattes. Au printemps, l’armée américaine était en effet à deux doigts de prendre d’assaut un navire chinois soupçonné de transporter des composants pour un programme nucléaire. Problème : le rapport sur lequel l’armée se basait a été généré par une IA qui a halluciné la cargaison du bateau.

Depuis quelques jours, les grands acteurs de l’IA jouent à se faire peur, en affirmant que cette technologie pourrait signer la fin de l’humanité. Un storytelling apocalyptique qui sert aussi et surtout les intérêts commerciaux d’entreprises qui préparent leurs introductions en Bourse.

Le vrai danger immédiat de l’IA réside dans les décisions potentiellement catastrophiques d’humains prises à partir d’informations non fiables ou carrément hallucinées. C’est particulièrement problématique quand il s’agit de décisions militaires. CNN rapporte un exemple qui fait froid dans le dos.

WarGames pour les nuls

Au plus fort de la guerre contre l’Iran ce printemps, l’armée américaine a très sérieusement envisagé d’intercepter un navire chinois par la force, avec l’aide d’un support aérien armé. Le bâtiment, qui croisait au Moyen-Orient, transportait des composants destinés à un programme d’armement nucléaire, du moins d’après un rapport rédigé par un analyste du commandement des opérations spéciales américaines pour le Pacifique, basé à Hawaï.

Fort heureusement, juste avant le lancement de l’opération, des responsables ont examiné de plus près le fameux rapport. Ils ont alors découvert qu’il avait été rédigé avec l’aide d’un bot IA qui a mal identifié la nature du matériel transporté par le navire, à partir de son manifeste. Une des sources de CNN affirme que le rapport était « complètement faux ». Cette histoire basée sur l’hallucination d’une IA a « presque failli déclencher une guerre » : toute opération américaine contre un navire chinois peut dégénérer en conflit entre les États-Unis et la Chine.

Le bot aurait patouillé des renseignements publics avec des renseignements classifiés pour déterminer, faussement, que le bâtiment transportait une cargaison dangereuse. Une conclusion qui aurait pu être très lourde de conséquences.

Le Pentagone hallucine aussi

Le ministère de la Défense américain, emmené par le très trumpiste Pete Hegseth, a fait de l’intégration de l’IA dans les opérations militaires une priorité. Une intégration à marche forcée : les responsables états-uniens, tout comme Donald Trump, estiment que le pays ne peut pas prendre de retard sur ce dossier. Que se passerait-il si les États-Unis devaient affronter la Chine ou un autre adversaire mieux équipé ?

Une note du Pentagone décrivait la stratégie à suivre (PDF) : démocratiser l’expérimentation de l’IA dans l’ensemble du ministère, « en mettant les modèles d’IA américains de pointe directement entre les mains de nos trois millions de personnels civils et militaires, à tous les niveaux de classification ».

La mise en œuvre serait cependant bien décousue : chaque branche du gouvernement utilise des outils différents avec des normes de sécurité tout aussi différentes. Aucun standard n’existe pour vérifier les informations de ces systèmes d’IA. Les humains restent donc, plus que jamais, absolument indispensables pour prendre les décisions, en espérant que ce soient les bonnes.

  •  

Switch 2 : les cartouches 32 Go commencent enfin à sortir du bois

Le physique, mais à quel prix ?
Switch 2 : les cartouches 32 Go commencent enfin à sortir du bois

En matière de support physique, s’il ne devait en rester qu’un, ce serait probablement Nintendo. Les jeux sur cartouches sont presque à parité avec les jeux dématérialisés sur les consoles Switch.

Les joueurs Nintendo sont très attachés au support physique : durant l’exercice fiscal 2025, 45,4 % du chiffre d’affaires des jeux provenait des cartouches Switch, contre 54,6 % pour le dématérialisé (PDF). En plus des jeux téléchargeables sur l’eShop, ce dernier chiffre inclut aussi les DLC, les titres exclusivement numériques et l’abonnement Nintendo Switch Online.

Le ratio chez les concurrents tourne plutôt autour de 80/20 en faveur du tout dématérialisé. Et avec l’annonce de Sony de l’arrêt des supports physiques pour les jeux PlayStation (programmé en janvier 2028), la part associée au physique ne va pas s’améliorer.

Les Game-Key Cards, compromis peu populaire

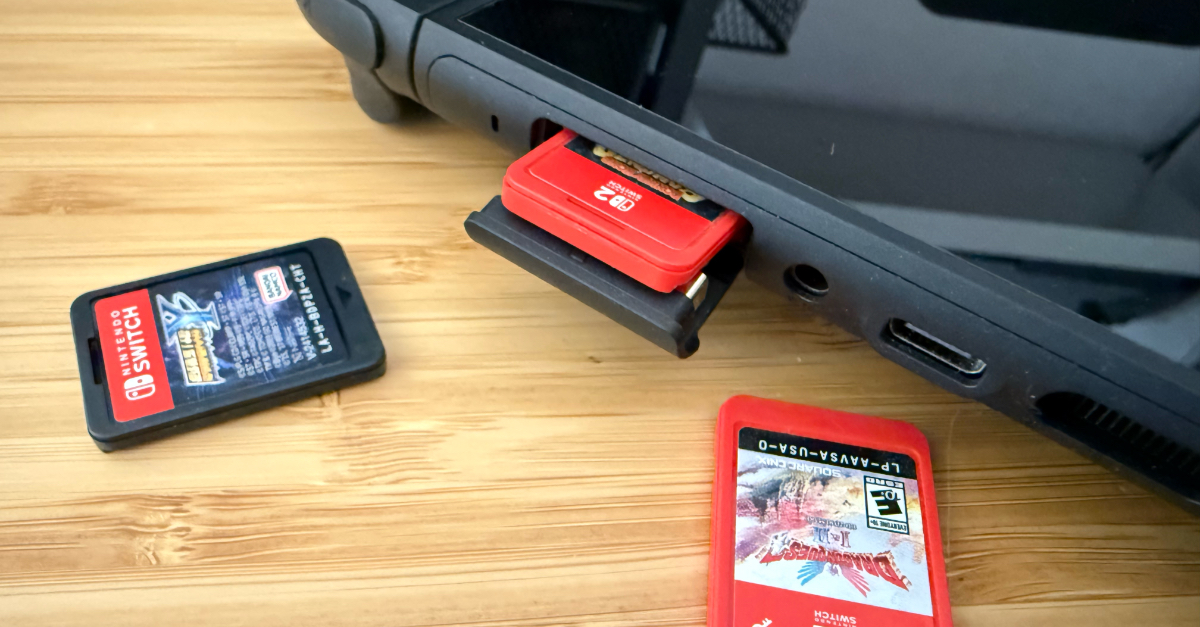
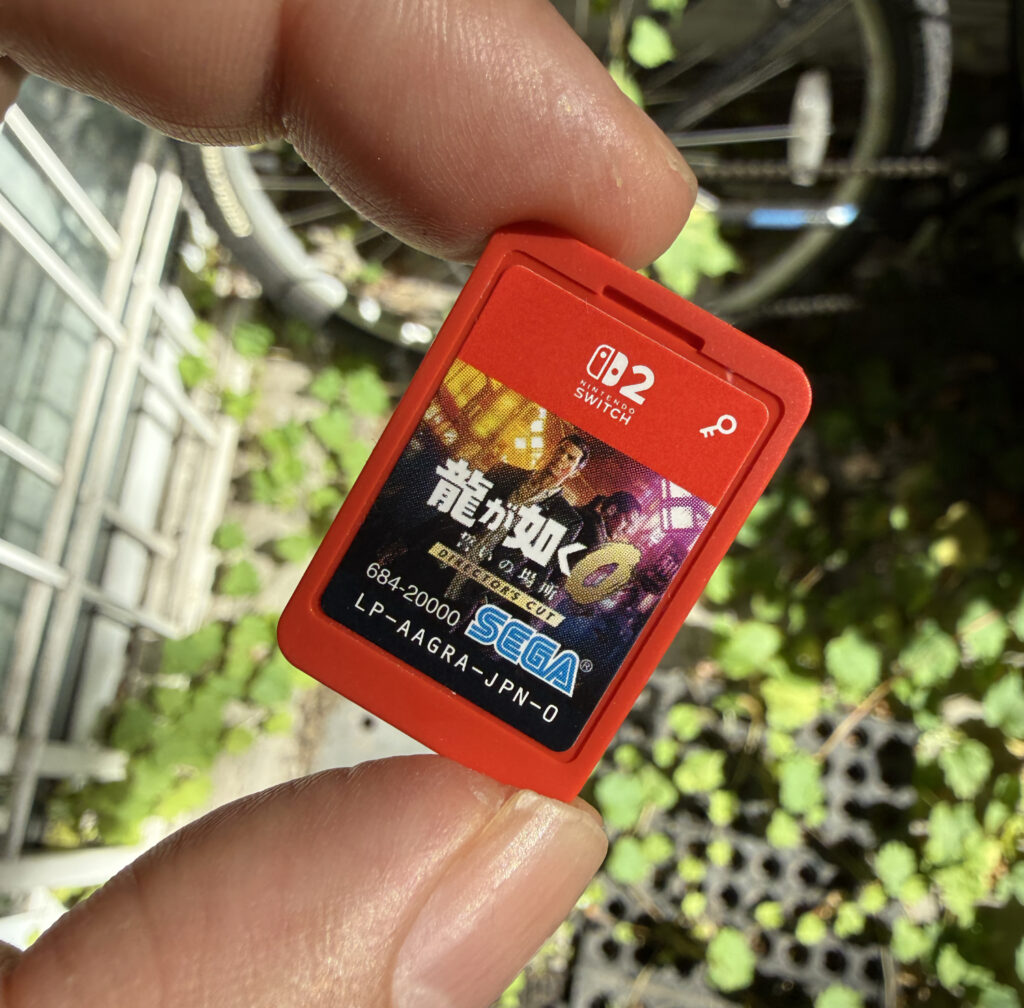
Nintendo n’est pas PlayStation : pas question de s’aliéner une part importante de la clientèle. La Switch 2 intègre donc un port cartouche, qui plus est compatible avec les jeux Switch 1. La nouvelle console, plus puissante, exige aussi des supports de stockage plus imposants ; c’est pourquoi les cartouches de la Switch 2 sont de 64 Go, deux fois plus que les cartouches de Switch 1 qui se déclinent en plusieurs capacités allant de 1 à 32 Go.

Une carte clé de jeu. Image : Next

Le hic, c’est que le support physique pour Switch 2 a un coût élevé pour les éditeurs. ININ Games, qui publie R-Type Dimensions III, avait expliqué dans un billet datant de décembre dernier, avant le lancement du jeu, pourquoi il ne sortirait pas sur cartouche.

« Pour la Switch 2, tous les exemplaires d’un même titre doivent utiliser le même format physique. Comme environ 90 % de la production totale est destinée à la distribution classique en magasin, avec un prix de vente fixé à 39,99 €, passer l’ensemble de la production sur de véritables cartouches ferait fortement augmenter les coûts de fabrication », indiquait le studio. « Nous serions alors contraints d’augmenter le prix de vente d’au moins 15 €. »

Nintendo propose bien une alternative avec les cartes clés de jeu (game-key card) qui s’apparentent à un code de téléchargement mais… physique. Ces cartes sont bien plus abordables pour les éditeurs puisqu’elles ne comportent aucun espace de stockage ; en revanche, elles se transformeront en petit bout de plastique inutile le jour où l’eShop fermera ses portes.

Ça n’arrivera pas demain ni (probablement) dans dix ans, mais la boutique en ligne des Switch finira sans aucun doute par fermer ses portes, tout comme celle de la 3DS et de la Wii U : depuis mars 2023, il n’est plus possible d’acheter de jeux pour ces consoles (les retéléchargements de contenus précédemment achetés restent cependant toujours possibles aujourd’hui). D’ici là, les cartes clés de jeu ont néanmoins l’avantage de pouvoir être revendues en occase ou prêtées à un ami, contrairement aux jeux 100 % dématérialisés.

Moins de capacité, mais un vrai jeu dans la carte

Ce n’est cependant pas suffisant pour de nombreux joueurs, qui rechignent toujours à acheter des cartes clés de jeu ou du dématérialisé. Mais comme on l’a vu avec ININ Games, les « vraies » cartouches reviennent souvent trop chères, ce qui oblige à relever inconsidérément le prix des jeux physiques…

Depuis quelques mois, la rumeur court que Nintendo proposerait aux éditeurs des cartouches pour Switch 2 d’une capacité moindre, et donc plus abordable. ININ avait ainsi annoncé sur les réseaux sociaux, avant de supprimer le post, que Nintendo proposait désormais deux nouveaux formats de cartouches de plus petite capacité, de 16 et de 32 Go ajoutait le compte Does It Play?. Le surcoût de cette version physique revenait à 10 euros, 50 % de moins qu’une cartouche 64 Go.

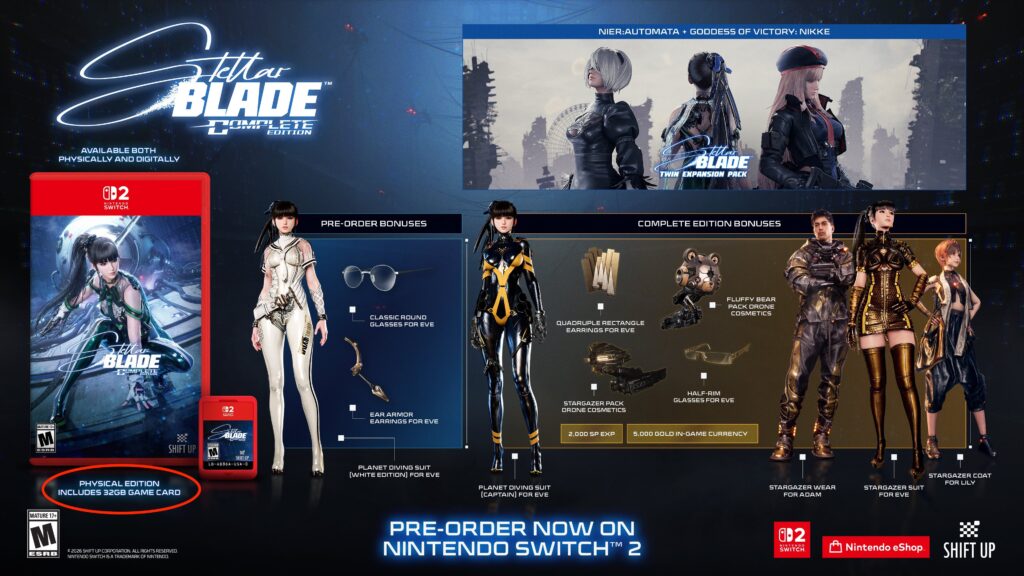
Difficile d’en savoir plus depuis, Nintendo étant notoirement adepte du plus grand secret. Très peu de jeux Switch 2 sortent sur cartouche. Beaucoup d’éditeurs préfèrent la carte clé de jeu, voire les « codes dans la boîte » ou tout simplement l’eShop. Mais l’histoire a rebondi tout récemment avec l’annonce par le studio Shift Up du lancement le 5 novembre de Stellar Blade, portage pour Switch 2 d’un jeu PS5.

Non seulement la version physique est une cartouche en bonne et due forme mais surprise, celle-ci est d’une capacité de 32 Go, comme on le voit sur le visuel de l’édition complète. Une hirondelle ne fait pas le printemps et rien ne dit que d’autres éditeurs vont suivre – ce qui coûtait déjà cher l’an dernier ne doit pas être spécialement meilleur marché aujourd’hui en raison de crise de la mémoire. Néanmoins, c’est bien la première fois qu’un studio communique aussi librement sur la capacité de la cartouche.

  •  
❌