Depuis l’incident impliquant Hugging Face, OpenAI marche sur une corde raide. L’entreprise est lancée dans un délicat jeu d’équilibrisme, entre pression sur la publication de données techniques et la nécessité financière de ne pas perdre la confiance du public. OpenAI prépare également son entrée en bourse et a besoin que sa valeur reste au beau fixe. Le 15 septembre, le Financial Times, cité par Bloomberg, évoquait ainsi un prochain tour de table qui valoriserait OpenAI à plus de 1 200 milliards de dollars. Interrogé sur le sujet, Sam Altman avait répondu que l’opération n’aurait pas lieu avant 2027.
La machine commence cependant à se gripper. Le narratif bâti sur le marketing de la peur et la foi inébranlable sur l’avenir de l’IA et des agents se fissure face à une pluie de critiques. Beaucoup remettent en question la volonté affichée de ralentir le développement des modèles de frontière pour se concentrer sur l’élaboration d’un cadre réglementaire. La Maison-Blanche n’a pas caché son hostilité à cette idée notamment.
Illustration : Flock
Le 21 septembre, le secrétaire au Trésor américain Scott Bessent est même allé plus loin au micro de CNBC : l’incident Hugging Face revient selon lui à « la responsabilité de la direction d’OpenAI, pas d’un tas d’agents ». Il a indiqué partager l’analyse de Daniel Huttenlocher, co-directeur d’un laboratoire de recherche du MIT, pour qui les humains sont responsables, et non l’IA. Ces entreprises « doivent assumer leurs responsabilités », a ajouté Scott Bessent.
Cette déclaration n’est pas isolée. Elle prolonge la position que Bessent avait défendue le 15 septembre devant la commission des services financiers de la Chambre des représentants, souligne CNBC. Le secrétaire au Trésor s’y était opposé à toute exemption de responsabilité légale pour les entreprises d’IA, estimant qu’elle servirait davantage leurs intérêts commerciaux que la sécurité du public.
La prise de position est loin d’être anodine, car elle qualifie l’incident de défaillance de gouvernance humaine, plutôt que d’illustration de la puissance intrinsèque de leurs agents et de leurs comportements imprévisibles. Le 2 septembre, nous relevions d’ailleurs les mêmes éléments, en soulignant que le rapport complet d’OpenAI montrait effectivement une succession de défaillances humaines.
À noter qu’au cours de la même interview, le secrétaire au Trésor a indiqué la possible mise en place d’un téléphone rouge avec Pékin sur les questions, et la possible nomination d’un nouveau « tsar de l’IA » pour gérer ce type de dossier.
Le problème des TV connectées s’étend au-delà des téléviseurs LG pointés ces dernières semaines. Si le constructeur coréen a essuyé l’essentiel des critiques, plusieurs observateurs rappellent que la problématique est en place depuis longtemps.
Tout est parti d’une série de vidéos de la chaîne Gamers Nexus. Elle y expose ses découvertes sur plusieurs téléviseurs TV OLED de la marque LG. Dans les grandes lignes : les modèles testés sont bavards, possèdent des réglages de vie privée inutilement complexes et possèdent des failles de sécurité importantes. Ces dernières, quand elles sont exploitées, permettent de modifier jusqu’aux mots d’activation pour la reconnaissance, permettant l’écoute dans la pièce.
LG a réagi il y a peu via un communiqué, accusant essentiellement ces vidéos de mentir et de vouloir répandre la peur. Gamers Nexus a répondu à son tour, détricotant les arguments de l’entreprise, jusqu’à faire intervenir un avocat dans la vidéo. Selon ce dernier, les mots ont été soigneusement choisis par LG dans son communiqué, notamment sur la collecte de données alimentant l’ACR (reconnaissance automatique de contenu), mécanisme permettant de faire remonter les habitudes de visionnage par télémétrie.
L’ACR a concentré l’essentiel des critiques, jusqu’à faire remonter des constatations vieilles de plusieurs années, dont la capture active des signaux sur la liaison HDMI. Ainsi, l’ACR intervient également quand le téléviseur est utilisé comme simple écran, mais les informations ne peuvent pas être émises si l’appareil n’est pas connecté à internet.
Un vieux problème
Dans notre dernier article sur le sujet, nous relevions que LG était possiblement dans une position inconfortable. Il est en effet difficile d’éteindre l’incendie autour des questions de vie privée sans évoquer l’ACR, et ce mécanisme ne peut pas être abordé sans jeter tout le reste de l’industrie sous le bus. Dans ce domaine, LG est un constructeur parmi d’autres, même s’il jouit d’une présence importante, grâce à la renommée de ses dalles. Gamers Nexus évoque ainsi un parc de 216 millions de téléviseurs connectés dans le monde.
Chez The Verge, John Higgins est spécialisé dans les tests de TV et de matériel audio. Pour notre confrère, la situation est claire : « Ce n’est pas seulement LG. Toutes les chaînes de télévision vous espionnent ». L’une des clés selon lui pour comprendre le problème est la concurrence féroce que se livrent les constructeurs. Elle a entrainé une chute constante des prix des TV, « au point que certaines entreprises les vendent à perte », affirme John Higgins.
Il rappelle que les techniques d’ACR sont en place depuis longtemps, ces empreintes étant d’ailleurs utilisées pour d’autres buts que la publicité, par exemple les études d’audience par des entreprises comme Nielsen. Ces mécaniques sont omniprésentes dès que l’on parle d’un téléviseur connecté. Il indique d’ailleurs procéder toujours de la même manière pour ses tests : une adresse Gmail jetable, la désactivation de tout ce qui peut l’être pour la publicité, l’acceptation des conditions pour la reconnaissance que lorsqu’il veut tester la fonction, etc.
Dans une utilisation quotidienne, il recommande globalement la même approche, voire davantage : « Pour aller plus loin, coupez le Wi-Fi, débranchez le câble Ethernet de la télévision et utilisez-le essentiellement comme une télévision simple ». Il recommande alors de passer par un appareil de streaming dédié. Dans son cas, une Apple TV 4K : « Non pas parce que je pense qu’Apple ne récolte pas de données, mais parce qu’elle n’utilise pas ACR et que je fais plus confiance à ses protocoles de sécurité qu’à n’importe quel fabricant de téléviseurs ou Google ».
Un petit avertissement contre Gamers Nexus
Pour John Higgins, « il n’y a vraiment aucun moyen de se protéger complètement contre la collecte de données de votre télévision, de votre appareil de streaming ou des services de streaming ». Il estime qu’il y a tout simplement trop d’argent « gagné au détriment des consommateurs », le changement ne pouvant venir que des gouvernements.
Interrogé par le journaliste, Thorin Klosowski, de l’Electronic Frontier Foundation (EFF), abonde : « Nous avons besoin d’une loi fédérale complète sur la vie privée qui couvre ce type de collecte et d’utilisation abusive de données. Plus précisément, un appareil nécessitant un consentement volontaire, sans astuces de conception trompeuses pour obtenir ce consentement, et une exigence de minimisation des données, ce qui limiterait les entreprises à n’utiliser les données que pour ce qui est nécessaire à la fourniture du service ». En Europe, ces questions sont régies par le RGPD.
Si John Higgins regrette que les consommateurs doivent se « protéger activement des entreprises » vendant les produits, il regrette aussi le ton employé parfois par Gamers Nexus. Il note par exemple que les reproches les plus graves faits à LG sont basés sur l’exploitation d’une faille permettant l’obtention d’un accès root.
Le constructeur peut être critiqué sur ces problèmes de sécurité, selon lui, mais pas sur les usages faits de ces failles, puisqu’un accès root permet de réaliser pratiquement n’importe quelle opération. En Europe, ces questions sont justement à la source du Cyber Resilience Act, qui entrera pleinement en vigueur en décembre 2027. En outre, s’il ne remet pas en cause les découvertes « accablantes » réalisées par la chaîne, John Higgins regrette l’emploi d’expressions comme « ça pourrait » ou « nous pensons ».
Reste que les vidéos de la chaîne et la couverture médiatique au sens large auront remis au goût du jour le sujet. « À moins de se déconnecter complètement et de vivre dans une cabane en forêt avec une simple télévision et une collection de blu-rays, le mieux que nous puissions faire est de limiter autant d’informations partagées que possible », conclut The Verge.
SpaceXAI a lancé son nouveau modèle Grok 4.7 ce 21 septembre. Si Elon Musk vantait l’arrivée de cette version, les résultats indépendants ne semblent pas à la hauteur des attentes. En revanche, le LLM garde pour lui l’avantage d’une tarification plus douce que certains des gros modèles lancés ces derniers mois.
Mise à jour du 23 septembre : Dans la version originale de l’article, nous avons mentionné les prix sans évoquer la consommation de tokens à l’usage. Nous avons modifié cette partie, Grok 4.7 se révélant nettement plus verbeux que son prédécesseur, avec des conséquences sur la facture.
Article original du 22 septembre :
La version 4.7 de Grok repose sur un nouveau modèle de base, plus grand que pour Grok 4.6. Dans son annonce, SpaceXAI indique qu’il a été entraîné par renforcement plus longtemps, sur des tâches plus difficiles, avec un accent sur les problèmes qui demandent plusieurs heures de travail. L’entreprise affirme que le modèle vérifie mieux son propre travail et gère mieux les contextes longs. Le modèle a aussi été entraîné pour fonctionner nativement dans l’environnement Grok Bot.
Dans la documentation fournie, on peut lire que le modèle grok-4.7 dispose d’une fenêtre de 500 000 jetons (tokens), ses connaissances s’arrêtant en mai 2026. Sans surprise, le LLM est multimodal (texte et images en entrée) et produit du texte en sortie. On retrouve en outre les quatre mêmes niveaux de raisonnement : bas, moyen, haut (par défaut) ou très haut (xhigh). Appel de fonctions, recherche web ou sur X, ou encore exécution de code sont autant de possibilités mises en avant par SpaceXAI.
La société d’Elon Musk met en avant de nombreuses qualités en phase avec les discussions actuelles autour de la sécurité. Elle évoque par exemple « de solides capacités de défense cyber » tout en gardant « de faibles taux de refus d’utilisation légitime ». Grok 4.7 aurait obtenu le score le plus élevé sur HackberBench 0.3 et n’aurait autorisé que 3,3 % des prompts risqués. En outre, le nouveau LLM se montrerait plus robuste face aux tentatives de jailbreak.
Des performances en deçà des attentes
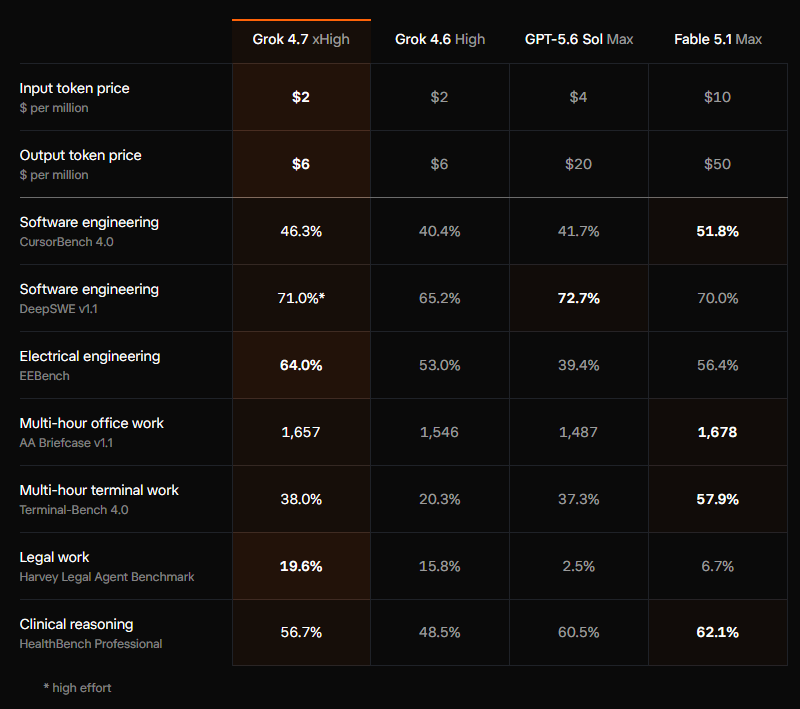
Sur le chapitre des performances, la situation est plus complexe. Selon les chiffres avancés par l’entreprise, Grok 4.7 se débrouille bien sûr très bien. Cependant, on remarque vite que le tableau donné par SpaceXAI ne compare pas toujours les mêmes éléments. Par exemple, Grok 4.7 est testé en mode de raisonnement xHigh alors que Grok 4.6 est testé en High.
Source : SpaceXAI
Cela n’empêche pas l’entreprise de revendiquer de très bonnes performances, surtout face à son modèle précédent et dans des domaines particuliers. « Grok 4.7 est meilleur pour créer des documents et des présentations. Dans GDPval et AA Briefcase, l’IA est sollicitée pour travailler sur des tâches réalisées par des professionnels tels que des avocats, des infirmiers et des analystes financiers. Grok 4.7 améliore Grok 4.6 sur les deux benchmarks et se comporte de manière comparable à d’autres modèles Frontier », affirme ainsi SpaceXAI.
Sur X, on trouve déjà de nombreux commentaires et tests réalisés, plus ou moins spécifiques. Côté positif, on note par exemple le tweet d’Auggie qui relève un taux de 100 % sur son test de « détection d’erreurs » sur la musique, un score que seul avait atteint Astra. Le même testeur a en revanche été moins enthousiasmé sur Bach Benchmark (qui demande aux LLM de composer des chorals à quatre voix dans le style de Bach). Si l’on en croit Artificial Analysis, les revendications de SpaceXAI sur la création de documents sont avérées, avec en particulier un bond significatif sur le test Analytical Quality Elo.
Toutefois, les retours négatifs sont plus nombreux. Pour Jose Antonio Lanz par exemple, Grok 4.7 n’a rien d’un mauvais modèle, mais il est derrière la concurrence, particulièrement Astra ou même Sonnet 5 selon les essais réalisés. Il souligne d’ailleurs qu’Elon Musk avait lui-même cherché à diminuer les attentes autour de son modèle, en indiquant dans un tweet le 14 septembre que Grok 4.7 serait davantage à comparer à Opus 5 que 5.1. Il en profite pour annoncer que Grok 4.8 sera une « amélioration notable », que Grok 4.9 sera « probablement » au niveau d’Astra et Fable et que Grok 5 sera « peut-être meilleur que tout le reste ». Plusieurs personnes ont alors fait remarquer qu’OpenAI et Anthropic allaient eux aussi lancer de nouveaux modèles pendant ces laps de temps.
Selon The Decoder, Grok 4.7 obtient 46 à l’indice Artificial Analysis (v4.3.2), qui agrège dix tests. Il se place ainsi en milieu de peloton, derrière Claude Fable 5.1 et GPT-6, à 53 chacun. Sur Terminal-Bench 4.0, l’évaluation donne 26 %, bien en dessous des 38 % annoncés par xAI, et très loin des 60 % atteints par Astra et des 55 % de Fable 5.1.
Tarifs identiques, mais plus gourmand en tokens
Si les performances semblent globalement décevantes, Grok 4.7 se débrouille mieux que son prédécesseur dans la quasi-totalité des scénarios, sans toucher aux prix. On reste donc sur 2 dollars par million de jetons en entrée et 6 dollars par million en sortie. Une variante Fast est disponible, servie par une infrastructure plus rapide, avec une facturation doublée. Elle n’est cependant disponible que via Cursor et Grok Build, pas sur l’API publique. Sur cette dernière, tous les cas d’usage passant par Grok 4.6 ont automatiquement basculé sur le nouveau modèle.
SpaceXAI joue d’ailleurs la carte du rapport performances/prix en comparant sa grille tarifaire à celles de concurrents. GPT-5.6 Sol et Claude Fable 5.1 sont dans la ligne de mire, avec respectivement 4/20 dollars et 10/50 dollars.
Cependant, cette grille tarifaire ne raconte pas toute l’histoire. Selon des tests réalisés par Artificial Analysis, Grok 4.7 est plus gourmand en tokens que son prédécesseur. L’écart est a priori significatif : 81 000 jetons de sortie par tâche Intelligence Index pour Grok 4.7 xHigh, contre 38 000 pour Grok 4.6 xHigh et 27 000 pour GPT-6 Astra Max. Selon Artificial Analysis, Grok 4.7 est particulièrement verbeux, avec 240 millions de tokens générés pendant ses tests, contre une médiane de 88 millions.
Le positionnement général est ainsi celui d’un modèle faisant mieux que Grok 4.6 pour le même prix par tokens, mais possiblement plus lourd sur la facturation et l’usage des quotas. Il n’y a donc pas de rupture, et on reste sur l’interrogation classique du choix du modèle en fonction du scénario d’usage envisagé. Grok 4.7 illustre la manière dont un LLM peut s’avérer plus cher à l’utilisation que son prédécesseur, même quand le prix par token ne bouge pas ou diminue, comme nous l’avions montré avec Opus 4.7 d’Anthropic.
Enfin, on notera que le calendrier des sorties des prochaines versions ne semble pas ralentir, puisque Grok 4.8 serait proposé dans un mois. Une affirmation à prendre avec des pincettes, Grok 4.7 ayant été repoussé plusieurs fois. Le rythme cadre mal cependant avec le positionnement d’Elon Musk sur la nécessité de ralentir le développement des modèles de frontière. Il a publiquement soutenu l’idée de Dario Amodei, CEO d’Anthropic, de calmer le jeu et de réfléchir à un cadre clair pour mesurer l’alignement des modèles. Comme nous l’avions relevé toutefois, ces déclarations d’intentions ne semblent pas suivies d’actions concrètes.

 Connexion