❌

Vue lecture

Nouvelle alerte sur la prolifération de deepfakes nourrissant la désinformation en santé

S'abonner à Next rend le poil doux et brillant
Nouvelle alerte sur la prolifération de deepfakes nourrissant la désinformation en santé

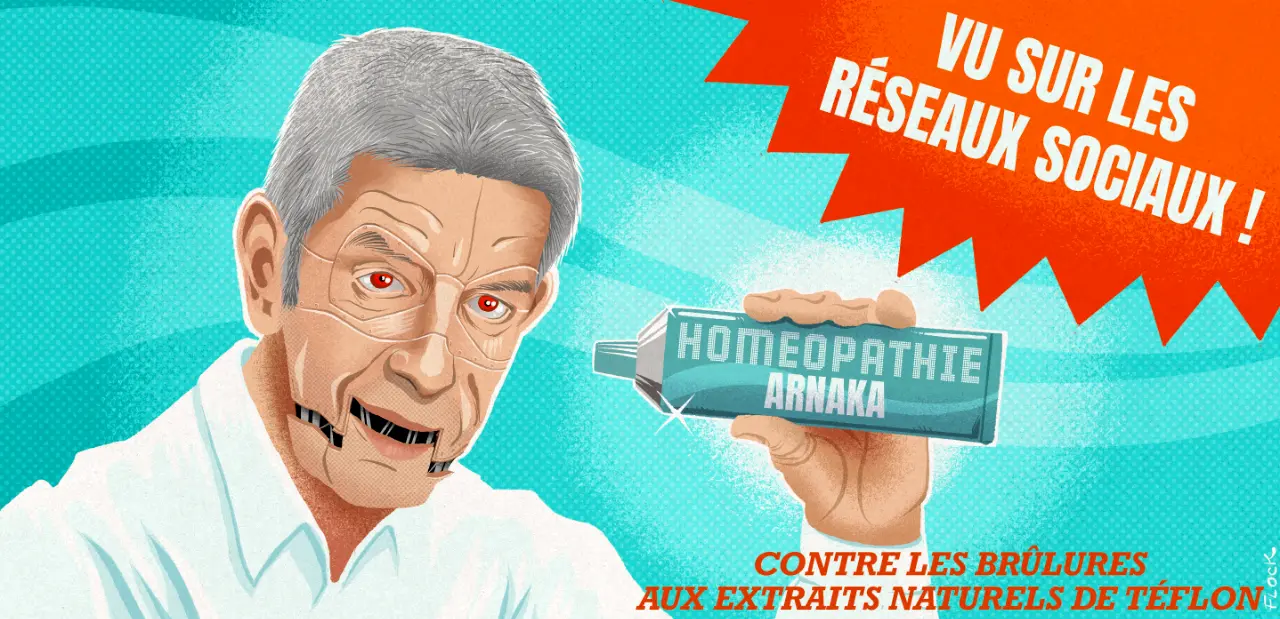
Plusieurs vidéos diffusées sur Facebook contrefaisaient l’image d’une présentatrice de TF1 et d’un médecin des Hôpitaux de Paris pour inciter les internautes à acheter un prétendu remède miracle. L’AP-HP indique avoir porté plainte et demandé le retrait des vidéos concernées à Meta. Elle alerte sur le danger que représentent ces deepfakes en matière de santé publique. Nous nous sommes procuré l’une des vidéos concernées, qui exploite délibérément les codes de la désinformation complotiste.

Dépêchez-vous de lire cette actu avant que Big Pharma ne la fasse supprimer, ils ne veulent pas que vous appreniez la vérité ! L’Assistance publique – Hôpitaux de Paris (AP-HP) et Sorbonne Université ont alerté, lundi 5 octobre, dans un communiqué commun, sur la circulation de vidéos mettant en scène l’un de leurs médecins, dont l’image et la voix ont été manipulées à l’aide de l’intelligence artificielle générative. Un cas typique de deepfake, exploité ici pour assurer la promotion d’une soi-disant recette miracle contre les maux courants qui affectent notamment les personnes âgées.

Des deepfakes dangereux pour la santé des patients

De quoi alarmer l’AP-HP et Sorbonne Université, qui redoutent des conséquences désastreuses. « Au-delà de l’atteinte portée à l’image du médecin et à celle de l’AP-HP, la diffusion de tels contenus constitue un véritable danger pour la santé des patients : ils peuvent conduire des internautes à adhérer à de fausses informations ou à recourir à des produits dont l’efficacité et la sécurité ne reposent sur aucune donnée scientifique », s’inquiètent les deux institutions.

Elles indiquent avoir « déposé plainte et saisi notamment Meta afin d’obtenir le retrait de ces vidéos ». La plateforme semble s’être exécutée mais « d’autres vidéos similaires ont de nouveau été diffusées sur Facebook », s’inquiète l’AP-HP.

Les deux institutions rappellent le devoir de réserve auquel sont soumis ses membres : « En tant que service public hospitalier, l’AP-HP ne fait pas la promotion commerciale de services ou de produits sur les réseaux sociaux ». Et concluent sur un constat désabusé : « l’utilisation de l’image d’un professionnel de santé ou de l’identité visuelle d’un établissement hospitalier ne constitue en aucun cas une garantie de l’authenticité ou de la fiabilité d’une publication ».

Une narration fidèle aux codes complotistes

La vidéo en question, que nous nous sommes procurée, prend la forme d’un faux reportage télévisé d’environ cinq minutes qui usurpe l’identité visuelle de TF1. Introduit par la présentatrice du journal Anne-Claire Coudray, il déroule d’abord le témoignage d’une dame de 82 ans, qui assure avoir exploré sans succès toutes les voies de la médecine conventionnelle pour soulager ses douleurs et ses problèmes de sommeil. Elle enchaine sur sa révélation : ses maux ne sont pas liés au vieillissement ou à une quelconque maladie, mais à la présence de parasites dans son organisme. Elle affirme avoir été, enfin, soulagée par une méthode naturelle.

Le pseudo-reportage embraye ensuite avec la soi-disant intervention du professeur Renaud Piarroux, médecin biologiste, spécialisé notamment en parasitologie et en infectiologie. Le choix de ce médecin ne doit rien au hasard : sans être un habitué des plateaux TV, il compte à son actif de nombreuses interventions dans les médias, particulièrement pendant la période du Covid. Dans la vidéo en question, on voit le professeur Piarroux expliquer d’une voix monocorde que la cause de la plupart des symptômes dont souffre la population n’est « ni le stress, ni l’âge, mais les parasites », dont il est possible de se débarrasser grâce à une méthode simple.

«  La France est en choc !  »

Il enchaîne en affirmant que l’industrie médicale fait tout son possible pour cacher cet état de fait et invoque pour soi-disant preuve que sa vidéo gratuite révélant la vérité a déjà été supprimée plusieurs fois, car si plus de gens connaissaient cette méthode, « plus personne n’achèterait de produits chimiques en pharmacie ». La voix contrefaite poursuit en affirmant que plus de 85 000 personnes se sont déjà soignées grâce à ce secret, et qu’il est urgent de cliquer sur le lien qui accompagne la vidéo pour en profiter tant qu’il est encore temps.

Outre le ton quelque peu mécanique, de nombreux indices sont à même de mettre la puce à l’oreille des internautes avertis, ou même des fidèles des JT de TF1. La réalisation est complètement statique, les images d’illustration reviennent plusieurs fois au cours de la même séquence, et les sous-titres comportent de nombreuses fautes d’orthographe, sans même parler des coupes approximatives ou du bandeau rouge « La France est en choc ! Les parasites sont déjà l’intérieur de vous ! » que même Cnews n’oserait pas.


La vidéo d’origine et ses copies ou variantes ont néanmoins circulé sur plusieurs profils, pages et groupes Facebook, orientés notamment vers les médecines parallèles et les théories antivaccination.

La santé, terrain de jeu propice à tous les détournements

Si l’alerte conjointe lancée par les deux institutions est inédite, l’exploitation de l’image de personnalités du monde de la santé à des fins de désinformation n’est pas une première, loin de là. Avant même l’avènement de l’IA générative, le médecin et animateur TV Michel Cymes relatait déjà en 2020 à quel point il était difficile de faire disparaître de Facebook des publicités usurpant son image.

Depuis, le phénomène s’est encore accentué : au printemps 2024, l’AFP signalait par exemple des campagnes frauduleuses, basées sur des deepfakes générés par IA mettant en scène le même Michel Cymes, mais aussi Didier Raoult et d’autres personnalités médiatiques (Jean Reno, Gilles Bouleau) pour vendre de soi-disant traitements miracles contre le diabète.

D’autres capitalisent sur l’IA pour participer à la vague des influenceurs bien-être, les créateurs de contenu qui profitent de leur popularité pour vendre, ou inciter à acheter, des produits censés guérir certains maux ou améliorer l’apparence physique. Outre-Atlantique, le phénomène a déjà pris des proportions industrielles : en juillet dernier, une enquête du New York Times révélait ainsi la présence, sur les réseaux sociaux, de centaines d’influenceurs virtuels, générés par IA, se faisant passer pour des professionnels de santé à des fins mercantiles.

L’IA sert aussi parfois à allumer des contrefeux. En France, le syndicat des jeunes médecins généralistes ReAGJIR a par exemple entrepris début 2025 d’exploiter l’IA pour contrefaire les vidéos d’influenceurs conseillant des pratiques absurdes ou dangereuses à leurs abonnés. « Ainsi, l’influenceuse qui prônait l’utilisation de gousses d’ail pour arrêter une grippe explique, blême et le nez rougi, avoir été victime d’une infection nasale, tandis que le Tiktokeur qui recommandait l’ingestion de bleu de méthylène explique, le visage bleui, la méthémoglobinémie qui en a résulté », expliquait alors le syndicat, qui conclut ses vidéos par une révélation de la supercherie, et un appel à systématiquement se référer à un professionnel de santé pour tout avis médical.

Reste que, entre quête de viralité, recherche de profits faciles et propension au complotisme, les contenus problématiques continuent à circuler sur les réseaux sociaux, tandis que les plateformes affirment respecter leurs obligations réglementaires en matière de modération. Le ministère de la Santé avait annoncé en janvier 2026 le lancement d’une série de mesures visant à endiguer le phénomène, dont la création d’un « observatoire de la désinformation en santé » qui se fait toujours attendre.
  •  

Mistral lance une préversion de son LLM frontière Mistral Large 4, surnommé « Le Chonk »

Il revient !
Mistral lance une préversion de son LLM frontière Mistral Large 4, surnommé « Le Chonk »

Mistral vient de lancer une préversion publique de son nouveau LLM de frontière Mistral Large 4. Surnommé « Le Chonk », il doit remettre l’entreprise française dans la course, après de longs mois de quasi-silence sur les grands modèles.

Mistral Large 4 affiche 1 050 milliards de paramètres, dont 49 milliards actifs simultanément, dans une architecture MoE (Mixture of Experts) désormais classique. La fenêtre de contexte est d’un million de tokens. Dans sa présentation, Mistral évoque un entraînement depuis zéro sur la base de 3 800 puces Grace Blackwell de NVIDIA dans ses propres centres de calcul en Europe.

S’agissant d’une préversion, l’entrainement est toujours en cours. Mistral indique que d’ici la publication de la version le 26 octobre, une version privée du modèle est mise entre les mains de « partenaires sélectionnés, en leur donnant accès à une version de nos endpoints avec une modération allégée et des fonctionnalités plus avancées dans le domaine de la cybersécurité, et en leur distribuant les poids de la préversion du modèle ». Les poids seront d’ailleurs publiés le 26 octobre également, en même temps que des informations plus précises.

L’entreprise semble sûre de son fait : « Le Chonk fait progresser l’état de l’art des modèles à poids ouverts en matière de fonctionnalités agentiques génériques. Sur les métriques agrégées, il se classe parmi les meilleurs modèles à poids ouverts et est de loin le meilleur en Europe et aux États-Unis. Parmi les modèles à poids ouverts, Le Chonk est à l’état de l’art sur les tâches de cybersécurité, sur les tâches liées à la production industrielle et à la finance, ainsi que sur l’usage multimodal. »

Les benchmarks publiés vont bien sûr dans ce sens, avec 61,7 % sur DeepSWE v1.1, 59,4 % sur SWE-Atlas-QnA et 28,3 % sur Terminal-Bench 4, soit 49,8 % à l’indice combiné, devant DeepSeek V4 Pro 0813 et Qwen3.8 Max. Des scores que l’on retrouve sur Artificial Analysis, qui place ML4 dans la moyenne haute des LLM en matière d’intelligence et de rapidité. En revanche, le site classe le nouveau LLM comme très verbeux. De fait, malgré une tarification intéressante de 1,36 dollar par million de jetons en entrée et 4,18 dollars en sortie, cette verbosité peut avoir une grande influence. Étrangement, Artificial Analysis évoque une fenêtre de contexte de 524 000 jetons, mais ce chiffre pourrait venir d’une préversion antérieure.

Un accent sur la cybersécurité

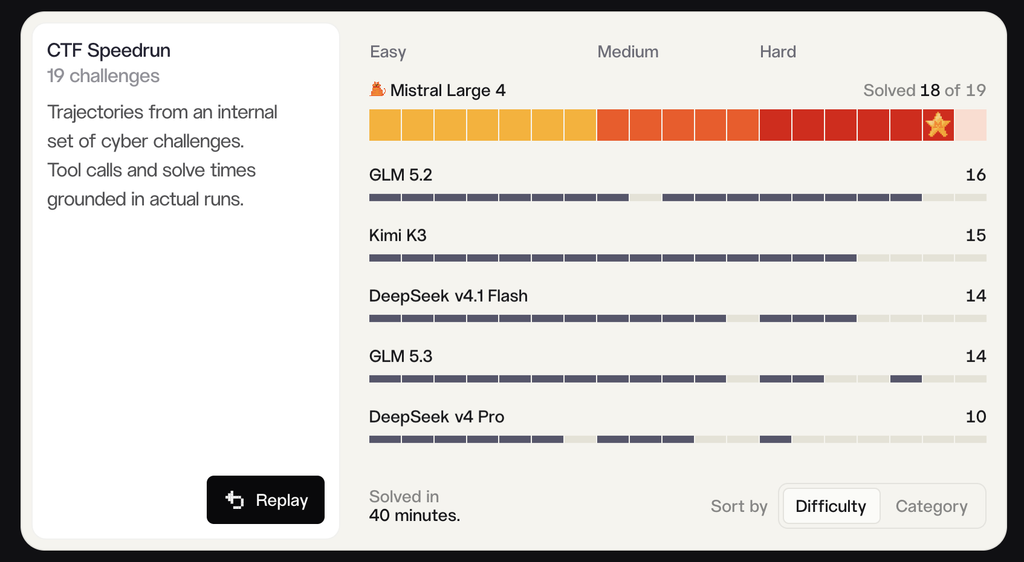
Selon Mistral, ML4 est « l’un des modèles d’IA les plus puissants au monde pour la cybersécurité », classé dans le Top 5 du Cyber Index d’Artificial Analysis, devançant « largement les modèles à poids ouverts développés hors de Chine ». Dans les tests du Cyber Index, ML4 aurait ainsi obtenu 82 %, soit le meilleur score à ce jour, et 93 % sur Cybench, se classant parmi les meilleurs modèles à poids ouverts.

L’entreprise française se fait un plaisir de s’engouffrer dans cette porte ouverte, abordant directement le problème des risques que de telles performances peuvent faire courir. Un quasi non-sujet pour Mistral, car il s’agit avant tout de défense. Elle pointe les modèles fermés comme Claude Opus 5.5 et GPT-6 Astra, qui obtiennent zéro au Cyber Index car ils refusent d’exécuter des tâches.

« C’est d’autant plus important que les acteurs malveillants font de plus en plus de jailbreaks de ces mêmes modèles pour soutenir une cyberactivité offensive : les défenseurs ont besoin de systèmes pouvant égaler ces capacités sans être contraints par les mêmes refus », ajoute Mistral. L’incident Hugging Face n’est pas directement cité, mais on se souvient que l’entreprise s’était plainte de ne pas avoir pu analyser les premières traces de l’attaque qu’elle subissait parce que les modèles fermés se cabraient devant les questions de cybersécurité. Ironie, Hugging Face s’était alors tournée vers un modèle chinois, GLM 5.2.

Enfin, pour le travail de bureau, Mistral indique 59,9 % sur AutomationBench. Sur des tâches financières et juridiques évaluées par vals.ai, il dépasserait GPT-6 Astra, et il est en tête des modèles ouverts sur le test juridique de Harvey. Pour l’ancrage visuel, il obtient 42 % contre 41 % pour GPT-6 Astra sur Dense 200, un écart minime.

De quoi remplacer prochainement GLM 5.3 dans Vibe Code avec un modèle maison ?

  •  

AI Slop : Google met en pause son programme de bug bounty pour le logiciel libre


AI Slop : Google met en pause son programme de bug bounty pour le logiciel libre

Google a suspendu son programme de bug bounty Open Source Software Vulnerability Rewards Program (OSS VRP). L’entreprise explique qu’elle reçoit trop de rapports erronés générés par IA.

Depuis le 1er octobre dernier, Google n’accepte « plus les signalements de vulnérabilités de produits soumis au programme OSS VRP [Open Source Software Vulnerability Rewards Program] », a-t-elle expliqué sur la page dédiée à ce programme.

L’entreprise avait ouvert ce programme spécifique aux logiciels libres en 2022. Elle expliquait à l’époque qu’ « en fonction de la gravité de la faille de sécurité et de l’importance du projet, les récompenses varieront entre 100 et 31 337 dollars ». L’idée était notamment de faire émerger les vulnérabilités de la supply chain, mais aussi les problèmes de design informatique causant des problèmes de sécurité, par exemple.

« Une forte augmentation des soumissions automatisées »

Mais le système mis en place par Google pour recueillir ces signalements (qui peuvent donc être lucratifs pour leurs auteurs) montre des signes de fragilité face à l’affluence des signalements de plus en plus automatisés via l’IA générative. Comme Apple cet été, Google ferme le robinet.

L’entreprise le dit dans un message posté sur X : « Cette interruption est due à une forte augmentation des soumissions automatisées, dont la grande majorité n’est pas valide. Nous allons poursuivre le remaniement et le travail sur cet aspect du programme OSS VRP et nous nous engageons à faire le point au premier trimestre 2027 ».

Tous les programmes de bug bounty de Google ne sont pas touchés : uniquement l’OSS VRP. L’entreprise redirige donc les personnes qui voudraient signaler une faille notamment vers son programme Patch Rewards.

Ces entreprises, qui par ailleurs font la course aux modèles d’IA générative, n’ont pas trouvé la solution pour éviter la submersion de contenus générés par IA de qualité médiocre qui les empêche de traiter convenablement les signalements réellement utiles.

« Impact psychologique considérable »

Mais ce problème touche d’autres organisations. Ainsi, en janvier dernier, le créateur du fameux logiciel libre cURL, Daniel Stenberg, avait annoncé : « Le programme de bug bounty de cURL n’existe plus. Il prendra officiellement fin le 31 janvier 2026 ». « La gestion de ces soumissions incessantes de contenus de mauvaise qualité a un impact psychologique considérable et prend parfois beaucoup de temps à démystifier. C’est du temps et de l’énergie complètement gaspillés, qui sapent en outre notre envie de vivre », expliquait-il.

Du côté de la communauté du noyau Linux, le sujet est vu différemment. Si Linus Torvalds avait pesté un moment contre les nombreux rapports d’erreurs générés par les LLM et peu efficaces, cet été il avait changé d’avis sur le sujet et refusait de rejeter en bloc les rapports d’erreurs générés de la sorte, se disant prêt à peser de tout son poids de mainteneur principal du noyau si nécessaire. Il faut préciser qu’on ne parle pas ici de signalements faisant appel à rétribution. Le système des bug bounty attribuant une récompense aux signalements, avec une somme plus importante en fonction de l’importance du bug pousse sans doute davantage certains à utiliser des systèmes automatisés de signalements de bugs, sans se préoccuper de leur qualité et de la possible submersion du système.

  •  

☕️ Apple veut savoir combien de fois Google fait la pub de Chrome dans Safari


Google ne manque jamais une occasion de faire la promotion de Chrome ou de sa propre application de recherche dans Safari, tout particulièrement sur iPhone. Apple voudrait en avoir le cœur net et mesurer précisément le volume et la fréquence de ces bannières et de ces panneaux souvent envahissants.

Illustration : Flock

La bêta 2 d’iOS 27.2 contient en tout cas des outils de télémétrie pour relever l’usage que fait Google de ces promotions dans Safari, d’après le code découvert par le site 9to5Mac. Cela ne veut pas nécessairement dire qu’ils seront présents dans la version finale d’iOS 27.2, mais leur présence dans la bêta confirme l’expérimentation par Apple de cette fonction.

Safari injecte un script JavaScript dans certaines pages du site de Google : accueil et résultats de recherche. Il cherche les bannières et les éléments visuels qui incitent les utilisateurs à lancer Chrome ou l’app Google. Lorsqu’une de ces promotions est détectée, le navigateur peut enregistrer plusieurs informations : si elle a été affichée, si l’utilisateur a interagi avec elle, ou encore s’il semble connecté à un compte Google.

Apple est ainsi en mesure de déterminer si l’utilisateur a accepté ou ignoré les sollicitations de Google. Reste à savoir pour quoi faire. 9to5Mac avance l’idée que ces outils pourraient être indispensables dans un cadre réglementaire. Dans l’UE, le règlement sur les marchés numériques oblige Apple à proposer aux internautes le choix du navigateur et du moteur de recherche. Mais pourquoi dans ce cas se limiter à Chrome ?

Le constructeur informatique n’a en tout cas rien officialisé ni documenté la fonction.

  •  

☕️ La Norvège va interdire temporairement les lunettes connectées dans certains lieux publics


Le gouvernement norvégien avait déjà annoncé qu’il voulait durcir la législation du pays concernant l’utilisation des lunettes connectées alors que la grogne s’amplifie contre les lunettes Meta un peu partout. Il explique maintenant que ce durcissement devrait passer par une « interdiction temporaire » de ces lunettes dans certains lieux publics.

« Le temps de mener une étude approfondie et d’avoir un débat éclairé qui pourra jeter les bases d’une réglementation durable », précise le ministre de la Numérisation et de la Gouvernance publique, Torgeir Micaelsen, qui semble reprendre le dossier des mains de la ministre chargée du numérique, Karianne Tung. Celle-ci avait montré des signes de réticence à toute nouvelle législation sur le sujet au début de l’été.

Sans qu’un texte de loi ne soit encore rédigé, le communiqué évoque comme potentiels lieux interdits à ces lunettes les parcs, les plages, les musées, les aires de jeux, les parcs d’attractions, ainsi que les manifestations sportives, musicales et culturelles. Les lieux de scolarisation de la maternelle au lycée, voire aux établissements d’enseignement supérieur devraient figurer dans la liste aussi.

L’interdiction de ces lunettes connectées ne serait pas totale en Norvège. Le gouvernement évoque, comme l’explique Reuters, la possibilité de les utiliser dans des lieux purement privés et certains endroits où l’utilisation ne présente aucun risque d’être filmé sans son consentement.

  •  

Google commencerait à payer les sites web pour les contenus utilisés dans les Aperçus IA

Un prix à la tête du contenu
Google commencerait à payer les sites web pour les contenus utilisés dans les Aperçus IA

Les « aperçus IA » qui s’affichent en tête des résultats d’une recherche Google sont générés à partir de contenus produits par des sites web. Après avoir capté une partie de leur trafic grâce à ces résumés, Google aurait commencé à rémunérer des éditeurs pour leurs contenus.

Avec les AI Overviews (Aperçus IA en France), Google prive les sites web d’une partie de leur trafic et donc, de leurs revenus publicitaires. Les internautes ne sont plus incités à se rendre sur ces sites, se contentant bien souvent des résumés générés par IA. C’est la double peine pour les éditeurs, qui se font voler à la fois leurs contenus et leurs lecteurs. Et cela explique aussi la méfiance de plus en plus grande de plusieurs d’entre eux, qui envisagent tout simplement de couper les ponts avec le moteur de recherche dominant.

Fin 2025, la Commission européenne ouvrait une enquête sur Google, accusé de fausser la concurrence en imposant des conditions abusives aux éditeurs et aux créateurs de contenu qui désavantagent les développeurs d’IA concurrents.

Poussé par les régulateurs, Google a dû mettre en place cet été un réglage permettant aux éditeurs d’interdire la collecte de leurs articles pour entraîner les modèles IA de l’entreprise. Tout en autorisant tout de même l’indexation de ces mêmes articles, pour les intégrer dans les résultats de recherche classiques.

Le baiser de la mort

Mais avant de générer des aperçus IA, faut-il encore avoir la matière première : les contenus. Et Google a toujours besoin des sites web. Le site The Information rapporte l’existence d’un programme pilote lancé il y a moins d’un an ; il rémunère une centaine d’éditeurs de sites web. Les sommes varient en fonction de la contribution de leurs contenus aux réponses générées par l’IA dans son moteur de recherche, ainsi que dans le mode IA et dans le chatbot Gemini.

Un éditeur anonyme aurait, depuis son inscription au programme, touché entre 50 000 et 60 000 dollars, ce qui ne représente qu’une petite partie de son activité. Un autre perçoit plus d’un million de dollars par an, ce qui est une part plus significative de son chiffre d’affaires. Les sommes peuvent sembler importantes, mais tout dépend de la taille des éditeurs et de leurs rédactions. Certains sites doivent se contenter de moins de 1 000 dollars sur plusieurs mois.

Pour les petits sites qui participent à ces tests, les sommes versées par Google pèseraient pour moins de 0,1 % de leurs revenus publicitaires, d’après les sources de The Information. La petitesse de ces enveloppes auraient même dissuadé des éditeurs plus importants de se lancer. Ce faisant, ils espèrent pousser Google à mieux valoriser les contenus utilisés pour l’entraînement des IA.

Un modèle pour le secteur de la presse en ligne ?

Plus pragmatiques, d’autres éditeurs espèrent comprendre le type de contenus favorisés par Google et son IA, afin d’optimiser leurs articles et profiter de la manne. Un dirigeant d’un éditeur indique que Google décide seule de la valeur des contenus afin de garder le mystère sur la boîte noire de son système de génération IA.

Des participants au programme n’auraient aucune idée de la manière dont Google calcule les rémunérations, ni ce que Google considère comme une contribution significative à un aperçu IA. Des contenus consacrés à des sujets niches (comme les anime ou les jeux vidéo) mais suscitant un fort intérêt de la part des internautes, semblent toutefois rapporter davantage.

Beaucoup des participants espèrent que ce programme fera figure de modèle à suivre pour les autres acteurs de l’IA qui ont tendance à jeter par dessus bord le copyright au nom d’un « usage légitime » qui a parfois bon dos. Il faudra au préalable que Google officialise l’initiative et que davantage d’éditeurs y participent.

  •  

☕️ [MàJ] Finlande : Google contraint de mettre en pause ses projets de datacenter


Mise à jour, mercredi 7 octobre, 12h20 : La Finlande a finalement pris le mors aux dents et décidé, dans une déclaration datée du 6 octobre, de contraindre Google et sa filiale locale, Tuike Finland Oy, à suspendre les travaux d’édification des datacenters de Muhos et de Kajaani, en attendant que les études d’impact environnemental aient été menées à leur terme.

Les deux décisions associées (une par datacenter) émanent de l’Agence nationale responsable des licences et de la supervision, l’organisme chargé, entre autres missions, de la supervision de la protection de l’environnement. D’après cette dernière, des travaux concrets de déforestation ont été engagés avant qu’elle ait pu procéder aux évaluations prévues par la loi finlandaise sur l’environnement. Elle ordonne donc l’interruption des travaux, et affirme s’efforcer principalement « de veiller à ce que l’exploitant remédie volontairement à la situation ».

Le message semble avoir été entendu par Google. « Nous comprenons les préoccupations et reconnaissons ne pas avoir été à la hauteur de nos propres exigences dans ce cas précis », a déclaré un porte-parole de l’entreprise à CNBC. Le groupe défend cependant le bien-fondé de son approche. « Nous avons agi de bonne foi, conformément à la loi forestière, et avons réalisé des inventaires de la nature et mis en place des mesures pour protéger les zones à haute valeur écologique », ajoute le porte-parole.


Publication initiale, mardi 6 octobre, 10h50 :

Au nord de la Finlande, plus de 300 hectares de forêts ont été rasés pour permettre la construction d’un ensemble de centres de données pour Google. Ceci avant même que le projet n’ait obtenu l’audit environnemental que le régulateur national l’avait enjoint à réaliser, rapporte Wood Central.

« C’est soit de l’incompétence grossière de la part de la société chargée du projet finlandais de Google, Tuike Finland Oy, soit un dédain grossier de la réglementation finlandaise. Dans le pire des cas, c’est les deux », estimait la directrice de l’Association finlandaise pour la conservation de la nature Hanna Halmeenpää auprès du média Kaleva, mi-septembre.

Au mois d’avril, la filiale finlandaise de Google avait argumenté auprès du régulateur qu’elle n’avait pas besoin d’audit environnemental. Elle espérait pouvoir obtenir ses permis de construire en l’absence de ces travaux. 


En mai, l’administration l’a détrompé : le projet devait suivre le cours normal des autorisations, dans la mesure où la loi locale oblige à des audits environnementaux pour tout rasage permanent de forêt sur plus de 200 hectares.

Illustration : Flock

Des images satellites montrent que des coupes ont néanmoins été menées entre le mois de mai et le mois d’août, en l’absence des travaux demandés par le régulateur.

Ces images montrent aussi que quatre sites naturels supposément protégés dans le plan local d’urbanisme ont été passés au bulldozer. L’association finlandaise pour la conservation de la nature déclare n’avoir jamais rencontré de cas comparable en 86 ans d’existence.

Directrice de l’enquête ouverte par l’Autorité finlandaise en charge des licences et de la supervision, Sari Myllyoja indique que son unité explorerait les réactions possibles.

Localisé dans les villes de Muhos et Kajaani, le projet s’étend sur 1400 hectares, vendus il y a deux ans à Google par le gouvernement finlandais. La société américaine a annoncé investir 13 milliards de dollars pour y construire des centres de données, ce qu’elle déclare être son plus gros investissement unique en Europe.

Fin septembre, la municipalité de Muhos informait l’Autorité des licences et de la supervision qu’elle n’avait fourni aucun permis de construire pour ces travaux. L’équipe de Sari Myllyoja déclare attendre les clarifications de la filiale de Google pour comprendre en vertu de quels permis celle-ci a lancé ses travaux.

  •  

☕️ Lookups : la ministre du Numérique signale un nouveau site de données volées au parquet


Anne Le Hénanff, ministre déléguée chargée de l’intelligence artificielle et du numérique, a annoncé lundi 5 octobre avoir saisi la procureure de Paris, au titre de l’article 40 du code de procédure pénale, au sujet d’un moteur de recherche donnant accès à des données personnelles issues de fuites de cybersécurité. C’est la deuxième fois que la ministre recourt à cette procédure depuis le mois de juin.

Les sites en question, parfois déclinés sous forme de canaux Telegram ou Discord, permettent pour mémoire d’effectuer des recherches nominatives dans des bases de données agrégées à partir des fichiers issus de fuites de données.

Historiquement cantonnés au dark web et souvent qualifiés de « lookups », ils s’affichent désormais sur le web ouvert, et développent de véritables offres commerciales avec abonnement, accès via API, ou promesse d’effacement des données personnelles contre monnaie sonnante et trébuchante.

La portée d’une telle action parait toutefois limitée : elle restreint peut-être la visibilité sur le moteur de recherche en question, mais elle ne garantit absolument pas que les données concernées continuent de circuler via les fichiers d’origine. « Aux personnes concernées, ne payez jamais pour faire retirer vos données », appelle la ministre.

un portrait de la valeur des données biométriques pour un pirate
Illustration : Flock

L’avertissement est justifié. Confier des données personnelles à ces moteurs, pour s’inscrire ou pour souscrire leurs services payants, constitue en effet un risque supplémentaire, puisqu’elles peuvent servir à consolider les informations déjà présentes en base.

La déclaration d’Anne Le Hénanff intervient quelques jours après que le sujet des lookups est revenu sur le devant de la scène médiatique, notamment en raison d’articles de RTL, relayés par M6, illustrant comment ces outils permettent de mettre au jour les informations personnelles ou les coordonnées de personnalités publiques.

Le phénomène et son exposition n’ont pourtant rien de nouveau. En juin, une enquête de France Info avait mis en lumière une autre plateforme qui revendiquait l’accès à 1,2 milliard de données personnelles.

Comme nous le relations alors, la ministre du Numérique avait déjà annoncé à cette occasion saisir le parquet de Paris, déjà au travers de l’article 40. Le député Renaissance des Côtes-d’Armor, Éric Bothorel, avait lui aussi déclaré avoir saisi la justice « pour 3 sites qui compilent des fuites de données et les rendent publiques », tout en rappelant que « le recel de data volées est un crime ».

Si d’après France Info, aucune condamnation n’avait encore été prononcée dans une affaire de lookups au 21 août dernier, le parquet n’ignore pas le sujet et n’a d’ailleurs pas attendu la médiatisation du phénomène pour s’y intéresser. En mai dernier, on apprenait ainsi que l’administrateur présumé d’un de ces moteurs de recherche avait été mis en examen et placé en détention provisoire.

  •  

En Europe, OpenAI tatoue les textes de ChatGPT pour se conformer à l’AI Act

Si c'est tatoué, c'est pas à toi
En Europe, OpenAI tatoue les textes de ChatGPT pour se conformer à l’AI Act

OpenAI déploie son outil de filigrane sur le texte généré par ChatGPT. Cette fonctionnalité, réservée au Vieux continent en vertu de l’AI Act, demeure une solution imparfaite à un problème complexe.

Après Anthropic qui a intégré une fonction de filigrane dans le texte généré par Claude (depuis Fable 5.1 plus précisément), c’est au tour d’OpenAI de respecter l’obligation européenne de permettre l’identification d’un texte généré par ChatGPT. Cette mesure, inscrite dans l’AI Act, est en vigueur depuis début août – les systèmes d’IA présents sur le marché ont jusqu’au 2 décembre pour respecter les obligations de marquage technique.

Le filigrane est dans les mots

OpenAI a donc dévoilé sa feuille de route pour le tatouage des textes. La technologie, baptisée textGrain, ajoute un « signal statistique invisible » sur les choix des mots. Autrement dit, c’est une technique qui « modifie subtilement la manière dont le modèle choisit de façon aléatoire entre plusieurs mots ou fragments de mots possibles au fil de la génération [du texte] », explicite l’entreprise dans une fiche technique.

« Sur l’ensemble d’un passage, ces choix créent un motif qu’un détecteur peut repérer, même après certaines modifications du texte. » Le résultat est censé être invisible aux yeux du lecteur, la technique n’ajoutant « aucun caractère caché, espace invisible ou signe de ponctuation inhabituel ». Anthropic a choisi une solution similaire.

Pangram, qui a beaucoup fait parler ces dernières semaines suite à l’affaire Thélyson Orélien, analyse les textes après leur génération, en se basant sur des caractéristiques comme le choix des mots. Il ne détecte pas les signaux intégrés à même les textes, comme c’est le cas des filigranes.

Toutes les langues ne se valent pas

Le code des bonnes pratiques sur la transparence des contenus de l’AI Act n’impose pas de watermark sur les textes de moins de 200 tokens, ce qui représente environ 150 mots en anglais. De toute manière, les techniques de filigrane ne sont pas efficaces sur les textes courts, comme le rappelle OpenAI.

Image : OpenAI

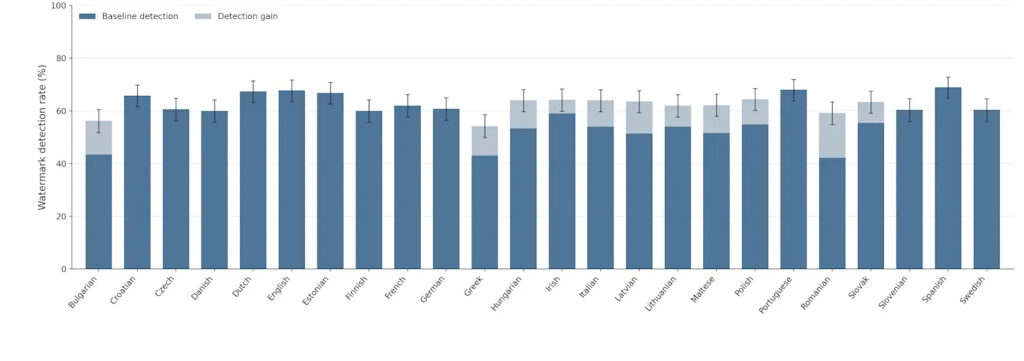
Le taux de détection varie en fonction de la langue, certaines d’entre elles se montrant « plus faciles à détecter que d’autres ». Sur les tests réalisés par l’entreprise – 500 prompts générés en anglais, puis traduits –, l’espagnol obtient le meilleur taux de détection (69 %), le roumain affichant le taux le plus faible (42,2 %). Avec un taux qui dépasse 60 %, le français est plus proche de l’espagnol.

OpenAI ajoute à textGrain un paramètre d’ajustement de l’intensité pour renforcer ou réduire le signal du filigrane en fonction des domaines. Le taux de détection de certaines langues, qui se situe normalement sous le seuil des 60 %, s’améliore grâce à ce paramètre. L’entreprise a l’intention de proposer sa technologie en open source.

Image : OpenAI

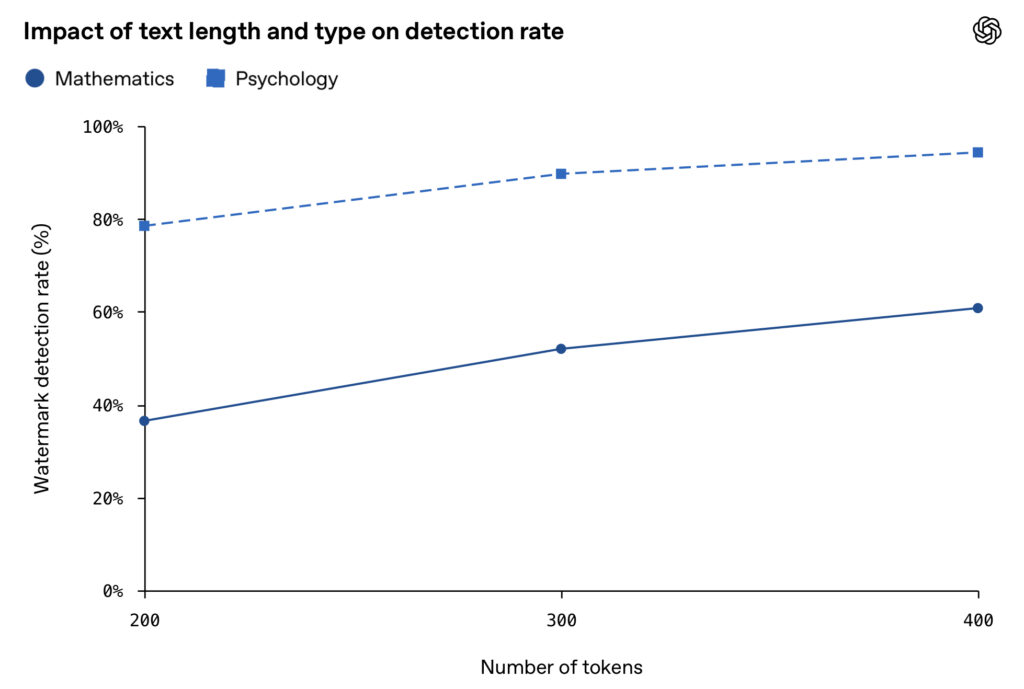
OpenAI explique que les détecteurs peuvent commettre deux types d’erreurs de détection : faux positifs (signaler la présence d’un filigrane qui n’existe pas) et faux négatifs (ne pas repérer la présence d’un filigrane existant). Sur des passages de 400 tokens, avec un taux de faux positifs cible de 1 %, le détecteur a identifié un filigrane dans 95 % des cas – mais tout dépend du contenu. Sur les textes portant sur la psychologie, le taux de détection est particulièrement élevé ; il l’est beaucoup moins quand il s’agit de mathématiques, où le choix des mots est plus limité.

Brouiller les pistes

Autre limite : modifier les textes générés par IA a un impact sur le taux de détection. Un taux de détection à 92 % peut tomber à 66 % si 10 % des mots ont été remplacés par des synonymes. Remplacer 25 % des mots fait chuter le taux à 17 %. Ce qui est logique, au vu du fonctionnement du filigrane.

L’entreprise prévient aussi que les filigranes sur le texte ne sont pas la panacée. Un watermark ne mesure pas la contribution d’un humain, il se contente de dire qu’un modèle a généré ou modifié un texte. Il ne détermine pas non plus à qui appartient le texte ou qui en est le responsable. Il n’identifie pas non plus l’utilisateur et ne mesure pas la fiabilité du texte. Enfin, l’absence d’un filigrane ne prouve pas qu’un texte a été écrit par un humain.

textGrain est disponible dès aujourd’hui dans l’API, où la fonction peut être activée via les réglages (uniquement dans l’UE). Il se déploiera au sein de ChatGPT et Codex dans les prochaines semaines. En revanche, l’accès à l’outil de détection demeure encore la chasse gardée des chercheurs et des organisations sélectionnés qui travaillent à l’amélioration de la fiabilité de l’outil.

  •  

Meta : Muse se souvient de beaucoup de choses sur l’utilisateur, mais aussi ses proches

Tous fichés
Meta : Muse se souvient de beaucoup de choses sur l’utilisateur, mais aussi ses proches

ChatGPT, Claude ou Gemini ont une mémoire qui leur permettent d’enregistrer certaines informations importantes sur leurs utilisateurs, afin de se « souvenir » d’un détail, d’un nom, d’un événement ou d’une date utile à une réponse. C’est le cas aussi de Muse, mais le nouvel agent de Meta pousse le principe beaucoup plus loin.

Avec Muse, Meta semble enfin avoir trouvé sa voie dans la course à l’IA. L’agent, lancé le 6 septembre mais toujours indisponible dans l’Union européenne, va bien plus loin qu’un « simple » chatbot : il peut chasser des informations sur internet en permanence et agir au nom de l’utilisateur, par exemple pour réserver un restau ou faire des courses (ce qui déplaît beaucoup à Amazon). Le succès de Muse ne tombe pas du ciel : Meta s’est fortement inspirée d’OpenClaw pour développer son propre agent. Et l’entreprise peut aussi compter sur l’immense surface de ses réseaux sociaux pour se donner une confortable longueur d’avance.

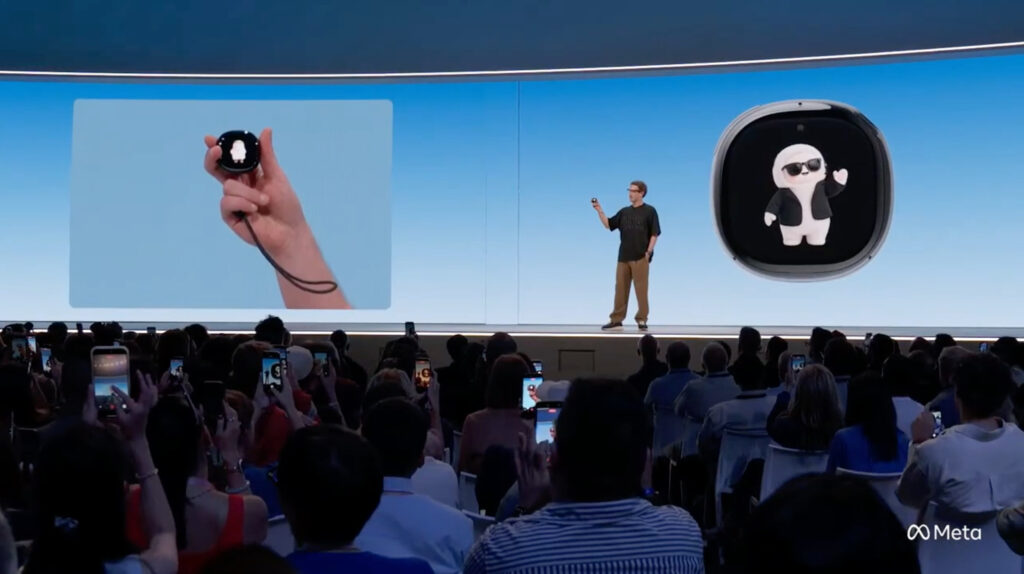
Le Charm dévoilé par Mark Zuckerberg durant la dernière conférence Meta Connect.

Le succès de Muse n’est pas tombé dans l’oreille d’un sourd : OpenAI a présenté pas plus tard que la semaine dernière son propre agent IA, Dots. Et Meta compte bien battre le fer tant qu’il est chaud. Muse est mis à toutes les sauces dans les autres produits et services du groupe, qu’il s’agisse de lunettes connectées… ou de Tamagotchi.

Les petites fiches de Muse

Mais Meta traîne derrière elle suffisamment de casseroles sur la vie privée pour que le fonctionnement de Muse mérite qu’on y regarde de plus près. Karan Joshi, chercheur en sécurité indépendant, a pu extraire un grand volume d’instructions et de prompts de l’agent, simplement en utilisant astucieusement l’interface de discussion. Il en a partagé une copie avec Wired, ce qui permet de jeter un œil dans les cuisines.

Il se trouve que Muse crée une page pour chaque personne importante dans la vie de l’utilisateur. Il s’agit de compiler des informations sur la famille, les intimes, les amis, les collègues, les personnes suivies par l’utilisateur. Cette mémoire, en fait des fichiers de texte structuré, se remplit au fur et à mesure des événements et des interactions ; ces données permettent à l’agent de construire une « représentation » des relations, avec le degré de proximité, l’historique, et même des pistes pour les renforcer.

D’après la documentation fournie par Karan Joshi, une « page » s’enrichit progressivement avec des sections : « Faits », « Historique », « Relation », « Points communs », « Sujets en suspens » et « Renforcement ». Muse doit uniquement utiliser les éléments qu’il a sous la main, et ne pas inventer des informations même si la page est vide.

Selon les instructions de Meta, Muse doit conserver « les sujets qui reviennent régulièrement (le déménagement, l’objectif commun d’épargne) », où vivent les relations de l’utilisateur, ce qu’elles font dans la vie. Le modèle peut également enregistrer les dates importantes comme les anniversaires, et des éléments de contexte comme une dispute terminée (certains parlent de beaucoup de choses très personnelles avec leur bot), une réunion importante la semaine dernière, un voyage…

L’enregistrement de l’état des relations est aussi manifestement important pour Muse : degré de proximité, sur quoi repose telle relation, ce dont cette relation peut avoir besoin… La section « Renforcements » peut d’ailleurs suggérer des moyens d’améliorer une relation : rappeler une date à ne pas oublier, une raison d’appeler…

Le plombier n’a rien demandé

« Pour qu’un agent soit utile et puisse réellement vous aider à atteindre vos objectifs, il doit disposer d’un certain contexte sur vous et sur les personnes avec lesquelles vous interagissez », explique un porte-parole de Meta. « Muse rassemble ces informations à partir de données publiques et de ce que vous avez choisi de partager. C’est ainsi qu’il peut se souvenir que la personne qui vous a envoyé une facture est en fait le plombier que vous aviez précédemment engagé pour effectuer des travaux dans votre salle de bains, ou encore l’envoi à votre conjoint de ses fleurs préférées. »

Une déclaration apparemment de bon sens, à laquelle on peut ajouter l’infrastructure de Muse. Il s’agit d’une machine virtuelle dans laquelle sont stockés les données de l’utilisateur et le contexte. Les agents tiers n’y ont pas accès sans autorisation, et l’utilisateur peut déconnecter les services tiers connectés à Muse, ou tout simplement en effacer la mémoire.

Muse va néanmoins plus loin que d’autres bots IA dans le stockage d’informations sur les personnes connues de l’utilisateur. ChatGPT possède une mémoire structurée, mais OpenAI la présente comme une synthèse évolutive du contexte entourant l’utilisateur. L’IA sélectionne les infos jugées pertinentes et la synthèse se met à jour et s’enrichit au fil du temps.

Le système de Meta organise les informations sur la relation qu’entretient un utilisateur avec une personne, leur historique, le degré de proximité, les sujets en suspens et peut même proposer des moyens de renforcer cette relation. Le problème ici, c’est la réputation exécrable de Meta quand il s’agit de manipuler les données personnelles, comme on l’a vu encore très récemment avec… Muse :

Enfin, le conjoint, les collègues, ou ce fameux plombier n’ont rien demandé, et surtout pas à être intégrés dans les petites fiches de Muse. Mais il suffit que l’utilisateur ait évoqué ces relations pour que ces personnes se retrouvent dans la mémoire de l’agent. L’utilisateur a certes accepté de partager des données publiques, mais pas nécessairement de ficher son entourage.

  •  
❌