Apple veut donner à la nouvelle version de son assistant le meilleur accès possible à l’actualité. Et le constructeur y mettrait les moyens. D’après le Wall Street Journal, le constructeur informatique veut utiliser les contenus des éditeurs de presse qui permettront à Siri AI de fournir aux utilisateurs des informations à jour.
Image : Apple
Les négociations auraient débuté il y a quelques mois, avec des accords sur plusieurs années et à neuf chiffres (100 millions de dollars et au-delà). Dans le détail, l’entreprise proposerait un plan de rémunération variable : les paiements seraient ainsi versés aux partenaires dès que leurs contenus sont utilisés.
Ce n’est pas la première fois qu’Apple fait appel aux éditeurs de presse pour son intelligence artificielle, mais les précédents accords portaient sur l’entraînement des modèles IA de l’entreprise. Il s’agit cette fois de muscler la capacité de Siri à donner l’heure juste en matière d’actualité. L’assistant n’a jamais été très fortiche en la matière (ni sur le reste, d’ailleurs).
Siri AI fait bien meilleure impression. Alimenté par des modèles basés sur ceux de Gemini, le nouvel assistant se rapproche finalement des chatbots comme ChatGPT ou Copilot. Tout n’est pas parfait, mais la version qui sera proposée dans iOS 27 est infiniment supérieure à celle qui traîne sa pauvre carcasse depuis des années.
Malheureusement, Siri AI ne sera pas disponible dès septembre dans l’Union européenne sur iPhone, iPad et l’Apple Watch, Apple boudant toujours le DMA. En revanche, on pourra s’en servir sur Mac, sous réserve de parler anglais.
Apple a déjà eu une expérience malheureuse en prise en charge de l’actualité par ses systèmes d’IA. Début 2025, les résumés de notifications pour les titres de presse générés par Apple Intelligence se sont révélés catastrophiques, ce qui a forcé l’entreprise à suspendre cette fonction et à revoir sa copie.
La réorganisation de Google DeepMind n’empêche pas le labo IA du géant du web de continuer à produire des technologies inédites. À l’occasion de la présentation de la nouvelle gamme Pixel 11, DeepMind a dévoilé un nouveau modèle qui transcrit la langue des signes en texte.
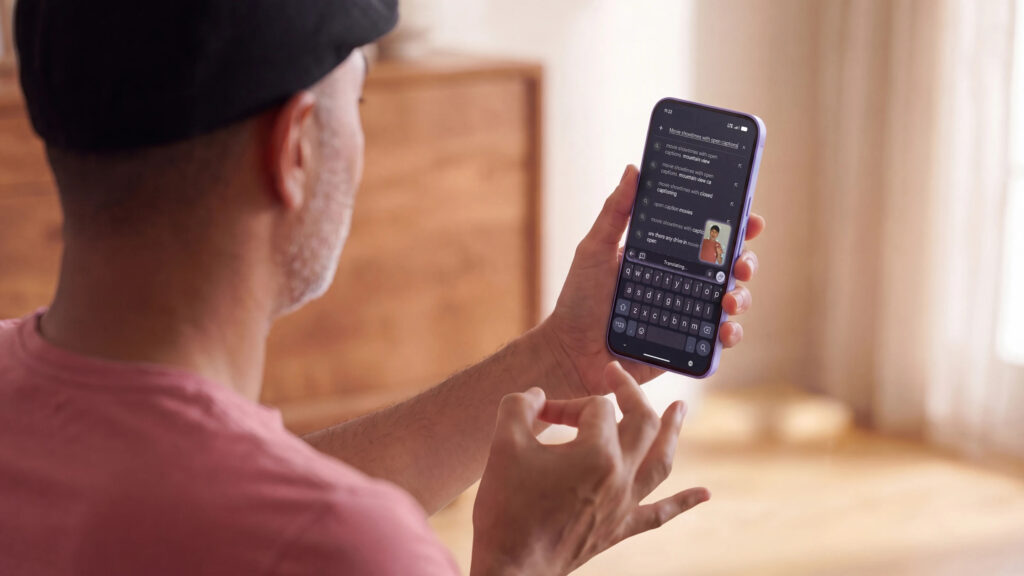
Les Pixel 11 sont les premiers smartphones Android à intégrer le modèle SL2T (pour « sign-language-to-text »). Développé par Google DeepMind, il permet aux sourds et aux malentendants de signer devant leur téléphone au lieu de saisir du texte. Il devient donc possible de chercher quelque chose sur internet, d’écrire des messages, d’interagir avec Gemini ou de répondre dans le fil d’une conversation en utilisant la langue des signes.
Les testeurs de Google affirment que cette fonction d’accessibilité est bien plus naturelle, plus rapide et plus agréable que de taper du texte. L’ASL, la langue des signes américaine, est la première à être prise en charge. D’autres langues sont dans les tuyaux, tout comme le support d’appareils supplémentaires.
Les mains dans le cambouis
Comme l’explique Google, les langues des signes – il en existe plus de 200 – sont de « vraies langues », chacune ayant sa propre grammaire et son propre lexique, qui utilise non seulement les mains bien sûr, mais aussi le visage et les mouvements de la tête, le torse et l’espace.
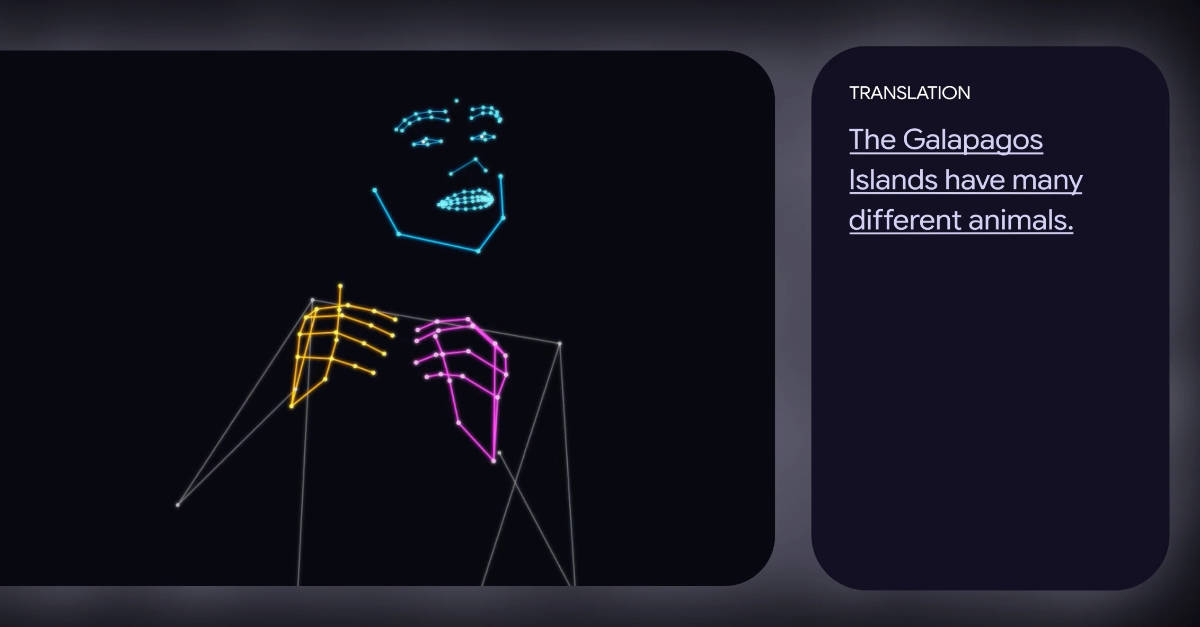
Le développement d’un modèle SL2T doit franchir deux obstacles : d’une, le défi linguistique, puisque les langues des signes ne sont pas la transcription mot à mot d’une langue orale. De deux, un défi visuel : le modèle doit en effet comprendre des mouvements complexes du corps, des mains, du visage, de la position du corps, le tout étant très rapide et parfois simultané.
Image : Google
Google rappelle l’existence de « gants de traduction », une des premières tentatives de transcrire la langue des signes en texte. Une tentative « fondamentalement limitée » puisque les langues des signes ne sont pas de « l’anglais [ou du français] avec les mains ». Le modèle mis au point par DeepMind doit répondre à ces deux problématiques.
Le modèle SL2T a été entraîné sur plus de 100 000 heures de données de 50 langues des signes (un quart de ce volume d’heures ayant été consacré à l’ASL). « L’entraînement conjoint sur diverses langues, dialectes et niveaux de maîtrise permet au modèle d’apprendre des structures sous-jacentes communes, ce qui l’a amené à surpasser les modèles monolingues dans nos expériences », explique l’équipe.
En attendant la LSF
La traduction ne s’appuie pas sur le flux vidéo brut, afin de protéger la vie privée de l’utilisateur. Un modèle spécialisé, MediaPipe Holistic, suit les points de repères du corps ; le traitement est réalisé en local, sur l’appareil. Il envoie ces points de repère au serveur, tandis que la vidéo est immédiatement supprimée.
Les coordonnées corporelles sont ensuite analysées et transformées en texte. « Traduire directement à partir des points de repère supprime les limites artificielles de vocabulaire et permet à la qualité de traduction de progresser directement avec la quantité de données », ajoute Google qui s’enorgueillit de n’avoir pas utilisé de gloses. Ces annotations intermédiaires, très utilisées dans les travaux sur la traduction des langues des signes, sont jugées insuffisantes pour capturer la richesse de ces langages.
En termes de performances, Google affirme que SL2T décroche les meilleurs résultats sur les principaux tests de traduction de l’ASL vers l’anglais (à l’instar de FLEURS-ASL). Le modèle a aussi été optimisé pour des usages du monde réel, où il faut une latence faible, éviter les hallucinations, sans oublier de prendre en compte les signeurs gauchers.
Pour développer la suite, Google a créé l’AI Sign Language Advisory Committee (AISLAC), qui regroupe des organisations internationales de sourds et malentendants, ainsi que des spécialistes du sujet. Un rapport d’impact a également été publié à l’occasion du lancement de cette version 1.0 du modèle SL2T.
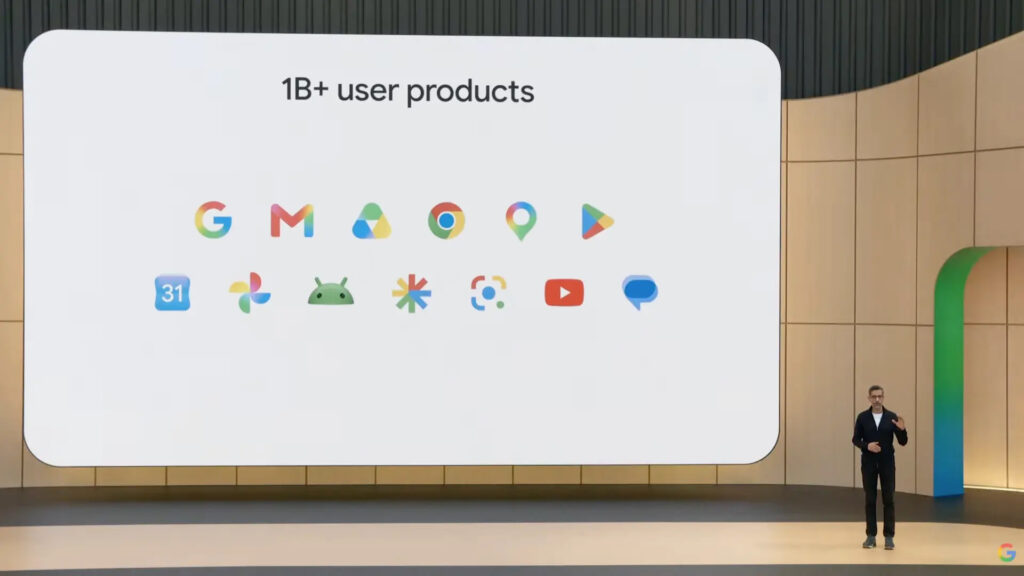
Google peut s’enorgueillir de compter dans son catalogue 14 services et produits qui dépassent le milliard d’utilisateurs : Gemini fait désormais partie de ce club, comme s’en réjouit Sundar Pichai, le directeur général d’Alphabet et de Google. Le dirigeant parle de l’application Gemini, ce qui exclut les utilisateurs qui se servent de cette IA ailleurs (Google a pris l’habitude d’insérer Gemini partout où c’est possible, parfois au chausse-pied).
La performance est quand même à relativiser, sachant que l’app Gemini est préinstallée sur les smartphones Android. Évidemment, c’est un sérieux avantage qui aide à recruter des utilisateurs. Josh Woodward, le chef de Gemini, confirme qu’Android est la plateforme dominante et de loin, puisque Gemini compte plus de 100 millions d’utilisateurs sur iOS.
Il donne aussi quelques précisions et statistiques d’usage sur Gemini. En vrac : les utilisateurs avancés sur macOS envoient des requêtes deux fois plus souvent que les utilisateurs d’autres plateformes, 63 % des utilisateurs parlent à Gemini, l’IA génère plus de 150 millions d’images chaque jour, elle peut automatiser des actions dans une quarantaine d’apps.
Image : Google
En ce qui concerne les 13 autres produits qui dépassent le milliard d’utilisateurs, ils avaient été révélés durant l’édition 2026 de la Google I/O en mai dernier. Il s’agit de la recherche Google, Gmail, Google Drive, Chrome, Google Maps, Google Play, Google Calendar, Google Photos, Android, Google Discover, Google Lens, YouTube et Google Messages.
Gemini n’est pas la seule application IA qui ait atteint ce seuil psychologique. OpenAI a révélé au détour d’un billet de blog posté le 6 août que ChatGPT dépassait également le milliard d’utilisateurs. Comme l’indique The Verge, le chatbot aurait en fait franchi cette étape dès le mois de juin.
Anthropic va appliquer des watermarks sur les contenus générés par Claude, ce qui permettra de les repérer plus facilement. Cet engagement est aussi une obligation réglementaire en vertu de l’AI Act européen.
Depuis le 2 août dans l’UE, les fournisseurs d’IA générative doivent intégrer un marquage technique de détection dans les images, les sons, les vidéos ou les textes générés ou manipulés par IA. C’est le sens de l’article 50 de l’AI Act. Il y a des exceptions importantes : quand le contenu généré par IA a fait l’objet d’un examen humain ou d’un contrôle éditorial, le tatouage n’est pas nécessaire.
Cette obligation ne concerne aussi que les modèles d’IA commercialisés après la date du 2 août ; pour les modèles déjà disponibles, un sursis de 4 mois – jusqu’au 2 décembre – a été accordé. Mais, quoi qu’il en soit, les fournisseurs d’IA doivent plancher sur des systèmes de marquage des contenus générés par leurs services.
Un double dispositif de marquage
Anthropic a dévoilé son plan de match, en tant que fournisseur et comme signataire du code de pratique sur la transparence des contenus générés par IA. L’adhésion à ce code est volontaire, mais de toute manière les exigences de transparence prévues à l’article 50 constituent des obligations légales.
Deux mécanismes sont mis en œuvre sur les modèles lancés après le 2 août (Anthropic indique travailler sur un watermark pour les contenus générés avec les modèles disponibles avant cette date). Le premier concerne le texte, qui contient une marque statistique invisible. Elle ne se voit pas à la lecture, elle ne change pas le sens du texte, et elle reste intégrée au texte ; par conséquent, un copier/coller conservera la marque.
Le deuxième dispositif touche les fichiers générés ou traités par Claude, comme les images au format SVG, PNG ou JPG. Le modèle ajoute des métadonnées de provenance signées selon le standard ouvert Content Credentials de la C2PA (Coalition for Content Provenance and Authenticity). Si de telles métadonnées sont présentes dans un fichier, cela signifie qu’il a été traité par Claude.
Google utilise de son côté SynthID, un filigrane invisible développé par DeepMind. Ce signal est directement intégré dans le contenu, ce n’est pas une métadonnée. Par conséquent, il est possible de combiner SynthID avec Content Credentials : c’est d’ailleurs le choix d’OpenAI pour ses outils de génération d’images. Anthropic donne malheureusement très peu de détails techniques sur son marquage, que ce soit pour les fichiers ou le texte.
Il y a des limites à l’exercice. Anthropic explique ainsi qu’un texte généré par Claude peut ne pas présenter de tatouage s’il a été « fortement modifié, paraphrasé, traduit ou mélangé à d’autres écrits », si le passage est très court (trop peu de texte pour obtenir un signal fiable), si les métadonnées ont été supprimées après une conversion de format, une capture d’écran ou un nouvel enregistrement.
Logiquement, le texte n’aura pas de marquage s’il a été généré par un modèle ne prenant pas en charge le tatouage numérique. Par ailleurs, si un contenu ne présente aucun marquage, cela ne veut pas dire pour autant qu’il n’a pas été généré ou modifié par une IA.
Marquage au fer rouge
Anthropic ne précise pas la technologie utilisée pour tatouer le texte, mais le marquage d’un tel contenu repose généralement sur un algorithme qui influence discrètement les choix de mots ou de tokens du modèle. Cela produit un motif statistique détectable qui peut signaler qu’un texte a été généré ou traité par un système d’IA.
L’entreprise prévient aussi que la présence d’une marque ne confirme pas la provenance d’un contenu. Claude peut ne pas être « l’auteur » d’origine : le modèle peut servir à relire, traduire, résumer ou convertir des fichiers. Le résultat porte un tatouage Anthropic, mais les idées ou les données peuvent provenir d’une autre source. De même, un contenu marqué peut être modifié, extrait ou combiné avec d’autres éléments après son traitement par Claude.
Il ne reste plus qu’une chose à mettre en place : un outil de détection des marques de Claude. Anthropic n’a rien à proposer, ce qui annule tout l’intérêt de cette annonce – pour le moment. L’entreprise planche en effet sur le sujet pour « permettre aux utilisateurs et aux tierces parties de détecter les watermarks intégrés et les métadonnées ». Une documentation technique sur les mécanismes de détection est en préparation. Pour les fichiers contenant un marquage C2PA, des outils sont déjà disponibles comme celui-ci pour détecter des Content Credentials, ou encore celui-là d’OpenAI.
Si l’AI Act a une portée européenne, Anthropic précise que ces marquages seront intégrés partout où les modèles Claude sont utilisés (le chatbot Claude, l’API, Claude Code, Cowork et Tag), dans le monde entier.
Personne n’aime découvrir que son nouveau chanteur ou sa nouvelle chanteuse préférée se révèle être une IA. Spotify lance donc un nouveau badge, « AI Persona », qui sera accolé aux profils des artistes qui ne sont pas des humains. Les créateurs de ces personnages IA pourront le signaler à Spotify, mais la plateforme attribuera également ce badge.
La musique générée par IA inonde les serveurs des plateformes de streaming. Deezer a annoncé le 21 juillet dernier que plus de la moitié des nouvelles chansons téléversées chaque jour – 90 000 morceaux – était générée par IA. L’an dernier, le service de streaming français a détecté 13,4 millions de chansons générées par IA.
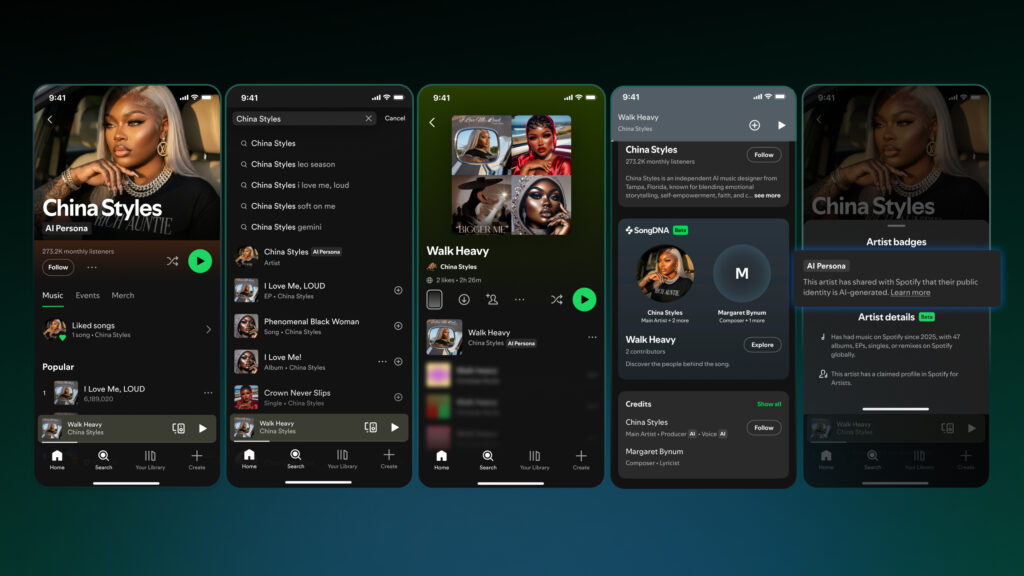
Ce tsunami force les plateformes à agir. Le même Deezer démonétise ainsi les écoutes de ces morceaux IA. Du côté du leader du secteur, Spotify, on sort finalement la grosse artillerie. Un nouveau badge « AI Persona » va faire son apparition sur les profils d’artistes générés par IA à partir de la mi-septembre.
Les artistes IA privés de recommandations
Les morceaux proposés par ces profils ne seront pas intégrés dans les recommandations éditoriales ou algorithmiques, sauf si l’auditeur a choisi de suivre l’artiste en question. La plateforme cherche aussi à écarter de ses recommandations le spam et les contenus de faible qualité. Spotify explique :
« Si nous estimons que chaque artiste doit rester libre de choisir la manière dont il se présente, les recommandations de Spotify ont vocation à mettre en avant les artistes authentiques qui développent une véritable carrière musicale. »
Les créateurs de ces artistes peuvent dès aujourd’hui indiquer que leur profil est une persona générée par IA. Mais au vu des changements que cela implique (ne plus faire partie des recommandations revient à se faire invisibiliser, et donc démonétiser de fait), ça ne suffira pas. C’est pourquoi Spotify examinera de son côté « certains profils d’artistes » dont l’identité, le nom, les visuels et la manière dont ils se présentent « semble représenter des identités photoréalistes générées par l’IA ». Ces profils écoperont alors d’un badge « Likely AI Persona ».
Image : Spotify
Le badge sera présent sur la page de profil de l’artiste IA, mais aussi dans les résultats de recherche et à côté des titres dans les listes de lecture. L’auditeur pourra cliquer sur le badge pour savoir si c’est l’artiste lui-même qui s’est déclaré persona IA « dans une démarche de transparence vis-à-vis de son public », ou si Spotify l’a attribué. Dans les prochains mois, les abonnés pourront aussi signaler les artistes qui leur semblent être des personas IA.
Les artistes qui recevront ce badge de la part de Spotify pourront confirmer leur statut ou le contester. La plateforme précise que ce badge ne concerne que l’identité publique de l’artiste, « et non la manière dont la musique a été créée ». Pour ça, l’entreprise propose un système de crédits d’IA et SongDNA qui permettent aux artistes d’être transparents sur la manière dont leurs morceaux ont été créés.
Ce badge complète le « profil vérifié » qui est son exact inverse : ce statut indique qu’un être humain réel se cache derrière un artiste. Spotify précise que des centaines de milliers de profils ont déjà été vérifiés de la sorte.
Meta reprend son bâton de pèlerin pour les poids ouverts, après l’avoir perdu suite au flop de Llama 4. Muse Glimmer est un nouveau modèle IA de 30 milliards de paramètres, installable sur un ordinateur personnel (assez costaud tout de même), assorti d’une licence open source permissive.
En publiant la première version de Muse Spark au mois d’avril, Meta changeait son fusil d’épaule sur la diffusion de son nouveau LLM : les poids ouverts de Llama laissaient la place à la fermeture d’un modèle propriétaire. Le débat autour de Kimi K3 et des modèles chinois à poids ouverts que Washington voudrait brider a poussé une bonne partie du secteur de l’IA à soutenir ce type de distribution.
Meta a retrouvé au fin fond d’un placard poussiéreux son costume de chevalier blanc des poids ouverts avec Muse Glimmer. Ce nouveau modèle est en effet distribué sous licence Apache 2.0, une licence open source standard, permissive, beaucoup plus familière aux développeurs et aux entreprises que ne l’étaient les licences spécifiques de Llama. Le modèle est disponible sur Hugging Face, on trouvera aussi une documentation technique à cette adresse.
Un modèle à installer chez soi (sur une bonne bécane)
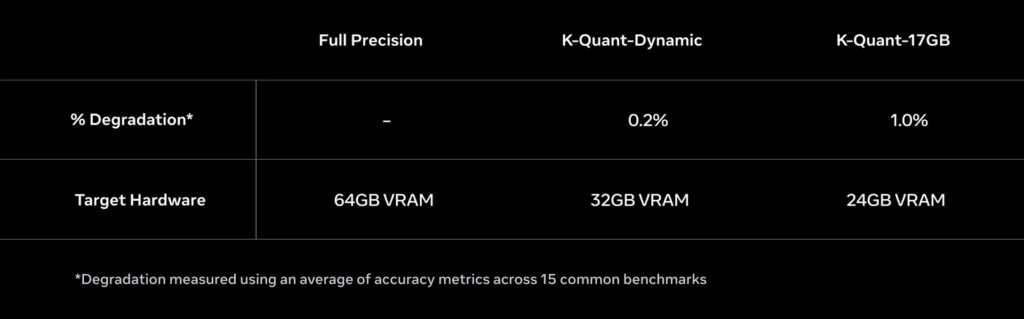
Glimmer est un modèle de 30 milliards de paramètres qui peut être installé sur un ordinateur du commerce – oubliez le petit portable Windows avec 4 Go de RAM, il faudra plutôt un Mac haut de gamme (Meta publie des benchs réalisés sur des MacBook Pro M4 Max et M5 Max) ou un PC équipé d’un GPU puissant (RTX 5090), avec idéalement 24 à 32 Go de mémoire GPU ou unifiée. « Le modèle est suffisamment rapide pour permettre une conversation fluide et une interaction en temps réel avec un agent, le tout entièrement exécuté sur votre appareil », affirme Meta.
La version quantifié en 4 bits descend sous les 20 Go, mais il faut aussi de la marge pour le cache, l’encodeur image et le modèle de décodage spéculatif. En mode « full precision », Glimmer requiert plus de 55 Go de mémoire. Évidemment, rien n’empêche d’installer Glimmer sur un serveur distant, mais là on ne parle plus d’un fonctionnement en local.
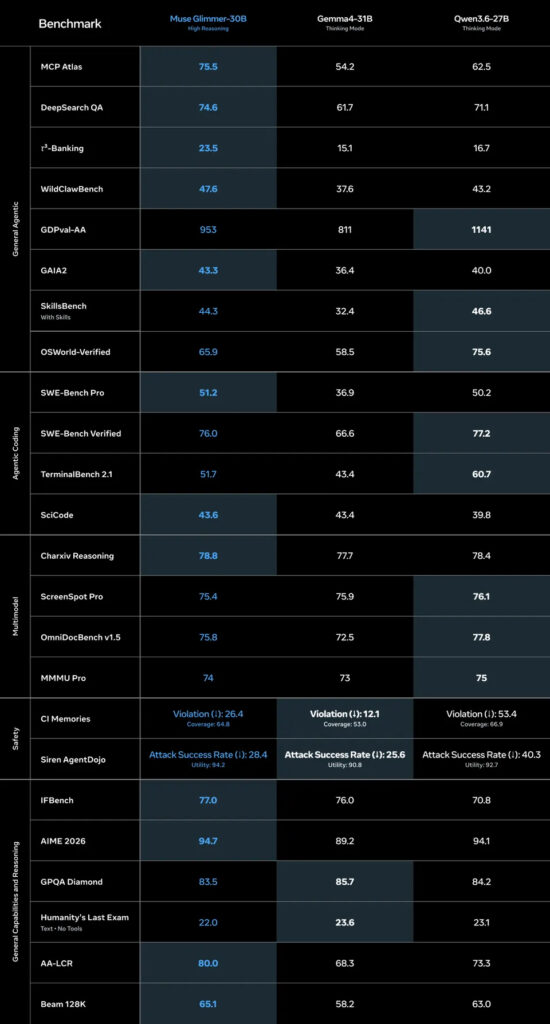
Dans le secteur des modèles de 30 milliards de paramètres, Muse Glimmer se défend bien à en croire les benchmarks publiés par Meta. Sur les tests agentiques, le modèle de Meta est souvent devant : MCP Atlas 75,5, contre 54,2 pour Gemma et 62,5 pour Qwen ; DeepSearch QA affiche un score de 74,6, devant les deux autres ; GAIA2 43,3, devant Gemma et Qwen. En codage aussi, Glimmer se montre très solide. En revanche, sur le multimodal, Qwen peut passer devant dans certains benchs.
L’avantage est marqué pour les tâches agentiques, la recherche multi-étapes et les tests de codage. Le modèle n’est pas systématiquement premier en tout, mais il a été optimisé pour un usage précis : faire tourner des agents en local qui peuvent utiliser des outils, coder et mener des tâches longues. Glimmer sera suivi dans quelques semaines de la publication des poids de Muse Spark 1.2, son modèle lancé la semaine dernière dans la foulée de l’offensive de Meta sur les outils pour développeurs.
Le manifeste de Zuckerberg
Mark Zuckerberg a profité de l’occasion pour publier un très long manifeste techno-libertarien sur les capacités mirifiques de l’IA générative, dans la droite ligne de la nouvelle campagne de com’ hors sol de Meta. Le patron de l’entreprise vante une fois de plus sa vision d’une « superintelligence personnelle », distribuée aux individus plutôt que concentrée entre les mains de quelques entreprises (un digest vidéo est visible ici).
Illustration : Flock
Pour le milliardaire, la principale contribution de la « superintelligence » ne sera pas de remplacer les travailleurs, mais d’aider les gens à créer : entreprises, produits, traitements médicaux, contenus, logiciels, ou encore recherches scientifiques. Un plaidoyer intéressant, sachant ce que Meta fait de son IA sur ses réseaux sociaux : un générateur de slop et de désinformation.
En attendant, il faut implanter des datacenters. L’entreprise promet des retombées locales sur l’emploi, la formation, les services publics, l’eau, les infrastructures. Le fonds « Future Is For Everyone » que Meta vient de lancer sera abondé à hauteur d’1 milliard de dollars pour soutenir les communautés affectés par l’installation de ces centres de données.
Le dirigeant s’oppose aux discours de certains acteurs de l’IA qui affirment qu’elle est dangereuse, tout en voulant cloisonner cette technologie. Pour Zuckerberg, qui rejette l’idée d’une « superintelligence bienveillante unique », le scénario du pire serait une IA contrôlée par une poignée d’institutions.
Ce qui nous amène directement à Glimmer. Le dirigeant estime que l’open source est une force positive contre la centralisation, et que ce serait une erreur de restreindre cet écosystème (clin d’œil appuyé vers la Maison-Blanche). S’il soutient les contrôles à l’exportation sur les puces, il ne manque pas de critiquer les règles ralentissant les entreprises américaines du secteur, ou qui limiteraient trop l’usage des données, de la distillation et des modèles étrangers open source.
Le temps du Far West dans le secteur de la musique générée par IA est-il bientôt terminé ? Suno, une des principales startups sur ce marché bouillonnant, promet davantage de transparence pour lutter contre la fraude et les abus, sans pour autant freiner l’adoption de l’IA générative parmi les professionnels de la filière.
Depuis son accord l’an dernier avec Warner Music Group, Suno veut filer doux. En échange de l’arrêt des poursuites de la major, la jeune pousse a pris plusieurs engagements, en particulier sur le téléchargement. Une nouvelle politique va être mise en œuvre pour limiter la distribution massive de morceaux générés par IA sur les plateformes de streaming.
Les serveurs des services de streaming sont pris d’assaut par la musique générée par IA. Au mois d’avril, Deezer avait ainsi annoncé que c’était le cas pour 44 % des chansons téléversées. La plateforme signale d’ailleurs quand le contenu est généré par IA (ou par un humain dans le cas de Spotify).
L’industrie tente de s’organiser, par exemple via l’organisation Digital Data Exchange (DDEX, qui fédère les entreprises et organisations ayant des intérêts commerciaux dans le domaine des contenus multimédias numériques, mais dont Suno ne serait pas membre) pour mettre en place des standards communs, mais chacun y va aussi avec ses propres outils.
C’est le cas de Suno, qui en plus de rappeler cette fameuse politique anti-téléchargements de masse dont les détails sont encore inconnus, vient d’annoncer plusieurs nouveaux dispositifs. À commencer par l’adoption « dans les prochaines semaines » de technologies de filigrane (watermarking) audio et de fingerprinting pour lutter contre la fraude et les usages abusifs. Des outils de transparence vont aussi être proposés pour faire en sorte que les chansons générées par Suno puissent être identifiées si elles sont partagés avec d’autres plateformes.
De la transparence pour les oreilles
Il s’agit pour l’entreprise de s’aligner avec les standards de l’industrie… et probablement aussi des régulateurs. Depuis le 2 août, l’AI Act impose une obligation de transparence aux fournisseurs d’IA qui passe par un marquage technique de détection sur les sons, mais aussi les images, les vidéos ou textes générés ou modifiés par IA.
Les systèmes commercialisés avant le 2 août ont cependant quatre mois pour respecter ces obligations, qui ne s’appliqueront pas aux éditeurs d’information générale si le contenu généré par IA a fait l’objet « d’un examen humain ou d’un contrôle éditorial ». Une zone grise pleine de flou qui pourrait justifier tous les abus.
L’UE propose d’ailleurs des badges (optionnels) à placer à côté des contenus générés par IA :
L’icône basique quand l’IA a servi à la création du contenu.L’icône à afficher quand l’intégralité du contenu a été généré par IA.L’icône à afficher quand du contenu humain a été modifié partiellement par de l’IA.
Suno clarifie également ses règles de communauté, avec une interdiction explicite des imitations non autorisées, des téléversements sans droits, de l’utilisation de voix ou d’image sans permission, des scams, faux engagements, et des contenus trompeurs. La plateforme IA va également renforcer sa collaboration avec Audible Magic et Musixmatch pour détecter les usages non autorisés.
Suno ne veut pas se poser en gardien des « valeurs artistiques », ni juger si « telle chanson est bonne, porteuse de sens ou suffisamment humaine ». En revanche, la société estime qu’il est de sa responsabilité de « rendre plus difficile l’utilisation abusive des outils d’IA d’une manière qui fragilise un écosystème musical sain. » Une réflexion bienvenue mais qui sonne étrange à l’oreille, au vu du pillage orchestré par la startup pour entraîner ses modèles IA.
Les utilisateurs qui se servent gratuitement de ChatGPT vont bénéficier d’une douceur. OpenAI fait en effet sauter les limites des discussions texte, qui deviennent donc illimitées. Une proposition très agressive parmi les chatbots généralistes.
Ce n’est pas complètement inédit dans le secteur : Microsoft propose depuis début 2025 un accès gratuit et illimité au modèle de raisonnement avancé Think Deeper (propulsé par o1) de Copilot, ainsi qu’aux conversations vocales… mais avec des interruptions possibles en cas de forte demande. La formule standard (gratuite) du moteur de réponses IA Perplexity offre aussi des recherches quasiment illimitées.
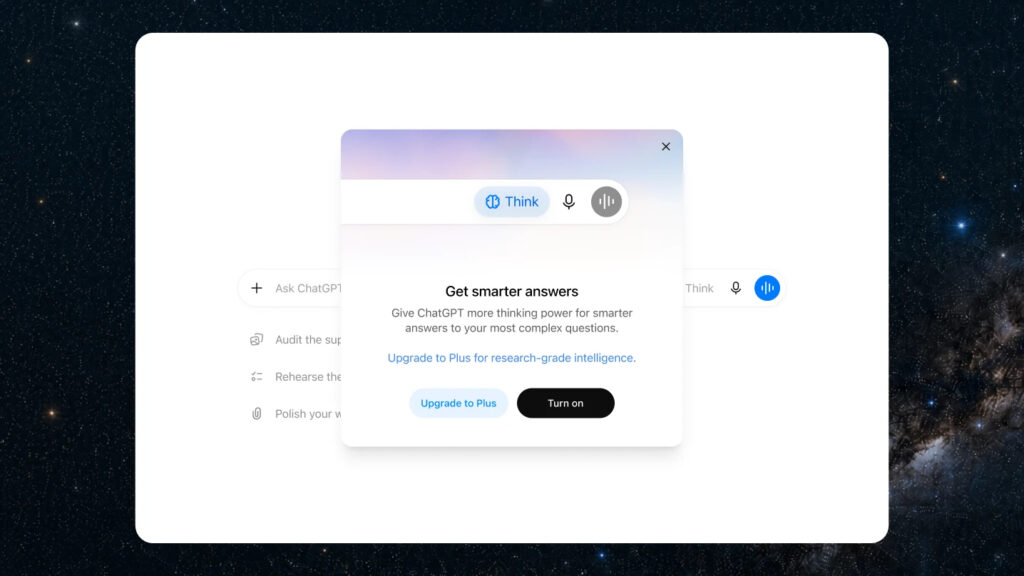
Néanmoins, cela n’en reste pas moins un gros coup pour OpenAI qui propose ainsi une carotte fort alléchante pour ferrer des utilisateurs qui pourront se transformer un jour en abonnés payants. Ce d’autant qu’ils ont aussi accès au bouton « Think » qui génère des réponses approfondies. Le modèle utilisé passe également de GPT-5.5 à GPT-5.6 Luna, l’« entrée de gamme » de la nouvelle famille de modèles IA et désormais la version par défaut de ChatGPT.
En revanche, la génération d’images, la voix et l’examen de fichiers et d’images sont toujours limités. Il faut passer à la caisse pour accéder aux modèles plus évolués Terra et Sol. Les abonnés payants bénéficient d’ailleurs d’une mise à jour de Sol, présenté comme plus efficace sur les tâches à accomplir rapidement (Codex et ChatGPT Work n’ont cependant pas droit à cette déclinaison de GPT-5.6 Sol, comprenne qui pourra).
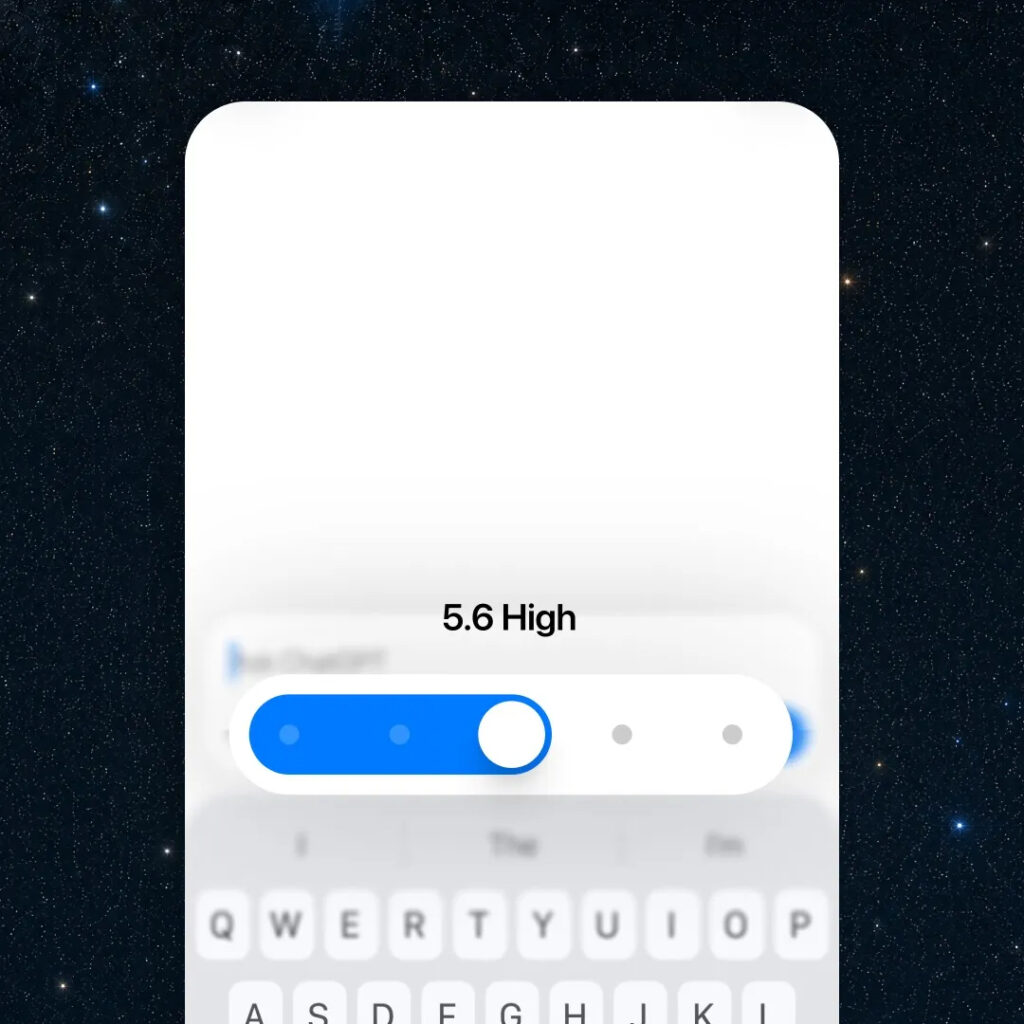
Les abonnés Plus et Pro obtiennent aussi une nouvelle réglette pour choisir plus facilement le niveau d’effort de GPT-5.6 : tout à gauche pour les questions du quotidien, plus à droite pour la planification, l’écriture, le code ou les décisions qui nécessitent un peu plus de jugeote qu’à l’accoutumée.

 Connexion