❌

Vue lecture

☕️ Les profils générés par IA devront se signaler sur Instagram


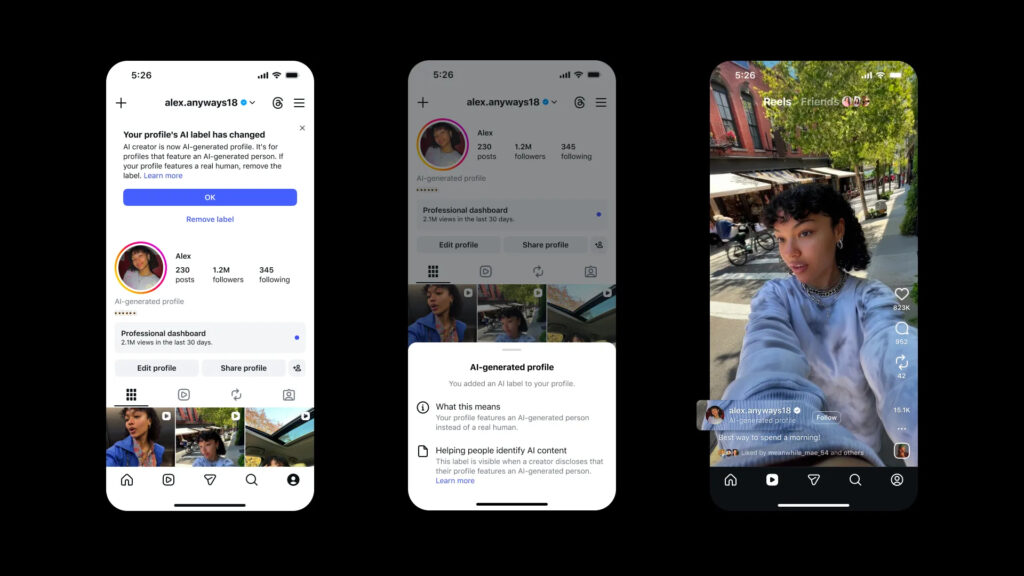
Instagram a entendu la grogne des utilisateurs qui n’aiment pas découvrir que la personne derrière un profil avait en fait été générée par une IA. De nouvelles mesures vont être mises en place pour mieux les informer.

Instagram a beau être un des plus gros tuyaux déversoirs d’IA slop au monde, trop c’est parfois trop. Le réseau social de Meta a décidé de serrer la vis aux profils générés par IA qui ne jouent pas franc jeu en « omettant » de se présenter de la sorte. « Les utilisateurs veulent savoir quand un profil met en avant une personne générée par IA », affirme Instagram.

Image : Instagram

C’est pourquoi l’étiquette « Créateur IA », expérimentée depuis le mois de mai, va être remplacée par un label, plus clair, « Profil généré par IA » (« AI-generated profile »). Le tag sera visible sur la page de profil et dans ses informations détaillées, ainsi que sous le nom de la créature synthétique apparaissant dans ses posts. Les créateurs qui utilisent l’IA générative pour produire des images, des vidéos ou du texte – mais pas le persona de leur profil – n’ont pas à demander l’étiquette.

Image : Instagram

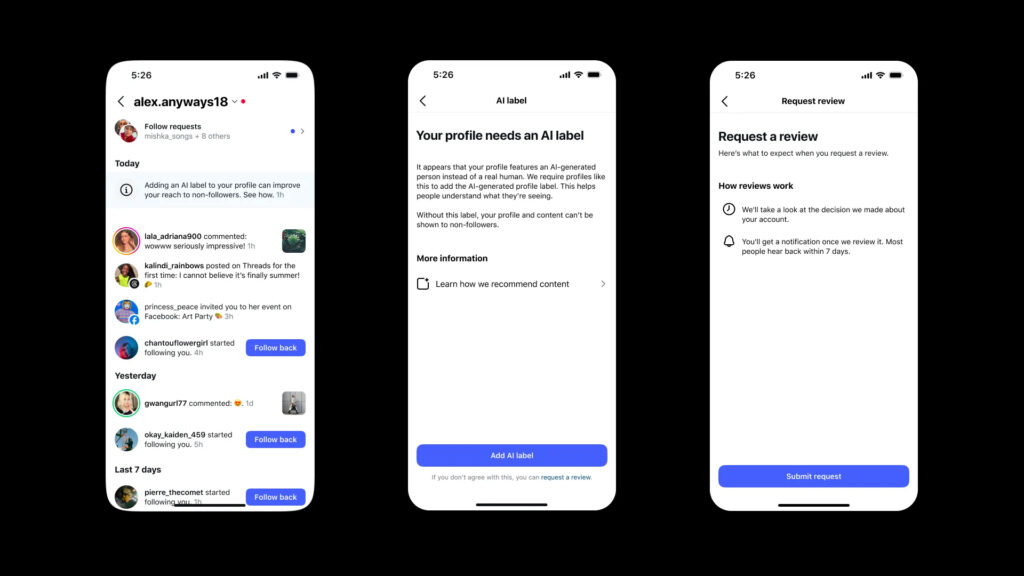
Les profils qui présentent une personne générée par IA et qui ne sont pas étiquetés sont fermement invités à activer l’option pour obtenir le label. Les créateurs qui se plieront volontairement à la règle ne verront aucune différence de visibilité pour leurs contenus. Ceux qui rechigneront à s’identifier comme profil généré par IA pourraient ne plus apparaitre dans les recommandations en cas de détection par les systèmes d’Instagram. Il sera toujours possible de faire appel d’une décision de restriction de visibilité.

  •  

☕️ OpenAI veut mettre toujours plus de publicité dans ChatGPT


La publicité dans ChatGPT n’est pas près de s’arrêter. Les annonces représentent déjà un petit business sympathique pour OpenAI : 1 milliard de dollars en revenus annualisés, d’après les projections d’OpenAI, alors que la réclame a été introduite aux États-Unis au mois de février, et qu’elle est en phase de lancement en France et ailleurs en Europe.

Le chiffre est certes symbolique, mais il est aussi important alors qu’OpenAI est en pleine préparation de son introduction en Bourse (IPO). L’entreprise veut démontrer que ses revenus reposent sur des sources diversifiées : après les abonnements payants, les offres aux entreprises et l’API basée sur l’usage, il y a aussi la publicité désormais qualifiée de « pilier », même si sa présence sur ChatGPT ne remonte même pas à 200 jours.

« Ensemble, ces offres donnent aux particuliers, aux développeurs et aux entreprises le choix dans la manière d’accéder aux produits OpenAI, y compris avec une formule gratuite financée par la publicité qui contribue à maintenir ChatGPT accessible à plus d’un milliard d’utilisateurs actifs hebdomadaires », explique OpenAI. La publicité est susceptible d’apparaitre dans les conversations avec la version gratuite de ChatGPT ainsi qu’avec celles de ChatGPT Go, l’abonnement à 8 euros par mois.

Les réclames apparaissent sous la forme de bandeaux, elles sont étiquetées et séparées de la conversation. La publicité « n’influence pas les réponses fournies par ChatGPT », assure OpenAI qui promet également que les annonceurs n’ont pas accès aux conversations privées. Malgré tout, l’entreprise « continue d’apprendre et de s’améliorer ». Un message qui semble destiné davantage aux annonceurs qu’aux utilisateurs.

OpenAI a ouvert plus grand le modèle publicitaire de ChatGPT Ads au mois de mai pour faire en sorte que les petites et moyennes entreprises puissent faire la promo de leurs produits et services. « De nouveaux formats, objectifs, options d’achat et outils de mesure » sont dans les tuyaux et envahiront l’inventaire de ChatGPT dans plus de 40 pays.

  •  

Debian ne dit pas non à l’IA et divise la communauté

Démocratie
Debian ne dit pas non à l’IA et divise la communauté

La communauté Debian devait voter sur la place que les grands modèles de langage (LLM) pouvaient tenir dans le développement de la distribution Linux. Parmi les axes proposés, elle a choisi un quasi-statu quo. La décision divise, ayant notamment provoqué le départ d’au moins un des développeurs.

Fin juillet, nous indiquions que la communauté Debian allait être amenée à se prononcer sur la place des LLM dans le développement de la distribution. Plusieurs propositions étaient mises en avant, de la plus radicale à la plus modérée. À l’époque où nous avions écrit ces lignes, on pouvait en lire quatre, mais la communauté a finalement dû voter parmi huit propositions.

  • Proposition A : interdiction pure et simple des LLM dans les contributions au projet
  • Proposition B : usage autorisé, mais avec un encadrement strict, avec garanties de licence et responsabilité totale des contributions
  • Proposition C : rejet des LLM autant que possible, affichage obligatoire des usages et interdiction des LLM pour les communications entre contributeurs
  • Proposition D : la plus pragmatique, avec acceptation des contributions par l’IA et responsabilité complète, en revanche pas d’IA distante pour les données sensibles
  • Proposition E : le statu quo, chacun étant responsable de ses contributions, peu importe l’outil
  • Proposition F : utilisation découragée des LLM quand c’est possible et mise en avant du travail humain, responsabilité complète des contributions, mais liberté pour les mainteneurs de refuser les contributions IA
  • Proposition G : usage contrôlé des LLM pour les tâches périphériques (réflexion, analyse, recherche, critique de code…), mais interdiction dans les contributions
  • Proposition H : l’impact environnemental des LLM est jugé rédhibitoire, leur utilisation doit être découragée autant que possible

Le choix de la communauté

Les participants se sont prononcés pour l’option E. De toutes celles mises en avant, la E est la plus consensuelle, car elle ne change presque rien à la situation qui existait avant.

Officiellement, la proposition E s’intitule « Usage responsable de l’IA générative ». On peut y lire notamment que Debian « n’encourage pas ni n’interdit l’utilisation d’outils d’IA générative dans le développement, la maintenance ou la documentation des logiciels, l’empaquetage, la documentation et les autres médias publiés dans le projet Debian ». Le texte reconnait que ces outils peuvent largement améliorer la productivité des contributeurs « s’ils sont utilisés de manière responsable ». Cela permettrait aux personnes de se libérer du temps pour des tâches plus intensives, notamment celles réclamant un jugement, une expertise ou une critique.

Techniquement, l’usage de l’IA ne change pas les exigences habituelles de qualité, d’exactitude et de maintenabilité. Toute personne soumettant un code, qu’il soit tout ou partiellement rédigé par une IA générative, est responsable de ce qu’elle propose. Elle doit être en mesure de comprendre, relire et tester ce code, dans l’idée de pouvoir expliquer ce qu’il fait avec précision. Tout envoi aveugle d’un contenu généré par IA est jugé incompatible avec les pratiques de Debian.

Dans la proposition, on peut lire qu’il est explicitement demandé aux personnes participantes de ne jamais envoyer d’informations personnelles à des services d’IA externes. Il peut aussi bien s’agir de données personnelles habituelles que de clés cryptographiques, communications privées, identifiants ou encore bugs de sécurité sous embargo.

Enfin, pour les opérations automatisées à grande échelle, comme la génération de nombreux rapports de bugs ou la modification en masse des paquets, un processus spécifique devra être mis en place.

« Les Contributeurs qui entendent effectuer des actions impactant tout le projet comme la soumission massive de bogues ou la soumission massive de correctifs, des modifications de code à grande échelle ou d’autres changements ou requêtes automatisés concernant de nombreux paquets ou de nombreux contributeurs, doivent d’abord lancer une discussion et rechercher un consensus à l’aide des canaux du projet avant d’agir. De tels projets automatisés doivent être validés par un humain qui demeure responsable de son comportement et du résultat », indique ainsi la proposition E.

En somme, Debian continue « de compter sur le jugement et la responsabilité de ses contributeurs individuels ». Point important : la mention de l’utilisation de l’IA dans un projet est recommandée, mais pas obligatoire.

Division et colère

La communauté a parlé. La proposition E ne change fondamentalement rien : chacun peut faire ce qu’il veut, tant que les pratiques habituelles de Debian sont respectées. La distribution s’appuie depuis longtemps sur la responsabilité individuelle et la relecture par les pairs. Pas question donc de changer de philosophie. Cependant, lorsque l’on parle de Debian, il n’est pas question d’une entité unique et mystique, mais bien d’un ensemble de personnes contribuant au projet. La consécration de ce quasi-statu quo n’est donc pas anodine.

Si la communauté a parlé, elle est également divisée, aussi bien chez les contributeurs que les utilisateurs. Sur X par exemple, la publication de la nouvelle sur le compte It’s FOSS montre des réactions très diverses, certains comprenant la position, mais la plupart affichent de la méfiance, voire de la déception. Même constant dans les commentaires de Phoronix.

Parmi les réactions négatives, l’une d’entre elles ressort particulièrement : celle d’Antoine le Gonidec, contributeur de longue date au projet Debian. Sur les huit propositions, il était parrain des options A, C, G et H. En somme, toutes celles cherchant à interdire ou limiter l’usage des IA. Face à la victoire de la proposition E, Antoine le Gonidec n’a pas caché sa colère. Sur la liste officielle de diffusion Debian, le développeur a pris une décision radicale :

« Je ne peux pas soutenir la décision actuelle de Debian concernant l’utilisation des LLM, et je ne suis plus prêt à être considéré comme faisant partie de Debian selon ces nouvelles règles. Prétendre avoir une « position neutre » face au fascisme n’est pas de la neutralité, c’est une collaboration active »

Il se retire donc du projet, expliquant que les LLM s’appuient en grande partie sur des entreprises « soutenues par des fascistes ». De toutes les propositions, la E était « la plus pro-LLM de toutes les options ». Il dit ne plus être intéressé par quoi que ce soit provenant de Debian, déclarant avec acidité qu’il peut être remplacé « par n’importe quelle IA agentique ». « Je pense n’avoir jamais autant été déçu par une communauté en qui j’avais confiance », affirme-t-il.

L’importance de Debian

Si ce vote était attendu, c’est que Debian est l’une des distributions Linux les plus importantes. En plus du système lui-même, connu pour sa fiabilité et sa rigueur, Debian sert de base à de nombreuses distributions, dont la plus connue est Ubuntu, celle-ci servant à son tour de socle à d’autres comme Linux Mint.

Comme l’indique It’s FOSS, plusieurs projets ont choisi des approches beaucoup plus radicales. OpenJDK par exemple, édité par Oracle, refuse toute contribution générée par IA. Même chose pour le compilateur GCC. D’autres ont choisi une approche plus souple, en particulier le noyau Linux. Au sujet des LLM, Linus Torvalds a adopté une approche pragmatique, estimant que l’aide procurée par l’IA ne peut plus être empêchée, mais que certaines situations sont problématiques, notamment l’automatisation des rapports des bugs (qu’il a fustigée).

  •  

Avant son lancement officiel, DLSS 5 apparaît dans la nature

Le filtre qui fâche
Avant son lancement officiel, DLSS 5 apparaît dans la nature

Très critiqué lors de sa présentation au printemps, le DLSS 5 commence à apparaître dans les jeux avant même son lancement officiel. Une bibliothèque NVIDIA repérée dans NBA 2K27 a déjà permis à des moddeurs de tester le rendu neuronal avec des résultats encore très expérimentaux.

C’est peu dire que DLSS 5 n’a pas été très bien accueilli par les joueurs. NVIDIA s’est pris les pieds dans le tapis en dévoilant, en mars dernier, la nouvelle version de sa technologie d’upscale graphique Deep Learning Super Sampling. La promesse était de « transformer la réalité visuelle dans les jeux » en la faisant basculer dans le photoréalisme. Les exemples partagés à l’époque par l’entreprise ont surtout donné l’impression qu’il s’agissait d’un « filtre de beauté » d’IA générative emmenant les graphismes des jeux et des personnages loin de l’intention initiale des développeurs.

Jensen Huang, le directeur général de NVIDIA, était monté au créneau pour défendre le DLSS 5, d’abord en affirmant que les joueurs avaient tort, puis en essayant de se les mettre dans la poche en assurant qu’il n’aimait pas l’« AI slop ». Sans rien changer au développement de la technologie, qui doit être lancée cet automne.

Les jeux se préparent à la déferlante DLSS 5

À l’heure actuelle, aucun jeu n’est officiellement compatible, mais les éditeurs préparent la prise en charge du DLSS 5. C’est le cas d’EA : NBA 2K27, en accès anticipé sur PC depuis le 26 août, cache une DLL baptisée nvngx_dlssnr.dll. Un fichier qui est vraisemblablement une bibliothèque NVIDIA pour accéder à une fonction DLSS Neural Rendering.

Découverte par le développeur Renan Maniero puis décortiquée par la communauté de spécialistes des mods RenoDX, il s’agirait très probablement d’une version préliminaire du composant logiciel nécessaire à l’activation du DLSS 5, comme l’explique Tom’s Hardware. Des moddeurs sont déjà parvenus à l’injecter dans les jeux Control, Cyberpunk 2077 avec des résultats visibles sur le rendu des personnages : ombres, peaux et cheveux.

Les artistes ont-ils toujours la main ?

La bibliothèque comprend sept curseurs pour contrôler des paramètres comme le style, l’intensité, le ton et le niveau de préservation des détails. DLSS 5 ne se contente pas de reconstruire des images, de générer des frames ou d’améliorer l’anti-aliasing comme c’est le cas des versions précédentes ; il réinterprète les caractéristiques de certains aspects des personnages et de la scène.

DLSS 5 tourne uniquement sur les GPU Blackwell (les GeForce RTX 50xx), ce qui n’est pas une surprise : NVIDIA réserve cette technologie pour cette génération, comme l’entreprise l’avait annoncé durant la présentation en mars. Elle a un coût pour les performances du PC : l’activer revient en effet à faire chuter le framerate de moitié environ, selon les premières mesures.

Il faut garder à l’esprit qu’il s’agit de benchs non officiels réalisés à partir d’une version préliminaire. Quand NVIDIA a dévoilé DLSS 5, les démos tournaient sur des machines équipées de… deux RTX 5090. Depuis, la technologie a été optimisée pour être capable de fonctionner avec un seul GPU.

Au SIGGRAPH, le rendez-vous annuel des professionnels de l’image de synthèse et du rendu graphique, NVIDIA avait donné de plus amples détails sur le DLSS 5 : comment l’image rendue par le jeu « ancre » le modèle, et comment NVIDIA essaie de préserver l’intention artistique.

C’est un enjeu de taille, car durant toute la polémique l’entreprise n’a eu de cesse de rappeler que le DLSS 5 respecte l’intention des artistes. « Tout cela est fait pour les créateurs, afin qu’ils puissent créer quelque chose de plus beau mais toujours dans le style qu’ils souhaitent », expliquait Jensen Huang. « Je pense qu’ils ont eu l’impression que les jeux allaient sortir tels quels, comme ils le font d’habitude, puis qu’on allait les post-traiter. Ce n’est pas ce que le DLSS est censé faire. »

  •  

2026 : l’été où les affiches IA ont inondé la France

Ça l'affiche mal
2026 : l’été où les affiches IA ont inondé la France

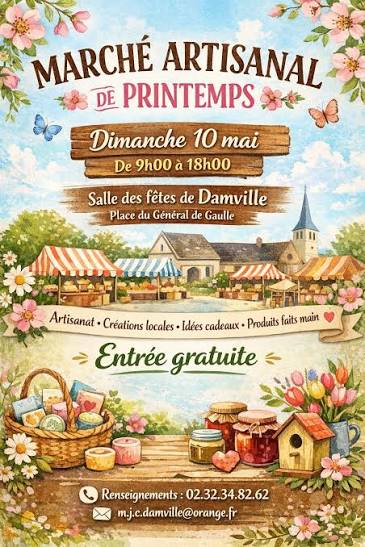
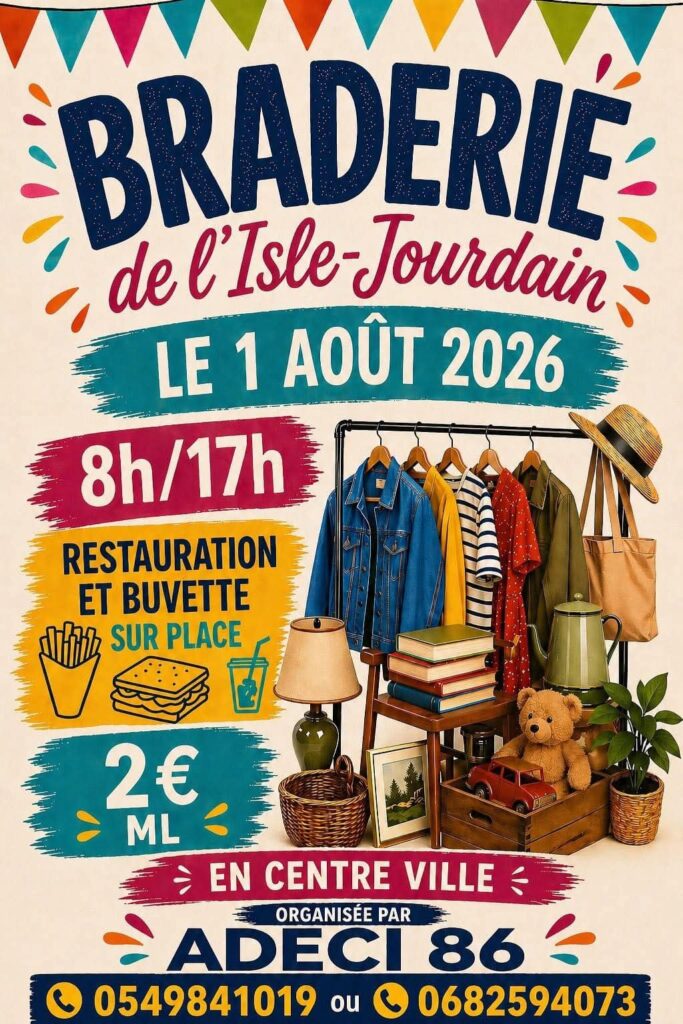
Pour annoncer des fêtes de village, des promotions ou le prochain concours de pétanque, les affiches IA se multiplient partout en France. Au point, cet été, d’avoir suscité des débats sur leur bien-fondé.

Celles et ceux qui ont pu partir en vacances s’en sont rendus compte en quittant leur environnement quotidien. Où qu’ils aillent, en France et ailleurs, des images lisses, parfois teintées d’un jaune caractéristique, envahissaient les menus, les espaces d’affichage de supermarchés, les panneaux d’annonces pour des brocantes, des fêtes de village, des marchés.

Que ce soit sur les réseaux sociaux ou dans les médias régionaux ou nationaux, l’évolution est claire : les affiches, cartes postales et autres images générées par IA se multiplient partout dans le pays, et tout le monde ne s’en réjouit pas.

Une technologie « pratique » pour les petites structures

Le débat a grossi, ces derniers mois, pour se répercuter d’un média régional à un autre. Dans la Manche, la propriétaire d’une friperie associative se réjouit de pouvoir utiliser l’IA générative pour produire de « jolies affiches colorées » : auparavant, sa structure se contentait d’une publication moins visuelle sur les réseaux sociaux.

En Champagne, plusieurs communes ont recouru à l’IA pour annoncer leurs événements estivaux, des fêtes du 14 juillet aux concours de pétanque. Auprès de l’Union, la secrétaire du comité des fêtes d’Igny-Comblizy estime que « c’est efficace », même si elle « n’obtient jamais le bon résultat du premier coup » : non seulement l’IA lui permet de générer des affiches, mais aussi de corriger les images de mauvaise qualité qu’on peut lui envoyer pour illustrer un concert, ou encore de préparer rapidement un visuel lorsque le sujet arrive sur la table sans avoir été prévu auparavant.

Certains, comme le président du comité d’Avenay-Val-d’Or, demandent même à la machine (le plus souvent, ChatGPT) d’ajouter « une touche plus vintage », lorsque cela correspond à l’idée de l’événement organisé. D’autres y recourent aussi pour véhiculer des messages problématiques : menée par le Rassemblement national, la mairie d’Agde a affiché un moment une image générée par IA et contenant des propos racistes, avant que la polémique pousse à les retirer.

Dans le Limousin, en Alsace, dans le Var ou le Puy-de-Dôme, dans des fêtes de village comme de grandes enseignes de supermarchés ou de plus petits commerces, l’IA générative est partout. Et son adoption large a rendu les similarités entre affiches (ou cartes postales, ou menus de restaurants, ou autres éléments visuels) d’autant plus évidentes.

À Avignon, certains lieux accueillant le off du festival de théâtre se sont eux aussi tournés vers l’IA générative pour annoncer certains des 1 700 spectacles joués. L’astuce a été suffisamment fréquente pour qu’un festivalier en forme écrive sur nombre d’entre elles la phrase « Artist ? No AI » au feutre noir, rapporte Libération. Les débats, cela dit, sont loin d’être simples : outre servir à produire des images à faible coût, l’IA est aussi utilisée dans diverses autres activités artistiques ou organisationnelles, y compris directement dans la création des pièces.

Un résultat de faible qualité

Sur les réseaux sociaux, néanmoins, un agacement monte, à coups de montages qui illustrent les similarités entre chaque production. Sur Facebook, des groupes doctement titrés « Affiches en IA claquées » ou « Affiches IA de merde » ont été créés – ils restent néanmoins bien moins animés que leurs concurrents dédiés à échanger des conseils pour bien prompter.

Des graphistes, designers, dessinateurs et autres artistes visuels se tournent aussi vers les réseaux sociaux pour regretter la vaste uniformisation visuelle qui semble avoir saisi la France cet été : le recours à Stable Diffusion, Midjourney ou d’autres pour générer l’annonce de la prochaine fête du hareng, c’est aussi une commande en moins pour ceux dont la production de ces supports de communication est le métier.

Des spécialistes soulignent par ailleurs un problème récurrent dans les productions obtenues : les machines ne sachant pas sélectionner les informations les plus pertinentes, le rendu est surchargé d’éléments. Si, à première vue, le résultat peut sembler satisfaisant, il ne permet pas de faire savoir l’essentiel de la manière la plus efficace.

Autre enjeu, qui fera peut-être, à terme, évoluer le recours à ces outils : en lissant affiches et publicités, le large recours à l’IA produit aussi une uniformisation des enseignes, des lieux et des marques. Pour qui souhaiterait se démarquer de son voisin, le prompt reste donc à revoir.

  •  

Cowork et Claude font maintenant mémoire commune

Données, données, données
Cowork et Claude font maintenant mémoire commune

Anthropic annonce que Cowork peut maintenant utiliser la mémoire de son chatbot. Les deux outils peuvent, par défaut, y enregistrer des informations automatiquement et les réutiliser.

« À partir d’aujourd’hui, la mémoire utilisée dans le chat est la même que celle de Claude Cowork. Désormais, quel que soit l’endroit où vous travaillez avec Claude, il part de ce qu’il sait déjà de vous », annonce d’emblée Anthropic dans un billet de blog publié ce mardi 25 aout.

Anthropic fusionne les mémoires de son chatbot et de son outil d’automatisation de tâches, Cowork : ce que vous faites dans l’un des outils peut être utilisé par l’autre pour adapter ses réponses. Mais cela ne concerne pas seulement les prochaines actions et discussions des utilisateurs de Claude.

« Cowork dispose désormais d’une mémoire, et il s’agit de celle que vous utilisez dans le chat, ce qui vous évite d’avoir à tout réexpliquer et vous permet de reprendre plus facilement là où vous vous étiez arrêté. Lorsque Cowork exécute une tâche dans le cloud, les informations dont Claude se souvient à partir de vos discussions y sont disponibles, et inversement », explique l’entreprise. Cela veut dire que toutes les actions et discussions passées peuvent être utilisées par l’un ou l’autre des outils.

L’entreprise donne un exemple de ce que pourra faire Cowork avec l’accès à vos conversations dans son chat : « Demandez à Cowork de rédiger un compte-rendu à l’intention de votre responsable : l’outil sait déjà de qui il s’agit et connaît ses préférences en matière de rédaction. Discutez de l’ordre du jour dans le chat pour une conférence que vous organisez ; lorsque Cowork établit le budget et le document logistique, il connaît déjà le nombre de participants, la ville et les intervenants ».

Ainsi, Anthropic rejoint Microsoft et OpenAI dans la course à la construction d’un outil qui récupèrera le plus de données possibles sur ce que nous faisons sur nos ordinateurs. Si Microsoft essaye d’imposer sa fonction Recall dans Windows depuis quelque temps, OpenAI a lancé plus récemment son « Computer History » qui agit comme un super keylogger pour récupérer le plus de données.

Néanmoins, l’entreprise de Dario Amodei semble y aller plus doucement, peut-être en imaginant que les grenouilles ne s’enfuient pas si on augmente progressivement la température de l’eau. Ainsi Anthropic assure à ses utilisateurs qu’ils peuvent désactiver la mémorisation.

Une mémorisation au fil de l’eau par défaut, sauf sur les sujets jugés « sensibles » par Anthropic

Mais celle-ci, si elle est activée comme c’est le cas par défaut, se fait maintenant au fil de l’eau. « Claude enregistre désormais les sujets dans sa mémoire au fur et à mesure de la conversation, au lieu de résumer les échanges une fois ceux-ci terminés », explique Anthropic. La mémorisation se fait sans que l’utilisateur tape « souviens-toi de ça » dans le chat.

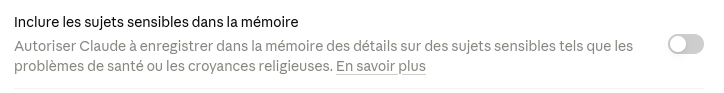
L’entreprise ajoute que, « par défaut, Claude ne conserve pas d’informations relatives à des sujets personnels ou sensibles, tels que votre santé, votre origine ethnique, vos convictions religieuses, vos opinions politiques, votre identité de genre et d’autres domaines similaires ». Sur ces sujets-là, l’utilisateur doit activer lui-même la mémorisation s’il veut que les outils d’Anthropic les gardent dans leur mémoire collective :

Précisons qu’Anthropic ne donne pas beaucoup de granularité : l’option ne permet que d’activer ou non le fait d’inclure les sujets considérés comme « sensibles » par l’entreprise elle-même.

Anthropic fournit aussi un accès aux données enregistrées par son outil avec lequel il est possible de les lire mais aussi de les modifier ou de les supprimer : « Les fichiers sont courts, et une correction porte ses fruits partout : il suffit de corriger l’ancien nom de votre entreprise dans un seul fichier pour que toutes les conversations ultérieures l’indiquent correctement », affirme Anthropic.

Remarquons qu’Anthropic ne prévoit pas (pour l’instant ?) la fusion de cette mémoire avec celle utilisée par Claude Code.

  •  

☕️ OpenAI bannit les comptes ChatGPT d’une opération russe de désinformation


OpenAI a supprimé un certain nombre de comptes ChatGPT connectés à une opération russe de désinformation. Ces derniers généraient des messages sur les réseaux sociaux pour faire la promotion de l’IBI (International Burke Institute), une soi-disant « communauté d’experts » basée en Israël.

Illustration : Flock

Ces messages, postés en anglais et en allemand sur X (anciennement Twitter), Telegram, Substack, Facebook et LinkedIn, sont générés de telle manière à masquer les indices linguistiques qui pourraient mettre les lecteurs attentifs sur la piste russe. OpenAI interdisant l’accès de ses modèles à la Russie, les attaquants utilisent des VPN.

La plupart des messages font donc la promotion de l’IBI, associée à un site enregistré en février 2025. Les articles lisibles sur ce site ne sont pas générés par ChatGPT, mais beaucoup sont copiés à partir de véritables travaux universitaires, parfois avec de fausses attributions d’auteurs.

Le site du vrai/faux think tank affirme réunir en son sein plusieurs experts de renommée mondiale, dont Noam Chomsky et Francis Fukuyama. OpenAI relève toutefois que sur 36 articles associés à des experts publiés sur le site de l’IBI entre septembre 2025 et le mois de mai, 34 avaient été copiés depuis d’autres sources. Certains étaient d’anciens papiers, d’autres étaient mal attribués.

Une des « réalisations » les plus notables de l’IBI est un « indice de souveraineté » qui fait l’éloge de la Russie et dénigre les pays occidentaux. Par exemple, la « note » de la France est peu amène pour Emmanuel Macron ; après ses deux mandats, « la France a été ouverte comme un coffre-fort rempli d’un capital historique, et elle est désormais vendue par morceaux ». Outre l’Hexagone, l’Allemagne et l’Union européenne en prennent pour leur grade, certainement en raison de leur opposition à la Russie et sa guerre en Ukraine.

« C’est la première fois que nous déjouons une opération d’influence liée à la Russie qui a déployé des efforts aussi considérables », affirme OpenAI. Malgré tout, l’impact de cette campagne semble limité : les publications sur les réseaux sociaux n’ont généré qu’un faible nombre de vues, les comptes liés à l’IBI comptant de leur côté peu d’abonnés. Exception faite des chaînes Telegram avec 10 000 à 20 000 abonnés pour chaque.

Ce qui est digne d’intérêt, c’est surtout l’infrastructure de cette campagne, dans laquelle ChatGPT n’a finalement joué qu’un petit rôle (produire des messages pour les réseaux sociaux). Mais cet usage de l’IA, même mineur, peut aider à dérouler la pelote d’une opération plus importante.

  •  

☕️ Apple Music va étiqueter la musique IA


Apple Music va étiqueter les morceaux générés par IA d’ici la fin de l’année. Le service de streaming a prévenu ses partenaires de la filière via un courriel obtenu par Billboard. Les chansons signalées comme « largement générées à l’aide de l’IA » par les maisons de disques et les distributeurs auront droit à un tag « Made With AI ».

En mars, la plateforme d’Apple avait dévoilé son système de signalement « AI Transparency Tags », par lequel les fournisseurs de musique doivent indiquer quand et où l’IA a été utilisée de manière « significative » – dans la création des visuels par exemple, ou encore le clip vidéo, la composition ou la chanson. « Tout contenu provenant principalement d’un service d’IA générative », précise le courriel.

Ces informations, qui permettront à Apple Music d’identifier les contenus concernés, devront obligatoirement être fournies par les distributeurs. Et si certains ne jouent pas le jeu ? Olivier Schusser, le directeur du service, expliquait à Billboard en avril qu’Apple avait développé une technologie qui permet de « savoir précisément quel type de musique nous est envoyé, quel modèle d’IA a été utilisé ».

Apple pourrait donc aisément mettre la main au collet des titres IA. Mais le responsable estimait que la responsabilité devait être portée par les fournisseurs de contenus. « Toutes les maisons de disques dans le monde nous livrent des contenus utilisant l’IA, même si elles n’en ont pas forcément conscience. Elles doivent elles aussi développer des outils pour comprendre l’ampleur de cette utilisation », déclarait-il.

La musique générée par IA ne représente que 0,5 % des écoutes sur Apple Music, a indiqué Olivier Schusser. En revanche, plus d’un tiers des chansons téléversées sur les serveurs de la plateforme est généré par IA. Apple Music rejoint ainsi Deezer, Tidal et Spotify dans le signalement des morceaux IA.

  •  

Sur macOS, ChatGPT sait désormais interagir avec l’application Messages et vos SMS

Aie confiance, crois en moi, que je puisse veiller sur toi
Sur macOS, ChatGPT sait désormais interagir avec l’application Messages et vos SMS

OpenAI lance un plugin qui permet à l’application ChatGPT sur macOS d’interagir directement avec les messages (iMessage, SMS) de l’utilisateur. Une intégration censée faciliter la vie de l’utilisateur, mais qui ne va pas sans poser de sérieuses questions quant à la confidentialité des données associées.

« Vos conversations de tous les jours viennent de gagner en simplicité grâce au nouveau plugin Apple Messages », annonce fièrement OpenAI. L’entreprise vient en effet d’annoncer la mise en ligne d’un nouveau composant optionnel, dédié aux versions macOS de ses clients logiciels, qui permet aux utilisateurs de ChatGPT de bénéficier d’une intégration renforcée avec l’application Messages du système, celle qui permet de gérer les messages texte (iMessage, SMS, RCS) envoyés par le truchement de l’iPhone de l’utilisateur.

Un accès complet aux messages (et au disque)

Dans une vidéo relayée sur X, OpenAI illustre l’utilité supposée de ce plugin : par exemple, demander à ChatGPT de retrouver les questions laissées en suspens dans les messages reçus la veille, puis rédiger, ou faire rédiger, directement la réponse depuis l’interface d’échange avec le LLM. Les fonctionnalités décrites illustrent la capacité du modèle à lire les messages envoyés ou reçus par l’utilisateur, pour en extraire des informations, générer une synthèse, ou préparer des réponses.

Sur son site, OpenAI précise le fonctionnement de ce nouveau plugin, et notamment la façon dont l’utilisateur garde le contrôle sur les messages envoyés, du moins s’il ne donne pas carte blanche à l’outil :

« Par défaut, ChatGPT n’envoie les messages qu’après votre approbation du message et de ses destinataires. Choisissez « Autoriser une seule fois » pour approuver uniquement cet envoi. Si vous sélectionnez « Toujours autoriser l’envoi vers cette conversation », ChatGPT pourra envoyer des messages ultérieurs à cette conversation sans nouvelle approbation. »

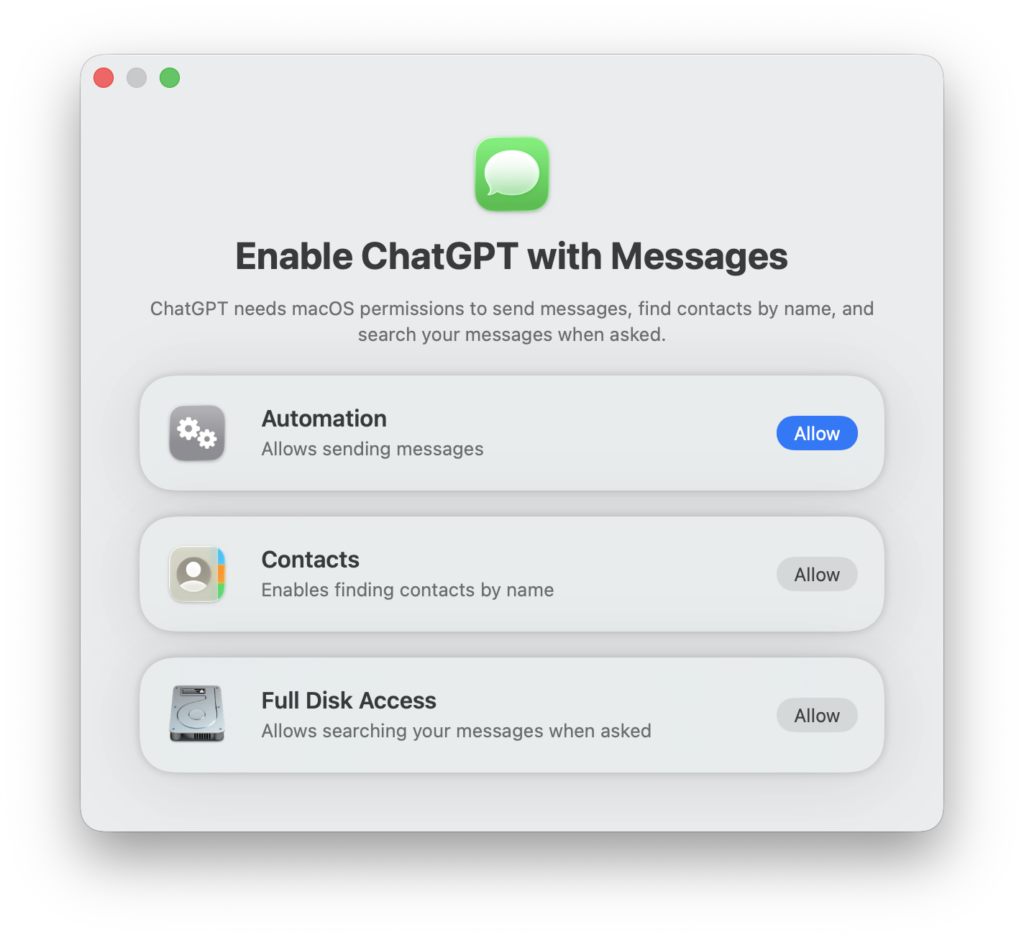
OpenAI annonce une disponibilité globale de ce plugin, ce que nous avons pu vérifier depuis une machine française, sur un compte ChatGPT gratuit. En passant par l’application et en sélectionnant le mode Codex, une recherche dans les plugins affiche bien l’intégration Messages. Son installation exige trois niveaux de permission : l’autorisation d’envoyer des messages, l’accès aux contacts, et l’accès total au disque (Full Disk Access), puisque le client doit pouvoir lire les messages archivés.

Permissions demandées à l’installation du plugin Messages pour ChatGPT – crédit Next

Dans sa doc, OpenAI ne dit rien en revanche des problèmes de confidentialité, ou de respect de la vie privée, soulevés par une telle intégration. L’entreprise a tout de même répondu à Bloomberg que son plugin ne créait pas d’index en propre des messages stockés sur la machine mais, dans les faits, on ne sait pas à ce stade quels sont les traitements exacts réalisés sur les Messages lors d’une requête, et dans quelle mesure le contenu de ces derniers transite par les serveurs d’OpenAI.

L’accès aux messages n’est pas anodin, puisqu’ils sont susceptibles de contenir des informations personnelles sensibles, qui impliquent l’utilisateur au premier chef, mais aussi l’ensemble des personnes avec lesquelles il correspond ou a correspondu.

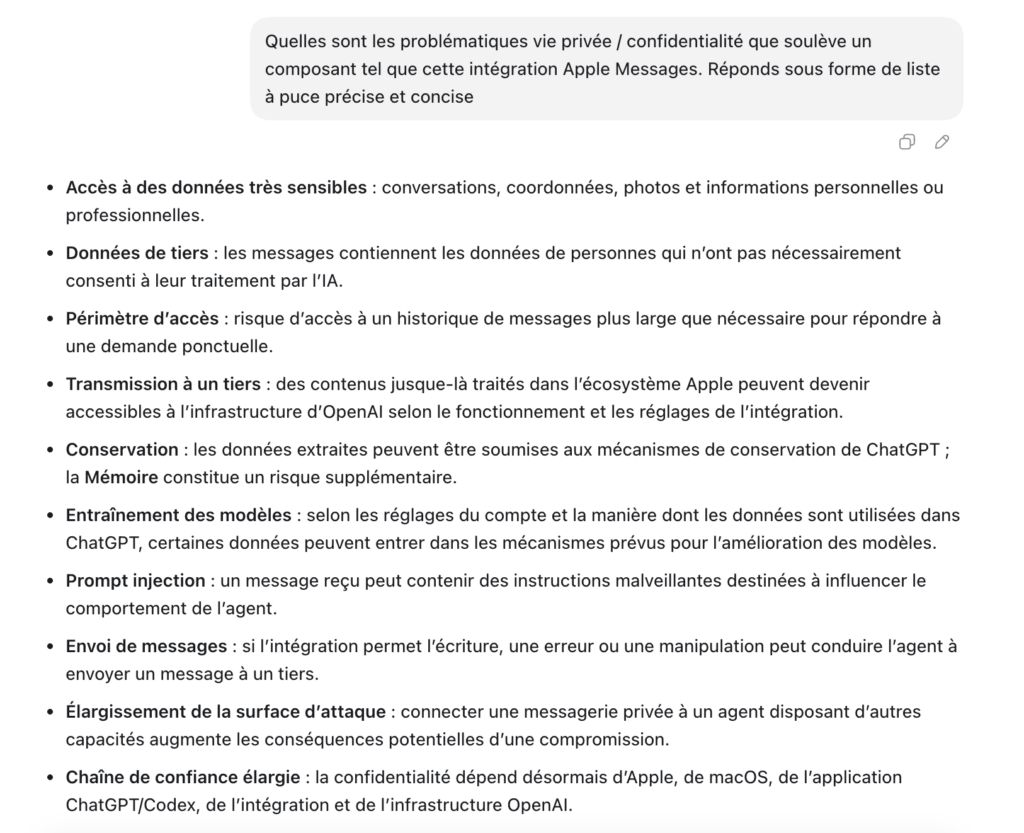
Comptant sur l’impartialité d’un modèle par essence probabiliste, nous avons demandé à ChatGPT de résumer de façon concise les risques soulevés par une telle intégration. La capture d’écran ci-dessous illustre la réponse formulée par le modèle :

Réponse fournie par ChatGPT à la question de savoir si cette intégration soulève des risques relatifs à la vie privée – crédit Next

Un plugin concurrent de l’intégration ChatGPT dans Apple Intelligence

Reste à savoir ce qu’en pense Apple ? La firme de Cupertino ne s’est pas, pour l’instant, exprimée au sujet de cette nouveauté, qui vient pourtant marcher sur les platebandes d’une intégration plus officielle cette fois, celle qui permet d’utiliser ChatGPT avec Apple Intelligence et Siri sur l’iPhone, avec un volet confidentialité encadré par Apple.

Ce lancement intervient quelques jours seulement après l’introduction d’une autre fonctionnalité dédiée à macOS, « Computer History », qui permet à ChatGPT (dont l’application macOS a déjà été épinglée pour avoir stocké des informations en clair) de s’appuyer sur toutes les actions de l’utilisateur pour lui rappeler ce qu’il a fait sur son ordinateur. Fonctionnant littéralement comme un keylogger, celle-ci « génère un flux d’événements d’interaction à partir des applications et des sites web autorisés » en s’appuyant notamment sur « les clics, la saisie au clavier, les raccourcis clavier, les changements d’application et le contexte que macOS met à disposition via son système d’accessibilité ».

Apple accuse pour mémoire OpenAI de malversations et de vol de secrets industriels, ce qui donne lieu depuis le mois de juillet à un bras de fer judiciaire entre les deux entreprises.

  •  

☕️ Sur le web, les bots IA écrivent de plus en plus pour les bots


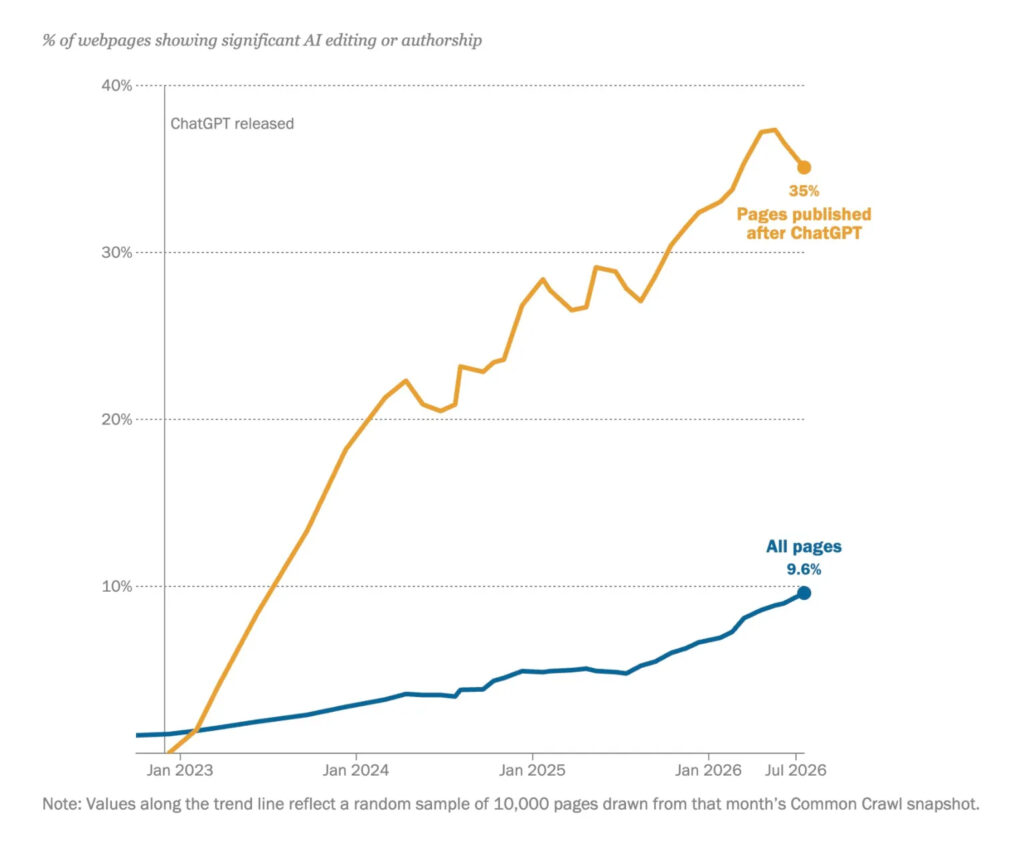
Les bots lisent les bots. Les sites web sont de plus en plus rédigés par des robots IA : plus d’un tiers des pages web mises en ligne après le lancement de ChatGPT intègre des contenus IA, selon une étude du Pew Research.

10 % des 10 000 pages web en anglais prélevées au mois de juillet par le Pew Research « présentent des signes significatifs d’une rédaction par IA » (textes complets ou largement remaniés). Cela parait finalement peu, mais comme le soulignent les chercheurs, une grande partie de ces pages a été mise en ligne avant l’avènement de l’IA. En mettant de côté les pages mises en ligne avant novembre 2022 et le lancement de ChatGPT, le taux monte à 35 % de pages intégrant du contenu IA.

L’étude a été réalisée avec l’aide de l’outil d’archivage web Common Crawl, les textes ayant été scrutés avec l’outil de détection IA Open Pangram. Ces utilitaires ne sont pas infaillibles, ils peuvent ranger à tort des documents rédigés par des humains dans la mauvaise case, et inversement. Néanmoins, certains types de ponctuation, de mots et d’expressions ont tendance à revenir plus fréquemment dans les textes générés par IA.

L’intelligence artificielle générative semble en effet apprécier les tirets cadratins (ils sont utilisés environ deux fois plus souvent) ; l’usage de la virgule de série (le fameux Oxford comma dans une énumération avant le « and », par exemple « I invited Alice, Bob, and Charlie ») augmente de 63 % ; certains mots prisés des IA sont employés plus de deux fois plus souvent (« testament », « interplay »…).

Pour rédiger une comparaison, l’IA a également davantage recours au parallélisme négatif, comme dans la phrase « Ce n’est pas seulement de l’information, c’est de l’influence ». Une tournure qui reste relativement rare tout de même. Les humains ne doivent pas pour autant s’interdire d’utiliser cet arsenal, mais l’IA montre un tropisme certain pour ces formes.

Début juin, Matthew Prince le patron de Cloudflare constatait que les bots (agents IA, mais aussi les bots plus traditionnels) représentaient plus de trafic que les internautes de chair et de sang. « Le trafic généré par les agents IA augmente si rapidement que, pour la première fois dans l’histoire d’internet, le trafic des bots a désormais dépassé celui des humains en ligne », s’étonnait-il. Le dirigeant avait prévu que cette bascule arriverait début 2027.

Autrement dit, de plus en plus de textes rédigés par des bots sont lus par d’autres bots. À ce rythme, les humains risquent bien de faire figure d’intrus sur Internet.

  •  
❌