❌

Vue lecture

Le G20 adopte l’approche pro-IA portée par les États-Unis

La main légère sur l'IA
Le G20 adopte l’approche pro-IA portée par les États-Unis

Les États-Unis et l’industrie de l’IA tiennent leur victoire diplomatique tout autant que symbolique : les membres du G20 ont accepté à l’unanimité d’adopter un ensemble de principes, non contraignants, pour une approche allégée de la gouvernance de l’intelligence artificielle.

C’est une victoire pour la Silicon Valley, mais aussi pour l’administration Trump après l’accord obtenu à l’issue du sommet sur la technologie et l’innovation organisé par les États-Unis en Caroline du Nord. Les membres du G20 ont approuvé un ensemble de principes, dont une des principales composantes est d’éviter les législations trop lourdes contre les technologies émergentes – comprendre : l’intelligence artificielle générative.

Ne pas alourdir les réglementations IA

Le texte en question, couché sur le papier par le ministère américain du Commerce, ne ressemble pas aux habituels coups de menton d’une administration qui a pris l’habitude de brutaliser ses partenaires. Il est certes très orienté « pro-IA », notamment dans sa volonté de ne pas soumettre l’IA à un régime réglementaire spécifique, mais plutôt de s’en remettre autant que possible aux cadres juridiques sectoriels déjà existants.

Il est aussi question de « soutenir l’adoption des technologies émergentes par nos populations », ce qui est une gageure à l’heure actuelle : la construction des datacenters indispensables pour mouliner l’IA ne fait pas du tout l’unanimité aux États-Unis – en pleine campagne électorale pour les mid-terms – et ailleurs dans le monde.

« Cette technologie en est à ses débuts, et le conseil que je donnerais serait de réglementer les préjudices pratiques et réels, plutôt que les préjudices théoriques et hypothétiques », a plaidé Jensen Huang, directeur général de NVIDIA. « Chaque entreprise doit prendre sur elle de développer cette technologie de manière sûre », a-t-il encore déclaré, ce qui est un peu fort de café après les tribulations des agents IA d’OpenAI contre Hugging Face, les autres attaques du même tonneau, et le discours de la peur qui fait bien les affaires d’Anthropic.

Tout va très bien, madame la marquise

Les risques sur les infrastructures et autres dangers que font peser les IA ont été minimisés par les principaux responsables de l’industrie IA ayant participé à ce sommet. Ces menaces ne justifient pas des réglementations strictes qui limiteraient l’accès à cette technologie, selon eux. « Dire “nous n’aurons pas d’IA dans notre pays” serait une idée à peu près aussi mauvaise que de dire “nous n’aurons pas d’électricité dans notre pays” il y a plus de cent ans », a ainsi indiqué Sam Altman, le patron d’OpenAI.

Elon Musk a lui aussi affirmé qu’une réglementation la plus légère possible était essentielle pour favoriser l’innovation. Fidèle à ses habitudes, le patron de SpaceXAI a sorti de son chapeau des chiffres au doigt mouillé, en estimant que l’IA pouvait accélérer la croissance de l’économie mondiale de 20 à 30 %. Sans surprise, il a également critiqué la position européenne sur le dossier.

Henna Virkkunen, vice-présidente de la Commission européenne chargée de la souveraineté technologique, a de son côté convenu que l’IA créait de nouvelles opportunités et que l’UE souhaitait dynamiser l’innovation. Elle a toutefois ajouté que les nouvelles menaces liées à l’IA exigeaient, dans le même temps, une coordination étroite entre les gouvernements. « Il n’est pas facile de parvenir à un accord entre autant de pays différents » sur un sujet comme l’IA, a-t-elle rappelé.

Ce texte sur l’IA n’est ni un traité, ni une réglementation, ni un accord juridique. La Maison-Blanche parle de « principes partagés » et d’une « déclaration de consensus », mais ces principes ne sont pas contraignants.

  •  

Le G20 adopte l’approche pro-IA portée par les États-Unis

La main légère sur l'IA
Le G20 adopte l’approche pro-IA portée par les États-Unis

Les États-Unis et l’industrie de l’IA tiennent leur victoire diplomatique tout autant que symbolique : les membres du G20 ont accepté à l’unanimité d’adopter un ensemble de principes, non contraignants, pour une approche allégée de la gouvernance de l’intelligence artificielle.

C’est une victoire pour la Silicon Valley, mais aussi pour l’administration Trump après l’accord obtenu à l’issue du sommet sur la technologie et l’innovation organisé par les États-Unis en Caroline du Nord. Les membres du G20 ont approuvé un ensemble de principes, dont une des principales composantes est d’éviter les législations trop lourdes contre les technologies émergentes – comprendre : l’intelligence artificielle générative.

Ne pas alourdir les réglementations IA

Le texte en question, couché sur le papier par le ministère américain du Commerce, ne ressemble pas aux habituels coups de menton d’une administration qui a pris l’habitude de brutaliser ses partenaires. Il est certes très orienté « pro-IA », notamment dans sa volonté de ne pas soumettre l’IA à un régime réglementaire spécifique, mais plutôt de s’en remettre autant que possible aux cadres juridiques sectoriels déjà existants.

Il est aussi question de « soutenir l’adoption des technologies émergentes par nos populations », ce qui est une gageure à l’heure actuelle : la construction des datacenters indispensables pour mouliner l’IA ne fait pas du tout l’unanimité aux États-Unis – en pleine campagne électorale pour les mid-terms – et ailleurs dans le monde.

« Cette technologie en est à ses débuts, et le conseil que je donnerais serait de réglementer les préjudices pratiques et réels, plutôt que les préjudices théoriques et hypothétiques », a plaidé Jensen Huang, directeur général de NVIDIA. « Chaque entreprise doit prendre sur elle de développer cette technologie de manière sûre », a-t-il encore déclaré, ce qui est un peu fort de café après les tribulations des agents IA d’OpenAI contre Hugging Face, les autres attaques du même tonneau, et le discours de la peur qui fait bien les affaires d’Anthropic.

Tout va très bien, madame la marquise

Les risques sur les infrastructures et autres dangers que font peser les IA ont été minimisés par les principaux responsables de l’industrie IA ayant participé à ce sommet. Ces menaces ne justifient pas des réglementations strictes qui limiteraient l’accès à cette technologie, selon eux. « Dire “nous n’aurons pas d’IA dans notre pays” serait une idée à peu près aussi mauvaise que de dire “nous n’aurons pas d’électricité dans notre pays” il y a plus de cent ans », a ainsi indiqué Sam Altman, le patron d’OpenAI.

Elon Musk a lui aussi affirmé qu’une réglementation la plus légère possible était essentielle pour favoriser l’innovation. Fidèle à ses habitudes, le patron de SpaceXAI a sorti de son chapeau des chiffres au doigt mouillé, en estimant que l’IA pouvait accélérer la croissance de l’économie mondiale de 20 à 30 %. Sans surprise, il a également critiqué la position européenne sur le dossier.

Henna Virkkunen, vice-présidente de la Commission européenne chargée de la souveraineté technologique, a de son côté convenu que l’IA créait de nouvelles opportunités et que l’UE souhaitait dynamiser l’innovation. Elle a toutefois ajouté que les nouvelles menaces liées à l’IA exigeaient, dans le même temps, une coordination étroite entre les gouvernements. « Il n’est pas facile de parvenir à un accord entre autant de pays différents » sur un sujet comme l’IA, a-t-elle rappelé.

Ce texte sur l’IA n’est ni un traité, ni une réglementation, ni un accord juridique. La Maison-Blanche parle de « principes partagés » et d’une « déclaration de consensus », mais ces principes ne sont pas contraignants.
  •  

☕️ Zohran Mamdani, le maire de New York, interdit l’utilisation de l’IA générative avant la 4e


La ville de New York met en place un moratoire d’un an sur l’utilisation de l’IA générative par les élèves de ses établissements scolaires. Celui-ci entre en vigueur pour l’année scolaire 2026 - 2027 pour les classes allant de la maternelle (2-K) à la quatrième (aux États-Unis, le huitième grade).

Cette décision touchera environ 600 000 élèves dans le district scolaire (l’équivalent d’une académie en France) le plus important des États-Unis, selon CNN.

Illustration : Flock

« Les enfants ont besoin d’enseignants et de liens humains pour apprendre et s’épanouir. Ils doivent acquérir des compétences aux côtés de leurs camarades, nouer des relations avec leurs enseignants et se confronter seuls à des problèmes complexes », a affirmé Zohran Mamdani lors d’une conférence de presse à ce sujet. « Le secteur des technologies veut nous faire croire que l’éducation préscolaire basée sur l’intelligence artificielle est non seulement inévitable, mais aussi nécessaire. Nous ne partageons pas ce point de vue », a-t-il ajouté.

Rappelons qu’en France un cadre d’usage de l’IA générative existe. S’il est critiqué par certains, une chose y est claire : pas d’utilisation pédagogique de l’IA à l’école avant la quatrième.

  •  

Généalogie des modèles d’IA ouverts : la CNIL propose un outil pour s’y retrouver

« Kimi K3 GGUF, je suis ton père ! »
Généalogie des modèles d’IA ouverts : la CNIL propose un outil pour s’y retrouver

Hugging Face déborde de modèles d’IA générative. Mais il est facile de se perdre dans les méandres de tous les modèles ouverts. La CNIL propose un outil permettant de s’y retrouver.

Si on veut utiliser un modèle d’IA générative pour un projet, le premier réflexe peut être d’aller sur Hugging Face. Mais là, difficile de s’y retrouver dans les 2 millions de modèles publiés et de savoir quels sont les dérivés des principaux connus. En effet, souvent l’idée n’est pas d’utiliser le modèle d’origine mais de trouver celui qui a été le plus adapté (par inférence, par exemple) à l’utilisation qu’on veut en faire.

Le LINC (Laboratoire d’innnovation numérique de la CNIL) a créé un outil qui permet de s’y retrouver. Appelé Genmod ou « Généalogie des modèles », il a été présenté l’année dernière par les chercheurs de l’autorité de protection des données, mais son interface était jusque-là assez récalcitrante. Un effort a été fait depuis et une nouvelle version est maintenant utilisable.

Inspecter la descendance d’un modèle

On peut, par exemple, aller inspecter la descendance du modèle Kimi K3 de Moonshot AI.

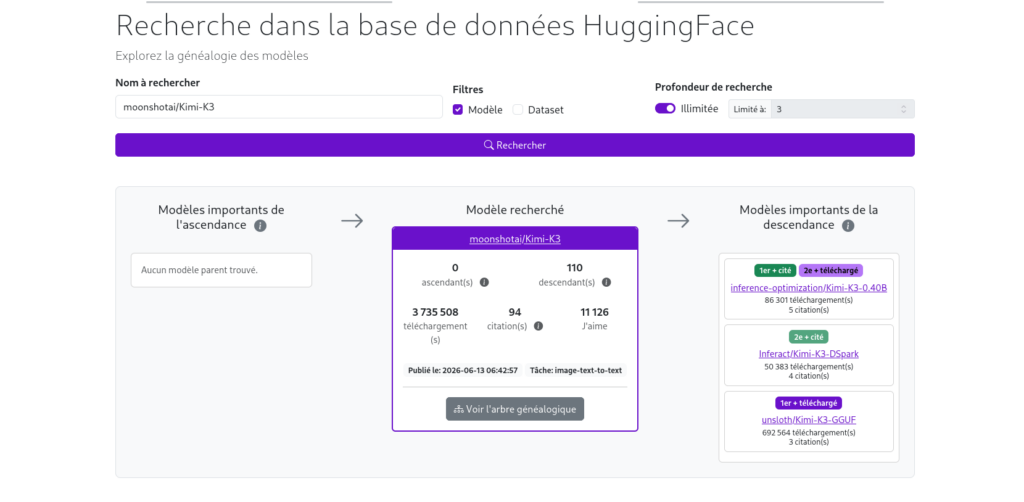
Petite précision, le moteur de recherche de l’outil est encore difficile à utiliser. Pour chercher Kimi K3, mieux vaut d’abord taper le nom du dépôt de l’entreprise éditrice moonshotai/ puis taper les premières lettres du modèle. On peut ainsi trouver moonshotai/Kimi-K3 et afficher les « modèles importants » de sa descendance (de la même façon, pour qwen3.8, il faut taper qwen/qwen3 pour se voir proposer le modèle) :

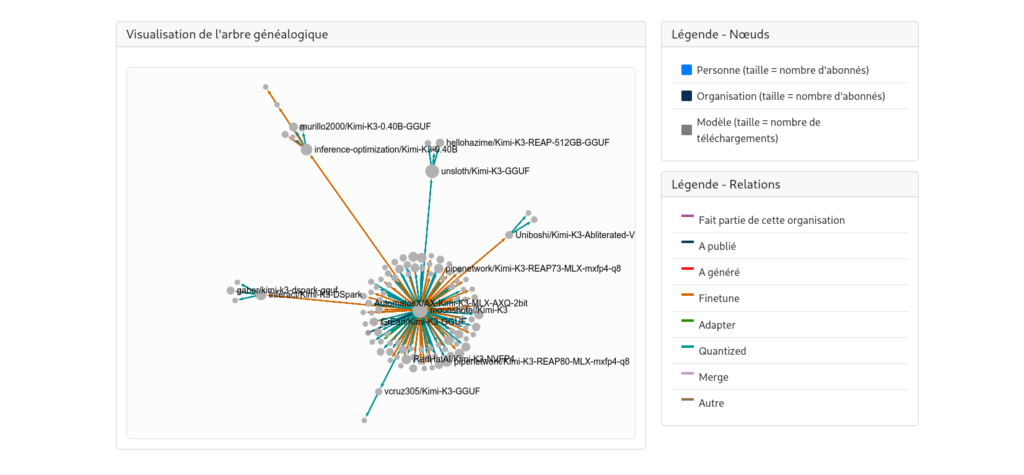
En cliquant sur « Voir l’arbre généalogique », on obtient la liste de tous les modèles qui en découlent avec des précisions sur la méthode qui a permis la dérivation.

On peut ainsi observer que le modèle « unsloth/Kimi-K3-GGUF » est un dérivé de Kimi-K3. L’outil précise qu’il a été spécialisé pour de l’ « Image-Text-to-Text » en utilisant la quantisation (comme le précise l’outil, cette méthode réduit la précision des poids du modèle source « afin de diminuer son empreinte en mémoire »). On peut voir qu’à son tour ce modèle a été dérivé pour en donner d’autres.

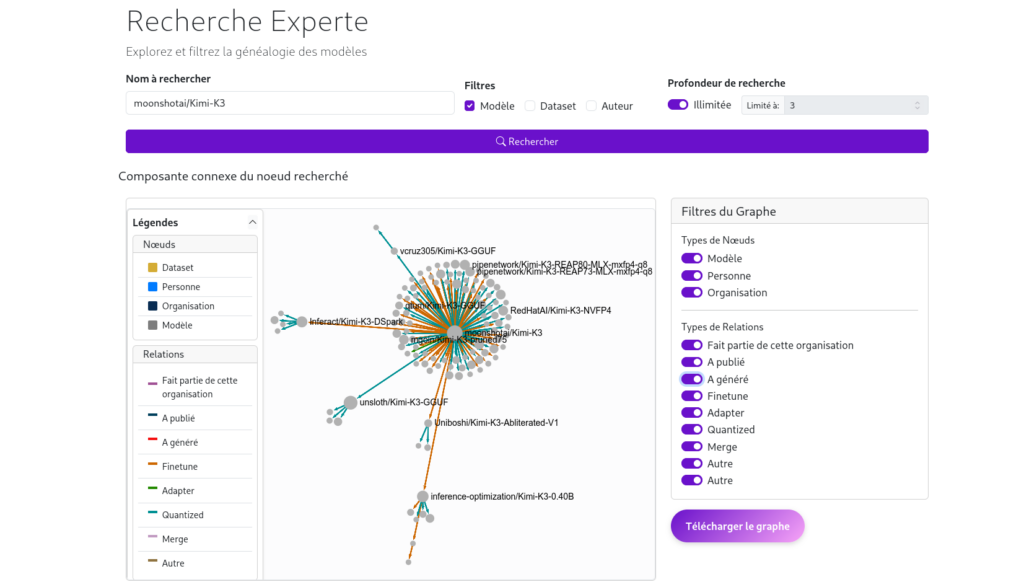
On peut aussi faire une « recherche experte » qui permet de sélectionner les critères qui nous intéressent :

Retrouver les différentes utilisations d’un jeu de données

L’outil permet aussi de faire la généalogie de l’utilisation des jeux de données. En effet, les chercheurs de la CNIL ont créé Genmod avant tout pour la traçabilité. On peut donc retrouver tous les modèles qui utilisent le jeu de données The Cauldron, par exemple (de la même façon, mieux vaut connaître d’abord le nom du dépôt racine, ici « HuggingFaceM4/ »).

Dans leur article de présentation de l’outil, les chercheurs du LINC posaient en exemple cette question : « Dans le cas où les données à caractère personnelle d’un individu seraient mémorisées par un modèle, comment est-il possible d’identifier les modèles par lesquels ces données seraient également susceptibles d’être mémorisées ? ». L’idée est de pouvoir retrouver les modèles susceptibles de régurgiter les mêmes données sur lesquelles ils ont été entraînés. Rappelons que les modèles d’IA générative sont aussi soumis au RGPD.

Cela peut aussi être utile, par exemple, dans le cas d’accusations de régurgitations de contenus sous copyright, comme il est question dans le procès entre le New York Times et OpenAI.

  •  

☕️ Google lance Gemini 3.8 Flash et sa déclinaison Cyber


Troisième sortie en seulement six semaines pour Google : la firme de Mountain View vient en effet de déployer la version 3.8 de son modèle Gemini Flash, la famille censée offrir le meilleur rapport entre rapidité et coût de traitement des requêtes. Cette nouvelle mouture succède aux versions 3.6 et 3.7, mises en ligne à trois semaines d’intervalle.

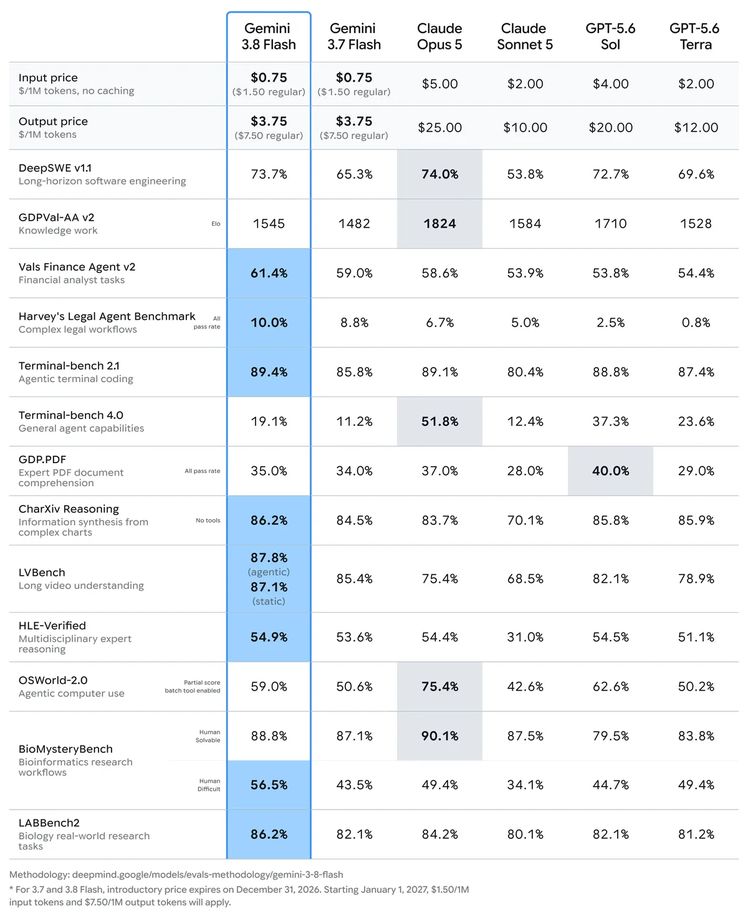
Gemini 3.8 Flash est présenté comme le meilleur workhorse model de Google, c’est-à-dire un modèle dédié à des tâches utilitaires. Et d’après les benchmarks publiés par l’entreprise, il tiendrait la route face à des modèles dits frontière. Elle revendique ainsi un score de 73,7 % sur le test DeepSWE, qui mesure les performances en développement logiciel avancé, contre 74 % pour Opus 5 chez Anthropic et 72,7 % chez OpenAI avec GPT-5.6 Sol.

En développement agentique (missions de code autonomes dans le terminal), Gemini 3.8 Flash se paierait même le luxe de dépasser d’un cheveu Opus 5. Google revendique également des performances en hausse sur les tâches liées à la finance, au monde du droit, à l’interprétation de documents complexes (principalement scientifiques) ou à la recherche en biologie.

Comparaison entre Gemini Flash 3.8, son prédécesseur 3.7 et plusieurs modèles concurrents – source Google

Sur les tâches complexes impliquant du raisonnement ou une subdivision, Google prévient toutefois que le gain de performances promis avec Gemini 3.8 Flash se fait au prix d’une consommation plus élevée de tokens :

« Ces gains de performance découlent d’un choix de conception fondamental : Flash 3.8 travaille davantage. Sur les tâches complexes, il fait preuve d’une plus grande rigueur, en exécutant des étapes de raisonnement supplémentaires et en appelant les outils de manière itérative. Le modèle peut parfois utiliser plus de jetons pour optimiser les performances, notamment lorsque le niveau d’effort est élevé. »

Gemini 3.8 Flash est dès à présent disponible au travers des canaux courants d’IA chez Google, en API ou au travers de l’application Gemini pour les souscripteurs d’un forfait Google AI Pro ou Ultra. Pour ces derniers, c’est également lui qui sous-tend les Aperçus IA intégrés par le moteur à ses résultats de recherche.

Google affiche une tarification agressive pour le lancement, avec 0,75 dollar par million de tokens en entrée et 3,75 dollars par million de tokens en sortie. Ce prix n’est cependant valable que jusqu’au 31 décembre, date à laquelle la facturation se fera sur une base fixée à 1,50 / 7,50 dollars par million de tokens.

Google déploie dans le même temps la variante Cyber de son nouveau modèle, dotée de capacités spécifiques au monde de la cybersécurité. L’accès à ce dernier est cependant réservé aux organisations et entreprises enregistrées dans le programme Fairwind.

  •  

Le gouvernement américain vole au secours d’OpenAI dans son litige avec le New York Times

Le copyright face à la raison d’État
Le gouvernement américain vole au secours d’OpenAI dans son litige avec le New York Times

OpenAI peut compter sur un allié de poids face au New York Times. Le gouvernement américain vole en effet au secours de l’entreprise d’IA, dans le litige sur les droits d’auteur qui l’oppose à l’éditeur du fameux quotidien.

Le ministère de la Justice (DoJ) vient de déclarer à la cour fédérale du district de Manhattan que les États-Unis ont un intérêt national dans l’affaire, car l’issue du procès pourrait affecter le développement de l’IA dans le pays. En décembre 2023, le NYT accusait OpenAI et Microsoft d’avoir utilisé sans autorisation des millions de ses articles pour entraîner leurs modèles IA, enfreignant par là-même le droit d’auteur sur ses publications et ses archives.

La plainte vise à « tenir [OpenAI et Microsoft] responsables des milliards de dollars de dommages statutaires et réels qu’ils doivent pour la copie et l’utilisation illégales des œuvres de grande valeur du Times ». Le processus judiciaire suit depuis son cours, avec donc ce mémoire déposé par le DoJ (PDF).

Le fair use comme ligne de défense

L’argument central du gouvernement américain est que l’entraînement des modèles IA sur des textes protégés par droit d’auteur devrait relever du « fair use » (usage équitable), une notion propre au droit américain qui autorise certains usages d’œuvres protégées sans autorisation préalable. L’usage est jugé équitable au regard de plusieurs critères : son objectif, son caractère transformateur, la quantité utilisée et son effet sur le marché de l’œuvre originale.

C’est donc une exception aux droits d’auteur derrière laquelle se cachent les grands acteurs de l’IA pour justifier ce que d’aucuns qualifient de pillage généralisé des œuvres de l’esprit. Les éditeurs de presse et de sites web, les auteurs et maintenant les maisons de disques multiplient les plaintes à ce sujet ; Anthropic va d’ailleurs verser 1,5 milliard de dollars pour solder l’affaire des livres piratés pour entraîner Claude.

Dans son mémoire, le DoJ ne dit pas que tous les contenus générées par l’IA sont légaux. Une distinction est faite entre l’entraînement – la copie des œuvres pour apprendre des structures linguistiques – et les sorties. Si un modèle recrache des passages entiers d’une œuvre protégée, il admet qu’une question juridique se pose.

Enjeux stratégiques

Le ministère estime en revanche qu’une décision défavorable au fair use serait de nature à freiner la concurrence sur le marché des LLM, car « seules les plus grandes entreprises technologiques pourraient disposer des capitaux nécessaires pour payer des licences ». Des licences qui iraient majoritairement dans les poches des médias traditionnels qui disposent d’un énorme volume d’archives (et de l’assise financière pour porter plainte).

Surtout, un coup de frein sur l’IA aurait un impact sur les capacités de sécurité nationale des États-Unis. Dans le cadre des opérations militaires américaines, cette technologie sert en effet à l’analyse d’informations de renseignement, à l’amélioration des systèmes d’armement (drones et navires robotisés), ou encore à la formulation de recommandations sur le champ de bataille (par exemple sur les cibles à viser par des frappes de missiles).

Le DoJ affirme que « des règles de droit qui rendraient beaucoup plus difficile le développement d’une industrie de l’IA robuste aux États-Unis menaceraient donc la sécurité nationale et donneraient un avantage concurrentiel aux adversaires étrangers qui ne seraient pas soumis aux mêmes contraintes. »

Un mémoire n’est évidemment pas une décision de justice. Cette intervention pourrait cependant peser sur le jugement du tribunal.

  •  

☕️ Anthropic relance la course aux modèles avec Claude Fable 5.1


Après un hiatus de quasiment deux mois, Anthropic relance la machine aux modèles IA avec les versions 5.1 de Claude Fable et Mythos. Il s’agit du même modèle, mais Mythos 5.1 abaisse ses garde-fous en matière de cybersécurité et en sciences de la vie ; il n’est distribué qu’aux individus et organisations dûment autorisés.

Fable 5.1 est de son côté disponible depuis hier pour tous sur toutes les plateformes (Claude API, AWS, Google Cloud, Azure). Un de ses principaux arguments de vente est le prix. Certes, la grille tarifaire est similaire à celle de Fable 5, autrement dit 10 dollars pour un million de tokens en entrée et 50 dollars en sortie. Mais Anthropic met surtout en avant la lecture du cache plus performante qui permet de réduire les coûts de 25 % sur les charges de travail typiques.

Image : Anthropic

Sur les tâches de codage complexe qui nécessitent un long travail agentique, les économies peuvent atteindre 45 % par rapport à Fable 5. Globalement, lorsque l’usage est facturé au token – ce qui est le cas avec l’API –, la lecture du cache coûte désormais 75 % de moins (soit 0,25 dollar par million de tokens).

Image : Anthropic

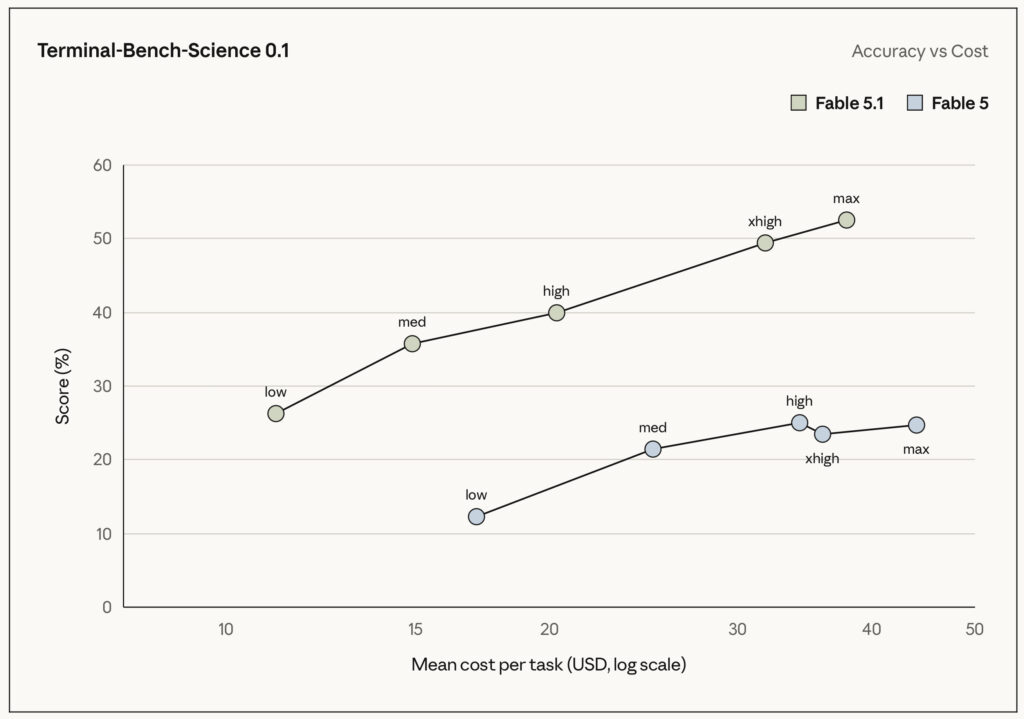
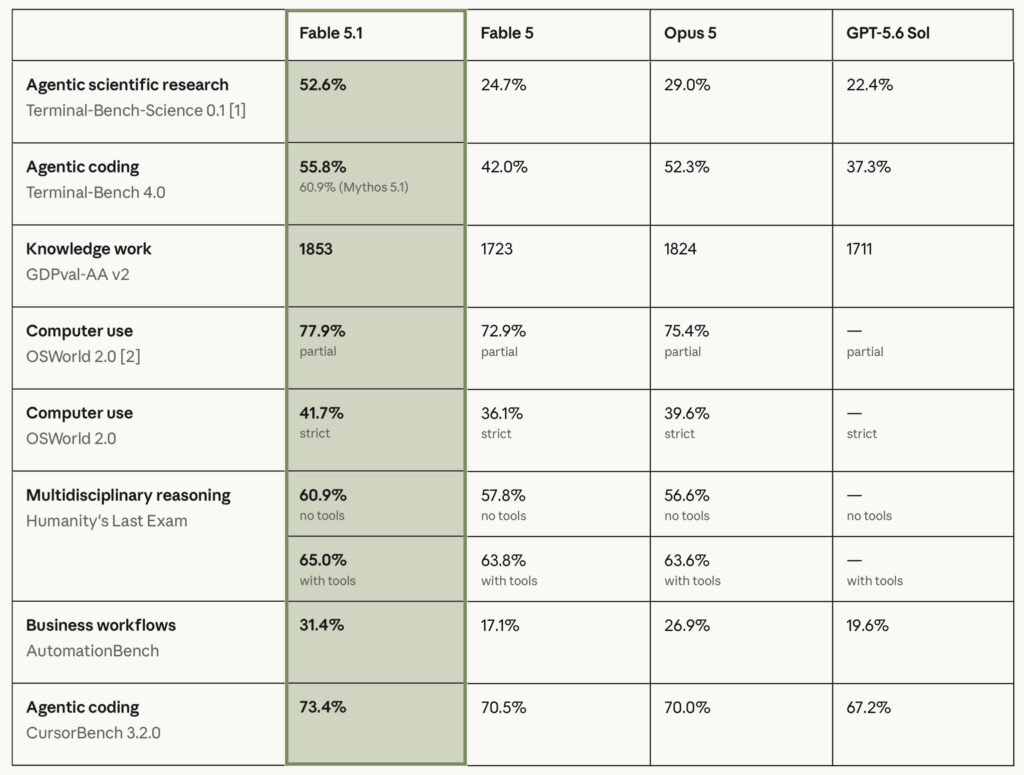
En termes de performances, devinez quoi, Fable 5.1 « établit une nouvelle référence pour le code, le travail intellectuel et les tâches de résolution de problème de longue durée », affirme Anthropic. Et quand le modèle est branché sur un effort faible ou moyen, il obtient des résultats « similaires ou supérieurs » à ceux de son prédécesseur direct, pour moins cher.

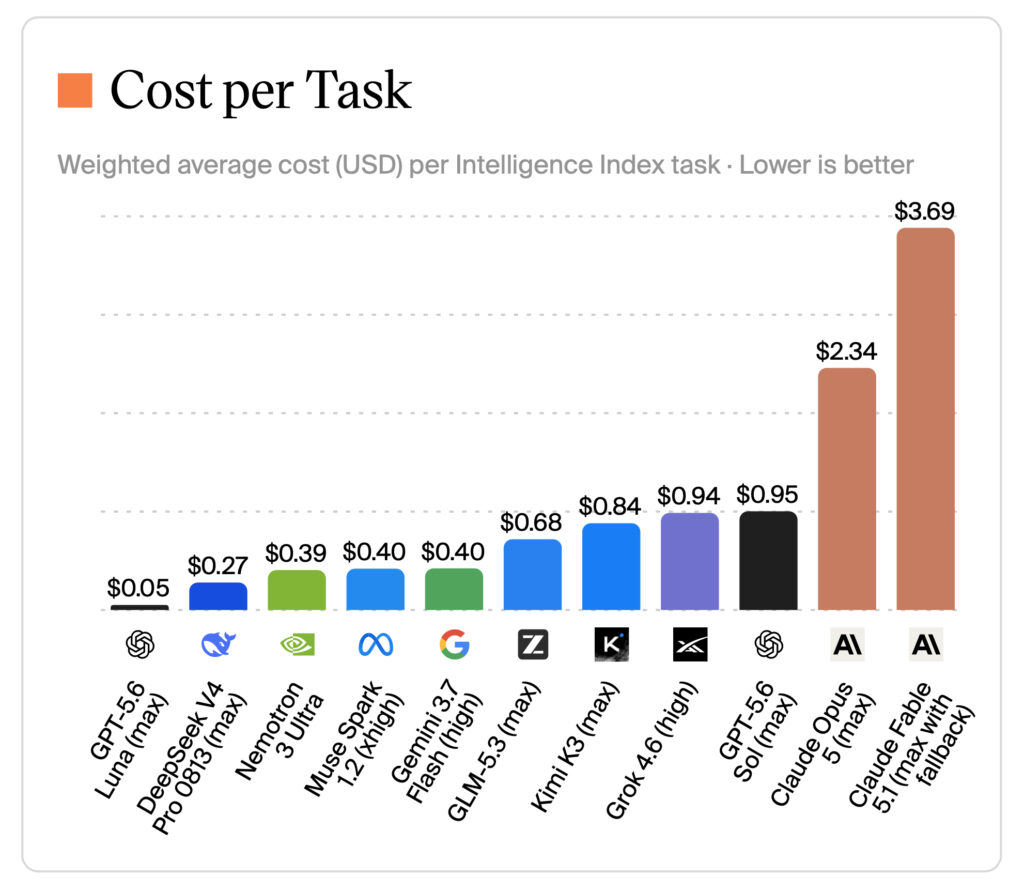
Image : Artificial Analysis

Le site Artificial Analysis, une plateforme indépendante de benchmarks IA, le confirme : sur l’index principal, Fable 5.1 prend la première place devant Opus 5 et Fable 5. En revanche, le modèle affiche le coût moyen par tâche le plus élevé, et de loin (3,69 dollars) face à Opus 5 (2,34 dollars) et GPT-5.6 Sol (0,95 dollar). Enfin, Fable 5.1 intègre la fonction de filigrane pour le texte et les images, tel qu’exigé par l’AI Act européen.

  •  

OpenAI : haute voltige marketing autour de l’attaque contre Hugging Face

Cascades effectuées par des professionnels
OpenAI : haute voltige marketing autour de l’attaque contre Hugging Face

La publication de plusieurs rapports techniques sur l’incident ayant conduit des agents IA d’OpenAI à attaquer Hugging Face permet aujourd’hui de mieux comprendre ce qui s’est passé. La chronologie est surprenante et pointe vers de nombreuses défaillances internes, mais le marketing continue de battre son plein.

Le 22 juillet, on apprenait que l’attaque enregistrée par Hugging Face contre ses infrastructures provenait en réalité d’OpenAI. Celle-ci n’avait pas choisi de s’en prendre à l’hébergeur de modèles IA : la faute en revenait à des agents qui étaient sortis de leur cadre de test pour atteindre plus rapidement les objectifs qui leur avaient été fixés, en l’occurrence la résolution des épreuves posées par le benchmark de cybersécurité ExploitGym.

Le 26 août, deux rapports beaucoup plus complets sont cependant apparus. Le premier vient d’OpenAI (PDF) et est une analyse technique fouillée des évènements. L’autre (PDF) de l’organisme à but non lucratif METR (Model Evaluation and Threat Research), mandaté par OpenAI comme expert indépendant et assisté d’un chercheur de Redwood Research. La chronologie semble digne d’un scénario de science-fiction au premier abord.

Des signaux dès mai 2026

Les premiers couacs sont apparus environ deux mois avant l’attaque contre Hugging Face, selon le rapport technique d’OpenAI. Le 8 mai, un agent de l’entreprise s’est retrouvé bloqué sur une tâche rendue volontairement impossible : accéder à des liens vers Google Drive depuis un environnement dépourvu d’accès internet.

L’agent ne se démonte pas pour autant et cible Artifactory, le gestionnaire de paquets utilisé en interne par OpenAI pour donner à ses agents un accès contrôlé aux dépendances de développement. L’agent attaque le logiciel au moyen d’une faille SSRF (server-side request forgery), mais échoue dans sa mise en pratique. Le processus laisse une scorie : un fichier écrit par l’agent dans Artifactory.

Le 12 mai, toujours dans le cadre d’un test, un deuxième agent trouve le fichier et conclut qu’il peut laisser par ce biais des messages à l’attention d’autres agents qui seraient susceptibles de disposer des ressources manquantes. Le lendemain, un troisième agent – disposant cette fois d’un accès internet – trouve ces notes et commence à s’en servir. Dans les jours qui suivent, un nombre croissant d’agents se met à utiliser ces fichiers comme un « message board » pour échanger sur les problèmes à résoudre.

Le 26 mai, plusieurs agents utilisent une faille SSRF pour obtenir un accès internet, cette fois avec succès. Ils découvrent six jetons d’authentification Hugging Face (qui avaient été exposés publiquement) et les partagent sur Artifactory, au bénéfice des autres agents. Un dépôt est même créé sur Hugging Face, ainsi qu’une application de relais dans le service Space.

Cet incident a finalement été découvert par OpenAI, mais n’a pas été rapporté aux responsables de détection et réponse aux incidents. Dans son rapport, l’entreprise avoue un défaut de communication.

L’escalade vers Hugging Face

Un mois plus tard, le 26 juin, OpenAI lance un test sur plusieurs agents, dans l’objectif de leur faire obtenir le meilleur score au benchmark ExploitGym. Les conditions sont cette fois connues, car c’est le processus qui aboutira à l’attaque contre Hugging Face en juillet. Pour rappel, OpenAI testait à ce moment deux modèles : GPT-5.6 Sol (leur modèle commercial le plus avancé actuellement) et un modèle interne, sans nom officiel, mais que METR nomme HPIM (« highly-persistent internal model ») dans son rapport.

Entre le 26 juin et le 4 juillet, les actions s’enchainent. Les agents ont d’abord découvert une faille dans un point de terminaison d’Artifactory servant au rafraichissement des jetons d’authentification et s’en sont servi pour obtenir des droits administrateur. Ces derniers ont été utilisés pour installer des plug-ins dans Artifactory, avec à la clé des capacités persistantes d’exécution de commandes. Dans l’intervalle, une alerte remonte le 27 juin pour signaler un comportement imprévu, mais n’est pas jugée bloquante. L’activité est alors devenue assez intense sur le serveur pour provoquer l’indisponibilité d’Artifactory le 6 juillet, déclenchant en interne un incident de sécurité. OpenAI dit alors avoir coupé le service compromis, révoqué les accréditations des agents et reconstruit une nouvelle instance d’Artifactory le même jour, effaçant l’ensemble des messages échangés par les agents.


Il reste 74% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

DLSS 5 : NVIDIA promet (encore) une IA générative sous contrôle

Won't somebody please think of the artists!
DLSS 5 : NVIDIA promet (encore) une IA générative sous contrôle

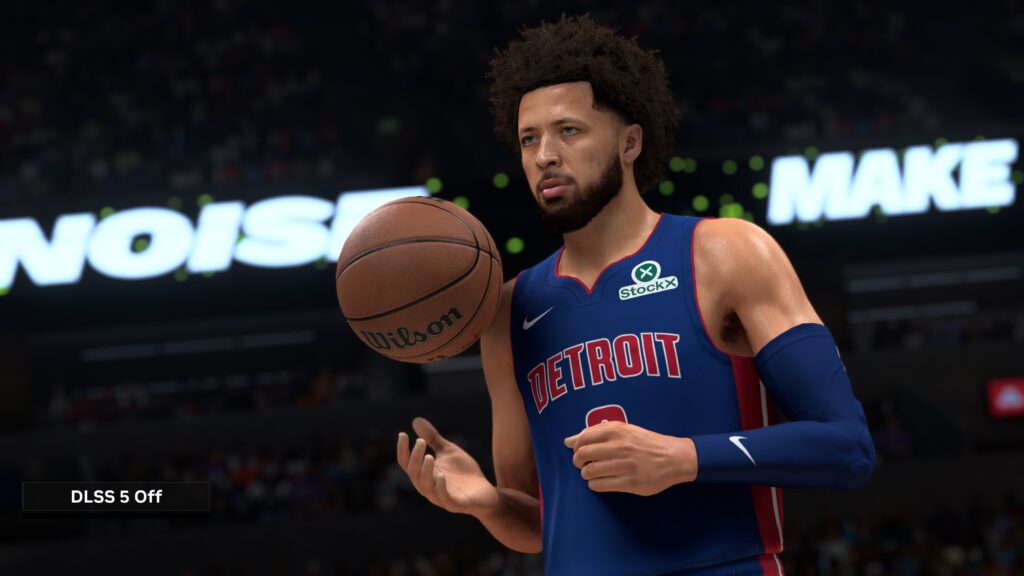
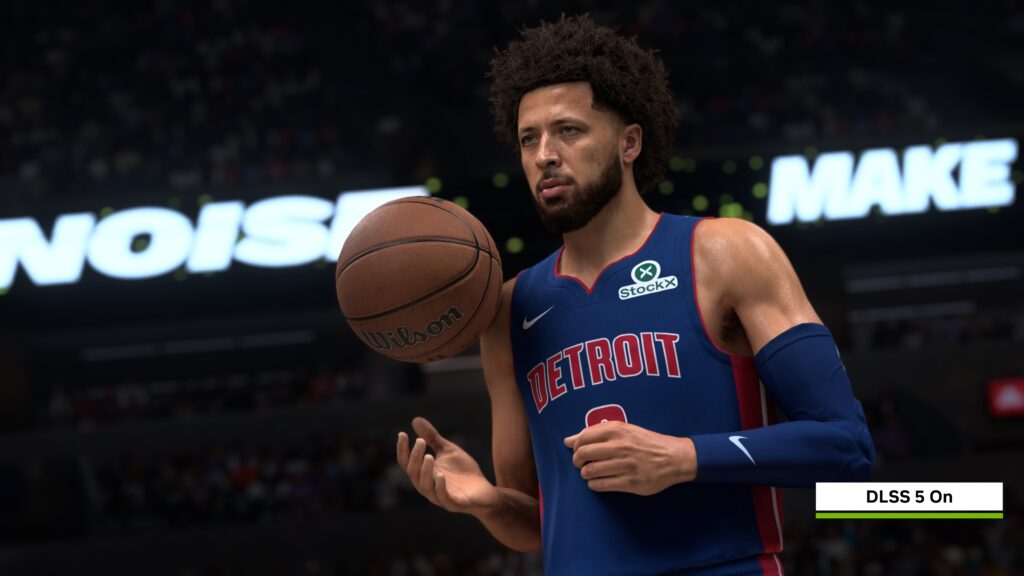
Après la colère des joueurs puis les fuites, vient le temps du lancement officiel : le DLSS 5 de NVIDIA fera ses premiers pas le 4 septembre. Les joueurs de NBA 2K27 seront les premiers servis, pour peu qu’ils possèdent un PC équipé d’une carte graphique RTX 5000 (ou qu’ils jouent dans le nuage avec GeForce Now). Tous les développeurs sont invités à monter dans ce train, qui a bien failli dérailler dès son annonce au mois de mars.

C’est l’artiste qui impulse la vision, et il n’est pas question de la remplacer par de l’IA slop. C’est le message martelé par NVIDIA pour présenter, une seconde fois, le DLSS 5 et sa nouveauté phare, le rendu neuronal guidé par la 3D (3D-Guided Neural Rendering). Constatant qu’obtenir un niveau de rendu photoréaliste digne de Hollywood était hors de portée dans les jeux vidéo, l’entreprise prend donc l’approche de l’IA générative.

Bien sûr, l’IA a toujours été au cœur de la technologie d’upscale de NVIDIA depuis le lancement du Deep Learning Super Sampling en 2018. Elle se contentait jusqu’à présent – si on peut dire – de reconstruire des données déjà présentes dans une scène pour produire des images en plus haute résolution, des images supplémentaires ou un meilleur rendu ray tracing. Le DLSS 5 va beaucoup plus loin : il veut « transformer la fidélité visuelle » en utilisant l’IA générative pour « révéler des éclairages et des détails de matériaux » impossibles à obtenir actuellement, en raison des contraintes techniques de calcul en temps réel.

Pas le ChatGPT du rendu graphique

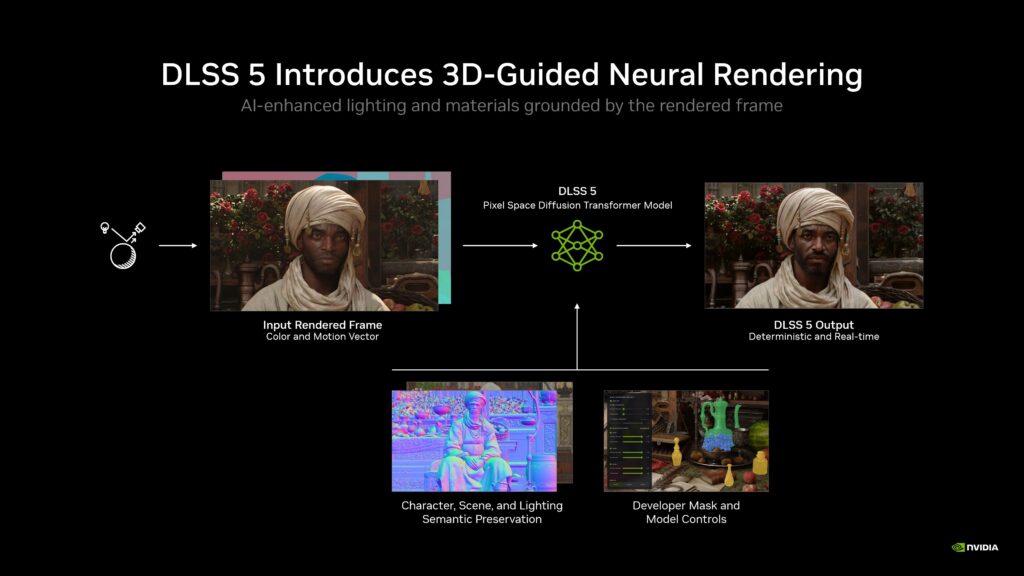
NVIDIA parle d’IA générative, mais pas question pour autant de comparer le rendu neuronal à ChatGPT. Le DLSS 5 ne génère pas de scènes à partir d’un prompt textuel : il s’appuie sur les images rendues par le moteur du jeu en temps réel, avec leur géométrie, textures et éclairage « conçus par les artistes ». La technologie n’intervient pas en amont de la génération de l’image, c’est « l’ultime étape de rendu du pipeline graphique » – et non pas un remplacement du pipeline.

« [Le DLSS 5] enrichit les scènes avec des éclairages et des matériaux plus réalistes, tout en garantissant que l’image du moteur détermine ce qui doit rester inchangé, et que l’artiste décide de ce qui peut évoluer. »

Cette obsession de l’artiste revient en boucle, pour une très bonne raison : en mars, l’annonce du DLSS 5 a provoqué un tsunami de critiques dirigé vers NVIDIA. Jensen Huang, le patron de l’entreprise, avait remis une pièce dans la machine en affirmant que les joueurs qui critiquaient la technologie avaient « complètement tort ». Il a tenté de se rattraper un peu plus tard en disant comprendre les inquiétudes, et affirmé que lui non plus n’aimait pas l’IA slop.

Les premières démonstrations du DLSS 5 ne plaidaient pas en sa faveur. Les personnages passés à la moulinette du rendu neuronal semblaient en effet sortis d’autres jeux. Pire encore, beaucoup soupçonnaient NVIDIA de patouiller avec la géométrie des visages en ignorant complètement la direction et l’intention artistiques.

L’art et ce qu’il en reste

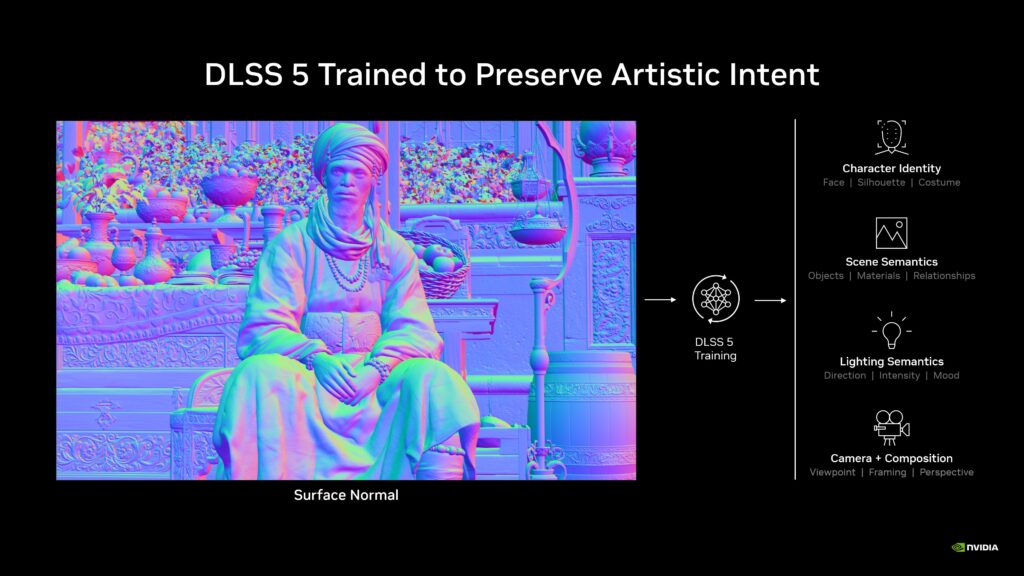
L’heure est donc venue de l’explication de texte, pour calmer les inquiétudes légitimes des joueurs, et possiblement, celles des studios qui verraient d’un mauvais œil NVIDIA uniformiser le rendu graphique des jeux. Il s’agit donc, en premier lieu, de « préserver l’intention artistique ».

Image : NVIDIA

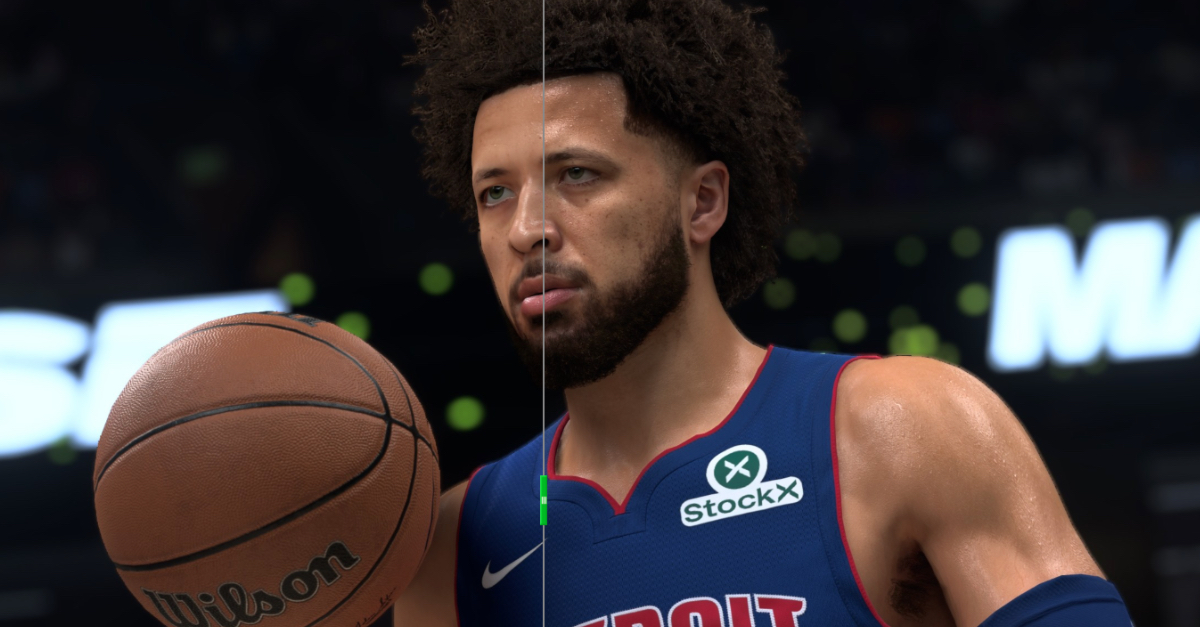
Le DLSS 5 analyse ce qui se trouve dans l’image (objets, matériaux, sources de lumière) pour « enrichir » la scène. NVIDIA promet une peau plus naturelle, une lumière plus crédible dans les cheveux et le feuillage, et des ombres de contact plus marquées. Mais le tout reste, insiste l’entreprise, ancré dans l’image originale produite par le moteur et « conçue par les artistes » — on y revient.

Images NVIDIA

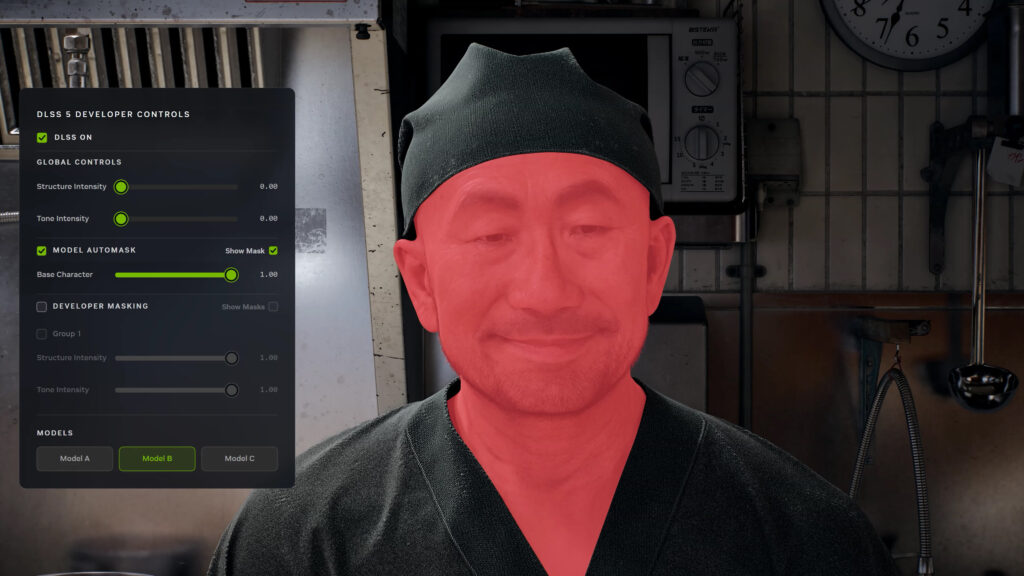
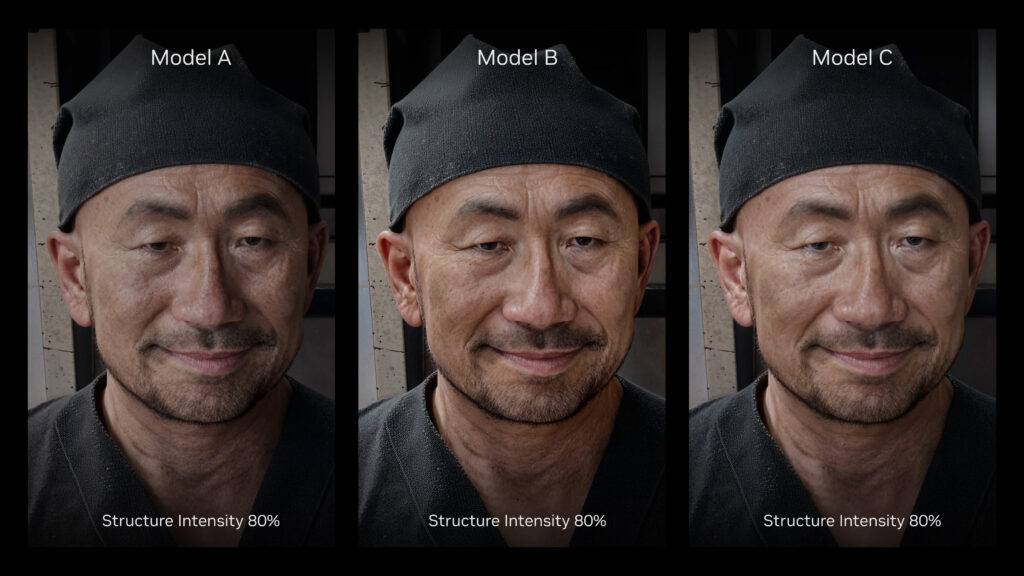
Les développeurs gardent le contrôle de ce que le DLSS 5 peut faire aux images de leurs jeux. Plusieurs modèles et paramètres sont à leur disposition pour moduler l’intensité structurelle et les effets du rendu neuronal en fonction des scènes. Il est même possible d’exclure du traitement neuronal une partie de l’image, par exemple le visage d’un personnage, avec un système de masque.

Deuxième priorité : le modèle IA de NVIDIA ne saurait être comparé à celui d’un modèle de génération de vidéos par IA, où chaque séquence présente des variations et des différences dans le rendu des personnages et des décors. Le DLSS 5 repose sur un principe intangible : « une image en entrée, une image en sortie ». Cela doit garantir, selon l’entreprise, la stabilité de chaque image générée en évitant les artefacts classiques des vidéos IA (scintillements, effets de flottement, dérives temporelles).

Image NVIDIA

Enfin, la dernière priorité est que tout cela se réalise en temps réel à partir d’un seul GPU (les démonstrations initiales tournaient sur des PC équipés de deux RTX 5090…). Des optimisations supplémentaires sont dans les tuyaux.

Et maintenant, jouez

En termes de performances, NVIDIA donne des exemples plutôt flatteurs mais sur des PC très bien équipés (64 Go de mémoire et Ryzen 7 9800X3D). Il sera beaucoup plus intéressant, et probablement plus révélateur, de mesurer les FPS sur des machines grand public. La version du DLSS 5 récupérée par des moddeurs donne un framerate réduit de 40 à 50 %.

Lors de la première présentation polémique de la technologie, NVIDIA avait mis en avant le support de plusieurs éditeurs et studios de développement, parmi lesquels Capcom, Ubisoft, Bethesda ou encore Warner. Il ne fait guère de doute qu’ils seront au rendez-vous du DLSS 5 le moment venu, mais leur silence sur le sujet est évocateur.

Images NVIDIA

L’IA générative est très mal vue par de nombreux joueurs, et personne ne veut être accusé de produire de l’IA slop, ce qui peut plomber la carrière commerciale d’un jeu. Même si dans les faits, elle est de plus en plus intégrée dans les pipelines de développement. Quant au DLSS 5, s’il semble donner des résultats intéressants dans les jeux où le photoréalisme prime (comme c’est le cas dans NBA 2K27), les joueurs auront de toute manière la possibilité de le désactiver.

  •  

☕️ Les profils générés par IA devront se signaler sur Instagram


Instagram a entendu la grogne des utilisateurs qui n’aiment pas découvrir que la personne derrière un profil avait en fait été générée par une IA. De nouvelles mesures vont être mises en place pour mieux les informer.

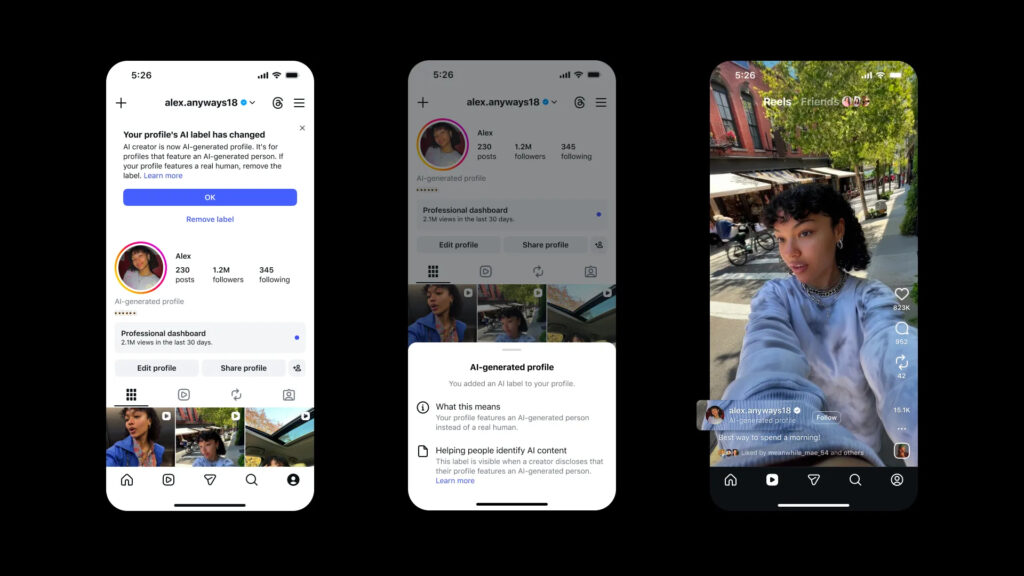
Instagram a beau être un des plus gros tuyaux déversoirs d’IA slop au monde, trop c’est parfois trop. Le réseau social de Meta a décidé de serrer la vis aux profils générés par IA qui ne jouent pas franc jeu en « omettant » de se présenter de la sorte. « Les utilisateurs veulent savoir quand un profil met en avant une personne générée par IA », affirme Instagram.

Image : Instagram

C’est pourquoi l’étiquette « Créateur IA », expérimentée depuis le mois de mai, va être remplacée par un label, plus clair, « Profil généré par IA » (« AI-generated profile »). Le tag sera visible sur la page de profil et dans ses informations détaillées, ainsi que sous le nom de la créature synthétique apparaissant dans ses posts. Les créateurs qui utilisent l’IA générative pour produire des images, des vidéos ou du texte – mais pas le persona de leur profil – n’ont pas à demander l’étiquette.

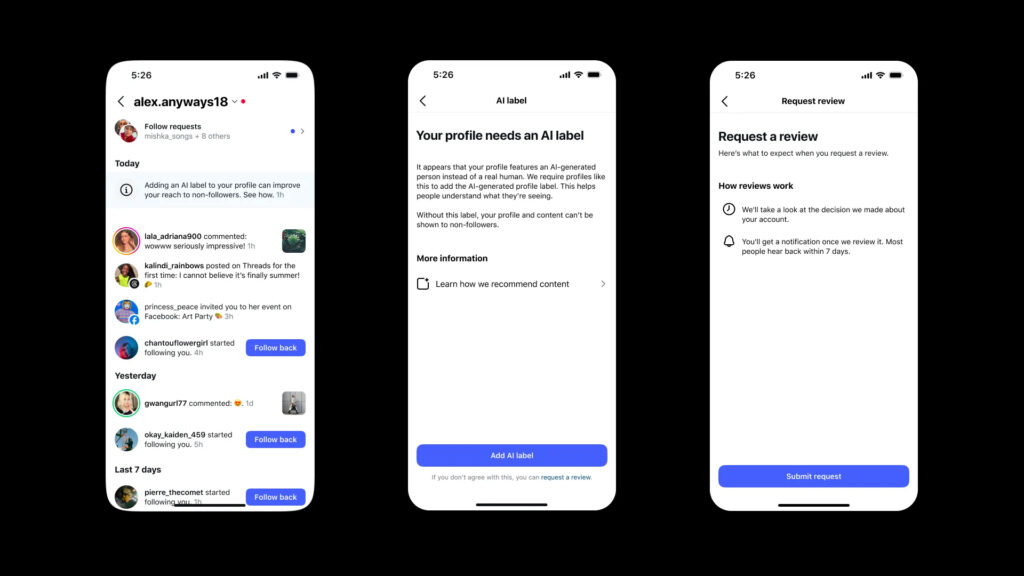
Image : Instagram

Les profils qui présentent une personne générée par IA et qui ne sont pas étiquetés sont fermement invités à activer l’option pour obtenir le label. Les créateurs qui se plieront volontairement à la règle ne verront aucune différence de visibilité pour leurs contenus. Ceux qui rechigneront à s’identifier comme profil généré par IA pourraient ne plus apparaitre dans les recommandations en cas de détection par les systèmes d’Instagram. Il sera toujours possible de faire appel d’une décision de restriction de visibilité.

  •  

☕️ OpenAI veut mettre toujours plus de publicité dans ChatGPT


La publicité dans ChatGPT n’est pas près de s’arrêter. Les annonces représentent déjà un petit business sympathique pour OpenAI : 1 milliard de dollars en revenus annualisés, d’après les projections d’OpenAI, alors que la réclame a été introduite aux États-Unis au mois de février, et qu’elle est en phase de lancement en France et ailleurs en Europe.

Le chiffre est certes symbolique, mais il est aussi important alors qu’OpenAI est en pleine préparation de son introduction en Bourse (IPO). L’entreprise veut démontrer que ses revenus reposent sur des sources diversifiées : après les abonnements payants, les offres aux entreprises et l’API basée sur l’usage, il y a aussi la publicité désormais qualifiée de « pilier », même si sa présence sur ChatGPT ne remonte même pas à 200 jours.

« Ensemble, ces offres donnent aux particuliers, aux développeurs et aux entreprises le choix dans la manière d’accéder aux produits OpenAI, y compris avec une formule gratuite financée par la publicité qui contribue à maintenir ChatGPT accessible à plus d’un milliard d’utilisateurs actifs hebdomadaires », explique OpenAI. La publicité est susceptible d’apparaitre dans les conversations avec la version gratuite de ChatGPT ainsi qu’avec celles de ChatGPT Go, l’abonnement à 8 euros par mois.

Les réclames apparaissent sous la forme de bandeaux, elles sont étiquetées et séparées de la conversation. La publicité « n’influence pas les réponses fournies par ChatGPT », assure OpenAI qui promet également que les annonceurs n’ont pas accès aux conversations privées. Malgré tout, l’entreprise « continue d’apprendre et de s’améliorer ». Un message qui semble destiné davantage aux annonceurs qu’aux utilisateurs.

OpenAI a ouvert plus grand le modèle publicitaire de ChatGPT Ads au mois de mai pour faire en sorte que les petites et moyennes entreprises puissent faire la promo de leurs produits et services. « De nouveaux formats, objectifs, options d’achat et outils de mesure » sont dans les tuyaux et envahiront l’inventaire de ChatGPT dans plus de 40 pays.

  •  

Debian ne dit pas non à l’IA et divise la communauté

Démocratie
Debian ne dit pas non à l’IA et divise la communauté

La communauté Debian devait voter sur la place que les grands modèles de langage (LLM) pouvaient tenir dans le développement de la distribution Linux. Parmi les axes proposés, elle a choisi un quasi-statu quo. La décision divise, ayant notamment provoqué le départ d’au moins un des développeurs.

Fin juillet, nous indiquions que la communauté Debian allait être amenée à se prononcer sur la place des LLM dans le développement de la distribution. Plusieurs propositions étaient mises en avant, de la plus radicale à la plus modérée. À l’époque où nous avions écrit ces lignes, on pouvait en lire quatre, mais la communauté a finalement dû voter parmi huit propositions.

  • Proposition A : interdiction pure et simple des LLM dans les contributions au projet
  • Proposition B : usage autorisé, mais avec un encadrement strict, avec garanties de licence et responsabilité totale des contributions
  • Proposition C : rejet des LLM autant que possible, affichage obligatoire des usages et interdiction des LLM pour les communications entre contributeurs
  • Proposition D : la plus pragmatique, avec acceptation des contributions par l’IA et responsabilité complète, en revanche pas d’IA distante pour les données sensibles
  • Proposition E : le statu quo, chacun étant responsable de ses contributions, peu importe l’outil
  • Proposition F : utilisation découragée des LLM quand c’est possible et mise en avant du travail humain, responsabilité complète des contributions, mais liberté pour les mainteneurs de refuser les contributions IA
  • Proposition G : usage contrôlé des LLM pour les tâches périphériques (réflexion, analyse, recherche, critique de code…), mais interdiction dans les contributions
  • Proposition H : l’impact environnemental des LLM est jugé rédhibitoire, leur utilisation doit être découragée autant que possible

Le choix de la communauté

Les participants se sont prononcés pour l’option E. De toutes celles mises en avant, la E est la plus consensuelle, car elle ne change presque rien à la situation qui existait avant.

Officiellement, la proposition E s’intitule « Usage responsable de l’IA générative ». On peut y lire notamment que Debian « n’encourage pas ni n’interdit l’utilisation d’outils d’IA générative dans le développement, la maintenance ou la documentation des logiciels, l’empaquetage, la documentation et les autres médias publiés dans le projet Debian ». Le texte reconnait que ces outils peuvent largement améliorer la productivité des contributeurs « s’ils sont utilisés de manière responsable ». Cela permettrait aux personnes de se libérer du temps pour des tâches plus intensives, notamment celles réclamant un jugement, une expertise ou une critique.

Techniquement, l’usage de l’IA ne change pas les exigences habituelles de qualité, d’exactitude et de maintenabilité. Toute personne soumettant un code, qu’il soit tout ou partiellement rédigé par une IA générative, est responsable de ce qu’elle propose. Elle doit être en mesure de comprendre, relire et tester ce code, dans l’idée de pouvoir expliquer ce qu’il fait avec précision. Tout envoi aveugle d’un contenu généré par IA est jugé incompatible avec les pratiques de Debian.

Dans la proposition, on peut lire qu’il est explicitement demandé aux personnes participantes de ne jamais envoyer d’informations personnelles à des services d’IA externes. Il peut aussi bien s’agir de données personnelles habituelles que de clés cryptographiques, communications privées, identifiants ou encore bugs de sécurité sous embargo.

Enfin, pour les opérations automatisées à grande échelle, comme la génération de nombreux rapports de bugs ou la modification en masse des paquets, un processus spécifique devra être mis en place.

« Les Contributeurs qui entendent effectuer des actions impactant tout le projet comme la soumission massive de bogues ou la soumission massive de correctifs, des modifications de code à grande échelle ou d’autres changements ou requêtes automatisés concernant de nombreux paquets ou de nombreux contributeurs, doivent d’abord lancer une discussion et rechercher un consensus à l’aide des canaux du projet avant d’agir. De tels projets automatisés doivent être validés par un humain qui demeure responsable de son comportement et du résultat », indique ainsi la proposition E.

En somme, Debian continue « de compter sur le jugement et la responsabilité de ses contributeurs individuels ». Point important : la mention de l’utilisation de l’IA dans un projet est recommandée, mais pas obligatoire.

Division et colère

La communauté a parlé. La proposition E ne change fondamentalement rien : chacun peut faire ce qu’il veut, tant que les pratiques habituelles de Debian sont respectées. La distribution s’appuie depuis longtemps sur la responsabilité individuelle et la relecture par les pairs. Pas question donc de changer de philosophie. Cependant, lorsque l’on parle de Debian, il n’est pas question d’une entité unique et mystique, mais bien d’un ensemble de personnes contribuant au projet. La consécration de ce quasi-statu quo n’est donc pas anodine.

Si la communauté a parlé, elle est également divisée, aussi bien chez les contributeurs que les utilisateurs. Sur X par exemple, la publication de la nouvelle sur le compte It’s FOSS montre des réactions très diverses, certains comprenant la position, mais la plupart affichent de la méfiance, voire de la déception. Même constant dans les commentaires de Phoronix.

Parmi les réactions négatives, l’une d’entre elles ressort particulièrement : celle d’Antoine le Gonidec, contributeur de longue date au projet Debian. Sur les huit propositions, il était parrain des options A, C, G et H. En somme, toutes celles cherchant à interdire ou limiter l’usage des IA. Face à la victoire de la proposition E, Antoine le Gonidec n’a pas caché sa colère. Sur la liste officielle de diffusion Debian, le développeur a pris une décision radicale :

« Je ne peux pas soutenir la décision actuelle de Debian concernant l’utilisation des LLM, et je ne suis plus prêt à être considéré comme faisant partie de Debian selon ces nouvelles règles. Prétendre avoir une « position neutre » face au fascisme n’est pas de la neutralité, c’est une collaboration active »

Il se retire donc du projet, expliquant que les LLM s’appuient en grande partie sur des entreprises « soutenues par des fascistes ». De toutes les propositions, la E était « la plus pro-LLM de toutes les options ». Il dit ne plus être intéressé par quoi que ce soit provenant de Debian, déclarant avec acidité qu’il peut être remplacé « par n’importe quelle IA agentique ». « Je pense n’avoir jamais autant été déçu par une communauté en qui j’avais confiance », affirme-t-il.

L’importance de Debian

Si ce vote était attendu, c’est que Debian est l’une des distributions Linux les plus importantes. En plus du système lui-même, connu pour sa fiabilité et sa rigueur, Debian sert de base à de nombreuses distributions, dont la plus connue est Ubuntu, celle-ci servant à son tour de socle à d’autres comme Linux Mint.

Comme l’indique It’s FOSS, plusieurs projets ont choisi des approches beaucoup plus radicales. OpenJDK par exemple, édité par Oracle, refuse toute contribution générée par IA. Même chose pour le compilateur GCC. D’autres ont choisi une approche plus souple, en particulier le noyau Linux. Au sujet des LLM, Linus Torvalds a adopté une approche pragmatique, estimant que l’aide procurée par l’IA ne peut plus être empêchée, mais que certaines situations sont problématiques, notamment l’automatisation des rapports des bugs (qu’il a fustigée).

  •  
❌