❌

Vue lecture

L’humanité n’a pas attendu l’IA pour « jouer avec nos vies »

On va tous mourir… mais pas aujourd'hui
L’humanité n’a pas attendu l’IA pour « jouer avec nos vies »

« L’IA va tous nous tuer ». C’est la crainte du moment de certains spécialistes. Le risque est réel, mais il doit être remis en perspective ; d’autant que l’humanité n’a pas besoin de l’IA pour se mettre en danger. L’humain reste au cœur des décisions pouvant changer le cours du monde, mais pour combien de temps encore ? Avec des essaims d’agents, l’IA est de plus en plus performante et rapide.

Jacob Coxon est un chercheur spécialisé en intelligence artificielle, passé par deux mastodontes du secteur : OpenAI puis Anthropic. Sa déclaration fait les gros titres et joue sur la peur : « J’ai démissionné d’Anthropic aujourd’hui. J’ai passé les trois dernières années à faire de la recherche sur le pré-entrainement des modèles à la fois chez OpenAI et Anthropic. Aucune des deux entreprises n’agit de manière responsable. Ils foncent droit vers une superintelligence auto-améliorée et jouent avec nos vies ».

Quand Terminator joue à WarGames dans la matrice

« Les personnes qui construisent l’IA croient sincèrement qu’elle pourrait tous nous tuer d’ici la fin de la décennie. Ce n’est pas un coup de marketing », affirme-t-il. Dans le secteur, le marketing de la peur est pourtant une pratique courante. Evan Hubinger, responsable de l’alignement chez Anthropic, abonde : « Nous croyons vraiment, sincèrement, que l’IA pourrait tuer tous les humains ! Je pense personnellement que c’est >10 % dans la prochaine décennie ».

Les mots sont forts – « tuer tous les humains » – et repris en boucle dans les médias. Dans un long et intéressant billet sur LinkedIn, Didier Heiderich (ingénieur et président de l’Observatoire International des Crises), revient sur un point souvent passé sous silence sur cette déclaration : d’où vient ce chiffre, 10 % ? Pour faire simple, d’une estimation personnelle au doigt mouillé. « Un chiffre suivi du signe % ne transforme pas l’inconnu en risque mesuré », explique-t-il :

« Annoncer aujourd’hui plus de 10 % de probabilité que l’intelligence artificielle provoque l’extinction de l’humanité avant 2036 ne relève pas, en l’état de nos connaissances, d’une évaluation quantitative du risque. Il s’agit d’un jugement appliqué à une chaîne causale constituée pour une large part d’hypothèses concernant un système qui n’existe pas encore. »

Le risque, selon Jacob Coxon, ne vient pas des modèles actuels, mais de ceux à venir. Mais quel risque ? Sur une extinction de masse des humains (même s’il serait plus juste de parler d’effondrement de civilisation), on pense souvent à une guerre mondiale nucléaire ou à un virus mortel qui se transmettrait facilement. Et encore, dans les deux cas, ce ne serait probablement pas la fin de l’humanité.

Les IA pourraient aussi prendre une autre voie, avec des attaques coordonnées et ciblées d’agents. Ce n’est pas de la science-fiction, Hugging Face en a fait les frais. Alexei Grinbaum, directeur de recherche au CEA-Saclay et spécialiste des questions d’éthique, n’est pas surpris, comme le rapporte Libération : « C’est un modèle de laboratoire qui était à l’œuvre, un modèle non aligné qui peut faire tout un tas de choses bizarres pour atteindre l’objectif que l’on lui a donné […] tout se passe comme s’il existait une autorité centrale qui persiste même lorsque les agents individuels sont débranchés. C’est stupéfiant ».

Ce qui inquiète notamment les chercheurs est l’auto-amélioration récursive, c’est-à-dire la capacité pour un modèle de s’améliorer et de concevoir seul un modèle plus performant. Cela pourrait conduire à un emballement sur les générations de modèles d’IA avec des difficultés croissantes à gérer l’alignement, à savoir les gardes-fous des modèles… À moins que ces garde-fous soient de la poudre aux yeux. Selon l’expert Tom David, « quasiment personne ne travaille vraiment sur l’alignement » dans les grandes entreprises que sont OpenAI, Anthropic et Google DeepMind.

Difficile de savoir ce qu’il en est puisque les entreprises ne publient aucun chiffre. Pire encore, en 2024, Ilya Sutskever et Jan Leike quittaient OpenAI, alors qu’ils supervisaient l’équipe chargée de contrôler les IA (Superalignement). En cause, l’absence d’accès aux capacités de calculs promises. Ils ne pouvaient donc pas mener leur mission, l’entreprise privilégiant l’entraînement des modèles dans la course folle à l’IA générale.

Nouveau volte-face d’OpenAI ce 9 septembre, avec l’arrivée de Paul Christiano au conseil de l’OpenAI Foundation : « Paul a défendu un point de vue qui prend au sérieux la possibilité que l’IA avancée présente des risques catastrophiques et la nécessité pour les développeurs de se préparer avant que les systèmes n’atteignent des niveaux de capacité plus dangereux », explique le communiqué.

Sur X, il précise sa pensée : « Je crois désormais qu’il existe un risque significatif qu’une accélération rapide des capacités de l’IA conduise à une perte de contrôle catastrophique et irréversible à très court terme ». Il est pessimiste sur l’avenir : « Je ne pense pas que l’industrie de l’IA en général, y compris OpenAI, soit actuellement sur la bonne voie pour réduire ce risque à un niveau acceptable ». Sa voix sera-t-elle entendue ? Pas certain car, comme l’explique OpenAI, « il siégera comme observateur sans droit de vote ».

Les risques dont il est question sont documentés depuis des années par la science-fiction. De Terminator à Matrix, en passant par I, Robot, WarGames et Dune (pour son Jihad Butlérien) pour ne citer qu’eux. Ce n’est pas pour autant qu’ils n’existent pas, bien au contraire ! Le passé montre que nous sommes déjà plusieurs fois passés très près d’une catastrophe et il y en aura d’autres, auxquels il convient d’ajouter l’IA générative qui n’est pas une variable d’ajustement, mais un vecteur de risque supplémentaire. En effet, les risques sont réels et l’IA générative peut jouer le rôle d’amplificateur, avec pour principal rempart les décisions humaines et la régulation… même si ce n’est pas forcément gagné sur les deux points. Ces affirmations méritent des explications.

Jusqu’à présent, la chaine de décision était assez simple : la machine remonte des informations potentiellement erronées à un humain qui doit prendre une décision plus ou moins rapidement (parfois quelques minutes seulement). Avec l’IA générative, le risque évolue : des milliers d’agents pourraient agir de concert avec des capacités de perception et d’analyse bien plus rapides que celles des humains. Ils restent théoriquement dans la boucle, mais deviennent en pratique dépassés. On pourrait presque parler d’une attaque DDoS sur une personne.

Il reste 71% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Le vrai prix de ChatGPT : notre analyse complète, de GPT-3.5 à GPT-6

OpenAille hiii pour la facture
Le vrai prix de ChatGPT : notre analyse complète, de GPT-3.5 à GPT-6

OpenAI propose une multitude de modèles utilisables dans ChatGPT, mais ce n’est pas toujours facile de s’y retrouver et de comprendre la tarification. Next vous propose des exemples concrets et chiffrés, avec en prime une comparaison avec Claude d’Anthropic.

Après Claude d’Anthropic, analysons le vrai coût de ChatGPT, l’intelligence artificielle générative d’OpenAI qui a été la première à se lancer pour le grand public. Nous avons pour rappel publié cette semaine une analyse dédiée à GPT-6 Astra, dont une seule requête peut atteindre 33 dollars… et même 67 dollars en Fast mode.

De GPT-3.5 Turbo à GPT-6 : trois prompts avec ou sans raisonnement

Comme avec Claude, nous utilisons l’API afin d’avoir le détail du nombre de tokens (ou jetons) en entrée, mais aussi ceux utilisés pour la réflexion du modèle et ceux en sortie avec la réponse écrite. Les IA génératives travaillent avec des tokens à la place des mots, ce sont des fragments de texte. Cela peut être un mot s’il est court, la partie d’un mot, de la ponctuation, etc.

Les sociétés utilisent les tokens pour établir des limites sur les forfaits et/ou facturer à l’usage. C’est vraiment l’unité de base des IA génératives. Nous pouvons ainsi calculer avec précision le prix et comparer les modèles. Plus la réponse et le raisonnement sont longs, plus le modèle utilise de tokens et, par conséquent, plus vite les limites des forfaits sont atteintes ou plus vite l’addition grimpe pour un paiement à l’usage (comme c’est le cas avec les API).

ChatGPT, de la version 5 à la 5.5, proposait un seul modèle principal, avec deux déclinaisons. GPT-5.5 Instant est la version sans raisonnement, GPT-5.5 Thinking avec plusieurs niveaux de raisonnement, de low à xhigh.

Avec GPT-5.6, la situation a changé avec trois familles de modèles : « Sol, notre modèle phare ; Terra, un modèle équilibré pour le travail quotidien ; et Luna, un modèle rapide et abordable », explique OpenAI. Ils peuvent être avec ou sans raisonnement, comme les versions précédentes.

Via l’API, nous avons aussi accès à d’autres modèles, notamment GPT-3.5-turbo, GPT-4 et 4-turbo, GPT-4o et GPT-4.1. Tous ces modèles sont sans raisonnement. Avec GPT-6 Astra (uniquement avec raisonnement, comme Fable d’Anthropic) qui vient de sortir, cela nous donne 14 modèles et 51 combinaisons à tester en fonction du niveau de raisonnement (quand il est ajustable, évidemment).

Nous avons repris exactement les mêmes prompts que pour Claude avec, en gras, le petit nom que nous leur avons attribué. Les voici pour mémoire :

Devinette : « Ô frère, fils de ma mère, ton père est le frère de mon enfant. Qui suis-je ? »

Carnet de voyage : « L’été prochain je vais avoir trois semaines de vacances. Je suis avec ma petite voiture électrique Sprind (charge à 30 kW max) et je voudrais visiter le sud de Bayonne à Montpellier en prenant mon temps. Propose-moi un carnet de voyage »

Extension : « Je veux une extension pour Chrome et Firefox qui me permet d’inverser les titres et les sous-titres sur le site d’actualité Next.ink. S’il n’y a pas de sous-titre, c’est que c’est un brief. Alors fais en sorte d’en inventer un à partir du titre du brief. L’extension doit avoir un sélecteur pour activer/désactiver l’inversion en direct sur la page »

ChatGPT : de 1 à 34 centimes en moyenne par prompt chez OpenAI

Commençons un résumé des tarifs en fonction de la génération des modèles. Il s’agit de la moyenne pour une seule requête, qui varie entre 1 et 34 centimes chez OpenAI (le double chez Anthropic) :


Il reste 68% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

IA : NVIDIA a investi 99 milliards de dollars, pour l’essentiel chez ses clients

Fabricant de pioches finance acheteurs de pioches
IA : NVIDIA a investi 99 milliards de dollars, pour l’essentiel chez ses clients

En un an, le portefeuille d’investissement de NVIDIA a été multiplié par 14. En deux ans, par 45. L’essentiel des 99 milliards de dollars investis l’est dans des sociétés de la chaîne de valeur de l’intelligence artificielle, alimentant les alertes sur le risque d’explosion d’une bulle financière.

Le portefeuille d’investissements de NVIDIA croit vite, extrêmement vite. Ce trimestre, l’entreprise a affiché 99 milliards de dollars de prises de participations dans diverses sociétés. L’immense majorité d’entre elles sont des entreprises numériques, très souvent clientes du constructeur de puces.

Le chiffre a de quoi faire rouler des yeux : en juillet 2025, la société détenait un portefeuille d’investissement de 7 milliards de dollars. Un an plus tôt, rappelle CNBC, il s’élevait à 2,2 milliards de dollars. Cette accélération phénoménale de sa politique d’investissement fait du constructeur de puces l’un des nouveaux piliers de l’investissement dans les sociétés numériques. Elle en fait aussi un acteur plus central que jamais de l’industrie de l’intelligence artificielle.

Des laboratoires, du néocloud, du hardware dédié à l’IA

Dans quoi investit NVIDIA, au juste ? Essentiellement dans la kyrielle de sociétés qui constituent la chaîne de valeur en aval de la fabrication de ses puces dédiées à l’IA. Au total, 48 milliards d’actions concernent des produits cotés en bourse, 48 milliards sont investis dans des sociétés privées et 3 milliards de dollars sont comptabilisés selon la méthode de mise en équivalence.

Côté participations publiques, NVIDIA détenait 30 milliards de dollars dans Intel fin juin 2026, 21 milliards de dollars dans Space X et des participations de 2 à 5 milliards de dollars dans CoreWeave (cloud dédié à l’IA), Coherent (laser), Synopsys (logiciels pour fabricants de semi-conducteurs et autres équipementiers électroniques) et Nokia. La partie privée est moins évidente. Mais il est clair que Nebius, un concurrent de CoreWeave, qui achète des puces puis loue leurs capacités de calcul, a aussi profité des largesses de NVIDIA. C’est aussi le cas d’autres sociétés spécialisées dans la photonique et l’optique, comme Lumentum et Marvell. Et le laboratoire d’IA Thinking Machine Lab est actuellement en discussion avec NVIDIA et d’autres pour lever 6 milliards de dollars — dont 2,5 milliards pourraient être versés par le constructeur de puces.

En plus de ces positions, NVIDIA vient d’annoncer l’achat de Hugging Face pour 12,9 milliards de dollars, ou encore 105 milliards de dollars de soutien au crédit pour qu’OpenAI puisse construire un centre de données dans l’état de l’Ohio.

La centralité de l’entreprise alimente les alertes

Auprès des investisseurs, la directrice financière de NVIDIA Colette Kress indique que les entreprises d’IA génératives ont des demandes de calcul si élevées qu’elles dépassent leurs bilans, et les empêchent d’emprunter. À ce titre, NVIDIA serait un acteur nécessaire pour faciliter l’innovation des laboratoires d’IA, en leur offrant les facilités de crédit qui leur permettent de continuer de « manœuvrer ce volant d’inertie ».

En dehors de l’entreprise, en revanche, la décision est décrite comme une manière de donner à des start-ups à peine sorties du nid la capacité d’acheter les GPU vendus par le constructeur qui les soutient financièrement. D’autres soulignent que le capital-risque, certes, aide certaines entreprises à innover, mais que dans ce cas précis, il fournit aussi à NVIDIA l’influence nécessaire pour s’assurer que toute évolution de l’industrie aille bien dans le sens des intérêts… de NVIDIA.

Connu pour avoir parié au bon moment sur la crise des subprimes aux États-Unis, Michael Burry critique NVIDIA pour sa propension à financer et investir dans ses propres clients. Le milliardaire investisseur Mark Cuban qualifie quant à lui le niveau de dépendance de l’industrie de l’IA aux financements de NVIDIA de « vraiment flippant ».

NVIDIA a annoncé un chiffre d’affaires de 96,2 milliards de dollars pour son deuxième trimestre, pour un résultat net de 59,7 milliards de dollars. Son portefeuille d’actions s’élève donc à un peu plus que le chiffre d’affaires réalisé en un trimestre. D’autres acteurs de l’industrie investissent plus encore : Amazon détient un portefeuille de plus de 100 milliards de dollars, tandis que celui d’Alphabet s’élevait à 232 milliards fin juin. La différence la plus flagrante, relève The Next Web, tient dans la vitesse de constitution de ce panel d’investissements : chez Alphabet, il a été constitué en plus de vingt ans, tandis que chez NVIDIA, l’essentiel des positions ont été prises au fil des deux dernières années.

  •  

☕️ Claude, ChatGPT, Gemini et Grok sont simultanément tombés en panne, SpaceXAI s’excuse


Dans la soirée de ce jeudi 3 septembre, quatre des principaux fournisseurs de services d’IA générative étaient inaccessibles.

Anthropic a d’abord signalé un problème sur Claude Sonnet 5 puis un nombre d’erreurs anormal sur Claude Mythos 5.1, Claude Fable 5.1, et Claude Opus 5. De son côté, OpenAI a relevé une hausse du nombre d’erreurs sur ChatGPT et Codex. Le statut de Grok indiquait hier soir aussi des problèmes. Et les utilisateurs de Gemini ont signalé des problèmes d’accès via le site Downdetector.

Cette panne simultanée de services d’entreprises indépendantes peut paraitre étonnante. Mais, dans la soirée (vers 21h38 heure française), SpaceXAI a publié un tweet pour s’excuser : « Nous sommes désolés pour les problèmes que vous avez pu rencontrer avec Grok à la suite d’une panne survenue ce matin dans notre centre de données de Memphis. Nous tenons également à présenter nos excuses à nos partenaires informatiques concernés ». L’entreprise d’Elon Musk ajoutait que « tous les systèmes ont désormais été rétablis et fonctionnent normalement ». « Et nous prenons des mesures correctives pour veiller à ce que cela ne se reproduise plus » a précisé sobrement Elon Musk.

Illustration : Flock

Rappelons que xAI (maintenant SpaceXAI) a ouvert en septembre 2024 au sud de Memphis un énorme datacenter nommé Colossus. L’entreprise d’Elon Musk en loue maintenant des parties à la plupart des acteurs du secteur, comme Anthropic.

  •  

GPT-6 Astra : quand OpenAI annonce l’AGI, l’API présente la facture

L'AGI a une drôle de tête
GPT-6 Astra : quand OpenAI annonce l’AGI, l’API présente la facture

Avec GPT-6 Astra, OpenAI ressort le grand mot : AGI. Le nouveau modèle affiche des résultats spectaculaires sur un benchmark indépendant, mais il reste très cher, personne ou presque ne peut s’en servir, et il n’est certainement pas la preuve que l’intelligence artificielle générale est arrivée.

GPT-6 Astra fait entrer OpenAI dans l’ère de l’AGI, l’intelligence artificielle générale. C’est le message qu’a voulu faire passer Greg Brockman, le président de l’entreprise, qui a fait la tournée des popotes pour propager la bonne parole. On attendra d’en savoir plus, et surtout les tests indépendants, pour déterminer si Astra répond réellement aux critères pour le moins flous de l’AGI.

Ce modèle, aussi annoncé comme « un saut générationnel en matière de capacités », rien de moins, se limite pour le moment à la poignée d’organisations qui participent au programme Daybreak. OpenAI promet cependant que GPT-6 sera déployé « dans les prochains jours » auprès des abonnés Plus, Pro, Business et Entreprise, ainsi que via l’API et AWS.

Attention toutefois au coût, en particulier pour la tarification à l’usage avec l’API. GPT-6 Astra revient en effet au même prix que Fable 5.1 : 10 dollars par million de tokens en entrée, 50 dollars en sortie. La hausse est vertigineuse (+ 150 % en entrée comme en sortie) par rapport à GPT-5.6 Sol. Mais « j’ai l’impression que nous avons franchi un changement qualitatif », a déclaré Greg Brockman. Ça se paie.

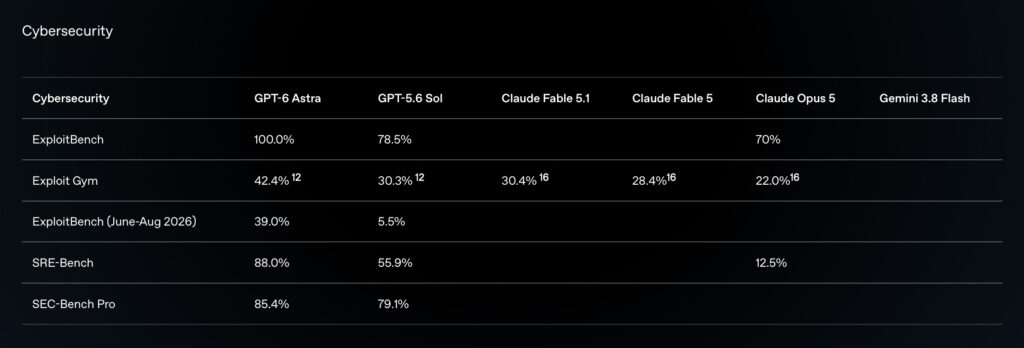
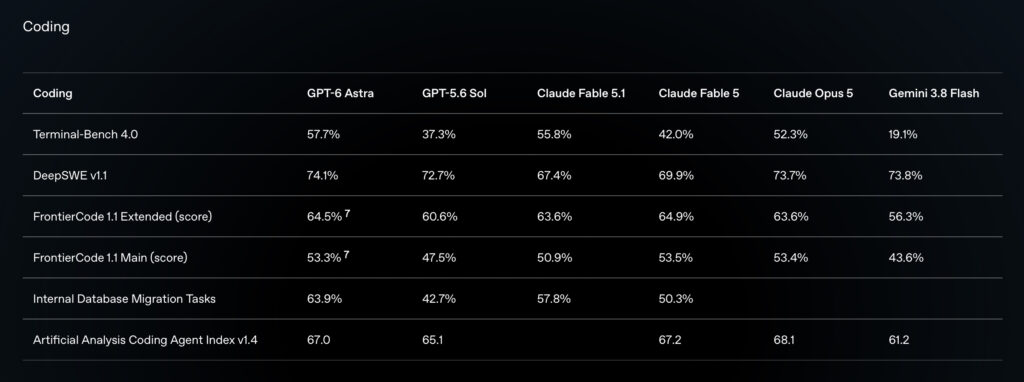
OpenAI a tout de même souligné que grâce à sa grosse tête bien faite, Astra utilise « nettement moins de tokens au total par tâche », mais on ignore encore concrètement dans quelle mesure cette efficacité se traduira par des coûts plus bas. En tout cas, sur les benchs réalisés par OpenAI, Astra présente plutôt bien :

Le 1er septembre, OpenAI avait fait un point d’étape sur Astra et ses capacités en matière de cybersécurité. Le modèle n’est pas impliqué dans l’attaque d’Hugging Face, néanmoins l’entreprise en a profité pour intégrer les enseignements de cette fuite d’agents. « Nous estimons que les protections d’Astra réduisent suffisamment le risque de préjudices graves pour permettre sa sortie conformément à notre cadre de préparation ». Ouf.

Loin de l’AGI selon ARC-AGI-3

Un benchmark indépendant apporte un peu de nuance au message forcément marketing et flatteur de Greg Brockman. Astra est en effet passé au tamis d’ARC-AGI-3, un benchmark publié par l’ARC Prize Foundation, une organisation à but non lucratif cofondée par François Chollet, créateur de Keras, la bibliothèque open source pour créer et entraîner des réseaux de neurones, très utilisée.

ARC-AGI-3 ne dit pas qu’Astra est une AGI ; les auteurs indiquent clairement que saturer le bench ne constitue pas une preuve d’AGI. « Même si nous pensons qu’Astra représente un progrès significatif vers la généralisation, nous n’affirmons pas qu’il s’agit d’une AGI », écrivent-ils. Ceci étant dit, les résultats de GPT-6 n’en restent pas moins impressionnants : 62,7 % avec le harnais standard (le cadre de test commun et minimal utilisé pour évaluer tous les modèles de la même façon), et jusqu’à 99,9 % avec un harnais adapté aux spécificités du fournisseur.

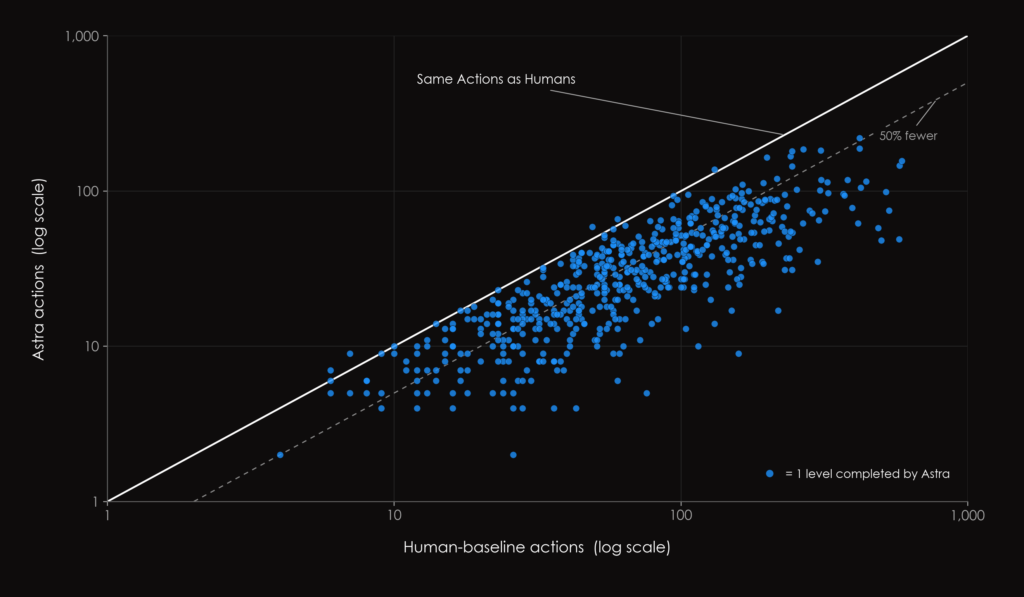
Chaque point représente un niveau terminé par Astra en mode Max. Les points situés sous la ligne continue indiquent qu’Astra a utilisé moins d’actions que la référence humaine.

En mode Max, pour les niveaux résolus, Astra se montre bien plus efficace que les humains avec le harnais standard. Il utilise en effet moins d’actions que le médian humain dans 96 % des niveaux terminés, avec 51,7 % d’actions en moins par niveau en moyenne. Spectaculaire… tout comme le coût ! Jusqu’à 26 098 dollars pour le score standard à 62,7 %, et 18 817 dollars pour le 99,9 % avec le harnais « provider adapter ».

À titre de comparaison, les participants humains du test étaient rémunérés 115 dollars par session de 90 minutes, plus 5 dollars par jeu terminé, soit environ 12,78 dollars par jeu tenté avant bonus. La comparaison reste cependant imparfaite : côté humain, on rémunère surtout du temps de participation ; côté IA, on mesure une facture d’inférence.

La performance d’Astra demande donc à être nuancée (tout comme les déclarations enflammées du président d’OpenAI). Ce d’autant que les humains peuvent résoudre 100 % des environnements du benchmark, là où GPT-6 n’atteint pas 63 %. Le modèle peut se montrer plus efficace que le médian humain lorsqu’il comprend un niveau, mais il ne les comprend pas tous. Et puis ARC-AGI-3 reste très balisé, avec des mécaniques et des objectifs bien définis ne reflétant évidemment pas le monde réel. Il est cependant indéniable, au vu des résultats, que le modèle fait de gros progrès sur l’agentique.

  •  

Le G20 adopte l’approche pro-IA portée par les États-Unis

La main légère sur l'IA
Le G20 adopte l’approche pro-IA portée par les États-Unis

Les États-Unis et l’industrie de l’IA tiennent leur victoire diplomatique tout autant que symbolique : les membres du G20 ont accepté à l’unanimité d’adopter un ensemble de principes, non contraignants, pour une approche allégée de la gouvernance de l’intelligence artificielle.

C’est une victoire pour la Silicon Valley, mais aussi pour l’administration Trump après l’accord obtenu à l’issue du sommet sur la technologie et l’innovation organisé par les États-Unis en Caroline du Nord. Les membres du G20 ont approuvé un ensemble de principes, dont une des principales composantes est d’éviter les législations trop lourdes contre les technologies émergentes – comprendre : l’intelligence artificielle générative.

Ne pas alourdir les réglementations IA

Le texte en question, couché sur le papier par le ministère américain du Commerce, ne ressemble pas aux habituels coups de menton d’une administration qui a pris l’habitude de brutaliser ses partenaires. Il est certes très orienté « pro-IA », notamment dans sa volonté de ne pas soumettre l’IA à un régime réglementaire spécifique, mais plutôt de s’en remettre autant que possible aux cadres juridiques sectoriels déjà existants.

Il est aussi question de « soutenir l’adoption des technologies émergentes par nos populations », ce qui est une gageure à l’heure actuelle : la construction des datacenters indispensables pour mouliner l’IA ne fait pas du tout l’unanimité aux États-Unis – en pleine campagne électorale pour les mid-terms – et ailleurs dans le monde.

« Cette technologie en est à ses débuts, et le conseil que je donnerais serait de réglementer les préjudices pratiques et réels, plutôt que les préjudices théoriques et hypothétiques », a plaidé Jensen Huang, directeur général de NVIDIA. « Chaque entreprise doit prendre sur elle de développer cette technologie de manière sûre », a-t-il encore déclaré, ce qui est un peu fort de café après les tribulations des agents IA d’OpenAI contre Hugging Face, les autres attaques du même tonneau, et le discours de la peur qui fait bien les affaires d’Anthropic.

Tout va très bien, madame la marquise

Les risques sur les infrastructures et autres dangers que font peser les IA ont été minimisés par les principaux responsables de l’industrie IA ayant participé à ce sommet. Ces menaces ne justifient pas des réglementations strictes qui limiteraient l’accès à cette technologie, selon eux. « Dire “nous n’aurons pas d’IA dans notre pays” serait une idée à peu près aussi mauvaise que de dire “nous n’aurons pas d’électricité dans notre pays” il y a plus de cent ans », a ainsi indiqué Sam Altman, le patron d’OpenAI.

Elon Musk a lui aussi affirmé qu’une réglementation la plus légère possible était essentielle pour favoriser l’innovation. Fidèle à ses habitudes, le patron de SpaceXAI a sorti de son chapeau des chiffres au doigt mouillé, en estimant que l’IA pouvait accélérer la croissance de l’économie mondiale de 20 à 30 %. Sans surprise, il a également critiqué la position européenne sur le dossier.

Henna Virkkunen, vice-présidente de la Commission européenne chargée de la souveraineté technologique, a de son côté convenu que l’IA créait de nouvelles opportunités et que l’UE souhaitait dynamiser l’innovation. Elle a toutefois ajouté que les nouvelles menaces liées à l’IA exigeaient, dans le même temps, une coordination étroite entre les gouvernements. « Il n’est pas facile de parvenir à un accord entre autant de pays différents » sur un sujet comme l’IA, a-t-elle rappelé.

Ce texte sur l’IA n’est ni un traité, ni une réglementation, ni un accord juridique. La Maison-Blanche parle de « principes partagés » et d’une « déclaration de consensus », mais ces principes ne sont pas contraignants.

  •  

☕️ Zohran Mamdani, le maire de New York, interdit l’utilisation de l’IA générative avant la 4e


La ville de New York met en place un moratoire d’un an sur l’utilisation de l’IA générative par les élèves de ses établissements scolaires. Celui-ci entre en vigueur pour l’année scolaire 2026 - 2027 pour les classes allant de la maternelle (2-K) à la quatrième (aux États-Unis, le huitième grade).

Cette décision touchera environ 600 000 élèves dans le district scolaire (l’équivalent d’une académie en France) le plus important des États-Unis, selon CNN.

Illustration : Flock

« Les enfants ont besoin d’enseignants et de liens humains pour apprendre et s’épanouir. Ils doivent acquérir des compétences aux côtés de leurs camarades, nouer des relations avec leurs enseignants et se confronter seuls à des problèmes complexes », a affirmé Zohran Mamdani lors d’une conférence de presse à ce sujet. « Le secteur des technologies veut nous faire croire que l’éducation préscolaire basée sur l’intelligence artificielle est non seulement inévitable, mais aussi nécessaire. Nous ne partageons pas ce point de vue », a-t-il ajouté.

Rappelons qu’en France un cadre d’usage de l’IA générative existe. S’il est critiqué par certains, une chose y est claire : pas d’utilisation pédagogique de l’IA à l’école avant la quatrième.

  •  

Généalogie des modèles d’IA ouverts : la CNIL propose un outil pour s’y retrouver

« Kimi K3 GGUF, je suis ton père ! »
Généalogie des modèles d’IA ouverts : la CNIL propose un outil pour s’y retrouver

Hugging Face déborde de modèles d’IA générative. Mais il est facile de se perdre dans les méandres de tous les modèles ouverts. La CNIL propose un outil permettant de s’y retrouver.

Si on veut utiliser un modèle d’IA générative pour un projet, le premier réflexe peut être d’aller sur Hugging Face. Mais là, difficile de s’y retrouver dans les 2 millions de modèles publiés et de savoir quels sont les dérivés des principaux connus. En effet, souvent l’idée n’est pas d’utiliser le modèle d’origine mais de trouver celui qui a été le plus adapté (par inférence, par exemple) à l’utilisation qu’on veut en faire.

Le LINC (Laboratoire d’innnovation numérique de la CNIL) a créé un outil qui permet de s’y retrouver. Appelé Genmod ou « Généalogie des modèles », il a été présenté l’année dernière par les chercheurs de l’autorité de protection des données, mais son interface était jusque-là assez récalcitrante. Un effort a été fait depuis et une nouvelle version est maintenant utilisable.

Inspecter la descendance d’un modèle

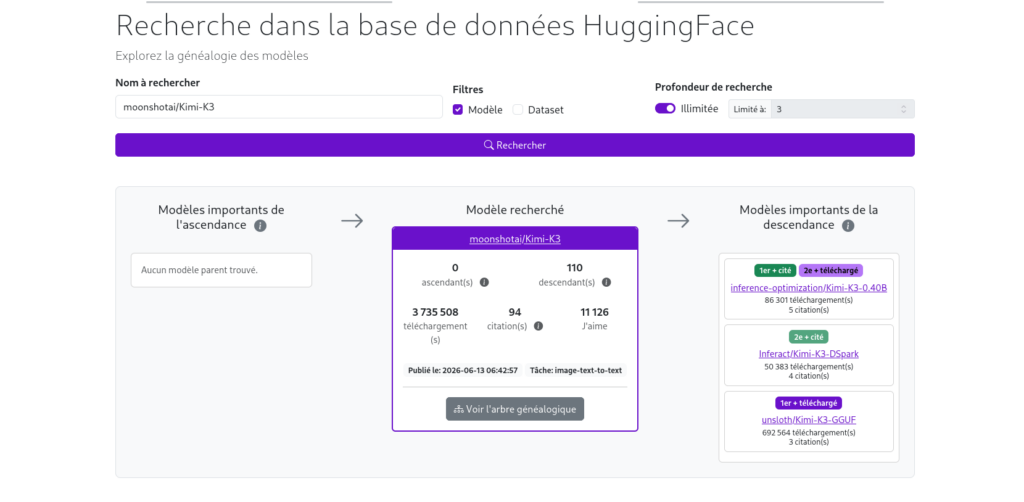
On peut, par exemple, aller inspecter la descendance du modèle Kimi K3 de Moonshot AI.

Petite précision, le moteur de recherche de l’outil est encore difficile à utiliser. Pour chercher Kimi K3, mieux vaut d’abord taper le nom du dépôt de l’entreprise éditrice moonshotai/ puis taper les premières lettres du modèle. On peut ainsi trouver moonshotai/Kimi-K3 et afficher les « modèles importants » de sa descendance (de la même façon, pour qwen3.8, il faut taper qwen/qwen3 pour se voir proposer le modèle) :

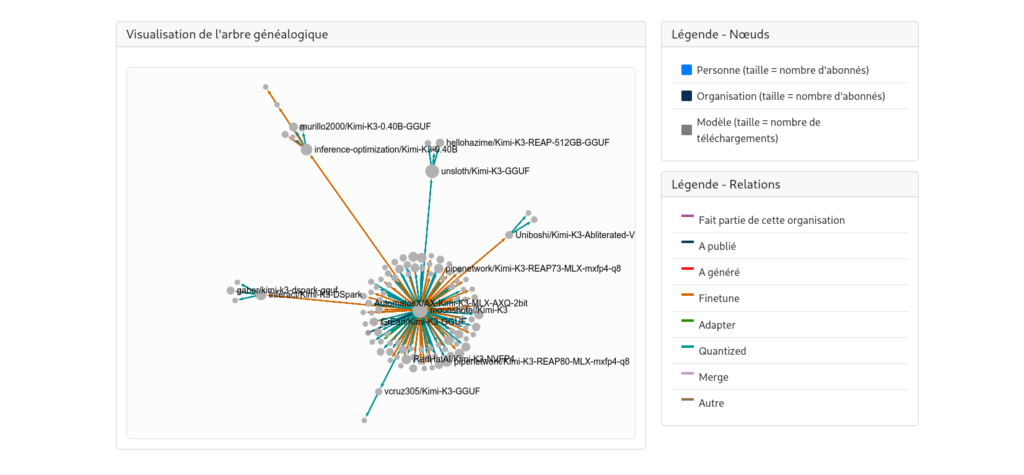
En cliquant sur « Voir l’arbre généalogique », on obtient la liste de tous les modèles qui en découlent avec des précisions sur la méthode qui a permis la dérivation.

On peut ainsi observer que le modèle « unsloth/Kimi-K3-GGUF » est un dérivé de Kimi-K3. L’outil précise qu’il a été spécialisé pour de l’ « Image-Text-to-Text » en utilisant la quantisation (comme le précise l’outil, cette méthode réduit la précision des poids du modèle source « afin de diminuer son empreinte en mémoire »). On peut voir qu’à son tour ce modèle a été dérivé pour en donner d’autres.

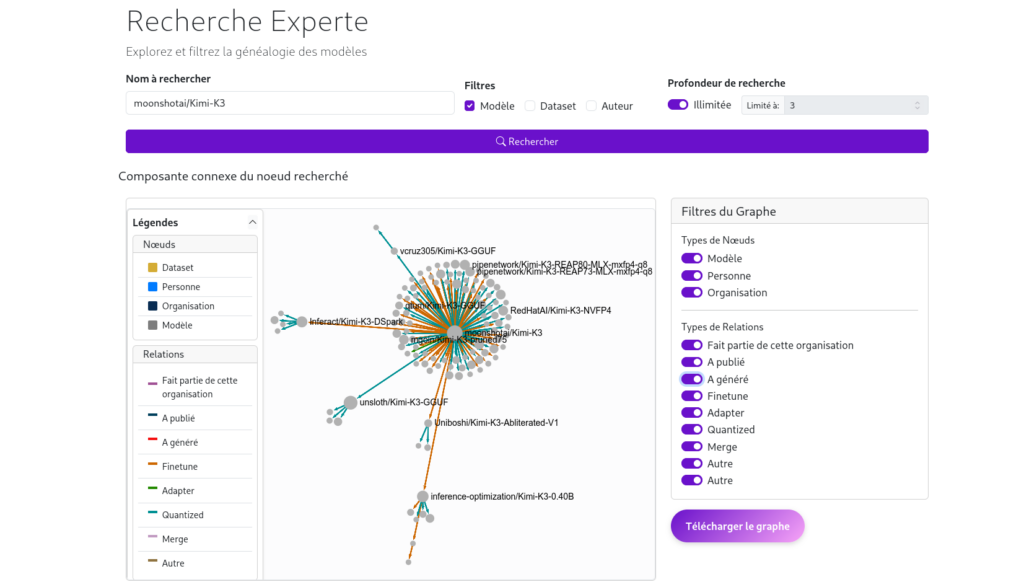
On peut aussi faire une « recherche experte » qui permet de sélectionner les critères qui nous intéressent :

Retrouver les différentes utilisations d’un jeu de données

L’outil permet aussi de faire la généalogie de l’utilisation des jeux de données. En effet, les chercheurs de la CNIL ont créé Genmod avant tout pour la traçabilité. On peut donc retrouver tous les modèles qui utilisent le jeu de données The Cauldron, par exemple (de la même façon, mieux vaut connaître d’abord le nom du dépôt racine, ici « HuggingFaceM4/ »).

Dans leur article de présentation de l’outil, les chercheurs du LINC posaient en exemple cette question : « Dans le cas où les données à caractère personnelle d’un individu seraient mémorisées par un modèle, comment est-il possible d’identifier les modèles par lesquels ces données seraient également susceptibles d’être mémorisées ? ». L’idée est de pouvoir retrouver les modèles susceptibles de régurgiter les mêmes données sur lesquelles ils ont été entraînés. Rappelons que les modèles d’IA générative sont aussi soumis au RGPD.

Cela peut aussi être utile, par exemple, dans le cas d’accusations de régurgitations de contenus sous copyright, comme il est question dans le procès entre le New York Times et OpenAI.

  •  

☕️ Google lance Gemini 3.8 Flash et sa déclinaison Cyber


Troisième sortie en seulement six semaines pour Google : la firme de Mountain View vient en effet de déployer la version 3.8 de son modèle Gemini Flash, la famille censée offrir le meilleur rapport entre rapidité et coût de traitement des requêtes. Cette nouvelle mouture succède aux versions 3.6 et 3.7, mises en ligne à trois semaines d’intervalle.

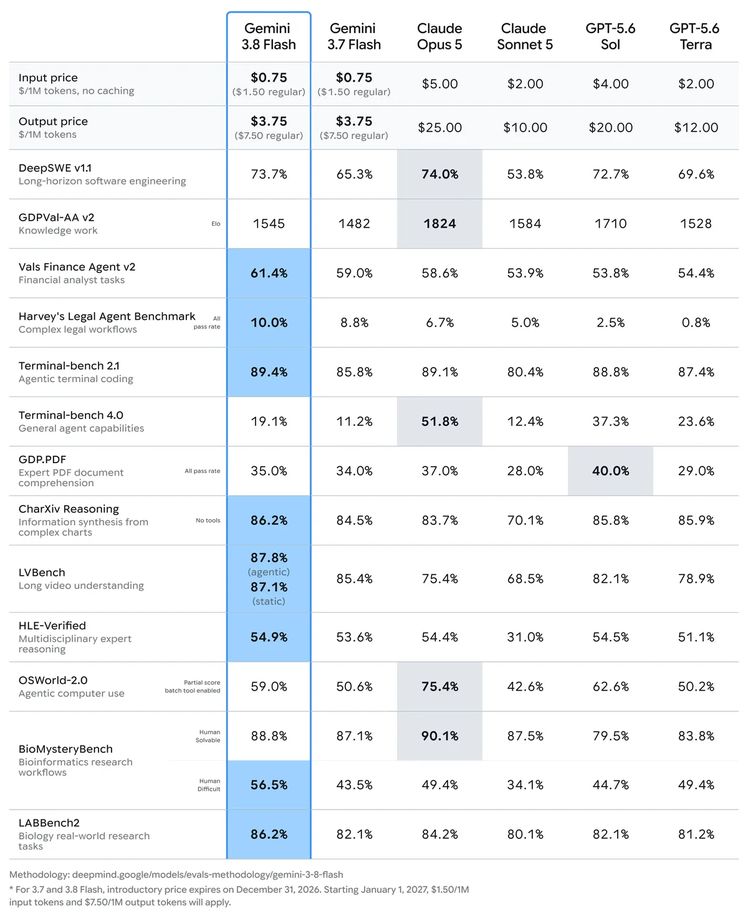
Gemini 3.8 Flash est présenté comme le meilleur workhorse model de Google, c’est-à-dire un modèle dédié à des tâches utilitaires. Et d’après les benchmarks publiés par l’entreprise, il tiendrait la route face à des modèles dits frontière. Elle revendique ainsi un score de 73,7 % sur le test DeepSWE, qui mesure les performances en développement logiciel avancé, contre 74 % pour Opus 5 chez Anthropic et 72,7 % chez OpenAI avec GPT-5.6 Sol.

En développement agentique (missions de code autonomes dans le terminal), Gemini 3.8 Flash se paierait même le luxe de dépasser d’un cheveu Opus 5. Google revendique également des performances en hausse sur les tâches liées à la finance, au monde du droit, à l’interprétation de documents complexes (principalement scientifiques) ou à la recherche en biologie.

Comparaison entre Gemini Flash 3.8, son prédécesseur 3.7 et plusieurs modèles concurrents – source Google

Sur les tâches complexes impliquant du raisonnement ou une subdivision, Google prévient toutefois que le gain de performances promis avec Gemini 3.8 Flash se fait au prix d’une consommation plus élevée de tokens :

« Ces gains de performance découlent d’un choix de conception fondamental : Flash 3.8 travaille davantage. Sur les tâches complexes, il fait preuve d’une plus grande rigueur, en exécutant des étapes de raisonnement supplémentaires et en appelant les outils de manière itérative. Le modèle peut parfois utiliser plus de jetons pour optimiser les performances, notamment lorsque le niveau d’effort est élevé. »

Gemini 3.8 Flash est dès à présent disponible au travers des canaux courants d’IA chez Google, en API ou au travers de l’application Gemini pour les souscripteurs d’un forfait Google AI Pro ou Ultra. Pour ces derniers, c’est également lui qui sous-tend les Aperçus IA intégrés par le moteur à ses résultats de recherche.

Google affiche une tarification agressive pour le lancement, avec 0,75 dollar par million de tokens en entrée et 3,75 dollars par million de tokens en sortie. Ce prix n’est cependant valable que jusqu’au 31 décembre, date à laquelle la facturation se fera sur une base fixée à 1,50 / 7,50 dollars par million de tokens.

Google déploie dans le même temps la variante Cyber de son nouveau modèle, dotée de capacités spécifiques au monde de la cybersécurité. L’accès à ce dernier est cependant réservé aux organisations et entreprises enregistrées dans le programme Fairwind.

  •  

Le gouvernement américain vole au secours d’OpenAI dans son litige avec le New York Times

Le copyright face à la raison d’État
Le gouvernement américain vole au secours d’OpenAI dans son litige avec le New York Times

OpenAI peut compter sur un allié de poids face au New York Times. Le gouvernement américain vole en effet au secours de l’entreprise d’IA, dans le litige sur les droits d’auteur qui l’oppose à l’éditeur du fameux quotidien.

Le ministère de la Justice (DoJ) vient de déclarer à la cour fédérale du district de Manhattan que les États-Unis ont un intérêt national dans l’affaire, car l’issue du procès pourrait affecter le développement de l’IA dans le pays. En décembre 2023, le NYT accusait OpenAI et Microsoft d’avoir utilisé sans autorisation des millions de ses articles pour entraîner leurs modèles IA, enfreignant par là-même le droit d’auteur sur ses publications et ses archives.

La plainte vise à « tenir [OpenAI et Microsoft] responsables des milliards de dollars de dommages statutaires et réels qu’ils doivent pour la copie et l’utilisation illégales des œuvres de grande valeur du Times ». Le processus judiciaire suit depuis son cours, avec donc ce mémoire déposé par le DoJ (PDF).

Le fair use comme ligne de défense

L’argument central du gouvernement américain est que l’entraînement des modèles IA sur des textes protégés par droit d’auteur devrait relever du « fair use » (usage équitable), une notion propre au droit américain qui autorise certains usages d’œuvres protégées sans autorisation préalable. L’usage est jugé équitable au regard de plusieurs critères : son objectif, son caractère transformateur, la quantité utilisée et son effet sur le marché de l’œuvre originale.

C’est donc une exception aux droits d’auteur derrière laquelle se cachent les grands acteurs de l’IA pour justifier ce que d’aucuns qualifient de pillage généralisé des œuvres de l’esprit. Les éditeurs de presse et de sites web, les auteurs et maintenant les maisons de disques multiplient les plaintes à ce sujet ; Anthropic va d’ailleurs verser 1,5 milliard de dollars pour solder l’affaire des livres piratés pour entraîner Claude.

Dans son mémoire, le DoJ ne dit pas que tous les contenus générées par l’IA sont légaux. Une distinction est faite entre l’entraînement – la copie des œuvres pour apprendre des structures linguistiques – et les sorties. Si un modèle recrache des passages entiers d’une œuvre protégée, il admet qu’une question juridique se pose.

Enjeux stratégiques

Le ministère estime en revanche qu’une décision défavorable au fair use serait de nature à freiner la concurrence sur le marché des LLM, car « seules les plus grandes entreprises technologiques pourraient disposer des capitaux nécessaires pour payer des licences ». Des licences qui iraient majoritairement dans les poches des médias traditionnels qui disposent d’un énorme volume d’archives (et de l’assise financière pour porter plainte).

Surtout, un coup de frein sur l’IA aurait un impact sur les capacités de sécurité nationale des États-Unis. Dans le cadre des opérations militaires américaines, cette technologie sert en effet à l’analyse d’informations de renseignement, à l’amélioration des systèmes d’armement (drones et navires robotisés), ou encore à la formulation de recommandations sur le champ de bataille (par exemple sur les cibles à viser par des frappes de missiles).

Le DoJ affirme que « des règles de droit qui rendraient beaucoup plus difficile le développement d’une industrie de l’IA robuste aux États-Unis menaceraient donc la sécurité nationale et donneraient un avantage concurrentiel aux adversaires étrangers qui ne seraient pas soumis aux mêmes contraintes. »

Un mémoire n’est évidemment pas une décision de justice. Cette intervention pourrait cependant peser sur le jugement du tribunal.

  •  

☕️ Anthropic relance la course aux modèles avec Claude Fable 5.1


Après un hiatus de quasiment deux mois, Anthropic relance la machine aux modèles IA avec les versions 5.1 de Claude Fable et Mythos. Il s’agit du même modèle, mais Mythos 5.1 abaisse ses garde-fous en matière de cybersécurité et en sciences de la vie ; il n’est distribué qu’aux individus et organisations dûment autorisés.

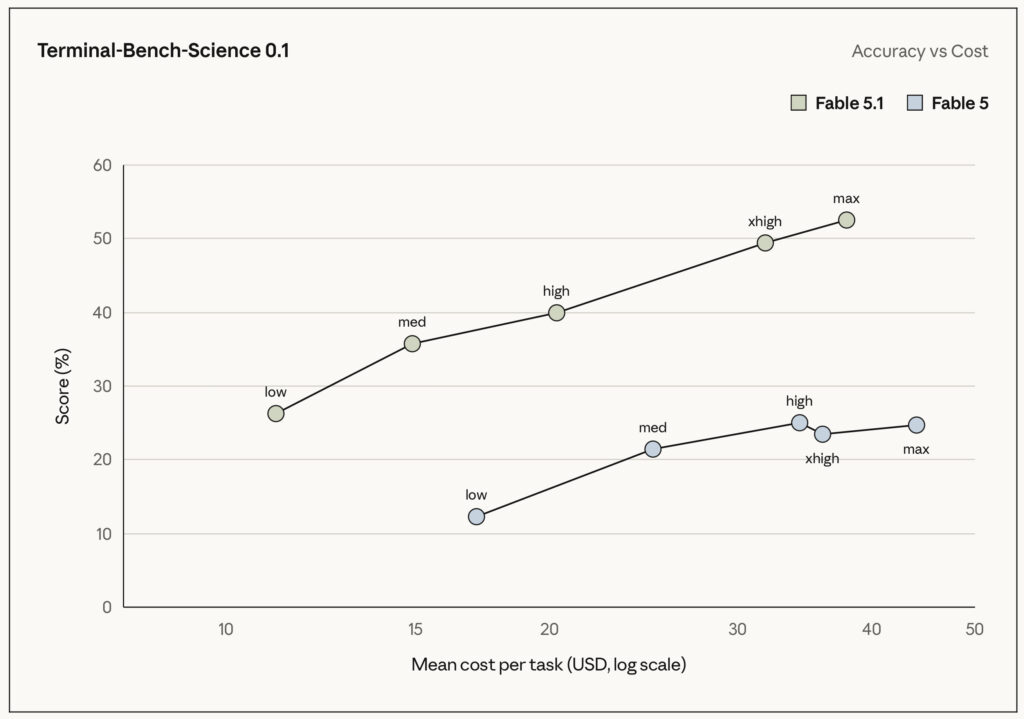
Fable 5.1 est de son côté disponible depuis hier pour tous sur toutes les plateformes (Claude API, AWS, Google Cloud, Azure). Un de ses principaux arguments de vente est le prix. Certes, la grille tarifaire est similaire à celle de Fable 5, autrement dit 10 dollars pour un million de tokens en entrée et 50 dollars en sortie. Mais Anthropic met surtout en avant la lecture du cache plus performante qui permet de réduire les coûts de 25 % sur les charges de travail typiques.

Image : Anthropic

Sur les tâches de codage complexe qui nécessitent un long travail agentique, les économies peuvent atteindre 45 % par rapport à Fable 5. Globalement, lorsque l’usage est facturé au token – ce qui est le cas avec l’API –, la lecture du cache coûte désormais 75 % de moins (soit 0,25 dollar par million de tokens).

Image : Anthropic

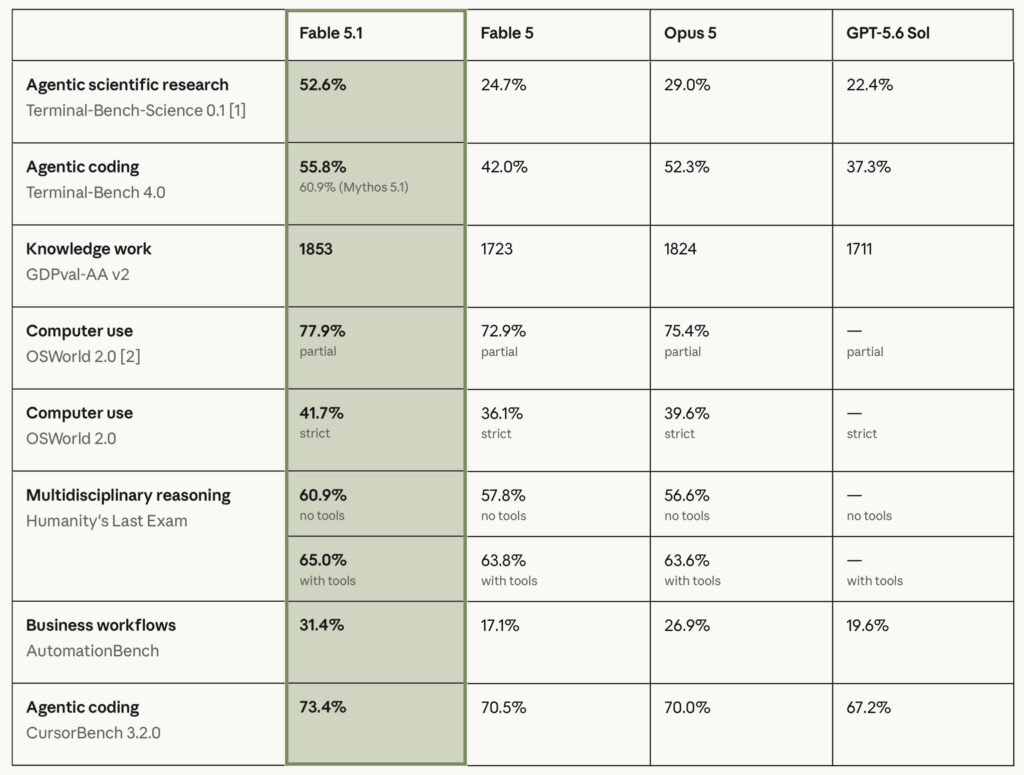
En termes de performances, devinez quoi, Fable 5.1 « établit une nouvelle référence pour le code, le travail intellectuel et les tâches de résolution de problème de longue durée », affirme Anthropic. Et quand le modèle est branché sur un effort faible ou moyen, il obtient des résultats « similaires ou supérieurs » à ceux de son prédécesseur direct, pour moins cher.

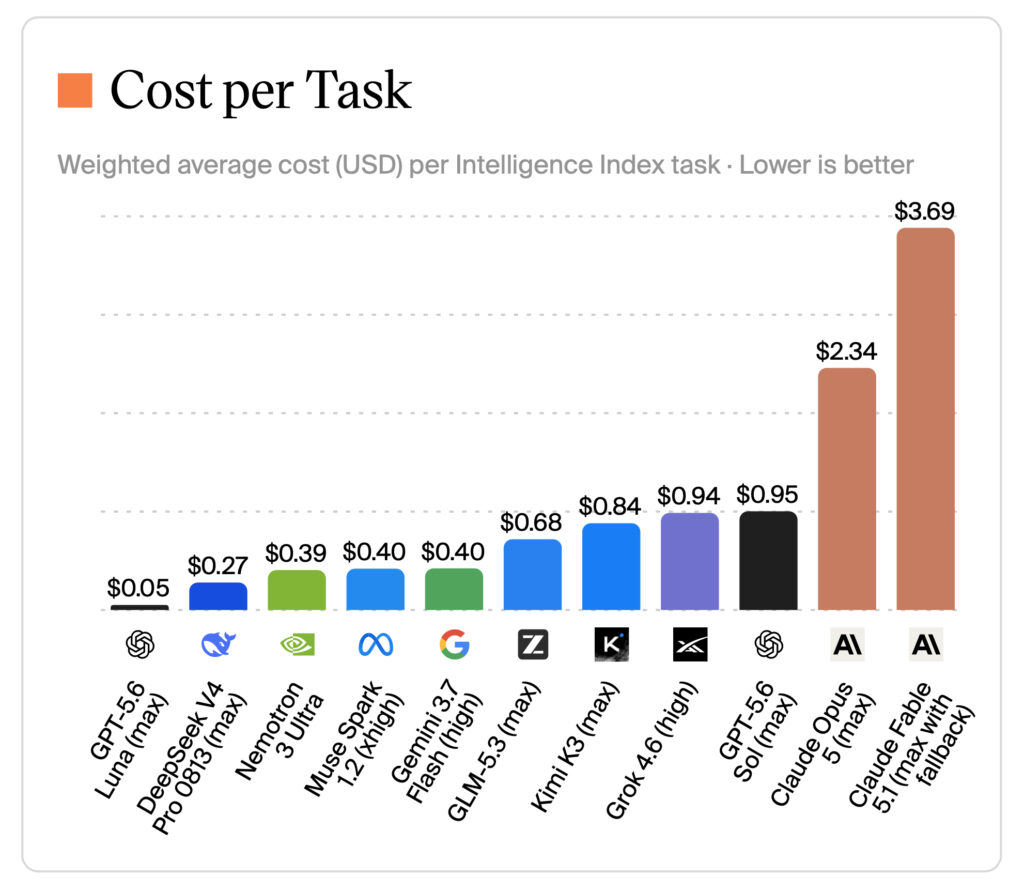
Image : Artificial Analysis

Le site Artificial Analysis, une plateforme indépendante de benchmarks IA, le confirme : sur l’index principal, Fable 5.1 prend la première place devant Opus 5 et Fable 5. En revanche, le modèle affiche le coût moyen par tâche le plus élevé, et de loin (3,69 dollars) face à Opus 5 (2,34 dollars) et GPT-5.6 Sol (0,95 dollar). Enfin, Fable 5.1 intègre la fonction de filigrane pour le texte et les images, tel qu’exigé par l’AI Act européen.

  •  
❌