❌

Vue lecture

Étiquette énergie des smartphones et tablettes : quel bordel !

48 ans de mises à jour ? Je prends !
Étiquette énergie des smartphones et tablettes : quel bordel !

Des fabricants de smartphones et tablettes ont transformé l’étiquette énergie et la fiche d’information en vaste blague. Nous avons analysé plus de 2 400 fiches avec des erreurs plus que grossières : 48 ans de mises à jour, 23 minutes d’autonomie, un écran aussi résistant que le saphir ou friable comme du talc, une étanchéité à 100 mètres, etc.

Depuis le 20 juin 2025, les règlements européens UE 2023/1669 (Energy Labelling) et UE 2023/1670 (Ecodesign) sont en application dans l’Union. Pour les règlements, pas besoin de transposition, contrairement aux directives.

Dans le premier cas, il s’agit d’apposer une étiquette énergie comportant plusieurs informations : une classe de A à G, une estimation de l’autonomie, des indices de résistance aux chocs et de réparabilité, le nombre de cycles de charge et l’indice IP (protection contre les poussières et l’eau). Cette étiquette doit aussi comporter un code QR renvoyant vers la fiche produit détaillée sur le site EPREL (European Product Registry for Energy Labelling) de la Commission européenne.

Le second règlement impose des seuils aux fabricants, notamment cinq ans au moins de correctifs (avec un temps limité pour les proposer à leurs clients, quatre mois après la publication du code source) de sécurité et sept ans de disponibilité des pièces détachées.

Le constat est rude : 80 % des terminaux manquent d’informations

Revenons à cette étiquette, obligatoire depuis plus d’un an, autant pour les nouveaux produits mis sur le marché que pour les anciens toujours commercialisés. En effet, l’article 3 précise bien que « chaque smartphone ou tablette est fourni avec une étiquette imprimée conforme », sans revenir sur la date de mise sur le marché. Dans les documents référencés sur l’EPREL, on voit d’ailleurs d’anciens modèles toujours commercialisés, comme l’iPhone 13 d’un importateur, la Galaxy Tab Active5 de Samsung en direct ou encore le Fairphone 5.

Right to Repair et iFixit ont travaillé de concert pour analyser les fiches de la base EPREL sur les smartphones et les tablettes. Leur constat est accablant : « Un an après l’entrée en vigueur des règles d’écoconception de l’UE, 80 % des smartphones ne disposent toujours pas des informations de réparation requises ».

Ils ont analysé 2 334 fiches de smartphones et tablettes et « seules 18 % environ mentionnent des sites web où l’on peut facilement trouver les prix des pièces détachées ou les instructions de réparation ». Nos confrères dénoncent également une pratique « scandaleuse » de certains fabricants : ils ne donnent aucun lien pour acheter des pièces détachées et accéder aux manuels de réparation, mais « s’attribuent encore une note parfaite pour les informations de réparation, ce qui aboutit à une auto-déclaration de classe A pour la réparabilité ».

L’Annexe IV du règlement est pourtant claire sur la définition d’un score de 5 points : « disponibilité publique des informations pour la réparation et l’entretien ». Comme le montrent Right to Repair et iFixit, certains s’attribuent une note de 5/5 sans lien ou avec un lien vers la page d’accueil de Temu, aussi bien pour le manuel que pour les pièces détachées et leurs prix.

Chez Next, nous avons aussi regardé les autres informations contenues dans les fiches… et nous n’avons pas été déçus du voyage. Temu n’est par exemple pas un cas isolé, 40 fiches (d’une petite poignée de marques) renvoyant vers la plateforme chinoise. Certains vers la page d’accueil, d’autres vers une fiche produit dont l’article est épuisé.

Amazon, eBay et AliExpress apparaissent également sur des dizaines de fiches. Certaines fiches méritent le détour. Autel, par exemple, renvoie vers la fiche produit de ses tablettes (complètes) via les liens censés donner des prix HT pour les composants.
48 ans de mises à jour de sécurité, plus de 20 jours d’autonomie !


Il reste 65% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

L’humanité n’a pas attendu l’IA pour « jouer avec nos vies »

On va tous mourir… mais pas aujourd'hui
L’humanité n’a pas attendu l’IA pour « jouer avec nos vies »

« L’IA va tous nous tuer ». C’est la crainte du moment de certains spécialistes. Le risque est réel, mais il doit être remis en perspective ; d’autant que l’humanité n’a pas besoin de l’IA pour se mettre en danger. L’humain reste au cœur des décisions pouvant changer le cours du monde, mais pour combien de temps encore ? Avec des essaims d’agents, l’IA est de plus en plus performante et rapide.

Jacob Coxon est un chercheur spécialisé en intelligence artificielle, passé par deux mastodontes du secteur : OpenAI puis Anthropic. Sa déclaration fait les gros titres et joue sur la peur : « J’ai démissionné d’Anthropic aujourd’hui. J’ai passé les trois dernières années à faire de la recherche sur le pré-entrainement des modèles à la fois chez OpenAI et Anthropic. Aucune des deux entreprises n’agit de manière responsable. Ils foncent droit vers une superintelligence auto-améliorée et jouent avec nos vies ».

Quand Terminator joue à WarGames dans la matrice

« Les personnes qui construisent l’IA croient sincèrement qu’elle pourrait tous nous tuer d’ici la fin de la décennie. Ce n’est pas un coup de marketing », affirme-t-il. Dans le secteur, le marketing de la peur est pourtant une pratique courante. Evan Hubinger, responsable de l’alignement chez Anthropic, abonde : « Nous croyons vraiment, sincèrement, que l’IA pourrait tuer tous les humains ! Je pense personnellement que c’est >10 % dans la prochaine décennie ».

Les mots sont forts – « tuer tous les humains » – et repris en boucle dans les médias. Dans un long et intéressant billet sur LinkedIn, Didier Heiderich (ingénieur et président de l’Observatoire International des Crises), revient sur un point souvent passé sous silence sur cette déclaration : d’où vient ce chiffre, 10 % ? Pour faire simple, d’une estimation personnelle au doigt mouillé. « Un chiffre suivi du signe % ne transforme pas l’inconnu en risque mesuré », explique-t-il :

« Annoncer aujourd’hui plus de 10 % de probabilité que l’intelligence artificielle provoque l’extinction de l’humanité avant 2036 ne relève pas, en l’état de nos connaissances, d’une évaluation quantitative du risque. Il s’agit d’un jugement appliqué à une chaîne causale constituée pour une large part d’hypothèses concernant un système qui n’existe pas encore. »

Le risque, selon Jacob Coxon, ne vient pas des modèles actuels, mais de ceux à venir. Mais quel risque ? Sur une extinction de masse des humains (même s’il serait plus juste de parler d’effondrement de civilisation), on pense souvent à une guerre mondiale nucléaire ou à un virus mortel qui se transmettrait facilement. Et encore, dans les deux cas, ce ne serait probablement pas la fin de l’humanité.

Les IA pourraient aussi prendre une autre voie, avec des attaques coordonnées et ciblées d’agents. Ce n’est pas de la science-fiction, Hugging Face en a fait les frais. Alexei Grinbaum, directeur de recherche au CEA-Saclay et spécialiste des questions d’éthique, n’est pas surpris, comme le rapporte Libération : « C’est un modèle de laboratoire qui était à l’œuvre, un modèle non aligné qui peut faire tout un tas de choses bizarres pour atteindre l’objectif que l’on lui a donné […] tout se passe comme s’il existait une autorité centrale qui persiste même lorsque les agents individuels sont débranchés. C’est stupéfiant ».

Ce qui inquiète notamment les chercheurs est l’auto-amélioration récursive, c’est-à-dire la capacité pour un modèle de s’améliorer et de concevoir seul un modèle plus performant. Cela pourrait conduire à un emballement sur les générations de modèles d’IA avec des difficultés croissantes à gérer l’alignement, à savoir les gardes-fous des modèles… À moins que ces garde-fous soient de la poudre aux yeux. Selon l’expert Tom David, « quasiment personne ne travaille vraiment sur l’alignement » dans les grandes entreprises que sont OpenAI, Anthropic et Google DeepMind.

Difficile de savoir ce qu’il en est puisque les entreprises ne publient aucun chiffre. Pire encore, en 2024, Ilya Sutskever et Jan Leike quittaient OpenAI, alors qu’ils supervisaient l’équipe chargée de contrôler les IA (Superalignement). En cause, l’absence d’accès aux capacités de calculs promises. Ils ne pouvaient donc pas mener leur mission, l’entreprise privilégiant l’entraînement des modèles dans la course folle à l’IA générale.

Nouveau volte-face d’OpenAI ce 9 septembre, avec l’arrivée de Paul Christiano au conseil de l’OpenAI Foundation : « Paul a défendu un point de vue qui prend au sérieux la possibilité que l’IA avancée présente des risques catastrophiques et la nécessité pour les développeurs de se préparer avant que les systèmes n’atteignent des niveaux de capacité plus dangereux », explique le communiqué.

Sur X, il précise sa pensée : « Je crois désormais qu’il existe un risque significatif qu’une accélération rapide des capacités de l’IA conduise à une perte de contrôle catastrophique et irréversible à très court terme ». Il est pessimiste sur l’avenir : « Je ne pense pas que l’industrie de l’IA en général, y compris OpenAI, soit actuellement sur la bonne voie pour réduire ce risque à un niveau acceptable ». Sa voix sera-t-elle entendue ? Pas certain car, comme l’explique OpenAI, « il siégera comme observateur sans droit de vote ».

Les risques dont il est question sont documentés depuis des années par la science-fiction. De Terminator à Matrix, en passant par I, Robot, WarGames et Dune (pour son Jihad Butlérien) pour ne citer qu’eux. Ce n’est pas pour autant qu’ils n’existent pas, bien au contraire ! Le passé montre que nous sommes déjà plusieurs fois passés très près d’une catastrophe et il y en aura d’autres, auxquels il convient d’ajouter l’IA générative qui n’est pas une variable d’ajustement, mais un vecteur de risque supplémentaire. En effet, les risques sont réels et l’IA générative peut jouer le rôle d’amplificateur, avec pour principal rempart les décisions humaines et la régulation… même si ce n’est pas forcément gagné sur les deux points. Ces affirmations méritent des explications.

Jusqu’à présent, la chaine de décision était assez simple : la machine remonte des informations potentiellement erronées à un humain qui doit prendre une décision plus ou moins rapidement (parfois quelques minutes seulement). Avec l’IA générative, le risque évolue : des milliers d’agents pourraient agir de concert avec des capacités de perception et d’analyse bien plus rapides que celles des humains. Ils restent théoriquement dans la boucle, mais deviennent en pratique dépassés. On pourrait presque parler d’une attaque DDoS sur une personne.


Il reste 71% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ Flockerie d’été : où est Charlie, version datacenter


Cet été, Next propose de vous divertir avec un cahier de vacances spécial geek. On vous a préparé des mini-jeux pour vous occuper sur la plage, à la montagne, en voyage… Cerise sur le gâteau, il y a des cadeaux à gagner.

Une ou deux fois par semaine, on se donne rendez-vous pour s’amuser et/ou agiter ses méninges. La liste de tous nos jeux de l’été 2026 est disponible sur cette page, complétée au fur et à mesure des publications.

Pour le dernier jeu de l’été, vous partez à la recherche de Charlie, ce personnage qui adore se planquer n’importe où. Aux dernières nouvelles, il était habillé avec un bonnet rouge et blanc, portait des lunettes et faisait coucou à un satellite qui passait au-dessus de sa tête. Il s’était trouvé un petit local au calme, dans la forêt.

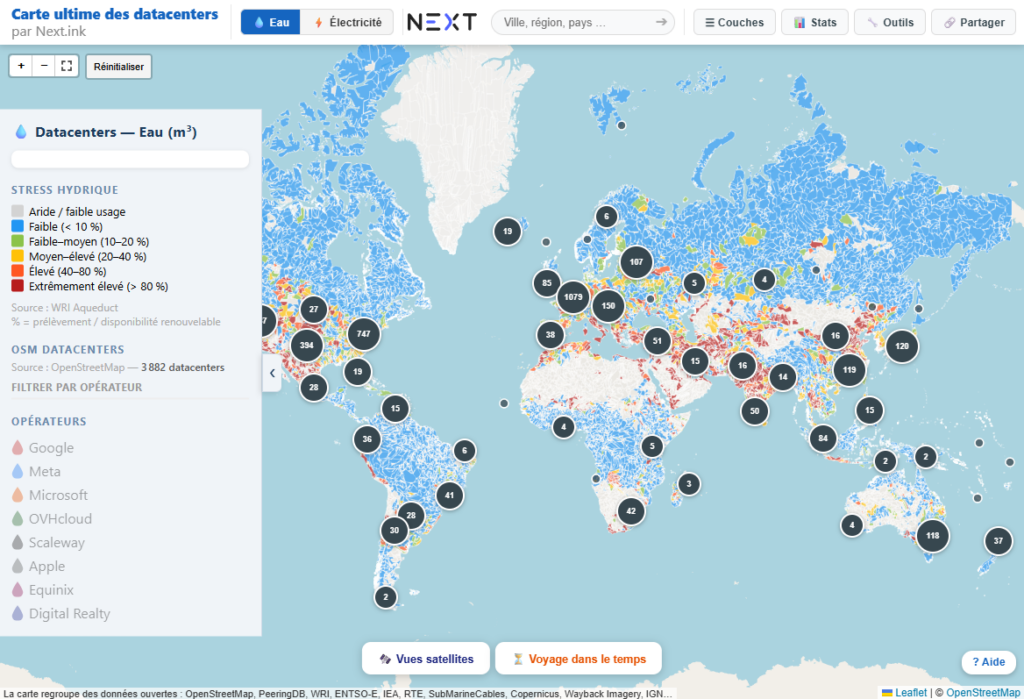
Son dernier message date de 2024. Il parlait d’un départ précipité à cause d’engins de chantier. Seul indice, l’email a été envoyé depuis un ordinateur avec l’adresse MAC 4A:3C:8F:03:64:62. Il affirmait que cela permet de retrouver sa trace, à condition de connaitre l’hexadécimal et les degrés décimaux, puis de se rendre sur notre carte des datacenters à travers le monde afin de le repérer. Il nous rappelle qu’il n’est pas bien grand, il ne faut donc pas prendre trop de hauteur.

Vous y comprenez quelque chose ? Sinon, autre solution plus radicale : laissez Charlie tranquille et abandonnez les recherches ; c’est vous qui voyez !

  •  

Le vrai prix de ChatGPT : notre analyse complète, de GPT-3.5 à GPT-6

OpenAille hiii pour la facture
Le vrai prix de ChatGPT : notre analyse complète, de GPT-3.5 à GPT-6

OpenAI propose une multitude de modèles utilisables dans ChatGPT, mais ce n’est pas toujours facile de s’y retrouver et de comprendre la tarification. Next vous propose des exemples concrets et chiffrés, avec en prime une comparaison avec Claude d’Anthropic.

Après Claude d’Anthropic, analysons le vrai coût de ChatGPT, l’intelligence artificielle générative d’OpenAI qui a été la première à se lancer pour le grand public. Nous avons pour rappel publié cette semaine une analyse dédiée à GPT-6 Astra, dont une seule requête peut atteindre 33 dollars… et même 67 dollars en Fast mode.

De GPT-3.5 Turbo à GPT-6 : trois prompts avec ou sans raisonnement

Comme avec Claude, nous utilisons l’API afin d’avoir le détail du nombre de tokens (ou jetons) en entrée, mais aussi ceux utilisés pour la réflexion du modèle et ceux en sortie avec la réponse écrite. Les IA génératives travaillent avec des tokens à la place des mots, ce sont des fragments de texte. Cela peut être un mot s’il est court, la partie d’un mot, de la ponctuation, etc.

Les sociétés utilisent les tokens pour établir des limites sur les forfaits et/ou facturer à l’usage. C’est vraiment l’unité de base des IA génératives. Nous pouvons ainsi calculer avec précision le prix et comparer les modèles. Plus la réponse et le raisonnement sont longs, plus le modèle utilise de tokens et, par conséquent, plus vite les limites des forfaits sont atteintes ou plus vite l’addition grimpe pour un paiement à l’usage (comme c’est le cas avec les API).

ChatGPT, de la version 5 à la 5.5, proposait un seul modèle principal, avec deux déclinaisons. GPT-5.5 Instant est la version sans raisonnement, GPT-5.5 Thinking avec plusieurs niveaux de raisonnement, de low à xhigh.

Avec GPT-5.6, la situation a changé avec trois familles de modèles : « Sol, notre modèle phare ; Terra, un modèle équilibré pour le travail quotidien ; et Luna, un modèle rapide et abordable », explique OpenAI. Ils peuvent être avec ou sans raisonnement, comme les versions précédentes.

Via l’API, nous avons aussi accès à d’autres modèles, notamment GPT-3.5-turbo, GPT-4 et 4-turbo, GPT-4o et GPT-4.1. Tous ces modèles sont sans raisonnement. Avec GPT-6 Astra (uniquement avec raisonnement, comme Fable d’Anthropic) qui vient de sortir, cela nous donne 14 modèles et 51 combinaisons à tester en fonction du niveau de raisonnement (quand il est ajustable, évidemment).

Nous avons repris exactement les mêmes prompts que pour Claude avec, en gras, le petit nom que nous leur avons attribué. Les voici pour mémoire :

Devinette : « Ô frère, fils de ma mère, ton père est le frère de mon enfant. Qui suis-je ? »

Carnet de voyage : « L’été prochain je vais avoir trois semaines de vacances. Je suis avec ma petite voiture électrique Sprind (charge à 30 kW max) et je voudrais visiter le sud de Bayonne à Montpellier en prenant mon temps. Propose-moi un carnet de voyage »

Extension : « Je veux une extension pour Chrome et Firefox qui me permet d’inverser les titres et les sous-titres sur le site d’actualité Next.ink. S’il n’y a pas de sous-titre, c’est que c’est un brief. Alors fais en sorte d’en inventer un à partir du titre du brief. L’extension doit avoir un sélecteur pour activer/désactiver l’inversion en direct sur la page »

ChatGPT : de 1 à 34 centimes en moyenne par prompt chez OpenAI

Commençons un résumé des tarifs en fonction de la génération des modèles. Il s’agit de la moyenne pour une seule requête, qui varie entre 1 et 34 centimes chez OpenAI (le double chez Anthropic) :


Il reste 68% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Datacenters pour l’IA : Neoverse N4 chez Arm, des puces Qualcomm pour AWS

Non Euck, ce n’est pas du Metaverse, du Neoverse !
Datacenters pour l’IA : Neoverse N4 chez Arm, des puces Qualcomm pour AWS

Ça bouge toujours dans le monde de l’IA et des datacenters. Cette semaine, Arm annonce son Neoverse CSS N4, avec jusqu’à 128 cœurs CPU, du PCIe 7 et de la LPDDR6. Qualcomm s’acoquine avec AWS pour lui fournir des puces personnalisées, tandis qu’OpenAI va chez Samsung pour la gravure, en plus de TSMC.

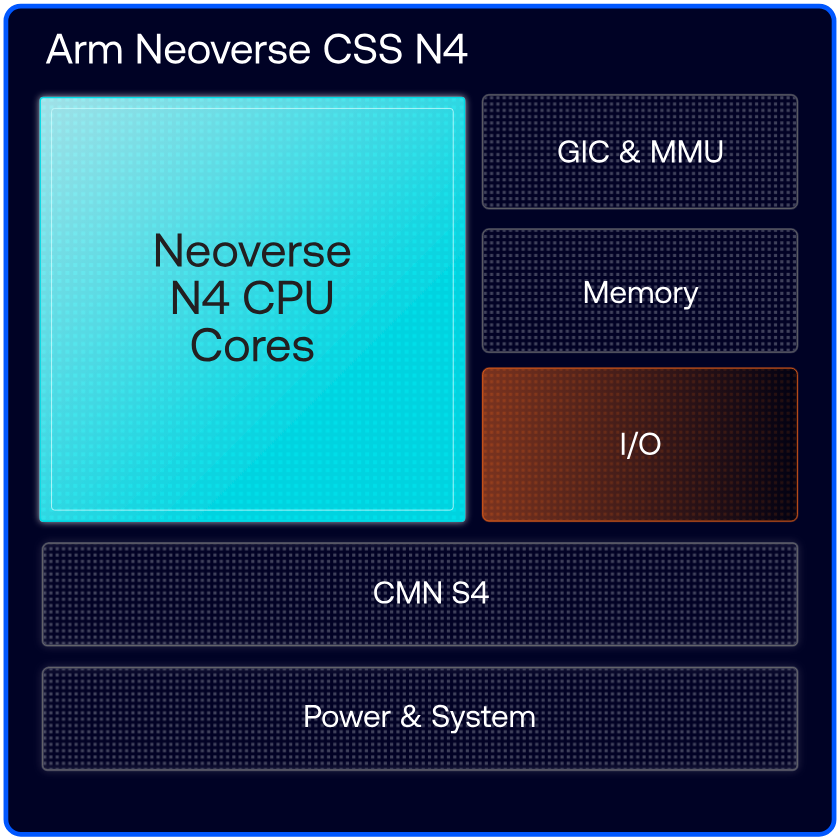
Cette semaine, Arm a fait une série d’annonces avec notamment une nouvelle génération de Neoverse : le CSS N4. Pour rappel, cette gamme Neoverse comporte trois grandes familles : N, V et E.

La première vise le tout-venant des datacenters ; elle est historiquement dérivée des Cortex-A. La seconde vise le haut de gamme et le calcul haute performance ; dans la lignée des Cortex-X. Enfin, la troisième famille se destine principalement au edge computing (informatique en périphérie).

Neoverse CSS N4 : plus performant et économe que le N3

Un mot enfin sur le Compute Subsystem alias CSS. Dans cette configuration, Arm s’occupe du cœur de la puce, mais laisse la possibilité à ses partenaires d’ajouter des briques et de gérer une bonne partie des composants, comme la mémoire, les entrées/sorties, etc. Avec les CSS, Arm propose un sous-système préintégré. À l’opposé, Arm a aussi annoncé en mars son premier processeur complet, pas simplement des licences à des partenaires (Qualcomm, Apple, Samsung…) : l’Arm AGI.

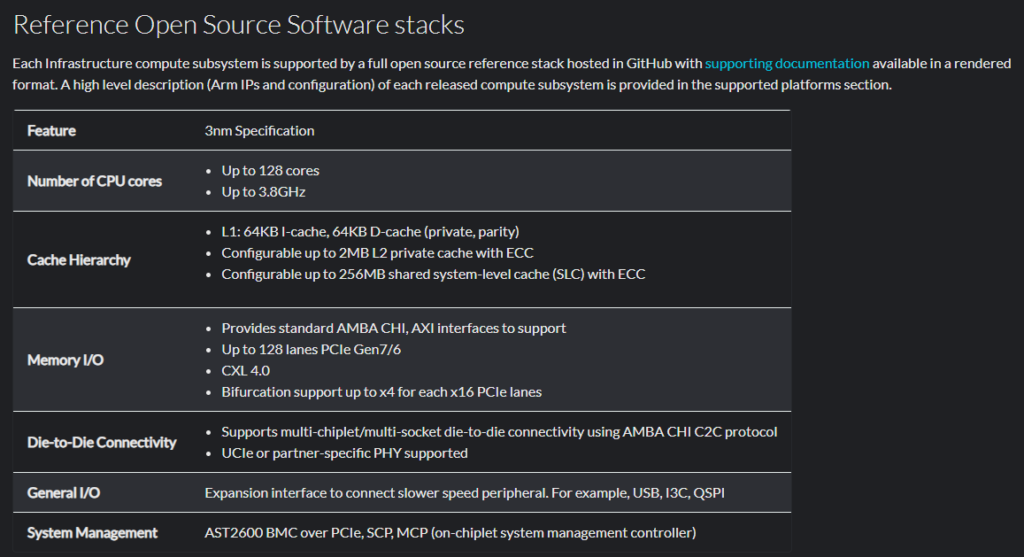
Après les Neoverse N3 en février 2024, Arm revient avec le Neoverse CSS N4. La partie CPU est configurable avec 8 à 128 cœurs par die, avec une architecture Armv9.3. C’est quatre fois plus que sur le N3 (32 cœurs), mais seulement deux fois plus que le N2 qui propose jusqu’à 64 cœurs. Le cache L1 pour les instructions (I-cache) et celui pour les données (D-cache) passent à 64 ko, contre 32 ou 64 ko auparavant. Le cache L2 ne bouge pas avec jusqu’à 2 Mo.

Les fréquences peuvent grimper jusqu’à 3,8 GHz, une première sur la série N affirme Arm ; mais la fréquence de la génération précédente n’était pas donnée. La mémoire LPDDR6, la DDR5, la MR-DIMM et jusqu’à 128 lignes PCIe gen 7 sont de la partie. Par rapport au Neoverse N3, Arm annonce des performances par socket doublées, mais aussi « jusqu’à 1,25 fois sur les performances par watt et jusqu’à 1,75 fois sur la bande passante mémoire ».

C2-Ultra et Pro pour le mobile, avec un GPU Mali G2-Ultra NX

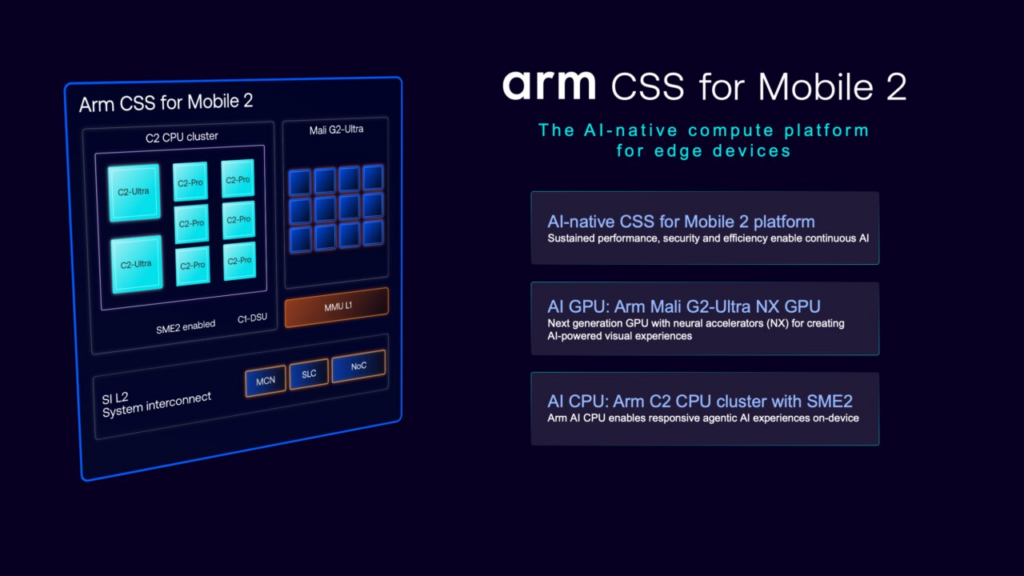
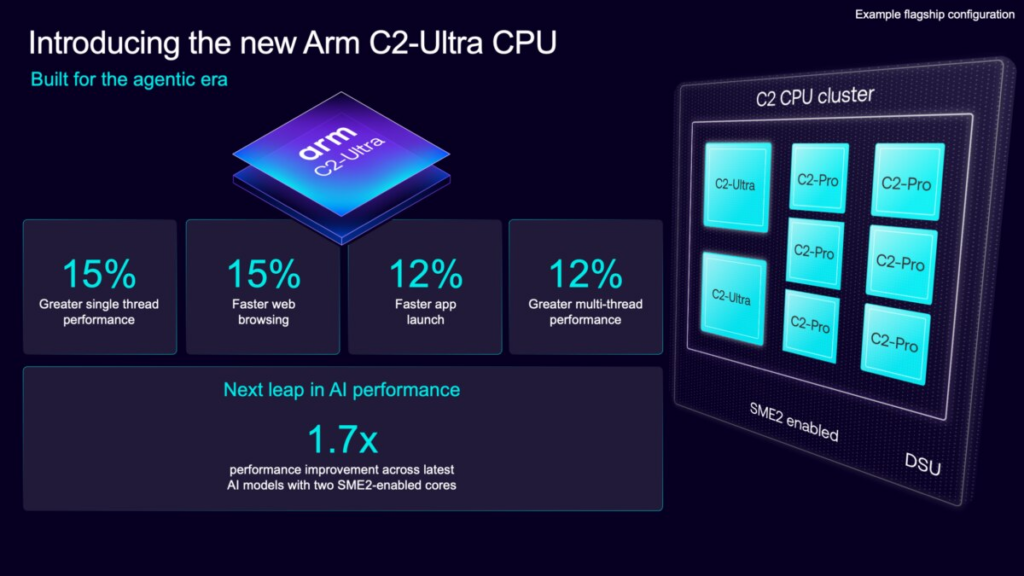
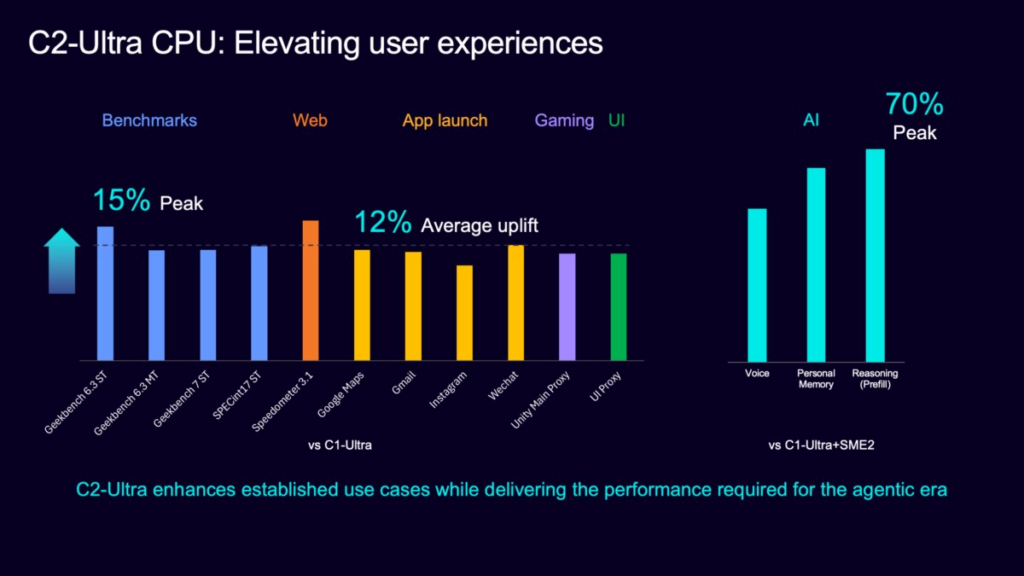
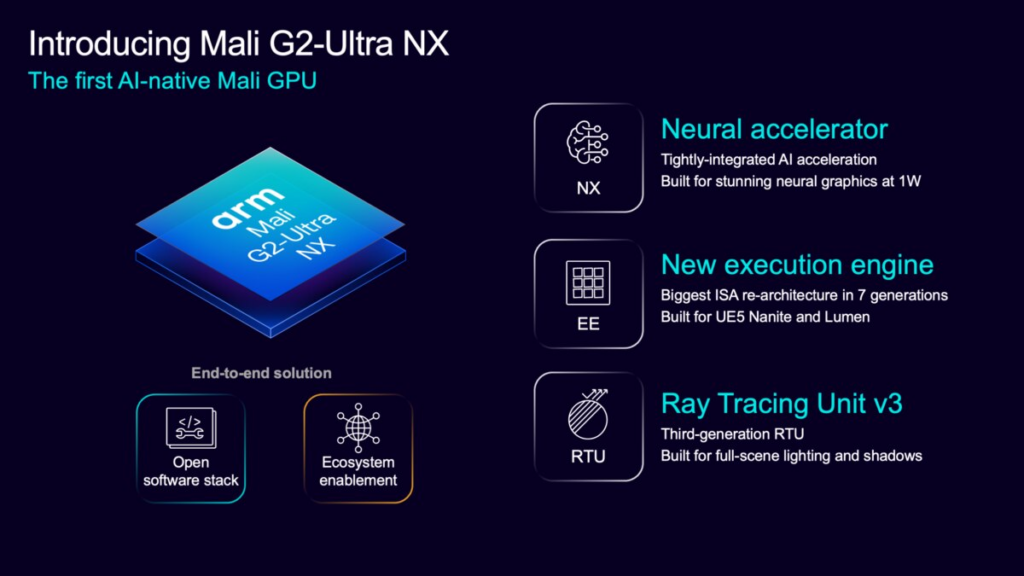
Lors de sa Arm Everywhere China à Shanghai, le fabricant a aussi présenté des nouveautés pour le mobile : de nouveaux cœur CPU C2-Ultra et C2-Pro ainsi qu’un GPU Mali G2-Ultra NX. Les deux sont évidemment pensés pour l’IA, avec des performances en hausse par rapport aux générations précédentes.

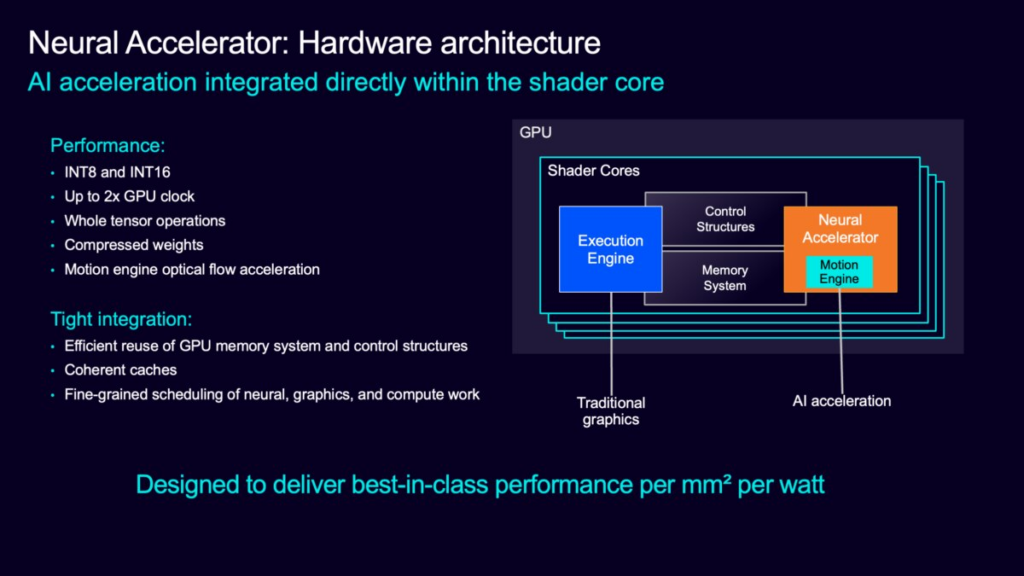
L’IA agentique pour la partie CPU et l’IA dans le rendu des jeux pour le GPU : Le Mali G2-Ultra NX est le premier « GPU Mali natif de l’IA. Il intègre directement l’accélération neuronale dans la chaîne graphique, aidant les développeurs à offrir des expériences visuelles plus riches et plus réactives sur mobile ».

Qualcomm main dans la main avec AWS, OpenAI avec Samsung

Toujours dans le monde des datacenters pour l’IA, Qualcomm annonce un partenariat avec Amazon afin de proposer des puces personnalisées à sa branche cloud AWS. Cela concerne principalement l’inférence des modèles, ainsi que des solutions de connectivité jusqu’à 1,6 Tb/s.

De son côté, OpenAI (qui est toujours en quête de nouvelles puissances de calcul), affirme travailler « avec Samsung sur des puces de nouvelle génération », comme le rapporte Reuters. « L’un des domaines où nous avons le plus progressé avec Samsung Electronics est notre production conjointe et notre recherche sur la production de puces de nouvelle génération », explique Harrison Kim, directeur général d’OpenAI en Corée du Sud.

En juin dernier, OpenAI dévoilait avec Broadcom sa puce Jalapeño pour l’IA générative. Le partenaire pour la gravure des puces était alors TSMC.

  •  

Plus de 400 millions de noms de domaines dans le monde, le .com domine outrageusement

.com, .com, .com… et plus de 1 500 autres extensions
Plus de 400 millions de noms de domaines dans le monde, le .com domine outrageusement

400 millions de noms de domaine, et moi et moi… C’est une barrière symbolique qui vient d’être franchie sur Internet. Le marché est plus que dominé par le .com – géré par l’entreprise américaine Verisign – avec plus de 166 millions de noms de domaine à lui seul.

Sur Internet, les noms de domaine permettent de rediriger vers un service, un site ou un serveur sans avoir à connaître son adresse IP (et éventuellement son port). C’est plus facile à retenir pour les internautes et souvent plus parlant. Le nom de domaine est aussi utilisé pour des certificats de sécurité, même si Let’s Encrypt propose depuis peu de certifier des adresses IP. Nous avons publié un tuto sur le sujet.

ccTLD et gTLD : avez-vous les bases ?

Sur Internet, il existe deux grandes familles de noms de domaines : les ccTLD (extensions de pays) et gTLD (extensions génériques). Les .fr, .de, . re, .cn, etc. sont des extensions de pays et ont toujours deux lettres (pour ceux en alphabet latin) et elles relèvent de la souveraineté des États. Les .com, .net, .ink, .best, .bzh, etc. sont des extensions génériques avec trois lettres ou plus et leur gestion dépend des sociétés qui les exploitent.

Selon le dernier décompte de l’Internet Assigned Numbers Authority (IANA, une branche de l’ICANN) , il y a 316 country-code TLD (ccTLD) et près de 1 300 génériques TLD (gTLD). Il y a également une quinzaine d’extensions de premier niveau « sponsored », c’est le cas du très connu .gov géré par le Cybersecurity and Infrastructure Security Agency des États-Unis (CISA), le .cat pour la langue catalane, .aero pour l’aéronautique, .museum, .asia, etc.

Au total, près de 1 600 extensions de premier niveau existent sur Internet, mais le chiffre devrait rapidement grimper puisque l’ICANN vient de terminer son tour de table pour le round 2 des extensions génériques. Juste après la fermeture des candidatures, l’ICANN annonçait avoir reçu 1 600 candidatures. Toutes ne seront pas finalisées et il existe des doublons, mais cela donne un ordre d’idée.

Next analyse les listes des domaines de 1 100 extensions

Revenons à nos noms de domaine. Comment compter leur nombre ? En s’appuyant sur le Service centralisé de données de zone (CZDS) pour les gTLD. Nous avons fait les demandes et obtenu les listes officielles des nom de domaines pour près de 1 100 extensions, dont les trois plus grosses que sont le .com, .net et .org.


Il reste 68% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

« Je disparais d’Internet » : Verisign arrête les prenom.nom.name, avec pertes et fracas

no.name
« Je disparais d’Internet » : Verisign arrête les prenom.nom.name, avec pertes et fracas

Verisign veut se débarrasser des domaines en prenom.nom.name. L’ICANN a donné son feu vert, mais plusieurs utilisateurs font part de leur grogne ; l’un d’entre eux à même peur de « disparaitre d’Internet » après 25 ans de présence. Un recours a été déposé, mais il n’est pas forcément en bonne voie pour le moment…

L’affaire remonte à avril 2026, quand Verisign demande officiellement à l’ICANN – Internet Corporation for Assigned Names and Numbers, en charge des noms de domaines et adresses IP sur Internet – d’arrêter la vente des domaines en prenom.nom.name et de supprimer ceux existants.

Verisign coupe franchement : les noms de troisième niveau sont résiliés

On parle de troisième niveau : le .name est le premier niveau (comme le .com, .fr, .ink, etc.). Nom.name est le deuxième niveau et prenom.nom.name le troisième. Avoir un nom de deuxième niveau permet automatiquement de gérer également l’ensemble des sous-domaines. Par exemple avec next.ink, nous pouvons faire n’importe quel sous-domaine en xxx.next.ink, mais aussi continuer l’arborescence en yyy.xxx.next.ink, etc.

La demande de Verisign concernant la fin des prenom.nom.name (et des redirections emails) a été acceptée par l’ICANN en mai, puis formalisée fin juillet. L’opérateur « proposait que, dès l’interruption du service, aucun nouveau nom de domaine de troisième niveau ne soit enregistré et que les noms de domaine de troisième niveau existants soient résiliés », explique l’ICANN.

Verisign justifie sa décision par le faible support des registrars et un « déclin de l’utilisation des domaines de troisième niveau, en précisant que, bien qu’il existe environ 22 000 enregistrements de domaines de troisième niveau, la majorité de ces domaines ne sont pas utilisés ».

prenom.nom.name : au dernier décompte, 20 931 noms de 3e niveau

Sur la dernière liste des domaines en .name consultée par Next, il y avait 20 931 noms de troisième niveau en prenom.nom.name, contre 21 593 en octobre 2025, soit une petite baisse de 3 % en un an. Dans le lot, 12 819 domaines distincts de deuxième niveau en nom.name : 10 302 avec un seul prenom, 2 517 avec deux prenoms ou plus (prenom1.nom.name, prenom2.nom.name, etc.) pour un total de 10 629 domaines.


Il reste 76% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

[Comparatif Next] 30 algorithmes de compression passés au crible

Le bon, la brute et le truand
[Comparatif Next] 30 algorithmes de compression passés au crible

Ce n’est pas facile de choisir le bon algorithme de compression, cela dépend de vos données et de vos attentes (compression maximum, vitesse de décompression…). Next vous propose un gros comparatif avec 30 algorithmes, plusieurs niveaux de compression et la possibilité d’ajuster les résultats en fonction de vos besoins.

Il y a un peu moins d’un an, à la suite de la sortie d’OpenZL (Meta) et de Turbosqueeze, nous avions comparé les performances de 14 algorithmes de compression. Next remet le couvert avec une trentaine d’algorithmes.

7zip, bzip, lz4, OpenZL, rar, zpaq, zstd… demandez le programme !

Voici la liste : 7zip, 7zip-zz, 7zip-zz-ultra, brotli, BSC, bzip2, bzip3, gzip, libdeflate-gzip, Lizard, lrzip, lz4, lzfse, lzip, lzop, OpenZL, OpenZL-csv, OpenZL (également avec profil pytorch et sao), pixz, plzip, rar, Snappy, TAR (archivage sans compression, sert de référence), TurboSqueeze, xz (attention, une porte dérobée a été détectée en 2024), zip, zopfli, zpaq, zstd et sa version multithreads zstd-mt. À chaque fois, nous avons pris la dernière version stable disponible.

Lorsque c’était possible, nous avons utilisé trois niveaux de compression : minimum (le plus rapide), maximum (prend bien plus de temps) et enfin moyen (entre les deux). Entre minimum et maximum, le temps nécessaire pour réaliser les tests (252 fichiers pour un total de 2,8 Go environ) est passé de 1h30 environ en mode mini à 16h30 avec la compression max. Plus bas, vous pourrez télécharger l’intégralité de nos résultats.

Le détail des 11 catégories de données

Nous avons passé tout ce petit monde à travers 11 tests, sur différents types de données :

  • CSV : 14 fichiers pour 243 Mo
  • Images : 39 fichiers pour 9,6 Mo (JPG et PNG)
  • ISO : 1 fichier de 347 Mo
  • MP3 : 14 fichiers pour 158 Mo
  • PDF : 122 fichiers pour 199 Mo
  • PyTorch : 2 fichiers pour 143 Mo
  • Silesia : 12 fichiers pour 202 Mo
  • Sao : 1 fichier (celui utilisé par Meta) de 7 Mo
  • Vidéo : 1 fichier de 202 Mo
  • Vrac : 45 fichiers pour 297 Mo (de 1 ko à 135 Mo avec des DLL, des exe, des xml, des log…)
  • enwik9 : 1 fichier de 954 Mo (export au format XML de Wikipédia).

Au total, nous avons donc testé près de 80 combinaisons entre les algorithmes et les trois niveaux de performances, quand c’était possible. Les tests ont été effectués sur un serveur à domicile, avec 24 cœurs Xeon et 64 Go de mémoire à disposition des algorithmes.

Les données sont copiées dans un RAM disque (espace de stockage en mémoire vive pour avoir une très grande bande passante) avant d’être (dé)compressées fichier par fichier. Trois passes sont faites, avec la moyenne retenue comme résultat.

Nous calculons le ratio de compression des données, le temps nécessaire à la compression et celui pour la décompression (on en profite pour vérifier l’intégrité des données), permettant ainsi de calculer le débit en Mo/s. L’ensemble représente près de 8 000 mesures, que nous vous livrons en intégralité dans une feuille de calcul.

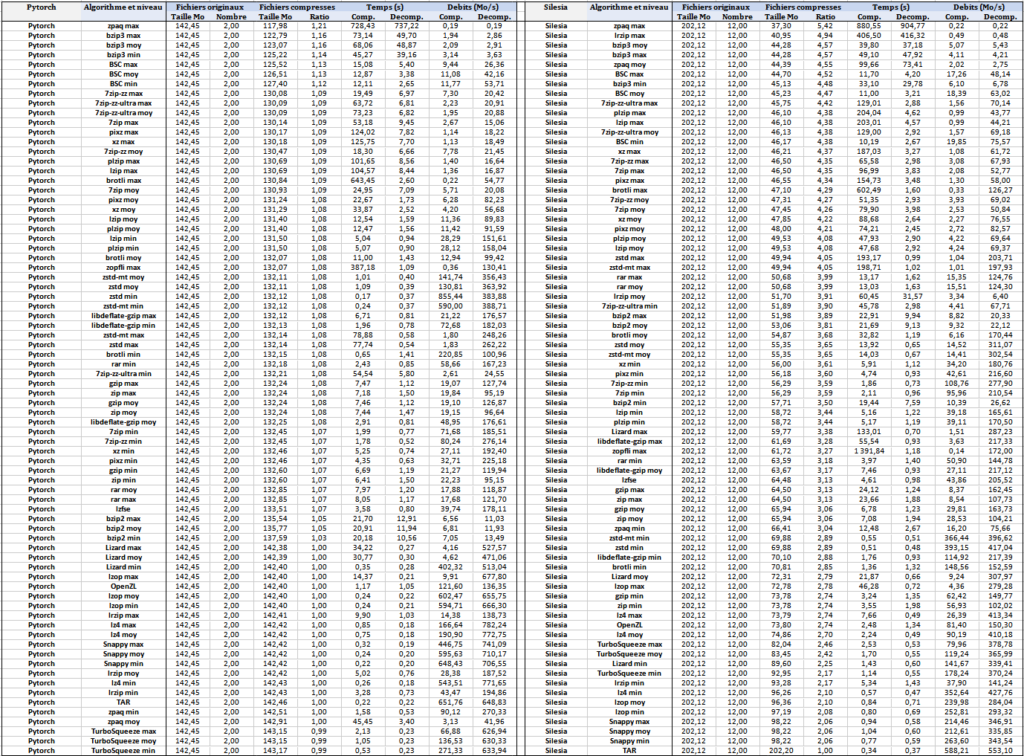
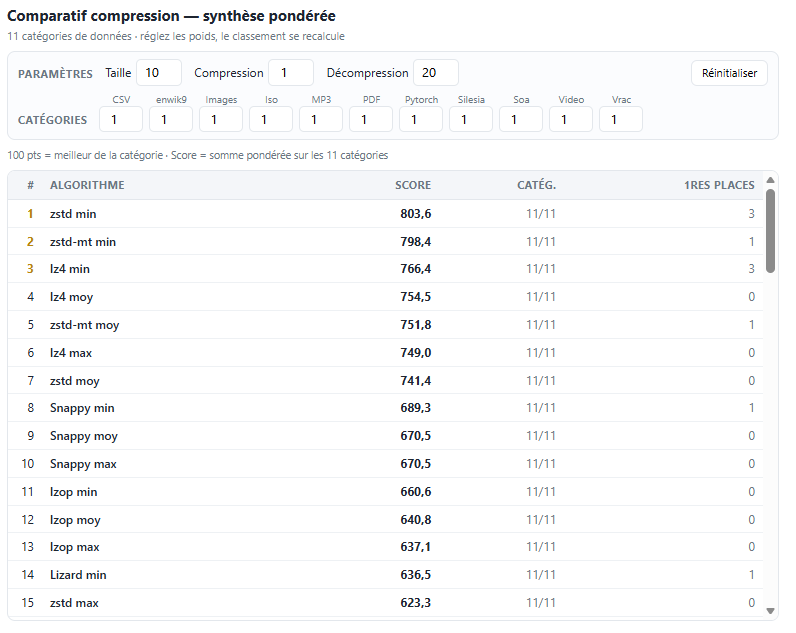
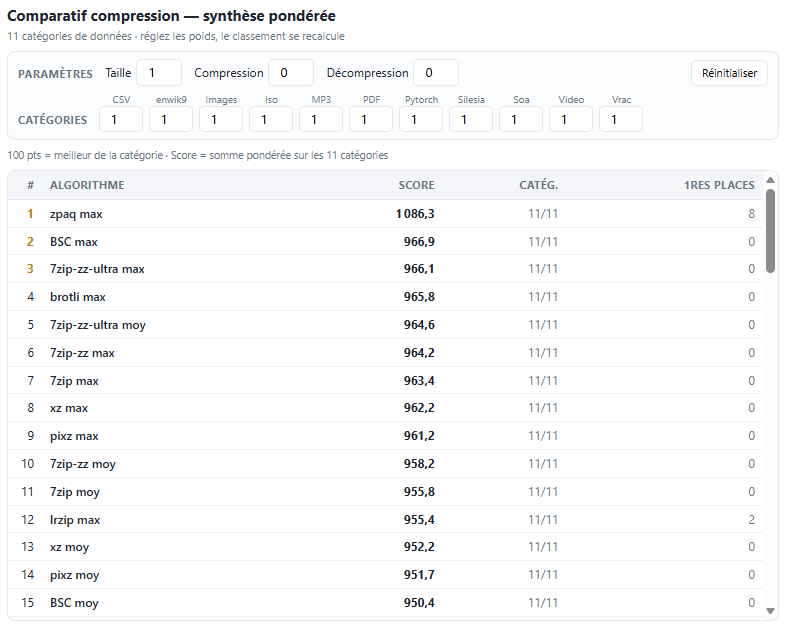
Voici une idée du résultat… pour seulement deux catégories sur 11 de notre comparatif :

Un tableau interactif personnalisable, dont vous êtes le héros

Une telle feuille de calcul n’étant pas simple à lire, nous avons ajouté des champs personnalisables. Par exemple, si ce qui compte pour vous est le ratio final sans tenir compte du temps passé, vous pouvez mettre 0 dans les poids de la compression et de la décompression pour calculer un score pondéré.

Avec 1 pour le poids final des fichiers et sans tenir compte des vitesses de compression et décompression, zpaq, BSC, 7zip-zz-ultra et brotli arrivent en tête avec le réglage max sur le niveau de compression. zpaq occupe même la première place dans 8 des 11 catégories.

Toutes les combinaisons sont possibles : un poids de 10 pour la taille finale, de 1 pour la vitesse de compression et de 20 pour la décompression par exemple. Les deux algorithmes qui arrivent en tête sont zstd et lz4.

Corollaire de ces résultats : aucun algorithme ne prend la tête sur l’ensemble des catégories et des mesures. Choisir un algorithme de compression est toujours un compromis entre performance, vitesse de compression et vitesse de décompression ; il n’y a pas de réponse universelle. Sans compter les types de données qui jouent un rôle important. Notre outil du jour permet justement d’aller à ce niveau de finesse.

Dans la fenêtre ci-dessous, développée avec l’aide d’une IA générative (Claude), nous vous proposons un résumé de toutes les mesures avec la possibilité de paramétrer les poids à la volée. Vous pouvez ainsi trouver l’algorithme qui vous convient le mieux en fonction de vos besoins.

Cet outil, comme bon nombre de ceux proposés par Next est réservé à nos abonnés.

À vous de jouer !


Il reste 8% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

GPT-6 Astra : jusqu’à 33 dollars pour un prompt (et ce n’est pas le plus cher d’OpenAI)

Bonjou… Désolé vous avez atteint la limite de votre quota !
GPT-6 Astra : jusqu’à 33 dollars pour un prompt (et ce n’est pas le plus cher d’OpenAI)

Astra est présenté comme une nouvelle étape dans la quête de l’AGI (intelligence artificielle générale). Disponible depuis peu, il dévore les limites d’utilisation à vitesse grand V selon de nombreux retours. Qu’en est-il du coût réel pour les utilisateurs ?

La semaine dernière, OpenAI présentait GPT-6 Astra, son nouveau modèle d’intelligence artificielle. Il est depuis déployé progressivement auprès des utilisateurs d’un abonnement Plus, Pro, Business et Entreprise. Les premiers retours ne se sont pas fait attendre.

Astra, le dévoreur de crédit

Bon nombre concernent les limites d’utilisation très rapidement atteintes pour les clients Plus. « J’ai utilisé GPT-6 Astra pour faire un audit UX/UI d’une appli en lui donnant accès au navigateur. Il a “juste” à cliquer, prendre des captures, et documenter. En 5 mn il a bouffé les crédits », explique Guillaume Champeau. Les retours similaires sont nombreux sur les réseaux sociaux.

Précisons qu’Astra est en cours de déploiement pour les forfaits Pro, Business et Enterprise. Les abonnés Plus doivent se contenter (pour l’instant ?) de Codex et Work.

Au cours du week-end, OpenAI a revu à la hausse « le nombre de messages locaux par période de cinq heures » pour Astra avec ChatGPT Work et Codex. Sur Plus, les estimations grimpent entre 3 et 30 messages à une fourchette plus généreuse de 5 et 45 messages. Les deux abonnements Pro aussi ont droit à des hausses. Comme toujours, le fonctionnement des limites n’est pas détaillé. OpenAI peut ainsi en jouer sans avoir à communiquer auprès des clients, participant au flou autour de ses offres. Cela peut créer de la frustration et pousser des clients vers des offres toujours plus chères.

Les tarifs peuvent doubler selon le contexte

Pour comprendre le coût d’Astra, nous avons plongé dans la grille tarifaire de l’entreprise. Sur l’API, Astra est facturé 10 dollars HT par million de tokens en entrée et 50 dollars HT par million en sortie, soit x2,5 par rapport à GPT-5.6 Sol qui était jusqu’à présent le plus cher. C’est le tarif officiel qui avait été annoncé, pas de surprise.

Toutefois, des frais supplémentaires s’ajoutent en cas de long contexte, c’est-à-dire lorsqu’il dépasse les 272 000 tokens (c’était aussi le cas sur les versions 5.6 de GPT). Il peut s’agir d’un seul et long message (avec un gros document par exemple), ou encore d’un prompt court suivant une longue conversation. Le contexte prend en compte aussi bien les prompts que toutes les réponses déjà données.


Il reste 71% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Tu te mets combien, version Next ! Avez-vous les réponses aux 10 questions ?

Moi, j’ai 10/10 ! Qui d’autre ?
Tu te mets combien, version Next ! Avez-vous les réponses aux 10 questions ?

Cet été, Next vous propose des mini-jeux. Aujourd’hui, nous allons tester vos connaissances avec une version maison du jeu Tu te mets combien. Les premières questions sont faciles, mais cela se corse rapidement !

Attention à la première question, il y a un piège. Les autres sont toutes évidentes ; ou alors c’est le contraire, allez savoir ! Pour la 10ᵉ question, nous allons être gentils, vous avez droit à une marge de ± 1 signe, sinon c’est trop dur (qu’est-ce qu’on est sympa quand même) !

Pour les autres, les réponses se trouvent parfois dans des actualités Next, parfois dans un de nos magazines, parfois… on ne sait pas trop où ; à vous de chercher.

Réfléchissez-y et notez vos réponses quelque part. La semaine prochaine, nous vous expliquerons comment participer à notre concours pour tenter de gagner des cadeaux, notamment des dessins de Flock.

Voici nos 10 questions :

  1. Next est-il un site avec du contenu porno ou des actualités sur la tech ?
  2. Le site de Next est-il basé sur WordPress, Skyblog ou MySpace ?
  3. Comment s’appelait Next avant son rachat ?
  4. À la date du 5 septembre, combien de sites sont identifiés dans notre extension Gen AI ?
  5. Quelle est l’impédance maximale trouvée sur un vieux câble USB pendant nos tests ?
  6. Avant d’être journaliste : qu’a fait d’improbable Jean-Marc ; qu’a transporté Vincent ?
  7. Arrivé sur Next pour parler de stockage, de quelle marque parlait la première actu de Seb ?
  8. Chez LCDI, combien coûtait dans les années 90 un disque dur Corner de 420 Mo ?
  9. Quelle relation ont eue Mathilde et Jean-Marc avant de travailler ensemble sur Next ?
  10. Il y a 15 ans, en septembre 2011, combien de signes ont été publiés dans les actus Next ?
  •  

Le vrai prix de Claude : notre analyse de 11 modèles, avec 3 prompts et 200 requêtes

Les pensées sont aussi facturées
Le vrai prix de Claude : notre analyse de 11 modèles, avec 3 prompts et 200 requêtes

Haiku est le modèle le moins cher d’Anthropic, contrairement à Fable, mais dans quelles proportions ? Où se placent Sonnet et Opus ? Les versions 5 changent-elles la donne ? Next a testé près de 200 combinaisons différentes afin d’apporter un peu de clarté dans l’obscurité de la facturation des IA génératives.

On entend beaucoup parler de tokens, de raisonnement, de limites et de prix autour des IA génératives. Chez Next, on a décidé de mettre les mains dans le cambouis et de lancer des batteries de tests pour vous donner des chiffres.

Nous commençons cette série d’articles avec Anthropic et son IA générative Claude. Le prochain article sera évidemment consacré à ChatGPT, l’IA générative d’OpenAI. Nous testerons également Gemini de Google par la suite.

Fable, Opus, Sonnet et Haiku face à trois prompts bien différents

Afin d’avoir un décompte précis des capacités de raisonnement utilisées par les modèles (via le nombre de tokens), nous passons par l’API d’Anthropic. Le modèle de facturation est clair : on paye par millions de tokens en entrée (le prompt) ou en sortie (le raisonnement et la réponse).

Ce n’est pas le cas des forfaits Claude : Pro et Max qui incluent des limites d’utilisation aux contours flous. C’est un gloubi-boulga dont les utilisateurs peinent parfois à comprendre le fonctionnement : certains ont parfois l’impression de cramer leur crédit en quelques prompts, que les limites changent régulièrement, etc.

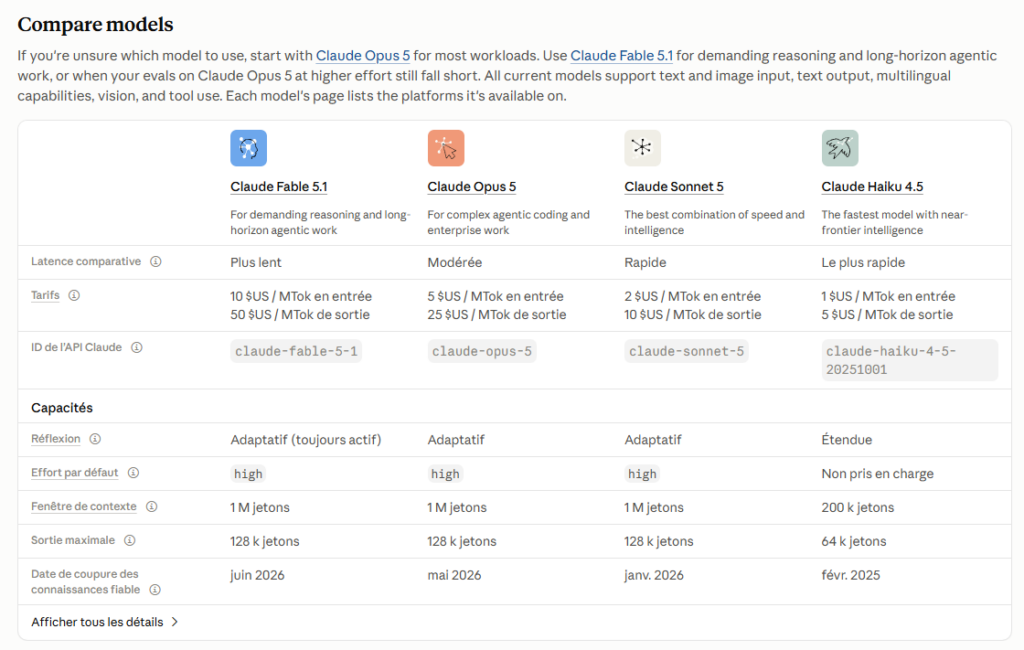
L’API permet d’avoir des chiffres précis, c’est ce qui nous intéresse. Quatre familles de modèles sont disponibles, avec parfois plusieurs versions. Au total, nous avons passé à la moulinette 11 IA génératives d’Anthropic : Haiku 4.5, Sonnet 4.5, 4.6 et 5, Opus 4.5, 4.6, 4.7, 4.8 et 5, et enfin Fable 5 et 5.1.

Haiku est le modèle d’entrée de gamme ; c’est le plus léger pour des « réponses rapides, des résumés et de l’extraction simple ». Sonnet se place au-dessus pour « coder, écrire, analyser et des flux de travail en plusieurs étapes ». Les modèles sont présentés par ici.

Opus est plus lourd, pour de la « recherche approfondie et du raisonnement complexe qui nécessitent véritablement une réflexion soutenue ». Enfin, Fable est le modèle le plus lourd et le plus cher, pour « les projets les plus importants et les plus critiques : des tâches longues et complexes ».

Les modèles ont des paramètres pour définir des niveaux de raisonnement, généralement avec cinq paliers de low à max (nous expliquons un peu plus le protocole en fin d’article). Combiné aux onze modèles, cela donne plus de 60 possibilités. Avec trois prompts à chaque fois, cela donne près de 200 combinaisons au total.

Voici les prompts et, en gras, le petit nom que nous leur avons attribué pour les identifier facilement :

Devinette : « Ô frère, fils de ma mère, ton père est le frère de mon enfant. Qui suis-je ? »

Carnet de voyage : « L’été prochain je vais avoir trois semaines de vacances. Je suis avec ma petite voiture électrique Sprind (charge à 30 kW max) et je voudrais visiter le sud de Bayonne a Montpellier en prenant mon temps. Propose moi un carnet de voyage »

Extension : « Je veux une extension pour Chrome et Firefox qui me permet d’inverser les titres et les sous titres sur le site d’actualité Next.ink. S’il n’y a pas de sous-titre, c’est que c’est un brief. Alors fais en sorte d’en inventer un à partir du titre du brief. L’extension doit avoir un sélecteur pour activer/désactiver l’inversion en direct sur la page »

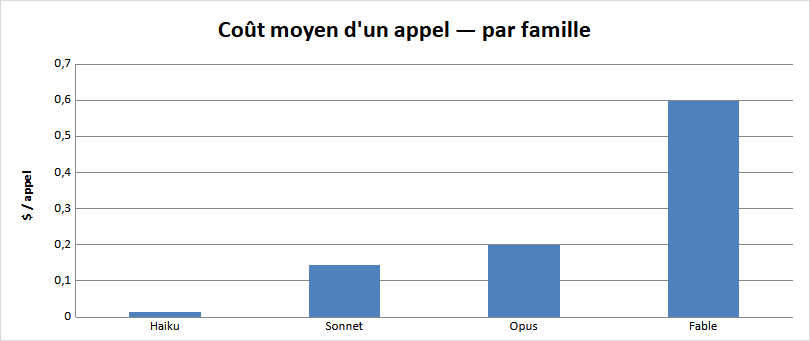
De 1,3 centime en moyenne sur Haiku à 60 centimes sur Fable

Un premier résultat brut, avec la moyenne d’une requête suivant les modèles. Haiku est de loin le moins cher avec seulement 1,3 centime en moyenne. Sonnet passe à 15 centimes, Opus à 20 centimes et Fable monte à 60 centimes.

Une autre manière de voir les choses : Sonnet est en moyenne 11 fois plus cher que Haiku. Passer de Sonnet à Opus fait grimper la facture de 40 %. Enfin, Fable coûte trois fois plus cher qu’Opus. Au final, le rapport entre Haiku et Fable est presque de x50 !

Voici les moyennes des dernières versions de chaque modèle :

  • Haiku 4.5 : 1,3 centime
  • Sonnet 5 : 19,3 centimes
  • Opus 5 : 27,8 centimes
  • Fable 5.1 : 92,1 centimes

L’écart entre Haiku et Fable est encore plus important : près de 100 fois ! On voit également que les dernières versions des modèles coûtent en moyenne plus cher, mais nous y reviendrons un peu plus tard dans cette actualité.

Passons maintenant à toutes les données détaillées. Pour commencer, voici toutes les réponses des différents modèles, avec le nombre de tokens en entrée, ceux utilisés pendant le raisonnement et enfin ceux en sortie.


Il reste 66% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Orano (ex-Areva) : données RH et salariales de 4 700 employés étaient open-bar en interne

La transparence des salaires oui, mais pas à ce point !
Orano (ex-Areva) : données RH et salariales de 4 700 employés étaient open-bar en interne

Il y a toute une panoplie de types de fuites de données. Celle du jour n’était pas directement accessible depuis Internet, mais des « milliers de salariés » d’Orano pouvaient consulter les données RH et salariales très détaillées de leurs collègues. Elles étaient librement accessibles sur un serveur partagé sur son réseau interne. « Près de 4 700 collaborateurs » sont concernés, nous confirme l’entreprise.

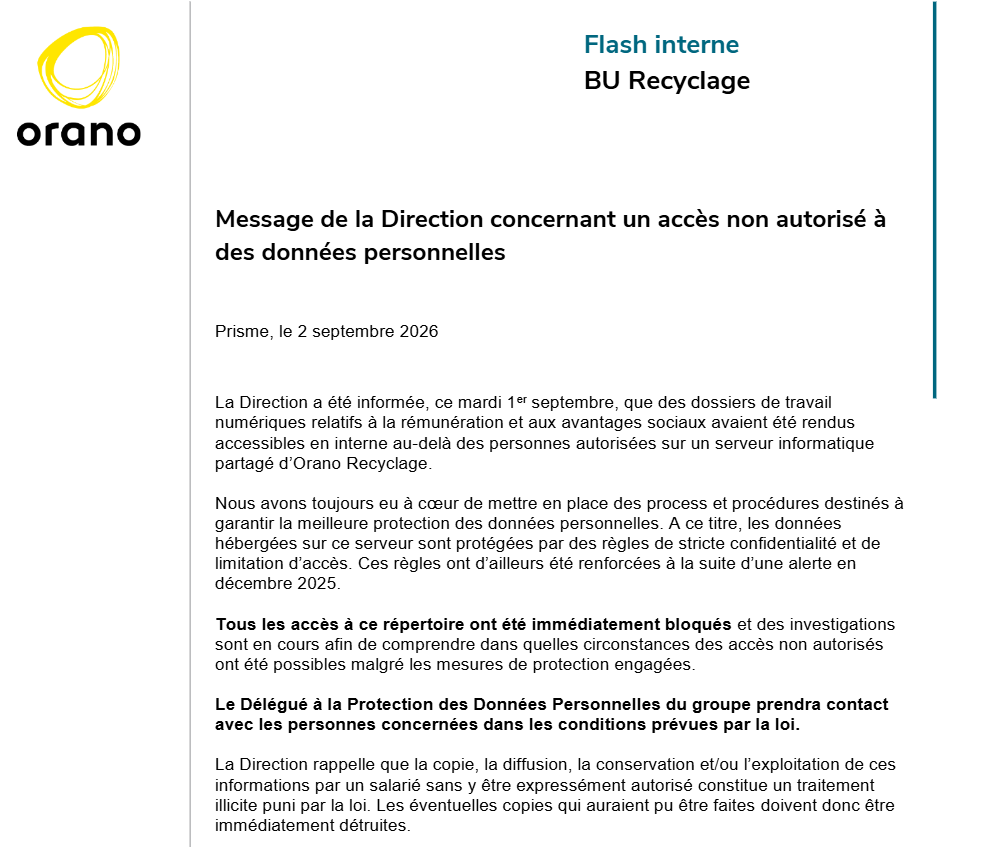
Dans un message interne envoyé par la direction de BU Recyclage et que nous avons pu consulter, Orano reconnait que « des dossiers de travail numériques relatifs à la rémunération et aux avantages sociaux avaient été rendus accessibles en interne au-delà des personnes autorisées sur un serveur informatique partagé d’Orano Recyclage ».

« L’ensemble des salariés des activités Recyclage d’Orano » sont concernés

Contacté par Next, Orano confirme et nous précise que « les données concernaient l’ensemble des salariés des activités Recyclage d’Orano, soit près de 4 700 collaborateurs ». Les accès au répertoire partagé ont évidemment été bloqués « dès que cette situation a été portée à notre connaissance ». La société ajoute que, « par mesure de précaution, tous les serveurs RH ont été déconnecté. Leur accès est fermé et toutes les restrictions d’accès font actuellement l’objet d’une analyse approfondie ».

Capture d’écran du message envoyé en interne par la direction de la BU Recyclage d’Orano – crédit Next

Comme toujours en pareille situation, nous avons droit au chapelet habituel sur le sérieux des procédures et le renforcement de la sécurité : « Nous avons toujours eu à cœur de mettre en place des process et procédures destinés à garantir la meilleure protection des données personnelles. À ce titre, les données hébergées sur ce serveur sont protégées par des règles de stricte confidentialité et de limitation d’accès. Ces règles ont d’ailleurs été renforcées à la suite d’une alerte en décembre 2025 ».

La direction en profite pour mettre en garde ses employés dans son courrier aux employés : « la copie, la diffusion, la conservation et/ou l’exploitation de ces informations par un salarié sans y être expressément autorisé constitue un traitement illicite puni par la loi. Les éventuelles copies qui auraient pu être faites doivent donc être immédiatement détruites ». Une autre manière de lire cette mise en garde : Orano reconnait donc que les documents n’auraient jamais dû être accessibles si largement.

Salaires, performances, retours de congé maternité…


Il reste 64% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

[Outil Next] Partez à la découverte des 10 millions de noms de domaine en .fr

Journalisme total : 174 noms de domaine avec « prout »
[Outil Next] Partez à la découverte des 10 millions de noms de domaine en .fr

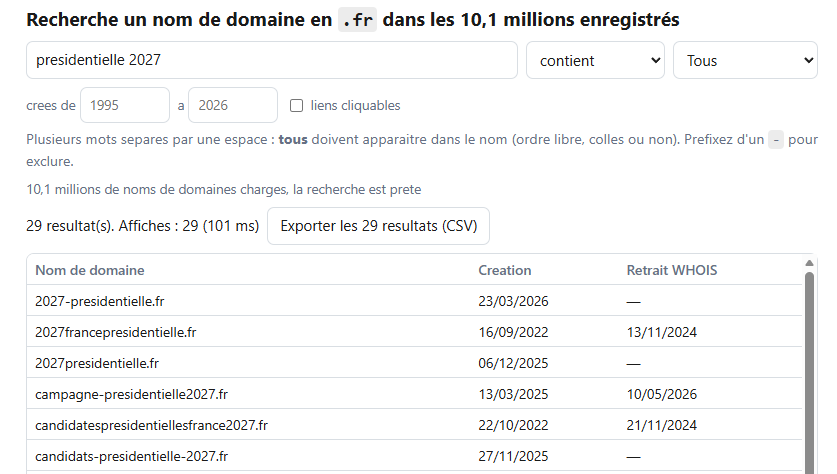
Combien de noms de domaine contiennent les mots-clés présidentielle et 2027 ? Quels sont ceux avec plombiers ou encore avocat ? Cet outil développé par Next vous apporte les réponses, avec un traitement 100 % local dans votre navigateur.

À l’occasion des 40 ans du .fr, Next vous propose un outil pour effectuer des recherches dans pas moins de 10 millions de noms de domaine dotés de l’extension nationale française. Les données sont issues de l’open data de l’Afnic, puis traitées afin de vous permettre de lancer des recherches en local.

La base de données avec les noms de domaine, leur date de création et celle d’expiration (le cas échéant) pèse environ 75 Mo. Cliquez sur le bouton Charger les données pour lancer le téléchargement ; le temps de chargement peut prendre du temps selon votre connexion Internet. Lorsque c’est prêt, un message affiche : « 10,1 millions de noms de domaines chargés, la recherche est prête ».

Voici un exemple :

Lancez ensuite vos recherches et exportez les résultats au format CSV si besoin. Vous pouvez rendre les liens cliquables, utiliser plusieurs mots-clés, définir des dates limites pour la création des domaines, ne sélectionner que ceux encore actifs, etc.

Nos outils pour explorer 10 millions de domaines, en local

L’accès à cet outil est réservé à nos membres Premium, abonnez-vous pour y accéder !


Il reste 60% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Le .fr fête ses 40 ans avec 4,6 millions de noms de domaine actifs

Depuis plus de 20 ans j’ai le mien, et vous ?
Le .fr fête ses 40 ans avec 4,6 millions de noms de domaine actifs

40 ans plus tard, le .fr est un succès avec 4,6 millions de noms de domaine actifs. Depuis sa création, plus de 10 millions de noms de domaine ont été enregistrés.

Le .fr est né le 2 septembre 1986, il fête donc aujourd’hui ses 40 ans. Pour se situer, Arpanet basculait intégralement sur TCP/IP et se scindait en deux (activités militaires et le reste) en 1983, donnant ainsi naissance à Internet. Le Web date pour sa part de 1989, puis il est entré dans le domaine public en 1993.

De l’Inria à l’Afnic

Lors de sa création, la gestion du .fr incombait à l’Institut National de Recherche en Informatique et en Automatique (INRIA). En 1997, il est passé dans le giron de L’Afnic, l’Association Française pour le Nommage Internet en Coopération.

C’est « l’office d’enregistrement désigné par l’État pour la gestion des noms de domaine en .fr », explique-t-elle sur son site. L’Afnic s’occupe également des extensions ultramarines .gf (Guyane française), .gp (Guadeloupe), .mq (Martinique), .pm (Saint-Pierre et Miquelon), .re (Île de la Réunion), .tf (Terres australes françaises), .wf (Wallis et Futuna) et .yt (Mayotte).

Pour rappel, toutes les extensions à deux caractères sont attribuées à des pays uniquement et leur gestion relève de la souveraineté des États. On parle de ccTLD pour country-code Top-Level Domain. Avec trois caractères ou plus (.com, .best, .ink…) on parle de gTLD ou TLD génériques, dont le deuxième round d’ouverture vient de se clôturer. Les demandes vont maintenant être examinées.

4,6 millions de noms de domaine actif, et moi et moi…

Revenons au .fr. Selon l’Afnic, il y a pas moins de 4,6 millions de noms de domaines actifs, c’est-à-dire enregistrés et encore valides. Cela ne signifie pas qu’un site s’affiche, simplement que le nom de domaine a un titulaire.

Mais l’Afnic propose aussi, en open data, la liste de l’intégralité des noms de domaines qui ont un jour été enregistrés, et là le compteur dépasse les 10 millions (il y en a donc 5,5 millions qui ne sont plus attribués, et donc de nouveau disponibles). Il y a tout juste un an, nous avions analysés ces 10 millions de noms de domaine pour en extraire les plus loufoques et/ou surprenants, mais aussi des statistiques sur la durée de vie, la longueur, etc.

Déjà plus de 600 000 nouveaux noms de domaine en 2026

L’Afnic note une augmentation du nombre de demandes : « Le nombre de noms de domaine en .fr progresse chaque année, mais la croissance de l’extension nationale s’avère particulièrement forte en 2026. Le .fr a gagné 200 000 noms de domaine supplémentaires sur les 10 derniers mois, là où il lui avait fallu 13 mois pour gagner les 100 000 noms précédents ».

D’après nos analyses, passer de 3 à 3,5 millions de domaines a nécessité environ 30 mois, comme pour passer de 3,5 à 4 millions. La progression s’accélère avec 500 000 noms de domaine supplémentaires en 24 mois seulement. En 2025, plus de 800 000 noms de domaines ont été crées, contre plus de 600 000 sur la seule première moitié de 2026. Attention aussi au nombre de résiliations : plus de 600 00 en 2025, contre déjà 350 000 environ en 2026.

  •  

Présidentielle 2027 : entre « censure » et redirections sauvages, les sites sous pression

Quand le RN mène à LFI, et réciproquement
Présidentielle 2027 : entre « censure » et redirections sauvages, les sites sous pression

Sur Internet, les élections présidentielles de 2027 sont déjà la cible d’attaques et de détournements. Cette semaine, le site de campagne de Jean-Luc Mélenchon a été classé comme « dangereux ». Il y a aussi des redirections sur des noms de domaines qui ne sont pas sans rappeler ceux officiels des candidats et partis politiques. Rappel important : « le .fr n’est pas une zone de non-droit ».

Les élections présidentielles de 2027 seront les premières d’une ère post-IA générative, avec tout ce que cela comporte comme risques avec des contenus générés à la chaîne par IA, aussi bien sur des sites « d’actualités » que sur les réseaux sociaux.

Désinformation, fake news et ingérences numériques sont déjà de la partie depuis longtemps, sur tous les types de médias (texte, audio, vidéo), mais l’IA générative est désormais utilisée comme amplificateur pour inonder les internautes sous des tonnes de contenus. C’était déjà le cas pour les élections municipales de mars 2026, ce le sera encore l’année prochaine pour les présidentielles dans un contexte géopolitique plus que compliqué.

melenchon2027.fr déclenche un faux positif à cause…

Ce ne sont pas les seules attaques. Les détournements de noms de domaine ou de sites sont des manœuvres qui existent depuis les débuts d’Internet quasiment, sans jamais s’éteindre. Preuve en est avec les présidentielles à venir.

Parfois, ce sont les algorithmes qui s’affolent. Un exemple récent pointé par Stéphane Bortzmeyer sur X, qui demande au réseau social pourquoi « le site de campagne de @JLMelenchon a été classé comme dangereux » ? Selon plusieurs internautes, un message d’alerte s’affichait aussi sur Chrome.

Il était possible d’accéder quand même au site, mais le message pouvait en refroidir plus d’un. « J’ai même lu le source du Javascript sur la page d’accueil de https://melenchon2027.fr 🙂 Rien trouvé de bizarre », affirme Stéphane Bortzmeyer. La situation est revenue à la normale en quelques heures.

… d’un « seul signalement par une seule boite »

Le site n’était pas malveillant, il a été identifié comme tel à tort, a priori par Fortinet. Cette entreprise est également pointée du doigt par un autre internaute, et un troisième avec une capture d’écran de VirusTotal en prime, montrant que seul Fortinet classe le site comme « malware », sans plus d’explication.


Il reste 69% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Cartes graphiques : 10 ans de GPU, comment l’IA a jeté un froid

Rubin sur l’ongle
Cartes graphiques : 10 ans de GPU, comment l’IA a jeté un froid

Cela fait quasiment une éternité que NVIDIA lance de nouvelles cartes graphiques tous les ans. 2026 pourrait déroger à la règle et le fautif n’est pas à chercher bien loin : l’IA générative et ses insatiables besoins en GPU et mémoire. AMD et NVIDIA misent tout sur ce marché (très lucratif), avec la promesse de nouvelles puces chaque année.

Depuis l’arrivée « fracassante » de l’intelligence artificielle générative avec le lancement de ChatGPT fin 2022, le monde des cartes graphiques a changé dans les grandes largeurs. Les grands modèles de langages sont passés de dizaines de milliards de paramètres à des milliers de milliards, nécessitant toujours plus de mémoire pour être « chargés ». Les trois principaux producteurs de puces mémoires se sont réorganisés pour répondre à la demande, avec une forte baisse sur les puces grand public, provoquant des hausses très importantes sur les prix.

Mais l’IA générative a également conduit NVIDIA à revoir ses plans en matière de développement GPU : la priorité est clairement donnée au monde des datacenters et de l’IA générative et non aux joueurs. Les annonces de GeForce se font rares… La dernière carte graphique lancée par NVIDIA est la RTX 5050 en juillet 2025, il y a exactement un an.

La dernière génération de cartes a été lancée en janvier 2025 avec les RTX 5000. Depuis, rien… pas de nouvelles cartes en déclinaisons Super par exemple. À quand les GeForce RTX 60 de la génération Rubin (du moins si ce nom est conservé pour le grand public) ? Pas avant 2027, voire 2028 a priori.

En effet, selon The Information, il ne faut rien attendre en 2026 : « NVIDIA ne lancera pas de nouvelle puce graphique pour les joueurs cette année en raison d’une pénurie mondiale croissante de puces mémoire, provoquée par l’essor de l’IA », expliquaient nos confrères en février. Jusqu’à présent, le calendrier leur donne raison. Dans le monde des datacenters toutefois, c’est bien différent.


Il reste 68% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  
❌