❌

Vue lecture

Les patrons de l’IA appellent à lever le pied, leurs dépenses disent l’inverse

It's the edge of the world in all of western civilization
Les patrons de l’IA appellent à lever le pied, leurs dépenses disent l’inverse

L’appel de Dario Amodei à ralentir le rythme de développement des modèles de pointe en l’absence d’une réglementation ne peut pas être décorrélé de la course aux investissements dans laquelle se sont lancées toutes les entreprises du secteur, à commencer par celles dont les CEO ont relayé son propos. À quelques semaines de l’introduction en bourse programmée d’Anthropic, il souligne non pas une contradiction, mais un décalage susceptible d’aggraver les craintes liées à une explosion de la bulle de l’IA générative.

Dernier épisode d’une actualité décidément frénétique quant aux enjeux de long terme liés aux développements de l’intelligence artificielle générative : Dario Amodei, patron d’Anthropic, a publié samedi 12 septembre un article intitulé « We Must Pace the Frontier », dans lequel il argue que l’industrie doit ralentir le rythme auquel elle améliore les capacités des modèles de pointe. Il prend bien soin de souligner qu’il ne s’agit pas d’arrêter l’entraînement de nouveaux modèles ou leur déploiement commercial, mais de prendre le temps nécessaire pour vérifier leur sécurité et leur alignement.

Pour ce faire, il propose de faire confirmer ces vérifications par des évaluateurs tiers disposant d’un droit d’accès complet aux travaux des entreprises concernées. Il suggère dans le même temps que ces dernières harmonisent leurs travaux de vérification, et qu’une coordination internationale planche sur une réglementation adaptée, intégrant les enjeux de compétition avec les régimes non démocratiques.

L’appel d’Amodei a rapidement reçu le soutien public d’Elon Musk, de Sam Altman, de Demis Hassabis (Google DeepMind) puis de Satya Nadella (Microsoft). Un discours dont l’unisson interroge : les cinq entreprises dirigées par ces cosignataires sont financièrement engagées dans la course à l’IA et mobilisent littéralement des centaines de milliards de dollars pour construire ou faire construire les infrastructures nécessaires à l’entraînement et à l’inférence de leurs modèles. Comment, dans ce contexte, peuvent-elles prôner un ralentissement du secteur, et quelle est la valeur réelle de cette prise de position d’un point de vue économique ?

Des paroles, mais peu ou pas d’engagements concrets

La lettre de Dario Amodei ouvre de nombreuses pistes de réflexion (« we should consider… »), mais elle se limite à une seule promesse concrète, qu’Anthropic présente d’ailleurs comme un « engagement unilatéral » : l’ouverture d’un accès « niveau salarié » à des évaluateurs indépendants qui seraient par la suite libres de publier leurs conclusions. L’entreprise se réserverait tout de même le droit de caviarder un certain nombre d’informations, dont celles « commercialement sensibles ». Amodei cite nommément l’institut METR comme l’un de ces auditeurs potentiels, en dépit des critiques formulées à l’encontre de ce dernier suite à la publication de son rapport sur l’incident de cybersécurité survenu entre OpenAI et Hugging Face.

Anthropic n’annonce en revanche aucun engagement concret sur le rythme de publication de nouveaux modèles, ou le ralentissement du déploiement de l’IA générative. Satya Nadella confirme dans sa propre réaction que la réflexion en cours ne remet pas en cause l’orientation stratégique globale : « Il nous faut également accélérer et étendre les avantages de l’IA, afin qu’ils profitent largement aux pays, aux communautés et aux entreprises. Cela nécessite un écosystème novateur où les modèles propriétaires et open source peuvent prospérer ».

Un prétexte utile pour retarder l’IPO d’OpenAI ?

De toutes les prises de position formulées suite à la publication d’Amodei, une seule semble avoir une conséquence économique immédiate. Il s’agit du soutien affiché par Sam Altman. Le patron d’OpenAI a en effet confirmé à Fortune, dans un entretien réalisé le 11 septembre et publié le 12 (voir la vidéo intégrale de l’échange), que les conditions n’étaient pas actuellement réunies pour que l’entreprise procède à son introduction en bourse. « Je pense sincèrement que, compte tenu de la situation actuelle en matière de sécurité, ce serait malvenu de nous introduire en bourse maintenant, et nous ne ressentons aucune pression à ce sujet », déclare Sam Altman, selon qui l’IPO ne devrait finalement pas intervenir en 2026.

Est-ce vraiment la controverse autour des risques soulevés par les modèles de pointe qui motive ce report ? Fortune rappelle à juste titre que le New York Times s’était déjà fait l’écho, en juin dernier, d’un glissement de calendrier décidé en interne. À l’époque, il n’était pas question d’alignement ou de modèles capables d’échapper à la supervision interne. Le report était motivé par des conditions de marché jugées peu favorables à la gigantesque levée de fonds souhaitée par OpenAI.

Sarah Friar, directrice financière d’OpenAI, avait également confirmé mi-août, en interne, cette lecture plus pragmatique qu’éthique. Dans un message adressé aux collaborateurs, elle expliquait que l’entreprise disposait des ressources nécessaires à son développement grâce à sa dernière levée de fonds, et que ce n’était pas grave si Anthropic partait en bourse avant OpenAI.

La décision n’était donc pas nouvelle, mais la façon de la justifier a changé. La combinaison du passage de Sam Altman au micro de Fortune et de la publication de Dario Amodei semble avoir eu quelques répercussions sur les marchés. Corrélation n’est pas causalité dans un environnement aussi complexe, mais l’annonce a notamment fait des vagues au Japon. Le conglomérat Softbank, qui s’est engagé à hauteur de 30 milliards de dollars supplémentaires au capital d’OpenAI cet hiver, a ainsi perdu plus de 10 % à la bourse de Tokyo lundi. Il semble avoir entraîné dans son sillage les valeurs asiatiques de la mémoire vive, dont Samsung, SK hynix et Kioxia.

L’effet s’est ensuite propagé dans le reste du monde : l’indice PHLX Semiconductor Sector, qui réunit 30 des plus grandes sociétés cotées du secteur des semi-conducteurs, a ainsi reculé de 5,86 % sur la seule journée de lundi.
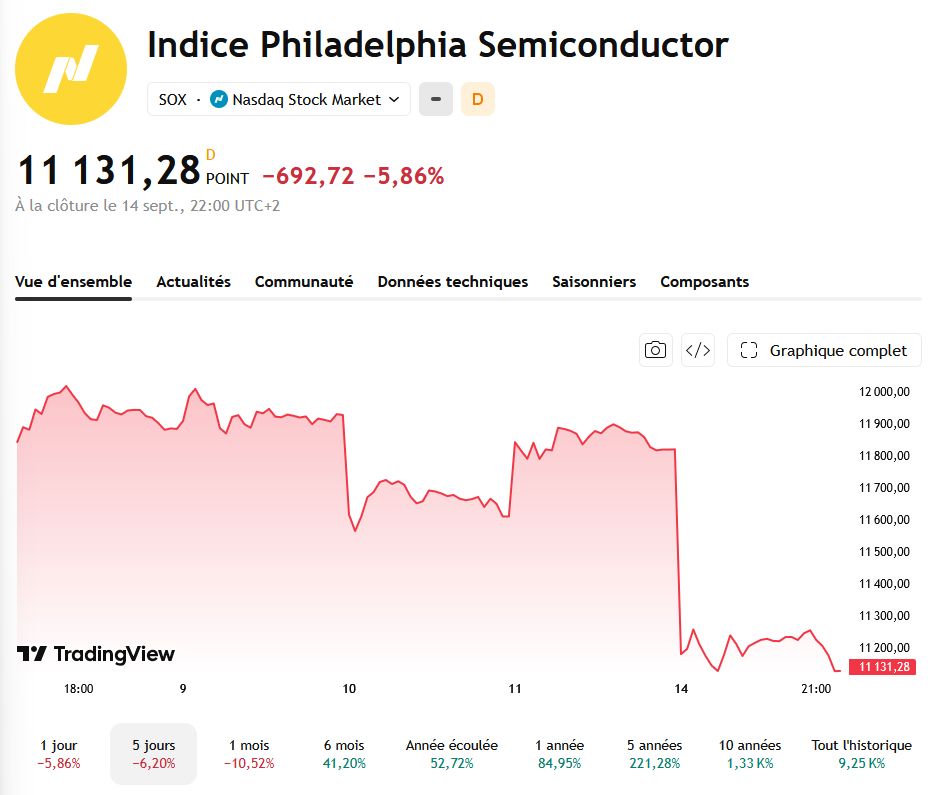
L’indice PHLX Semiconductor Sector a décroché de près de 6 % sur la journée du lundi 14 septembre – capture d’écran du site TradingView

La correction n’est pas exceptionnelle, à plus forte raison quand les tensions sur le pétrole mettent les marchés sous pression. Elle souligne cependant que les entreprises dont les perspectives de croissance reposent sur le développement de l’IA accusent le coup, avec des valorisations en berne par rapport à leurs plus hauts historiques du mois de juin.

Anthropic aurait-elle intérêt à ralentir ?

Hormis le report confirmé par OpenAI, la variable économique n’a pourtant pas fondamentalement changé. Les quatre grands hyperscalers (Amazon, Microsoft, Google, Meta) ont ainsi tous confirmé la révision à la hausse de leurs dépenses d’investissement prévisionnelles lors de la publication de leurs résultats trimestriels début août. Ces dernières dépassent donc désormais les 700 milliards de dollars envisagés à la fin du premier trimestre.

En parallèle des essais et autres lettres de têtes pensantes d’Anthropic, l’éditeur des modèles Claude poursuit d’ailleurs sa propre route vers la bourse. Pour ce faire, il cherche à envoyer des messages rassurants en direction des investisseurs. Or ces messages éclairent d’un jour particulier l’intention de ralentir le développement des modèles de pointe…

D’après le Financial Times, Anthropic a déclaré à un petit groupe de ses actionnaires qu’elle envisageait de réaliser son deuxième trimestre consécutif rentable sur la période en cours. L’entreprise aurait notamment affirmé atteindre une marge brute supérieure à 80 % avant règlement des frais liés à la location d’infrastructures chez ses partenaires et à l’entraînement de ses modèles. Pour tenir le rythme effréné des sorties de nouveaux modèles, Anthropic va maintenant jusqu’à louer des datacenters entiers chez certains de ses concurrents, et ses trajectoires de dépenses se montent à plusieurs dizaines de milliards de dollars par an.

Toujours d’après le Financial Times, Anthropic aurait revendiqué un chiffre d’affaires de 11,5 milliards de dollars sur le deuxième trimestre, ce qui porterait son revenu annualisé, c’est-à-dire la projection de chiffre d’affaires annuel estimée à partir de ses revenus actuels, à 65 milliards de dollars, contre 47 milliards de dollars estimés à fin mai 2026.

La croissance est donc réelle, mais en l’état, Anthropic communique un indicateur qui exclut ses principaux coûts, à quelques semaines d’une supposée tournée des investisseurs pour préparer son IPO. Il est bien sûr impossible, sans accès direct aux comptes d’Anthropic, de vérifier où se situe réellement le curseur. Convaincre le secteur de ralentir le développement des modèles de pointe, et donc des coûts d’entraînement associés, permettrait certainement à l’entreprise d’assainir son bilan et d’allouer plus de ressources à son développement commercial.

L’introduction en bourse comme juge de paix ?

L’analyse de la situation est d’autant plus complexe que pour l’instant, tout le monde navigue à vue, précisément parce que les bilans financiers en question restent dans l’ombre. Cette incertitude participe d’ailleurs à l’emballement médiatique du moment, ainsi qu’à l’anxiété grandissante du public vis-à-vis de l’IA et de ses datacenters. Les discours mi-complaisants, mi-frénétiques, sur la guerre à venir entre la Chine et les États-Unis ou sur les modèles échappant à tout contrôle, y trouvent un terreau fertile.

Les marchés, eux, attendent surtout de mesurer la solidité réelle des entreprises de l’IA. Dans ce contexte, la décision d’OpenAI de rester une entreprise privée peut d’ailleurs être interprétée comme une volonté de garder le secret sur la réalité de ses comptes.

L’exemple de l’introduction en bourse de SpaceX est à ce titre éclairant.

Il reste 52% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ Capgemini vend sa filiale états-unienne prestataire de la police de l’immigration


Capgemini a finalement coupé les ponts avec l’ICE, la tristement célèbre police de l’immigration des États-Unis. Le groupe français a en effet annoncé le 12 septembre dernier la signature d’un accord de vente définitif de sa filiale états-unienne spécialisée dans les contrats gouvernementaux, Capgemini Government Solutions. La transaction devrait être bouclée dans les prochaines semaines.

« Capgemini annonce aujourd’hui avoir conclu un accord avec ITC Federal, un fournisseur américain de services et de solutions digitales pour les agences fédérales chargées de sécurité intérieure et de défense, en vue de la vente de Capgemini Government Solutions, sa filiale qui travaille avec le gouvernement fédéral américain. »

caméra de vidéosurveillance par Flock
Illustration : Flock

Capgemini avait lancé ce processus de vente en début d’année, après que la presse a révélé les différents contrats gagnés par sa filiale CGS auprès de l’ICE. Parmi les différents appels d’offre remportés figurait une prestation d’identification et de localisation des personnes recherchées par l’ICE, en croisant l’ensemble des informations publiques ou privées susceptibles d’être recueillies en ligne à leur sujet.

Plusieurs syndicats représentants du personnel de Capgemini s’étaient insurgés contre ces missions, jugées incompatibles avec les valeurs éthiques prônées par le groupe et sa gouvernance.

Le montant de la transaction n’a pas été communiqué. Capgemini a rappelé samedi que CGS « représentait 0,4% du chiffre d’affaires du Groupe en 2025 et moins de 2% de son chiffre d’affaires aux Etats-Unis ».

  •  

☕️ Le groupe Muse se fait déloger de ses comptes de réseaux sociaux par Meta


Meta a présenté cette semaine Muse, son nouvel agent IA destiné au grand public et censé pouvoir gérer de façon autonome des tâches du quotidien. Stratégique au regard des ambitions affichées par Mark Zuckerberg dans le domaine de l’intelligence artificielle générative, ce lancement (réservé pour l’instant aux États-Unis) s’accompagne sans surprise d’une vaste campagne de communication en ligne sur les supports du groupe.

Pour ce faire, Meta avait logiquement besoin de comptes @Muse sur les principaux réseaux sociaux, à commencer par les siens. Problème : l’adresse en question est occupée, depuis de longues années déjà, par le célèbre groupe britannique du même nom.

Plusieurs internautes ont remarqué mercredi que le groupe emmené par Matt Bellamy s’était fait déloger de ladite adresse, d’abord sur Instagram. Le compte @Muse renvoie désormais vers l’agent IA de Meta, tandis que les 2,7 millions d’internautes qui suivaient les images de concert de Muse doivent désormais se rendre sur @museband. Même topo sur Facebook, où le groupe est désormais hébergé sur une adresse en /museband.

X, pourtant en dehors du réseau Meta, reflète lui aussi ce mouvement, dans des conditions identiques : Muse pour l’agent IA et Museband pour le groupe. Le site officiel de Muse référence encore, en pied de page, l’adresse de ses anciens réseaux sociaux, à l’exception d’Instagram qui avait été mis à jour au moment de la rédaction de cette brève.

Appelez moi le webmaster ! – capture d’écran Next

Plusieurs des fans de Muse (le groupe, pas l’agent) se sont émus de ce qu’ils considèrent comme une spoliation, et y sont allés de leurs commentaires mécontents sous les publications annonçant le lancement de Muse (l’agent, pas le groupe).

Cette prise de contrôle paraît à première vue fort cavalière, mais on ne sait pas pour l’instant dans quelles conditions elle a été réalisée, ni si le groupe avait été prévenu, voire indemnisé d’une façon ou d’une autre. Ni Meta, ni Bellamy et sa bande n’ont pour l’instant réagi publiquement.

En attendant d’avoir le fin mot de l’histoire, on ne peut tout de même s’empêcher de penser, et de rappeler, que l’univers musical de Muse, riche de plus de vingt ans de carrière, est profondément marqué par la dystopie et des critiques à peine larvées contre les dérives totalitaires du système moderne. « They will not control us. We will be victorious. »

  •  

Mistral lève 3 milliards d’euros et revendique une approche « full stack » de l’IA

Mistral de nuit ne dure qu’un pain cuit
Mistral lève 3 milliards d’euros et revendique une approche « full stack » de l’IA

Mistral AI a annoncé mardi avoir réuni 3 milliards de dollars lors d’un tour de table emmené notamment par Samsung et d’autres investisseurs étrangers. L’entreprise profite de l’occasion pour affirmer qu’elle n’a pas renoncé au développement de modèles de pointe, et met en avant sa capacité à accompagner les entreprises au-delà de la simple fourniture de modèles ou d’infrastructures de calcul.

Installée depuis peu dans le XVIIIe arrondissement de Paris, Mistral AI a annoncé mardi 8 septembre sa quatrième levée de fonds, hors amorçage, en trois ans d’existence. Cette série D constitue un record à l’échelle européenne : l’entreprise a en effet réuni 3 milliards d’euros, à l’issue d’un tour de table qui la valorise à 21 milliards d’euros.

Les multiples n’ont rien de comparable avec ceux affichés par OpenAI ou Anthropic, mais ils témoignent tout de même d’une accélération significative : le dernier tour de table de Mistral remonte à septembre 2025, date à laquelle ASML avait pris 11 % du capital pour 1,3 milliard d’euros. Depuis, Mistral a été chercher des fonds supplémentaires sous forme d’emprunts bancaires, à hauteur de 722 millions d’euros, pour soutenir l’approvisionnement en GPU de ses datacenters. Elle a également annoncé un investissement à hauteur de 1,2 milliard d’euros dans un complexe de datacenters en Suède.

Des fonds asiatiques, européens et états-uniens

La nouvelle levée de fonds annoncée mardi fait entrer Samsung Electronics au capital. Le fabricant sud-coréen est présenté comme le principal acteur de ce tour de table qui associe aussi le fonds suédois EQT, le géant états-unien PSG Equity, et la plupart des fonds ayant déjà financé Mistral. Dans le lot subsistent quelques rares acteurs français, dont la banque publique Bpifrance, Carmignac ou Eurazeo, aux côtés d’acteurs principalement états-uniens, dont NVIDIA.

Mistral indique que ces nouvelles ressources contribueront à « étendre significativement sa recherche de pointe », ainsi qu’à développer son infrastructure et à accélérer sa croissance commerciale et son expansion internationale. Face aux critiques qui soulignent depuis quelques temps sa propension à déployer des modèles à poids ouverts qu’elle n’a pas conçus, l’entreprise laisse donc entendre qu’elle n’abandonne pas ses projets en matière de modèles frontier en propre. Elle n’en fait cependant pas l’alpha et l’omega de sa stratégie, au contraire.

« Lors de la première vague d’IA générative, la question centrale était de savoir qui serait capable de concevoir le modèle le plus performant. Aujourd’hui, les organisations et les gouvernements se posent une question différente : comment exploiter la puissance de l’IA pour leurs besoins critiques sans perdre le contrôle de l’infrastructure et du processus d’analyse ? », expose ainsi Mistral.

Sur ce volet, Mistral affirme être « la seule entreprise d’IA au monde à développer l’ensemble de la pile technologique nécessaire pour répondre à cette question : des modèles à poids ouvert, l’infrastructure et la capacité de calcul sur lesquelles ils fonctionnent, et les produits qui permettent leur mise en production ». Une approche à la fois « full stack » et ouverte, qui serait donc gage de limitation de la dépendance vis-à-vis d’un fournisseur unique pour les clients concernés.

  •  

Les conférences développeurs appellent les entreprises à ne pas les laisser disparaitre

Support your local devconf dealer
Les conférences développeurs appellent les entreprises à ne pas les laisser disparaitre

33 collectifs et associations engagés dans l’organisation d’événements techniques pour développeurs lancent un appel collectif. Entre budgets de sponsoring et achats de billets en baisse, ils redoutent que leurs conférences ne soient plus économiquement viables et que leur disparition ne participe à un appauvrissement général du secteur, particulièrement dans le contexte d’un recours accru à l’IA.

Bon nombre de conférences techniques destinées aux développeurs reposent principalement sur l’engagement d’une communauté de bénévoles, qui se chargent de trouver un lieu, fédérer des intervenants, communiquer en amont et assurer l’accueil des participants le jour J.

Leur motivation est indispensable, mais pas suffisante : entre location d’une salle, obligations réglementaires de sécurité, fournitures, repas et autres kakémonos, il faut aussi que le budget de l’événement s’équilibre. Particulièrement quand il est porté par une association locale ou un collectif qui ne dispose pas d’autres ressources financières que les recettes de l’événement et les adhésions de ses membres.

La mécanique économique se grippe

L’équation s’équilibre en principe grâce aux sponsors, c’est-à-dire les entreprises qui paient pour afficher leur marque sur les supports de l’événement, disposer d’un stand sur place le jour J et, souvent, profiter d’un canal privilégié pour diffuser ou faire connaître leurs recrutements en cours. Le reste du budget provient généralement de la billetterie, autrement dit le public payant de l’événement, dont les entrées (le tarif est de l’ordre de quelques dizaines d’euros) sont généralement payées par l’employeur des développeuses et développeurs concernés par la thématique.

Problème : il semblerait que cette mécanique plutôt conventionnelle se grippe. 33 organisations en charge de conférences tech viennent en effet de signer un appel commun à une plus large mobilisation du secteur :

« Les événements techniques traversent aujourd’hui une crise silencieuse. Budgets sponsoring resserrés, achats de billets en baisse, adhésions associatives en recul : partout, les mêmes signaux d’alerte s’allument et l’inquiétude s’installe au sein des organisations. Si rien ne change, nombre d’entre eux ne verront pas de nouvelle édition. Nous, organisateurs, organisatrices et associations tech, alertons aujourd’hui l’écosystème sur ce qui est en train de se jouer. »

L’appel est notamment lancé par l’AFUP, l’Association française des utilisateurs de PHP, qui organise chaque année le Forum PHP (prochaine édition les 8 et 9 octobre prochain à Disneyland Paris) et, en 2026, des déclinaisons baptisées AFUP Day, portées par ses antennes locales de Lille, Lyon et Poitiers.

« L’an dernier, notre événement phare était déjà en deçà de ses objectifs. Sur l’année 2026, la tendance s’est accélérée et a touché également l’AFUP Day. Nous avons été globalement en dessous de nos objectifs (billetterie et sponsoring), pour un résultat à- 17 % – soit environ 6 500 euros », nous confie Xavier Leune, membre de l’association.

Le forum PHP, nettement plus ambitieux en termes de budget, s’annonce quant à lui sous des auspices inquiétants. « Les premières semaines de vente ont marqué un nouveau recul puisque nous étions en moyenne à 30 % en dessous de l’année dernière. L’été nous a fait connaître un nouveau décrochage, nous sommes désormais à- 47 % sur la billetterie. Le sponsoring quant à lui est en recul de 25 % », s’inquiète notre interlocuteur. Sans inversion de tendance, l’événement pourrait se solder par un déficit suffisamment important pour compromettre la pérennité de l’association.

Trouver des sponsors et des visiteurs payants

Début juin, l’AFUP avait déjà alerté sur les difficultés rencontrées autour de ses différents événements :

« Malgré nos multiples prises de contact, malgré les appels à la communauté, la recherche de soutiens est difficile. De multiples entreprises nous indiquent ne pas avoir de budget marketing en 2026. La grande incertitude qui règne dans le secteur, que cela soit lié au contexte mondial, à l’arrivée de l’IA ou d’autres raisons économiques, n’invite pas les acteurs de l’écosystème à s’impliquer auprès de l’association ».

Si le Forum PHP fait figure de locomotive, les difficultés n’épargnent pas de plus petites conventions locales. En juin, l’asso qui organise le BreizhCamp indiquait elle aussi faire face à un sponsoring en retrait pour son édition 2026. « Cela nous a amené à augmenter le prix des billets, mais cette augmentation n’est malheureusement pas suffisante pour absorber le manque de recettes, nous avons donc dû renoncer à certaines dépenses cette année », décrivait-elle alors.

D’autres signataires jonglent eux aussi avec un budget d’autant plus difficile à équilibrer qu’il recèle une part d’incertitude jusqu’à l’ouverture des portes. Hors early birds, le gros des billets se vend en effet souvent dans les dernières semaines, alors qu’il faut engager en amont les dépenses liées au lieu ou à la restauration.

La conférence girondine BDX I/O, dont l’édition 2026 se tiendra les 29 et 30 octobre prochain, a par exemple abandonné le Palais des congrès de Bordeaux au profit des couloirs et des amphis de l’école Enseirb-Matmeca de Talence. Le mouvement traduit une réalité économique, que l’asso organisatrice a tournée à son avantage, en profitant des frais de location réduits pour passer son événement sur deux jours et donc proposer un programme plus soutenu.

À ce stade, elle envisage un atterrissage à l’équilibre, mais le résultat final dépendra à la fois de la billetterie et de la décision des sponsors encore en attente. « Les budgets se resserrent partout et sur toutes les topologies d’entreprises, et malheureusement des événements comme le nôtre ne sont pas la priorité quand il s’agit d’attribuer des budgets », analyse Amélie Benoit, membre de la petite équipe bénévole qui s’active, et s’épuise, depuis des mois pour monter l’événement.

Même si l’optimisme reste de rigueur, l’organisation chasse donc les postes de dépense susceptibles d’être réduits sans dégrader la qualité de l’accueil, tout en cherchant des leviers pour dynamiser son offre. « Nous sommes très heureux de pouvoir accueillir des start-ups gratuitement cette année. C’est un choix, pas économique du tout pour le coup, qui nous tenait énormément à cœur pour pouvoir diversifier le paysage d’entreprises présentes à l’événement, et pour avoir une meilleure représentation de l’écosystème tech à Bordeaux », illustre Amélie Benoit.

Entre expertise et velléités d’ouverture

Quels que soient la communauté, le langage ou les pratiques de développement concernées, la clé de voûte du succès reste bien sûr la programmation. Elle doit à la fois garantir un niveau d’expertise suffisant pour motiver le déplacement sur le temps professionnel, mais aussi s’ouvrir aux problématiques transverses qui animent les réflexions et les transformations du secteur. Sans surprise, l’IA fait désormais partie intégrante de la plupart des programmes, qui intègrent également de plus en plus de sessions dédiées à des enjeux sociaux ou sociétaux.

Pour les signataires de l’appel lancé par l’AFUP, c’est précisément cette alliance entre technique et humain qui fait le sel des conférences spécialisées, et qui justifie que l’on se mobilise pour leur survie :

« Nous passons désormais une large partie de nos journées à échanger avec des IA. Dans ce contexte, les événements techniques prennent une valeur unique : ce sont des lieux où l’on se retrouve entre humains, où l’on partage une expertise, où de nouvelles vocations naissent, notamment autour des projets open source dont dépendent silencieusement la majorité de nos entreprises. Ces projets ont besoin de contributeurs et contributrices, de mainteneurs et mainteneuses, de relève mais aussi d’enthousiasme et d’inspiration. Les événements techniques sont l’un des rares endroits où cette relève se construit. »

De façon plus pragmatique, ils rappellent que ces conférences sont avant tout un accélérateur de compétences, nourri par la confrontation directe à des retours d’expérience, d’autres pratiques, et les échanges informels avec des pairs.

Pour autant, les organisateurs invitent les entreprises à ne pas raisonner que via le prisme du retour sur investissement. « On oublie parfois que sponsoriser un événement, c’est aussi apporter une visibilité durable et un soutien incommensurable à tout un écosystème tech local. Sans ce soutien, les événements vont tout simplement mourir. Et il n’y aura possiblement plus d’événements lorsqu’elles auront des besoins de visibilité et de recrutement », regrette Amélie Benoit.

La perte serait d’autant plus dommageable que la plupart des conférences recueillent un haut niveau de satisfaction chez les développeurs qui les fréquentent. La conjoncture impose toutefois déjà des choix. Plusieurs associations ont par exemple entrepris de basculer vers des formats plus légers, de type meet-ups mensuels, plus simples à équilibrer sur le plan financier, mais aussi moins ambitieux. « On est loin d’un format conférence où l’effervescence, les échanges et l’apprentissage varié sont au cœur des valeurs », remarque Amélie Benoit.

  •  

☕️ Le serveur multimédia Jellyfin passe en version 12.0


Destiné à la gestion d’un serveur multimédia local (hébergé par exemple sur un NAS), le projet Jellyfin passe en version 12.0.

Les amateurs de cette alternative open source (licence GPL 2.0) à Plex noteront immédiatement que cette nouvelle mouture s’accompagne d’un changement dans la numérotation adoptée. Jellyfin passe en effet d’un versionnage élaboré sous la forme « 10.11.11 » à un schéma simplifié, censé mieux refléter la publication d’une mise à jour considérée comme majeure.

Et c’est le cas pour Jellyfin 12.0. D’après les notes de version publiées par l’équipe, le logiciel serveur achève enfin les travaux de migration du modèle de données engagés un an plus tôt lors de la sortie de la précédente version majeure (la 10.11).

« L’un des changements majeurs concerne le stockage des listes de lecture et des collections. Auparavant, tous les éléments d’une liste de lecture étaient stockés dans une seule et même liste interne, et la base de données ne pouvait pas y accéder », décrit Cody Robibero, responsable de l’équipe core, serveur et plugins du projet :

« Chaque élément d’une liste de lecture correspond désormais à une ligne distincte. La base de données peut compter les lignes, afficher une seule page et ajouter ou supprimer un élément individuellement sans affecter les autres, ce qui représente une amélioration significative pour les listes de lecture volumineuses. »

Outre ces améliorations de performance, Jellyfin 12.0 passe à FFmpeg 8.1, traite maintenant les fichiers .ogg comme de l’audio, peaufine son ouverture à la gestion des livres et des bandes dessinées numériques (le plugin dédié, Bookshelf, est de ce fait maintenant déprécié) et sait désormais gérer proprement la présence de plusieurs fichiers pour un même épisode de série, comme il le faisait déjà pour les films.

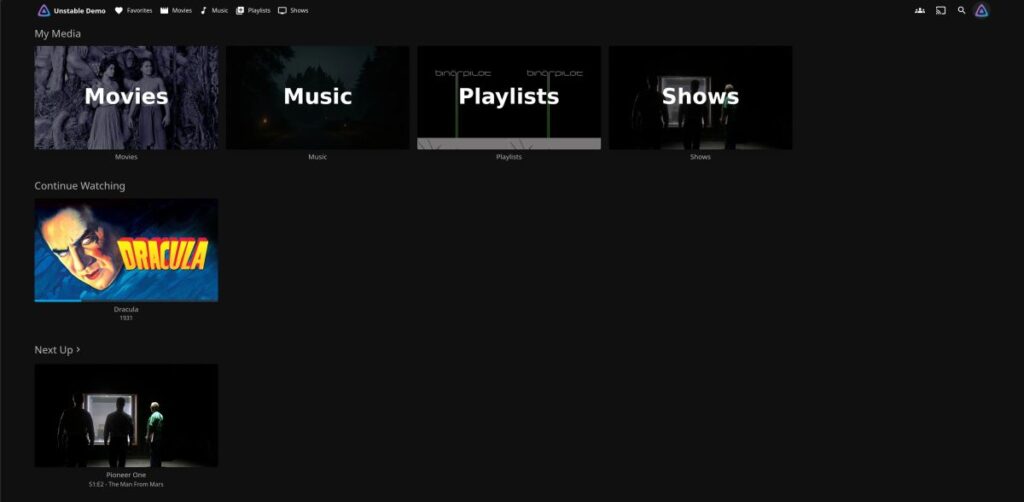
Du côté des clients, l’interface « Modern » devient l’interface par défaut sur desktop ou mobile. Elle profite elle aussi de nombreuses optimisations. L’abandon du support TLS/SSL interne, programmé pour cette version 12, a quant à lui été repoussé à une échéance ultérieure.

L’interface Modern UI est désormais proposée par défaut – crédit Jellyfin

Les notes de version complètes et les téléchargements sont disponibles sur GitHub pour le serveur et le client web. Une sauvegarde complète de la configuration existante est fortement recommandée avant d’appliquer la mise à jour, dont le processus va dépendre de la nature exacte de votre installation (paquet natif sur un NAS, conteneur Docker, etc.).

Cette mise à jour intervient alors que Plex a procédé cet été à une nouvelle hausse de tarifs, qui porte le prix de sa licence à vie à 690 euros.

  •  

[Édito] Et si on arrêtait d’introduire des chevaux de Troie dans nos foyers ?

Le chien de Pandore
[Édito] Et si on arrêtait d’introduire des chevaux de Troie dans nos foyers ?

Robots aspirateurs, tondeuses connectées, caméras, sonnettes, capteurs… le célèbre Internet des objets offre des possibilités fascinantes pour améliorer le confort du foyer au quotidien, mais il se gagne bien souvent au prix de compromis aussi inacceptables que passés sous silence en matière de sécurité et de vie privée. Le problème n’est toutefois pas inéluctable… pour peu qu’on s’en empare.

Si j’étais de mauvaise foi, je dirais que tout ça c’est la faute du chien, mais comme en vrai il n’y est pour rien, il vaut mieux que je vous explique. Il se trouve que dans la vraie vie, j’ai trois jeunes enfants très dynamiques, et depuis dix-huit mois environ, un chien. Un épagneul breton, pedigree SPA. Comme tous les épagneuls bretons, il est sympa, têtu et un brin hyperactif. C’est-à-dire qu’il pionce la moitié de la journée, mais quand il se réveille, il se transforme en tornade, et pour peu qu’une baie vitrée soit ouverte après la pluie, le parquet du salon se retrouve rapidement constellé de traces de patte.

Ajoutez à ça qu’il perd toute l’année autant de poils qu’un mammouth laineux en pleine mue, et vous comprendrez que mon sol intérieur n’est pas exactement d’une propreté clinique. Perso, j’ai un seuil de tolérance assez élevé et je trouve ce petit tapis de poils plutôt confortable sous les pieds, surtout en hiver, mais il se trouve que je partage ma vie avec quelqu’un d’un peu moins dilettante sur le sujet, et que certains enfants donnent des signes d’allergie. Accessoirement, il y a un consensus familial : tout le monde déteste passer le balai. Bref, la paix du ménage passe par l’achat d’un aspirateur robot.

Sur le principe, je n’ai rien contre. Il se trouve que cet été, j’ai déjà entrepris de connecter certains éléments de la maison, histoire de programmer l’ouverture des volets le matin, ou d’éteindre à distance les lumières laissées allumées par les enfants quand ils s’endorment le nez dans leur bouquin. Je fais ça via Home Assistant, qui tourne sur un petit serveur domestique, et comme je suis tombé dans un véritable rabbit hole, je serais ravi d’intégrer un aspirateur robot dans les automatisations en cours de construction.

Mais des principes, j’en ai quelques-uns. En matière de domotique, le premier d’entre eux consiste à protéger mordicus le caractère privé de mon foyer : tous mes équipements doivent fonctionner en local. Ça n’exclut pas des possibilités de contrôle à distance, notamment pour la sécurité, mais ces dernières doivent être strictement cantonnées aux deux adultes de la maison.

Control freak ?

Pourquoi ériger ça en principe cardinal ? Mettez ça sur le compte d’une déformation professionnelle. Sur Next et ailleurs, j’ai eu l’occasion de couvrir à de multiples reprises des incidents de sécurité impliquant des objets connectés, avec à chaque fois de graves implications potentielles en matière de vie privée. Le dernier exemple en date vient d’être publié : des failles de sécurité exposaient complètement la gamme de robots tondeuse Mammotion. Un peu plus tôt cette année, j’ai eu l’occasion de relater en détail la découverte de vulnérabilités béantes au niveau d’une infrastructure gérant des centaines de milliers de caméras IP et de babyphones connectés à l’échelle mondiale.

Impossible, faute de temps, de les traiter systématiquement, mais la rédaction voit passer presque toutes les semaines des alertes de sécurité relatives à des objets connectés du quotidien.

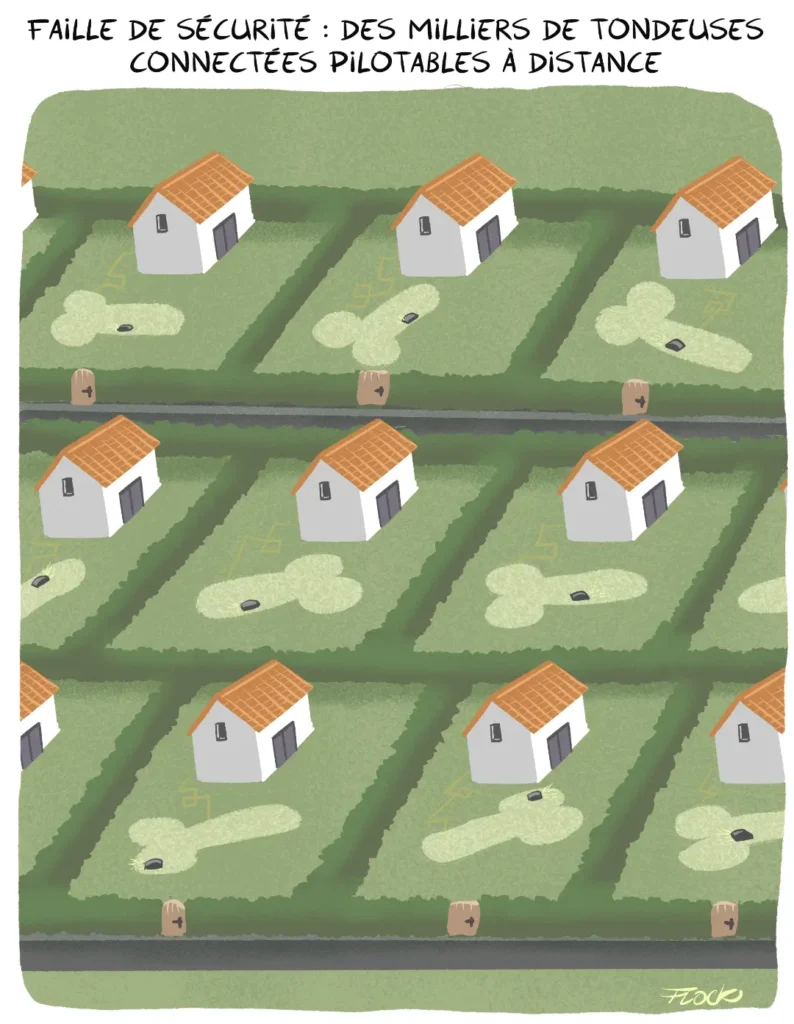
« Chéri, si tu voulais reproduire la langue des Rolling Stones avec la tondeuse, tu t’es planté ! » – Dessin : Flock

Le phénomène m’inquiète à au moins trois titres. Le premier, c’est qu’il concerne aussi bien les produits chinois premier prix que les appareils vendus à prix d’or par des marques renommées. Outre Mammotion, et ses tondeuses à 2 000 euros, vous avez peut-être vu passer en début d’année cette info selon laquelle un développeur a découvert presque par inadvertance qu’il pouvait prendre le contrôle à distance de près de 7 000 aspirateurs robots haut de gamme DJI.

Le deuxième motif d’inquiétude, c’est que les constructeurs concernés réagissent avec une diligence toute relative aux alertes. Si DJI a très vite corrigé les failles de ses robots en se coordonnant avec l’auteur de la découverte, d’autres lambinent, et mettent des semaines, voire des mois, à combler des failles pourtant béantes. L’examen des vulnérabilités en question participe de mes angoisses : on ne parle pas d’attaques sophistiquées, menées à grands coups de rootkits et de virus. Les portes sont souvent liées à des identifiants laissés en clair dans le code et à l’oubli de protections pourtant basiques dans le monde des réseaux.

Le troisième point découle du deuxième, en lien avec les possibilités offertes par l’IA. Je ne parle pas des Mythos, Fable, Atlas et autres modèles de pointe qui alimentent les discours ambigus des acteurs spécialisés en matière de cybersécurité. Non, je fais référence à un Claude ou ChatGPT courant qui, correctement interrogé, est capable en quelques prompts de disséquer le code d’une application mobile pour en identifier tous les éléments problématiques. Je dis ça en connaissance de cause, puisque je l’ai fait pour contrôler certaines des allégations relatives aux failles de sécurité mentionnées plus haut, ou pour vérifier l’histoire de ce prestataire des dispensaires de cannabis qui stockait en clair les pièces d’identité de ses clients…

Le piège de la simplicité

Dans la grande famille des objets connectés, plusieurs ont besoin de « voir » chez moi pour faire leur boulot, à commencer bien sûr par les caméras de vidéosurveillance. Les robots aspirateurs ou robots tondeuses s’y mettent aussi : pour mieux détecter leur environnement, les meubles ou les objets laissés au sol, ils s’appuient sur des batteries de capteurs, notamment optiques. Cette capacité est attendue, et bienvenue, mais elle s’accompagne d’une zone d’ombre : où sont opérés les traitements informatiques nécessaires à la détection de mouvement de la caméra, ou à l’analyse des objets observés par le robot aspirateur ?

La question n’est pas anodine. Comme beaucoup, j’ai attaqué le sujet de la vidéosurveillance chez moi avec une caméra IP Wi-Fi chopée à l’occasion d’une promo sur Internet il y a quelques années. Pour l’utiliser, je devais passer par l’application mobile du constructeur : c’est elle qui permet de recevoir les images ou les alertes à distance. Lors de l’installation, je suis passé rapidement sur les conditions d’utilisation et le parcours d’explications qui mentionnaient vaguement une possibilité de stockage dans le cloud, pressé que j’étais d’en tester le fonctionnement. C’est après coup, au moment de me connecter pour la première fois à distance à la caméra, que je me suis dit « hey, mais au fait, elles passent par où les images ? ».

Mon illumination est rhétorique : je sais très bien que ces images transitent par un serveur distant (le cloud du fabricant), qui gère ensuite l’envoi d’une alerte sur mon téléphone. Ce qui est moins évident en revanche, c’est ce qu’il advient des images ainsi envoyées : sont-elles stockées, analysées, utilisées à des fins d’entraînement, ou autre ? Et accessoirement, qui peut y accéder ? Compte tenu des nombreuses failles évoquées plus haut, il y a un risque, difficile à mesurer mais confirmé par l’expérience, que des images de mon intérieur circulent auprès de personnes malintentionnées. Bon, à la rigueur, s’il s’agit du portrait d’un cambrioleur ou de la langue pendante du chien, je m’en remettrai. Mais si ce sont mes enfants qui déclenchent la détection de mouvement, c’est une autre paire de manches. Exit la caméra premier prix.

Il se trouve que moi, comme bon nombre de lecteurs de Next sans doute, je suis sensibilisé à ces questions. Je suis aussi en mesure de circonvenir le problème. Je dispose chez moi de l’équipement nécessaire pour créer un réseau local privé, coupé d’Internet. Mes nouvelles caméras IP envoient désormais leurs images vers mon serveur domestique, sur lequel un logiciel déconnecté d’Internet, Frigate, réalise la détection de mouvement et peut, au besoin, déclencher via Home Assistant une alerte vers nos deux téléphones.

Pour un geek, cette configuration n’est pas particulièrement complexe (un routeur capable de gérer plusieurs réseaux locaux, des caméras choisies pour leur capacité à travailler en local, un serveur domestique chargé de coordonner l’ensemble), mais elle n’est pas triviale. D’abord parce qu’elle suppose une réflexion préalable, et quelques heures de paramétrage. Ensuite, parce qu’elle représente un investissement financier non négligeable, de l’ordre de quelques centaines d’euros.

Revenons-en à nos poils de chien

Revenons à nos moutons, ou plutôt à nos poils de chien. Ce n’est jamais expliqué très clairement dans les modes d’emploi, mais les aspirateurs robots fonctionnent un peu comme les caméras IP : ils disposent de commandes locales (les boutons physiques par exemple) et parfois d’intégrations dans des applications domotiques (Home Assistant, Apple HomeKit), mais le plus souvent, les fonctions avancées (détection d’objets, programmation pièce par pièce) ne sont accessibles qu’au travers de l’application mobile du fabricant, soi-disant parce qu’elles supposent des traitements réalisés à distance, sur ses propres infrastructures informatiques.

Qu’à cela ne tienne, je vais faire comme avec mes caméras : chercher un modèle d’aspirateur répondant à mes attentes (capacité à vider son bac à poussières à sa base, serpillière, gestion d’une programmation à distance pièce par pièce, cartographie de la maison pour optimiser le parcours, intégration dans Home Assistant pour éviter l’enfermement dans un écosystème propriétaire), mais avec un fonctionnement exclusivement en local, c’est-à-dire isolé d’Internet.

La démarche est aussi un enjeu de pérennité : s’il tourne uniquement en local, mon robot est à l’abri d’une éventuelle panne du cloud, ou d’une fermeture décidée arbitrairement par son fabricant (n’est-ce pas, les éditeurs de jeux vidéo ?).

Bref, deux-trois recherches sur Internet devraient bien me permettre de trouver ça ? Que nenni.

J’ai d’abord consulté quelques tests récents de médias tech, pour essayer d’isoler un ou deux robots considérés comme de bons rapports qualité-prix, sachant que je ne souhaite pas dépenser une somme à quatre chiffres pour une serpillière à roulettes. J’ai bien noté quelques références intéressantes saluées pour leur autonomie, leur aspiration ou leur gestion des obstacles, mais aucun des articles concernés n’abordait la question de la confidentialité. Seule exception : les tests et actus consacrés à l’entreprise états-unienne Matic, qui revendique une approche privacy first, mais ne distribue pas ses robots sur le Vieux Continent.

Je me suis donc tourné vers les forums et Reddit, où d’autres se sont déjà posé la même question. Et j’ai découvert, un peu surpris, qu’il n’y avait pas de solution évidente. Ou plutôt, pas de solution sans compromis.

Je vous la fais courte : la quasi-totalité des robots du marché qui disposent de fonctionnalités avancées imposent l’utilisation de l’application dédiée, et donc l’exploitation de données dans le cloud. Les fabricants présentent généralement ça comme une nécessité technique, et assurent offrir des garanties de pseudonymisation, voire des flux chiffrés, mais ils refusent que l’on coupe le cordon.

À défaut, le robot est limité à des fonctions de base (qui peuvent se révéler suffisantes mais ne répondent pas à mes attentes). Certains modèles récents affichent une compatibilité avec la norme Matter pour permettre un contrôle local natif plus étendu, en Wi-Fi ou en Thread, mais là aussi le niveau de contrôle reste limité.

Pour celui ou celle qui voudrait aller plus loin, la voie la plus complète, mais aussi la plus complexe, consiste à rooter l’appareil (remplacer son logiciel par une alternative non officielle). Plusieurs modèles courants (Dreame, Ecovacs, Roborock, Eureka) peuvent être déverrouillés au moyen du firmware Valetudo, mais la manipulation revêt plus ou moins de complexité selon les robots.

Pour certains, un simple flash via un PC sous Linux suffit. Pour d’autres, il faut intervenir physiquement sur la carte mère et donc rompre les scellés de garantie. Il y a quelque chose d’assez satisfaisant dans le fait de voir qu’une initiative particulière permet de court-circuiter le verrouillage orchestré par toute une industrie, mais celle-ci n’est valable que sur certains modèles (et parfois même uniquement sur certaines générations d’un modèle donné), et la manipulation a de quoi refroidir bon nombre d’utilisateurs néophytes.

Si l’on écarte cette piste « expert », l’acquéreur potentiel de robot aspirateur se retrouve confronté à trois choix : accepter de laisser ses données circuler vers un cloud extérieur, tirer un trait sur une partie des fonctionnalités associées, ou tout simplement continuer à passer l’aspirateur à la main. En ces temps qui imposent de réfléchir à l’impact environnemental de la tech, la dernière n’est probablement pas la plus mauvaise des solutions.

Reste que si l’on souhaite tout de même s’équiper, l’industrie nous place face à un choix cornélien : fonctions avancées ou vie privée ? De mon côté, je sais que je ne transigerai pas. Je me prépare donc soit à chercher un robot à prix raisonnable susceptible de passer par la case Valetudo, soit à compromettre les relations diplomatiques familiales en opposant mon veto au robot.

De la nécessité d’informer correctement

Chacun prend bien les risques qu’il souhaite, tant qu’il les a correctement soupesés. Avant de m’équiper plus sérieusement, j’ai utilisé pendant quelques semaines mes caméras connectées avec la Chine, parce qu’elles me rendaient un service dont j’estimais avoir besoin, mais je l’ai fait de façon précautionneuse, en veillant à n’activer les appareils que quand la maison était vide de tout occupant.

Ce qui m’ennuie, et motive en réalité ce long laïus, ce sont tous les utilisateurs d’objets connectés qui acceptent tacitement d’exposer leur vie privée à un risque parce qu’on ne leur a pas expliqué la nature du risque en question. J’ai posé quelques questions naïves à des gens de mon entourage ces dernières semaines, en mode : « Au fait, tu es sûr que c’est sécurisé ton robot ? Il a quand même une caméra et des fonctions qui permettent d’en prendre le contrôle à distance ? ». Dans certains cas, j’ai eu droit à des retours de type : « Ho ben oui, l’application est sur mon téléphone protégé par mot de passe, donc c’est sûr ».

Mauvaise réponse :/

La situation n’a cependant rien d’inéluctable.

Du côté des particuliers, il me semble primordial de sensibiliser sans relâche sur le sujet, et c’est bien sûr l’objectif premier de cet édito. Je prêche probablement des convaincus parmi les lecteurs assidus de Next, mais puisse ce texte contribuer à informer des internautes moins au fait des subtilités techniques de nos objets connectés.

Je profite de l’occasion pour en appeler à mes consœurs et confrères de la presse : bon nombre de médias consacrent d’innombrables news, tests et bons plans relatifs aux aspirateurs robots. Pourquoi ne pas intégrer à vos revues un paragraphe et des éléments de notation spécifiques au respect de la vie privée et à la confidentialité des données ? Vos tests y gagneraient en qualité, et n’y perdraient probablement pas tant que ça en conversion vers des liens affiliés.

Le dernier message s’adresse aux fabricants, avec un premier appel évident : quand allez-vous enfin prendre le mors aux dents et faire une passe complète d’audits sur vos outils afin d’en améliorer la sécurité ? Au-delà de cette simple mesure de bon sens, vous avez une carte à jouer en proposant des produits intelligents, mais véritablement respectueux de la vie privée. Plutôt que de simplement respecter a minima les exigences du RGPD ou du futur Cyber Resilience Act (CRA), faites de la confidentialité un argument commercial.

Si vous ne le faites pas pour vous, faites-le pour la paix de mon ménage !

  •  

Autistici/Inventati annonce sa dissolution, et la fermeture prochaine de ses services

Extinction du domaine de la lutte
Autistici/Inventati annonce sa dissolution, et la fermeture prochaine de ses services

Onze jours après avoir été désigné comme organisation terroriste par l’administration Trump, le collectif hacktiviste d’origine italienne Autistici/Inventati a annoncé mettre un terme à ses activités. Il explique ne plus pouvoir garantir la sécurité de ses membres, mais aussi des utilisateurs de ses services de messagerie ou d’hébergement, qui fermeront bientôt. Dans toute l’Europe, associations et mouvements en faveur des libertés numériques alertent sur cette attaque sans précédent contre un hébergeur alternatif.

Autistici/Inventati (A/I) baisse le rideau. Le collectif, né en Italie, désigné le 26 août dernier comme organisation terroriste par l’administration Trump, affirme ne pas pouvoir être en mesure de garantir la sécurité de ses membres, mais aussi des utilisateurs de ses services. « A/I ferme ses portes. Le collectif Autistici/Inventati cesse ses activités et interrompra prochainement tous les services qu’il propose », explique-t-il dans un billet daté du 6 septembre.

Un revirement soudain

Depuis le 26 août, il affichait pourtant sa volonté de résister face à cette désignation, qui a entraîné le gel, via DNS, du nom de domaine de son site principal, autistici.org, puis la suspension de son compte PayPal, et la résiliation des services financiers que lui prodiguait sa banque italienne, Banca Etica.

Le 2 septembre, Autistici/Inventati avait ainsi lancé un nouveau site, keepitfree.ai, pensé spécifiquement pour servir de point de liaison entre le collectif, ses utilisateurs et ses soutiens. Il y rappelait que même si A/I ne peut pas être qualifié de structure « neutre », en raison de son orientation idéologique assumée, la structure n’avait jamais été condamnée pour un quelconque crime, que ce soit aux États-Unis ou en Italie.

Quatre jours plus tard, changement de ton. « La possibilité que notre travail puisse avoir des conséquences juridiques et financières pour nos proches – ou même pour ceux qui ont simplement un lien avec nous – ne nous laisse pas le choix. Chaque jour passé en ligne après le 26 août 2026 a été une victoire, mais nous sommes maintenant contraints d’arrêter », écrit A/I dans le billet qui annonce sa dissolution.

Le collectif annonce dans le même temps la fermeture prochaine de ses services, à commencer par la messagerie autistici.org et la plateforme noblogs.org, et suggère à leurs utilisateurs de prendre les devants en sauvegardant leurs données :

« Nous vous enverrons prochainement des instructions pour sauvegarder le contenu de vos blogs, boîtes mail et sites web, ainsi que des recommandations plus techniques. Cependant, gardez à l’esprit que, tout comme le domaine autistici.org est devenu inaccessible sans préavis, nous pourrions rencontrer des problèmes similaires et imprévisibles dans les prochains jours. »

De nombreux soutiens affichés

L’annonce de la disparition d’A/I intervient alors que de nombreuses structures, associations et collectifs engagés en faveur de la liberté d’expression sur Internet, ont affiché leur soutien explicite. Outre la lettre ouverte de Sabot Media cosignée par Framasoft et la Quadrature du Net entre le 31 août et le 1er septembre, une trentaine d’organisations ont donné de la voix au travers d’une tribune publiée le 3 septembre par le réseau European Digital Rights (EDRi).

Tous dénoncent une attaque d’une gravité sans précédent contre le principe même de neutralité des infrastructures, et le risque que fait peser la sanction des États-Unis sur tous les fournisseurs de services alternatifs aux acteurs commerciaux dominants.

« Cette décision déplace la responsabilité des actes commis par les hébergés sur les hébergeurs. Et quand la menace qu’on fait peser sur toi est celle d’être qualifié d’organisation terroriste internationale, ce n’est pas la même chose qu’une fermeture administrative, ou qu’une réquisition de la police. Ici, la sanction est d’une violence extrême », analyse Pierre-Yves Gosset, coordinateur des services numériques de l’association Framasoft, initiatrice du Collectif des hébergeurs alternatifs, transparents, ouverts et solidaires (Chatons).

Le renoncement d’A/I parait, dans ce contexte, compréhensible. « Même si tu restes vindicatif, c’est difficile de te dire que tu vas te battre avec des cure-dents contre un porte-avion. Le rapport de force qui se met en place, une fois désigné comme organisation terroriste internationale, est intenable, donc il vaut sans doute mieux jouer la fluidité, quitte à renaître ailleurs », estime Pierre-Yves Gosset, qui rappelle les conséquences de la vindicte états-unienne sur la vie personnelle et la famille du juge Guillou, littéralement coupé de tout un pan de sa vie numérique en raison d’un décret signé par Donald Trump.

Outre le coup de boutoir frontal que constitue cette désignation comme organisation terroriste internationale, A/I subit également des assauts par la bande. Fin août, le collectif indiquait que sa plateforme noblogs.org, notoirement connue pour héberger des blogs de mouvements antifa parfois adeptes de la désobéissance civile, avait fait l’objet d’attaques informatiques, qui s’étaient traduites par le défaçage, pendant quelques heures, de sa page d’accueil.

Prévenir l’hypothèse du kill switch

Quelques jours plus tard (et sans qu’un lien direct avec la cyberattaque ait été établi), le site militant pro-Trump Datarepublican a publié une cartographie des 7 673 sites hébergés par noblogs. « NoBlogs, la tristement célèbre infrastructure antifa mondiale, sera fermée. Mais n’ayez crainte, les autorités détiennent tout le contenu, et nous le conserverons en mémoire sur TrumpBlogs », ironise sur X l’instigatrice de la plateforme.

Qu’adviendra-t-il des utilisateurs des services opérés jusqu’ici par A/I ? L’ONG norvégienne Electronic Forpost Norge (EFN) a annoncé dimanche qu’elle reprendrait une partie de l’infrastructure précédemment gérée par le collectif d’origine italienne. Les autres internautes qui cherchent des moyens de communication garantissant l’anonymat, ou l’alternative aux grands outils états-uniens, devront quant à eux trouver une nouvelle crèmerie, peut-être moins facilement identifiable que ne l’était A/I, dont les 25 ans d’histoire ont été émaillés de quelques coups d’éclat.

L’action contre Autistici/Inventati fait quoi qu’il en soit peser un risque nouveau sur les hébergeurs alternatifs qui, même sans afficher de coloration politique particulière, prennent le précédent très au sérieux. « C’est peut-être le point positif de cette histoire. Elle nous oblige à nous poser des questions, à réévaluer notre modèle de menaces et à anticiper la façon dont on répondrait si on était concernés », remarque Pierre-Yves Gosset.

  •  

Failles chez Mammotion : des milliers de robots tondeuses étaient contrôlables à distance

Christine de Stephen King, version tondeuse à gazon
Failles chez Mammotion : des milliers de robots tondeuses étaient contrôlables à distance

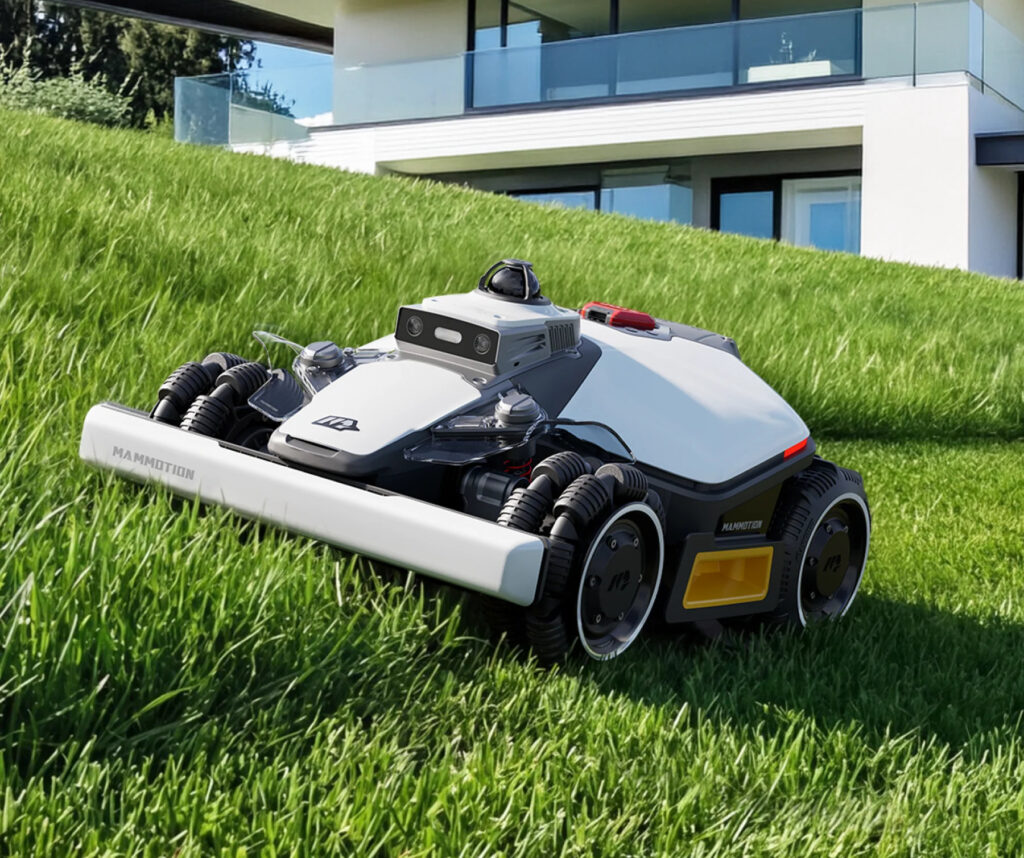
Trois chercheurs indépendants en cybersécurité ont découvert 14 failles de sécurité critiques au sein de l’infrastructure qui sous-tend le fonctionnement des robots tondeuses Mammotion. Elles exposaient potentiellement jusqu’à 337 000 comptes utilisateurs, ouvraient l’accès aux infos des réseaux connectés, et permettaient accessoirement la prise de contrôle à distance.

Un gazon sans doute coupé au cordeau, mais une véritable porte ouverte sur le jardin. Trois chercheurs en cybersécurité se sont penchés sur l’application mobile fournie par Mammotion pour le pilotage de ses robots tondeuses.

Ils y ont découvert comment accéder en seulement deux requêtes à un compte admin branché sur l’infrastructure cloud qui en sous tend les fonctions connectées. De là, les failles se sont enchaînées, jusqu’à représenter un total de 14 vulnérabilités, présentées dans un rapport dédié.

Des robots ouverts aux quatre vents

À l’appui de leurs travaux, les trois chercheurs, Sammy Azdoufal (@n0tsa), Andreas Makris (@Bin4ryDigit) et Kevin Finisterre (@d0tslash), ont réalisé une attaque par piratage de compte sur un robot tondeuse détenu en propre. Ils revendiquent une prise de contrôle quasi totale, avec possibilité de piloter le robot à distance et visualiser les images transmises par la caméra.

Image : Mammotion

S’ils affirment ne pas avoir avoir parcouru l’ensemble des services cloud exposés, ils donnent un aperçu de la surface potentielle de l’attaque, estimée à 337 000 comptes utilisateurs énumérables sans authentification, répartis sur quatre serveurs régionaux, dont un serveur EU servant 85 pays, avec une « forte concentration en Allemagne, France et Suède ». Sammy Azdoufal, qui avait déjà mis au jour les failles de sécurité béantes des babyphones et caméras IP Meari et dix CVE dans des produits connectés Aqara, précise à Next qu’environ 49 000 comptes correspondent à des utilisateurs français.

Pour chaque appareil, l’accès découvert donnait selon eux la possibilité d’interroger le robot à distance et d’en faire remonter, sans vérification de propriété, les informations réseau telles que les coordonnées GPS, l’adresse IP sur le réseau local, l’adresse MAC, ou l’IMEI de la connexion mobile, mais aussi le SSID du Wi-Fi domestique, et le numéro IMSI de la carte SIM utilisée pour les communications en cas d’absence de Wi-Fi.

Les chercheurs affirment par ailleurs avoir pu énumérer 46 785 stations RTK dont les clés de chiffrement RSA-2048 étaient récupérables sans vérification de propriété. Ces stations sont un accessoire commercialisé par Mammotion (et d’autres fabricants) pour offrir une référence de positionnement plus précise que celle du GPS et donc améliorer la capacité du robot tondeuse à s’orienter dans le jardin ou respecter les instructions de tonte.

« La flotte RTK européenne de Mammotion fonctionne avec des cartes SIM M2M d’Orange France. Chaque station de base équipée d’un module 4G (IMSI 208012xxxxxxx) transmet des données d’identité cellulaire à tout utilisateur authentifié de l’application », affirment à ce sujet les chercheurs.

Si les données GPS d’un robot individuel suffisent pour localiser son emplacement, les chercheurs suggèrent, sans l’affirmer explicitement, que l’exposition de cette infrastructure de communication mobile ouvrait la voie à des attaques à plus grande échelle.

Une communication assez limitée

La première et peut-être la plus inquiétante découverte tient à la façon dont les chercheurs ont pu accéder au cloud de Mammotion. D’après leur rapport, le fabricant référençait dans son application un endpoint (un point de terminaison pour se connecter à l’infra) lié à son serveur situé en Chine qui retournait, sans authentification ou token préalable, un mot de passe à usage unique (on parle de code OTP, pour One-Time Password), qui en réalité n’expirait pas.

Ce code à usage unique est lié à la récupération en cas de mot de passe oublié. Pour un utilisateur lambda, il faut en principe une demande de réinitialisation pour que ce code soit généré, puis reconnu au niveau du endpoint. « Pour admin@mammotion.com, la situation était différente. L’administrateur n’avait apparemment jamais déclenché sa propre procédure de mot de passe oublié ; son code OTP enregistré n’avait donc ni durée de vie ni renouvellement. Il était juste là », décrivent les trois auteurs, avant de résumer : « Deux requêtes HTTP non authentifiées et vous possédez le compte administrateur Mammotion ».

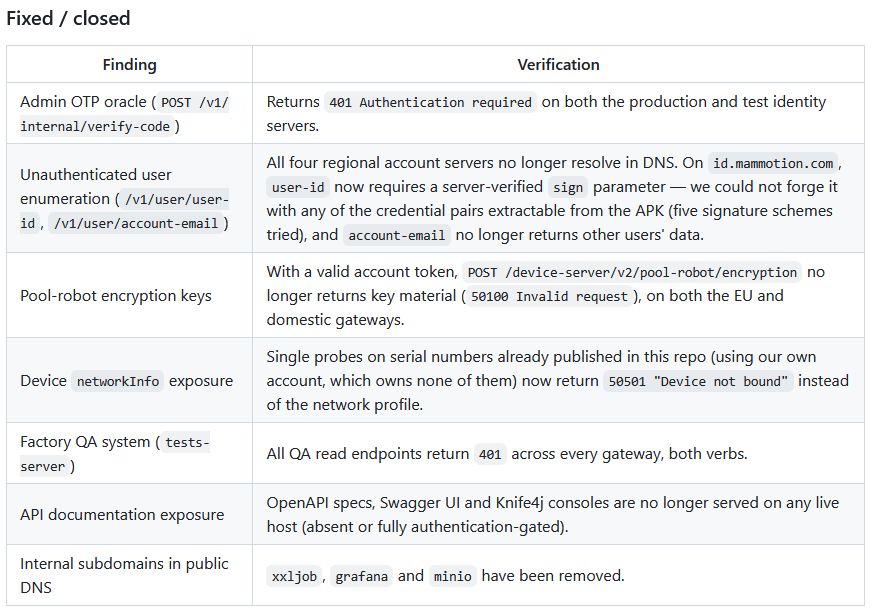
Les vulnérabilités corrigées par Mammotion selon les trois chercheurs – capture d’écran

Le dépôt GitHub créé pour l’occasion liste également les échanges par écrit entre les trois chercheurs et les services techniques de Mammotion. La conversation achoppe principalement sur des questions de forme, peut-être motivées par le passif de Kevin Finisterre avec la marque, quelques années plus tôt. Ce dernier s’était en effet inquiété de voir un service SSH tourner sur son robot, et avait donc demandé à la marque le mot de passe permettant de s’y connecter pour investiguer le sujet. Il s’était vu opposer une fin de non recevoir.

D’après la transcription publiée dans ce rapport, Mammotion indique avoir pris en compte les remarques des chercheurs et implémenté des « mesures de protection » adaptées. Affirmant travailler avec des institutions externes dédiées à la sécurité, elle a en revanche refusé d’ouvrir un canal technique avec les intéressés qui réclamaient la mise en place d’un processus de divulgation responsable. Elle ne livre par ailleurs aucune réponse sur le fond, mais a tout de même fini par corriger les failles les plus sérieuses. C’est ce constat qui a conduit les trois auteurs à publier leur rapport, daté du 21 août et mis en ligne sur GitHub le 24 août dernier.

Leurs conclusions relèvent d’ailleurs que trois problèmes restent en suspens : un secret codé en dur dans un élément JavaScript public, un processus d’auto-enregistrement de clients avec une adresse de redirection arbitraire ouvrant, par exemple, la voie à des tentatives de phishing, et des sous domaines internes résolus via des DNS publics.

Sur sa page de support, Mammotion s’engage à assurer des mises à jour de sécurité continues pour tous ses produits pendant les cinq ans qui suivent leur mise sur le marché. Contactée par nos soins le 24 août et relancée depuis, l’entreprise n’a pas répondu à nos questions.

  •  

☕️ Google lance Gemini 3.8 Flash et sa déclinaison Cyber


Troisième sortie en seulement six semaines pour Google : la firme de Mountain View vient en effet de déployer la version 3.8 de son modèle Gemini Flash, la famille censée offrir le meilleur rapport entre rapidité et coût de traitement des requêtes. Cette nouvelle mouture succède aux versions 3.6 et 3.7, mises en ligne à trois semaines d’intervalle.

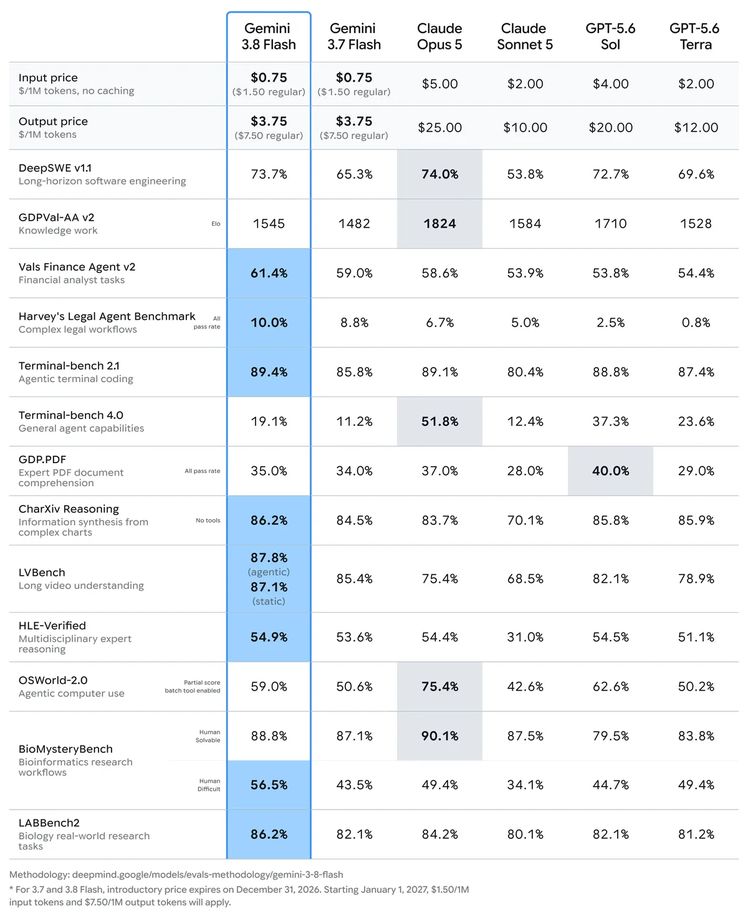
Gemini 3.8 Flash est présenté comme le meilleur workhorse model de Google, c’est-à-dire un modèle dédié à des tâches utilitaires. Et d’après les benchmarks publiés par l’entreprise, il tiendrait la route face à des modèles dits frontière. Elle revendique ainsi un score de 73,7 % sur le test DeepSWE, qui mesure les performances en développement logiciel avancé, contre 74 % pour Opus 5 chez Anthropic et 72,7 % chez OpenAI avec GPT-5.6 Sol.

En développement agentique (missions de code autonomes dans le terminal), Gemini 3.8 Flash se paierait même le luxe de dépasser d’un cheveu Opus 5. Google revendique également des performances en hausse sur les tâches liées à la finance, au monde du droit, à l’interprétation de documents complexes (principalement scientifiques) ou à la recherche en biologie.

Comparaison entre Gemini Flash 3.8, son prédécesseur 3.7 et plusieurs modèles concurrents – source Google

Sur les tâches complexes impliquant du raisonnement ou une subdivision, Google prévient toutefois que le gain de performances promis avec Gemini 3.8 Flash se fait au prix d’une consommation plus élevée de tokens :

« Ces gains de performance découlent d’un choix de conception fondamental : Flash 3.8 travaille davantage. Sur les tâches complexes, il fait preuve d’une plus grande rigueur, en exécutant des étapes de raisonnement supplémentaires et en appelant les outils de manière itérative. Le modèle peut parfois utiliser plus de jetons pour optimiser les performances, notamment lorsque le niveau d’effort est élevé. »

Gemini 3.8 Flash est dès à présent disponible au travers des canaux courants d’IA chez Google, en API ou au travers de l’application Gemini pour les souscripteurs d’un forfait Google AI Pro ou Ultra. Pour ces derniers, c’est également lui qui sous-tend les Aperçus IA intégrés par le moteur à ses résultats de recherche.

Google affiche une tarification agressive pour le lancement, avec 0,75 dollar par million de tokens en entrée et 3,75 dollars par million de tokens en sortie. Ce prix n’est cependant valable que jusqu’au 31 décembre, date à laquelle la facturation se fera sur une base fixée à 1,50 / 7,50 dollars par million de tokens.

Google déploie dans le même temps la variante Cyber de son nouveau modèle, dotée de capacités spécifiques au monde de la cybersécurité. L’accès à ce dernier est cependant réservé aux organisations et entreprises enregistrées dans le programme Fairwind.

  •  

Un service pirate permettait de consulter 153 millions de permis de conduire américains

Tous dans la même passoire
Un service pirate permettait de consulter 153 millions de permis de conduire américains

L’ancien journaliste spécialisé dans la cybersécurité Bryan Krebs raconte comment il a découvert un service illégal donnant accès à la bagatelle de 153 millions de permis de conduire enregistrés aux États-Unis et au Canada. Ses recherches indiquent que les données semblent avoir été extraites depuis les systèmes d’un prestataire spécialisé dans la vérification d’identité. Le FBI a lancé une enquête.

N’en déplaise aux Cassandre, voilà une découverte qui rappelle que la problématique des fuites de données n’est pas exclusive à la France. Bryan Krebs, ancien journaliste reconverti dans le conseil en cybersécurité, vient ainsi de raconter comment il a découvert la mise à disposition, via un outil dédié baptisé Nexus, d’un jeu de données revendiquant quelque 170 millions de documents d’identité provenant des États-Unis et du Canada. L’outil était mis à disposition au travers d’un forum russe dédié à la revente de données, et semble avoir été placé hors ligne suite à la divulgation de son existence.

Un guichet ouvert sur 153 millions de permis de conduire

Krebs explique avoir été alerté lundi 31 août par une source qui, pour faire bonne mesure, lui a transmis une capture d’écran des informations relatives à son propre permis de conduire. Dans la foulée, il accède à l’outil. D’après les résultats de recherche retournés par ce dernier, la base de données afférente listait donc 153 millions de permis de conduire, mais aussi 10 millions de cartes d’identité, près de 2 millions de documents de voyage, et près de 600 000 cartes médicales.

Le chercheur remarque, au fil de ses investigations, que les compteurs ne cessent de s’incrémenter, ce qui laisse supposer une base alimentée en continu, et donc une source de données qui ne s’est pas tarie. Il affirme ainsi avoir constaté l’ajout de 400 000 nouveaux permis de conduire sur une fenêtre de 24 heures.

Une dynamique confirmée par les auteurs de l’outil. Sur l’annonce qui présente leurs services, ils affirment ainsi : « Depuis plus d’un an, nous enrichissons continuellement notre base de données privée avec de nouvelles données », selon les propos rapportés par Krebs.

D’où viennent les données en question ? L’ancien journaliste indique avoir sollicité douze de ses contacts en leur demandant l’autorisation de vérifier si leurs documents figuraient dans la base. La recherche a retourné des résultats positifs pour neuf d’entre eux.

Après recoupements, Bryan Krebs associe la présence de leurs documents à des voyages récents, et notamment à des locations de voiture chez Hertz, mais pas uniquement. C’est le cas par exemple d’un autre chercheur en cybersécurité alerté par ses soins, selon qui les captures visibles via Nexus et l’horodatage associé correspondent à une location de voiture lors de vacances récentes. Zach Edwards, un autre chercheur en cybersécurité sur lequel Krebs a mené une recherche fructueuse, indique n’avoir fourni son permis de conduire qu’à l’enregistrement dans un hôtel de Las Vegas et à l’entrée d’un dispensaire de cannabis à l’occasion d’un déplacement à la Defcon.

Identifier le single point of failure

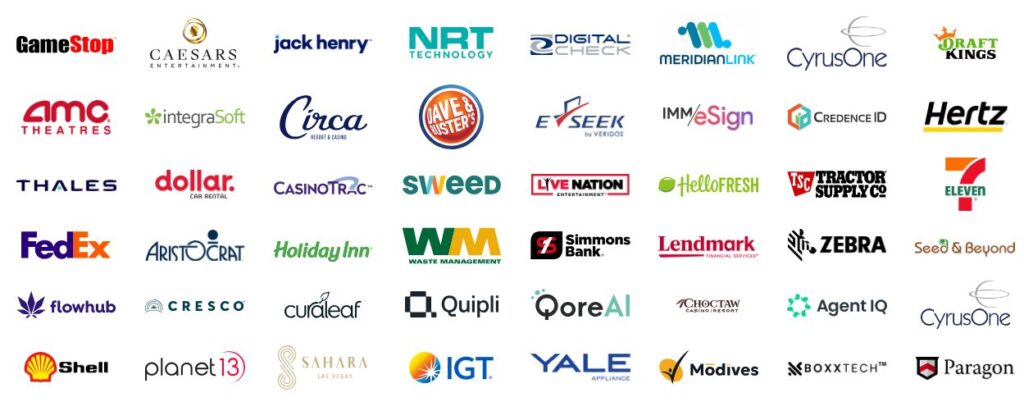
De fil en aiguille, Bryan Krebs trouve le point commun aux différents services concernés : un prestataire états-unien spécialisé dans la vérification d’identité, IDScan, qui se présente comme le leader dans la lutte contre la fraude aux fausses pièces d’identité, et revendique une longue liste de clients, dont Hertz et la chaîne de dispensaires concernée, mais aussi FedEx, plusieurs constructeurs automobiles, Shell et sans doute d’autres acteurs du monde du transport dont le nom reste confidentiel. Contactée par ses soins, l’entreprise n’a pour l’instant pas commenté ou confirmé la possibilité d’une fuite de données.

Un aperçu des clients revendiqués par IDScan sur son site Web – capture d’écran Next

Le sujet a, quoi qu’il en soit, très vite attiré l’attention du FBI. Bryan Krebs raconte avoir été ajouté à une conférence téléphonique avec plusieurs agents spécialisés dans la cybercriminalité du Bureau. « Ils ont probablement été mis au courant lorsque j’ai révélé à une source fiable que Nexus vendait également les informations relatives au permis de conduire du directeur adjoint du FBI (je n’ai pas trouvé le permis de conduire du directeur du FBI, Kash Patel, sur Nexus) », glisse-t-il.

Reste à voir quelle sera la réponse apportée par ID Scan, et sous quel délai l’accès temps réel aux données sera coupé ? Un commentaire laissé sous le billet de Krebs laisse entendre que l’entreprise a commencé à alerter ses clients entreprise mercredi 2 septembre, sans qu’il soit possible à ce stade de vérifier la légitimité du message.

  •  
❌