❌

Vue lecture

Google combine Android, ChromeOS et Gemini pour les portables Googlebook

Chromebook avec une moustache
Google combine Android, ChromeOS et Gemini pour les portables Googlebook

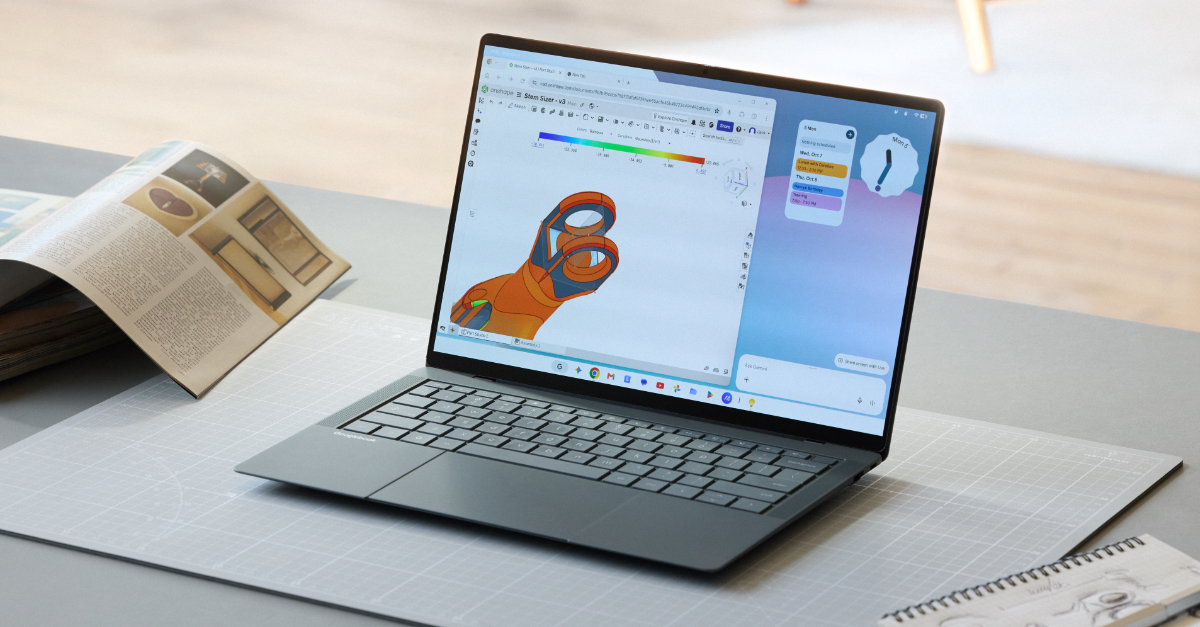
Après avoir échoué à imposer le Chromebook auprès du grand public – même si ces appareils restent populaires dans certains marchés comme celui de l’éducation –, Google remet donc une pièce dans la machine avec sa toute nouvelle famille Googlebook. Des portables fabriqués par des constructeurs partenaires, fonctionnant sur un système d’exploitation qui combine ChromeOS à Android, avec une bonne rasade d’IA par-dessus, le tout à des prix dignes d’un MacBook Air, à partir de 1 099 euros : c’est le pari du géant du web.

Google retente sa chance dans le secteur du portable. Après une première présentation mi-mai, le géant du web lance les premiers Googlebook et cette fois, pas question de vendre des machines au rabais comme le furent les premiers Chromebook. Ces appareils émargent dans la catégorie « haut de gamme », selon les propres mots de Google, avec des prix à l’avenant.

x86 ou Arm, pas de jaloux

Acer, Asus, Dell, HP et Lenovo sont les constructeurs partenaires de ce lancement, avec des modèles qui débutent à 1 099 euros. Au menu : « matériaux premium » (aluminium, alliage de magnésium, fibre de carbone), écrans tactiles OLED 2,8K pour les mieux dotés, trackpad en verre avec retour haptique ou mécanique, clavier rétroéclairé, barre lumineuse discrète sur le capot.
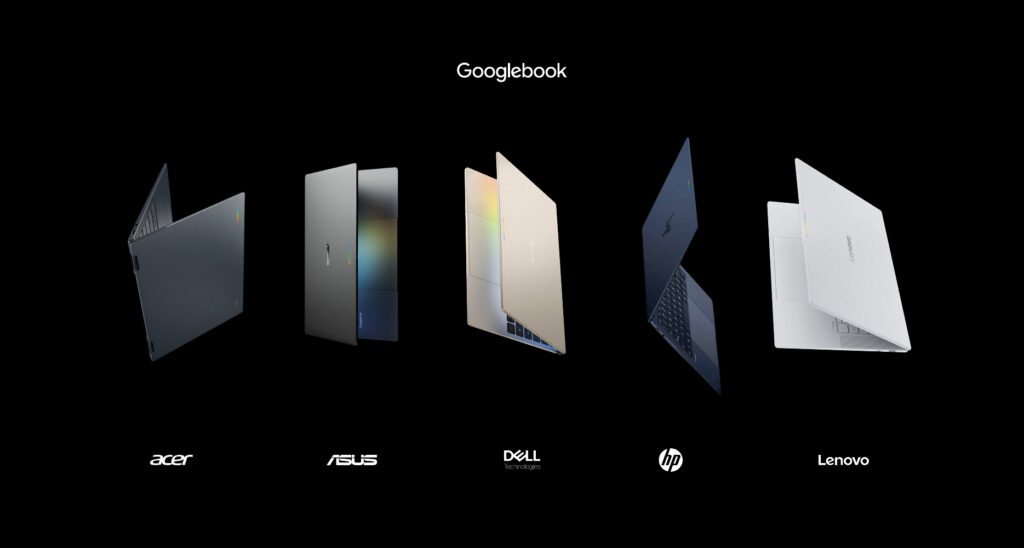
Sous le capot, les Googlebook ont le choix entre une puce Intel (Core Ultra Series 3 Panther Lake) et une puce Qualcomm (Snapdragon X Elite) ; des modèles avec du silicium MediaTek sont également prévus. Ils embarquent de 16 à 32 Go de mémoire unifiée, et de 256 Go à 1 To de stockage.

Il s’agit d’ordinateurs portables dans tous les cas (le Googlebook 14 d’Acer peut se transformer en tablette), mais d’autres formats ne sont pas exclus à l’avenir. Rick Osterloh, vice-président de Google en charge du matériel et des services, évoque rapidement chez The Verge la possibilité d’autres designs, et pourquoi pas des ordinateurs de bureau. L’équipe qui en interne s’occupe de la gamme Pixel pourrait proposer son propre Googlebook.

C’est surtout sur la partie logicielle que la gamme Googlebook sort du lot. Le système d’exploitation, baptisé Googlebook OS (pourquoi faire compliqué) repose sur un socle partagé entre ChromeOS et Android. L’idée générale est qu’un utilisateur de smartphone Android se sente comme chez lui sur un Googlebook.
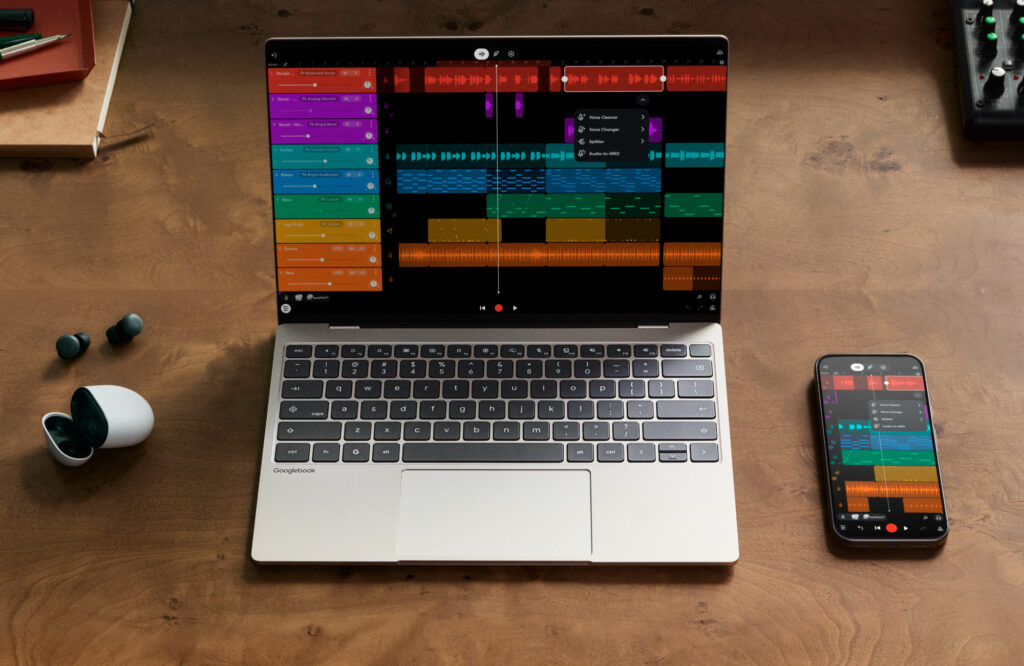
Image : Google

Ainsi, les paramètres Android, les mots de passe, les réseaux Wi-Fi et les messages sont synchronisés entre le portable et le téléphone. Une fonction de continuité permet de passer d’un appareil à l’autre et inversement. Google n’invente rien ici : les utilisateurs d’iPhone et de Mac connaissent ce type de fonctionnement transparent depuis des années.

Un petit air d’Apple

Les Googlebook ont accès au Play Store, donc à des millions d’applications Android et Google promet qu’ « un grand nombre est optimisé pour les grands écrans, le clavier et la souris ». L’entreprise évoque des logiciels comme Photoshop et Lightroom, mais il s’agit des versions mobiles.

Les jeux Android sont de la partie évidemment, tout comme le service GeForce Now de streaming de jeux. Il est aussi possible de projeter une app depuis son smartphone vers le portable, et d’accéder aux fichiers et documents stockés sur le téléphone ; il apparait en fait tout simplement dans la fenêtre de l’explorateur de fichiers.
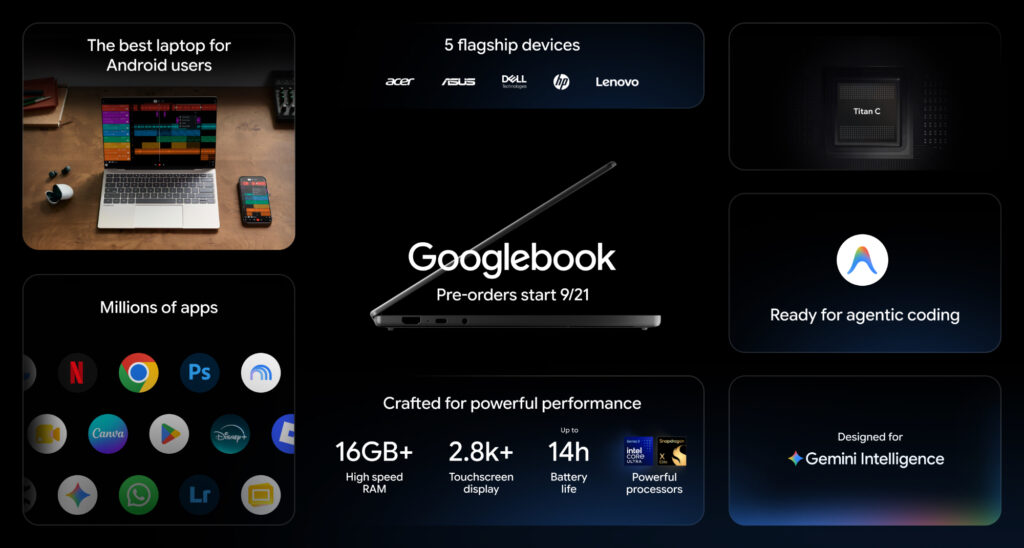
Googlebook a été « conçu pour Gemini Intelligence » – image : Google

L’autre grande affaire des Googlebook est l’intégration profonde de Gemini. Les portables intègrent un NPU jusqu’à 45 TOPS, de quoi leur assurer le traitement en local de fonctions d’IA regroupées sous la bannière « Gemini Intelligence ». Google met en avant le « Pointeur magique » qui permet à Gemini d’interagir avec le contenu affiché à l’écran en secouant le curseur de la souris.

Une fonction de dictée améliorée met en forme les mémos vocaux pour être partagés par écrit. Le bureau du Googlebook pourra être personnalisé avec des widgets créés par l’utilisateur. Les Googlebook intègrent également Antigravity, la plateforme maison qui permet de concevoir des agents IA et déployer des applications depuis la machine.

Les précommandes ont débuté auprès des distributeurs français, pour une disponibilité le 5 octobre. Pour l’occasion, Google livre 12 mois d’abonnements à sa formule IA Pro, 5 To de stockage en ligne, et surtout dix ans garantis de mises à jour logicielles.
  •  

Google combine Android, ChromeOS et Gemini pour les portables Googlebook

Chromebook avec une moustache
Google combine Android, ChromeOS et Gemini pour les portables Googlebook

Après avoir échoué à imposer le Chromebook auprès du grand public – même si ces appareils restent populaires dans certains marchés comme celui de l’éducation –, Google remet donc une pièce dans la machine avec sa toute nouvelle famille Googlebook. Des portables fabriqués par des constructeurs partenaires, fonctionnant sur un système d’exploitation qui combine ChromeOS à Android, avec une bonne rasade d’IA par-dessus, le tout à des prix dignes d’un MacBook Air, à partir de 1 099 euros : c’est le pari du géant du web.

Google retente sa chance dans le secteur du portable. Après une première présentation mi-mai, le géant du web lance les premiers Googlebook et cette fois, pas question de vendre des machines au rabais comme le furent les premiers Chromebook. Ces appareils émargent dans la catégorie « haut de gamme », selon les propres mots de Google, avec des prix à l’avenant.

x86 ou Arm, pas de jaloux

Acer, Asus, Dell, HP et Lenovo sont les constructeurs partenaires de ce lancement, avec des modèles qui débutent à 1 099 euros. Au menu : « matériaux premium » (aluminium, alliage de magnésium, fibre de carbone), écrans tactiles OLED 2,8K pour les mieux dotés, trackpad en verre avec retour haptique ou mécanique, clavier rétroéclairé, barre lumineuse discrète sur le capot.

Sous le capot, les Googlebook ont le choix entre une puce Intel (Core Ultra Series 3 Panther Lake) et une puce Qualcomm (Snapdragon X Elite) ; des modèles avec du silicium MediaTek sont également prévus. Ils embarquent de 16 à 32 Go de mémoire unifiée, et de 256 Go à 1 To de stockage.

Il s’agit d’ordinateurs portables dans tous les cas (le Googlebook 14 d’Acer peut se transformer en tablette), mais d’autres formats ne sont pas exclus à l’avenir. Rick Osterloh, vice-président de Google en charge du matériel et des services, évoque rapidement chez The Verge la possibilité d’autres designs, et pourquoi pas des ordinateurs de bureau. L’équipe qui en interne s’occupe de la gamme Pixel pourrait proposer son propre Googlebook.

C’est surtout sur la partie logicielle que la gamme Googlebook sort du lot. Le système d’exploitation, baptisé Googlebook OS (pourquoi faire compliqué) repose sur un socle partagé entre ChromeOS et Android. L’idée générale est qu’un utilisateur de smartphone Android se sente comme chez lui sur un Googlebook.

Image : Google

Ainsi, les paramètres Android, les mots de passe, les réseaux Wi-Fi et les messages sont synchronisés entre le portable et le téléphone. Une fonction de continuité permet de passer d’un appareil à l’autre et inversement. Google n’invente rien ici : les utilisateurs d’iPhone et de Mac connaissent ce type de fonctionnement transparent depuis des années.

Un petit air d’Apple

Les Googlebook ont accès au Play Store, donc à des millions d’applications Android et Google promet qu’ « un grand nombre est optimisé pour les grands écrans, le clavier et la souris ». L’entreprise évoque des logiciels comme Photoshop et Lightroom, mais il s’agit des versions mobiles.

Les jeux Android sont de la partie évidemment, tout comme le service GeForce Now de streaming de jeux. Il est aussi possible de projeter une app depuis son smartphone vers le portable, et d’accéder aux fichiers et documents stockés sur le téléphone ; il apparait en fait tout simplement dans la fenêtre de l’explorateur de fichiers.

Googlebook a été « conçu pour Gemini Intelligence » – image : Google

L’autre grande affaire des Googlebook est l’intégration profonde de Gemini. Les portables intègrent un NPU jusqu’à 45 TOPS, de quoi leur assurer le traitement en local de fonctions d’IA regroupées sous la bannière « Gemini Intelligence ». Google met en avant le « Pointeur magique » qui permet à Gemini d’interagir avec le contenu affiché à l’écran en secouant le curseur de la souris.

Une fonction de dictée améliorée met en forme les mémos vocaux pour être partagés par écrit. Le bureau du Googlebook pourra être personnalisé avec des widgets créés par l’utilisateur. Les Googlebook intègrent également Antigravity, la plateforme maison qui permet de concevoir des agents IA et déployer des applications depuis la machine.

Les précommandes ont débuté auprès des distributeurs français, pour une disponibilité le 5 octobre. Pour l’occasion, Google livre 12 mois d’abonnements à sa formule IA Pro, 5 To de stockage en ligne, et surtout dix ans garantis de mises à jour logicielles.
  •  

Google enfreint le RGPD et écope d’une amende de 403 millions d’euros

Un suivi à la trace qui coûte cher
Google enfreint le RGPD et écope d’une amende de 403 millions d’euros

Google essuie une nouvelle amende en Europe. La Commission à la protection des données irlandaise inflige une sanction financière de 403 millions d’euros au géant du web pour infraction au RGPD. Le régulateur ordonne également à l’entreprise de se conformer au règlement européen sur la protection des données dans les six mois.

La Commission à la protection des données irlandaise (DPC) n’a pas peur des gros chiffres. En 2023, elle infligeait une amende record de 1,2 milliard d’euros à Meta pour infraction au RGPD. Rebelote aujourd’hui, cette fois contre Google qui écope donc d’une douloureuse de 403 millions.

La DPC remonte la piste de Google

En sa qualité d’autorité de contrôle pour Google (le siège européen du groupe est installé en Irlande), la DPC menait l’enquête depuis début 2020. Deux ans plus tôt, des plaintes avaient été déposées par huit organisations de défense des consommateurs regroupées au sein du BEUC (Bureau européen des unions de consommateurs).

La décision de la DPC était donc attendue depuis un bon moment. Elle porte sur le traitement des données de localisation dans trois fonctions spécifiques : l’activité sur le web et les applications (historique de navigation, recherches et certaines données de localisation), l’historique de localisation (enregistrement des lieux visités et déplacements de l’utilisateur) et la précision de la localisation (amélioration de la géolocalisation de l’appareil au-delà des seules données GPS). Le tout sur la période comprise entre la mise en œuvre du RGPD en mai 2018 et février 2020.

Google a enfreint le règlement européen sur ces trois points. En ce qui concerne l’activité sur le web et les apps, ainsi que sur l’historique de localisation, l’entreprise a traité les données de localisation sans fondement juridique valable, et d’une manière déloyale envers les utilisateurs. Google a aussi démontré son incapacité à prouver que les données personnelles recueillies par la fonctionnalité de précision de la localisation étaient traitées légalement, loyalement et en toute transparence.

La DPC a également conclu que le groupe n’a pas respecté ses obligations de transparence concernant les trois fonctions en question, et qu’il a enfreint les principes de conservation des données de localisation pour les fonctionnalités d’activité sur le web et les apps, ainsi que pour l’historique de localisation.

Une décision longue à venir

« Les données de localisation peuvent être extrêmement sensibles, car elles révèlent beaucoup de choses sur notre vie privée : l’école fréquentée par nos enfants, le nombre de visites d’une personne à l’hôpital, voire ses lieux de culte. Il s’agit d’une pratique extrêmement intrusive, qui porte atteinte au droit fondamental à la vie privée et enfreint le RGPD », rappelle Agustín Reyna, directeur général du BEUC.

Ce dernier se réjouit de la décision de la DPC, mais regrette « le temps nécessaire pour parvenir à cette conclusion » jugé « disproportionné au regard de la gravité de l’infraction ». Pour Agustín Reyna, « Une application tardive de la loi peut être aussi préjudiciable qu’une absence totale d’application. Les droits fondamentaux des consommateurs doivent être protégés plus rapidement et plus efficacement. »

Google a maintenant six mois pour se mettre en règle… même si cela semble déjà être le cas. L’entreprise a en effet rappelé à Bloomberg que le dossier porte sur d’anciennes règles de confidentialité mises à jour depuis. « Depuis 2019, nous avons considérablement fait évoluer nos pratiques et lancé des outils performants qui simplifient la gestion des données de localisation », ajoute-t-elle.

Dix organisations membres du BEUC, dont Que Choisir Ensemble (à l’époque, UFC-Que Choisir) ont déposé une seconde plainte contre Google en 2022. Elle porte sur la manière dont le groupe pousse les utilisateurs, lors de la création d’un compte, à accepter une collecte et une exploitation étendues de leurs données personnelles via des méthodes d’interfaces manipulatrices (dark patterns). La DPC a ouvert une enquête en 2023.

  •  

Suno veut faire la paix avec l’industrie musicale, Sony et Universal attaquent de nouveau

Les majors sortent les dossiers
Suno veut faire la paix avec l’industrie musicale, Sony et Universal attaquent de nouveau

La quête de respectabilité de Suno est décidément un long chemin pas très tranquille. La start-up qui développe des outils de génération IA de musique est la cible d’une nouvelle plainte des majors Sony et Universal.

Dévoilé le 9 septembre, le modèle v6 de Suno a été développé en partenariat avec des représentants de la filière musicale, dont Warner, BMG et Believe. Ce modèle IA est présenté comme un moyen de montrer « comment l’IA et l’industrie musicale peuvent se renforcer mutuellement et créer des expériences entièrement nouvelles pour les artistes, les fans et, plus largement, toute la communauté musicale. »

Ce travail en commun avec une partie de la filière permet aussi et surtout à Suno de se rapprocher des acteurs traditionnels de l’industrie musicale et de montrer qu’elle entend désormais composer avec eux, plutôt que contre eux. À l’instar de son rival Udio, la start-up a mauvaise réputation dans le milieu.

Sony et Universal remettent une pièce

Malgré v6, Suno n’est pas au bout de ses peines. Sony Music et Universal Music (UMG) ont ainsi déposé plainte contre l’entreprise ce vendredi 18 septembre (PDF). Les deux majors lui reprochent d’avoir copié sans autorisation des dizaines de milliers d’enregistrements protégés pour l’entraînement de ses modèles. On parle de 60 202 enregistrements, et il ne s’agit là que d’une partie du corpus effectivement utilisé.

La deuxième accusation est que Suno aurait obtenu une partie des fichiers en les aspirant depuis YouTube, avec l’aide d’outils bien connus des pirates pour contourner les protections techniques de la plateforme vidéo. L’entreprise l’avait d’ailleurs admis :

Enfin, et c’est peut-être l’élément le plus saillant de la plainte, Sony et UMG veulent empêcher Suno de présenter v6 comme un nouveau départ. Les plaignantes affirment que le modèle aurait encore utilisé des copies de leurs enregistrements pour son entraînement, sans autorisation.

Le lourd passif des anciens modèles

Jack Brody, le directeur produit de Suno, avait affirmé au site MBW que l’entraînement de v6 s’est réalisé « à partir de zéro », avec « des données différentes de celles utilisées pour les modèles précédents ». Surtout, ces données n’incluent rien provenant de Sony et d’UMG.

Mais voilà : lorsqu’un utilisateur crée un morceau avec Suno, ce sont en fait deux titres qui sont générés. Ces données de préférence servent ensuite à améliorer les modèles. Les majors estiment que, puisque ces préférences portent sur des morceaux générés par les anciens modèles, elles ont permis de transmettre à v6 une partie de ce que ces modèles avaient appris à partir d’enregistrements utilisés sans autorisation. Autrement dit, du blanchiment de données.

Sony et Universal réclament une injonction pour faire cesser les pratiques de Suno, ainsi que des dommages et intérêts qui pourraient se monter jusqu’à 150 000 dollars par œuvre. On sent que la porte n’est pas fermée pour une entente à l’amiable. Dans leur plainte, les deux sociétés expliquent en effet qu’il existe un marché pour des licences qui permettraient d’obtenir légalement des données d’entraînement, la preuve : Suno a signé avec Warner, BMG et Believe…

C’est la deuxième action en justice menée par UMG et Sony contre Suno. La première remonte à juin 2024, qui portait sur l’utilisation présumée, sans autorisation, d’enregistrements protégés pour l’entraînement d’anciens modèles. Une procédure amendée au mois d’août, en ajoutant au lot l’accusation de contournement des protections anti-téléchargement de YouTube.

  •  

L’hallucination d’une IA a failli provoquer un affrontement entre les États-Unis et la Chine

« ChatGPT peut faire des erreurs »
L’hallucination d’une IA a failli provoquer un affrontement entre les États-Unis et la Chine

L’humanité est passée à un cheveu, ou plutôt à une hallucination près, de partir en lattes. Au printemps, l’armée américaine était en effet à deux doigts de prendre d’assaut un navire chinois soupçonné de transporter des composants pour un programme nucléaire. Problème : le rapport sur lequel l’armée se basait a été généré par une IA qui a halluciné la cargaison du bateau.

Depuis quelques jours, les grands acteurs de l’IA jouent à se faire peur, en affirmant que cette technologie pourrait signer la fin de l’humanité. Un storytelling apocalyptique qui sert aussi et surtout les intérêts commerciaux d’entreprises qui préparent leurs introductions en Bourse.

Le vrai danger immédiat de l’IA réside dans les décisions potentiellement catastrophiques d’humains prises à partir d’informations non fiables ou carrément hallucinées. C’est particulièrement problématique quand il s’agit de décisions militaires. CNN rapporte un exemple qui fait froid dans le dos.

WarGames pour les nuls

Au plus fort de la guerre contre l’Iran ce printemps, l’armée américaine a très sérieusement envisagé d’intercepter un navire chinois par la force, avec l’aide d’un support aérien armé. Le bâtiment, qui croisait au Moyen-Orient, transportait des composants destinés à un programme d’armement nucléaire, du moins d’après un rapport rédigé par un analyste du commandement des opérations spéciales américaines pour le Pacifique, basé à Hawaï.

Fort heureusement, juste avant le lancement de l’opération, des responsables ont examiné de plus près le fameux rapport. Ils ont alors découvert qu’il avait été rédigé avec l’aide d’un bot IA qui a mal identifié la nature du matériel transporté par le navire, à partir de son manifeste. Une des sources de CNN affirme que le rapport était « complètement faux ». Cette histoire basée sur l’hallucination d’une IA a « presque failli déclencher une guerre » : toute opération américaine contre un navire chinois peut dégénérer en conflit entre les États-Unis et la Chine.

Le bot aurait patouillé des renseignements publics avec des renseignements classifiés pour déterminer, faussement, que le bâtiment transportait une cargaison dangereuse. Une conclusion qui aurait pu être très lourde de conséquences.

Le Pentagone hallucine aussi

Le ministère de la Défense américain, emmené par le très trumpiste Pete Hegseth, a fait de l’intégration de l’IA dans les opérations militaires une priorité. Une intégration à marche forcée : les responsables états-uniens, tout comme Donald Trump, estiment que le pays ne peut pas prendre de retard sur ce dossier. Que se passerait-il si les États-Unis devaient affronter la Chine ou un autre adversaire mieux équipé ?

Une note du Pentagone décrivait la stratégie à suivre (PDF) : démocratiser l’expérimentation de l’IA dans l’ensemble du ministère, « en mettant les modèles d’IA américains de pointe directement entre les mains de nos trois millions de personnels civils et militaires, à tous les niveaux de classification ».

La mise en œuvre serait cependant bien décousue : chaque branche du gouvernement utilise des outils différents avec des normes de sécurité tout aussi différentes. Aucun standard n’existe pour vérifier les informations de ces systèmes d’IA. Les humains restent donc, plus que jamais, absolument indispensables pour prendre les décisions, en espérant que ce soient les bonnes.

  •  

Switch 2 : les cartouches 32 Go commencent enfin à sortir du bois

Le physique, mais à quel prix ?
Switch 2 : les cartouches 32 Go commencent enfin à sortir du bois

En matière de support physique, s’il ne devait en rester qu’un, ce serait probablement Nintendo. Les jeux sur cartouches sont presque à parité avec les jeux dématérialisés sur les consoles Switch.

Les joueurs Nintendo sont très attachés au support physique : durant l’exercice fiscal 2025, 45,4 % du chiffre d’affaires des jeux provenait des cartouches Switch, contre 54,6 % pour le dématérialisé (PDF). En plus des jeux téléchargeables sur l’eShop, ce dernier chiffre inclut aussi les DLC, les titres exclusivement numériques et l’abonnement Nintendo Switch Online.

Le ratio chez les concurrents tourne plutôt autour de 80/20 en faveur du tout dématérialisé. Et avec l’annonce de Sony de l’arrêt des supports physiques pour les jeux PlayStation (programmé en janvier 2028), la part associée au physique ne va pas s’améliorer.

Les Game-Key Cards, compromis peu populaire

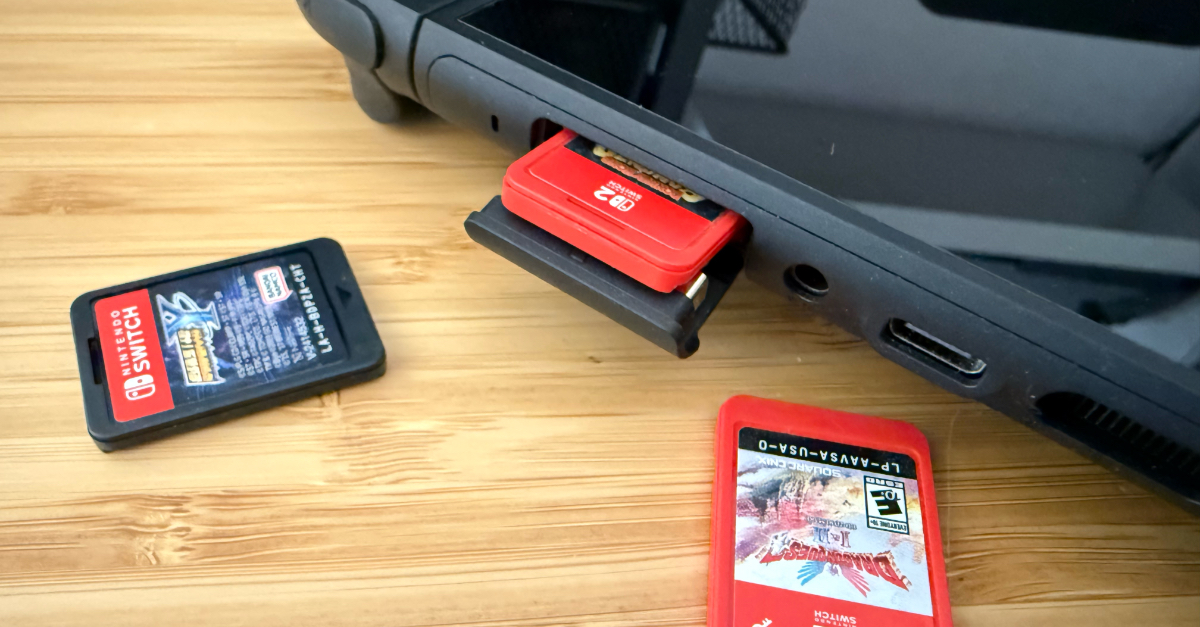
Nintendo n’est pas PlayStation : pas question de s’aliéner une part importante de la clientèle. La Switch 2 intègre donc un port cartouche, qui plus est compatible avec les jeux Switch 1. La nouvelle console, plus puissante, exige aussi des supports de stockage plus imposants ; c’est pourquoi les cartouches de la Switch 2 sont de 64 Go, deux fois plus que les cartouches de Switch 1 qui se déclinent en plusieurs capacités allant de 1 à 32 Go.

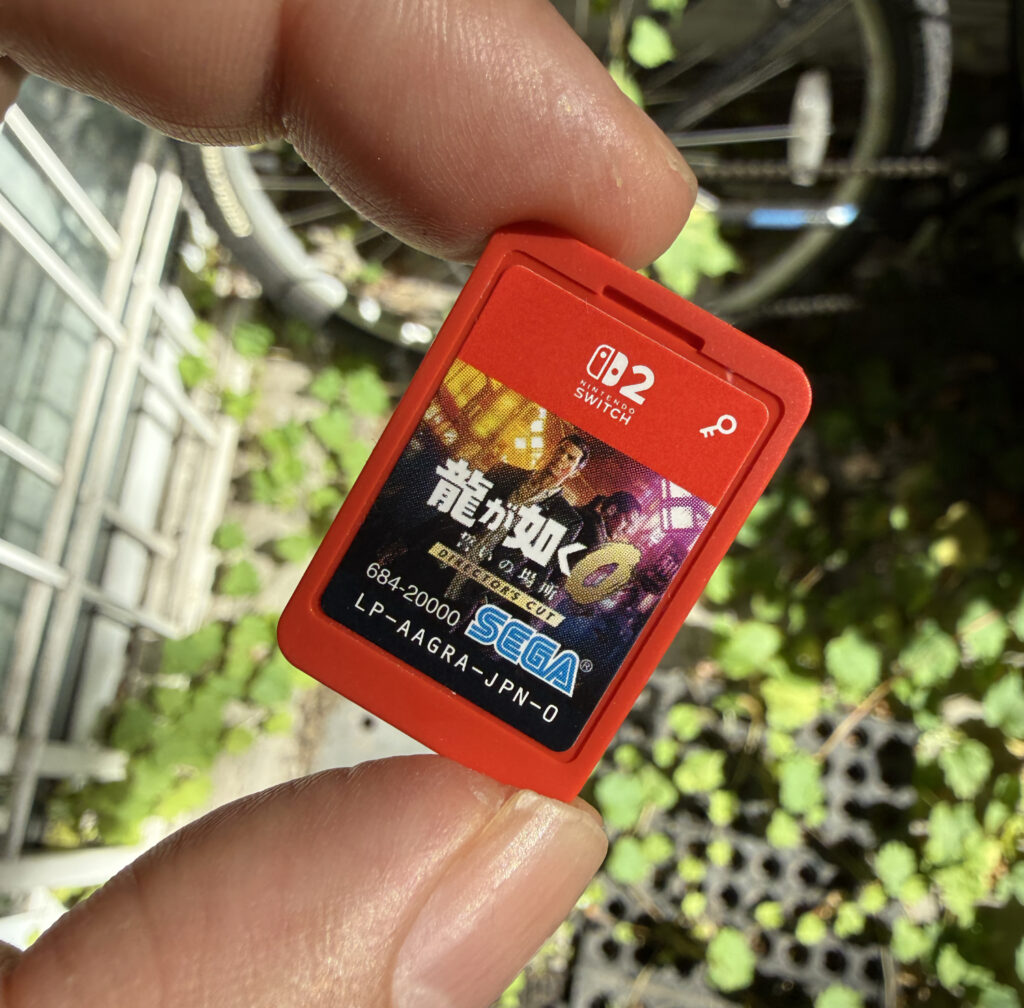
Une carte clé de jeu. Image : Next

Le hic, c’est que le support physique pour Switch 2 a un coût élevé pour les éditeurs. ININ Games, qui publie R-Type Dimensions III, avait expliqué dans un billet datant de décembre dernier, avant le lancement du jeu, pourquoi il ne sortirait pas sur cartouche.

« Pour la Switch 2, tous les exemplaires d’un même titre doivent utiliser le même format physique. Comme environ 90 % de la production totale est destinée à la distribution classique en magasin, avec un prix de vente fixé à 39,99 €, passer l’ensemble de la production sur de véritables cartouches ferait fortement augmenter les coûts de fabrication », indiquait le studio. « Nous serions alors contraints d’augmenter le prix de vente d’au moins 15 €. »

Nintendo propose bien une alternative avec les cartes clés de jeu (game-key card) qui s’apparentent à un code de téléchargement mais… physique. Ces cartes sont bien plus abordables pour les éditeurs puisqu’elles ne comportent aucun espace de stockage ; en revanche, elles se transformeront en petit bout de plastique inutile le jour où l’eShop fermera ses portes.

Ça n’arrivera pas demain ni (probablement) dans dix ans, mais la boutique en ligne des Switch finira sans aucun doute par fermer ses portes, tout comme celle de la 3DS et de la Wii U : depuis mars 2023, il n’est plus possible d’acheter de jeux pour ces consoles (les retéléchargements de contenus précédemment achetés restent cependant toujours possibles aujourd’hui). D’ici là, les cartes clés de jeu ont néanmoins l’avantage de pouvoir être revendues en occase ou prêtées à un ami, contrairement aux jeux 100 % dématérialisés.

Moins de capacité, mais un vrai jeu dans la carte

Ce n’est cependant pas suffisant pour de nombreux joueurs, qui rechignent toujours à acheter des cartes clés de jeu ou du dématérialisé. Mais comme on l’a vu avec ININ Games, les « vraies » cartouches reviennent souvent trop chères, ce qui oblige à relever inconsidérément le prix des jeux physiques…

Depuis quelques mois, la rumeur court que Nintendo proposerait aux éditeurs des cartouches pour Switch 2 d’une capacité moindre, et donc plus abordable. ININ avait ainsi annoncé sur les réseaux sociaux, avant de supprimer le post, que Nintendo proposait désormais deux nouveaux formats de cartouches de plus petite capacité, de 16 et de 32 Go ajoutait le compte Does It Play?. Le surcoût de cette version physique revenait à 10 euros, 50 % de moins qu’une cartouche 64 Go.

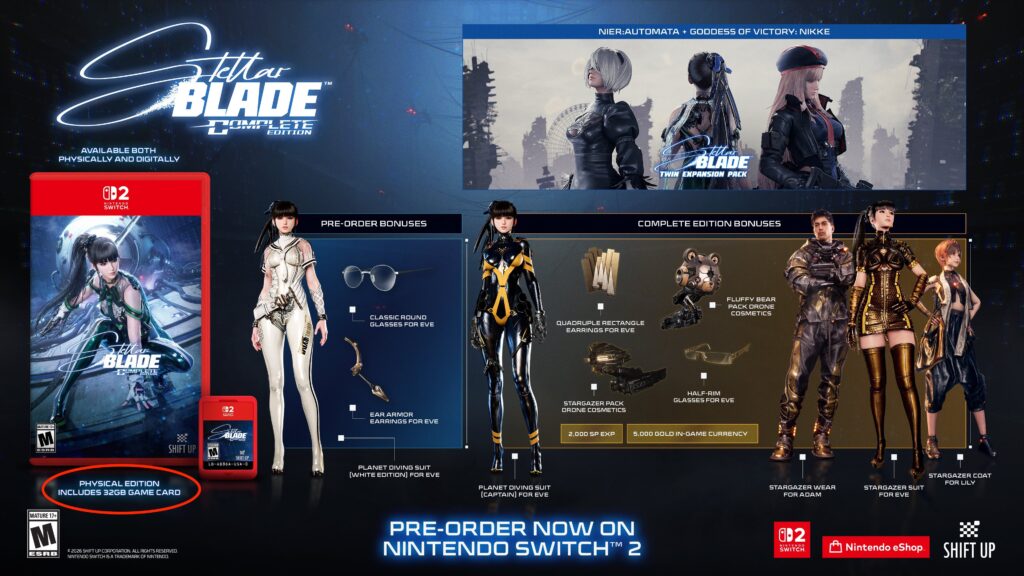
Difficile d’en savoir plus depuis, Nintendo étant notoirement adepte du plus grand secret. Très peu de jeux Switch 2 sortent sur cartouche. Beaucoup d’éditeurs préfèrent la carte clé de jeu, voire les « codes dans la boîte » ou tout simplement l’eShop. Mais l’histoire a rebondi tout récemment avec l’annonce par le studio Shift Up du lancement le 5 novembre de Stellar Blade, portage pour Switch 2 d’un jeu PS5.

Non seulement la version physique est une cartouche en bonne et due forme mais surprise, celle-ci est d’une capacité de 32 Go, comme on le voit sur le visuel de l’édition complète. Une hirondelle ne fait pas le printemps et rien ne dit que d’autres éditeurs vont suivre – ce qui coûtait déjà cher l’an dernier ne doit pas être spécialement meilleur marché aujourd’hui en raison de crise de la mémoire. Néanmoins, c’est bien la première fois qu’un studio communique aussi librement sur la capacité de la cartouche.

  •  

« Un vol d’une ampleur sans précédent » : les documents qui fragilisent OpenAI

« Boucle infernale »
« Un vol d’une ampleur sans précédent » : les documents qui fragilisent OpenAI

« Le plus grand vol de travail de l’histoire de l’humanité » : cette déclaration reprise par le New York Times dans sa procédure en justice contre OpenAI résonne particulièrement fort puisqu’elle émane de Brent Hecht, directeur scientifique de Microsoft. Dans un mémoire de synthèse remis à la justice, l’éditeur du célèbre quotidien aligne les éléments à charge contre le créateur de ChatGPT.

Le New York Times est parti en guerre contre OpenAI. En décembre 2023, l’éditeur portait plainte contre l’entreprise IA, l’accusant d’avoir utilisé des millions d’articles sans autorisation pour entraîner ses modèles GPT. L’administration Trump a récemment volé au secours d’OpenAI, en affirmant que l’entraînement de l’IA sur des contenus protégés par droit d’auteur relevait du « fair use » (usage équitable), un argument seriné en boucle par les entreprises IA pour se défausser de leur responsabilité.

Des documents internes difficiles à balayer

Le mémoire de synthèse, déposé devant le tribunal fédéral de New York (PDF) par le NYT et d’autres éditeurs de presse (Chicago Tribune, Ziff Davis, Mother Jones…), détaille les éléments recueillis pendant la phase de collecte des preuves : témoignages sous serment, messages et autres documents produits par OpenAI et Microsoft. Ils sont évidemment à charge, mais ils s’appuient sur des pièces et des témoignages qui donnent un aperçu assez cru de la manière dont OpenAI et Microsoft considéraient en interne l’exploitation des contenus de presse.

Le témoignage de Brent Hecht est particulièrement embarrassant. Selon lui, « des millions de personnes dans le monde considéreront bientôt que les grands modèles qui « aspirent » tout leur travail constituent un vol d’une ampleur sans précédent ». Il admet que « presque personne n’avait prévu que les contenus créés seraient utilisés de cette manière, sans que leurs auteurs soient rémunérés ».

Le directeur scientifique de Microsoft estime aussi qu’accepter l’argument d’OpenAI selon lequel le moissonnage de contenus n’est que du « fair use » revient à complètement vider la notion de son sens. « Ces propos reflètent le point de vue personnel d’un employé et ne constituent pas une analyse juridique », a déclaré Microsoft auprès d’Ars Technica.

Le mémoire cite un autre échange dans lequel Nick Ryder, responsable de recherche chez OpenAI, annonce à Greg Brockman l’existence d’un « moyen pour contourner le paywall du New York Times » afin de collecter les articles. Le cofondateur et président de l’entreprise a simplement répondu : « ah, très bien » (« ah nice »).

Des aveux qui tombent mal

Les éditeurs de presse font tout simplement face à une « menace existentielle », reconnait Nick Turley, responsable de ChatGPT chez OpenAI, dans un message interne remontant à juin 2023. Une fois que ChatGPT fournit une réponse, il n’y a « aucune bonne raison de cliquer » sur le lien vers la source d’origine, ajoute-t-il. Un document chez Microsoft parle de « boucle infernale » : en détournant une partie du trafic des sites d’actualité, les assistants IA fragilisent les éditeurs qui produisent précisément les contenus dont leurs modèles ont besoin pour rester performants.

Selon les propres données de Microsoft, le taux de clic depuis Bing Chat ou Copilot vers les sites des éditeurs est très inférieur à celui observé depuis la recherche Bing classique : baisse de 87 à 93 % pour les sites du New York Times, de 83 à 91 % pour les autres plaignants. C’est d’autant moins de revenus pour les sites de presse qui se retrouvent en concurrence avec leurs propres contenus recrachés par les bots. Un ingénieur logiciel d’OpenAI reconnaissait dans un message interne que, « peu importe la visibilité donnée aux liens, les utilisateurs ne cliqueront pas dessus ».

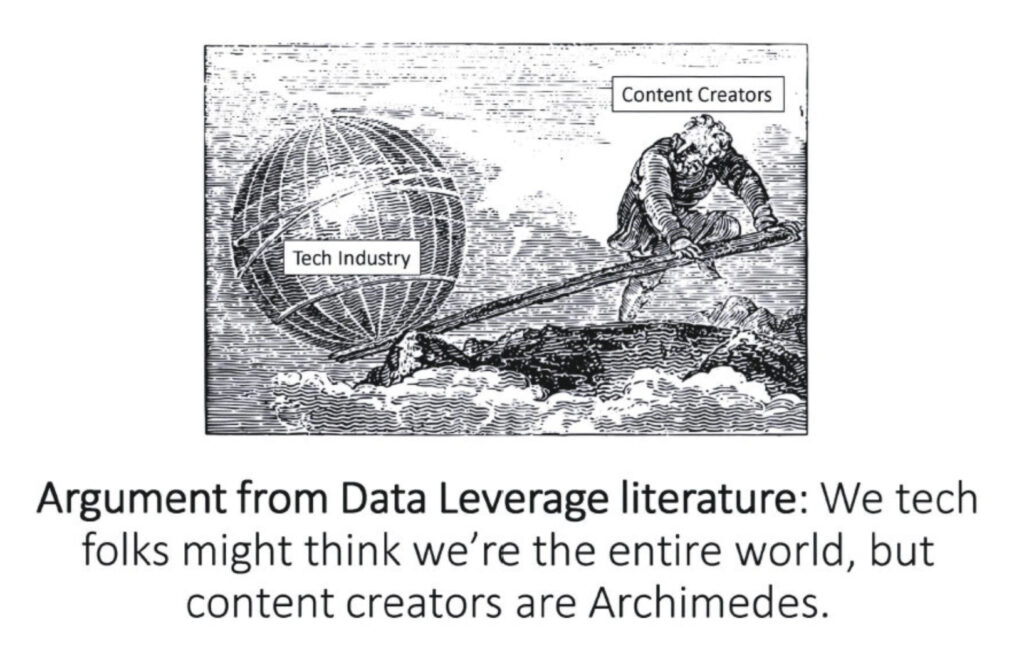
Un dessin présent dans un document de Microsoft, repris dans le mémoire du NYT : « Argument tiré des travaux sur le pouvoir de négociation lié aux données : nous, dans la tech, avons peut-être tendance à nous croire au centre du monde, mais ce sont les créateurs de contenus qui tiennent le levier d’Archimède. »

Satya Nadella face à la question des paywalls

Dans son témoignage sous serment, Satya Nadella, le directeur général de Microsoft, admet que « tout contenu placé derrière un paywall devrait faire l’objet d’une licence de la part de quiconque souhaite l’utiliser, que ce soit pour alimenter les réponses d’un modèle ou pour son entraînement ».

S’il avait su qu’OpenAI – dont Microsoft est un des principaux partenaires – avait moissonné des contenus placés derrière un paywall pour entraîner ses modèles IA, Nadella aurait invoqué le droit de Microsoft d’exiger le réentraînement des modèles sans ces données protégées. Pour le dirigeant, les entreprises IA ne devraient pas accéder à des contenus enfreignant les conditions d’utilisation.

Satya Nadella reconnait également que les chatbots comme Copilot peuvent se substituer aux sites d’actualité : ils donnent en effet l’information « directement sur la plateforme d’IA, plutôt que d’obliger l’utilisateur à se rendre à la source d’origine ». Pour le porte-parole de Microsoft, ce témoignage porte sur des « principes généraux », il ne s’agit que « d’observations qui ne doivent pas être confondues avec des conclusions sur les questions de droit d’auteur soumises au tribunal ».

Si ce mémoire de synthèse est certes accablant, il ne constitue pas pour autant une décision de justice ni une conclusion du tribunal sur le fond de l’affaire. Néanmoins, les pièces de première main qu’il expose éclairent l’état d’esprit d’OpenAI et de Microsoft quant à la portée réelle de leur utilisation du « fair use ».

  •  

☕️ Lunettes connectées : le parquet de Paris ouvre une enquête pour harcèlement sexuel


Le parquet de Paris a ouvert « au moins » une enquête pénale suite à des plaintes pour harcèlement sexuel impliquant des lunettes connectées, selon Reuters. Ces appareils et leur caméra intégrée auraient été utilisées pour filmer des femmes dans la rue à leur insu. Les vidéos ont ensuite été publiées sur internet, sans le consentement des victimes.

Le parquet ne donne aucun détail supplémentaire, ni la marque des lunettes incriminées. Mais difficile de ne pas songer aux modèles de Ray-Ban de Meta qui ont gagné le surnom peu enviable de « pervert glasses » (« lunettes de pervers »). L’entreprise tente d’éteindre l’incendie provoqué par des harceleurs qui utilisent leurs montures pour « piéger » des femmes et poster leurs exploits en ligne.

La cellule cybercriminalité du parquet a testé ces appareils « il y a deux semaines » pour déterminer les infractions potentielles rendues possibles par ces lunettes. La CNIL reçoit de plus en plus de demandes d’entreprises souhaitant savoir s’il est possible d’interdire ces appareils sur le lieu de travail. La garante de la protection des données a enregistré une dizaine de plaintes. En mai dernier, la CNIL avait alerté des risques que font peser les lunettes connectées pour la vie privée.

Meta et ses lunettes connectées attaquées en justice aux États-Unis

Les lunettes Meta intègrent une diode qui s’allume lorsque la caméra est activée. L’entreprise a renforcé cette protection (et envisage même de lancer des modèles… sans caméra). « Une réaction tardive alors que les risques liés à des lunettes capables de filmer presque à l’insu des personnes auraient dû être anticipés avant leur commercialisation », dénonçait cette semaine e-Enfance, une association de protection de l’enfance sur internet.

« Voir un voyant ne signifie pas consentir à la diffusion de son image. Et encore faut-il le voir, en comprendre la signification et avoir la possibilité de réagir », poursuit l’association. Pour Véronique Béchu, directrice de l’Observatoire de l’Association e-Enfance/3018 : « Il faut aujourd’hui revoir l’encadrement de ces dispositifs dès leur conception. Et quand des créateurs font de l’humiliation d’inconnus leur fonds de commerce, les plateformes doivent appliquer une tolérance zéro et suspendre les comptes récidivistes. »

  •  

Meta ajoute de l’IA dans ses abonnements payants avec Meta One

Meta tend la sébile
Meta ajoute de l’IA dans ses abonnements payants avec Meta One

Pas besoin de se soucier des finances de Meta, qui vit très bien de la publicité. Mais le mastodonte des réseaux sociaux aimerait bien créer une autre source de revenus, et les abonnements payants pourraient être cette solution. Beaucoup d’abonnements payants avec de l’IA.

Après une phase de test débutée en mars et confirmée en mai, l’entreprise lance donc officiellement ces formules partout dans le monde et ajoute en sus Meta One, qui gonfle l’enveloppe d’usage IA.

Plus qu’une offre simple et lisible, c’est tout un bazar de formules pour toutes les plateformes du groupe, avec des fonctionnalités différentes pour chacune. Avec un engagement important : « l’expérience principale » reste gratuite, tout comme Meta AI.

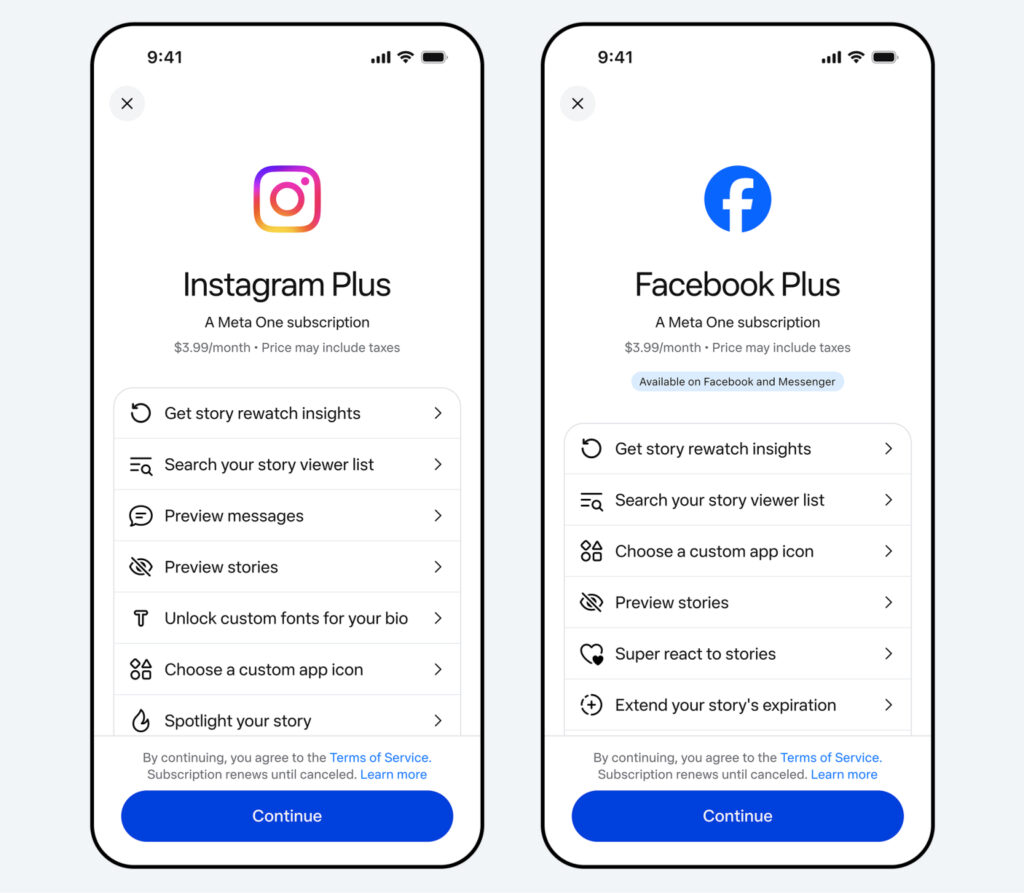
Image : Meta

Commençons par le plus simple : les abonnements Plus pour Instagram (2,99 euros/mois), Facebook (2,99 euros/mois) et WhatsApp (2,49 euros/mois). Sur Instagram, il sera possible de créer des « listes d’audience », d’accéder aux statistiques de relecture des Stories, de rechercher des personnes dans la liste de ceux qui ont visionné une Story (et de recevoir une notification quand telle personne a vu une Story), de prolonger de 24 heures la durée d’une Story (24 heures en temps normal), d’envoyer des « super cœurs », etc.

Un abonnement pour les regrouper tous

Les abonnés Plus sur Facebook gagneront aussi la prolongation de 24 heures d’une Story et la recherche d’une personne ayant consulté une Story, l’envoi de « super réactions » aux Stories, ou encore le choix d’une icône personnalisée.

Enfin, dans WhatsApp, l’abonné pourra partager des autocollants exclusifs avec des effets spéciaux, des thèmes et des icônes d’apps uniques, la possibilité d’épingler jusqu’à 20 discussions, personnaliser les sonneries et les listes de discussion (alertes, sonneries, thèmes).

Ce ne sont pas là des fonctions extraordinaires, mais plutôt des options de personnalisation supplémentaires ainsi que des petits coups de pouce pour améliorer la visibilité de ses contenus. En cela, pas grand chose n’a changé depuis le test de ces abonnements… et puis ces formules payantes ne suppriment pas la pub.

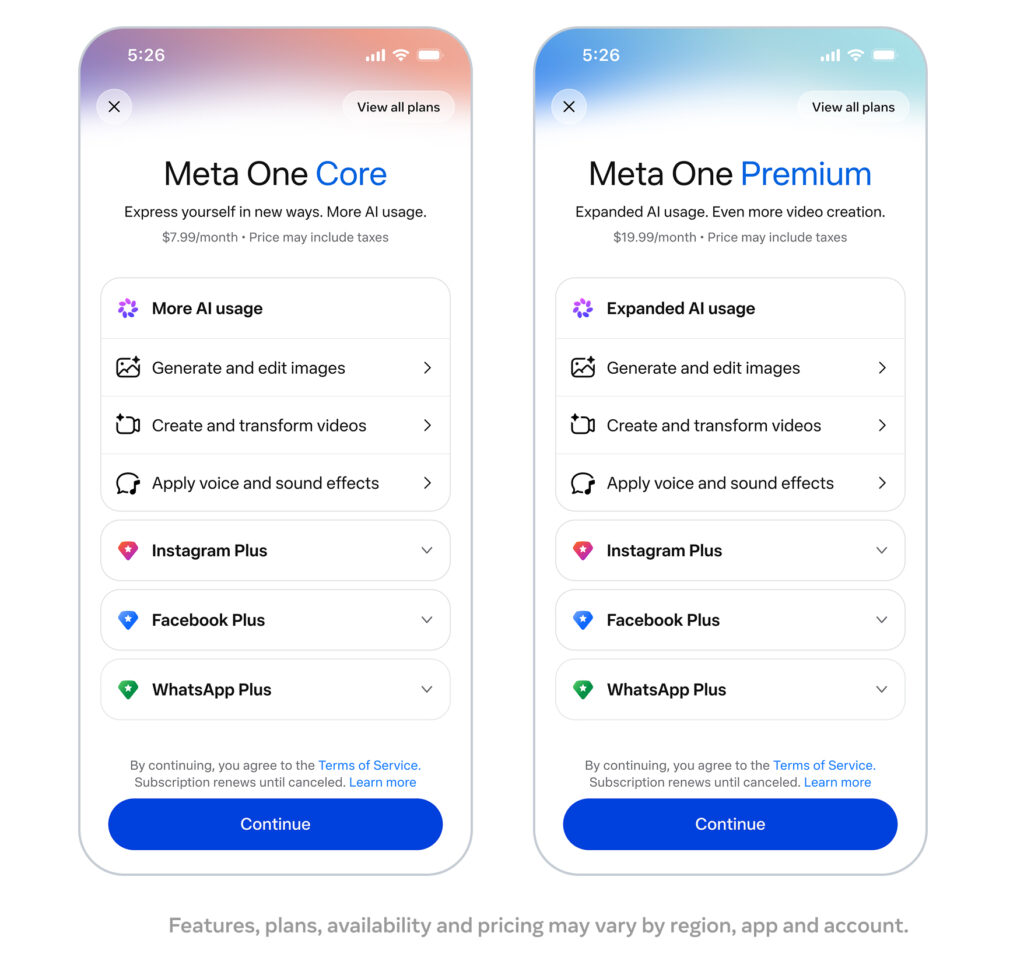
Image : Meta

La nouveauté est destinée aux fans hardcore de Meta : un abonnement Core à 6,99 euros par mois qui regroupe les trois formules Plus, avec en bonus un plafond relevé pour l’utilisation de IA, de quoi inonder les réseaux sociaux avec encore plus de slop. L’offre Premium à 20,99 euros intègre Core et augmente encore le niveau d’usage de l’IA.

Des revenus au-delà de la publicité

Meta n’oublie pas les créateurs et les entreprises, avec deux abonnements supplémentaires. Essential, à partir de 16,99 euros par mois, comprend un badge vérifié, un canal vérifié dans WhatsApp Business (bot IA pour répondre aux questions des clients) et une protection contre l’usurpation d’identité. Advanced va un cran plus loin : cette offre à partir de 54,99 euros par mois permet de programmer des Stories jusqu’à 30 jours à l’avance, d’ajouter des liens dans les publications et les Reels, d’exporter des données analytiques, de donner aux membres de l’équipe un accès au compte.

Il existe aussi des offres Expert et Max, à respectivement 169 et 549 euros par mois, pour obtenir les niveaux d’accès aux fonctions les plus élevés et aux capacités de Meta Business Agent, un agent IA pour aider les entreprises à automatiser les interactions client dans l’écosystème de Meta.

L’entreprise promet d’ajouter de nouvelles fonctions dans Meta One, par exemple pour l’outil de montage vidéo Edits pour les créateurs de contenu, avec une formule Plus offrant du stockage supplémentaire dans le cloud. WhatsApp Plus va tester le stockage des sauvegardes des discussions et des médias, et une fonction « Focus Schedules » qui mettra en sourdine ou masquera certaines discussions d’après un calendrier spécifique.

Meta revendique déjà « 15 millions d’abonnements et d’essais » à ce jour. C’est évidemment très peu en regard des milliards d’utilisateurs de Facebook, Instagram et WhatsApp, mais il faut bien commencer quelque part. Meta One est aussi et surtout là pour tenter de rentabiliser les très lourds investissements dans l’IA.

Face aux investisseurs impatients, Mark Zuckerberg avait déjà souligné (PDF) lors de la présentation des résultats du deuxième trimestre que l’IA améliorait l’efficacité du ciblage publicitaire. Selon lui, elle avait entraîné 5 % de conversions supplémentaires sur Instagram et 3 % sur Facebook. Des gains déjà significatifs à cette échelle, mais encore insuffisants pour justifier les dizaines de milliards de dollars déjà engloutis.

  •  

☕️ Google ouvre la porte de sa maison connectée aux agents IA


Voyons voir, qu’est-ce qui pourrait mal tourner ? Google a annoncé l’ouverture de sa plateforme domotique Home aux agents IA compatibles avec le Model Context Protocol (MCP).

Cela signifie qu’un agent autre que Gemini (Claude, OpenClaw, Hermes, un agent conçu avec la plateforme Google Antigravity, ou autres) peut interagir avec les appareils Google Home ou certifiés Works with Google Home de la maison : sonnettes, thermostats, ampoules…

Image : Google

L’entreprise donne quelques exemples d’interactions possibles : l’agent peut consulter le flux vidéo des caméras pour résumer l’activité des enfants de retour à la maison ; il peut compter le nombre de lessives réalisées pendant la semaine, ou combien de temps la lumière du couloir est restée allumée ; il peut prévenir qu’une tâche a été réalisée en l’annonçant via un message audio sur l’enceinte Home. Un agent peut encore construire un tableau de bord personnalisé en reprenant les principales informations des différents capteurs et caméras installés dans la maison.

Cette nouveauté est en accès anticipé et proposée uniquement en anglais, aux utilisateurs basés aux États-Unis détenteurs d’un abonnement Google Home Premium Advanced. La configuration n’est pas non plus aussi simple que de pousser un bouton virtuel, il faut créer un projet Google Cloud pour le configurer de telle manière à pouvoir utiliser Google Home MCP.

La perspective de confier sa maison connectée à un agent IA peut donner quelques sueurs froides. Google l’écrit en toutes lettres : « Selon l’agent utilisé, sa connexion à Home MCP peut entraîner des comportements inattendus, voire indésirables ». L’entreprise recommande de prévenir les habitants de la maison qu’un agent peut contrôler des appareils et accéder aux données du domicile.

Google Home MCP intègre tout de même des garde-fous : interdiction de certaines actions sensibles comme le déverrouillage des portes (ouf !) et une fréquence d’usage limitée. L’accès d’un agent à la plateforme MCP peut par ailleurs être révoqué à tout moment depuis l’app Google Home.

  •  

☕️ Pour entraîner Grok, SpaceXAI voudrait racheter les données de startups en difficulté


Maintenant que les acteurs de l’IA ont consciencieusement collecté (certains diront pillé) tous les contenus possibles et imaginables sur le web ouvert et même fermé, il faut bien trouver des données ailleurs pour continuer à entraîner les modèles IA. SpaceXAI pourrait acquérir ces trésors auprès de startups en difficulté ou ayant cessé leurs activités, selon Bloomberg.

Illustration : Flock

Le projet serait en discussion, et pourrait ne pas aboutir. Il est toutefois révélateur de la course engagée par les géants de l’IA pour mettre la main sur des données inédites, spécialisées et de qualité, devenues une ressource de plus en plus précieuse pour améliorer leurs modèles. C’est le cas aussi de la société d’Elon Musk. Les données opérationnelles et les informations clients seraient particulièrement recherchées pour l’entraînement de Grok, le chatbot maison.

SpaceXAI dispose déjà de plusieurs sources de données maison. Grok a l’avantage de pouvoir s’appuyer sur les contenus publiés sur le réseau social X (anciennement Twitter), lui aussi propriété d’Elon Musk. L’entreprise emploie également des spécialistes internes, surnommés « tuteurs IA », qui participent à l’entraînement et à l’affinage du modèle, notamment en l’aidant à progresser sur des compétences spécialisées. Ils travaillent ainsi sur des domaines aussi variés que la finance, les sciences ou même… l’« humour », rapporte Bloomberg.

SpaceXAI a cependant suspendu le recrutement de nouveaux tuteurs, alors qu’en interne, les changements de stratégie et plusieurs départs provoqueraient un certain désordre. D’où le recours à des sources de données extérieures, comme par exemple celles provenant de startups en difficulté.

La stratégie n’est pas inédite. Google a proposé de racheter pour 10 millions de dollars d’actifs de Spirit Airlines, une compagnie aérienne en faillite. L’entreprise mettrait ainsi la main sur un impressionnant volume de documents très spécialisés pour entraîner les modèles de Gemini.

  •  
❌