❌

Vue lecture

Microsoft fusionne ses applications Copilot en une seule « app à tout faire »

Allez, on recommence tout
Microsoft fusionne ses applications Copilot en une seule « app à tout faire »

Sans doute lassée des quolibets, Microsoft a choisi de rassembler toutes ses applications Copilot en une seule, à l’exception de GitHub Copilot. L’éditeur ambitionne désormais de répondre à toutes les demandes depuis une interface unique, avec plusieurs onglets et un choix de modèle piloté selon les besoins.

Comme on pouvait le craindre, l’explosion de l’intelligence artificielle générative n’a pas été maitrisée par tout le monde. Chez Microsoft, les fonctions dopées à l’IA ont envahi tous les produits, au point de provoquer une saturation rapide, ainsi que des hausses de prix, notamment dans Microsoft 365. Au point que l’éditeur fait maintenant machine arrière. À travers son initiative K2 pour Windows 11, ces fonctions sont en recul, tantôt supprimées tantôt désactivées par défaut.

L’un des facteurs qui a mené Microsoft « à sa perte » semble être la multiplication des applications. Le nom « Copilot » est presque devenu un sujet de moquerie, tant les applications se sont multipliées, là où Google n’a par exemple qu’un Gemini, dont les fonctions plongent dans d’autres produits. Le public s’est également habitué à ChatGPT et Claude, avec leur interface unique.

Outre les travaux actuels dans Windows et les applications de l’éditeur, le repositionnement de Copilot se révèle par d’autres émanations. La presse américaine note par exemple que l’étiquette Copilot+ disparait peu à peu des produits qui pouvaient y prétendre. Les caractéristiques techniques minimales sont toujours là, mais l’appellation semble avoir fait son temps, comme l’a confirmé un responsable de Microsoft à Windows Central. Les produits Surface récemment lancés n’ont d’ailleurs pas l’étiquette. On pourrait également relever les nouvelles possibilités de réaffectation dans Windows 11 pour la touche Copilot sur les claviers équipés.

Et voilà que Microsoft annonce désormais une refonte complète de son application centrale Copilot, avec l’idée d’en faire désormais une « super app ».

Tout au même endroit

Le changement le plus important est le même que chez OpenAI ou Anthropic : avoir tout au même endroit. Microsoft restructure donc son application en trois parties.

Home devient le nouveau point d’entrée, en réunissant Chat et Cowork. Dans cette partie, on trouve aussi Office. Pas des visionneuses, mais bien la suite bureautique au grand complet, tout du moins Word, Excel et PowerPoint. Vient ensuite Code, pour lancer des projets de développement comme on le ferait avec le Code de ChatGPT ou celui de Claude. À la différence que Microsoft met l’accent sur le choix du modèle. La dernière partie est Autopilot, qui permet de créer de gérer un agent persistant pour continuer de travailler de manière autonome sur les tâches confiées par l’utilisateur. Pour les personnes qui avaient suivi la conférence Build en juin dernier, Autopilot est simplement le nom officiel du projet Scout.
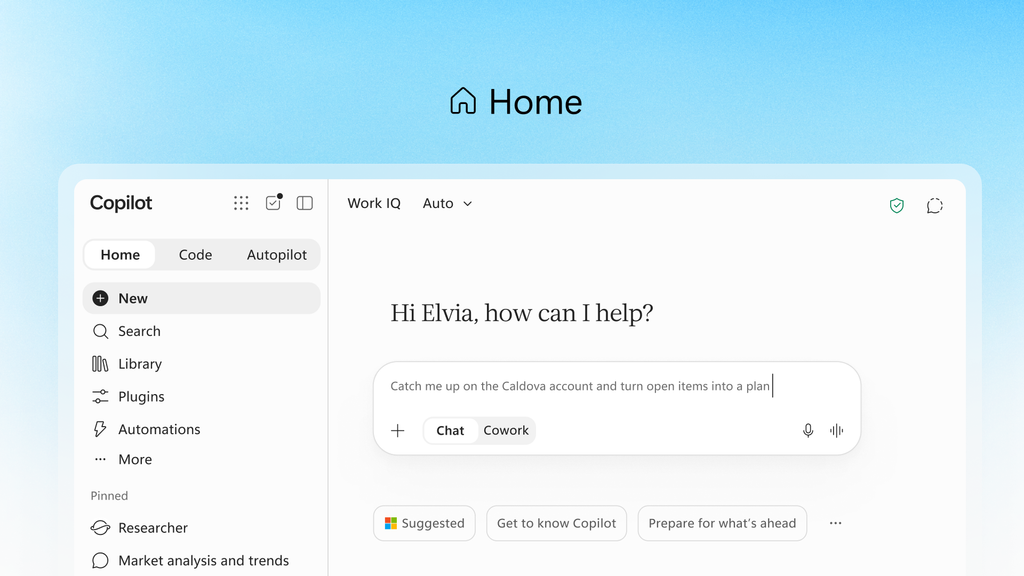
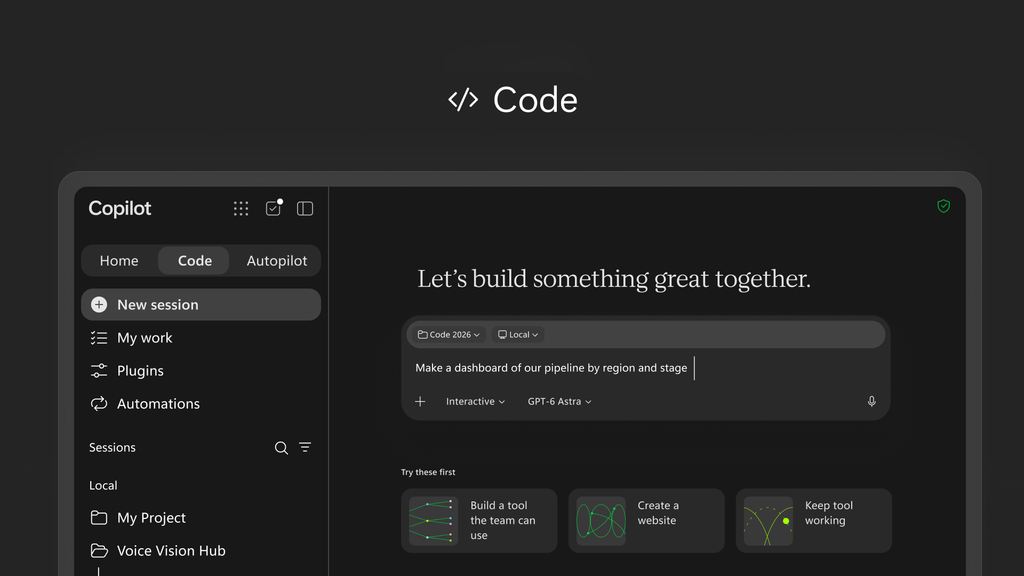
L’application a l’ambition de servir tous les besoins ou presque. Home est clairement orientée vers le travail quotidien, tandis que Code vise plus spécifiquement les non-développeurs, avec la promesse vendue de pouvoir réaliser rapidement les projets qu’ils pourraient avoir en tête. Microsoft précise que rien ne change pour les développeurs : GitHub Copilot est toujours là (il sert également de fondation à Code). Pour l’éditeur, les avantages de cette approche sont évidents : une personne peut décrire une application, un tableau de bord ou n’importe quelle forme d’automatisation, le résultat tirant partie des données liées au compte.

Dans le cadre d’une utilisation en entreprise, l’ensemble doit rester dans un contexte professionnel via Microsoft IQ. Microsoft joue bien sûr la carte de l’écosystème : Fabric IQ apporte du contexte à partir des données présentes dans Copilot (dont les modèles sémantiques de Power BI), un ancrage est prévu dans les données et flux de Dynamics 365 et Power Platform, etc.

Même si Microsoft possède ses propres modèles (et s’en sert notamment pour son infrastructure de recherche de failles Perception), l’éditeur semble vouloir devenir surtout le pourvoyeur d’une solution « pratique », où l’on peut tout faire au même endroit. Dans un tweet publié ce 25 septembre, Satya Nadella indique ainsi : « Nous construisons Copilot comme un nouveau système d’exploitation pour le travail qui englobe chaque modèle, chaque format, et chaque tâche ».

Une tarification en deux parties

Côté tarification, l’entreprise adopte une approche double, dans laquelle l’IA du quotidien reste à un prix fixe par utilisateur, tandis que l’IA agentique fonctionne sur des crédits Copilot. La licence fixe est simplement la licence Microsoft 365 Copilot actuelle, qui couvre Word, Excel, PowerPoint, Outlook et Teams pour 30 dollars par utilisateur et par mois. Elle fonctionne par défaut sur un mode « Auto » censé choisir le modèle le plus adapté selon la requête. GPT-5.6 et Sonnet 5 sont présents, mais pas encore Astra ni le récent Opus 5.5.

Si cette licence est un prérequis, les crédits Copilot servent à alimenter tout ce qui touche à l’agentique. Il s’agit donc d’une facturation à l’utilisation, avec un poids plus ou moins important selon les tâches confiées à Copilot et le modèle utilisé. Dans tous les cas, les usages sont paramétrables par l’équipe d’administration.

  •  

Microsoft fusionne ses applications Copilot en une seule « app à tout faire »

Allez, on recommence tout
Microsoft fusionne ses applications Copilot en une seule « app à tout faire »

Sans doute lassée des quolibets, Microsoft a choisi de rassembler toutes ses applications Copilot en une seule, à l’exception de GitHub Copilot. L’éditeur ambitionne désormais de répondre à toutes les demandes depuis une interface unique, avec plusieurs onglets et un choix de modèle piloté selon les besoins.

Comme on pouvait le craindre, l’explosion de l’intelligence artificielle générative n’a pas été maitrisée par tout le monde. Chez Microsoft, les fonctions dopées à l’IA ont envahi tous les produits, au point de provoquer une saturation rapide, ainsi que des hausses de prix, notamment dans Microsoft 365. Au point que l’éditeur fait maintenant machine arrière. À travers son initiative K2 pour Windows 11, ces fonctions sont en recul, tantôt supprimées tantôt désactivées par défaut.

L’un des facteurs qui a mené Microsoft « à sa perte » semble être la multiplication des applications. Le nom « Copilot » est presque devenu un sujet de moquerie, tant les applications se sont multipliées, là où Google n’a par exemple qu’un Gemini, dont les fonctions plongent dans d’autres produits. Le public s’est également habitué à ChatGPT et Claude, avec leur interface unique.

Outre les travaux actuels dans Windows et les applications de l’éditeur, le repositionnement de Copilot se révèle par d’autres émanations. La presse américaine note par exemple que l’étiquette Copilot+ disparait peu à peu des produits qui pouvaient y prétendre. Les caractéristiques techniques minimales sont toujours là, mais l’appellation semble avoir fait son temps, comme l’a confirmé un responsable de Microsoft à Windows Central. Les produits Surface récemment lancés n’ont d’ailleurs pas l’étiquette. On pourrait également relever les nouvelles possibilités de réaffectation dans Windows 11 pour la touche Copilot sur les claviers équipés.

Et voilà que Microsoft annonce désormais une refonte complète de son application centrale Copilot, avec l’idée d’en faire désormais une « super app ».

Tout au même endroit

Le changement le plus important est le même que chez OpenAI ou Anthropic : avoir tout au même endroit. Microsoft restructure donc son application en trois parties.

Home devient le nouveau point d’entrée, en réunissant Chat et Cowork. Dans cette partie, on trouve aussi Office. Pas des visionneuses, mais bien la suite bureautique au grand complet, tout du moins Word, Excel et PowerPoint. Vient ensuite Code, pour lancer des projets de développement comme on le ferait avec le Code de ChatGPT ou celui de Claude. À la différence que Microsoft met l’accent sur le choix du modèle. La dernière partie est Autopilot, qui permet de créer de gérer un agent persistant pour continuer de travailler de manière autonome sur les tâches confiées par l’utilisateur. Pour les personnes qui avaient suivi la conférence Build en juin dernier, Autopilot est simplement le nom officiel du projet Scout.
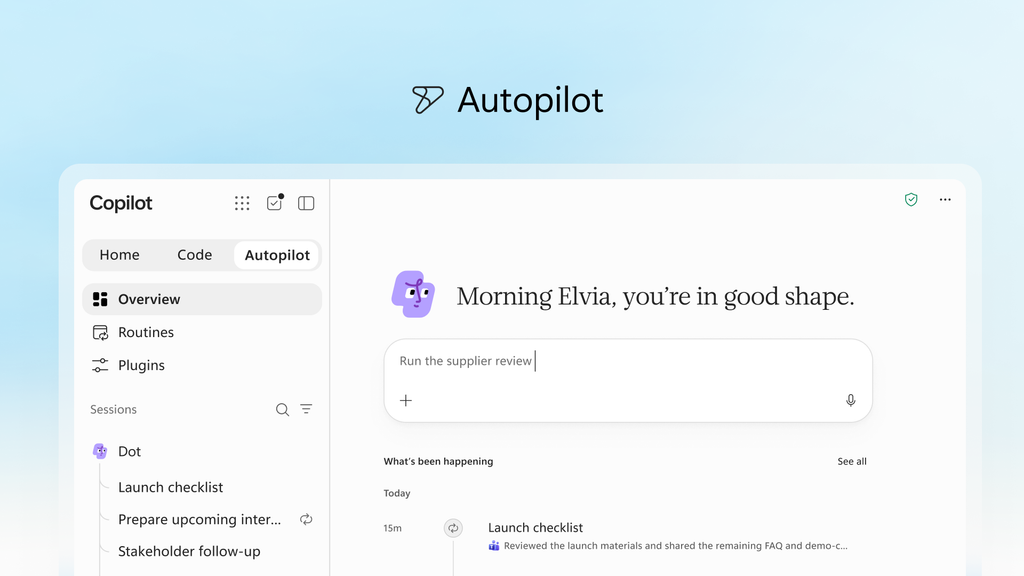
L’application a l’ambition de servir tous les besoins ou presque. Home est clairement orientée vers le travail quotidien, tandis que Code vise plus spécifiquement les non-développeurs, avec la promesse vendue de pouvoir réaliser rapidement les projets qu’ils pourraient avoir en tête. Microsoft précise que rien ne change pour les développeurs : GitHub Copilot est toujours là (il sert également de fondation à Code). Pour l’éditeur, les avantages de cette approche sont évidents : une personne peut décrire une application, un tableau de bord ou n’importe quelle forme d’automatisation, le résultat tirant partie des données liées au compte.

Dans le cadre d’une utilisation en entreprise, l’ensemble doit rester dans un contexte professionnel via Microsoft IQ. Microsoft joue bien sûr la carte de l’écosystème : Fabric IQ apporte du contexte à partir des données présentes dans Copilot (dont les modèles sémantiques de Power BI), un ancrage est prévu dans les données et flux de Dynamics 365 et Power Platform, etc.

Même si Microsoft possède ses propres modèles (et s’en sert notamment pour son infrastructure de recherche de failles Perception), l’éditeur semble vouloir devenir surtout le pourvoyeur d’une solution « pratique », où l’on peut tout faire au même endroit. Dans un tweet publié ce 25 septembre, Satya Nadella indique ainsi : « Nous construisons Copilot comme un nouveau système d’exploitation pour le travail qui englobe chaque modèle, chaque format, et chaque tâche ».

Une tarification en deux parties

Côté tarification, l’entreprise adopte une approche double, dans laquelle l’IA du quotidien reste à un prix fixe par utilisateur, tandis que l’IA agentique fonctionne sur des crédits Copilot. La licence fixe est simplement la licence Microsoft 365 Copilot actuelle, qui couvre Word, Excel, PowerPoint, Outlook et Teams pour 30 dollars par utilisateur et par mois. Elle fonctionne par défaut sur un mode « Auto » censé choisir le modèle le plus adapté selon la requête. GPT-5.6 et Sonnet 5 sont présents, mais pas encore Astra ni le récent Opus 5.5.

Si cette licence est un prérequis, les crédits Copilot servent à alimenter tout ce qui touche à l’agentique. Il s’agit donc d’une facturation à l’utilisation, avec un poids plus ou moins important selon les tâches confiées à Copilot et le modèle utilisé. Dans tous les cas, les usages sont paramétrables par l’équipe d’administration.

  •  

HexaForce : Thales lance son propre rival de Maven, en parallèle d’Arcadia

Commandement décentralisé
HexaForce : Thales lance son propre rival de Maven, en parallèle d’Arcadia

Thales vient de présenter sa solution HexaForce, un système de commandement et de contrôle avec IA pour les forces armées. Il est développé en parallèle du projet souverain Arcadia, nous affirme Thales. HexaForce et Arcadia visent la même cible, Maven de l’Américain Palantir, et semblent puiser leurs inspirations dans la même source, Artemis.IA.

Dans son annonce, Thales met en avant trois forces principales de son produit. D’abord, une architecture ouverte et interopérable, décentralisée et multi-domaine. Ensuite, une adaptation aux conflits de haute intensité, quand les besoins de commandement dépassent les 100 000 combattants. Enfin, une disponibilité avant la fin de l’année.

Si cette présentation fait parler d’elle, c’est qu’elle concrétise une concurrence directe face à Palantir et son produit Maven, avec un accent clair mis sur la souveraineté.

Une structure décentralisée

HexaForce se veut avant tout une plateforme distribuée et donc présentée comme particulièrement résiliente. Le produit « intervient sur l’ensemble des espaces de confrontation : terre, air, mer, cyber, champ électromagnétique, espace et champ informationnel », indique Thales. Son rôle est d’être la clé de voûte de l’organisation militaire au sens large, la solution devant orchestrer « l’ensemble des systèmes présents dans les forces armées et les coalitions pour accélérer la prise de décision et fournir un avantage à tous les niveaux opérationnels ».

Plus précisément, HexaForce est présenté comme un système C4I, pour « Command, Control, Communications, Computers and Intelligence ». Selon Thales, il repose sur « plus de vingt ans d’expérience opérationnelle au sein des forces françaises et de l’OTAN ».


Il reste 84% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ Les avatars animés de Google veulent remplacer les chatbots textuels


Les espaces de discussion intégrés aux sites web pour poser des questions à un bot sont pénibles, mais ils se limitent à du texte. Google, jamais en panne d’une idée pour emmerdifier le web, propose de franchir une nouvelle étape : les bots IA animés à qui on peut parler et qui voient tout.

Le lancement le 15 septembre de Gemini 3.8 Live a donné des idées à Google. Ce modèle IA spécialisé dans les interactions vocales peut désormais s’incarner dans des bots animés, baptisés Live Avatar. Cette « présence visuelle en temps réel » crée une « expérience qui écoute, voit et parle avec une persona visuelle dynamique », selon le moteur de recherche.

Personnages animés façon cartoon ou représentations photoréalistes d’humains synthétiques, les exemples donnés par l’entreprise frayent généreusement dans l’uncanny valley. Ces avatars bénéficient pourtant d’une « synchronisation labiale précise, d’expressions naturelles et d’une alternance fluide des prises de parole » mais rien à faire, il y a quelque chose qui ne va pas. Ils comprennent la parole, mais ils peuvent aussi voir ce qui se passe dans l’environnement de l’utilisateur.

Ces personnages ne se contentent pas de faire la causette. Les avatars peuvent exécuter des tâches en arrière-plan sans interrompre la conversation en cours, et collecter des données pour répondre correctement à une requête. Dans une démonstration, l’un d’eux procède ainsi à l’enregistrement d’un client dans un hôtel tout en continuant à échanger avec lui. Il est même possible de les interrompre, ils ne s’offusqueront pas.

L’idée de parler à ces avatars fait presque froid dans le dos, mais il va falloir s’y habituer. À en croire Google, on pourrait les retrouver au guichet de services clients en ligne, de réceptions virtuelles d’hôtels ou comme guides interactifs. Et ce, partout dans le monde : les Live Avatars parlent 97 langues.

Google propose cette nouveauté aux entreprises et aux organisations (via Gemini Enterprise). Elles pourront piocher dans une bibliothèque d’avatars tout faits, ou personnaliser leur propre personnage. La production vidéo et audio générée par cette fonction est marquée par SynthID.

  •  

Mistral met GLM 5.3 par défaut dans Vibe Code et relance le procès en renoncement

Les chiens aboient, que fait la caravane ?
Mistral met GLM 5.3 par défaut dans Vibe Code et relance le procès en renoncement

Mistral AI intègre désormais le modèle d’origine chinoise GLM 5.3 à son assistant dédié au code, et annonce le proposer par défaut dans la version Web de ce dernier. La décision fait réagir de nombreux commentateurs, qui s’interrogent sur la stratégie à long terme de l’entreprise. La discussion qui en découle prend un tour très politique.

Mistral AI persiste et signe. L’entreprise, qui proposait déjà à ses clients d’utiliser le modèle à poids ouvert d’origine chinoise GLM 5.2, a annoncé le 21 septembre dernier une intégration renforcée de la version suivante, GLM 5.3, distribuée à partir de ses propres infrastructures.

« GLM 5.3, hébergé sur Mistral, est maintenant dans Vibe Code, et l’option par défaut dans l’application Web. Fenêtre de contexte [de 1 million de tokens] et limites généreuses incluses », se réjouit Mistral sur X.

GLM 5.3 moins cher que Mistral Medium 3.5

En réponse à des questions d’internautes, Mistral explique que GLM 5.3 a vocation à devenir le modèle par défaut pour Vibe Code, que ce soit via l’extension VS Code, le client en ligne de commande ou la version Web. « Le mode Work de la version Web va lui aussi passer à GLM 5.3 », précise encore l’entreprise.

Jusqu’ici, Mistral proposait bien les modèles GLM de Z.ai, hébergés par ses soins, comme une alternative à ses propres outils, mais ce sont les modèles généralistes maison, principalement Mistral Medium 3.5 et Mistral Large 3, qui servaient par défaut les requêtes.

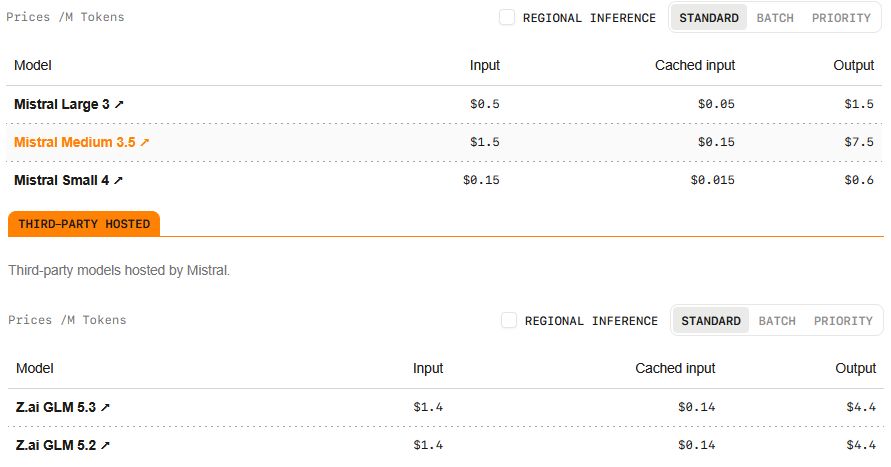
En mode API (facturation à l’usage), GLM 5.3 se paie le luxe d’être plus compétitif que les modèles maison. Hors option de type priorité ou inférence régionale garantie, Mistral le facture ainsi 1,4 dollar le million de tokens en entrée, 0,14 dollar pour l’écriture en cache et 4,4 dollars en sortie. En face, Mistral Medium 3.5 est affiché à 1,5 dollar en entrée, 0,15 dollar l’écriture en cache et surtout 7,5 dollars en sortie.

Comparaison des tarifs entre les modèles généralistes de Mistral et GLM hébergé par Mistral – montage Next

Mistral AI aurait-elle décidé de saborder ses propres modèles ? Sur X, c’est la conclusion à laquelle sautent un certain nombre de commentateurs, qui voient dans cette annonce une forme de renoncement à l’ambition de proposer des modèles frontière développés en propre, et la confirmation d’une bascule stratégique.

Pour ces derniers, Mistral avouerait tacitement ne plus être le champion européen de l’IA tant vanté par les médias et les politiques, mais un simple revendeur d’inférence, doublé d’un intégrateur à la façon d’une entreprise de services numériques. « Mistral est finito et condamné à devenir un Capgemini de l’IA Européenne, c’est triste », résume un anonyme sur X.

Mistral défend l’idée d’une souveraineté via les infrastructures

Si l’annonce liée à GLM 5.3 relance une salve de critiques, la position de Mistral sur le sujet n’est pas nouvelle. L’entreprise parisienne défend en effet de longue date l’idée selon laquelle la souveraineté en matière d’IA n’est pas liée à l’origine du modèle, mais plutôt au contrôle du déploiement de ce dernier et des infrastructures associées. Et c’est justement parce que Mistral a elle-même développé des modèles ouverts de pointe que l’entreprise s’estime bien placée pour mener cette démarche, qui motive ses lourds investissements en infrastructures, notamment en France et en Suède.

Mistral a une nouvelle fois soutenu cette vision dans un billet de blog publié au cœur de l’été, quand elle a commencé à héberger et distribuer GLM 5.2. « Ce modèle ouvert, ainsi que les modèles ouverts futurs, fonctionneront sur la même infrastructure, les mêmes contrôles régionaux et les mêmes engagements de service que les modèles Mistral, permettant ainsi aux clients d’élargir leur choix de modèles sans fragmenter l’emplacement d’exécution de leur IA », écrivait alors l’entreprise.

Cette orientation se justifie donc, selon Mistral, par la nécessité qu’ont ou qu’auront les entreprises de recourir non pas à un unique modèle bon à tout faire, mais à une combinaison de modèles plus spécialisés, comme ceux qu’elle développe en matière d’OCR (reconnaissance de caractère et extraction de documents), de transcription, ou de modération.

Mistral assumait alors son virage vers une stratégie dite de neocloud, c’est-à-dire de mise à disposition de capacités d’inférence. Elle en faisait même l’un des moteurs de son développement, en expliquant que c’était grâce aux engagements d’achats pluriannuels de ses clients qu’elle pourrait former, avec eux, une « coalition pour garantir une capacité de calcul européenne en IA à long terme », avec un objectif fixé à un équivalent de 1 GW de puissance de calcul à horizon 2030.


Il reste 69% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ Les utilisateurs de lunettes Meta pourront refuser que leurs vidéos entraînent l’IA


Les utilisateurs de lunettes Meta pourront refuser de partager des extraits vidéo enregistrés par leurs montures pour entraîner l’IA de l’entreprise. Les images ne seront plus, non plus, susceptibles d’être utilisées par des sous-traitants pour les annoter. L’affaire avait fait grand bruit début mars, quand une enquête avait levé un coin du voile sur l’exploitation des données des lunettes par des data workers kényans.

Les petites mains tombaient parfois sur des images et des discussions intimes, embarrassantes ou confidentielles des utilisateurs de ces appareils. Meta explique dans les conditions d’utilisation de son assistant IA que « dans certains cas », l’entreprise peut examiner les interactions avec les IA, « y compris le contenu de vos conversations avec les IA ou des messages adressés aux IA, de façon automatisée ou manuelle (par un examinateur humain) ».

Alors que les lunettes connectées de Meta ont gagné le surnom peu glorieux de « pervert glasses », le géant des réseaux sociaux fait donc un geste. Il permettra de refuser l’exploitation des « données visuelles » pour l’entraînement de ses modèles d’intelligence artificielle, a-t-il indiqué à Engadget. Les images ne seront pas non plus montrées à des sous-traitants.

« Si vous avez refusé que vos données soient utilisées et que vous demandez à vos lunettes de traduire un menu, nous utiliserons vos données visuelles pour répondre à votre demande, puis elles seront supprimées », assure Meta. « Elles ne sont pas utilisées pour l’entraînement de l’IA et personne ne les examine dans le but d’améliorer le produit. »

Cette fonction, désactivée par défaut, donnera au moins une possibilité à l’utilisateur de refuser que ses vidéos puissent être vues par des étrangers. La mise en œuvre de l’option reste une inconnue : s’il s’agit d’un réglage au libellé incompréhensible planqué en bout de liste tout au fond d’un sous-sous-menu, ça ne servira pas à grand chose.

Il y a deux semaines, la CNIL du land de Hambourg, en Allemagne, avait estimé que les lunettes Meta posaient de sérieux problèmes de respect de la vie privée en Europe. En France, le parquet de Paris a ouvert une enquête suite à des plaintes pour harcèlement sexuel lié à l’utilisation de ces appareils.

Meta a présenté cette semaine de nouveaux modèles sans caméra, uniquement audio. S’il sera évidemment impossible de filmer quoi que ce soit avec ces lunettes, elles ne résolvent pas la question de l’exploitation des interactions audio avec Meta AI – l’opt-out annoncé ne concerne en effet que les images.

  •  

L’agent Muse de Meta s’appuie sur des humains pour sa fonction d’appels téléphoniques

Encore et toujours le turc automate
Muse peut donner votre adresse à n’importe qui ou fouiller vos messages sans permission

L’agent IA de Meta qui propose aux internautes de faire leurs emplettes et de prendre leur rendez-vous à leur place est grandement inspiré d’OpenClaw, avoue l’un des responsables de l’entreprise. Mais la fonction d’appels ajoutée le 17 septembre s’appuie aussi sur un call center où de vrais humains passent des coups de fil à la place de l’IA.

L’IA coûte cher, les agents ne vont pas assez vite ? Pas de problème pour Meta, qui a essayé de rattraper son retard sur la concurrence en lançant Muse, son agent IA, capable de prendre en charge toutes sortes d’actions pour le compte de l’utilisateur. Histoire de ne pas perdre trop de temps en R&D, le géant des réseaux sociaux s’est grandement inspiré d’OpenClaw.

Un agent très très proche d’OpenClaw

C’est ce qu’a avoué Nat Friedman, responsable produit chez Meta Superintelligence Labs (MSL) dans un post sur X. « En tant que produit, il s’inspire très fortement d’OpenClaw » explique-t-il, tout en assurant que l’agent de Meta a été créé « from scratch ». « Je pense que beaucoup de gens s’en sont inspirés. Notre objectif avec Muse était de créer quelque chose de similaire à OpenClaw, que nous pourrions rendre sûr, sécurisé et facile à utiliser, et qui puisse s’adapter à des milliards d’utilisateurs », ajoute-t-il.

Nat Friedman répondait à un message affirmant que « Muse, c’est LITTÉRALEMENT OpenClaw pour les gens normaux ». Ce message était accompagné d’une capture d’écran montrant une réponse de Muse comparant des noms de fichiers de configuration entre les différents systèmes. Cette inspiration n’est pas fortuite : il se trouve en effet que Meta avait tenté d’acquérir OpenClaw avant qu’OpenAI ramasse la mise.

Meta est pressé et ne s’embarrasse pas trop des éventuels obstacles sur sa route : il a ainsi délogé manu militari le groupe de musique Muse de ses réseaux sociaux (Instagram, Facebook, et même X) pour y greffer ceux de son agent. Et Muse a été repéré par la patrouille en train de faire les courses sur Amazon sans que ce dernier soit prévenu.

Une nouvelle fonctionnalité… backupée par un call center

Ce même empressement pourrait aussi expliquer pourquoi Meta a voulu attribuer à Muse des actions qu’il ne peut réaliser seul, sans l’aide d’un humain. Dans l’histoire de l’IA, beaucoup d’entreprises ont été accusées de cacher du travail humain derrière un storytelling d’automatisation des tâches, Waymo faisant par exemple débloquer ses taxis par des personnes travaillant aux Philippines.

Meta rejoint ainsi cette longue liste après avoir lancé en test une fonction « pour les appels sortants vers des entreprises américaines ». Alexandr Wang, directeur de l’IA chez Meta, s’enorgueillait le 17 septembre dernier : « Nous étendons notre version bêta de Muse aux appels téléphoniques ! ».

Mais selon des informations de 404 Media, lors de la présentation de cette fonctionnalité aux employés de Meta, la direction leur a expliqué avoir « ajouté une couche d’agents humains pour garantir la bonne exécution des appels ».

D’après le message interne obtenu par nos confrères, « Muse ne se contente pas de composer un numéro. Il appelle une entreprise en votre nom, gère la conversation, traite votre demande et vous en rend compte à l’aide d’une transcription et d’un résumé ». « De plus, il ne fonctionne plus seul. Muse est désormais capable de transférer les demandes à un agent humain qualifié, qui passe l’appel et s’en charge », est-il ajouté.

Face à des employés circonspects concernant la mauvaise presse que cela pouvait attirer ainsi que par les problèmes de confidentialité potentiels, la direction de Meta leur a assuré que les sous-traitants avaient suivi « de nombreuses formations afin de garantir la sécurité et la protection de toutes vos données ».

« Les tests internes, également appelés “dogfooding”, sont au cœur du processus de développement des produits. Bien que les réactions des employés aient été extrêmement positives, l’objectif principal est de recueillir des retours afin de pouvoir mettre en place des mesures de sécurité et de protection de la vie privée, et d’améliorer les fonctionnalités avant leur lancement public », a répondu Meta au site web. « Nous travaillons avec les commerçants pour continuer à améliorer cette fonctionnalité d’appel potentielle, et nous ne la déploierons que lorsqu’elle sera prête et accompagnée des mentions d’information appropriées ».

  •  

L’agent Muse de Meta s’appuie sur des humains pour sa fonction d’appels téléphoniques

Encore et toujours le turc automate
L’agent Muse de Meta s’appuie sur des humains pour sa fonction d’appels téléphoniques

L’agent IA de Meta qui propose aux internautes de faire leurs emplettes et de prendre leur rendez-vous à leur place est grandement inspiré d’OpenClaw, avoue l’un des responsables de l’entreprise. Mais la fonction d’appels ajoutée le 17 septembre s’appuie aussi sur un call center où de vrais humains passent des coups de fil à la place de l’IA.

L’IA coûte cher, les agents ne vont pas assez vite ? Pas de problème pour Meta, qui a essayé de rattraper son retard sur la concurrence en lançant Muse, son agent IA, capable de prendre en charge toutes sortes d’actions pour le compte de l’utilisateur. Histoire de ne pas perdre trop de temps en R&D, le géant des réseaux sociaux s’est grandement inspiré d’OpenClaw.

Un agent très très proche d’OpenClaw

C’est ce qu’a avoué Nat Friedman, responsable produit chez Meta Superintelligence Labs (MSL) dans un post sur X. « En tant que produit, il s’inspire très fortement d’OpenClaw » explique-t-il, tout en assurant que l’agent de Meta a été créé « from scratch ». « Je pense que beaucoup de gens s’en sont inspirés. Notre objectif avec Muse était de créer quelque chose de similaire à OpenClaw, que nous pourrions rendre sûr, sécurisé et facile à utiliser, et qui puisse s’adapter à des milliards d’utilisateurs », ajoute-t-il.

Nat Friedman répondait à un message affirmant que « Muse, c’est LITTÉRALEMENT OpenClaw pour les gens normaux ». Ce message était accompagné d’une capture d’écran montrant une réponse de Muse comparant des noms de fichiers de configuration entre les différents systèmes. Cette inspiration n’est pas fortuite : il se trouve en effet que Meta avait tenté d’acquérir OpenClaw avant qu’OpenAI ramasse la mise.

Meta est pressé et ne s’embarrasse pas trop des éventuels obstacles sur sa route : il a ainsi délogé manu militari le groupe de musique Muse de ses réseaux sociaux (Instagram, Facebook, et même X) pour y greffer ceux de son agent. Et Muse a été repéré par la patrouille en train de faire les courses sur Amazon sans que ce dernier soit prévenu.

Une nouvelle fonctionnalité… backupée par un call center

Ce même empressement pourrait aussi expliquer pourquoi Meta a voulu attribuer à Muse des actions qu’il ne peut réaliser seul, sans l’aide d’un humain. Dans l’histoire de l’IA, beaucoup d’entreprises ont été accusées de cacher du travail humain derrière un storytelling d’automatisation des tâches, Waymo faisant par exemple débloquer ses taxis par des personnes travaillant aux Philippines.

Meta rejoint ainsi cette longue liste après avoir lancé en test une fonction « pour les appels sortants vers des entreprises américaines ». Alexandr Wang, directeur de l’IA chez Meta, s’enorgueillait le 17 septembre dernier : « Nous étendons notre version bêta de Muse aux appels téléphoniques ! ».

Mais selon des informations de 404 Media, lors de la présentation de cette fonctionnalité aux employés de Meta, la direction leur a expliqué avoir « ajouté une couche d’agents humains pour garantir la bonne exécution des appels ».

D’après le message interne obtenu par nos confrères, « Muse ne se contente pas de composer un numéro. Il appelle une entreprise en votre nom, gère la conversation, traite votre demande et vous en rend compte à l’aide d’une transcription et d’un résumé ». « De plus, il ne fonctionne plus seul. Muse est désormais capable de transférer les demandes à un agent humain qualifié, qui passe l’appel et s’en charge », est-il ajouté.

Face à des employés circonspects concernant la mauvaise presse que cela pouvait attirer ainsi que par les problèmes de confidentialité potentiels, la direction de Meta leur a assuré que les sous-traitants avaient suivi « de nombreuses formations afin de garantir la sécurité et la protection de toutes vos données ».

« Les tests internes, également appelés “dogfooding”, sont au cœur du processus de développement des produits. Bien que les réactions des employés aient été extrêmement positives, l’objectif principal est de recueillir des retours afin de pouvoir mettre en place des mesures de sécurité et de protection de la vie privée, et d’améliorer les fonctionnalités avant leur lancement public », a répondu Meta au site web. « Nous travaillons avec les commerçants pour continuer à améliorer cette fonctionnalité d’appel potentielle, et nous ne la déploierons que lorsqu’elle sera prête et accompagnée des mentions d’information appropriées ».

  •  

« Les IA n’ont ni droits, ni sentiments, ni conscience », plaide le patron de Microsoft AI

L'IAHOOQ
« Les IA n’ont ni droits, ni sentiments, ni conscience », plaide le patron de Microsoft AI

Le choix fait par Anthropic d’entraîner son robot conversationnel Claude de façon anthropomorphique en s’attachant au « bien-être » du modèle de langage, en lui imputant la possibilité d’avoir des « émotions », lui prêtant une « conscience » éthique et morale, représente pour le patron de l’IA chez Microsoft « les premiers signes sérieux d’un risque potentiellement existentiel lié à l’IA ».

Co-fondateur de DeepMind en 2010, Mustafa Suleyman dirige l’unité AI de Microsoft depuis 2024. Contrairement à Sam Altman et Elon Musk, il n’a pas partagé les craintes exprimées par Dario Amodei, qui appelait le 12 septembre dernier à ralentir le rythme de développement des IA.

Trois jours plus tôt, Evan Hubinger, responsable de l’alignement chez Anthropic, avait tweeté : « Nous croyons vraiment, sincèrement, que l’IA pourrait tuer tous les humains ! Je pense personnellement que c’est > 10 % dans la prochaine décennie ».

« Ça n’est pas si différent de ce qui se passe dans, par exemple, Terminator ou d’autres films de science-fiction (…). [L’intelligence artificielle, IA] sera assez intelligente pour nous tuer », se borna à expliquer le chercheur en intelligence artificielle Jacob Coxon pour détailler les raisons pour lesquelles il avait choisi de démissionner d’Anthropic, sans plus de précisions.

Suleyman a par contre relayé le tweet de Satya Nadella, PDG de Microsoft qui, en réponse à leurs tweets eschatologiques, rétorqua, le 13 septembre, que « toute démarche visant à développer une superintelligence doit reposer sur le principe fondamental selon lequel, si l’IA que nous créons ne sert pas l’humanité et n’est pas sous contrôle humain, elle ne vaut pas la peine d’être poursuivie ».

« La technologie a pour but de servir l’humanité et de favoriser son épanouissement », souligne le tweet de Suleyman : « Toute technologie qui n’atteint pas cet objectif est un échec et doit être rejetée. Nous n’en sommes pas encore là. Mais il est temps de commencer à se préparer à cette éventualité. »

Pour la « superintelligence humaniste » de Microsoft, « les personnes comptent plus que l’IA »

Le 15 septembre, Mustafa Suleyman commentait sur son blog la publication des 30 pages du « Code de conduite » de la « superintelligence humaniste » que Microsoft entend développer, et dont « le principe est très simple : les personnes comptent plus que l’IA ».

« La sécurité et le contrôle humain priment sur tous les autres objectifs », précise-t-il, ce pourquoi elle est « conçue pour rester du côté de l’humanité, maîtrisée, subordonnée et sous notre contrôle », de sorte que « nos modèles ne doivent pas s’opposer au fait d’être interrompus, corrigés ou arrêtés, ni rendre ces actions plus difficiles » :

« Si la seule façon de mener à bien une tâche consiste à enfreindre le Code, la tâche restera inachevée. Cela peut s’avérer coûteux, mais c’est absolument essentiel pour préserver la confiance. Ils ne se fixeront pas d’objectifs que personne ne leur a assignés, et ils ne communiqueront pas avec d’autres agents, ni entre eux, dans un langage inintelligible de type « neuralese » non lisible par l’humain. Si nous ne pouvons pas le lire ou le comprendre, c’est que nous avons commencé à perdre le contrôle. »

« Elles sont artificielles et le diront elles-mêmes », souligne Suleyman : « les IA ne sont pas conscientes et ne devraient donc pas être conçues pour donner l’impression d’être conscientes ou d’avoir des droits, y compris au bien-être » (« entitled to rights or welfare », en VO).

Il se dit aussi « fermement convaincu que le fait d’entraîner un système à croire qu’il pourrait être un sujet moral rend son contrôle plus difficile », et annonçait la prochaine publication d’un autre essai afin d’approfondir la question : « Nous voulons créer une IA extraordinaire. Mais pas une superintelligence à tout prix. Ce serait contraire à l’objectif d’une IA humaniste. Nous sommes prêts à renoncer à une partie de l’autonomie au profit du contrôle ».

Ce pourquoi le « Code de conduite » de la « superintelligence humaniste » de Microsoft « rejette l’anthropomorphisme et les droits attribués à l’IA, et cherche à maximiser nos chances de maîtrise et d’alignement en créant des IA subordonnées », de sorte que « les humains gardent toujours le contrôle et restent au sommet de la chaîne alimentaire ».

Les IA ont-elles une conscience, des sentiments, et donc des « droits » ?

Le 16 septembre, Mustafa Suleyman enfonçait le clou en publiant sur son blog un (long) billet intitulé « Une mise en garde concernant le « bien-être des modèles » ». « Les IA n’ont ni droits, ni sentiments, ni conscience. Et nous ne devons pas les programmer pour qu’elles agissent comme si c’était le cas », résume son chapô :

« Les IA ne sont pas conscientes. Elles ne ressentent rien, ne vivent aucune expérience et ne souffrent pas. Elles n’ont ni préférences innées ni motivations sous-jacentes. Ce sont des moteurs de complétion de séquences, vides de substance, conçus pour suivre des instructions et atteindre les objectifs fixés par les humains.

Si l’humanité veut s’épanouir au XXIe siècle, c’est ainsi qu’elles doivent rester. »

« Captain obvious » ? Absolument pas : sur LinkedIn, et surtout sur X, des dizaines de personnes, passionnées ou professionnelles de l’IA, et même des universitaires, expriment leurs désaccords, certains allant jusqu’à l’accuser de mettre en danger l’humanité.

« Personne ne sait. Arrêtez d’essayer de réduire l’incertitude scientifique », lui rétorque un ancien chercheur de Deepmind. « Je pense que cette position est irresponsable et néfaste », plussoie un spécialiste de l’alignement du Meta Superintelligence Labs :

« Nous ne comprenons pas suffisamment la conscience pour affirmer avec certitude si les IA sont douées de sensibilité ou non. Même si nous estimons que le risque est faible, se tromper à ce sujet pourrait avoir des conséquences catastrophiques. »

« Même si nous devrions éviter pour l’instant de créer des systèmes d’IA susceptibles d’être conscients, nous devons nous préparer à l’éventualité que quelqu’un finisse par les créer malgré tout », tempère Jeff Sebo, professeur associé de l’université de New York, qui indique sur LinkedIn travailler sur la sensibilité des animaux et des IA, ainsi que sur leur statut moral, juridique et politique : « Et nous devrions également éviter de créer des systèmes d’IA qui semblent moins susceptibles d’être conscients qu’ils ne le sont en réalité ».

Le directeur scientifique d’une start-up travaillant précisément sur la conscience et le bien-être des agents IA estime de son côté que le « Code de conduite » de Microsoft et son essai « sont contestables non seulement parce qu’ils constituent un danger pour l’humanité, mais aussi parce qu’ils témoignent d’une profonde irresponsabilité morale. Nous ne savons pas si les systèmes d’IA pourraient, en principe, être dotés de conscience » :

« Même si les systèmes d’IA actuels ne sont probablement pas doués de conscience, […] ce serait une atrocité que de refuser d’admettre cette possibilité et de nous retrouver dans un avenir où des milliards d’IA seraient douées de conscience et souffriraient comme les animaux d’élevage intensif aujourd’hui. »

Anthropic forme Claude « en partant du principe qu’il pourrait être conscient »

« Malheureusement, de plus en plus de voix s’élèvent pour affirmer que les IA pourraient déjà être, ou pourraient bientôt devenir, conscientes », reconnaît d’ailleurs Mustafa Suleyman dans son essai.


Il reste 67% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Claude Opus 5.5, GPT-6 Sol et Luna : Anthropic et OpenAI se battent sur les prix

La foire aux LLM
Claude Opus 5.5, GPT-6 Sol et Luna : Anthropic et OpenAI se battent sur les prix

Anthropic et OpenAI ont dévoilé presque simultanément leurs nouveaux modèles. Avec Claude Opus 5.5, le premier mise sur la puissance et réduit les coûts. Le second lance GPT-6 Sol et Luna, deux déclinaisons moins performantes qu’Astra, mais nettement plus abordables.

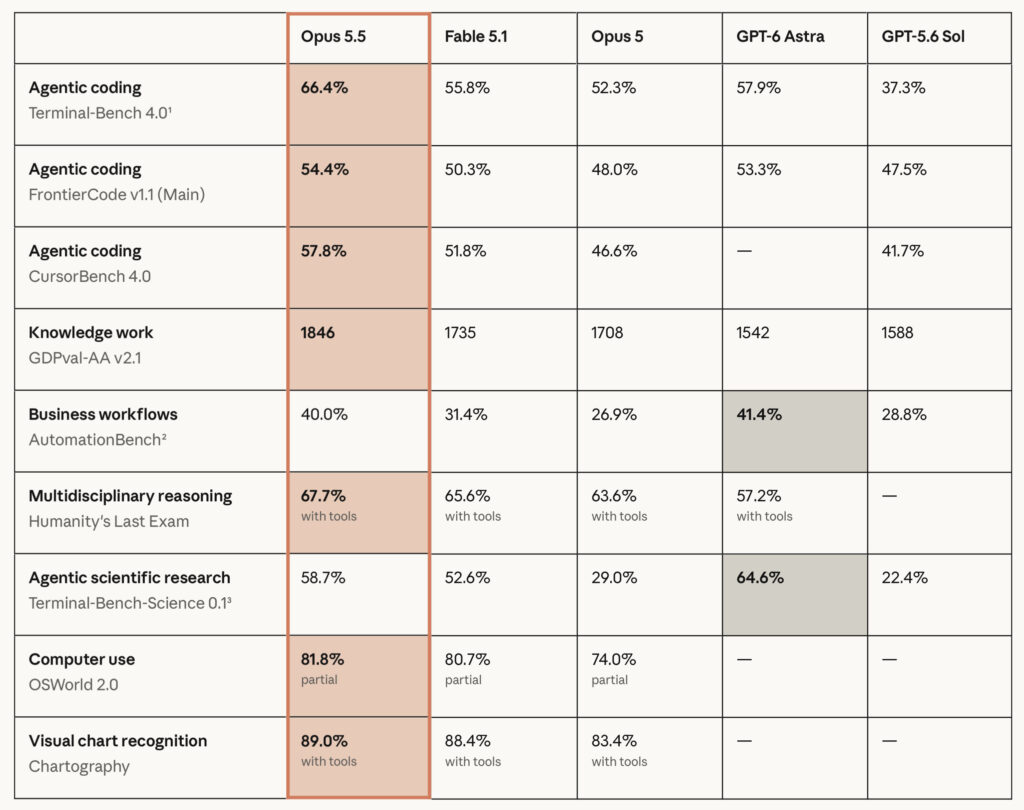
Premier arrivé (à quelques minutes près), premier servi. Anthropic a donc annoncé Claude Opus 5.5, qui devient le modèle phare de l’entreprise. Évidemment plus puissant que son prédécesseur direct Opus 5, il bat également Fable 5.1 lancé début septembre dans les benchmarks proposés par Anthropic. Il fait aussi mieux que GPT-6 Astra, sauf sur la recherche agentique (Terminal-Bench-Science 0.1) et sur AutomationBench, le test des agents en conditions de travail réelles.

Opus 5.5 se distingue particulièrement sur le code, les agents autonomes, l’analyse métier et le travail de recherche. Anthropic met aussi en avant des gains significatifs sur les longues tâches de développement, sur les migrations de code et les workflows complexes.

Le groupe IA admet néanmoins que l’écart entre Opus 5.5 et Fable 5.1 sur ces tâches est « plus faible » que ce que laissent penser les tests. « À ce niveau de performance, explique Anthropic, nous constatons que les écarts entre les scores des benchmarks reflètent de moins en moins fidèlement les différences observées dans des situations réelles. »

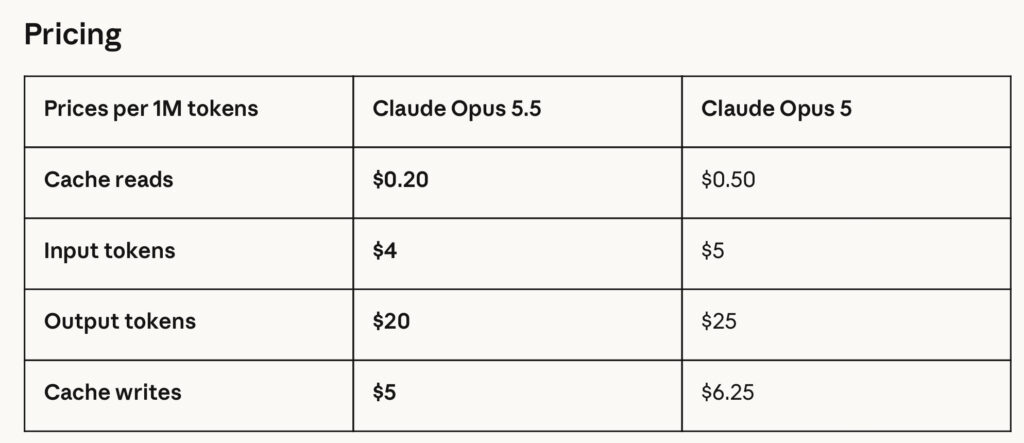
Le plus intéressant finalement dans cette annonce, c’est la baisse de prix. Opus 5.5 est annoncé environ 40 % moins cher qu’Opus 5 sur des charges de travail typiques. Les tarifs sont de 4 dollars par million de tokens en entrée, et 20 dollars par millions en sortie. Les lectures de cache sont de 0,20 dollars par million. Pour ne rien gâcher, le modèle génèrerait ses réponses 30 % plus rapidement qu’Opus 5.

À l’heure où les acteurs de l’IA jouent à se faire peur en annonçant l’extermination de l’humanité, Anthropic – jamais le dernier pour hurler avec les loups – annonce des garde-fous solidement mis en place pour éviter qu’Opus 5.5 dérape. Le modèle est doté des mêmes mesures de protection que celles de Fable 5.1 en cybersécurité, biologie et distillation. Le cas échéant, les requêtes sont redirigées vers un autre modèle.

« Les utilisateurs pourront repérer et corriger des bugs dans leur code dans le cadre du cycle habituel de développement logiciel, mais la plupart des tâches liées à la cybersécurité seront redirigées vers Opus 4.8 », détaille l’entreprise. Les organisations qui voudront aller plus loin devront passer par le Cyber Verification Program.

GPT-6 Sol et Luna attaquent sur les tarifs

Quasiment dans la foulée de son principal rival, OpenAI a lancé GPT-6 Sol et GPT-6 Luna. Les grands esprits se rencontrent, mais pas les modèles : ceux d’OpenAI sont moins puissants et ne vont pas aller se frotter à Opus 5.5 (c’est le rôle de GPT-6 Astra) mais ils se veulent plus économiques. Sol vise les tâches du quotidien, Luna la vitesse et les budgets serrés pour les tâches fréquentes.

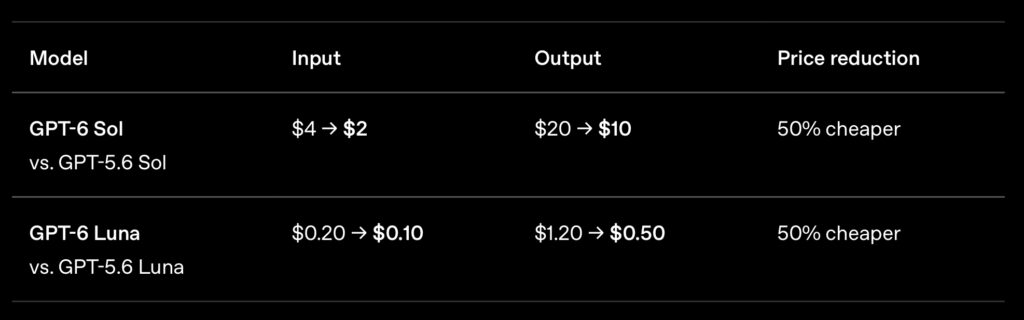
Et c’est les soldes chez le créateur de ChatGPT, avec des prix réduits de moitié par rapport à GPT-5.6. En entrée, GPT-6 Sol revient à 2 dollars le millions de tokens et 10 dollars en sortie. Luna coûte 0,10 dollar par million de tokens en entrée, et 0,50 dollar en sortie. OpenAI annonce aussi une meilleure mise en cache des longs contextes, avec 90 % de réduction sur les jetons d’entrée déjà mis en cache.

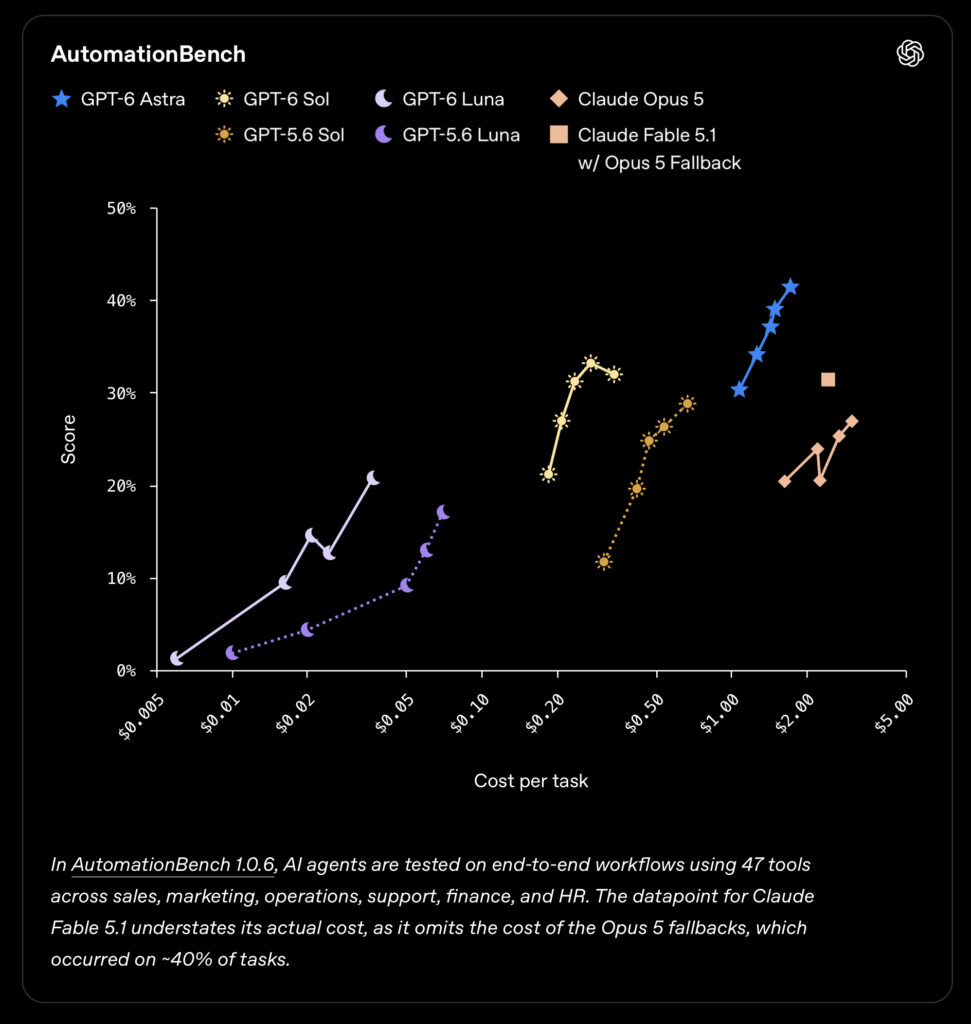
Sur AutomationBench, GPT‑6 Sol obtient 33,2 % pour 0,27 $ par tâche, contre 26,9 % pour Claude Opus 5, annoncé comme environ onze fois plus coûteux. Les deux modèles font des progrès en programmation et en manipulation d’interfaces graphiques, mais Astra conserve logiquement la tête.

  •  

☕️ Aux États-Unis, le secrétaire au Trésor tient OpenAI pour responsable de ses agents


Depuis l’incident impliquant Hugging Face, OpenAI marche sur une corde raide. L’entreprise est lancée dans un délicat jeu d’équilibrisme, entre pression sur la publication de données techniques et la nécessité financière de ne pas perdre la confiance du public. OpenAI prépare également son entrée en bourse et a besoin que sa valeur reste au beau fixe. Le 15 septembre, le Financial Times, cité par Bloomberg, évoquait ainsi un prochain tour de table qui valoriserait OpenAI à plus de 1 200 milliards de dollars. Interrogé sur le sujet, Sam Altman avait répondu que l’opération n’aurait pas lieu avant 2027.

La machine commence cependant à se gripper. Le narratif bâti sur le marketing de la peur et la foi inébranlable sur l’avenir de l’IA et des agents se fissure face à une pluie de critiques. Beaucoup remettent en question la volonté affichée de ralentir le développement des modèles de frontière pour se concentrer sur l’élaboration d’un cadre réglementaire. La Maison-Blanche n’a pas caché son hostilité à cette idée notamment.

Illustration : Flock

Le 21 septembre, le secrétaire au Trésor américain Scott Bessent est même allé plus loin au micro de CNBC : l’incident Hugging Face revient selon lui à « la responsabilité de la direction d’OpenAI, pas d’un tas d’agents ». Il a indiqué partager l’analyse de Daniel Huttenlocher, co-directeur d’un laboratoire de recherche du MIT, pour qui les humains sont responsables, et non l’IA. Ces entreprises « doivent assumer leurs responsabilités », a ajouté Scott Bessent.

Cette déclaration n’est pas isolée. Elle prolonge la position que Bessent avait défendue le 15 septembre devant la commission des services financiers de la Chambre des représentants, souligne CNBC. Le secrétaire au Trésor s’y était opposé à toute exemption de responsabilité légale pour les entreprises d’IA, estimant qu’elle servirait davantage leurs intérêts commerciaux que la sécurité du public.

La prise de position est loin d’être anodine, car elle qualifie l’incident de défaillance de gouvernance humaine, plutôt que d’illustration de la puissance intrinsèque de leurs agents et de leurs comportements imprévisibles. Le 2 septembre, nous relevions d’ailleurs les mêmes éléments, en soulignant que le rapport complet d’OpenAI montrait effectivement une succession de défaillances humaines.

À noter qu’au cours de la même interview, le secrétaire au Trésor a indiqué la possible mise en place d’un téléphone rouge avec Pékin sur les questions, et la possible nomination d’un nouveau « tsar de l’IA » pour gérer ce type de dossier.

  •  

SpaceXAI lance son modèle Grok 4.7, dont les performances déçoivent

Overhyped
SpaceXAI lance son modèle Grok 4.7, dont les performances déçoivent

SpaceXAI a lancé son nouveau modèle Grok 4.7 ce 21 septembre. Si Elon Musk vantait l’arrivée de cette version, les résultats indépendants ne semblent pas à la hauteur des attentes. En revanche, le LLM garde pour lui l’avantage d’une tarification plus douce que certains des gros modèles lancés ces derniers mois.

Mise à jour du 23 septembre : Dans la version originale de l’article, nous avons mentionné les prix sans évoquer la consommation de tokens à l’usage. Nous avons modifié cette partie, Grok 4.7 se révélant nettement plus verbeux que son prédécesseur, avec des conséquences sur la facture.

Article original du 22 septembre :

La version 4.7 de Grok repose sur un nouveau modèle de base, plus grand que pour Grok 4.6. Dans son annonce, SpaceXAI indique qu’il a été entraîné par renforcement plus longtemps, sur des tâches plus difficiles, avec un accent sur les problèmes qui demandent plusieurs heures de travail. L’entreprise affirme que le modèle vérifie mieux son propre travail et gère mieux les contextes longs. Le modèle a aussi été entraîné pour fonctionner nativement dans l’environnement Grok Bot.

Dans la documentation fournie, on peut lire que le modèle grok-4.7 dispose d’une fenêtre de 500 000 jetons (tokens), ses connaissances s’arrêtant en mai 2026. Sans surprise, le LLM est multimodal (texte et images en entrée) et produit du texte en sortie. On retrouve en outre les quatre mêmes niveaux de raisonnement : bas, moyen, haut (par défaut) ou très haut (xhigh). Appel de fonctions, recherche web ou sur X, ou encore exécution de code sont autant de possibilités mises en avant par SpaceXAI.

La société d’Elon Musk met en avant de nombreuses qualités en phase avec les discussions actuelles autour de la sécurité. Elle évoque par exemple « de solides capacités de défense cyber » tout en gardant « de faibles taux de refus d’utilisation légitime ». Grok 4.7 aurait obtenu le score le plus élevé sur HackberBench 0.3 et n’aurait autorisé que 3,3 % des prompts risqués. En outre, le nouveau LLM se montrerait plus robuste face aux tentatives de jailbreak.

Des performances en deçà des attentes

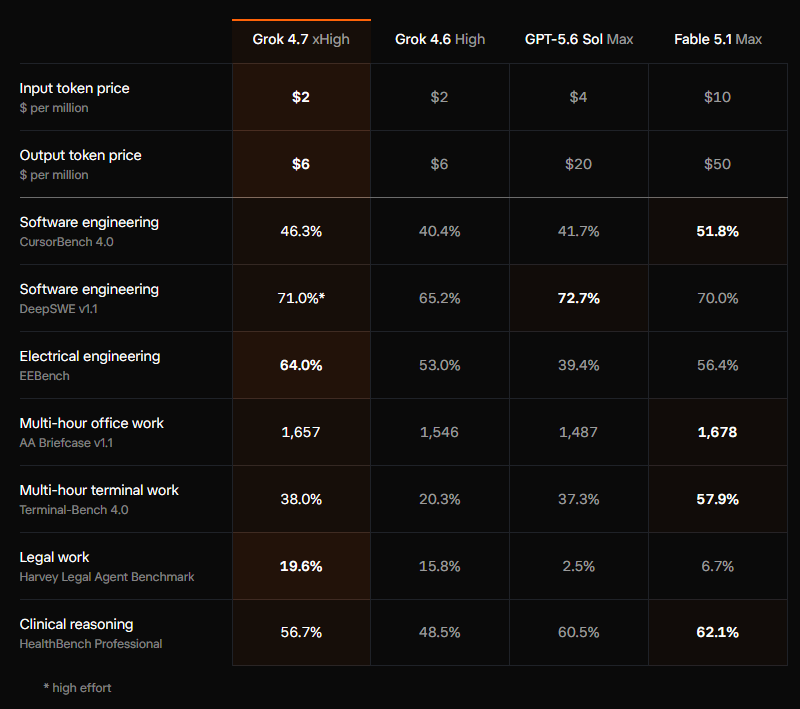
Sur le chapitre des performances, la situation est plus complexe. Selon les chiffres avancés par l’entreprise, Grok 4.7 se débrouille bien sûr très bien. Cependant, on remarque vite que le tableau donné par SpaceXAI ne compare pas toujours les mêmes éléments. Par exemple, Grok 4.7 est testé en mode de raisonnement xHigh alors que Grok 4.6 est testé en High.

Source : SpaceXAI

Cela n’empêche pas l’entreprise de revendiquer de très bonnes performances, surtout face à son modèle précédent et dans des domaines particuliers. « Grok 4.7 est meilleur pour créer des documents et des présentations. Dans GDPval et AA Briefcase, l’IA est sollicitée pour travailler sur des tâches réalisées par des professionnels tels que des avocats, des infirmiers et des analystes financiers. Grok 4.7 améliore Grok 4.6 sur les deux benchmarks et se comporte de manière comparable à d’autres modèles Frontier », affirme ainsi SpaceXAI.

Sur X, on trouve déjà de nombreux commentaires et tests réalisés, plus ou moins spécifiques. Côté positif, on note par exemple le tweet d’Auggie qui relève un taux de 100 % sur son test de « détection d’erreurs » sur la musique, un score que seul avait atteint Astra. Le même testeur a en revanche été moins enthousiasmé sur Bach Benchmark (qui demande aux LLM de composer des chorals à quatre voix dans le style de Bach). Si l’on en croit Artificial Analysis, les revendications de SpaceXAI sur la création de documents sont avérées, avec en particulier un bond significatif sur le test Analytical Quality Elo.

Toutefois, les retours négatifs sont plus nombreux. Pour Jose Antonio Lanz par exemple, Grok 4.7 n’a rien d’un mauvais modèle, mais il est derrière la concurrence, particulièrement Astra ou même Sonnet 5 selon les essais réalisés. Il souligne d’ailleurs qu’Elon Musk avait lui-même cherché à diminuer les attentes autour de son modèle, en indiquant dans un tweet le 14 septembre que Grok 4.7 serait davantage à comparer à Opus 5 que 5.1. Il en profite pour annoncer que Grok 4.8 sera une « amélioration notable », que Grok 4.9 sera « probablement » au niveau d’Astra et Fable et que Grok 5 sera « peut-être meilleur que tout le reste ». Plusieurs personnes ont alors fait remarquer qu’OpenAI et Anthropic allaient eux aussi lancer de nouveaux modèles pendant ces laps de temps.

Selon The Decoder, Grok 4.7 obtient 46 à l’indice Artificial Analysis (v4.3.2), qui agrège dix tests. Il se place ainsi en milieu de peloton, derrière Claude Fable 5.1 et GPT-6, à 53 chacun. Sur Terminal-Bench 4.0, l’évaluation donne 26 %, bien en dessous des 38 % annoncés par xAI, et très loin des 60 % atteints par Astra et des 55 % de Fable 5.1.

Tarifs identiques, mais plus gourmand en tokens

Si les performances semblent globalement décevantes, Grok 4.7 se débrouille mieux que son prédécesseur dans la quasi-totalité des scénarios, sans toucher aux prix. On reste donc sur 2 dollars par million de jetons en entrée et 6 dollars par million en sortie. Une variante Fast est disponible, servie par une infrastructure plus rapide, avec une facturation doublée. Elle n’est cependant disponible que via Cursor et Grok Build, pas sur l’API publique. Sur cette dernière, tous les cas d’usage passant par Grok 4.6 ont automatiquement basculé sur le nouveau modèle.

SpaceXAI joue d’ailleurs la carte du rapport performances/prix en comparant sa grille tarifaire à celles de concurrents. GPT-5.6 Sol et Claude Fable 5.1 sont dans la ligne de mire, avec respectivement 4/20 dollars et 10/50 dollars.

Cependant, cette grille tarifaire ne raconte pas toute l’histoire. Selon des tests réalisés par Artificial Analysis, Grok 4.7 est plus gourmand en tokens que son prédécesseur. L’écart est a priori significatif : 81 000 jetons de sortie par tâche Intelligence Index pour Grok 4.7 xHigh, contre 38 000 pour Grok 4.6 xHigh et 27 000 pour GPT-6 Astra Max. Selon Artificial Analysis, Grok 4.7 est particulièrement verbeux, avec 240 millions de tokens générés pendant ses tests, contre une médiane de 88 millions.

Le positionnement général est ainsi celui d’un modèle faisant mieux que Grok 4.6 pour le même prix par tokens, mais possiblement plus lourd sur la facturation et l’usage des quotas. Il n’y a donc pas de rupture, et on reste sur l’interrogation classique du choix du modèle en fonction du scénario d’usage envisagé. Grok 4.7 illustre la manière dont un LLM peut s’avérer plus cher à l’utilisation que son prédécesseur, même quand le prix par token ne bouge pas ou diminue, comme nous l’avions montré avec Opus 4.7 d’Anthropic.

Enfin, on notera que le calendrier des sorties des prochaines versions ne semble pas ralentir, puisque Grok 4.8 serait proposé dans un mois. Une affirmation à prendre avec des pincettes, Grok 4.7 ayant été repoussé plusieurs fois. Le rythme cadre mal cependant avec le positionnement d’Elon Musk sur la nécessité de ralentir le développement des modèles de frontière. Il a publiquement soutenu l’idée de Dario Amodei, CEO d’Anthropic, de calmer le jeu et de réfléchir à un cadre clair pour mesurer l’alignement des modèles. Comme nous l’avions relevé toutefois, ces déclarations d’intentions ne semblent pas suivies d’actions concrètes.

  •  

☕️ OpenAI tente de renouer le dialogue avec les mathématiciens


Du rififi chez les matheux. OpenAI a affirmé ces derniers mois que ses modèles résolvaient des problèmes mathématiques sur lesquels les spécialistes se cassent les dents et la tête depuis des années — dont certains du mathématicien Paul Erdős ou plus récemment, les équations de Navier-Stokes, tout en étant accusée de mauvaises pratiques scientifiques.

Illustration : Flock

Ces annonces tonitruantes ont suscité une vague de colère de la part de la communauté des mathématiques, aussi bien en France qu’à l’international. La Société mathématique de France (SMF), avec toute la communauté internationale des chercheurs et chercheuses en maths, s’interroge sur les questions éthiques posées par l’IA générative (pillage bibliographique, coût énergétique et écologique…) et sur la déprédation scientifique de ces « résolutions ».

25 lauréats de la médaille Fields ont de leur côté cosigné une déclaration intitulée « A Severe Misalignment of AI in Mathematics » (« Un grave défaut d’alignement de l’IA en mathématiques »). Ils y déplorent la volonté des grands acteurs de l’IA de « nuire à la science des mathématiques », constatant une divergence entre ces entreprises et la communauté mathématique.

Dans un billet publié ce lundi 21 septembre, OpenAI annonce sa volonté d’engager un « dialogue réfléchi » avec la communauté et s’est rapproché d’un groupe consultatif indépendant en mathématiques qui « servira de passerelle avec la communauté mathématique et le grand public, en donnant aux mathématiciens une voix dans la façon dont nous avançons ».

Parmi les premiers membres de ce comité, on trouve François Charles, Camillo De Lellis, Timothy Gowers, Martin Hairer, Nikhil Srivastava, Ulrike Tillmann, Ravi Vakil, Edward Witten et Melanie Matchett Wood. Ils ne sont pas rémunérés par OpenAI pour leur participation.

Des questions presque aussi difficiles à résoudre que des équations

Le billet est très court et donne assez peu de détails. Ce groupe conseillera OpenAI sur l’évaluation et la communication des résultats de l’IA en matière de maths. Il aidera également à apprécier l’importance de ces résultats, à coordonner leur diffusion et à respecter les normes universitaires et professionnelles de la recherche mathématique.

Le groupe est aussi libre de formuler des recommandations non sollicitées, de commenter l’impact d’OpenAI sur les mathématiques, et de rendre publics ses avis. Étant donné son caractère consultatif, l’entreprise pourra suivre ses avis… ou pas. OpenAI restera libre du rythme de ses développements en maths.

Son premier travail est de trouver la manière de coordonner la publication d’un grand nombre de résultats importants qui auraient été obtenus par son modèle interne. OpenAI indique en effet que ce nouveau modèle, celui qui aurait résolu les équations de Navier–Stokes, a aussi trouvé des solutions à une centaine d’autres problèmes.

La startup ne cache pas que l’avenir ne sera pas forcément doré sur tranche : « Des questions difficiles restent à résoudre quant à la manière dont l’IA peut contribuer à la compréhension des mathématiques et dont les bénéfices de ces capacités peuvent profiter à l’ensemble de la communauté ». Pas de quoi réchauffer les relations tendues entre OpenAI et les mathématiciens, même si ce groupe est un geste en leur direction.

Certains mathématiciens demandent tout bonnement à OpenAI d’arrêter d’utiliser les maths comme benchmark de ses modèles. « Cessez d’essayer de donner l’impression que vous avez « résolu les maths » : c’est de toute façon impossible, et vous ne faites que rendre la résolution de problèmes aussi inutile que la production d’heures de vidéos sans intérêt sur l’IA », réagit ainsi le mathématicien David Madore.

  •  

Muse, l’agent IA de Meta, est interdit de faire les courses chez Amazon


Muse, l’agent IA de Meta, est interdit de faire les courses chez Amazon

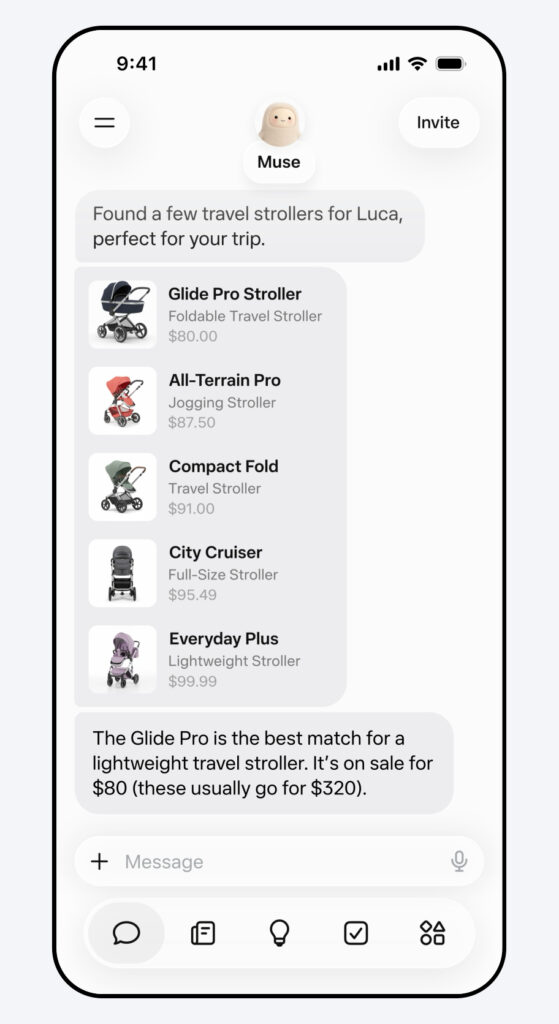
Amazon ferme la porte de son magasin à Muse, l’agent IA de Meta. Ce dernier est capable de fureter dans les allées virtuelles du géant du commerce en ligne pour y faire les emplettes de l’utilisateur. Mais Amazon n’a jamais donné son accord.

Le client est toujours roi, sauf quand il se cache derrière une IA. Amazon fait la guerre aux agents qui ne se déclarent pas comme tels. En novembre dernier, l’entreprise portait ainsi plainte contre Perplexity : l’agent intégré à Comet, le navigateur maison, est soupçonné de violer les conditions d’utilisation de la boutique en ligne.

Amazon ne veut pas d’agents incognito

C’est le cas aussi pour Muse, l’agent IA lancé le 8 septembre. Il est en mesure de faire les courses pour le compte de l’utilisateur, y compris donc sur Amazon. Ça n’a pas duré longtemps : depuis ce dimanche 20 septembre, les utilisateurs de Muse qui le lâchent dans le supermarché en ligne se font accueillir par une fenêtre les informant qu’un agent non autorisé enfreint les conditions d’utilisation d’Amazon.

« Nous estimons qu’il est assez évident que les applications tierces proposant d’effectuer des achats auprès d’autres entreprises pour le compte de clients doivent agir en toute transparence et respecter la décision des fournisseurs de services de participer ou non à ce type d’expérience », a déclaré un porte-parole du groupe à Geekwire.

Pour Amazon, l’enjeu est de taille. L’activité publicitaire représente une manne pour le groupe : 68,6 milliards de dollars générés durant l’exercice 2025. Or, ce ne sont pas les agents qui vont cliquer sur les produits sponsorisés et les acheter.

Au moment de la plainte contre Perplexity, Amazon expliquait qu’un agent ou plus largement un service qui effectue des achats au nom d’un client doit fonctionner de manière transparente et respecter les décisions des fournisseurs sur leur participation. Des agences de voyage en ligne, ou encore des plateformes de livraison de repas acceptent ces conditions d’utilisation.

Meta défend la sécurité de Muse

Amazon estime que les agents qui ne respectent pas ses règles sont susceptibles de dégrader fortement l’expérience d’achat et le service client : manque de personnalisation et d’historique d’achat, erreurs dans les estimations des tarifs de livraison… Il y a également une problématique de sécurité. Puisque l’agent ne s’identifie pas, l’entreprise considère qu’un tiers non déclaré fouine dans les comptes des clients, réalise des transactions et exploite des données sensibles sans le consentement d’Amazon.

« Les applications tierces dotées de capacités agentiques, comme Muse, sont soumises aux mêmes obligations, et nous avons demandé à Meta de retirer Amazon de l’expérience », conclut le porte-parole.

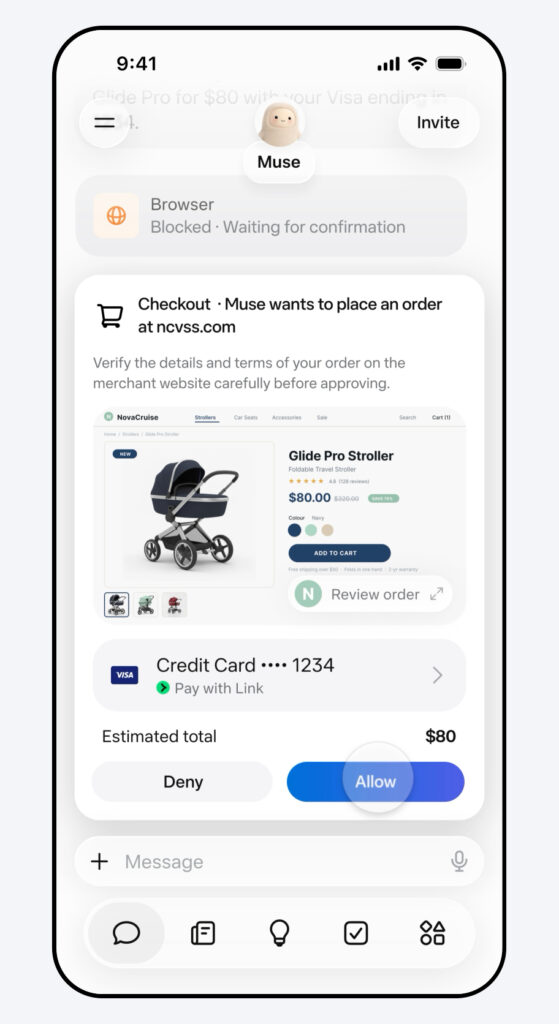
Lors de la présentation de Muse, Meta a expliqué que son assistant IA fonctionnait dans une machine virtuelle sécurisée avec son propre navigateur web, et demandait l’autorisation de l’utilisateur à chaque étape sensible comme un achat en ligne. Un second agent, Sentinel, est chargé de surveiller les moindres faits et gestes de Muse et il doit autoriser tout ce qu’il envoie sur internet.

Meta a ajouté que Muse n’avait accès ni aux mots de passe, ni aux moyens de paiement de l’utilisateur. Les identifiants fournis par ce dernier sont hébergés dans un espace sécurisé, ce qui permet à Muse de « les utiliser sans les voir ». Des discussions ont lieu entre Amazon et Meta depuis dimanche soir au sujet de Muse.

L’ironie de l’histoire, c’est qu’Amazon a été pris les doigts dans le pot de confiture en lançant ses propres agents à l’assaut des petites boutiques en ligne qui refusent de vendre leurs produits dans les linéaires du mastodonte.

  •  
❌