❌

Vue lecture

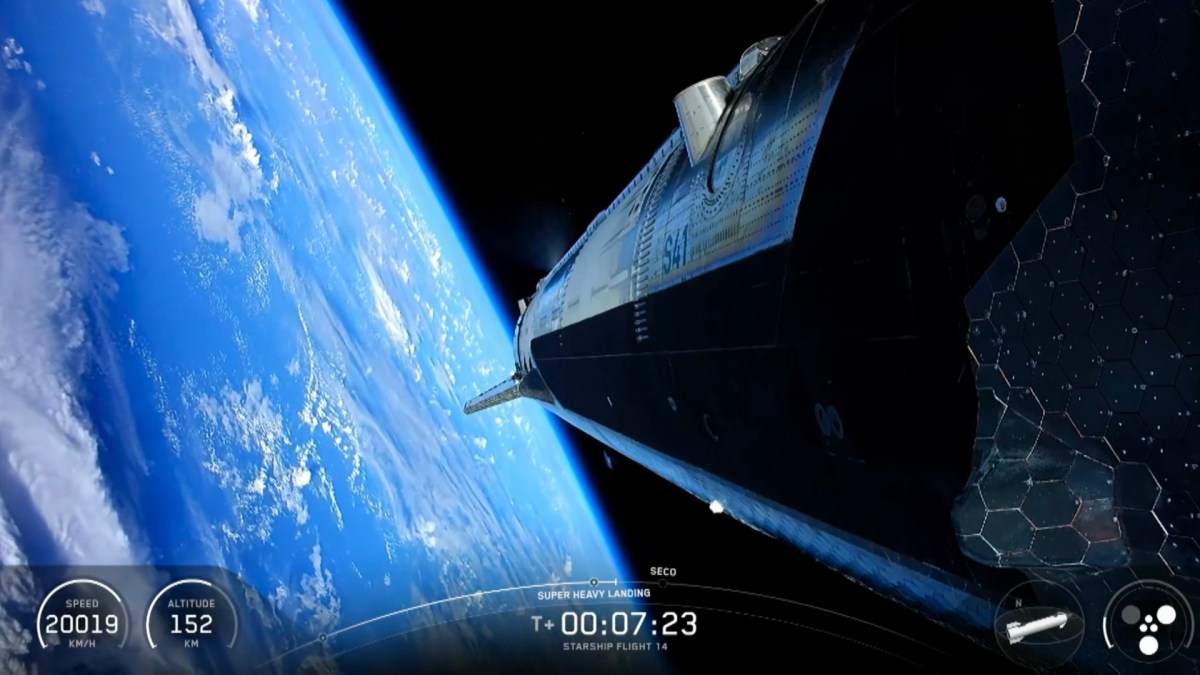
Le 14e vol du Starship était historique, mais le record absolu lui échappe

SpaceX a placé 26 satellites Starlink V3 en orbite ce lundi 28 septembre 2026, lors du 14e vol de son Starship. Ils pèsent environ 52 tonnes au total. Une infographie publiée sur X classe ce chargement au troisième rang des plus lourds de l'histoire, derrière la navette soviétique Bourane et la station américaine Skylab.

  •  

L’Allemagne se lance concrètement pour sauver les données climatiques menacées par Trump

Retten wir die Daten
L’Allemagne se lance concrètement pour sauver les données climatiques menacées par Trump

L’Allemagne se lance dans la résilience des données scientifiques sur le climat en finançant plusieurs projets et en mettant à disposition son data center créé en 2022 pour abriter les données allemandes sur le sujet. Reste que les financements ne sont pour l’instant pas pérennes et devront être renouvelés après 2027.

Depuis le retour de Donald Trump au pouvoir, les données sur le climat stockées par les États-Unis sont menacées. Les chercheuses et chercheurs allemands mettent maintenant en place des infrastructures pour les protéger.

Dès janvier 2025, des chercheurs et militants états-uniens ont essayé de prémunir les informations et données des agences de leur suppression. Mais l’attaque de l’administration Trump contre les données scientifiques est massive. 375 jeux de données ont déjà été touchés, selon le relevé du projet dataindex.us. Politico vient de son côté de révéler que des associations conservatrices traquent les chercheurs américains sur le climat en faisant nombre de demandes d’accès à des documents administratifs.

En Europe, une certaine volonté de les aider est affichée. L’année dernière, le directeur général délégué à la science du CNRS, Alain Schuhl affirmait que les bases de données sont « l’urgence absolue ». Mais, depuis, la plus importante structure scientifique française a encore vu son budget baisser avec le constat d’ « un net désengagement de l’État ». Et aucun projet de financement français ne semble émerger alors que la direction du CNRS s’est lancée dans une réorganisation du monde de la recherche.

Concrétisation en Allemagne

C’est d’outre-Rhin que des initiatives plus concrètes semblent arriver. Ainsi, comme l’explique le magazine de l’École de l’environnement de Yale, plusieurs racks qui vont être ajoutés dans le German Climate Computing Center (DKRZ) pour accueillir les données jusque-là stockées par les laboratoires américains. Les capacités de stockage du DKRZ, actuellement de 254 pétaoctets, se voient augmenter de 5 pétaoctets qui doivent être alloués à la sauvegarde des données venant des projets américains.

La Fondation allemande pour la recherche (DFG) a obtenu de son gouvernement des financements visant à sécuriser les référentiels de données menacés et à promouvoir la résilience des données. En tout, l’Allemagne prévoit de financer 10 projets autour de cette « résiliences des données ».

Le projet SEND Earth Data va, par exemple, identifier les jeux de données et les services à risque et mettre en place des systèmes de redondance « là où cela s’avère nécessaire et en élaborant des stratégies durables pour leur conservation et leur accessibilité à long terme ». L’idée n’est pas seulement de faire des backups mais d’instaurer des standards pour l’acquisition des données, s’assurer de leur qualité, de leur enrichissement par des métadonnées et de leur conservation à long terme.

Certains chercheurs allemands ont déjà identifié des besoins. Ainsi, un autre projet, nommé CMIP7-ark, a prévu de mettre en place sur le DKRZ ce qu’ils appellent une « zone de réplication d’urgence » pour « dupliquer les flux de données américains hautement prioritaires dès leur publication » concernant le CMIP7, un projet international de comparaison des modèles climatiques.

« Bien que les données soient diffusées par l’intermédiaire de l’Earth System Grid Federation (ESGF), les faiblesses structurelles et les coupes budgétaires prévues au sein des agences scientifiques américaines (NASA, NOAA, NCAR, DOE) menacent la stabilité opérationnelle de leurs nœuds de données locaux », expliquent-ils. « Toute interruption de l’accès créerait un « vide de données » critique, entravant gravement les capacités de recherche allemandes en matière de détection de signaux climatiques à haute résolution et de modélisation comparative du système terrestre ».

Des projets de résilience des données au-delà du climat

Les projets de « résilience des données » ne s’arrêtent pas au climat. Ainsi, le biologiste Lorenz Christian Reimer a convaincu la DFG de financer l’intégration des données de transcriptions de gènes du projet RegulonDB, créé en 1998 et financé jusqu’à récemment par le NIH américain, dans l’outil DSMZ Digital Diversity géré par son équipe.

La DFG finance aussi un projet qui veut « répondre au besoin urgent de créer une plateforme européenne dédiée au dépôt des données biomoléculaires de résonance magnétique nucléaire (RMN), actuellement stockées, annotées et gérées par le BMRB aux États-Unis ».

Mais un financement non pérenne

L’Allemagne semble donc avoir mis les mains dans le cambouis de la « résilience » des données de la science, jusque-là très souvent stockées par les diverses agences états-uniennes. Si on peut saluer l’effort, notons quand même que la DFG souligne dans ses « guidelines » [PDF] que « cette initiative de financement est limitée aux années 2026 et 2027 » et que les « projets peuvent bénéficier d’un financement jusqu’au 31 décembre 2027 au plus tard ; cette date marque également la fin de la durée du projet ».

Ce financement « par projet », qui s’est généralisé depuis des années dans la recherche européenne et qui limite sa portée à quelques années, est en contradiction avec la résilience des données qui demande que l’engagement de financement s’étale sur le long terme. Les chercheurs qui les portent vont devoir espérer que d’autres institutions, allemandes ou européennes, acceptent de reprendre le flambeau.

  •  

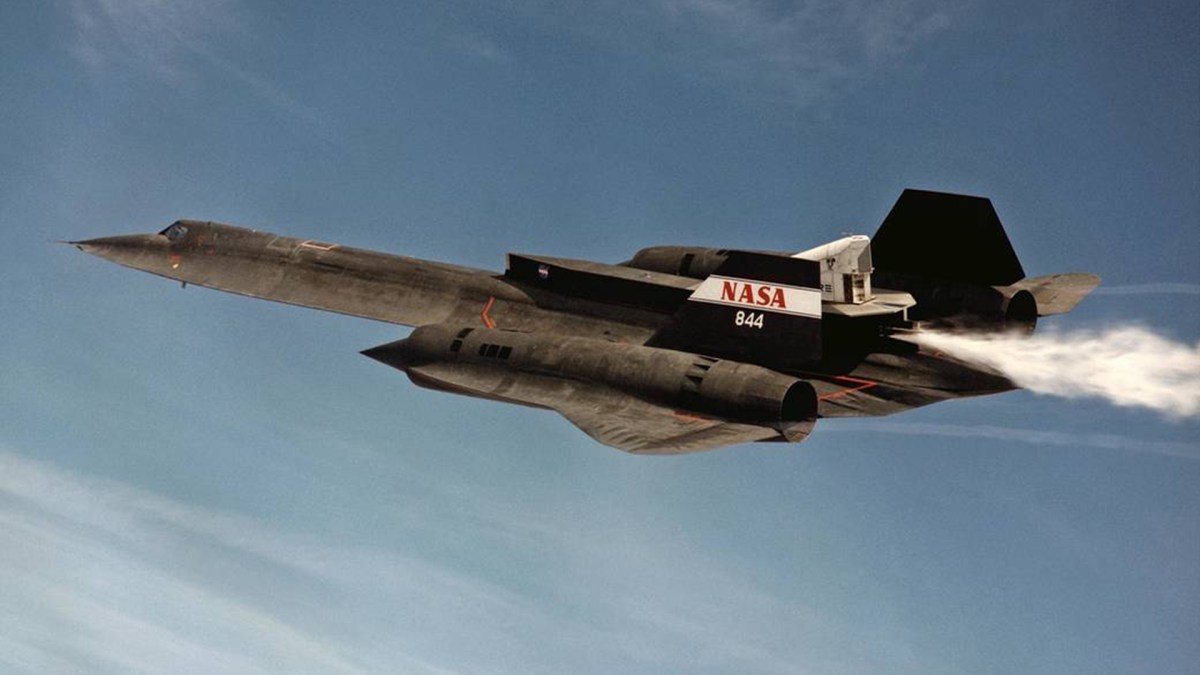
27 ans après, cet avion mythique utilisé par la Nasa pourrait faire son grand retour

Décollage d'un SR-71.

Le SR-71 Blackbird était un avion militaire américain qui a volé, pour la dernière fois, en 1999. Depuis, les exemplaires restants sont exposés dans des musées. Or, celui que la Nasa gardait en Californie a disparu de son emplacement, et l'agence a discrètement lancé un projet pour le remettre en vol, selon Aviation Week ce mardi 29 septembre.

  •  

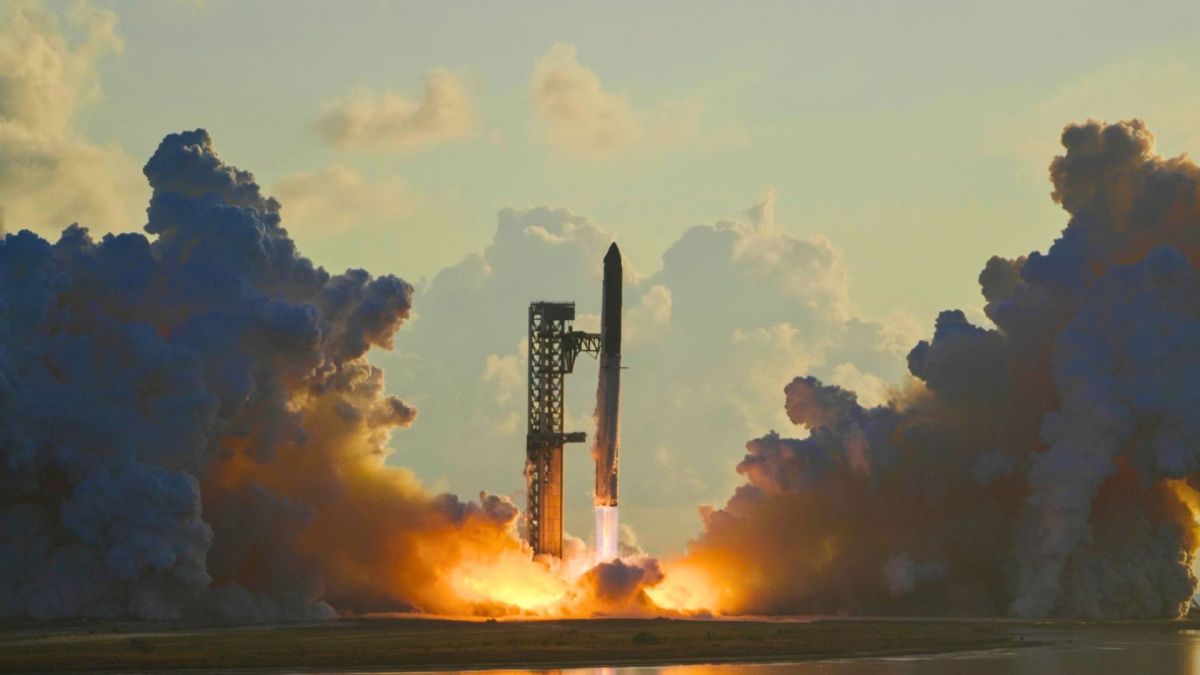
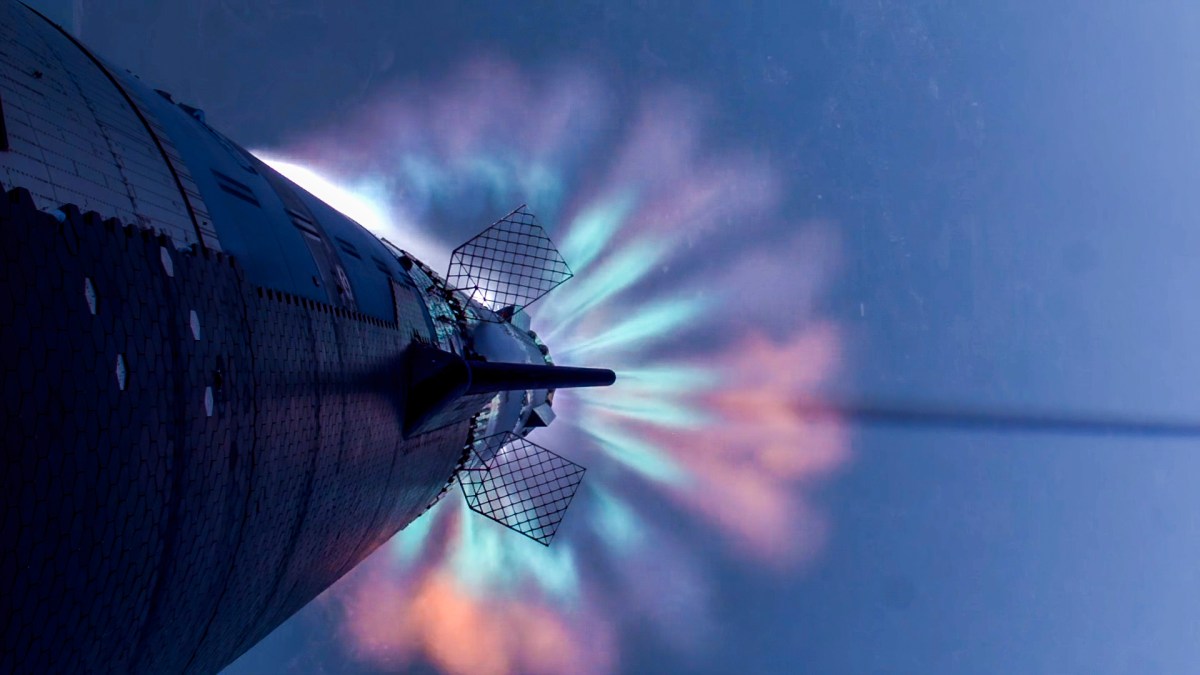
Starship : SpaceX réussit le décollage de la fusée géante et le retour en mer du booster, et vise sa première mise en orbite

spacex starship

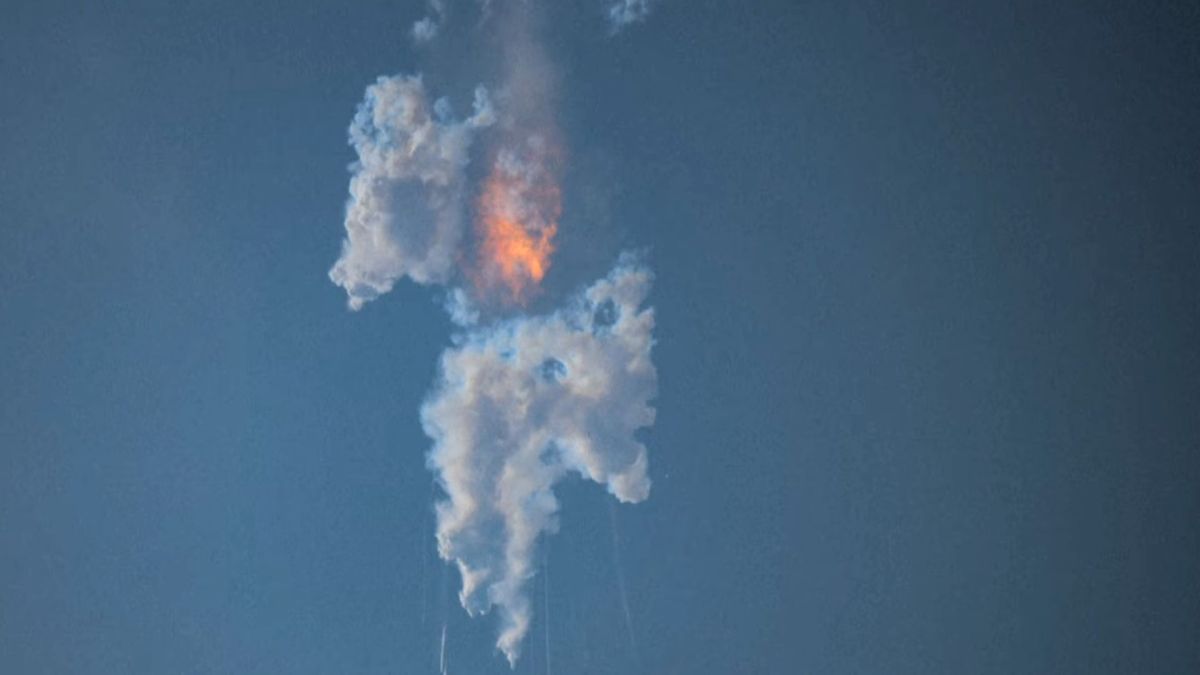
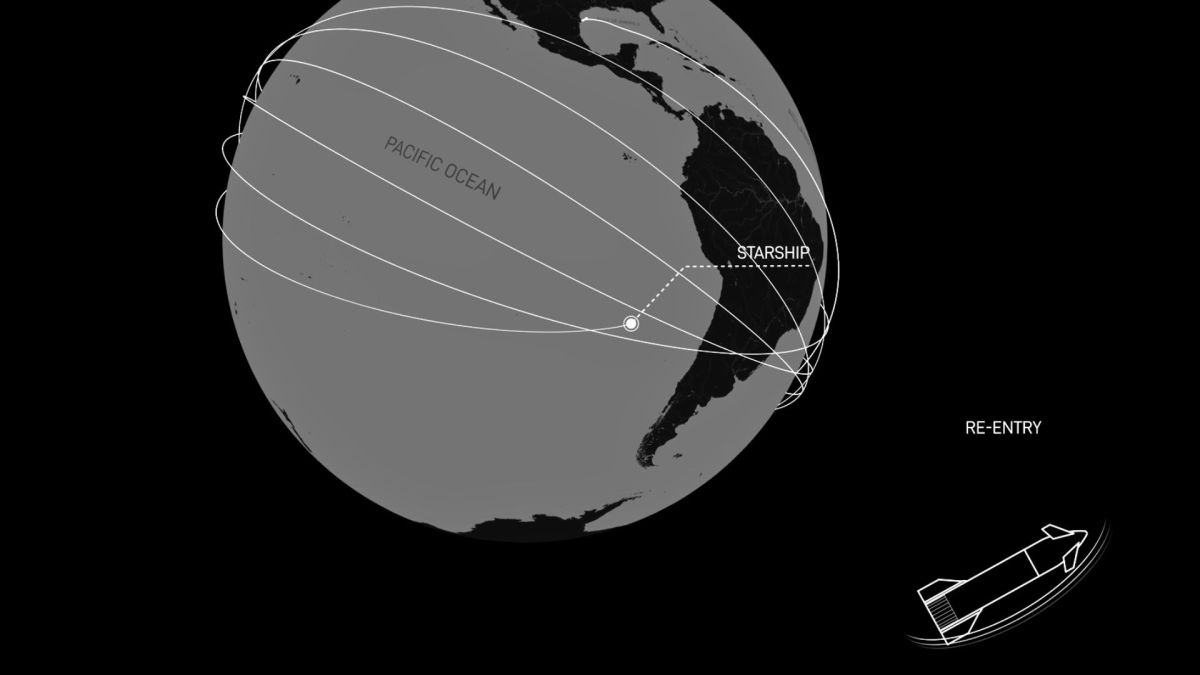
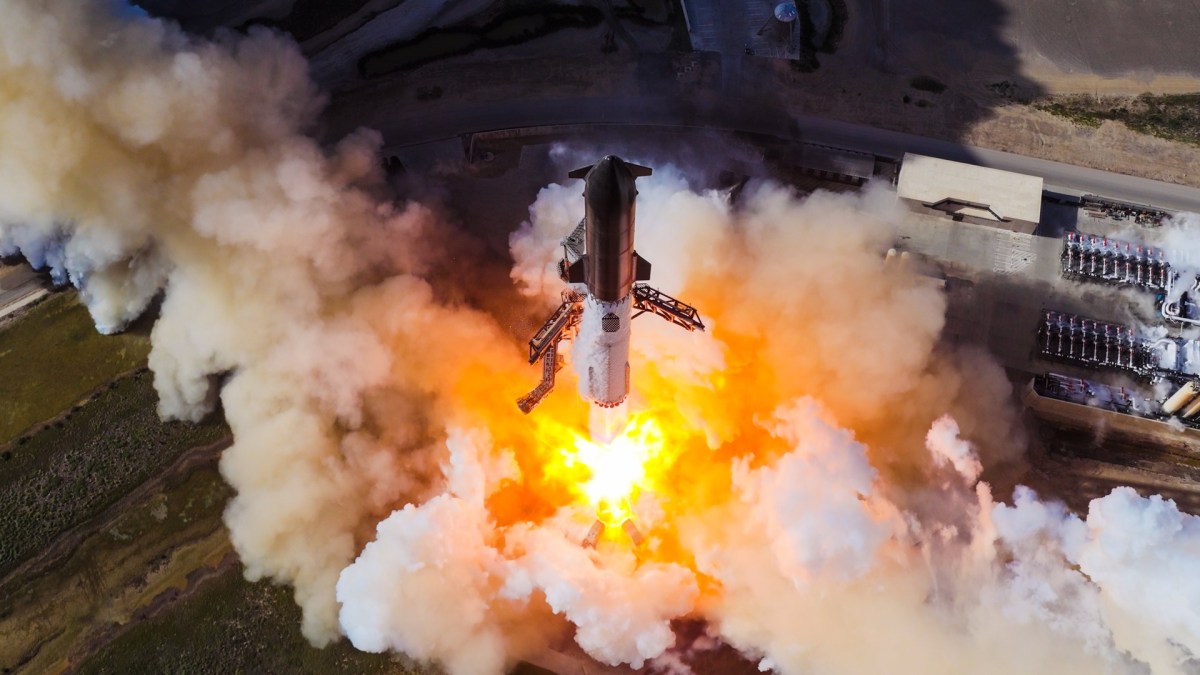
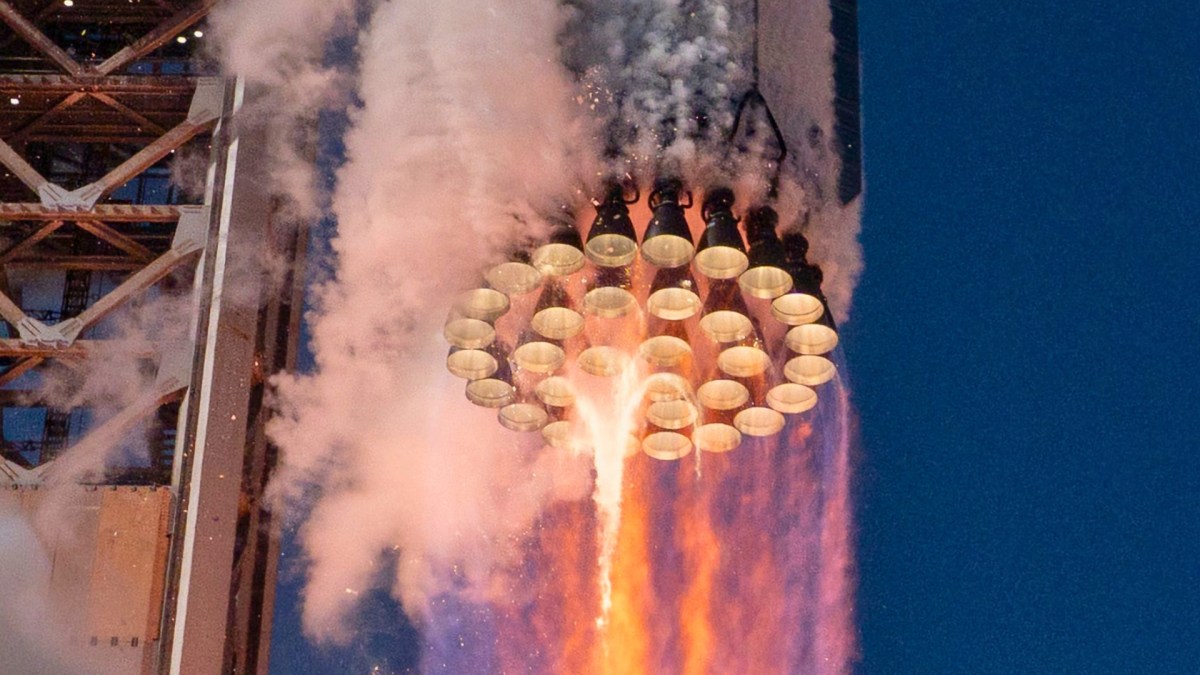
Le Starship de SpaceX a décollé du Texas ce lundi 28 septembre 2026 pour son 14e vol d'essai, et son propulseur Super Heavy a réussi son retour en mer dans le golfe du Mexique. Pour la première fois, l'étage supérieur de la fusée géante vise ensuite une vraie orbite autour de la Terre.

  •  

Plus de 200 prépublications en 2026 : un chercheur utilisant l’IA désespère ses collègues

Slop or perish?
Plus de 200 prépublications en 2026 : un chercheur utilisant l’IA désespère ses collègues

Depuis le début de l’année, un statisticien de l’université de Chicago, Nicholas Polson, a mis en ligne plus de 200 prépublications. Assumant d’utiliser l’IA générative pour augmenter sa productivité, il soulève l’indignation de ses consœurs et confrères.

La course à la publication coûte que coûte dans le milieu de la recherche s’intensifie encore avec l’utilisation généralisée de l’IA générative. Pour nombre de chercheuses et chercheurs, le travail consiste à mettre en ligne quelques articles issus de leurs travaux de recherche par an au maximum. Mais on peut voir sur le profil Google Scholar de Nicholas Polson, statisticien bayésien de l’école de commerce Booth de l’université de Chicago, que celui-ci en a signé plus de 200 depuis le début de l’année, comme le soulignait sur X déjà mi-aout Auyon Siddiq, chercheur à l’université de Californie (UCLA), .

La plupart des articles listés sur son profil ont été mis en ligne sur la plateforme de prépublications scientifiques SSRN. Cette plateforme a été lancée en 1994, quelques années après la pionnière du genre, arXiv, et a été rachetée en 2016 par Elsevier.

258 working papers en 8 mois

« D’après mes calculs, basés sur sa page SSRN, Nicholas Polson a déjà rédigé 258 working papers rien qu’en 2026. Il a déjà rédigé (ou du moins publié sur SSRN) six articles aujourd’hui, le 26 août 2026. Au cours du mois d’août 2026, il a rédigé et publié sur SSRN un total de 104 documents – et ce n’est pas fini, puisque le mois n’est pas encore tout à fait terminé », expliquait l’économiste de l’université de Central Arkansas, Jeremy Horpedahl, dans un billet de blog.

« Il s’agit probablement, à des degrés divers, de slops générés par IA, mais contrairement à beaucoup de ce genre de contenu, celui-ci recèle sans doute une réelle valeur. Ce que je n’ai pas encore pu vérifier, c’est si une partie de ce contenu a fait l’objet d’une vérification, d’une analyse ou d’une sélection rigoureuse de la part de l’auteur », ajoutait Michael Makowsky, économiste à l’université de Clemson.

Interrogé par le Washington Post, Nicholas Polson assume utiliser l’IA générative pour plus de productivité : « il est évident que l’IA rend un chercheur productif encore plus productif ». Il ajoute qu’ « une grande partie du travail fastidieux est grandement simplifiée ». Et il a, selon nos confrères, laissé entendre que ces plaintes étaient motivées par « la jalousie et l’envie de s’approprier ma méthode. Mais qui sait ? ».

Suppression des articles sur SSRN

Depuis que plusieurs de ses confrères ont pointé du doigt ce nombre prolifique, plus aucun article récent de Nicholas Polson n’est accessible sur SSRN. Par exemple, la page de l’article titré « Over-parameterization in Statistical Genomics » et listé sur son profil Google Scholar affiche maintenant : « Cet article est en cours d’évaluation ou a été retiré de SSRN à la demande de l’auteur, de SSRN ou du titulaire des droits ». Son profil sur la plateforme ne liste plus que des articles mis en ligne avant octobre 2018.

Plusieurs chercheurs ont souligné que les articles de Nicholas Polson ne faisaient pas mention d’utilisation de l’IA. Mais la plateforme souligne que « s’il est vrai que bon nombre de ces articles ne comportaient pas de mention relative à l’IA, ce n’est pas notre principale préoccupation. […] Le problème le plus important résidait dans l’activité inhabituelle en matière de soumission d’articles ». Elle indique que le statisticien s’était aventuré dans des champs dont il n’est pas spécialiste, bien que la plupart des articles y restaient.

« Ce n’est pas seulement une question de volume, mais aussi de diversité des thèmes abordés et de la manière dont ils se distinguent de ses œuvres précédentes », insiste Auyon Siddiq interrogé par nos confrères.

  •  

Le prix de la mémoire complique vraiment l’achat de matériel informatique dans les labos

L'IA genérative ralentit la recherche française
Le prix de la mémoire complique vraiment l’achat de matériel informatique dans les labos

La course à l’IA générative a créé une pénurie de mémoire RAM et de stockage SSD et leurs prix se sont envolés. Conséquence : en respectant le code des marchés publics, l’enseignement supérieur et la recherche français peinent à acheter de nouveaux matériels informatiques.

La croissance du nombre de data centers a entraîné une forte augmentation de la demande en mémoire et en stockage et mécaniquement une hausse des prix. Celle-ci a des effets importants sur la recherche française : Matinfo, le groupement d’achat de matériel informatique pour l’enseignement et la recherche (ESR), explique au personnel : « on en arrive à des situations de blocage ».

Ce groupement permet aux établissements français d’enseignement supérieur et de la recherche (universités mais aussi CNRS et autres institutions de recherche) de faire leurs achats de « matériel informatique, postes de travail, pilotage d’expérience ou serveurs » via un accord-cadre. Avec 250 établissements membres, en temps normal, celui-ci leur permet de bénéficier de tarifs « très avantageux » tout en respectant le code des marchés publics.

L’augmentation des prix de la mémoire crée un goulot d’étranglement

Le comité de suivi Matinfo a envoyé à ses membres un document rédigé le 18 septembre dernier, qu’a pu consulter Next, destiné à « toute personne faisant partie d’un établissement de l’enseignement supérieur et de la recherche français » qui explique les difficultés.


Il reste 79% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  
❌