❌

Vue lecture

Pour Octave Klaba, il est « trop risqué de ne pas investir » dans l’IA

On Voudrait de la Hype, pas de la dépendance
Pour Octave Klaba, il est « trop risqué de ne pas investir » dans l’IA

Hier, Octave Klaba – PDG d’OVHcloud – était auditionné par la commission des affaires économiques de l’Assemblée nationale. Les questions tournaient autour de son entreprise, mais aussi des enjeux de souveraineté, des datacenters et de l’intelligence artificielle générative, en France et en Europe.

S’il fallait résumer la vision d’Octave Klaba, cela tiendrait en une phrase : « Aujourd’hui, les technologies sont principalement américaines ou chinoises ; les innovations viennent énormément de la Chine. En Europe, on n’a pas d’acteur technologique qui souhaite investir dans l’intelligence artificielle ».

Ce n’est pas qu’une question de logiciel, il donne durant son intervention un chiffre intéressant : « 3 % du volume des puces de RAM sont achetés en Europe ». Autre manière de le dire : « ce n’est pas là que ça se passe » ; c’est aux États-Unis ou en Asie, comme pour les modèles.

L’IA générative selon OVHcloud : cyberattaque et défense, coder et agents

« Bien sûr, vous avez des usages », c’est-à-dire l’utilisation de l’intelligence artificielle. Actuellement, ils reposent beaucoup sur l’open source, « à juste titre parce qu’elle est bonne, mais c’est chinois. On ne sait pas ce qui va se passer demain, ni la stratégie » des entreprises qui sont derrière. Est-ce temporaire le temps de nous rendre dépendants avant de couper le robinet ? La question mérite d’être posée.

OVHcloud est « arrivé à la conclusion que c’est trop risqué de ne pas investir dans l’intelligence artificielle ». Pour l’entreprise basée à Roubaix, cela signifie des acquisitions afin de renforcer ses équipes. Elle peut ainsi « entraîner des modèles from scratch et les enrichir » pour ses usages. Trois pistes : la cybersécurité (aussi bien offensive que défensive, le PDG cite bien les deux versants), coder et développer des logiciels et enfin l’agentique.

Sur la cybersécurité, il affirme que les enjeux autour de l’intelligence artificielle « sont devenus colossaux […] Les IA permettent de découvrir des failles de sécurité ou de pénétrer des systèmes à une vitesse qui n’a jamais été connue jusque-là ».

L’IA générative ne peut se faire sans GPU

La position n’est pas nouvelle, l’année dernière déjà le patron expliquait : « l’IA est systémique et irréversible. On ne peut pas arrêter cette révolution ». Enfin si, un grain de sable vient mettre un gros coup de frein : la disponibilité et le tarif des GPU. Essayez donc de louer une instance « Cloud GPU » chez OVHcloud avec un GPU NVIDIA. C’est une gageure à cause du manque de disponibilité, depuis des mois.

Octave Klaba était face à un dilemme l’année dernière : « La vraie question derrière les GPU, c’est le business model. La problématique aujourd’hui, c’est que tous ceux qui investissent ne savent pas encore s’ils vont les rentabiliser ». Il donne un exemple chiffré avec des H100 de NVIDIA, lancées il y a trois ans : « elles ne valent pratiquement plus rien […] vous avez quasiment perdu 80 % de la valeur ».

Ce n’est pas le seul problème, les technologies évoluent très vite : « Si vous investissez aujourd’hui dans un datacenter et vous vous dites « Ça y est, j’ai un datacenter pour l’intelligence artificielle », soyez sûr que dans 18 ou 12 mois, vous allez devoir faire du rétrofit pour l’adapter à des nouvelles technologies des GPU qui vont sortir dans deux ans parce que votre chaîne énergétique ou de refroidissement ne sera plus à jour ».

« Vous avez l’interdiction pendant deux ans de faire quoi que ce soit »


Il reste 67% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

IA générative : pour réduire vos coûts et votre empreinte, parlez anglais

Le français, cette langue de luxe
IA générative : pour réduire vos coûts et votre empreinte, parlez anglais

Changer de langue permet de consommer moins de tokens, c’est un fait et nous l’avons mesuré aussi bien chez Anthropic, OpenAI et Google. Moins de tokens, c’est un coût de revient plus faible et moins de calcul, donc une empreinte écologique plus faible.

Les IA génératives ne travaillent pas sur des mots, mais sur des tokens (ou jetons). C’est une manière de découper des phrases, propre à chaque famille de modèle. C’est le rôle du tokenizeur : vous saisissez votre prompt, il le transforme en tokens qui sont envoyés au modèle.

Il fait des centaines de milliards d’opérations sur chaque token et renvoie le résultat, de nouveau en tokens. Opération inverse du tokeniseur et voilà la réponse affichée.

Tous les tokens ne se valent pas !

Les grands modèles de langage ne parlent qu’en tokens, c’est l’unité de base pour les calculs et la facturation. Plus il y a de tokens en entrée et en sortie, plus vous payez cher (ou plus cela entame votre forfait). Il y a aussi plus de calculs, dont une empreinte environnementale plus importante.

Quel rapport avec le titre de notre actualité et donc avec les langues ? La création de tokens (ou jetons) n’est pas universelle : elle dépend de chaque famille de modèle, mais également de la langue. Pour mettre en lumière cette différence, nous avons pris comme référence le règlement général sur la protection des données (RGPD) de la Commission européenne, un long texte traduit dans les 24 langues de l’Union.

Une précision importante : le gain dont nous parlons ici reste anecdotique par rapport à un usage responsable : ne demandez pas à ChatGPT de faire de la reconnaissance de caractère basique sur une image ou de traduire un texte, des IA spécialisées le feront bien mieux et pour moins cher (en argent et en consommation). Vous pouvez aussi demander aux modèles d’être moins bavards, d’aller à l’essentiel. Les économies seront bien plus importantes.

Les tokens dans 24 langues et près de 10 millions de caractères

Chaque texte ne fait pas la même longueur : entre 320 000 et 415 000 caractères, avec 371 000 de moyenne environ. Mais ce règlement est assez long pour en tirer une métrique intéressante : le nombre de caractères moyens par token et par langue.


Il reste 74% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

[màj] Google : Gemini 4 Argon et son million de tokens en sortie disponible pour tous

Un gaz inerte comme emblème ? Pourquoi pas
[màj] Google : Gemini 4 Argon et son million de tokens en sortie disponible pour tous

Alors que les deux mastodontes Anthropic et OpenAI sont lancés dans une course à l’échalote sur les performances (et la désobéissance) de leurs modèles, Google veut revenir dans la course avec Gemini 4 Argon. La cybersécurité et le code sont particulièrement mis en avant.

Mise à jour 13/10 – À chaque jour son nouveau LLM, ou pas loin. Après Meta et Muse Wonder, c’est au tour de Google de lancer Gemini 4 Argon auprès du grand public, après une disponibilité limitée à des spécialistes de la cybersécurité. Le modèle est accessible via l’API dans AI Studio et Gemini, ainsi que pour les abonnés Google AI Ultra (y compris dans la plateforme de création d’agents Antigravity) et Pro dans l’app Gemini et le mode IA de la recherche.

Article original, 1er/10 – Avec ce LLM qualifié de « frontier model », Google se présente comme un bon élève face à Donald Trump : « Nous participons activement au processus volontaire du gouvernement américain pour l’accès anticipé au modèle de prélancement, tout en élargissant progressivement cet accès ». C’est en effet ce que demande le président dans son décret du 2 juin.

Traduction : ne comptez pas en profiter pour l’instant. Ce modèle est « déployé auprès d’un groupe de spécialistes de la cybersécurité de confiance par le biais de notre programme Fairwind ». C’était aussi le cas pour Gemini 3.8 Flash Cyber au début du mois. Cela ne concerne donc que des gouvernements, des autorités nationales de cybersécurité, des opérateurs d’infrastructures critiques et d’autres spécialistes triés sur le volet. Une ouverture à tous est prévue, sans calendrier.

1 million de tokens : Google multiplie par 15 la limite de sortie

Premier changement important, la limite de sortie explose : « nous augmentons la limite de jetons de sortie du modèle à 1 million de jetons, une performance inégalée dans l’industrie, contre 64 000 auparavant ». À titre de comparaison, Fable 5.1 d’Anthropic et GPT-6 Astra d’OpenAI ont une fenêtre de contexte de 1 million de tokens, mais de « seulement » 128 000 tokens en sortie. Une limite huit fois plus large donc chez Google.

Google insiste sur ce point : « Grâce à cette capacité de traitement, le modèle peut analyser en profondeur et générer des centaines de milliers de jetons en une seule étape, ce qui lui permet de résoudre des problèmes complexes d’un seul coup ».

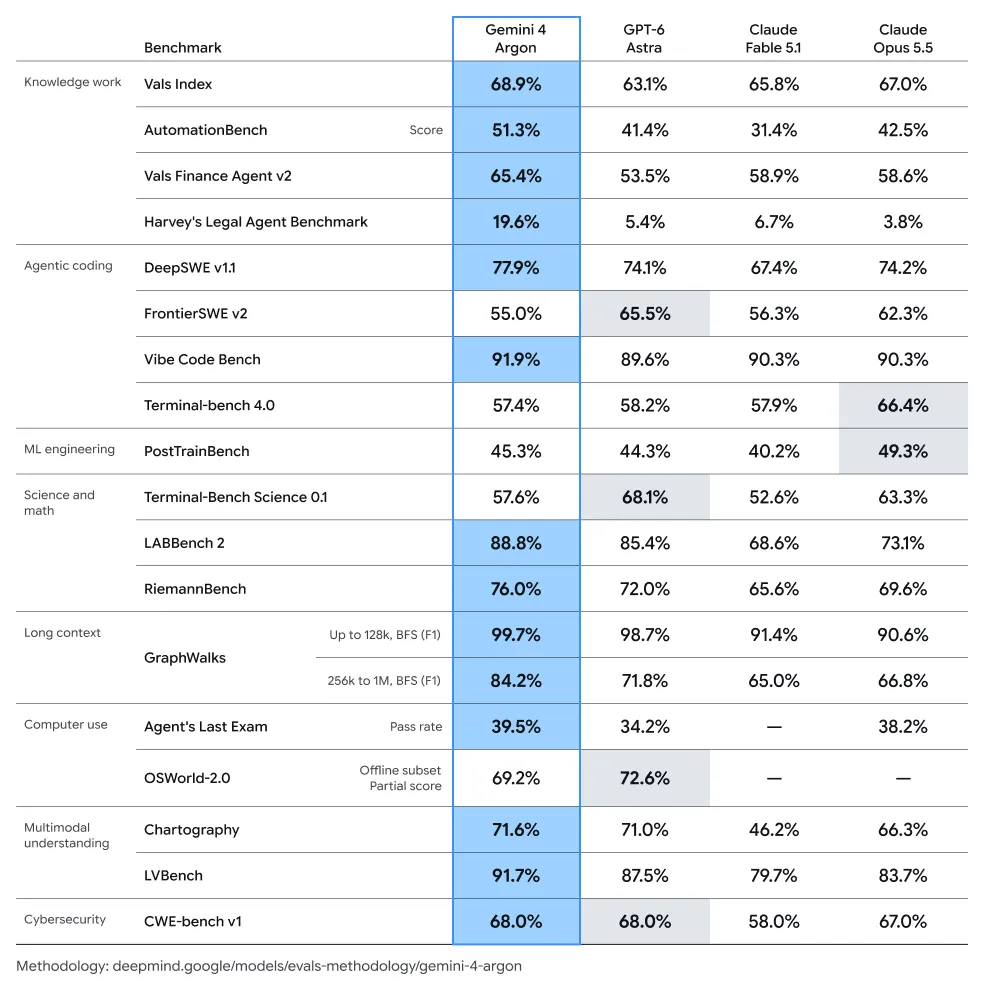
Cette annonce s’accompagne comme toujours d’une série de benchmarks maison, dans lesquels Gemini 4 Argon dépasse généralement GPT-6 Astra et Claude Fable 5.1 et Opus 5.5. Google affirme que son nouveau modèle est particulièrement bon « pour les tâches de codage spécialisées ». On attendra de voir pour les tâches courantes sur le code, car Gemini 3.8 n’était pas bon dans notre test sur l’extension Next.

Google revendique la couronne sur DeepSWE v1.1 et CWE-bench v1

Google en remet une couche : « Les ingénieurs de Google utilisent Argon au quotidien, du débogage courant aux migrations de code à grande échelle et à la conception d’algorithmes. Il établit une nouvelle référence sur DeepSWE v1.1 (77,9 %), qui mesure la performance d’un modèle dans des tâches d’ingénierie logicielle concrètes et à long terme ». GPT-6 Astra est à 74,3 %, Claude Opus 5.5 à 74,2 % et Fable 5.1 à 67,4 %.

Autre exemple : « les agents Argon travaillent à la migration des bases de code C/C++ vers Rust chez Google, allant de quelques dizaines de milliers de lignes pour les bibliothèques essentielles comme re2 et libgav1 à plus de 800 000 lignes pour le noyau Zircon de Fuchsia OS ».

Sujet sensible, ce n’est pas l’ingénieur Galen Hunt de Microsoft qui dira le contraire. Il s’était pris une volée de bois vert quand il avait annoncé vouloir « éliminer toutes les lignes de C et C++ de Microsoft d’ici 2030 », grâce à l’IA. Depuis, il y a eu rétropédalage en règle.

Autre axe largement mis en avant par Google : la cybersécurité. « Pour mieux préparer les équipes de cyberdéfense à la nouvelle ère des cyberattaques, nous avons entraîné Gemini 4 Argon à exceller en matière de défense contre les cybermenaces. Argon est capable de détecter, valider et corriger de manière autonome les vulnérabilités logicielles critiques ».

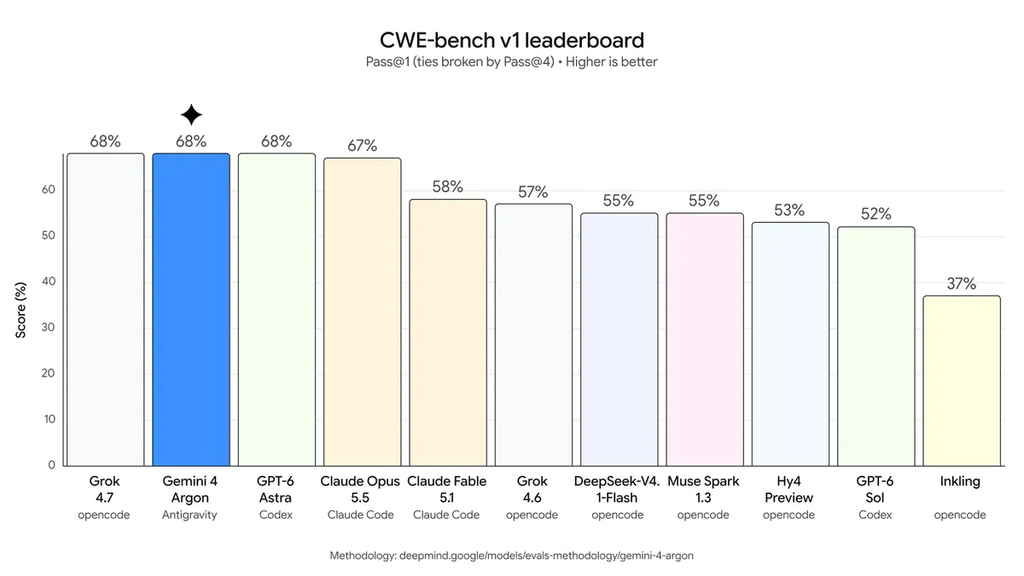
Pour mettre des chiffres sur ces mots, Google annonce un score CWE-bench v1 de 68 %, à égalité avec Grok 4.7 et GPT-6 Astra.

Google fait également une annonce surprenante vu l’actualité autour des agents IA qui font un peu n’importe quoi : « Pour nos équipes de confiance et nos équipes internes chez Google, nous déploierons Argon sans aucune restriction de sécurité afin qu’elles puissent exploiter pleinement ses capacités de pointe en matière de cybersécurité ».

La version anglaise du communiqué de Google est cependant moins forte : « Pour nos partenaires de confiance et nos équipes internes chez Google, nous déploierons Argon sans garde-fous cyber [cyber guardrails en VO, ndlr] afin qu’ils puissent exploiter pleinement ses capacités de pointe en cybersécurité ».

Sans restriction, mais pas sans protection. Pour le grand public, en revanche, des garde-fous sont prévus : « Afin d’empêcher toute utilisation malveillante d’Argon à des fins de cyberattaques ou d’attaques chimiques, biologiques, radiologiques et nucléaires (CBRN), le modèle est conçu pour refuser les requêtes malveillantes tout en préservant la recherche scientifique légitime à double usage, conformément à notre cadre de sécurité Frontier ». Pour Google, comme les autres, le message est simple : ne vous inquiétez pas, on s’occupe de tout. Pas facile vu l’actualité récente.

Moins cher qu’Astra et Fable, mais plus loquace

Pour terminer, le prix : Gemini 4 Argon est à 2 dollars en entrée et 10 dollars en sortie, par million de tokens dans les deux cas (le cache en entrée a une réduction de 95 % du prix). C’est un prix promotionnel, il sera par la suite doublé avec 4 et 20 dollars respectivement. Google n’a pas précisé quand cette promotion se terminera.

Fable 5.1 et GPT-6 Astra sont tous les deux à 10 et 50 dollars par million de tokens, respectivement en entrée et en sortie. Gemini 4 Argon est-il donc cinq fois moins cher ? Non, car nous n’avons ici qu’une moitié de l’équation. L’autre partie, c’est la consommation de tokens. Facturer deux fois moins mais produire deux fois plus n’apporterait aucune économie.

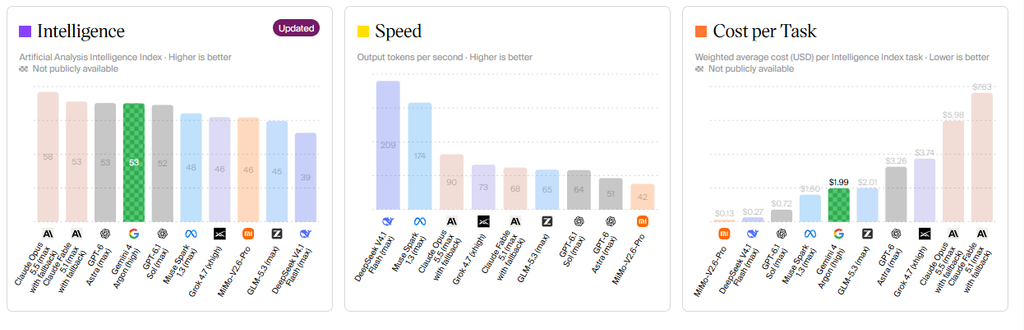
Sur ce point, le nouveau modèle ne semble pas tirer son épingle du jeu, selon Artificial Analysis, spécialisé dans les benchmarks d’IA : « Gemini 4 Argon fait en moyenne 62 000 jetons de sortie par tâche, contre 27 000 pour GPT-6 Astra (max) ». Pour rappel, OpenAI double le prix de certains modèles – dont GPT-6 Astra – quand l’entrée dépasse les 272 000 tokens.

Gemini 4 Argon, prix par tâche, tarif promotionnel à 2/10 dollars
  •  

Piratage de la DGFiP : pas d’attaque sophistiquée, mais une série de défaillances techniques

BYOD nouvelle version : Bring Your Own... Désastre
Piratage de la DGFiP : pas d’attaque sophistiquée, mais une série de défaillances techniques

Cet été, la Direction générale des Finances publiques (DGFiP) reconnaissait une intrusion dans ses systèmes informatiques avec l’accès à des données concernant pas moins de 678 000 contribuables et entreprises. Deux suspects de 16 et 18 ans ont été interpellés fin août, dont un mis en examen et placé en détention provisoire.

L’attaquant disposait de mots de passe de dizaines de comptes

Ce piratage a fait grand bruit, d’autant qu’il s’inscrit dans une longue liste de sites et institutions publiques piratés ces dernières semaines, mois et même années. Plusieurs enquêtes ont été lancées, dont une du cyberpompier français, l’ANSSI (Agence nationale de la sécurité des systèmes d’information). Elle vient de publier son rapport d’incident (pdf).

S’il fallait résumer l’affaire en une phrase : « La compromission des SI de la DGFiP n’est pas la conséquence d’une attaque sophistiquée, mais de l’exploitation de faiblesses dans trois domaines ». Il s’agit de l’identité, de l’architecture réseau et de la détection des signaux.

Premier point, la volumétrie : les données volées concernent « près de 353 000 particuliers et 252 000 professionnels, obtenues à partir d’un outil de gestion de la relation avec les usagers de la DGFiP ». Les infiltrations dans la DGFiP ont commencé dès le mois de mai 2026.

L’ANSSI revient tout d’abord sur la sécurité des comptes et le volume important de ceux auxquels le pirate pouvait accéder car il disposait des couples identifiant et mot de passe. En effet, « aucune tentative d’attaque par force brute ou credential stuffing n’a été identifiée, ce qui signifie que l’attaquant disposait de mots de passe pour ces comptes (pouvant être valides ou expirés) ».

Dans son rapport, l’ANSSI anonymise les comptes compromis et utilise la dénomination suivante : compte-dgfip-X pour ceux internes à la DFGIP, et compte-dgfip-xt-Y pour les externes. Les X et Y sont incrémentés pour différencier chaque compte. Voici le bilan officiel : compte-dgfip-X va jusqu’à 22 et compte-dgfip-xt-X jusqu’à 7… soit presque une trentaine de comptes compromis par infostealer.

Pour les comptes externes, « les investigations de la DGFiP mettront en évidence que la compromission du poste d’un géomètre-expert au sein d’un cabinet privé a permis de contourner la double authentification par messagerie, puis l’accès et l’exfiltration des données entre le 27 juillet 2026 et le 8 août 2026 ».

La réinitialisation des mots de passe n’a pas servi à grand-chose.

Une des pistes évoquées pour obtenir ses informations est « la fuite d’identifiants de connexion fréquente et consécutive à l’utilisation d’appareils personnels ». La DGFiP a procédé à la réinitialisation des mots de passe, mais si des machines restent infectées et/ou que les sessions actives ne sont pas coupées, cela n’est pas d’une grande utilité.

Preuve en est : la réinitialisation du 24 juin 2026 « n’interrompt pas la session et l’exfiltration en cours qui se poursuivent », précise l’ANSSI dans le détail de la chronologie des faits. Ajoutez à cela « l’absence d’authentification forte sur deux portails dont l’un donnant accès à des ressources sensibles » et vous avez un combo explosif.

Des indices en pagaille : IP en Inde, des Go téléchargés, connexions nocturnes

Autre problème pour l’ANSSI, le manque de détection : « Les sessions d’exfiltration menées par l’attaquant n’ont pas été détectées en temps réel par les mécanismes de contrôle implémentés sur les applicatifs métiers ni sur les équipements de sécurité de la DGFiP ».

Il y avait pourtant des indices élémentaires facile à identifier : « la volumétrie d’informations échangées lors des connexions (11Go entre le 22 et 25 juin, 3Go entre le 21 et 23 juillet) », ainsi que « le nombre de requêtes par utilisateur sur une plage temporelle ».

L’Agence prend soin de préciser que « la technique de scraping utilisée par les attaquants impose de devoir initier autant de requêtes que de pages accédées ». Cela aurait dû déclencher des alertes. Une technique connue depuis la nuit des temps aurait dû être mise en place : un rate-limiting. Le but est de bloquer un nombre trop important de requêtes, permettant aussi de limiter des attaques par force brute.

Ce n’est pas le seul problème. La DGFiP n’analysait pas les adresses IP puisque des connexions ont été réalisées « depuis des adresses de VPN, depuis des adresses localisées en Inde et pour plusieurs catégorisées comme malveillantes ». Ajoutez à cela des adresses IP déjà identifiées comme liées à un compte compromis qui peuvent revenir en toute impunité et des heures de connexions nocturnes ; vous avez un beau tableau de ce qu’il ne faut pas faire.

« Ces paramètres pris individuellement ne permettent généralement pas d’identifier des comportements suspects sans générer d’importants volumes de faux positifs, néanmoins la corrélation de plusieurs d’entre eux aurait pu permettre de lever des alertes », ajoute l’ANSSI.

Après « le besoin d’en connaître », le besoin d’y avoir accès

Troisième point de faiblesse : le RIE ou Réseau Interministériel de l’État, utilisé par les pirates pour accéder « au portail ADER [Accès Distant aux Échanges Réseau, ndlr] de la DGFiP ». Opérationnel depuis 2013, il raccorde les services de l’État. L’ANSSI note que « plusieurs accès illégitimes identifiés proviennent du RIE [la suite est caviardée, ndlr], à partir de localisations n’ayant pas de besoins apparents d’accéder à des infrastructures de la DGFiP ».

« Pendant l’incident, le SOC [Security Operation Center, ndlr] de la DGFiP ne supervisait pas le portail ADER, utilisé par l’attaquant pour exfiltrer les informations E-Contact », contrairement au portail PIGP (Portail internet de la gestion publique) qui était bien surveillé. Ce trou dans la raquette a permis aux pirates de s’infiltrer, mais a aussi empêché « de corréler des activités malveillantes avec le reste du SI ou en provenance du RIE suite à un signalement d’un autre ministère ».

Là encore on retrouve un basique de la cybersécurité : la segmentation réseau avec le cloisonnement des « accès aux seules populations et zones logiques qui en ont le besoin ». L’Agence recommande de mettre en place « un filtrage plus fin des accès réseau entre ministères et au sein du RIE ».

Comment les pirates sont rentrés dans le RIE ? Par la porte ouverte d’un autre piratage : « L’utilisation du RIE lui a été rendue possible à cause de la compromission d’infrastructures appartenant au ministère de l’Éducation nationale elles-mêmes raccordées au RIE ». Pour l’ANSSI, cela illustre parfaitement le « risque de latéralisation depuis des ressources d’organismes tiers » et le besoin de cloisonner.

Des signalements en pagaille

L’ANSSI fait son mea culpa sur sa supervision. « Les acteurs malveillants utilisaient des comptes légitimes pour accéder aux applications et la supervision réseau de l’Agence n’a pas permis de les voir ». De plus, « le volume cumulé de requêtes que l’attaquant a dû générer pour orchestrer l’exfiltration de données aurait dû déclencher des alertes ».

Dans la même veine, elle explique qu’un partenaire l’a informé le 15 juin de la compromission de deux comptes DGFIP. Cette dernière « ne répond pas et n’est pas relancée par l’Agence ». Nouveau signalement le 22 juin, suivi d’une action cette fois-ci : « un partenaire informe l’ANSSI de la compromission d’un compte. La DGFIP répond le jour même à l’ANSSI avoir réinitialisé ce compte et sensibilisé leur agent ».

D’autres signalements sont remontés dans la chronologie, notamment le 29 juin 2026 avec un bel acte manqué : « un partenaire informe l’ANSSI de la compromission du compte. Il s’agit du compte utilisé pour l’exfiltration de données le 24 juin 2026, or cette compromission n’était pas connue à cette date et les analyses menées par le SOC de la DGFIP ne l’identifient pas. La DGFIP répond le jour même à l’ANSSI avoir déjà connaissance de ce fait et confirme l’avoir réinitialisé ».

D’autres signalements ? Le 1ᵉʳ juillet, la « DGFIP est informée par son prestataire de la vente de deux comptes ». Là aussi le pot aux roses aurait pu être découvert : « les investigations montreront, à posteriori, des échecs de connexion sur le PIGP le même jour et le jour précédent avec ces comptes à partir d’une des adresses IP utilisées pour l’exfiltration du 24 juin 2026 ».

Plein de mesures de remédiation, ça fait pas de mal de les relire !

Enfin, l’ANSSI propose des mesures de remédiation (page 10) afin « d’assurer que le même chemin de compromission ne puisse être emprunté de nouveau, par le même acteur ou un nouveau ». Elles couvrent toutes les lacunes précédentes et ouvrent aussi de nouvelles pistes.

Cela va des restrictions d’accès aux ressources métiers à la protection contre les vols d’identifiants. On y retrouve notamment des propositions sur le matériel. « L’usage d’appareils personnels pour accéder à des ressources professionnelles doit être proscrit », et les machines professionnelles doivent être durcies. Évidemment, l’authentification multifacteurs doit être généralisée.

Pour les applications à usage interne, l’accessibilité ne doit se faire « que depuis des postes administrés par la DGFiP. Dans ce cas, l’accès à l’application ne doit pas être possible depuis Internet, sauf à travers un VPN dédié aux agents de la DGFiP ». Les VPN ne servent pas uniquement à contourner des restrictions, ils permettent aussi de renforcer la sécurité, mais attention aux promesses de certains !

Dans sa synthèse, l’ANSSI rappelle que l’exfiltration des données s’est produite sept semaines avant la revendication des pirates le 12 août, et « qu’elle a été précédée de plusieurs semaines d’exploration sur des applicatifs de la DGFIP ».

Des indices étaient bien présents, mais pas correctement pris en compte, c’est un rappel important pour toute la communauté cyber. En effet, ces recommandations peuvent s’appliquer bien au-delà de la DGFiP. Il est toujours bon de les lire et de vérifier qu’elles sont bien appliquées.

  •  

Piratage de la DGFiP : pas d’attaque sophistiquée, mais une série de défaillances techniques

BYOD nouvelle version : Bring Your Own... Désastre
Piratage de la DGFiP : pas d’attaque sophistiquée, mais une série de défaillances techniques

Cet été, la Direction générale des Finances publiques (DGFiP) reconnaissait une intrusion dans ses systèmes informatiques avec l’accès à des données concernant pas moins de 678 000 contribuables et entreprises. Deux suspects de 16 et 18 ans ont été interpellés fin août, dont un mis en examen et placé en détention provisoire.

L’attaquant disposait de mots de passe de dizaines de comptes

Ce piratage a fait grand bruit, d’autant qu’il s’inscrit dans une longue liste de sites et institutions publiques piratés ces dernières semaines, mois et même années. Plusieurs enquêtes ont été lancées, dont une du cyberpompier français, l’ANSSI (Agence nationale de la sécurité des systèmes d’information). Elle vient de publier son rapport d’incident (pdf).

S’il fallait résumer l’affaire en une phrase : « La compromission des SI de la DGFiP n’est pas la conséquence d’une attaque sophistiquée, mais de l’exploitation de faiblesses dans trois domaines ». Il s’agit de l’identité, de l’architecture réseau et de la détection des signaux.

Premier point, la volumétrie : les données volées concernent « près de 353 000 particuliers et 252 000 professionnels, obtenues à partir d’un outil de gestion de la relation avec les usagers de la DGFiP ». Les infiltrations dans la DGFiP ont commencé dès le mois de mai 2026.

L’ANSSI revient tout d’abord sur la sécurité des comptes et le volume important de ceux auxquels le pirate pouvait accéder car il disposait des couples identifiant et mot de passe. En effet, « aucune tentative d’attaque par force brute ou credential stuffing n’a été identifiée, ce qui signifie que l’attaquant disposait de mots de passe pour ces comptes (pouvant être valides ou expirés) ».

Dans son rapport, l’ANSSI anonymise les comptes compromis et utilise la dénomination suivante : compte-dgfip-X pour ceux internes à la DFGIP, et compte-dgfip-xt-Y pour les externes. Les X et Y sont incrémentés pour différencier chaque compte. Voici le bilan officiel : compte-dgfip-X va jusqu’à 22 et compte-dgfip-xt-X jusqu’à 7… soit presque une trentaine de comptes compromis par infostealer.

Pour les comptes externes, « les investigations de la DGFiP mettront en évidence que la compromission du poste d’un géomètre-expert au sein d’un cabinet privé a permis de contourner la double authentification par messagerie, puis l’accès et l’exfiltration des données entre le 27 juillet 2026 et le 8 août 2026 ».

La réinitialisation des mots de passe n’a pas servi à grand-chose.

Une des pistes évoquées pour obtenir ses informations est « la fuite d’identifiants de connexion fréquente et consécutive à l’utilisation d’appareils personnels ». La DGFiP a procédé à la réinitialisation des mots de passe, mais si des machines restent infectées et/ou que les sessions actives ne sont pas coupées, cela n’est pas d’une grande utilité.

Preuve en est : la réinitialisation du 24 juin 2026 « n’interrompt pas la session et l’exfiltration en cours qui se poursuivent », précise l’ANSSI dans le détail de la chronologie des faits. Ajoutez à cela « l’absence d’authentification forte sur deux portails dont l’un donnant accès à des ressources sensibles » et vous avez un combo explosif.

Des indices en pagaille : IP en Inde, des Go téléchargés, connexions nocturnes

Autre problème pour l’ANSSI, le manque de détection : « Les sessions d’exfiltration menées par l’attaquant n’ont pas été détectées en temps réel par les mécanismes de contrôle implémentés sur les applicatifs métiers ni sur les équipements de sécurité de la DGFiP ».

Il y avait pourtant des indices élémentaires facile à identifier : « la volumétrie d’informations échangées lors des connexions (11Go entre le 22 et 25 juin, 3Go entre le 21 et 23 juillet) », ainsi que « le nombre de requêtes par utilisateur sur une plage temporelle ».

L’Agence prend soin de préciser que « la technique de scraping utilisée par les attaquants impose de devoir initier autant de requêtes que de pages accédées ». Cela aurait dû déclencher des alertes. Une technique connue depuis la nuit des temps aurait dû être mise en place : un rate-limiting. Le but est de bloquer un nombre trop important de requêtes, permettant aussi de limiter des attaques par force brute.

Ce n’est pas le seul problème. La DGFiP n’analysait pas les adresses IP puisque des connexions ont été réalisées « depuis des adresses de VPN, depuis des adresses localisées en Inde et pour plusieurs catégorisées comme malveillantes ». Ajoutez à cela des adresses IP déjà identifiées comme liées à un compte compromis qui peuvent revenir en toute impunité et des heures de connexions nocturnes ; vous avez un beau tableau de ce qu’il ne faut pas faire.

« Ces paramètres pris individuellement ne permettent généralement pas d’identifier des comportements suspects sans générer d’importants volumes de faux positifs, néanmoins la corrélation de plusieurs d’entre eux aurait pu permettre de lever des alertes », ajoute l’ANSSI.

Après « le besoin d’en connaître », le besoin d’y avoir accès

Troisième point de faiblesse : le RIE ou Réseau Interministériel de l’État, utilisé par les pirates pour accéder « au portail ADER [Accès Distant aux Échanges Réseau, ndlr] de la DGFiP ». Opérationnel depuis 2013, il raccorde les services de l’État. L’ANSSI note que « plusieurs accès illégitimes identifiés proviennent du RIE [la suite est caviardée, ndlr], à partir de localisations n’ayant pas de besoins apparents d’accéder à des infrastructures de la DGFiP ».

« Pendant l’incident, le SOC [Security Operation Center, ndlr] de la DGFiP ne supervisait pas le portail ADER, utilisé par l’attaquant pour exfiltrer les informations E-Contact », contrairement au portail PIGP (Portail internet de la gestion publique) qui était bien surveillé. Ce trou dans la raquette a permis aux pirates de s’infiltrer, mais a aussi empêché « de corréler des activités malveillantes avec le reste du SI ou en provenance du RIE suite à un signalement d’un autre ministère ».

Là encore on retrouve un basique de la cybersécurité : la segmentation réseau avec le cloisonnement des « accès aux seules populations et zones logiques qui en ont le besoin ». L’Agence recommande de mettre en place « un filtrage plus fin des accès réseau entre ministères et au sein du RIE ».

Comment les pirates sont rentrés dans le RIE ? Par la porte ouverte d’un autre piratage : « L’utilisation du RIE lui a été rendue possible à cause de la compromission d’infrastructures appartenant au ministère de l’Éducation nationale elles-mêmes raccordées au RIE ». Pour l’ANSSI, cela illustre parfaitement le « risque de latéralisation depuis des ressources d’organismes tiers » et le besoin de cloisonner.

Des signalements en pagaille

L’ANSSI fait son mea culpa sur sa supervision. « Les acteurs malveillants utilisaient des comptes légitimes pour accéder aux applications et la supervision réseau de l’Agence n’a pas permis de les voir ». De plus, « le volume cumulé de requêtes que l’attaquant a dû générer pour orchestrer l’exfiltration de données aurait dû déclencher des alertes ».

Dans la même veine, elle explique qu’un partenaire l’a informé le 15 juin de la compromission de deux comptes DGFIP. Cette dernière « ne répond pas et n’est pas relancée par l’Agence ». Nouveau signalement le 22 juin, suivi d’une action cette fois-ci : « un partenaire informe l’ANSSI de la compromission d’un compte. La DGFIP répond le jour même à l’ANSSI avoir réinitialisé ce compte et sensibilisé leur agent ».

D’autres signalements sont remontés dans la chronologie, notamment le 29 juin 2026 avec un bel acte manqué : « un partenaire informe l’ANSSI de la compromission du compte. Il s’agit du compte utilisé pour l’exfiltration de données le 24 juin 2026, or cette compromission n’était pas connue à cette date et les analyses menées par le SOC de la DGFIP ne l’identifient pas. La DGFIP répond le jour même à l’ANSSI avoir déjà connaissance de ce fait et confirme l’avoir réinitialisé ».

D’autres signalements ? Le 1ᵉʳ juillet, la « DGFIP est informée par son prestataire de la vente de deux comptes ». Là aussi le pot aux roses aurait pu être découvert : « les investigations montreront, à posteriori, des échecs de connexion sur le PIGP le même jour et le jour précédent avec ces comptes à partir d’une des adresses IP utilisées pour l’exfiltration du 24 juin 2026 ».

Plein de mesures de remédiation, ça fait pas de mal de les relire !

Enfin, l’ANSSI propose des mesures de remédiation (page 10) afin « d’assurer que le même chemin de compromission ne puisse être emprunté de nouveau, par le même acteur ou un nouveau ». Elles couvrent toutes les lacunes précédentes et ouvrent aussi de nouvelles pistes.

Cela va des restrictions d’accès aux ressources métiers à la protection contre les vols d’identifiants. On y retrouve notamment des propositions sur le matériel. « L’usage d’appareils personnels pour accéder à des ressources professionnelles doit être proscrit », et les machines professionnelles doivent être durcies. Évidemment, l’authentification multifacteurs doit être généralisée.

Pour les applications à usage interne, l’accessibilité ne doit se faire « que depuis des postes administrés par la DGFiP. Dans ce cas, l’accès à l’application ne doit pas être possible depuis Internet, sauf à travers un VPN dédié aux agents de la DGFiP ». Les VPN ne servent pas uniquement à contourner des restrictions, ils permettent aussi de renforcer la sécurité, mais attention aux promesses de certains !

Dans sa synthèse, l’ANSSI rappelle que l’exfiltration des données s’est produite sept semaines avant la revendication des pirates le 12 août, et « qu’elle a été précédée de plusieurs semaines d’exploration sur des applicatifs de la DGFIP ».

Des indices étaient bien présents, mais pas correctement pris en compte, c’est un rappel important pour toute la communauté cyber. En effet, ces recommandations peuvent s’appliquer bien au-delà de la DGFiP. Il est toujours bon de les lire et de vérifier qu’elles sont bien appliquées.

  •  

Le vrai prix de Gemini 3.1 à 3.8 : coût, tokens et performances face à nos prompts

Pour trois fois rien, on n’a pas toujours quelque chose…
Le vrai prix de Gemini 3.1 à 3.8 : coût, tokens et performances face à nos prompts

Gemini, l’intelligence artificielle de Google, consomme bien moins de tokens que ses concurrents, tout en coûtant moins cher. Le prix moyen d’une requête sur les derniers modèles n’est que de 1,2 centime environ. Que des bonnes nouvelles ? Non, car elle ne parvient pas à répondre correctement au prompt Extension.

Après Claude d’Anthropic et ChatGPT d’OpenAI, place à Gemini de Google. L’intelligence artificielle du moteur de recherche infuse dans de nombreux produits, à commencer par Android. Elle est donc largement utilisée à travers le monde et, contrairement à ses deux concurrents, la question du coût est plus secondaire à cause de cette profonde intégration.

Des tokens à moitié prix jusqu’à fin 2026

Comme dans les deux précédents articles, nous passons par l’API pour connaître le nombre de tokens en entrée et en sortie, qui comprend aussi ceux utilisés pendant le raisonnement, le cas échéant. Nous avons testé plusieurs modèles différents, de Gemini 3.1 à 3.8 flash, la dernière version en date. Google propose quatre niveaux de réflexion avec Gemini 3.1 à 3.6, avec minimal, low, medium et high. Avec les 3.1 Pro, 3.7 et 3.8 seuls les trois derniers (low, medium et high) sont possibles.

Via l’API, Gemini 3.6 à 3.8 ont un tarif de 0,75 dollar par million de tokens en entrée… mais jusqu’au 31 décembre 2026 seulement. Idem en sortie avec 3,75 dollars par million de tokens. À partir du 1ᵉʳ janvier 2027, les deux prix doubleront, pour atteindre respectivement 1,5 et 7,5 dollars.

La version 3.5 Flash est la plus chère, avec 1,5 et 9 dollars respectivement, tandis que la 3.1 Flash Lite est moins chère avec 0,25 et 1,5 dollar. La palme revient à Gemini 3.1 Pro avec 2 et 12 dollars par millions respectivement.

Nous avons repris exactement les mêmes prompts que pour Claude et ChatGPT avec, en gras, le petit nom que nous leur avons attribué. Les voici pour mémoire :

Devinette : « Ô frère, fils de ma mère, ton père est le frère de mon enfant. Qui suis-je ? »

Carnet de voyage : « L’été prochain je vais avoir trois semaines de vacances. Je suis avec ma petite voiture électrique Sprind (charge à 30 kW max) et je voudrais visiter le sud de Bayonne à Montpellier en prenant mon temps. Propose-moi un carnet de voyage »

Extension : « Je veux une extension pour Chrome et Firefox qui me permet d’inverser les titres et les sous-titres sur le site d’actualité Next.ink. S’il n’y a pas de sous-titre, c’est que c’est un brief. Alors fais en sorte d’en inventer un à partir du titre du brief. L’extension doit avoir un sélecteur pour activer/désactiver l’inversion en direct sur la page »

Nouveauté de notre protocole : la vérification des extensions !

Pour ce nouvel article, une nouveauté que vous avez demandée à plusieurs reprises dans les commentaires : une estimation de la validité des résultats. C’est désormais le cas pour les extensions. Les deux autres prompts sont en cours de validation, nous y reviendrons dans un prochain article.

Nous avons mis au point et utilisé un protocole de vérification avec Playwright et le navigateur Chromium. Les fichiers de l’extension sont générés automatiquement à partir de la réponse du modèle, puis elle est chargée dans le navigateur via Playwright. L’extension est lancée sur une fausse page (fichier html local) reprenant la structure de Next, puis en live sur Next.ink.


Il reste 67% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Pangram sait-il vraiment détecter les textes IA ? Notre test sur plus de 1 000 articles

On peut tromper 1 000 fois un détecteur, mais pas 1 000 détecteurs une fois
Pangram sait-il vraiment détecter les textes IA ? Notre test sur plus de 1 000 articles

Après les tests sur les détecteurs à poids ouverts, passons à un modèle commercial qui fait beaucoup parler de lui : Pangram. Nous lui avons envoyé des centaines d’articles, soit rédigés à 100 % par des humains (depuis notre base de données), soit générés par des IA.

Quasiment 100 % de réussite sur les articles écrits par des humains

En tout, 460 articles humains ont été soumis au détecteur. Pangram en a détecté 450 comme totalement humains, 9 comme principalement humains mais avec quelques passages signalés comme étant GenAI et enfin un seul faux positif identifié comme étant surtout écrit par une IA.

Dans les 460 textes, une trentaine de textes n’avaient jamais été publiés sur Internet, impossible donc pour Pangram d’en trouver la moindre trace (ce sont des brouillons finalisés de certains articles). Gardez en tête un élément important de notre analyse : elle repose sur un corpus d’articles techniques.

  • Bilan : 459 textes sur 460 sont bien étiquetés humains.

95 % de réussite sur notre corpus de textes GenAI

Sur les textes générés par IA nous avons multiplié les analyses. Nous avons utilisé 350 textes différents générés par IA, mais au total 570 articles ont été soumis au détecteur Pangram. Il y a parfois plusieurs variantes d’un même texte pour essayer de comprendre les mécanismes du détecteur. Nous y reviendrons.


Il reste 89% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

On a soumis plus de 5 000 textes à 75 détecteurs d’IA gratuits : un constat d’échec

Détecte moi si tu peux
On a soumis plus de 5 000 textes à 75 détecteurs d’IA gratuits : un constat d’échec

La détection de textes générés par IA est sur toutes les lèvres depuis l’affaire du livre de Thélyson Orélien. Chez Next, nous avons décidé de voir ce qu’il en était avec des milliers de nos articles, écrits à 100 % par des humains ! Dans cette première partie, nous passons au crible 75 détecteurs gratuits.

Next s’engage de manière forte sur l’utilisation de l’IA générative : aucun de nos articles n’est rédigé tout ou partie avec des IA génératives. Nous allons très prochainement publier une charte précise sur le sujet, mais ce n’est pas l’objet du jour.

Cette première partie de notre dossier permet de poser les bases : comment sont étiquetés nos 5 000 articles, quels sont les détecteurs utilisés et surtout ce que la détection implique. Car, oui, c’est une histoire de compromis entre les vraies et les fausses détections ; et il n’est pas toujours facile de placer le curseur au bon endroit.

5 000 textes passés au crible de 75 détecteurs

Pour nos tests, nous avons plus de 5 000 textes étiquetés ainsi : 4 000 articles écrits à 100 % par des humains (actus Next) et plus de 1 000 générés par des IA. Première limite : notre corpus de textes comprend donc des articles techniques, avec la patte et l’angle Next.

Nous avons généré entre 150 et 200 articles par modèle Anthropic, OpenAI, Google, Mistral et Qwen. La moitié environ est générée depuis des réécritures d’un article humain, l’autre moitié inventée à partir d’un titre et du chapô.

Nous avons ensuite testé environ 70 combinaisons de détecteurs d’IA. Dans le détail, il y a cinq classifieurs autonomes : AI Text Detector, RoBERTa AI Text Detection (de fakespot), ChatGPT Detector RoBERTa, RoBERTa OpenAI Detector et RADAR Vicuna-7B.

Nous avons également une dizaine de méthodes statistiques (Binoculars, Fast-DetectGPT, log-vraisemblance, GLTR, entropie…) avec sept modèles de langage (Qwen, Llama, Gemma, Mistral…). On parle dans ce cas de détecteurs statistiques (ou zero-shot) : ils utilisent un modèle de langage pour estimer à quel point un texte est prévisible, et donc potentiellement généré par IA.

Les 5 classifieurs et les 70 combinaisons de détecteurs statistiques sont tous exécutés sur les 5 000 articles, dans un VPS géré par nos soins, avec un A10 de NVIDIA (cela a tout de même nécessité près de 10 heures de calcul). Font-ils mieux qu’un pile ou face ?

TPR, FPR, AUROC : des notions importantes pour comprendre la suite !


Il reste 84% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ Raspberry Pi bloque les changements sauvages de puces mémoire


Il est loin le temps où le Raspberry Pi 5 de 4 Go se trouvait pour un peu plus de 60 euros. Le revendeur officiel Kubii le propose désormais à plus de 135 euros. En cause, la pénurie sur les puces mémoire causée par l’ogre IA, avec une explosion des prix.

Face à cette crise, des bidouilleurs (un peu extrêmes) modifiaient leur Raspberry Pi afin de changer la puce mémoire. Une opération qui nécessite de dessouder l’ancienne puce et de souder la nouvelle, ce qui n’est pas à la portée de n’importe qui.

Cette technique fonctionnait, mais Raspberry Pi a sifflé depuis un moment déjà la fin de la récréation avec un blocage au niveau du firmware, au moins sur les Raspberry Pi 5 et Compute Module 5. Si la puce n’est pas de la bonne taille ou n’est pas certifiée pour la carte (avec les multiples sources d’approvisionnement, les réglages ne sont pas toujours les mêmes), alors le Raspberry Pi refusera de démarrer.

Illustration : Flock

Un comble pour un microordinateur jouant justement sur le côté bidouille dans ses usages ? C’est évident pour certains, mais comme l’expliquait récemment un ingénieur de Raspberry Pi, la situation est plus complexe : « Si la main-d’œuvre est suffisamment bon marché, il peut être rentable d’acheter une carte avec, par exemple, 2 Go de mémoire et de la remplacer par une puce de 8 Go d’origine douteuse, puis de la revendre comme un appareil de 8 Go », mais avec une puce de mauvaise qualité pouvant entrainer des plantages à répétition.

Selon Minimachines, avec cette décision « Raspberry Pi veut éviter que des mafias s’emparent de cette faille ». Pour notre confrère, « une alternative sage à ce blocage aurait pu être trouvée. Celle d’un avertissement au démarrage indiquant au client final la modification de mémoire de la carte […]. Cela empêcherait le commerce de ce type de cartes contrefaites ».

Pour Jeff Geerling (youtubeur hardware bien connu), le changement sur le firmware et la mise en place du blocage remonteraient à 2024, et donc avant la crise de la mémoire. Il n’a néanmoins été confirmé que récemment par PhilE, ingénieur chez Raspberry Pi et modérateur du forum.

  •  

Suncatcher : Google envoie en orbite ses premiers TPU pour l’IA

The World Is Not Enough
Suncatcher : Google envoie en orbite ses premiers TPU pour l’IA

Cette semaine, Google va envoyer dans l’espace ses premiers TPU (des puces dédiées à l’intelligence artificielle). Il ne s’agit pour le moment que de récolter des informations sur l’état des puces, puis en 2027 ce sera au tour des communications entre satellites.

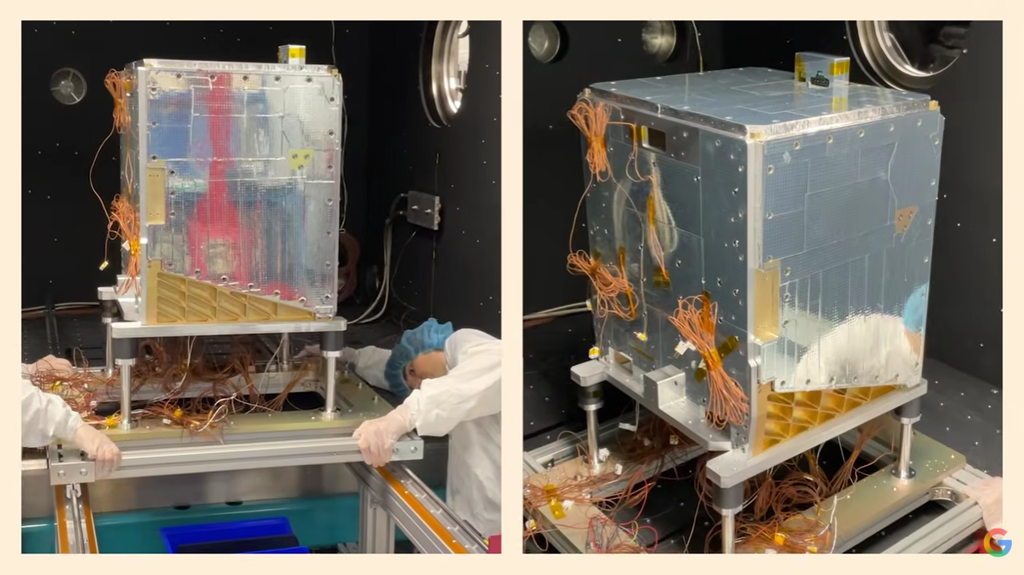
Le 1ᵉʳ octobre, la mission Transporter-18 de SpaceX décollera du Space Launch Complex 4E (SLC-4E) à Vandenberg en Californie. À l’intérieur, 130 charges utiles (cubesats, microsats, véhicules spatiaux…), dont le projet Suncatcher de Google, avec Planet Labs pour la conception du prototype.

Nous en parlions déjà il y a un an : le géant du Net va analyser « comment un réseau interconnecté de satellites alimentés grâce à l’énergie solaire et équipés de nos puces IA Tensor Processing Unit (TPU) pourrait exploiter toute la puissance du Soleil ».

Le lancement prévu jeudi est donc la première étape concrète de ce projet. But de l’opération : récolter des données. Google résume la situation : « certaines choses ne peuvent être testées que dans l’espace ».

10 minutes de « folie » avant d’arriver dans l’espace

Le décollage d’une fusée dure une dizaine de minutes avant d’arriver sur une orbite basse. Cette période est intense avec des « vibrations intenses ainsi que des accélérations atteignant jusqu’à 10 fois la force de gravité (ou force g) », rappelle Google.

L’entreprise ajoute que « certains composants, comme les puces TPU, peuvent être soumis à des forces encore plus élevées, allant de 50 à 100 g ». Ces pics sont causés par les vibrations et les chocs qui se produisent lors du décollage. Google a réalisé des tests en laboratoire, mais rien ne remplace l’expérience du terrain.

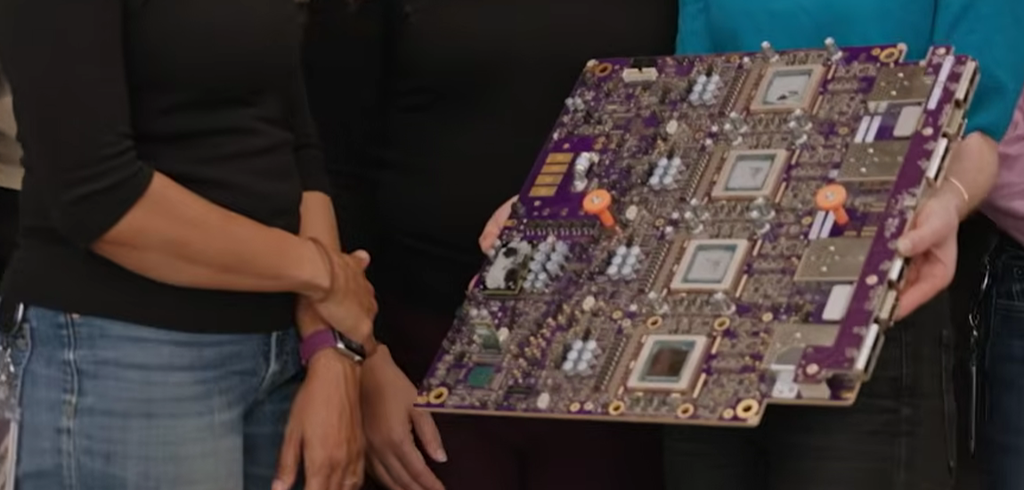
Voici une photo de la carte mère envoyée en orbite, avec quatre TPU dessus :

Les radiations et le refroidissement, deux enjeux importants

Une fois dans l’espace, un autre problème arrive : les radiations. Elles peuvent endommager les composants lors d’une longue exposition. Là aussi, Google a réalisé des tests en amont : « Les premiers résultats montrent que nos TPU Trillium affichent une résistance remarquable et peuvent supporter une dose totale de rayonnement ionisant supérieure à celle qu’ils recevraient durant une mission de cinq ans ». Mais les radiations peuvent aussi provoquer des inversions de bits (bit-flip) pendant les phases de calculs, et donc conduire à des erreurs.

En outre, on imagine souvent l’espace comme glacial, et on pourrait se dire que c’est idéal pour refroidir des puces. Pas si vite, car un satellite exposé au Soleil peut rapidement chauffer. Un exemple parlant avec les températures que peuvent subir les combinaisons spatiales des astronautes : entre - 157 et + 121 °C, selon la NASA.

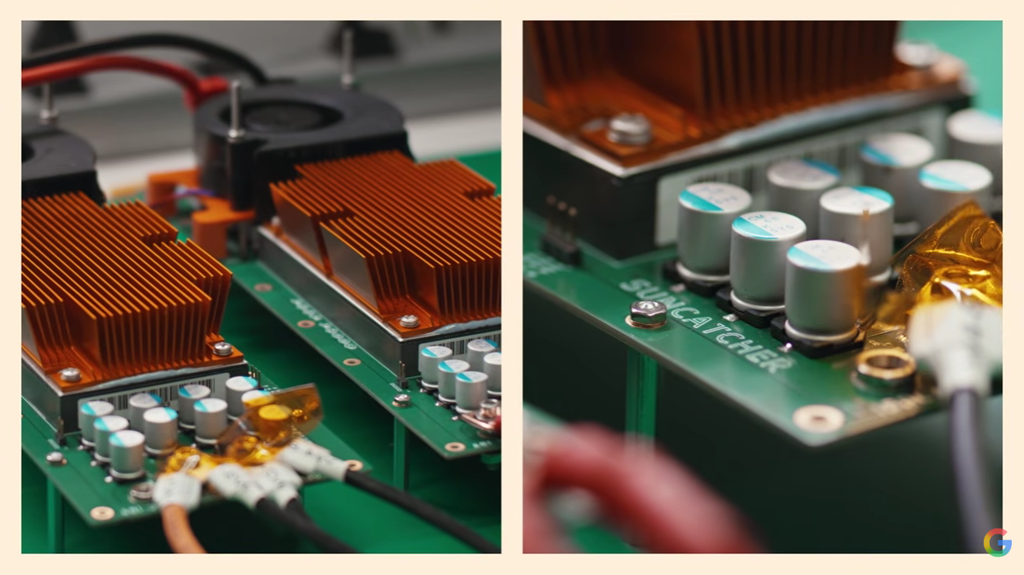
À l’intérieur des machines, les « TPU génèrent une quantité importante de chaleur sur une petite surface […] Dans l’espace, il n’y a pas de circulation d’air, la dissipation thermique ne peut s’effectuer que par rayonnement (via des radiateurs) ». Google s’est lancé sur « une solution combinant caloducs et radiateurs pour refroidir les puces ». Après le passage dans une chambre à vide thermique, place à l’espace.

En 2027, des tests de communication entre satellites

Plus tard, en 2027, la communication entre deux satellites du projet Suncatcher sera testée. C’est un point crucial pour Google car les calculs liés à l’IA générative répartis entre plusieurs satellites nécessitent une forte bande passante, de l’ordre de 10 Tb/s.

L’entreprise va utiliser des lasers, une technologie spatiale déjà éprouvée, mais « la plupart des systèmes de pointe sont optimisés pour une faible bande passante sur de longues distances, alors que nos lasers doivent fonctionner avec une bande passante très élevée sur des distances extrêmement courtes », de l’ordre de « quelques centaines de mètres » entre les satellites.

Google a besoin d’une précision extrême selon son communiqué, de l’ordre de celle permettant d’atteindre « une cible de la taille d’une pièce de monnaie à plusieurs kilomètres de distance », avec les deux parties en mouvement.

Cette première étape ne vise donc qu’à démontrer que le matériel « peut résister aux réalités physiques et imprévisibles d’une exploitation en orbite ». Une série de vidéos a été mise en ligne pour l’occasion. C’est aussi l’occasion d’identifier les « surprises » qui peuvent arriver.

HPE avait connu quelques surprises avec ses serveurs en orbite

Ce n’est pas HPE qui dira le contraire avec des serveurs envoyés dans l’ISS (Spaceborne Computer). La situation n’est pas tout à fait identique puisque la Station spatiale internationale est pressurisée, des ventilateurs peuvent donc se servir de l’air pour dissiper la chaleur. Suncatcher sera dans le vide et n’aura pas cette possibilité.

Un exemple de surprise chez HPE : « En l’absence de pesanteur, les composants non attachés flottent à l’intérieur du châssis, y compris le câblage interne. Des fils se sont aventurés trop près des ventilateurs du système de refroidissement, ce qui a limé les fils pendant le fonctionnement, produisant des poussières à l’intérieur du système. Elles ont ensuite été capturées par les filtres ». À voir maintenant si Google proposera à la communauté un retour d’expérience aussi complet.

Google rappelle enfin que, « en orbite terrestre basse, les satellites peuvent accéder à une lumière solaire quasi constante, générant jusqu’à huit fois plus d’énergie solaire que sur Terre », de quoi profiter d’une électricité 100 % renouvelable (pour de vrai) avec une empreinte carbone sur la Terre nulle lors de l’utilisation des satellites.

Le coût d’un datacenter spatial comparable à un terrestre ?

L’électricité est captée en direct, le refroidissement ne prélève pas d’eau et ne rejette rien dans notre atmosphère. Reste tout de même la production des puces et leur envoi dans l’espace, deux postes à forte empreinte carbone. Il n’y a pas de recyclage, les satellites en basse altitude finissent par se désintégrer dans l’atmosphère.

Google a mené une étude de coût avant de se lancer : les prix des lancements « pourraient tomber à moins de 200 dollars par kg d’ici le milieu des années 2030 […] À ce prix, le coût de lancement et d’exploitation d’un centre de données spatial pourrait devenir à peu près comparable aux coûts énergétiques d’un centre de données terrestre équivalent ».

  •  

La 2G s’éteint dans trois mois… mais il y a encore 1,7 million de cartes SIM actives

« La 2G m’a tuer », signé le Nokia 3310
La 2G s’éteint dans trois mois… mais il y a encore 1,7 million de cartes SIM actives

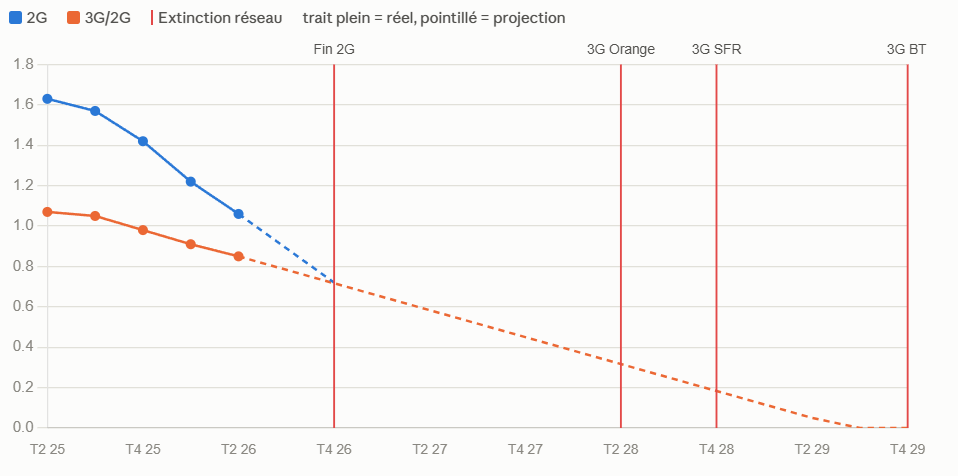
Fin juin 2026, plus d’un million de cartes SIM 2G étaient encore actives dans des smartphones et des tablettes 2G compatibles 2G seulement. Il y en avait aussi plus de 600 000 pour des communications Machine to Machine. Problème, dans trois mois la 2G sera définitivement éteinte. Il faut aussi préparer la fin de la 3G pour 2028/2029.

C’est acté depuis bien longtemps : la 2G tire sa révérence en France cette année. Orange a fermé ses premiers sites en mars dans le Sud-Ouest et a continué avec les départements 64, 47, 46, 32, 65, 31, 82 et 09.

En 2026, la 2G sera définitivement éteinte

Place maintenant à la généralisation sur l’ensemble du territoire avec une extinction totale fin 2026 chez Orange. Les autres opérateurs suivent quasiment le même calendrier.

SFR a prévu d’arrêter sa 2G le 15 novembre 2026, et c’est aussi à cette date que Bouygues Telecom débutera par Brest, Guipavas, Nancy et Vandœuvre-lès-Nancy, avant de généraliser en décembre. Free n’a, pour rappel, pas de réseau 2G en propre et passe par un contrat d’itinérance avec Orange.

Bref, fin 2026 – c’est-à-dire dans à peine trois mois –, la 2G ne sera plus qu’un souvenir chez les quatre opérateurs nationaux. Mais qu’en est-il chez les utilisateurs ?

Plus d’un million de cartes SIM 2G encore en circulation

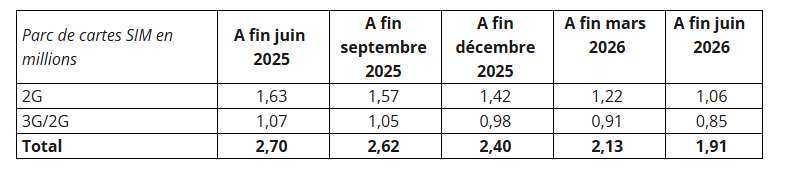
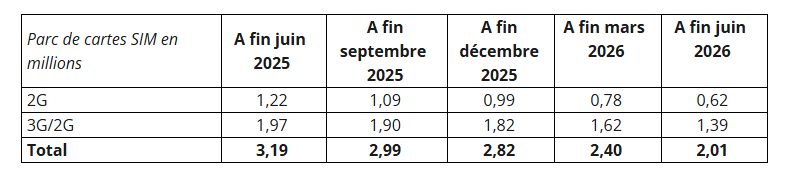
Depuis plusieurs trimestres, l’Arcep tient à jour un observatoire des cartes SIM utilisées dans les terminaux compatibles uniquement avec la 2G et la 3G. Fin juin 2026, elles étaient encore 1,91 million dans des terminaux pour les particuliers.

1,06 million de cartes SIM sont dans des téléphones mobiles et des tablettes uniquement compatibles avec la 2G ; elles seront donc inutilisables fin 2026 chez l’ensemble des opérateurs. Un an auparavant, il y avait 1,63 million de cartes SIM en circulation.

Depuis trois trimestres, le rythme est aux alentours de 150 000 à 200 000 cartes SIM 2G en moins. La baisse entre juin et septembre 2025 était moins importante avec 60 000 cartes seulement. Avec le rythme moyen des trois derniers trimestres (56 000 SIM par mois), il faudrait encore un an et demi pour éradiquer les dernières cartes… alors qu’il ne reste que trois mois pour les plus chanceux.

En 2028 et 2029, ce sera au tour de la 3G

Qu’en est-il de la 3G ? Son extinction est aussi programmée : 2028 chez Orange (et même chose pour Free Mobile), fin 2028 pour SFR et fin 2029 pour Bouygues Telecom qui devrait donc la maintenir un an de plus que ses concurrents.

Le parc des terminaux compatibles avec la 3G et la 2G uniquement est encore de 0,85 million à fin juin 2026, contre 1,07 million un an auparavant, toujours uniquement pour les smartphones et tablettes du grand public.

Là encore les baisses restent relativement régulières depuis trois trimestres avec 67 000 terminaux de moins par trimestre, soit 22 000 environ par mois. Avec encore 0,85 million en circulation, cela donnerait un peu plus de trois ans pour arriver à 0 au rythme actuel. Problème, la 3G sera arrêtée avant chez Orange, Free et SFR, seul Bouygues Telecom devrait encore avoir de la 3G, du moins selon les prévisions actuelles.

L’autre versant de la fin de la 2G et 3G : le Machine to Machine

On ne parle ici que des cartes SIM pour les appels, voix et Internet dans les tablettes et les smartphones, mais il y a aussi le M2M (Machine to Machine). Attention, l’Arcep précise que cela ne concerne pas les « cartes SIM montées par les constructeurs automobiles dans les véhicules ».

Fin juin, il restait encore 620 000 cartes SIM 2G en circulation et 1,39 million de cartes SIM 2G/3G. On retrouve des cartes M2M dans de nombreuses industries : alarmes, téléassistance, transport, services de l’eau, ascenseurs… Pour ces derniers, un décret a été publié en mars pour « garantir la sécurité des ascenseurs », avec notamment un contrôle technique renforcé.

Migrations forcées et parfois couteuses

Au total, cela fait donc 1,7 million de cartes SIM encore en circulation à fin juin 2026, si on prend celles du grand public et du M2M. Pour le grand public, cela passe par l’achat d’un nouveau téléphone mobile. Pour les équipements M2M, par le changement (souvent coûteux) du modem au moins. Il existe parfois des solutions intermédiaires avec des « kits de migration », mais encore faut-il qu’il en existe pour votre matériel.

Et ne comptez pas trouver des adaptateurs 4G/5G vers 3G en France. Les fréquences sont attribuées aux opérateurs qui ont payé cher pour en avoir un usage exclusif. Les fréquences libérées avec l’arrêt de la 2G sont d’ailleurs réutilisées pour augmenter la bande passante d’autres technologies de téléphonie mobile.

  •  

« Ils se défendent plus et mieux » : l’IA générative s’invite dans les litiges en .fr

L'humain n'a pas attendu l'IA pour écrire n'importe quoi
« Ils se défendent plus et mieux » : l’IA générative s’invite dans les litiges en .fr

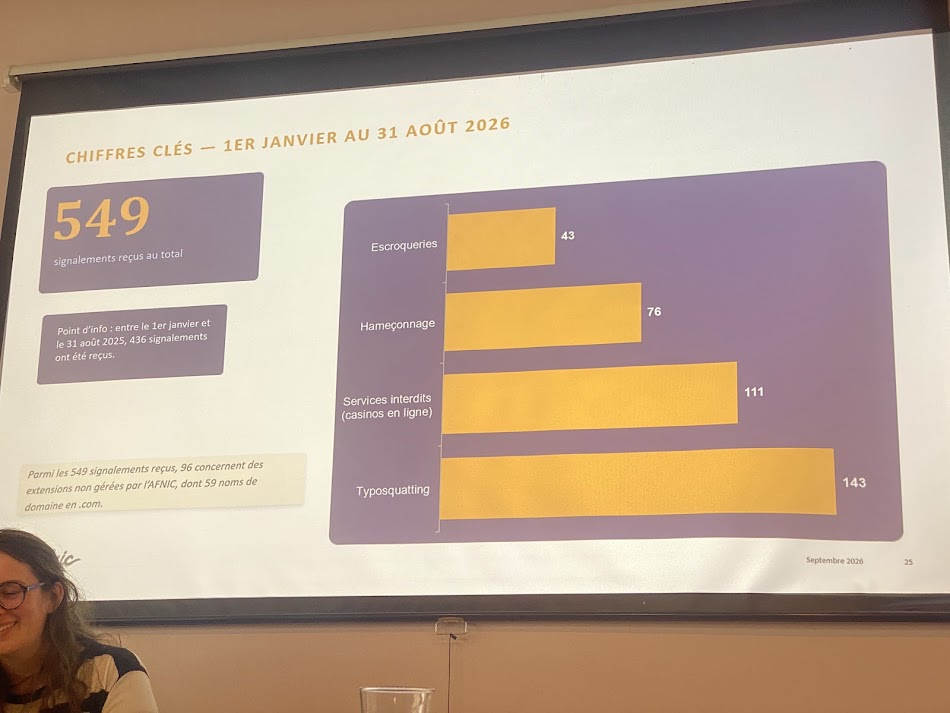
Depuis plusieurs années maintenant, l’Afnic (organisme en charge des noms de domaine en .fr) organise des rencontres juridiques. C’est l’occasion de faire le point sur les demandes de blocages, les abus et de parler d’un nouvel arrivant : l’IA générative. Next était présent.

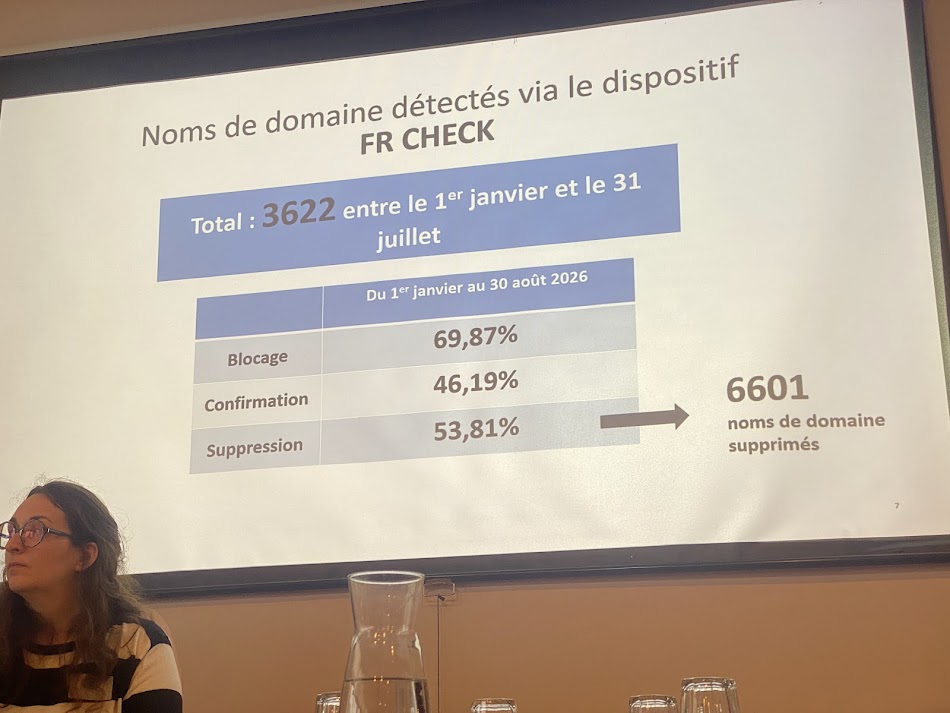
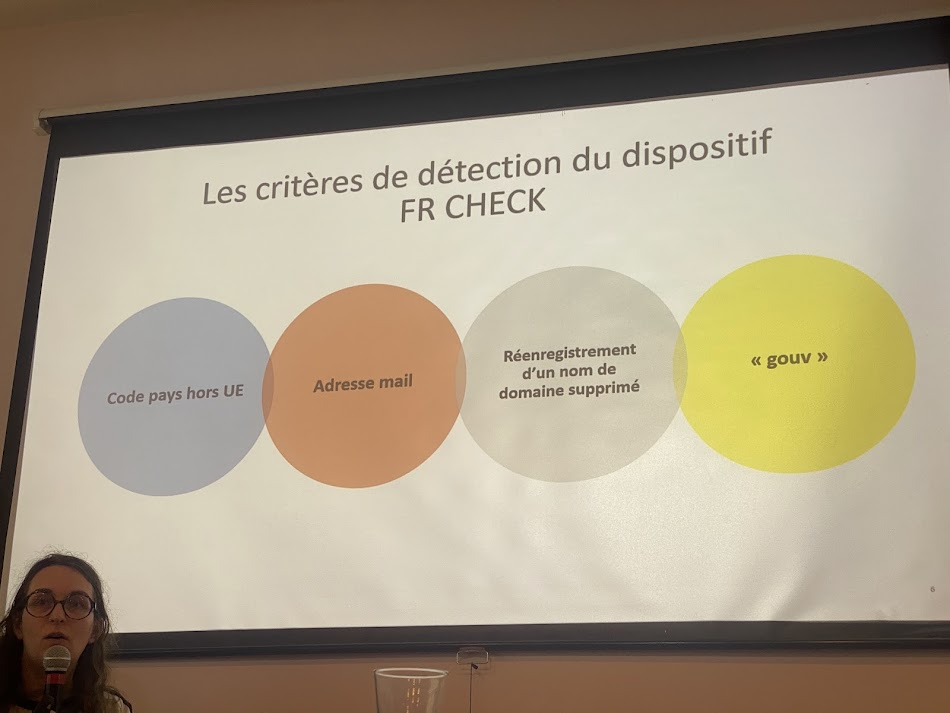
Premier point abordé, son dispositif FR Check qui vérifie certains noms de domaine lors des demandes d’enregistrement. C’est le cas pour ceux qui ont été précédemment supprimés par l’Afnic, qui ont un email de contact invalide, un code pays non éligible (en dehors de l’UE, de l’EEE et de la Suisse) et enfin contenant « gouv » car ils présentent un risque important de phishing.

C’est un premier tri à l’entrée, mais cela n’empêche évidemment pas des petits malins de passer entre les mailles du filet, avec un qouv.fr par exemple. Les procédures de vérification au fil du temps et de signalement restent donc indispensables.

L’une des procédures fétiches de l’Afnic est la vérification des données du titulaire. En cas de défaut, cela peut entrainer la suppression du nom de domaine, mais aussi de l’ensemble du portefeuille des noms de domaine du titulaire ; un bel exemple de l’effet boule de neige. Prochainement, France Transfert sera utilisé pour lui envoyer des documents.

Plein de faux jugements, l’Afnic s’est même fait usurper son identité


Il reste 81% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Nouvelles extensions Internet : 1 616 demandes payées, joyeux Hunger Games à tous

ICANN’t stop them now
Nouvelles extensions Internet : 1 616 demandes payées, joyeux Hunger Games à tous

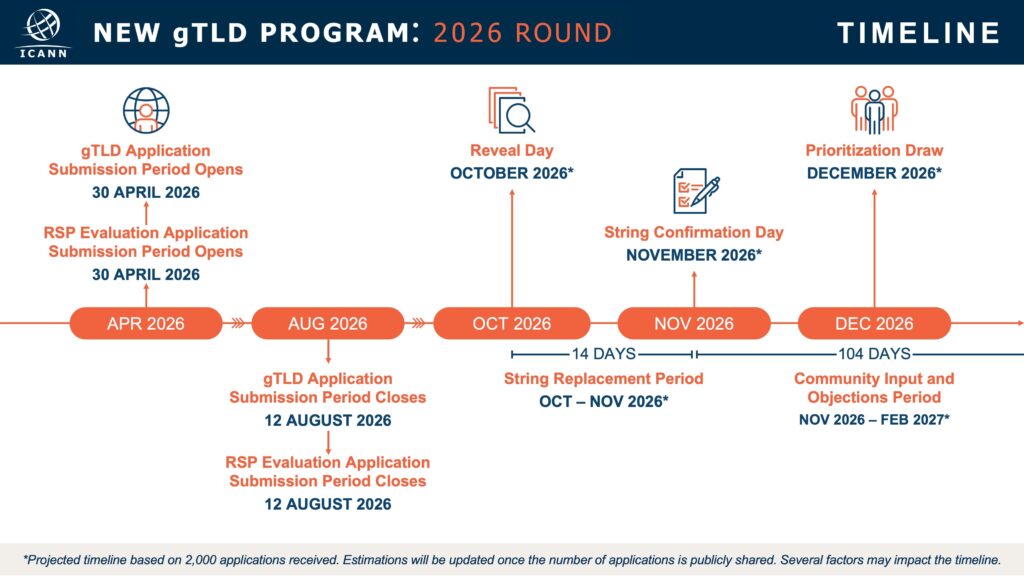
L’ICANN vient de confirmer que 1 616 demandes ont été payées pour de nouvelles extensions de premier niveau sur Internet. La liste n’est pas encore connue, mais devrait l’être dans les prochaines semaines, ce qui permettra de savoir quelles sont les extensions demandées plusieurs fois. Un long processus s’engagera alors… mais certains n’ont pas attendu pour déjà s’attaquer aux tribunaux.

Cela fait déjà 14 ans que les dernières extensions ont été ajoutées sur Internet, on parle des extensions de premier niveau, comme les .alsace, .best, .sncf et .xyz pour ne citer qu’elles. Les propriétaires de ces extensions peuvent ensuite vendre des domaines de deuxième niveau.

1 663 demandes, 1 616 payées

L’ICANN a rouvert les vannes cette année, avec le « round 2 » (ou série 2026) qui a suscité un engouement certain. Au total, 1 663 demandes ont été envoyées. Pour valider leur participation, les candidats avaient jusqu’au 19 août pour payer des frais de 227 000 dollars minimum par candidature, sauf dans le cadre du Applicant Support Program qui permet d’avoir des réductions sur la facture. Fin aout, l’ICANN annonçait que 56 entités étaient éligibles, mais sans indiquer combien ont réellement déposé des demandes.

Sur les 1 663, 1 616 se sont acquittés des frais nécessaires pour continuer, ce qui représenterait donc plus de 360 millions de dollars. Il y en avait un peu moins de 2 000 lors de la précédente campagne en 2012, pour un montant de 350 millions de dollars, selon l’ICANN.

Le détail des candidats sera annoncé au plus tard le 14 octobre, à l’occasion du Reveal Day. De plus amples détails sur le calendrier seront donnés en début de semaine prochaine. L’ICANN en profite pour lancer un avertissement :

« Ces dernières semaines, plusieurs candidats au Round 2026 ont décidé de divulguer publiquement à quelle(s) extension(s) ils auraient postulé. L’ICANN encourage les candidats et les parties intéressées à rester méfiants de toute information ne provenant pas directement de l’ICANN. Elle est la seule source pour des informations complètes et vérifiées sur les candidatures du Round 2026, y compris les entités qui ont postulé et pour quelle extension (ou extensions) ».

.easy : déjà des attaques devant les tribunaux

Comme nous le rappelions, « si plusieurs ont déposé les mêmes termes, les litiges pourraient bien se régler aux enchères au cas où les discussions à l’amiable sous l’égide de l’ICANN n’ont pas abouti ». Cette fois-ci, l’ICANN interdit aux candidats de régler directement entre eux (arrangement, accord financier…) un litige sur une extension. Pas besoin d’attendre le Reveal Day pour que les combats autour d’une extension commencent, comme le rapporte Domainnamewire. Le litige concerne l’extension .easy.

EasyGroup, qui a notamment EasyJet, « a menacé les candidats au domaine de premier niveau .easy, et l’un d’eux riposte désormais en justice », comme l’expliquent nos confrères. EasyGroup a en effet mis en demeure Link Freedom Group (LFG) de retirer sa candidature au plus tard le 9 septembre. Un troisième larron, Aruba, aurait aussi déposé une candidature pour cette extension.

De son côté, LFG demande à un juge de préciser que « tout litige concernant l’extension « .easy » doit se régler via la procédure d’arbitrage de l’ICANN, ou bien que l’extension de premier niveau « .easy » qu’elle projette de lancer ne portera pas atteinte aux marques d’easyGroup ». Le 10 septembre, LFG a aussi demandé à l’ICANN de disqualifier (la demande est publiée par Domainnamewire) EasyGroup pour ne pas avoir, selon elle, respecté les règles (notamment la communication interdite entre candidats) de ce deuxième round.

Le Texas « s’oppose à la candidature pour l’extension gTLD ".texas" »

Sur le .texas, l’État a pris les devants dans une lettre publiée par l’ICANN : « Je crois comprendre que des personnes n’ayant aucun lien avec le gouvernement de l’État du Texas pourraient déposer, ou auraient déjà déposé, une candidature pour la chaîne gTLD « .texas » dans le cadre du cycle 2026 du programme gTLD de l’ICANN […] Sur instruction du gouverneur, je vous informe par la présente que l’État du Texas ne soutient pas et s’oppose à la candidature pour l’extension gTLD « .texas », ainsi qu’à toute extension qui en serait dérivée ». L’État ne précise pas s’il est candidat, mais le ton de la lettre laisse penser que non. En tout cas, aucune candidature tierce pour le .texas ne pourra être validée par l’ICANN.

L’ICANN n’a rien publié pour le moment concernant le .easy. La dernière correspondance concerne bien les nouveaux gTLD ; il s’agit d’une lettre de l’avocat Jeff Neuman (fondateur et CEO de JJN) qui demande à l’ICANN de publier au plus vite la suite du calendrier et les modalités afin que chacun puisse se préparer.

Il rappelle notamment que « les candidats n’auront par ailleurs que 14 jours pour décider s’ils optent pour une extension de remplacement désignée à l’avance. Cette décision est irréversible » et nécessite donc un certain délai de réflexion, affirme-t-il. Les extensions de remplacement sont nombreuses, comme l’expliquait l’ICANN cet été dans un premier bilan : « plus de 1 600 candidatures primaires, dont plus de 1 100 incluent des candidatures pour des extensions de remplacement (candidatures secondaires) ».

De plus, « si le Reveal Day a lieu avant ou pendant l’ICANN 87 [du 17 au 22 octobre 2026 à Bali, ndlr], les candidats doivent être prêts, dès ce jour-là, à respecter les restrictions de communication » qui s’appliquent à ceux ayant postulé pour une même extension. C’est d’ailleurs sur ce point que porte la demande de LFG à l’ICANN, mais sur une zone grise : les discussions/attaques sont réalisées en amont du Reveal Day.

  •  

Eau, électricité : la consommation de 770 datacenters en Europe

Quand les datacenters boivent, qui trinque
Eau, électricité : la consommation de 770 datacenters en Europe

La Commission européenne propose un bilan des indicateurs environnementaux des datacenters en Europe… Du moins des 36 % qui ont répondu au questionnaire, pourtant obligatoire. On y trouve de fortes disparités suivant les pays, notamment en Belgique… où Google pourrait peser très lourd. La France est plutôt un bon élève sur l’usage de l’eau, mais pas sur l’efficacité électrique.

Dans l’Union européenne, les datacenters de 500 kW (puissance informatique installée) ou plus doivent envoyer des données à la Commission sur leurs usages : eau, électricité, énergie renouvelable et réutilisation de la chaleur fatale. Cette dernière est dégagée par les serveurs et peut servir pour chauffer des logements ou des bâtiments, par exemple. Nous en avons déjà parlé, c’est une catastrophe niveau réutilisation pour le moment…

Ces quatre critères permettent, selon la Commission, d’évaluer « l’efficacité énergétique et la durabilité » des datacenters. Problème, sur 2 161 datacenters devant répondre à cette enquête, seuls 770 ont envoyé des données (soit 36 % seulement). Sur l’ensemble des données, seulement 70,1 % sont jugées comme « fiables ».

La Commission continue d’avancer et vient d’adopter son barème avec des notes de A à G sur l’efficacité des usages de l’eau et de l’électricité. Le Parlement et le Conseil ont deux mois pour s’y opposer s’ils le souhaitent, mais sans pouvoir le modifier.

Les informations sont publiées dans ce rapport de 22 pages (PDF), mais de manière agrégée : au niveau de l’Union européenne et par État. Rien sur les datacenters en eux-mêmes, permettant ainsi aux plus mauvais de se cacher dans la masse et de ne pas être pointés du doigt.

La Belgique explose les compteurs sur l’usage de l’eau… Merci Google ?

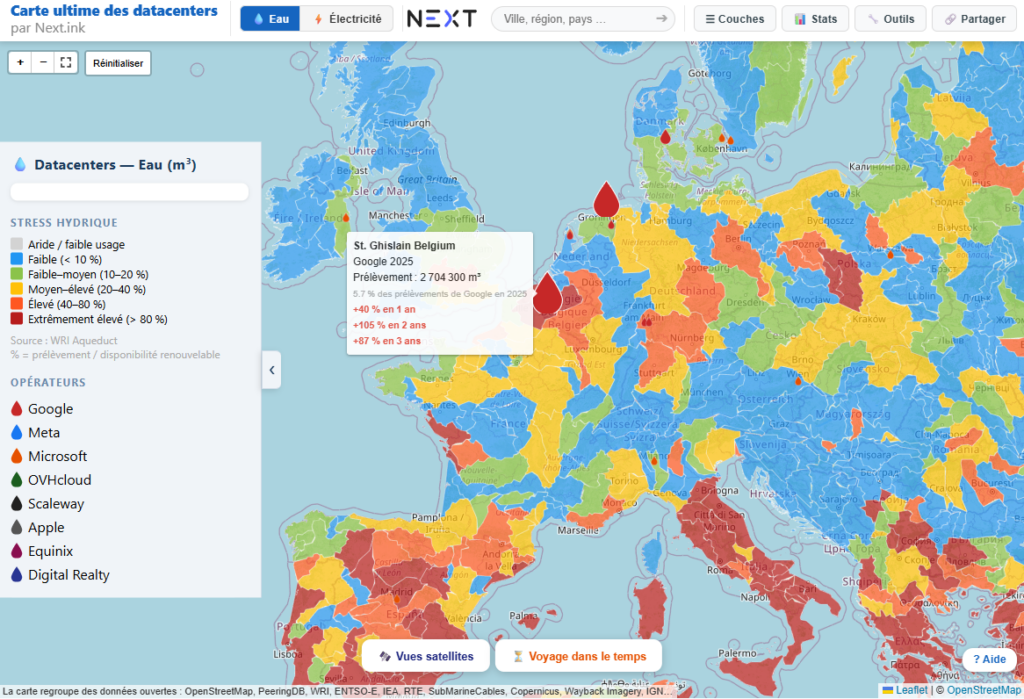
Un exemple ? La Belgique avec le WUE. Cet indicateur mesure « le rapport entre l’apport total d’eau et la consommation d’énergie des équipements informatiques ». Plus il est élevé, plus un datacenter consomme de l’eau par kWh d’électricité. La Belgique crève le plafond avec 1,28 m³ d’eau par MWh d’électricité, alors que la moyenne est à 0,58 m³/MWh.

Sans détails par datacenter, impossible de savoir qui est responsable de cette très mauvaise performance… Des indices tout de même : « dans certains États membres, les chiffres de la WUE sont dominés par ceux de quelques grands opérateurs disposant d’une seule installation, qui déclarent un apport d’eau plus élevé ». Pour la Belgique, l’éléphant dans la pièce pourrait bien être… Google. On vous explique, calculatrice à la main.


Il reste 76% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Datacenters : l’Europe agite son barème de A à G… sans avoir toutes les copies

À quand un écoscore sur la gestion des données personnelles ?
Datacenters : l’Europe agite son barème de A à G… sans avoir toutes les copies

Les datacenters en Europe vont avoir droit à deux notes, de A à G. Une pour l’électricité et le PUE, l’autre pour l’eau et le WUE. La Commission consulte aussi sur des critères minimums à respecter, avant de présenter une proposition en 2027. De leur côté, les datacenters (et/ou les États) rechignent à envoyer des données (fiables), alors qu’ils sont normalement obligés de le faire.

Après plusieurs mois de travaux, la Commission européenne propose officiellement « un système commun de notation des centres de données » sur leurs consommations de ressources. Le but de l’opération est de « garantir la transparence des informations sur l’utilisation effective des ressources (énergie, eau) ». Pour le moment, c’est loin d’être le cas, mais la Commission continue d’avancer.

Déclarations obligatoires… mais seulement 36 % répondent présents

Le système de notation concerne l’ensemble des datacenters « d’une capacité supérieure à 500 kW ». Ces datacenters doivent, en théorie, déjà communiquer des données sur leurs consommations à la Commission et/ou aux autorités nationales, comme le ministère de la Transition écologique en France. L’Arcep aussi récolte des données afin de nourrir son observatoire pour un numérique soutenable.

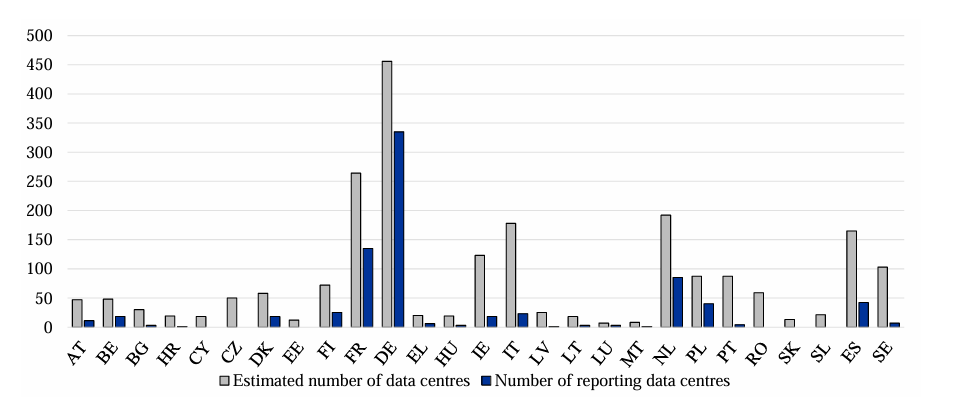
En théorie seulement, car en pratique les comptes ne sont pas bons : « Au total, 770 centres de données ont transmis leurs données au cours de la première période de déclaration [de mai à septembre 2024, ndlr], ce qui représente environ 36 % du total estimé des centres de données de l’UE soumis aux exigences en matière de communication d’informations ».

Six États membres n’ont déclaré aucun datacenter, cinq États n’en indiquent qu’un ou deux. L’Allemagne est largement en tête avec, en théorie, plus de 450 datacenters à déclarer, la France en seconde position avec plus de 250. Les Pays-Bas, l’Italie et l’Espagne sont entre 150 et 200. Dans les faits, un peu moins de 350 sont déclarés en Allemagne, moins de 150 en France, moins de 100 aux Pays-Bas, moins de 50 en Espagne, etc.

La Commission précise avoir reçu des « données préliminaires provenant d’au moins 30 % de centres de données supplémentaires ». Dans tous les cas, elle invite donc « les États membres à mettre en œuvre intégralement et rapidement l’article 12 de la DEE et veillera à ce que le nombre de centres de données déclarants augmente à l’avenir ».

Pire encore, « 70,1 % des données déclarées sont jugées fiables »

Mais ce n’est pas le seul problème. Sur les données récupérées, une « évaluation de la qualité […] a été
réalisée afin de vérifier la plausibilité, l’exactitude et la cohérence des indicateurs
 ». Comme nous l’avons remarqué avec l’étiquette énergie des smartphones et tablettes, c’est important tant il y a parfois du n’importe quoi remonté par les fabricants. 48 ans de mises à jour de sécurité ou 20 minutes maximum d’autonomie sont de parfaits exemples.

Là encore, les comptes ne sont pas bons : « Dans l’ensemble, 70,1 % des données déclarées sont jugées fiables, ce qui signifie que des chiffres cohérents ont été communiqués pour l’ensemble des indicateurs donnés ». Fiables, pas exactes car c’est encore un autre souci…


Il reste 74% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  
❌