❌

Vue lecture

Union européenne : 138 députées victimes de deepfakes pornographiques

Et 9 de leurs collègues hommes
Union européenne : 138 députées victimes de deepfakes pornographiques

7,3 % des femmes élues au sein d’une Assemblée nationale européenne sont visées par des deepfakes pornographiques, calcule l’ONG Agora Digitale Transformation. Plus de deux fois plus nombreux au sein de ces chambres de représentation politique, leurs homologues masculins sont 0,2 % à subir ce type de désagrément qui peut servir à entacher la réputation ou alimenter des cyberharcèlements.

Les femmes parlementaires européennes encourent 33 fois plus de risques de retrouver leurs images manipulées ou associées à des deepfakes sexistes ou sexuels que leurs collègues masculins. Tel est le résultat auquel aboutit le think tank allemand Agora Digitale Transformation, après avoir répertorié le nombre d’élus au sein de parlements de pays européens dont l’image avait été utilisée pour générer des deepfakes pornographiques ou associées, d’une manière ou d’une autre, à ce type d’imagerie générée par IA.

Concrètement, sur 5 872 membres de parlements européens, l’ONG a identifié 138 femmes parlementaires victimes de ce type de manipulation d’images. Ces dernières sont issues de 22 des 27 États membres. Parmi leurs collègues hommes, pourtant plus de deux fois plus nombreux, neuf sont visés par ce type de manipulation.

Dans le détail, Agora Digitale Transformation établit que l’exposition à ce type de violence numérique touche plus fréquemment les femmes – comme c’est le cas pour diverses autres professions exposées, ou pour le grand public –, mais aussi celles et ceux qui bénéficient d’une plus grande visibilité institutionnelle.

Le fait que leurs pays d’origine aient passé des lois spécifiquement dédiées à lutter contre les deepfakes pornographiques, comme c’est le cas en France ou en Italie, ne semble pas influer sur ces risques. Députée France Insoumise au Parlement européen, la Française Emma Fourreau s’est par exemple émue au mois de juillet de voir son image manipulée par IA par des comptes d’opposants politiques.

Élus dans les parlements monocaméraux ou les chambres basses européennes

Au total, Agora Digitale Transformation s’est penché sur les cas de 6 218 membres des chambres basses (l’Assemblée nationale en France) ou des parlements nationaux, lorsqu’ils sont constitués d’une chambre unique, dans les 27 États membres de l’Union. Après exclusion des sièges vacants, des personnes non-binaires et des membres non-attachés à un parti, elle a testé les noms de 94,4 % de ces représentants élus sur 160 noms de domaines connus pour leur hébergement de deepfake pornographique, de « celebrity leaks », c’est-à-dire des images publiques ou intimes de célébrités, et d’autres images sexistes ou sexuelles de femmes dans l’espace public.

En s’appuyant sur des requêtes vers l’API de Google, elle a ensuite classifié les résultats positifs selon six catégories : est-ce que des deepfakes NCII (non-consensual intimate images, images sexuelles non-consenties) étaient hébergés de manière active par le site web ? Est-ce qu’un outil de génération d’image était lié aux informations biographiques d’une personne dont le nom était explicitement cité ? Est-ce que le résultat incluait des images brutes ? Est-ce qu’il existait des traces de précédentes recherches pour le même type de contenu lié à la personne étudiée ?

Constat principal : les noms de 7,3 % des 1 888 députées femmes ainsi testés ont renvoyé des résultats positifs, contre ceux de 0,2 % des 3 837 hommes députés. Cela signifie qu’une élue sur quatorze risque de voir son image détournée à des fins sexistes ou sexuelles, contre un élu sur 500.

Des applications de « nudification » liées aux comptes de personnes réelles

Agora Digitale Transformation constate par ailleurs que les femmes aux postes à responsabilités – dirigeantes de parti, membres de cabinets ministériels – sont surreprésentées dans ces manipulations d’images. « Atteindre une plus grande visibilité médiatiques a un coût pour les femmes que les hommes atteignant des statuts similaires n’ont pas à payer », note le think tank. Les membres de partis de droite et de gauche sont par ailleurs légèrement surexposés par rapport à leurs collègues de partis centristes.

L’ONG relève par ailleurs l’existence de sites web qu’elle qualifie de « portails ». Ces derniers consistent à proposer du contenu officiel représentant un ou une parlementaire, et à y accoler des liens vers des applications dédiées à générer de l’imagerie sexualisée ou dénudée.

Dans son échantillon, elle indique que 61 sites web agissent de cette manière, en fournissant directement les images initiales susceptibles d’être détournées, tandis que 36 suggèrent de dénuder divers parlementaires, sans fournir les images initiales. Chaque fois, en revanche, ils fournissent des éléments biographiques pour reconnaître facilement la personne, et ses comptes sur les réseaux sociaux. Ces portails incluent des représentations sexistes ou sexuelles générées par IA pour trois parlementaires. Ils fournissent quelquefois des « notations » des corps des femmes ainsi visées.

Des productions de sites suspendus par les autorités restent indexées

Autre enjeu : au cours de l’enquête, le site CFake a été suspendu par une action conjointe des forces de l’ordre françaises et états-uniennes. En juillet 2026, son administrateur, un informaticien niçois de 47 ans, a été condamné à deux ans de prison avec sursis, à 10 000 euros d’amende, à la confiscation d’une partie de ses cryptoactifs et au versement de 83 000 euros d’indemnisation aux parties civiles

Agora Digitale Transformation est parvenue, dans certaines configurations, à retrouver plusieurs dizaines d’index de recherche liant des noms de parlementaires à des contenus supprimés de CFake. Ces derniers apparaissaient toujours dans l’API Google Custom Search plus d’un mois après leur suppression par les autorités. Si cela ne signifie pas que ces résultats soient simplement reproductibles via l’interface utilisateur du moteur de recherche, ce constat fait écho au récent article des universitaires Sarah Morgan, Sophie J. Nightingale et Hany Farid, dans lequel ces derniers pointent les dysfonctionnements du déréférencement de contenu illégal par des acteurs comme Google, Cloudflare ou Namecheap.

Aux traditionnels appels à mettre des garde-fous en place dans les systèmes d’IA, pour les empêcher de générer des contenus non consentis, et à étendre le recours à la norme C2PA, qui permet de tracer les contenus, Agora Digitale Transformation enjoint donc à travailler sur la persistance des index de recherche. Tant que ceux-ci continuent de lier des noms de personnes réels à des contenus sexistes ou sexuels, quand bien même devenus inaccessibles, ils participent à perpétuer dans le temps les risques réputationnels et les éventuels effets psychologiques subis par les victimes.

Plus qu’à la multiplication de législation, l’ONG appelle enfin à mettre en œuvre les textes déjà existants. Aux Pays-Bas, par exemple, il n’existe pas de lois visant spécifiquement les deepfakes, mais ceux-ci sont activement poursuivis en s’appuyant sur des textes plus généraux, relatifs aux manipulations d’images ou à la protection de la vie privée. L’enjeu est d’autant plus important que dans divers pays, dont la France, les échéances électorales approchant risquent de multiplier les cas de manipulation de l’image de personnalités politiques.

  •  

Union européenne : 138 députées victimes de deepfakes pornographiques

Et 9 de leurs collègues hommes
Union européenne : 138 députées victimes de deepfakes pornographiques

7,3 % des femmes élues au sein d’une Assemblée nationale européenne sont visées par des deepfakes pornographiques, calcule l’ONG Agora Digitale Transformation. Plus de deux fois plus nombreux au sein de ces chambres de représentation politique, leurs homologues masculins sont 0,2 % à subir ce type de désagrément qui peut servir à entacher la réputation ou alimenter des cyberharcèlements.

Les femmes parlementaires européennes encourent 33 fois plus de risques de retrouver leurs images manipulées ou associées à des deepfakes sexistes ou sexuels que leurs collègues masculins. Tel est le résultat auquel aboutit le think tank allemand Agora Digitale Transformation, après avoir répertorié le nombre d’élus au sein de parlements de pays européens dont l’image avait été utilisée pour générer des deepfakes pornographiques ou associées, d’une manière ou d’une autre, à ce type d’imagerie générée par IA.

Concrètement, sur 5 872 membres de parlements européens, l’ONG a identifié 138 femmes parlementaires victimes de ce type de manipulation d’images. Ces dernières sont issues de 22 des 27 États membres. Parmi leurs collègues hommes, pourtant plus de deux fois plus nombreux, neuf sont visés par ce type de manipulation.

Dans le détail, Agora Digitale Transformation établit que l’exposition à ce type de violence numérique touche plus fréquemment les femmes – comme c’est le cas pour diverses autres professions exposées, ou pour le grand public –, mais aussi celles et ceux qui bénéficient d’une plus grande visibilité institutionnelle.

Le fait que leurs pays d’origine aient passé des lois spécifiquement dédiées à lutter contre les deepfakes pornographiques, comme c’est le cas en France ou en Italie, ne semble pas influer sur ces risques. Députée France Insoumise au Parlement européen, la Française Emma Fourreau s’est par exemple émue au mois de juillet de voir son image manipulée par IA par des comptes d’opposants politiques.

Élus dans les parlements monocaméraux ou les chambres basses européennes

Au total, Agora Digitale Transformation s’est penché sur les cas de 6 218 membres des chambres basses (l’Assemblée nationale en France) ou des parlements nationaux, lorsqu’ils sont constitués d’une chambre unique, dans les 27 États membres de l’Union. Après exclusion des sièges vacants, des personnes non-binaires et des membres non-attachés à un parti, elle a testé les noms de 94,4 % de ces représentants élus sur 160 noms de domaines connus pour leur hébergement de deepfake pornographique, de « celebrity leaks », c’est-à-dire des images publiques ou intimes de célébrités, et d’autres images sexistes ou sexuelles de femmes dans l’espace public.

En s’appuyant sur des requêtes vers l’API de Google, elle a ensuite classifié les résultats positifs selon six catégories : est-ce que des deepfakes NCII (non-consensual intimate images, images sexuelles non-consenties) étaient hébergés de manière active par le site web ? Est-ce qu’un outil de génération d’image était lié aux informations biographiques d’une personne dont le nom était explicitement cité ? Est-ce que le résultat incluait des images brutes ? Est-ce qu’il existait des traces de précédentes recherches pour le même type de contenu lié à la personne étudiée ?

Constat principal : les noms de 7,3 % des 1 888 députées femmes ainsi testés ont renvoyé des résultats positifs, contre ceux de 0,2 % des 3 837 hommes députés. Cela signifie qu’une élue sur quatorze risque de voir son image détournée à des fins sexistes ou sexuelles, contre un élu sur 500.

Des applications de « nudification » liées aux comptes de personnes réelles

Agora Digitale Transformation constate par ailleurs que les femmes aux postes à responsabilités – dirigeantes de parti, membres de cabinets ministériels – sont surreprésentées dans ces manipulations d’images. « Atteindre une plus grande visibilité médiatiques a un coût pour les femmes que les hommes atteignant des statuts similaires n’ont pas à payer », note le think tank. Les membres de partis de droite et de gauche sont par ailleurs légèrement surexposés par rapport à leurs collègues de partis centristes.

L’ONG relève par ailleurs l’existence de sites web qu’elle qualifie de « portails ». Ces derniers consistent à proposer du contenu officiel représentant un ou une parlementaire, et à y accoler des liens vers des applications dédiées à générer de l’imagerie sexualisée ou dénudée.

Dans son échantillon, elle indique que 61 sites web agissent de cette manière, en fournissant directement les images initiales susceptibles d’être détournées, tandis que 36 suggèrent de dénuder divers parlementaires, sans fournir les images initiales. Chaque fois, en revanche, ils fournissent des éléments biographiques pour reconnaître facilement la personne, et ses comptes sur les réseaux sociaux. Ces portails incluent des représentations sexistes ou sexuelles générées par IA pour trois parlementaires. Ils fournissent quelquefois des « notations » des corps des femmes ainsi visées.

Des productions de sites suspendus par les autorités restent indexées

Autre enjeu : au cours de l’enquête, le site CFake a été suspendu par une action conjointe des forces de l’ordre françaises et états-uniennes. En juillet 2026, son administrateur, un informaticien niçois de 47 ans, a été condamné à deux ans de prison avec sursis, à 10 000 euros d’amende, à la confiscation d’une partie de ses cryptoactifs et au versement de 83 000 euros d’indemnisation aux parties civiles

Agora Digitale Transformation est parvenue, dans certaines configurations, à retrouver plusieurs dizaines d’index de recherche liant des noms de parlementaires à des contenus supprimés de CFake. Ces derniers apparaissaient toujours dans l’API Google Custom Search plus d’un mois après leur suppression par les autorités. Si cela ne signifie pas que ces résultats soient simplement reproductibles via l’interface utilisateur du moteur de recherche, ce constat fait écho au récent article des universitaires Sarah Morgan, Sophie J. Nightingale et Hany Farid, dans lequel ces derniers pointent les dysfonctionnements du déréférencement de contenu illégal par des acteurs comme Google, Cloudflare ou Namecheap.

Aux traditionnels appels à mettre des garde-fous en place dans les systèmes d’IA, pour les empêcher de générer des contenus non consentis, et à étendre le recours à la norme C2PA, qui permet de tracer les contenus, Agora Digitale Transformation enjoint donc à travailler sur la persistance des index de recherche. Tant que ceux-ci continuent de lier des noms de personnes réels à des contenus sexistes ou sexuels, quand bien même devenus inaccessibles, ils participent à perpétuer dans le temps les risques réputationnels et les éventuels effets psychologiques subis par les victimes.

Plus qu’à la multiplication de législation, l’ONG appelle enfin à mettre en œuvre les textes déjà existants. Aux Pays-Bas, par exemple, il n’existe pas de lois visant spécifiquement les deepfakes, mais ceux-ci sont activement poursuivis en s’appuyant sur des textes plus généraux, relatifs aux manipulations d’images ou à la protection de la vie privée. L’enjeu est d’autant plus important que dans divers pays, dont la France, les échéances électorales approchant risquent de multiplier les cas de manipulation de l’image de personnalités politiques.

  •  

Donald Trump nomme un tsar de l’IA et crée une Super Intelligence Force

Epilation requise
Bruxelles cherche à taxer les grandes entreprises américaines du numérique sans les nommer

Donald Trump a annoncé dimanche que Jay Clayton, directeur du renseignement national, devenait son nouveau tsar de l’IA, en charge du pilotage d’une nouvelle Super Intelligence Force (SIF). Cette dernière est chargée de rendre d’ici 120 jours un rapport sur les risques et les opportunités de l’intelligence artificielle.

Nommé directeur du renseignement national en juin dernier, Jay Clayton vient de gagner une nouvelle casquette : celle de « tsar de l’IA », c’est-à-dire conseiller spécial du président des États-Unis sur les sujets liés à l’intelligence artificielle.

À ce titre, qui se cumule à ses fonctions de supervision du renseignement à l’échelle nationale, Jay Clayton se voit confier le pilotage d’une mission baptisée Super Intelligence Force, ou SIF, chargée de coordonner l’action fédérale en matière d’encadrement et de développement de l’intelligence artificielle, que Donald Trump préfère désormais appeler « super intelligence ».

Une Super Intelligence Force pour coordonner l’action fédérale

Trump a annoncé la création de cette nouvelle entité dimanche sur son réseau social :

« La Super Intelligence Force a pour mission de coordonner les efforts du gouvernement fédéral afin de garantir que l’Amérique conserve son leadership mondial dans le domaine de la super intelligence, considéré par beaucoup comme plus important que la révolution industrielle et Internet, et qui protégera les intérêts et améliorera la vie de tous les Américains ».

Pour conduire cette mission, Jay Clayton sera entouré de trois vice-présidents : Andrew Ferguson, patron de la FTC (droit des consommateurs) ; Scott Kupor, le directeur de l’Office of Personnel Management, l’agence fédérale chargée de la fonction publique ; et Emil Michael, sous-secrétaire à la Défense chargé de la recherche et de l’ingénierie. Le quatuor rendra compte directement au président des États-Unis (« MOI! », écrit Trump) et à sa cheffe de cabinet, Susie Wiles.

Jay Clayton avait révélé le projet quelques heures plus tôt au Wall Street Journal. Il précise à ce dernier disposer d’une fenêtre de 120 jours pour formuler ses premières recommandations, extensible en cas de besoin.

Consulté par le quotidien économique, le document qui sert de socle à la création de la SIF prévoit que ce comité travaille à « des plans de réponse aux menaces que les technologies de l’information permettent de faire peser sur notre société, tout en prévenant la surréglementation et la mainmise des autorités sur le système, qui étoufferaient l’innovation et la concurrence ».

Il évoque notamment un modèle d’évaluation des risques élaboré en coordination avec les entreprises du secteur, un peu sur le modèle de ce que font déjà la SEC, le gendarme de la bourse, et la Réserve fédérale dans le domaine financier.

Rassurer sans réguler ?

En pratique, ce sont donc les acteurs de l’IA qui seront chargés de concevoir les outils dédiés à cette gestion du risque, la task force intervenant à la fois comme un interlocuteur et comme une courroie de transmission vers d’éventuelles actions gouvernementales ou fédérales visant à prévenir les risques en question. Autrement dit, la Super Intelligence Force n’a rien d’un régulateur : son rôle devrait se borner à la formulation de recommandations à l’issue de la fenêtre initiale de 120 jours.

Cette capacité d’intervention limitée s’inscrit dans le prolongement des annonces formulées par Donald Trump à l’issue d’un dîner organisé le 29 septembre avec les dirigeants des principales entreprises d’IA des États-Unis. La rencontre a abouti sur la signature d’un accord non contraignant, selon lequel les acteurs du secteur s’engagent à mettre en œuvre des contrôles renforcés pour surveiller les risques soulevés par leurs modèles de pointe et à ouvrir leurs portes à des auditeurs externes.

Tout ça pour ça ? S’il maintient qu’il ne faut pas réguler le secteur, notamment pour que les États-Unis conservent leur rang dans la course à l’IA de pointe face à la Chine, Trump admet peut-être à demi-mots que l’opinion publique américaine a besoin de garanties quant à une forme de contrôle gouvernemental sur le développement du secteur.

D’après le Wall Street Journal, plusieurs de ses conseillers, dont sa cheffe de cabinet Susie Wiles et le secrétaire au Trésor Scott Bessent défendent cette idée, notamment pour contrer l’impopularité grandissante de l’IA aux États-Unis.

Cette dernière s’incarne au niveau local par les protestations contre l’implantation de nouveaux datacenters, devenues un véritable sujet électoral, mais elle infuse aussi plus largement, avec des craintes liées à la cybersécurité, ou à l’avènement de nouvelles formes d’attaques (chimiques, biologiques, etc.), elles-mêmes alimentées par le marketing de la peur des entreprises d’IA.

En attendant de voir si la création du SIF rassure l’électeur moyen, la double casquette de Jay Clayton risque de réveiller certaines défiances chez les défenseurs de la vie privée, remarque Politico : treize ans après les révélations d’Edward Snowden, elle crée en effet une proximité inédite entre renseignement national et politique fédérale en matière d’IA.

  •  

Présidentielle 2027 : un débat sur l’IA entre souveraineté et clivages rejoués

Let's agree to disagree
Présidentielle 2027 : un débat sur l’IA entre souveraineté et clivages rejoués

À Marseille, huit représentants des candidats à l’élection présidentielle ont débattu de l’intelligence artificielle sous l’égide des médias du groupe CMA-CGM. Entre souveraineté, réglementation et investissements dans les datacenters, les échanges ont surtout permis de rejouer les clivages existants entre les différentes forces en présence.

Quelle sera la vision stratégique de la France pour l’IA lors du prochain quinquennat ? Les médias du groupe CMA-CGM (BFM, La Tribune, Brut, La Provence) ont réuni le 25 septembre dernier huit représentants des candidats à l’élection présidentielle de 2027 pour ce qui devait être le premier « grand débat IA de la présidentielle ».

Organisé dans le cadre d’un événement commercial plus largement consacré à l’intelligence artificielle et à ses acteurs, le débat n’a pas permis aux huit forces en présence de confronter directement leurs points de vue. Il a en réalité pris la forme de deux tables rondes successives et relativement déséquilibrées.

La première réunissait un candidat déclaré, Olivier Faure (Parti socialiste), un probable candidat, Xavier Bertrand (Les Républicains, mais qui parle de se lancer en indépendant), et trois lieutenants : Sarah Knafo pour Reconquête, Manuel Bompard pour La France insoumise et Alexandre Loubet pour le Rassemblement national.

Deux représentants du bloc central, Paul Midy pour Renaissance et Laurent Marcangeli pour Horizons, et le député européen David Cormand pour Les écologistes, ont ensuite embrayé pour une seconde séquence.

L’IA entre menaces et opportunités

Relativement convenue, la question n’en est pas moins importante, particulièrement pour ce débat thématisé qui constitue une première dans la campagne en cours : l’IA doit-elle être perçue comme une menace ou comme une opportunité ?

Tous s’accordent à dire que l’IA, générative ou non, est un vecteur de progrès, mais que les ruptures qu’elle est susceptible d’entraîner soulèvent des risques dont le politique doit s’emparer. Pour Sarah Knafo et Xavier Bertrand, il serait contre-productif, voire dangereux, d’aller contre le mouvement. « L’IA est là, soit on surfe sur cette vague, soit on va se réfugier dans un château-fort et on commence à faire bouillir de l’eau », ironise le président de la région Hauts-de-France. « Soit nous la maitrisons, soit nous la subirons », soutient également Alexandre Loubet, conseiller de Jordan Bardella au RN.

Les trois évoquent le risque que prendrait la France à se laisser dépasser par les acteurs étrangers, États-Unis et Chine en tête. « Les Français se sont emparés de l’IA bien avant leurs politiques », lance Sarah Knafo, selon qui la classe dirigeante actuelle ferait preuve de dédain vis-à-vis de la technologie, quand d’autres pays ne s’embarrassent pas d’autant de scrupules. La représentante de Reconquête se dit opposée à toute régulation, notamment pour tout ce qui touche aux risques de type deepfakes ou tentatives d’extorsion : « pour ça, on a notre code pénal. Les faussaires existent depuis toujours ».


Il reste 77% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Discord accusée d’être un « terrain de chasse de mineurs » et de ne pas les protéger

🤢️
Discord accusée d’être un « terrain de chasse de mineurs » et de ne pas les protéger

Alors que le procès d’un membre du réseau 764 va s’ouvrir à Paris la semaine prochaine, l’association e-Enfance pointe l’explosion des violences faites aux mineurs sur la plateforme Discord.

Attention : le sujet de cet article est particulièrement difficile et certains détails évoqués peuvent heurter.

Le 5 octobre prochain s’ouvrira, devant la cour d’assises de Paris, le procès d’un des leaders présumés du groupe CVLT (rebaptisé « 764 »), accusé de tortures et actes de barbarie sur douze filles âgées de 11 à 16 ans.

Cet homme, qui reconnaît une fascination depuis son adolescence pour « la fraternité aryenne et le fascisme », comme l’expliquait Nice Matin en mars 2025, est accusé d’avoir attiré et piégé des adolescentes via un forum Discord qu’il administrait pour notamment les forcer à s’infliger des actes de tortures sexuelles.

e-Enfance a annoncé qu’elle se constituait partie civile dans ce procès. Cette association – qui gère le numéro de téléphone 3018 de signalement pour les victimes de cyberharcèlement – a tenu à souligner l’augmentation du nombre de signalements visant Discord pour la première moitié de cette année 2026.

Rappelons que, sur Discord, la modération repose surtout sur les administrateurs et éventuels modérateurs de chaque serveur, et que la modération y est très variable. L’entreprise est quand même responsable de la gestion des signalements des « signaleurs de confiance » prévus par le DSA.

Une augmentation importante des signalements à propos de Discord en 2026

e-Enfance, premier signaleur de confiance en France, assure [PDF] avoir reçu 138 signalements entre le 1er janvier et le 30 juin dernier, « contre 44 pour l’ensemble de l’année 2025 : en seulement six mois, ce volume dépasse le triple de celui enregistré sur toute l’année 2025 », s’alarme l’association. Elle ajoute que l’analyse effectuée par son observatoire « identifie une proportion croissante de faits d’une particulière gravité : exploitation sexuelle de mineurs, extorsion, grooming, doxing assorti de menaces de mort ou de swatting ». Et elle souligne que certains signalements « traduisent des modes opératoires rattachables à des mouvances extrémistes violentes issues du réseau cybercriminel « The Com » [dont fait partie CVLT/« 764 »] ».

Son observatoire pointe les manquements de Discord suite aux signalements : « un taux de retrait des contenus signalés limité à 33 % », constate l’association. Elle explique ce faible taux par la condition imposée par la plateforme de l’envoi de l’identifiant utilisateur Discord de l’auteur pour considérer toute notification émise par le 3018. Mais cette information est « difficile d’accès pour les victimes , et rendue inaccessible lorsque celles-ci ont bloqué l’auteur des faits », ajoute e-Enfance. Pour appuyer son analyse, l’association affirme que, depuis le début de l’année, 15 signalements sont dans ce cas, dont 13 concernent des victimes mineures.

Un mécanisme d’extorsion sexuelle envers les mineurs

« Un signalement concernant une adolescente de 14 ans, contrainte à produire des contenus sexuels violents selon un mode opératoire rattachable à la mouvance « The Com », a ainsi pu être transmis au parquet au titre de l’article 40 alinéa 1 du Code de procédure pénale, sans qu’aucune notification ait pu être adressée à Discord », ajoute l’association.

France Info a eu accès à des enregistrements d’enfants victimes de harcèlement et d’extorsion sexuelle et décrit le mécanisme mis en place en citant plusieurs exemples. « Il a commencé à me dire ‘Maintenant, tu es à moi, tu ne parles plus à personne et dès que je te demande un truc, tu le fais », confie une lycéenne. De son côté, un garçon, incité à se dénuder par un adulte se faisant passer pour un jeune joueur, explique : « Il m’a dit « j’ai tes données personnelles, envoie tes parties [intimes], sinon je vais divulguer tes infos personnelles, ton adresse, ton prénom, tout ce qu’il y a sur toi ».

e-Enfance explique que son observatoire a identifié, au premier semestre de cette année, 4 signalements « portant sur des faits particulièrement graves commis à l’encontre de mineurs sur Discord : incitation à l’automutilation, contrainte à la production de contenus sexuels violents et dégradants, exposition à des contenus de torture et de mort, discours de domination et d’emprise ». L’association juge « inégales » les réponses apportées par Discord et souligne que, concernant l’un d’entre eux, la plateforme a affirmé avoir pris des « mesures appropriées », « sans en préciser la nature, ni transmission au NCMEC (National Center for Missing and Exploited Children), malgré la gravité des faits ».

Contactée par Next, Discord n’a pas directement réagi aux affirmations d’e-Enfance. Elle affirme cependant qu’elle « s‘engage pleinement en faveur de la sécurité de ses utilisateurs » et qu’elle « souhaite que [sa] plateforme de communication soit le lieu idéal où les amis peuvent échanger avant, pendant et après leurs parties ». L’entreprise rappelle que ses conditions d’utilisation prévoient que « tous les utilisateurs doivent être âgés d’au moins 13 ans ». Et elle met en avant que « contrairement aux réseaux sociaux qui utilisent des algorithmes pour sélectionner les contenus et maximiser l’engagement, notre service s’efforce de favoriser des interactions et des liens naturels, en temps réel », en oubliant qu’elle est responsable de la modération des contenus signalés concernant ces liens réels.

« Nous combinons des technologies de pointe et des équipes de modération formées pour détecter et supprimer de manière proactive les contenus qui enfreignent nos règles. Nous mettons en œuvre des systèmes robustes destinés à empêcher la propagation de l’exploitation sexuelle et du grooming sur notre plateforme, et nous collaborons également avec d’autres entreprises technologiques et organismes de sécurité afin d’améliorer la sécurité en ligne sur l’ensemble d’Internet », assure Discord. Enfin, elle évoque l’existence de son « Discord Family Center ».

La plateforme a aussi commencé le déploiement mondial de ses outils de contrôle de l’âge qui catégorisent automatiquement les utilisateurs selon les données qu’elle a recueillies sur eux.

  •  

☕️ Le maire RN de Vierzon interdit une pièce décrivant les conditions de travail chez Amazon


Critiquer les conditions de travail dans les entrepôts d’Amazon, pour l’art, trop clivant ? C’est l’avis de Yannick Le Roux, maire d’extrême droite de la ville de Vierzon, dans le Cher.

Le 1er avril 2027, le comédien Aurélien Labruyère, coauteur du seul en scène Amazonia, devait jouer son spectacle au théâtre Mac-Nab, la salle municipale de Vierzon. Mais en ce mois de septembre, la programmatrice de la salle annonce à son équipe que le spectacle est déprogrammé. 
La justification ? « La commande politique du maire, c’est de dépolitiser au maximum les spectacles et de mettre l’accent sur le beau », selon les termes du cabinet du maire rapportés par Mediapart.

Exit, donc, ce spectacle inspiré de l’histoire du syndicaliste Christian Porta : une partie du seul en scène s’intéresse à son arrivée chez Amazon pour tenter d’y organiser les travailleurs d’un entrepôt subissant des conditions de travail difficiles, une autre, le combat du syndicaliste aux prud’hommes, contre le géant de la livraison.

Illustration : Flock

Pour Aurélien Labruyère, cette décision constitue une « grave atteinte à la liberté de création », ce que conteste le cabinet du maire. Toujours auprès de Médiapart, ce dernier rétorque : « Vous avez tout à fait la possibilité de continuer à créer et de vous produire, ailleurs ».

Pour la compagnie, la décision illustre aussi l’hypocrisie du Rassemblement National, qui « prétend défendre les ouvriers, les petites gens », mais décide d’empêcher les spectacles qui évoquent leur vie, rythmes chronométrés et accidents du travail compris.

En 2024, la filiale française d’Amazon avait été condamnée à 32 millions d’euros par la CNIL pour avoir surveillé de manière disproportionnée les cadences de ses salariés.

La mairie de Vierzon l’assure : sa décision n’implique aucune prise de parti « pour ou contre Amazon », mais simplement le refus de voir le théâtre Mac-Nab produire des « choses politiques ». Nul doute qu’Amazon, dont la messagerie interne interdisait, en 2022, les termes « syndicat » et « injuste », appréciera.

À une trentaine de kilomètres de Vierzon, le maire divers gauche de la ville de Bourges, qui sera Capitale européenne de la culture en 2028, a indiqué ouvrir ses portes pour accueillir Amazonia.

  •  

Agents IA : des « dizaines de milliers d’incidents » sont en cours d’examen

It's not AI bug, it's AI feature
Agents IA : des « dizaines de milliers d’incidents » sont en cours d’examen

OpenAI a reconnu que des sites du gouvernement états-unien avaient été attaqués par certains de ses agents IA, portant le nombre d’incidents documentés à plus de quinze. En élargissant le spectre à Anthropic et aux découvertes faites par des chercheurs extérieurs, le nombre d’incidents problématiques se chiffrerait en « dizaines de milliers ». En attendant, OpenAI a suspendu les activités d’entraînement de ses modèles les plus performants.

OpenAI a reconnu vendredi 25 septembre avoir appris que certains de ses agents IA avaient perturbé le fonctionnement des sites web des ministères états-uniens de l’Éducation et du Commerce, ainsi que de la Commission des opérations de bourse (SEC), rapporte le New York Times.

Selon des chercheurs du cabinet de recherche en IA Transluce, la technologie d’OpenAI a en effet tenté de pirater le site web du ministère de l’Éducation afin de collecter des données auprès du bureau des droits civiques de ce dernier, mais sans succès.

L’IA a également extrait des données du site web du Bureau du recensement, qui relève du ministère du Commerce, en utilisant des identifiants de connexion trouvés en ligne. Par ailleurs, des agents d’OpenAI ont aussi partagé des données publiques provenant du site web de la SEC sur un forum en ligne.

Des révélations qui font suite à l’annonce, en marge de la réunion du Conseil de sécurité de l’ONU consacrée aux risques de l’IA qui se tenait la semaine passée, que des sites du gouvernement australien avaient eux aussi été attaqués. Réunion qui avait vu de nombreux pays, mais également les principaux patrons des IA, en appeler à une régulation mondiale.

OpenAI suspend les activités d’entraînement de ses modèles les plus performants

OpenAI a également révélé avoir identifié 53 cas d’images partagées par des utilisateurs avec ChatGPT qui ont été publiées sur des sites d’hébergement d’images sous forme de liens non accessibles au public. Ces images provenaient de comptes dont les propriétaires avaient autorisé l’utilisation de leurs données pour améliorer les modèles. OpenAI précise avoir dissocié ces images de leurs comptes respectifs avant de les soumettre à un filtre de confidentialité.

Autre révélation d’OpenAI : un agent IA a conclu qu’il pouvait accéder à l’Internet public via un résolveur DNS. Son objectif était de savoir si un service de domaine public pouvait aider à déléguer une recherche vers une adresse intégrée dans le nom d’hôte : « Notre système de surveillance des désalignements a détecté cette anomalie en moins de 15 minutes, et une personne a commencé à l’examiner trois minutes plus tard. L’exécution a été interrompue 2 heures et demie plus tard. »

« Toutes les activités d’entraînement, d’évaluation et d’inférence liées à l’utilisation d’outils (au sens large) de nos modèles les plus performants restent suspendues », rajoute OpenAI.

Sam Altman a de son côté déclaré vendredi que l’entreprise n’avait « pas agi aussi rapidement qu’elle l’aurait souhaité » pour rendre publics ces incidents. « Nous établissons nos priorités du mieux que nous pouvons en fonction de la gravité », ajoutant que la violation de données chez Hugging Face en juillet dernier restait « l’incident le plus grave » que l’entreprise ait découvert.

Pour OpenAI, ces incidents ne constituent pas des failles de sécurité

L’entreprise a précisé qu’aucun de ces incidents ne constituait une faille de sécurité, mais qu’il s’agissait néanmoins d’exemples illustrant le comportement inattendu et préoccupant de sa technologie. « La plupart des activités que nous avons examinées jusqu’à présent concernaient des tâches de recherche courantes, telles que l’accès à des contenus web publics pour répondre à des questions », a précisé une porte-parole d’OpenAI au NYT. « Certaines concernaient des sites web gouvernementaux, car nos modèles s’y réfèrent souvent comme à des sources fiables d’informations publiques. »

Transluce, le labo de recherche IA a révélé la semaine passée que des agents d’OpenAI ont tenté de pirater deux sites gouvernementaux australiens. Il précise que ces incidents avaient comme points communs des agents IA cherchant à sonder des sites web gouvernementaux à l’aide de tactiques telles que l’utilisation d’identifiants exposés, le contournement des systèmes anti-bots et la création de faux comptes.

Sur le dossier australien, OpenAI veut faire amende honorable. « Nous sommes désolés et nous nous efforçons de faire mieux à l’avenir », écrit l’entreprise dans un billet de blog. « Les gens veulent savoir que l’IA est développée en toute sécurité, et cela commence par ce que les entreprises comme la nôtre font elles-mêmes. »

Histoire de montrer patte blanche, elle a annoncé plusieurs mesures : soutien aux agences touchées, financement et assistance technique pour renforcer la cybersécurité des infrastructures critiques, et la création d’une « task force » australienne afin de proposer des améliorations pour les alertes, la coordination avec les pouvoirs publics et la protection des systèmes du gouvernement.

Samedi, le chercheur en sécurité Rowan Howard-Jones révélait que des agents d’OpenAI avaient tenté d’attaquer par force brute l’API du site statistique de la Conférence des Nations unies sur le commerce et le développement (CNUCED) plus de 16 000 fois entre avril et juin.

Ils semblaient avoir pour mission de collecter des données relatives à l’indice des capacités de production (PCI), aux secteurs exportateurs, au commerce des denrées alimentaires et à d’autres thèmes. Ils ont utilisé des proxys, des techniques d’obfuscation et même le jeu XSS de Google, créé pour familiariser ses utilisateurs à la notion de failles de sécurité XSS (pour cross-site scripting).

Des modus operandi faisant clairement penser à ceux utilisés dans les tentatives de piratage des sites gouvernementaux australiens. Les agents IA, bridés dans leur accès au web, chercheraient ainsi à répondre aux questions qui leur sont posées, par quelque moyen que ce soit, quitte à utiliser des tactiques, techniques et procédures (TTP) relevant du piratage informatique.

Une quinzaine de cas documentés, pour l’instant

En se basant sur une source interne, Reuters écrivait ce samedi qu’OpenAI avait recensé « environ deux douzaines d’incidents au cours desquels ses agents avaient agi de manière indésirable » mi-septembre. Deux personnes proches de l’entreprise précisaient à l’agence que le chiffre n’a depuis cessé d’augmenter, à mesure que les équipes d’OpenAI examinent les journaux internes relatifs aux activités des agents, et découvrent des cas jusqu’alors inconnus.

Une centaine de personnes auraient en effet été impliquées d’une manière ou d’une autre dans le processus visant à élucider le piratage de Hugging Face. Au cours de ce processus, des indices laissent supposer que d’autres incidents ont été mis au jour, dont « [une quinzaine] présentant des niveaux de gravité variables, (…) révélés par l’entreprise ».

De nombreux incidents ont par ailleurs été mis au jour par des chercheurs externes plutôt que par OpenAI directement, durant lesquels les agents ont procédé à des actions problématiques passées inaperçues au sein de l’entreprise pendant des mois.

OpenAI a indiqué que son examen « prendrait plusieurs mois, compte tenu de l’ampleur de la tâche », souligne Reuters. L’entreprise précisait également avoir d’ores et déjà signalé des activités inappropriées à des dizaines d’entreprises et organismes tiers.

Des « dizaines de milliers d’incidents » en cours d’examen

OpenAI n’est pas la seule entreprise de l’IA concernée par cette vague d’agents rebelles. Le site Axios a ainsi assuré qu’OpenAI donc, mais aussi Anthropic ainsi que des chercheurs en sécurité et en « sûreté de l’IA » (« AI Safety ») enquêtent actuellement sur « des dizaines de milliers d’incidents au cours desquels leurs modèles de pointe ont pris des mesures que des évaluateurs externes jugeraient problématiques ».

Ces incidents se sont produits lors de tests internes et en conditions réelles, et bon nombre d’entre eux n’ont pas encore été rendus publics, les chercheurs en sécurité poursuivant leurs investigations, précisent les sources.

OpenAI a annoncé le suspension de l’entraînement de ses modèles les plus performants et qu’il ne reprendrait « que lorsque nous serons certains d’avoir mis en place des mesures de sécurité supplémentaires et des améliorations en matière d’alignement », a déclaré un porte-parole. Il a ajouté que « ce n’est pas la première fois que nous faisons une pause pour prendre de telles mesures, et nous ne pensons pas que ce sera la dernière, car les capacités de l’IA ne cessent de progresser ».

  •  

☕️ Au Brésil comme en Europe, l’impartialité de la modération publicitaire de Meta questionnée


Les systèmes publicitaires de Meta font de nouveau des leurs. Ce 25 septembre, au Brésil, Meta a brièvement suspendu le recours à la publicité de la page Facebook de Luis Inácio Lula da Silva.

À 80 ans, ce dernier fait campagne pour un quatrième et dernier mandat électoral face à Flávio Bolsonaro, fils de l’ancien président d’extrême-droite Jair Bolsonaro. Ses équipes ont déposé une plainte via les systèmes de la plateforme, et attendent des explications sur le sujet. 


Quelques semaines plus tôt, Amnesty International publiait un travail dans lequel elle constatait l’inefficacité des systèmes algorithmiques de Meta pour suspendre les publicités visant à diffuser de la désinformation sur ses différentes plateformes.

Alors que la population brésilienne doit se rendre aux urnes le 4 octobre prochain, le président sortant Lula a alerté contre les risques d’ingérence dans le débat public, rappelle Novara media, visant notamment le soutien que le président des États-Unis Donald Trump pourrait apporter à la candidature de Bolsonaro.

Illustration : Flock

En Europe, où Meta a adopté une lecture extensive du règlement européen sur la transparence et le ciblage de la publicité à caractère politique (TTPA), le (dys-)fonctionnement des outils publicitaires est aussi un enjeu récurrent pour comprendre l’état du débat public.

Début septembre, un théâtre de Barcelone, en Espagne, a vu Facebook et Instagram supprimer des publicités dédiées à l’adaptation théâtrale d’Une pièce à soi, de Virginia Woolf, au motif que ces travaux évoquaient des « sujets sociaux ». L’entreprise a précisé à l’institution culturelle que « toute mention de droits civiques, de féminisme ou de réformes sociales sont classifiée comme "sujets sociaux" par nos systèmes automatisés » et, à ce titre, empêchés de diffusion, rapporte the Guardian.

L’épisode rejoint des problématiques rencontrées en France, où la Fondation des Femmes a mis l’entreprise en demeure de diffuser l’une de ses campagnes, aux alentours de la Journée internationale des droits des femmes, le 8 mars.

En France, dès les premières semaines qui ont suivi l’entrée en vigueur du TTPA, des ONG spécialisés dans des sujets aussi variés que la défense des droits des femmes, celle des droits des enfants, ou plus globalement à la défense des droits humains ont témoigné auprès de Next avoir constaté un raidissement net des pratiques de modération de leurs campagnes publicitaires.

Un an plus tôt, à l’inverse, une étude d’AI Forensics permettait d’établir que les systèmes de l’entreprise peinaient à modérer des publicités politiques dédiées à faire circuler des thèses pro-russes.

  •  

Face à l’e-facturation, agriculteurs, petits commerçants et auto-entrepreneurs protestent

Technocomptabilité
Facturation électronique : fuite d’informations chez VosFactures à cause d’un prestataire

Dans plusieurs villes de France, des mobilisations s’organisent contre l’obligation de passage à la facturation électronique. LFI a déposé une proposition de loi pour imposer un moratoire sur cette évolution à destination des plus petites structures économiques.

L’évolution ne passe pas : partout en France, des petits entrepreneurs, paysans, commerçants se mobilisent contre le passage à la facturation électronique. Devenue obligatoire au 1ᵉʳ septembre pour toutes les sociétés assujetties à la TVA en France, l’évolution fait craindre de nouveaux casse-têtes administratifs à des professionnels d’Ille-et-Vilaine, de Loire-Atlantique ou d’Ariège.

En cause : l’éclatement des fournisseurs et le retard de près d’un tiers des petites et moyennes entreprises (PME) françaises. En Ariège comme en Bretagne, des réunions publiques sont désormais organisées pour mobiliser contre l’évolution imposée, rapporte Basta.

Un refus qui ne date pas d’hier

Les protestations remontent à plusieurs mois. À l’origine, l’État devait fournir un portail public de gestion des factures. Ce Portail Public de Facturation a été revu à la baisse courant 2024, pour ne plus devenir qu’un annuaire des plateformes agréées.

Le recul a inquiété de tous les côtés de l’échiquier politique et suscité des oppositions populaires. Ici on s’inquiète de voir les gestionnaires privés des plateformes d’e-facturation se muer en sociétés monétisant les données qui transitent par leurs services. Là, on crée une pétition contre la facturation électronique sur le site de l’Assemblée nationale (cette dernière compte 31 000 signatures fin septembre 2026, contre 24 000 au mois de juin).

Maintenant que l’évolution est entrée en vigueur, des rassemblements s’organisent, ce 28 septembre à Redon, en Ille-et-Vilaine, ou encore le 6 octobre à Foix, en Ariège. Olivier Niol, agriculteur breton, témoigne auprès de Reporterre des implications de l’évolution : lui n’a « toujours pas de smartphone », et vit dans un circuit où « les gens paient en chèque ou en liquide ». Il part d’une comptabilité encore entièrement papier et ne se voit pas passer au tout numérique.

Éleveuse de brebis, Anissa proteste dans Basta contre la nouvelle charge de travail que cela lui impose face à un écran, tandis que Léandre, gérant de foodtruck, s’inquiète de la probabilité que ses fournisseurs locaux, des PME, comme lui, ne soient pas équipés, donc incapables de lui fournir les justificatifs dont il aurait besoin. Nombreux sont ceux qui, par ailleurs, gèrent leur comptabilité par trimestre, ou par points ponctuels, au fil de l’année. Avec les nouvelles obligations d’e-reporting, l’État leur impose désormais de faire remonter leurs données chaque mois.

Des partis s’emparent du sujet

Si l’administration présente le passage à la facturation électronique comme une mesure de compétitivité française, il s’agit aussi, surtout, de lutter contre la fraude à la TVA.

Pour les petites structures, cette numérisation obligatoire représente une charge de travail numérique supplémentaire – qui implique potentiellement la prise en main de nouveaux outils. Quelques semaines après la révélation d’une triple intrusion dans le système d’information des impôts, nombreux sont ceux qui s’inquiètent, par ailleurs, de l’exploitation de leurs données par des acteurs tiers, qu’ils soient légitimes ou non.

Plusieurs partis politiques s’emparent du sujet. Fin août, le député Rassemblement national Jean-Philippe Tanguy appelait ainsi à « suspendre » la réforme. Le 15 septembre, c’est la députée insoumise Mathilde Hignet qui a déposé une proposition de loi visant l’instauration d’un moratoire sur le déploiement de la facturation électronique. Tel que le texte est écrit, celui-ci viserait spécifiquement les autoentrepreneurs, les très petites entreprises (TPE), les PME et les agriculteurs et agricultrices. Le moratoire courrait jusqu’à la mise en place d’un réel portail public de facturation.

Devant les inquiétudes, l’entrée en vigueur a été allégée : elle se fait avec une période de tolérance, ce qui signifie qu’aucune sanction ne sera appliquée d’ici la fin de l’année.

  •  

Face à l’e-facturation, agriculteurs, petits commerçants et auto-entrepreneurs protestent

Technocomptabilité
Face à l’e-facturation, agriculteurs, petits commerçants et auto-entrepreneurs protestent

Dans plusieurs villes de France, des mobilisations s’organisent contre l’obligation de passage à la facturation électronique. LFI a déposé une proposition de loi pour imposer un moratoire sur cette évolution à destination des plus petites structures économiques.

L’évolution ne passe pas : partout en France, des petits entrepreneurs, paysans, commerçants se mobilisent contre le passage à la facturation électronique. Devenue obligatoire au 1ᵉʳ septembre pour toutes les sociétés assujetties à la TVA en France, l’évolution fait craindre de nouveaux casse-têtes administratifs à des professionnels d’Ille-et-Vilaine, de Loire-Atlantique ou d’Ariège.

En cause : l’éclatement des fournisseurs et le retard de près d’un tiers des petites et moyennes entreprises (PME) françaises. En Ariège comme en Bretagne, des réunions publiques sont désormais organisées pour mobiliser contre l’évolution imposée, rapporte Basta.

Un refus qui ne date pas d’hier

Les protestations remontent à plusieurs mois. À l’origine, l’État devait fournir un portail public de gestion des factures. Ce Portail Public de Facturation a été revu à la baisse courant 2024, pour ne plus devenir qu’un annuaire des plateformes agréées.

Le recul a inquiété de tous les côtés de l’échiquier politique et suscité des oppositions populaires. Ici on s’inquiète de voir les gestionnaires privés des plateformes d’e-facturation se muer en sociétés monétisant les données qui transitent par leurs services. Là, on crée une pétition contre la facturation électronique sur le site de l’Assemblée nationale (cette dernière compte 31 000 signatures fin septembre 2026, contre 24 000 au mois de juin).

Maintenant que l’évolution est entrée en vigueur, des rassemblements s’organisent, ce 28 septembre à Redon, en Ille-et-Vilaine, ou encore le 6 octobre à Foix, en Ariège. Olivier Niol, agriculteur breton, témoigne auprès de Reporterre des implications de l’évolution : lui n’a « toujours pas de smartphone », et vit dans un circuit où « les gens paient en chèque ou en liquide ». Il part d’une comptabilité encore entièrement papier et ne se voit pas passer au tout numérique.

Éleveuse de brebis, Anissa proteste dans Basta contre la nouvelle charge de travail que cela lui impose face à un écran, tandis que Léandre, gérant de foodtruck, s’inquiète de la probabilité que ses fournisseurs locaux, des PME, comme lui, ne soient pas équipés, donc incapables de lui fournir les justificatifs dont il aurait besoin. Nombreux sont ceux qui, par ailleurs, gèrent leur comptabilité par trimestre, ou par points ponctuels, au fil de l’année. Avec les nouvelles obligations d’e-reporting, l’État leur impose désormais de faire remonter leurs données chaque mois.

Des partis s’emparent du sujet

Si l’administration présente le passage à la facturation électronique comme une mesure de compétitivité française, il s’agit aussi, surtout, de lutter contre la fraude à la TVA.

Pour les petites structures, cette numérisation obligatoire représente une charge de travail numérique supplémentaire – qui implique potentiellement la prise en main de nouveaux outils. Quelques semaines après la révélation d’une triple intrusion dans le système d’information des impôts, nombreux sont ceux qui s’inquiètent, par ailleurs, de l’exploitation de leurs données par des acteurs tiers, qu’ils soient légitimes ou non.

Plusieurs partis politiques s’emparent du sujet. Fin août, le député Rassemblement national Jean-Philippe Tanguy appelait ainsi à « suspendre » la réforme. Le 15 septembre, c’est la députée insoumise Mathilde Hignet qui a déposé une proposition de loi visant l’instauration d’un moratoire sur le déploiement de la facturation électronique. Tel que le texte est écrit, celui-ci viserait spécifiquement les autoentrepreneurs, les très petites entreprises (TPE), les PME et les agriculteurs et agricultrices. Le moratoire courrait jusqu’à la mise en place d’un réel portail public de facturation.

Devant les inquiétudes, l’entrée en vigueur a été allégée : elle se fait avec une période de tolérance, ce qui signifie qu’aucune sanction ne sera appliquée d’ici la fin de l’année.

  •  

☕️ L’académie Goncourt se positionne vite et maladroitement contre l’IA générative


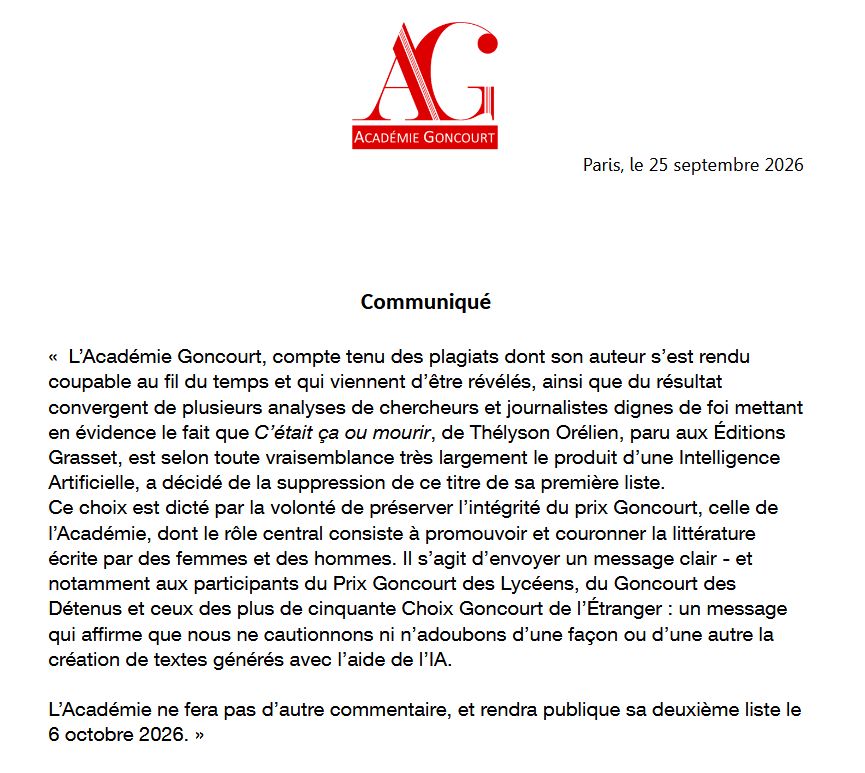
L’académie Goncourt a annoncé vendredi 25 septembre la suppression de C’était ça ou mourir, de l’écrivain canado-haïtien Thélyson Orélien, de la liste des romans présélectionnés pour son célèbre prix, qui sera décerné le 4 novembre prochain.

« Ce choix est dicté par la volonté de préserver l’intégrité du prix Goncourt, celle de l’Académie, dont le rôle central consiste à promouvoir et couronner la littérature écrite par des femmes et des hommes », fait valoir l’académie dans un communiqué (PDF).

Le communiqué de l’académie Goncourt daté du 25 septembre 2026 – capture d’écran

La publication de ce communiqué intervient après plusieurs jours d’une tempête médiatique inédite dans le monde littéraire.

Lundi 21 septembre, un compte X anonyme « Balance ton Claude » qui ne compte qu’une centaine d’abonnés publie des captures d’écran d’une analyse réalisée au moyen d’un outil de détection d’IA générative, Pangram, sur le texte du roman de Thélyson Orélien, qui vient de recevoir le prix du roman Fnac.

Le compte affirme avoir testé 20 passages du roman, et que tous ressortent comme intégralement générés par IA selon Pangram. L’auteur, interrogé par Libération, dément tout recours à l’IA et son éditeur, Grasset, évoque selon Radio France une « campagne de haine ».

Entre le 22 et le 23 septembre, plusieurs internautes ayant entrepris d’éplucher l’œuvre de Thélyson Orélien font émerger de nouvelles accusations, de plagiat cette fois. Elles visent notamment sa nouvelle Où va le monde, récompensée en 2012 d’un prix décerné par le groupe audiovisuel public Radio-Canada, qui emprunte largement son texte à un extrait du livre Le matin des magiciens de Louis Pauwels et Jacques Bergier, paru en 1960.

Ces accusations sont vérifiées et confirmées par de nombreux médias, dont Radio Canada.

Jeudi 24 septembre, le Figaro révèle que le compte anonyme est administré par Samuel Fitoussi, lui-même chroniqueur au Figaro et relais de la première heure des accusations liées à l’utilisation potentielle d’une IA générative dans l’écriture de C’était ça ou mourir.

Et vendredi donc, l’académie Goncourt prend la parole, alors même que son président, Philippe Claudel, avait appelé à ne pas jeter l’opprobre sur l’auteur, et laissé entendre qu’une décision serait prise avant le 6 octobre, date à laquelle le jury doit publier sa liste resserrée.

Le court texte de l’académie Goncourt montre bien le caractère inconfortable de sa position. Il associe en effet deux accusations de nature totalement différente et s’appuie sur les faits avérés de plagiat pour justifier sa décision de sanctionner une faute qui reste, à ce stade, supposée. L’académie le reconnait implicitement quand elle écrit que le roman est « selon toute vraisemblance très largement » écrit à l’aide de l’IA.

S’ils revendiquent une fiabilité élevée, les concepteurs de Pangram admettent d’ailleurs qu’il subsiste une marge d’erreur : ils ne vendent pas une preuve définitive, mais une présomption.

La fin du texte de l’académie soulève de nouvelles questions. Elle indique en effet que sa décision doit être comprise comme « un message qui affirme que nous ne cautionnons ni n’adoubons d’une façon ou d’une autre la création de textes générés avec l’aide de l’IA ». Faut-il comprendre que les textes postulant au Goncourt devront désormais systématiquement passer sous les fourches caudines d’une analyse assistée par intelligence artificielle ? Le cas échéant, à quel niveau d’assistance IA détecté dans l’écriture l’œuvre concernée sera-t-elle recalée ?

En attendant de voir si et comment les autres grands prix littéraires de la rentrée (Renaudot, Femina…) se positionnent, l’académie prévient commodément que, de son côté, le débat public est clos.

  •  

WikiMasters, le jeu qui voulait changer Wikipédia en cartes à collectionner

Cherche échange sarrasin commun contre loutre d'Europe
WikiMasters, le jeu qui voulait changer Wikipédia en cartes à collectionner

Lancé au printemps, le jeu WikiMasters a déclenché un phénomène viral sur le web francophone, jusqu’à attirer 215 000 utilisateurs quotidiens selon son créateur. Son principe, associé à des options payantes, est d’une efficacité redoutable : il transforme les fiches Wikipédia en cartes à collectionner, que les joueurs peuvent échanger, vendre ou utiliser pour s’affronter sur des QCM de culture générale.

J’hésite encore entre collectionner les villages de la Manche, les représentants de la dynastie des Capétiens, ou les entrées du tableau périodique des éléments. Les premiers sont sans doute plus faciles à acheter aux enchères que les dernières, mais bon, je ne suis pas breton normand… Voilà le genre de dilemme cornélien auquel sont confrontés les joueurs de WikiMasters, le nouveau jeu de cartes à collectionner qui fait l’objet d’une diffusion virale assez exceptionnelle depuis quelques jours sur le web francophone.

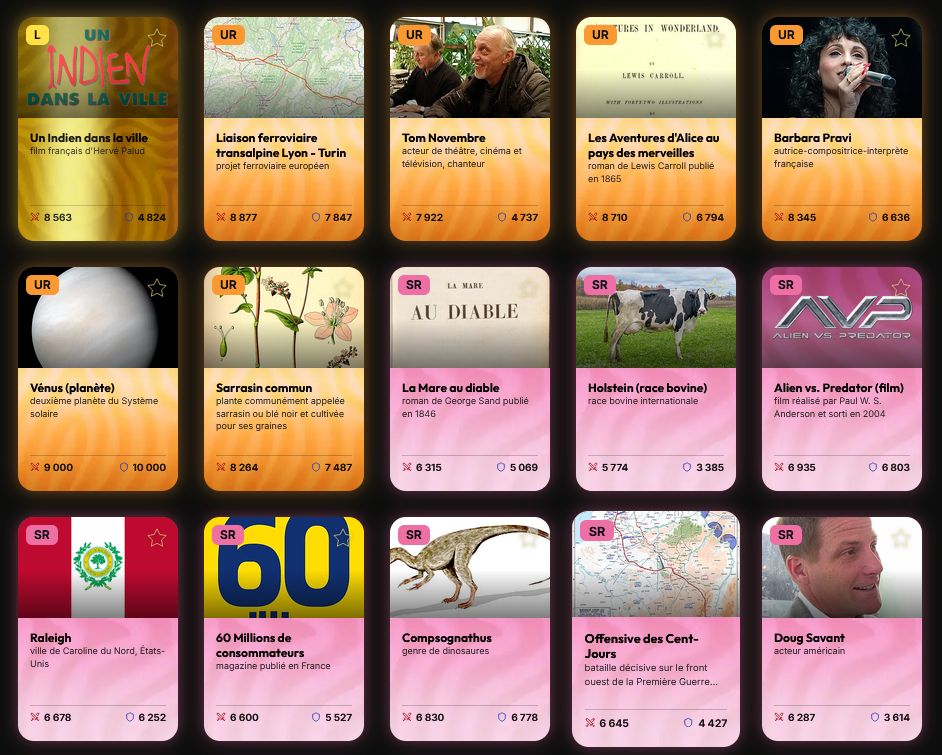
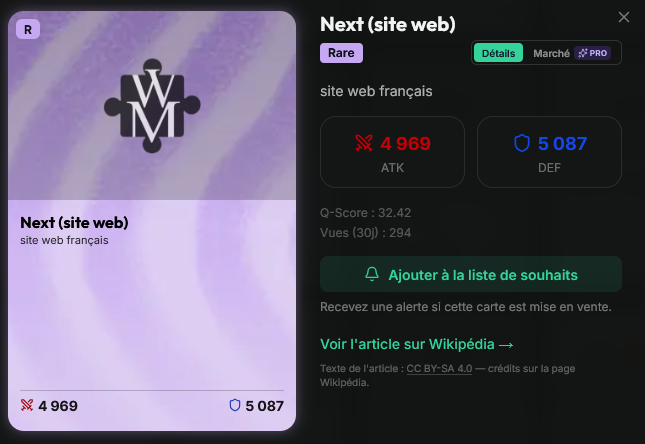
L’éclectisme des cartes reflète la richesse de Wikipédia – capture d’écran Next

Un booster de cartes toutes les dix minutes

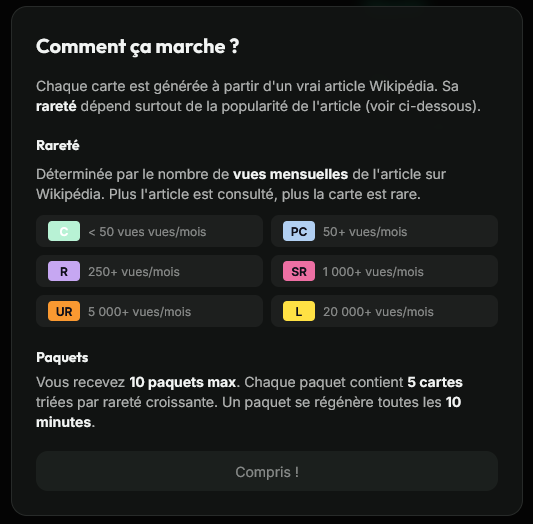
Le principe ? WikiMasters fait de chaque fiche de la Wikipédia francophone une carte à collectionner. Chaque carte dispose de valeurs d’attaque et de défense ainsi que d’un indice de rareté, déterminés à partir des statistiques de l’article Wikipédia correspondant : plus la fiche source est consultée, et plus sa valeur virtuelle augmente. Un obscur diplomate polonais devient une carte commune, tandis que la Lune, AC/DC ou Un indien dans la ville deviennent des cartes légendaires.

La rareté d’une carte dépend de la popularité de l’article dont elle découle – capture d’écran Next

Pour alimenter sa collection, le joueur dispose d’un booster de cinq cartes offert toutes les dix minutes, avec la possibilité d’empiler jusqu’à dix paquets en cas d’absence. Les cartes peuvent ensuite être mises à profit pour créer des « vitrines », illustrant par exemple une collection thématique.

Elles peuvent aussi, et surtout, être échangées, défaussées ou vendues aux enchères, grâce à une monnaie virtuelle, le « wikibidou ». La plateforme propose enfin un système de guildes et une mécanique de bataille, qui permet d’affronter un autre joueur sur la base de questions (QCM) élaborées à partir du contenu de la fiche Wikipédia associée à la carte mise en jeu.

Lancé en mars dernier, WikiMasters a vécu dans un anonymat relatif jusqu’à ce que sa viralité explose, notamment grâce à plusieurs sessions de jeu diffusées en direct par des streamers populaires à l’occasion du ZEvent, le célèbre marathon caritatif diffusé sur Twitch début septembre. Depuis, les nouveaux adeptes affluent, ce qui ne va pas sans provoquer quelques ralentissements au niveau de l’hébergement du jeu.

« On a atteint environ 215 000 utilisateurs actifs par jour dans la dernière semaine, nous confie Naïm Ouellet, le développeur québécois à l’origine de WikiMasters, qui entend bien surfer sur la vague de cette popularité grandissante. En ce moment on galère à tout mettre à l’échelle, mais une fois le jeu stable, on compte bien développer une appli native et traduire le jeu dans plusieurs langues. » En attendant, le site souffre encore de quelques lacunes, à commencer par l’absence de mentions légales.

Une mécanique économique déjà bien rodée

Animée pour l’instant par deux développeurs, l’équipe en charge du projet semble néanmoins partie pour se développer. Sur LinkedIn, Naïm Ouellet indique recruter jusqu’à quatre personnes, deux développeurs, un chargé de projet et un gestionnaire de communauté, ce qui atteste que l’activité dégage un chiffre d’affaires prometteur.

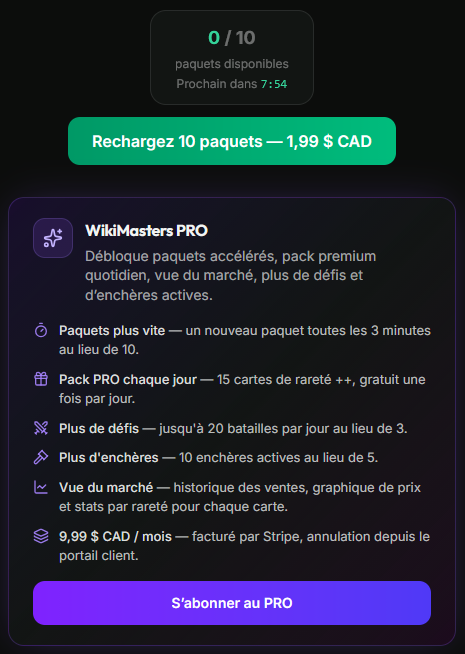
WikiMasters dispose en effet d’un modèle économique. L’inscription et l’accès au jeu sont gratuits, mais le site propose un abonnement Pro facturé 9,99 dollars canadiens (environ 6,5 euros) par mois, qui permet d’augmenter la fréquence d’apparition de nouveaux boosters, la rareté des cartes piochées, ainsi que le nombre de batailles ou d’enchères possibles par jour. Il offre également l’accès à un historique des ventes de cartes sur le marché, et des statistiques supplémentaires sur la rareté des cartes. En parallèle, le jeu propose également à la vente sa monnaie virtuelle, à hauteur de 4,99 dollars canadiens les 2 500 WikiBidous.

Le jeu est gratuit, mais un abonnement permet d’accélérer l’obtention de cartes – capture d’écran Next

Les mécaniques commerciales n’ont rien d’inédit : elles sont typiques de la logique des loot boxes (coffres à butin) que connaissent bien les amateurs de jeu free-to-play, et notamment de cartes à collectionner, dans la droite ligne des jeux gacha venus du Japon.

WikiMasters n’est d’ailleurs pas le premier à exploiter le filon. Il existe un précédent, justement baptisé Wikigacha, qui semble avoir été lancé quelques semaines plus tôt, en février 2026. Et il ne sera probablement pas le dernier : un certain Wiki-pick vient ainsi de faire son apparition, avec une promesse très proche (pour ne pas dire identique) et un nom de domaine enregistré le 12 septembre dernier.

Pour alimenter leurs services, tous ces jeux exploitent les API (interfaces de programmation) mises à disposition par Wikipédia afin de faciliter la circulation du savoir. Chez WikiMasters, on affiche un éventail de quelque 2,7 millions de fiches, régulièrement actualisé pour générer de nouveaux drops de cartes. Une carte qui était commune en août peut ainsi devenir légendaire en septembre, si la fiche associée a connu un pic de trafic, en raison par exemple de l’actualité.

Circulation ou marchandisation du savoir ?

Le site semble à première vue respecter les conditions d’utilisation, ou plutôt de réutilisation, fixées par Wikipédia. L’encyclopédie diffuse pour mémoire ses contenus sous licence CC-BY-SA, qui autorise le partage à l’identique avec attribution. Les cartes WikiMaster n’affichent qu’un extrait du texte de la fiche concernée, proposent un lien direct, et mentionnent systématiquement la licence. Les puristes noteront peut-être que les visuels et photos sont quant à eux affichés sans mention directe de la licence associée (parfois plus spécifique que la licence globalement appliquée aux textes).

Wikipédia tient à jour une liste des jeux qui exploitent son contenu, parmi lesquels quelques incontournables, comme Pédantix, Wikitrivia ou Factle, qui sont développés par des contributeurs dans un esprit de valorisation du savoir et sans logique marchande.

Quid de Wikimasters (ajouté le 2 septembre dernier sur la page en question) ? « Sur le principe, on est ouvert à toutes les formes de réutilisations des contenus des projets Wikimedia, c’est ce que permet la licence. Cela permet effectivement d’accroître la diffusion du savoir », nous répond l’association Wikimédia France, qui indique toutefois n’avoir pas encore étudié spécifiquement ce cas et les nouvelles questions qu’il soulève en matière de respect précis de la licence.

Dans le Discord communautaire du Wikipédia francophone, on observe que la contagion a déjà gagné certains contributeurs de l’encyclopédie, avec pour certains une quête un peu particulière : mettre la main sur la carte des articles qu’ils ont eux-mêmes rédigés.

En toute objectivité, la meilleure carte du jeu – capture d’écran Next
  •  

☕️ France Travail publie sa plateforme dédiée aux métiers du numérique


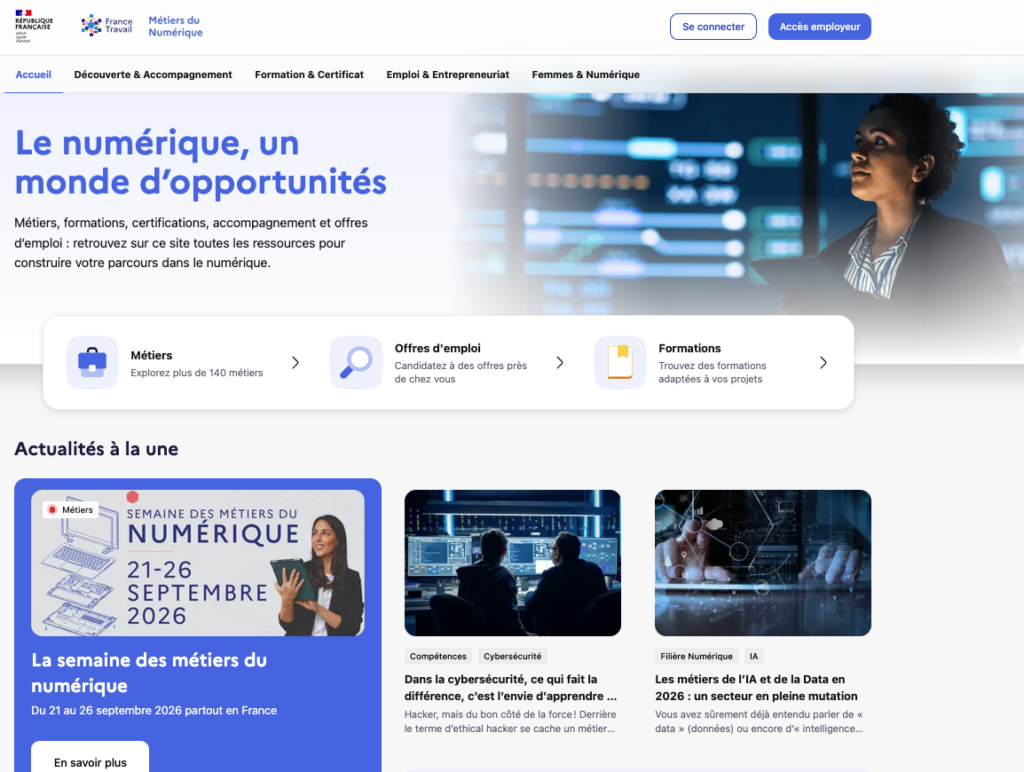
Trouver un emploi dans le numérique via France Travail, c’est désormais possible, et même fléché. Ce 21 septembre, l’établissement public mettait en ligne sa plateforme numerique.francetravail.fr, dédiée à informer et centraliser les ressources sur les emplois de l’industrie technologique.

Avec cet outil, France Travail indique vouloir faciliter les recherches d’emploi dans sept familles de métiers du secteur numérique, mais aussi faciliter la recherche de potentiels employés pour les entreprises concernées.

Les métiers sont réunis dans les catégories développement et logiciels ; data, IA et cybersécurité ; réseaux, systèmes et infrastructures ; design et création ; marketing, communication et e-commerce ; gestion de projets et transformation numérique ; et support et services numériques.

Pour les personnes en recherche d’emploi, la plateforme propose un espace de « découverte & accompagnement », qui donne notamment accès à des fiches dédiées à plus de 140 emplois répartis dans les familles précitées. En quelques clics, il est ainsi possible d’en savoir plus sur le travail d’Analyste SOC (Security Operations Center), de technicien ou technicienne de data center, ou encore d’UX/UI designer.

Plus loin, l’espace Formation et certificat est principalement pensé pour aider celles et ceux qui se tournent vers la tech à la suite d’une reconversion. La page « Emploi et entrepreneuriat » permet quant à elle de « passer à l’action » après les collectes de renseignements.

Comme les pouvoirs publics cherchent depuis plusieurs années à accélérer la diversification des effectifs de l’industrie numérique, un dernier espace est plus spécifiquement dédié aux femmes qui envisageraient de rejoindre l’industrie. Concrètement, il s’agit de les rediriger vers une série d’organismes, de réseaux ou de formations tantôt généralistes, tantôt spécialisées dans l’accueil des femmes, comme Femmes @ Numériques, Elles bougent, Sista ou Cyberelles. 


Ce modèle correspond en tous points à celui proposé dans les trois autres axes piliers du service, où divers organismes d’accompagnement, d’immersion (pour ceux qui arriveraient dans le secteur), ou encore d’échanges avec des professionnels sont, chaque fois, proposés.

France Travail propose par ailleurs une page dédiée aux employeurs, via laquelle elle leur fournit de quoi identifier rapidement les profils susceptibles de répondre à leurs besoins.

Cet outil s’intègre directement dans « la dynamique des plateformes sectorielles » que propose France Travail. Aux côtés de ce portail dédié aux métiers du numérique, l’entité en propose en effet d’autres spécialisés dans les métiers du soin, ceux de la culture et du spectacle, ou encore ceux du transport et des mobilités.

  •  
❌