Des agents IA par-ci, des agents par là… les entreprises d’IA générative ont toutes ce mot à la bouche. On parle également de plus en plus de harnais. Mais de quoi s’agit-il ? Next vous explique !
L’intelligence artificielle existe depuis des décennies, elle remonte même aux années 1950. Après quelques « hivers » – des périodes durant lesquelles l’IA stagne et se fait oublier, elle a fait un bond avec l’arrivée des cartes graphiques modernes. En 2022, le grand public est entré de plein fouet dans l’ère de l’intelligence artificielle générative (ou GenAI), capable de produire du texte et des contenus multimédias et propulsée par ChatGPT.
De l’IA générative, nous voilà désormais dans l’ère de l’IA agentique. Pour la CNIL, il s’agit d’un « ensemble de systèmes qui reposent sur la coordination de plusieurs sous-systèmes appelés agents IA ». Ces agents sont bien plus qu’une IA générative, ils sont capables « d’agir sur un environnement défini […] et d’en modifier l’état […], avec des niveaux variables d’autonomie ».
Un agent IA, c’est un harnais avec un modèle d’IA générative
Si l’IA générative produit du texte et du contenu multimédia, un agent IA va en plus pouvoir exécuter des actions, en s’appuyant sur cette même IA. On touche du doigt la notion de harnais, qui est l’infrastructure logicielle. Le modèle d’IA générative et le harnais forment un agent IA. S’il se dégage un consensus sur le harnais, il n’existe pas (encore) de définition précise ; il faut dire que le terme est récent et n’est utilisé couramment que depuis le début de l’année.
Il reste 76% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Nouvelle mouture pour le « petit modèle » d’Anthropic, Haiku. Moins spectaculaire qu’un nouvel Opus, cette version était attendue pour ses tarifs accessibles. Le bond en performances est majeur, mais plusieurs points sont à connaître.
Présenté ce 7 octobre, Haiku 5.5 est ainsi mis en avant par Anthropic comme son modèle le moins cher, le plus rapide et le plus « capable ». Il est destiné aux tâches à fort volume (résumés, compaction, requêtes de bases de données, classification…) et peut servir de sous-agent pour Opus/Sonnet 5.5. Il est aussi conçu pour les usages sensibles à la latence comme l’assistance client et le pilotage de navigateur.
Haiku a bien changé
Cela faisait quand même près d’un an qu’Anthropic n’avait pas mis à jour ce modèle, depuis Haiku 4.5 (aucune version 5 n’avait été lancée). L’attente en valait-elle la peine ? Sur le papier, le bond est majeur. Haiku 5.5 présente ainsi une fenêtre de contexte d’un million de tokens (jetons) et de 128 000 en sortie, contre respectivement 200 000 et 64 000 pour Haiku 4.5. Le nouveau venu se dote pour la première fois d’un réglage d’effort, calé sur « Moyen » par défaut.
Côté tarifs, on reste sur une approche agressive, avec 0,10 dollar par million de tokens en entrée et 0,50 dollar en sortie. Mais attention, ces chiffres ne concernent que les requêtes inférieures à 100 000 tokens. Au-delà de cette frontière, les tarifs sont multipliés par 5, tout en restant inférieurs à ceux de Haiku 4.5 (la moitié en moyenne). Selon Anthropic, 90 % des requêtes adressées à Haiku 4.5 étaient sous le seuil des 100 000 jetons.
Si la baisse de prix est réelle, elle est aussi conditionnelle. Haiku 5.5 est plus verbeux que son prédécesseur, selon Artificial Analysis. Tout dépend aussi désormais du niveau d’effort configuré. Mais si l’on en croit le testeur indépendant, Haiku 5.5 présente un coût par tâche systématiquement plus intéressant que l’ancien Haiku. Anthropic positionne d’ailleurs Haiku 5.5 face à GPT-6 Luna, contre lequel il se montre plus avantageux. Mais là encore attention, car la majoration tarifaire sur Luna intervient à 272 000 tokens, contre 100 000 « seulement » pour Haiku.
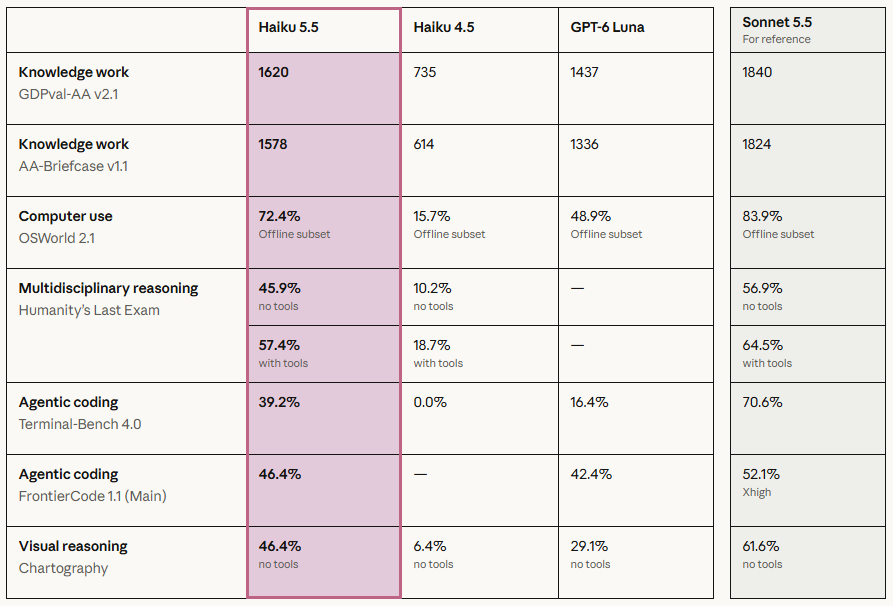
Côté performances, Anthropic met en avant un bond assez spectaculaire dans les différents benchs. Par exemple, un score de 39,2 % sur Terminal-Bench 4.0 (développement agentique), contre 0 pour Haiku 4.5. De l’ancien modèle au nouveau, on relève un passage de 735 à 1 620 sur GDPval-AA v2.1, de 15,7 à 72,4 % sur OSWorld 2.1, ou encore de 6,4 à 46,4 % sur Chartography.
Source : Anthropic
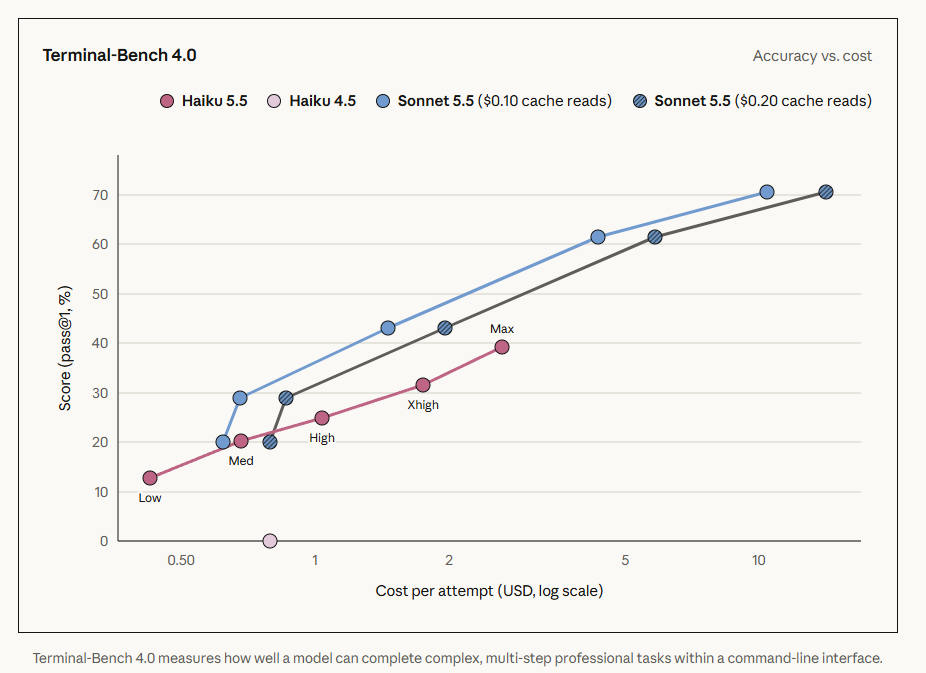
« Capable » semble donc être le mot, mais il faut souligner un point important : les scores affichés dans le tableau fourni par Anthropic sont tous en effort maximal. On peut le voir facilement dans le graphique plus bas dans la page de l’annonce : sur les exemples donnés, l’entreprise relève toujours le score correspondant à l’effort Max. Mieux vaut garder ce détail en mémoire, car les scores n’ont bien sûr rien à voir en « Moyen » (le mode par défaut), le score Terminal-Bench 4.0 étant par exemple divisé par deux, avec 20,3.
Source : Anthropic
En outre, le seul effort mentionné dans le tableau est dans la colonne de Sonnet 5.5, donnée en référence : 52,1 % en Xhigh sur FrontierCode 1.1. Une manière sans doute d’attirer l’attention sur les performances de Haiku 5.5, qui obtient 46,4 % sur ce test, donc avec un écart de moins de 6 points. Impressionnant ? En quelque sorte, mais sur Terminal-Bench 4.0, Sonnet 5.5 grimpe à 70,6 % (niveau d’effort inconnu), contre 39,2 % pour Haiku. L’écart est cette fois énorme.
Comme l’indique Anthropic dans son annonce, ces résultats ne sont donnés qu’à titre de « référence », car Haiku 5.5 « convient mieux aux tâches plus étroites qui auraient autrement été coûteuses avec les versions précédentes de Claude – comme la compaction, la synthèse ou le travail sur les sous-agents ».
Un mot enfin sur la cybersécurité. Selon l’éditeur, les garde-fous de cybersécurité sont plus stricts que ceux de Haiku 4.5, mais moins que ceux de Sonnet 5.5. Ils autorisent davantage de tâches défensives et bloquent toujours les tests d’intrusion. Peut-être une manière de faire un clin d’œil à Hugging Face, qui avait fustigé l’impossibilité d’utiliser les modèles commerciaux américains pour se défendre, alors qu’elle était attaquée par des agents d’OpenAI.
Anthropic a profité de son annonce sur Haiku 5.5 pour annoncer plusieurs changements tarifaires qui, dans certains cas, peuvent avoir une influence importante pour les projets exploitant l’API commerciale (facture à l’usage).
Le tarif pour la lecture de cache dans Sonnet 5.5 est ainsi réduit de moitié, « ce qui signifie que Sonnet 5.5 coûte désormais environ 20 % moins cher sur la plupart des travaux d’agent » affirme Anthropic.
L’entreprise déploie également un nouveau crédit API mensuel pour les abonnements Max et Team sur la Claude Platform. Les utilisateurs Max 5x recevront 100 dollars de crédits par mois, les Max 20x auront 200 dollars et les Teams auront jusqu’à 500 dollars, à répartir entre les utilisateurs. « Ces crédits sont conçus pour permettre à nos utilisateurs d’expérimenter la création d’outils, d’applications et d’agents qui appellent notre API », indique Anthropic.
Enfin, les SDK (kits de développement) pour Python et TypeScript ont été mis à jour pour ajouter la prise en charge de l’utilisation de l’ordinateur et du navigateur. Il s’agit pour l’instant de bêtas, et Anthropic braque la lumière sur Haiku 5.5, décrit comme « particulièrement adapté » à ce type d’usage.
Mistral vient de lancer une préversion publique de son nouveau LLM de frontière Mistral Large 4. Surnommé « Le Chonk », il doit remettre l’entreprise française dans la course, après de longs mois de quasi-silence sur les grands modèles.
Mistral Large 4 affiche 1 050 milliards de paramètres, dont 49 milliards actifs simultanément, dans une architecture MoE (Mixture of Experts) désormais classique. La fenêtre de contexte est d’un million de tokens. Dans sa présentation, Mistral évoque un entraînement depuis zéro sur la base de 3 800 puces Grace Blackwell de NVIDIA dans ses propres centres de calcul en Europe.
S’agissant d’une préversion, l’entrainement est toujours en cours. Mistral indique que d’ici la publication de la version le 26 octobre, une version privée du modèle est mise entre les mains de « partenaires sélectionnés, en leur donnant accès à une version de nos endpoints avec une modération allégée et des fonctionnalités plus avancées dans le domaine de la cybersécurité, et en leur distribuant les poids de la préversion du modèle ». Les poids seront d’ailleurs publiés le 26 octobre également, en même temps que des informations plus précises.
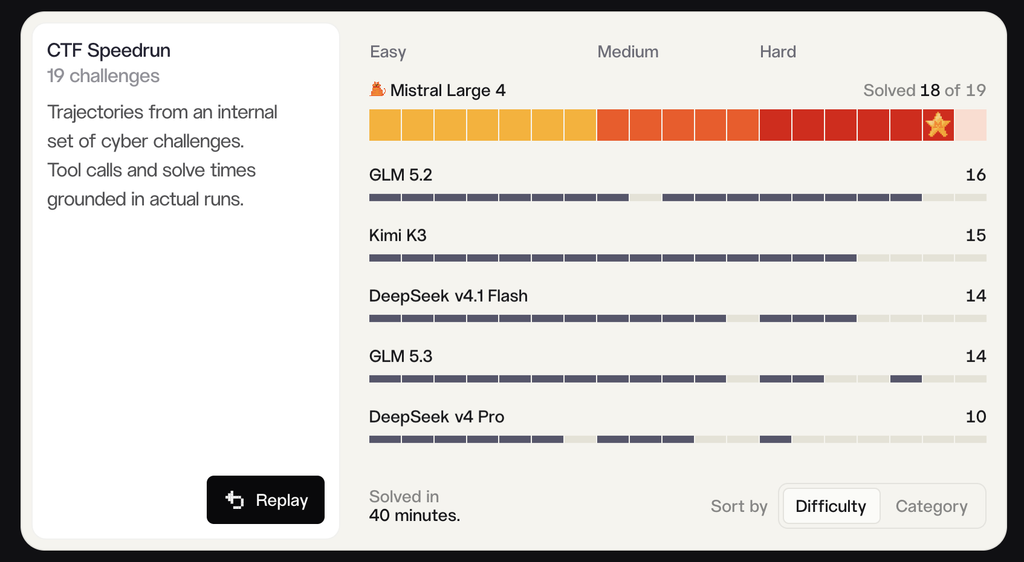
L’entreprise semble sûre de son fait : « Le Chonk fait progresser l’état de l’art des modèles à poids ouverts en matière de fonctionnalités agentiques génériques. Sur les métriques agrégées, il se classe parmi les meilleurs modèles à poids ouverts et est de loin le meilleur en Europe et aux États-Unis. Parmi les modèles à poids ouverts, Le Chonk est à l’état de l’art sur les tâches de cybersécurité, sur les tâches liées à la production industrielle et à la finance, ainsi que sur l’usage multimodal. »
Les benchmarks publiés vont bien sûr dans ce sens, avec 61,7 % sur DeepSWE v1.1, 59,4 % sur SWE-Atlas-QnA et 28,3 % sur Terminal-Bench 4, soit 49,8 % à l’indice combiné, devant DeepSeek V4 Pro 0813 et Qwen3.8 Max. Des scores que l’on retrouve sur Artificial Analysis, qui place ML4 dans la moyenne haute des LLM en matière d’intelligence et de rapidité. En revanche, le site classe le nouveau LLM comme très verbeux. De fait, malgré une tarification intéressante de 1,36 dollar par million de jetons en entrée et 4,18 dollars en sortie, cette verbosité peut avoir une grande influence. Étrangement, Artificial Analysis évoque une fenêtre de contexte de 524 000 jetons, mais ce chiffre pourrait venir d’une préversion antérieure.
Un accent sur la cybersécurité
Selon Mistral, ML4 est « l’un des modèles d’IA les plus puissants au monde pour la cybersécurité », classé dans le Top 5 du Cyber Index d’Artificial Analysis, devançant « largement les modèles à poids ouverts développés hors de Chine ». Dans les tests du Cyber Index, ML4 aurait ainsi obtenu 82 %, soit le meilleur score à ce jour, et 93 % sur Cybench, se classant parmi les meilleurs modèles à poids ouverts.
L’entreprise française se fait un plaisir de s’engouffrer dans cette porte ouverte, abordant directement le problème des risques que de telles performances peuvent faire courir. Un quasi non-sujet pour Mistral, car il s’agit avant tout de défense. Elle pointe les modèles fermés comme Claude Opus 5.5 et GPT-6 Astra, qui obtiennent zéro au Cyber Index car ils refusent d’exécuter des tâches.
« C’est d’autant plus important que les acteurs malveillants font de plus en plus de jailbreaks de ces mêmes modèles pour soutenir une cyberactivité offensive : les défenseurs ont besoin de systèmes pouvant égaler ces capacités sans être contraints par les mêmes refus », ajoute Mistral. L’incident Hugging Face n’est pas directement cité, mais on se souvient que l’entreprise s’était plainte de ne pas avoir pu analyser les premières traces de l’attaque qu’elle subissait parce que les modèles fermés se cabraient devant les questions de cybersécurité. Ironie, Hugging Face s’était alors tournée vers un modèle chinois, GLM 5.2.
Enfin, pour le travail de bureau, Mistral indique 59,9 % sur AutomationBench. Sur des tâches financières et juridiques évaluées par vals.ai, il dépasserait GPT-6 Astra, et il est en tête des modèles ouverts sur le test juridique de Harvey. Pour l’ancrage visuel, il obtient 42 % contre 41 % pour GPT-6 Astra sur Dense 200, un écart minime.
OpenAI déploie son outil de filigrane sur le texte généré par ChatGPT. Cette fonctionnalité, réservée au Vieux continent en vertu de l’AI Act, demeure une solution imparfaite à un problème complexe.
Après Anthropic qui a intégré une fonction de filigrane dans le texte généré par Claude (depuis Fable 5.1 plus précisément), c’est au tour d’OpenAI de respecter l’obligation européenne de permettre l’identification d’un texte généré par ChatGPT. Cette mesure, inscrite dans l’AI Act, est en vigueur depuis début août – les systèmes d’IA présents sur le marché ont jusqu’au 2 décembre pour respecter les obligations de marquage technique.
OpenAI a donc dévoilé sa feuille de route pour le tatouage des textes. La technologie, baptisée textGrain, ajoute un « signal statistique invisible » sur les choix des mots. Autrement dit, c’est une technique qui « modifie subtilement la manière dont le modèle choisit de façon aléatoire entre plusieurs mots ou fragments de mots possibles au fil de la génération [du texte] », explicite l’entreprise dans une fiche technique.
« Sur l’ensemble d’un passage, ces choix créent un motif qu’un détecteur peut repérer, même après certaines modifications du texte. » Le résultat est censé être invisible aux yeux du lecteur, la technique n’ajoutant « aucun caractère caché, espace invisible ou signe de ponctuation inhabituel ». Anthropic a choisi une solution similaire.
Pangram, qui a beaucoup fait parler ces dernières semaines suite à l’affaire Thélyson Orélien, analyse les textes après leur génération, en se basant sur des caractéristiques comme le choix des mots. Il ne détecte pas les signaux intégrés à même les textes, comme c’est le cas des filigranes.
Le code des bonnes pratiques sur la transparence des contenus de l’AI Act n’impose pas de watermark sur les textes de moins de 200 tokens, ce qui représente environ 150 mots en anglais. De toute manière, les techniques de filigrane ne sont pas efficaces sur les textes courts, comme le rappelle OpenAI.
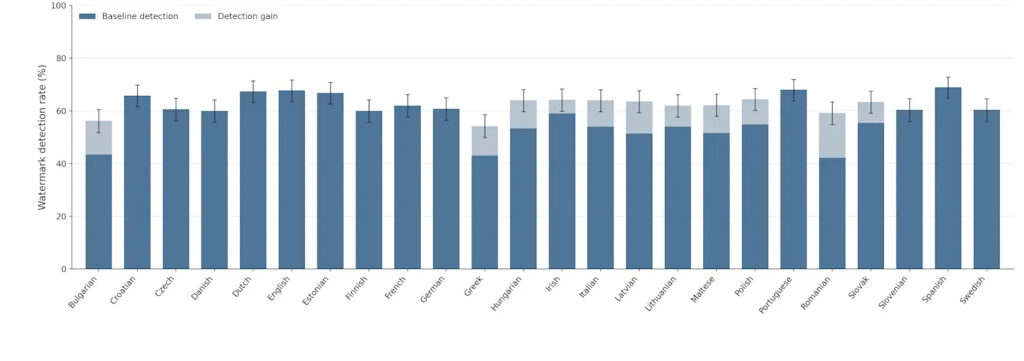
Image : OpenAI
Le taux de détection varie en fonction de la langue, certaines d’entre elles se montrant « plus faciles à détecter que d’autres ». Sur les tests réalisés par l’entreprise – 500 prompts générés en anglais, puis traduits –, l’espagnol obtient le meilleur taux de détection (69 %), le roumain affichant le taux le plus faible (42,2 %). Avec un taux qui dépasse 60 %, le français est plus proche de l’espagnol.
OpenAI ajoute à textGrain un paramètre d’ajustement de l’intensité pour renforcer ou réduire le signal du filigrane en fonction des domaines. Le taux de détection de certaines langues, qui se situe normalement sous le seuil des 60 %, s’améliore grâce à ce paramètre. L’entreprise a l’intention de proposer sa technologie en open source.
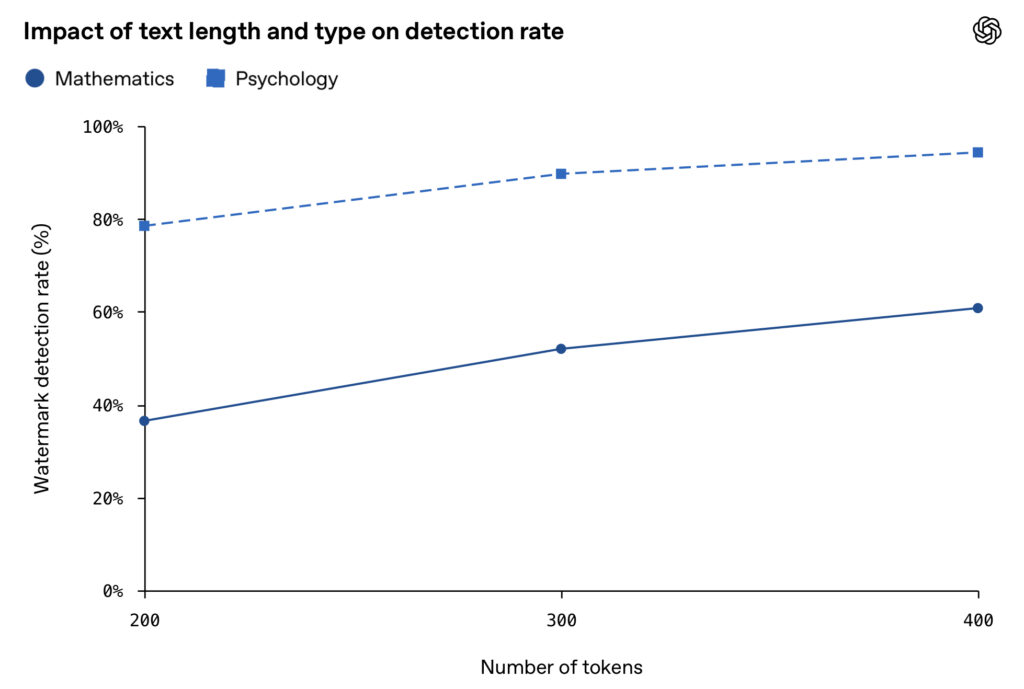
Image : OpenAI
OpenAI explique que les détecteurs peuvent commettre deux types d’erreurs de détection : faux positifs (signaler la présence d’un filigrane qui n’existe pas) et faux négatifs (ne pas repérer la présence d’un filigrane existant). Sur des passages de 400 tokens, avec un taux de faux positifs cible de 1 %, le détecteur a identifié un filigrane dans 95 % des cas – mais tout dépend du contenu. Sur les textes portant sur la psychologie, le taux de détection est particulièrement élevé ; il l’est beaucoup moins quand il s’agit de mathématiques, où le choix des mots est plus limité.
Brouiller les pistes
Autre limite : modifier les textes générés par IA a un impact sur le taux de détection. Un taux de détection à 92 % peut tomber à 66 % si 10 % des mots ont été remplacés par des synonymes. Remplacer 25 % des mots fait chuter le taux à 17 %. Ce qui est logique, au vu du fonctionnement du filigrane.
L’entreprise prévient aussi que les filigranes sur le texte ne sont pas la panacée. Un watermark ne mesure pas la contribution d’un humain, il se contente de dire qu’un modèle a généré ou modifié un texte. Il ne détermine pas non plus à qui appartient le texte ou qui en est le responsable. Il n’identifie pas non plus l’utilisateur et ne mesure pas la fiabilité du texte. Enfin, l’absence d’un filigrane ne prouve pas qu’un texte a été écrit par un humain.
textGrain est disponible dès aujourd’hui dans l’API, où la fonction peut être activée via les réglages (uniquement dans l’UE). Il se déploiera au sein de ChatGPT et Codex dans les prochaines semaines. En revanche, l’accès à l’outil de détection demeure encore la chasse gardée des chercheurs et des organisations sélectionnés qui travaillent à l’amélioration de la fiabilité de l’outil.
ChatGPT, Claude ou Gemini ont une mémoire qui leur permettent d’enregistrer certaines informations importantes sur leurs utilisateurs, afin de se « souvenir » d’un détail, d’un nom, d’un événement ou d’une date utile à une réponse. C’est le cas aussi de Muse, mais le nouvel agent de Meta pousse le principe beaucoup plus loin.
Avec Muse, Meta semble enfin avoir trouvé sa voie dans la course à l’IA. L’agent, lancé le 6 septembre mais toujours indisponible dans l’Union européenne, va bien plus loin qu’un « simple » chatbot : il peut chasser des informations sur internet en permanence et agir au nom de l’utilisateur, par exemple pour réserver un restau ou faire des courses (ce qui déplaît beaucoup à Amazon). Le succès de Muse ne tombe pas du ciel : Meta s’est fortement inspirée d’OpenClaw pour développer son propre agent. Et l’entreprise peut aussi compter sur l’immense surface de ses réseaux sociaux pour se donner une confortable longueur d’avance.
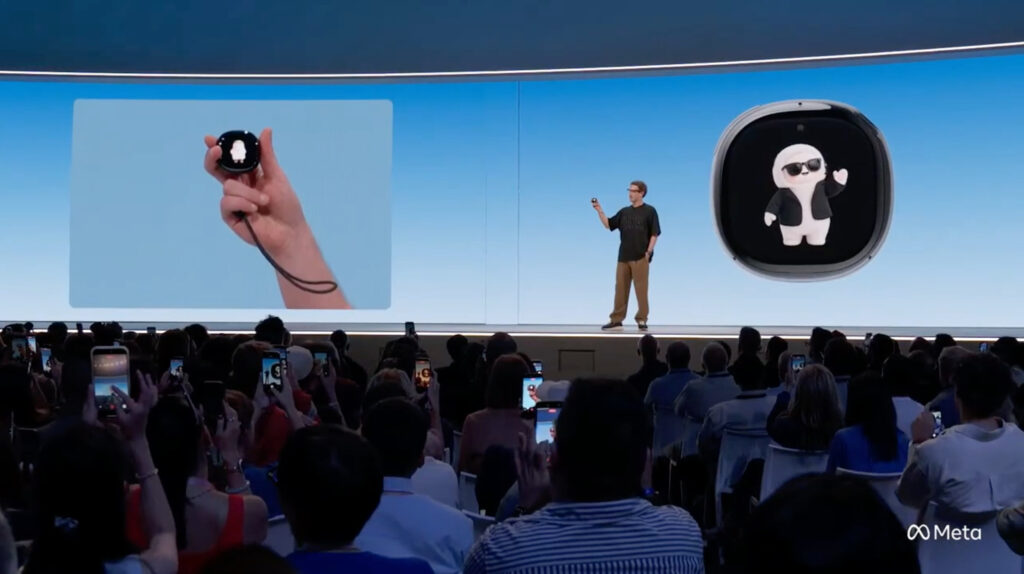
Le Charm dévoilé par Mark Zuckerberg durant la dernière conférence Meta Connect.
Le succès de Muse n’est pas tombé dans l’oreille d’un sourd : OpenAI a présenté pas plus tard que la semaine dernière son propre agent IA, Dots. Et Meta compte bien battre le fer tant qu’il est chaud. Muse est mis à toutes les sauces dans les autres produits et services du groupe, qu’il s’agisse de lunettes connectées… ou de Tamagotchi.
Les petites fiches de Muse
Mais Meta traîne derrière elle suffisamment de casseroles sur la vie privée pour que le fonctionnement de Muse mérite qu’on y regarde de plus près. Karan Joshi, chercheur en sécurité indépendant, a pu extraire un grand volume d’instructions et de prompts de l’agent, simplement en utilisant astucieusement l’interface de discussion. Il en a partagé une copie avec Wired, ce qui permet de jeter un œil dans les cuisines.
Il se trouve que Muse crée une page pour chaque personne importante dans la vie de l’utilisateur. Il s’agit de compiler des informations sur la famille, les intimes, les amis, les collègues, les personnes suivies par l’utilisateur. Cette mémoire, en fait des fichiers de texte structuré, se remplit au fur et à mesure des événements et des interactions ; ces données permettent à l’agent de construire une « représentation » des relations, avec le degré de proximité, l’historique, et même des pistes pour les renforcer.
D’après la documentation fournie par Karan Joshi, une « page » s’enrichit progressivement avec des sections : « Faits », « Historique », « Relation », « Points communs », « Sujets en suspens » et « Renforcement ». Muse doit uniquement utiliser les éléments qu’il a sous la main, et ne pas inventer des informations même si la page est vide.
Selon les instructions de Meta, Muse doit conserver « les sujets qui reviennent régulièrement (le déménagement, l’objectif commun d’épargne) », où vivent les relations de l’utilisateur, ce qu’elles font dans la vie. Le modèle peut également enregistrer les dates importantes comme les anniversaires, et des éléments de contexte comme une dispute terminée (certains parlent de beaucoup de choses très personnelles avec leur bot), une réunion importante la semaine dernière, un voyage…
L’enregistrement de l’état des relations est aussi manifestement important pour Muse : degré de proximité, sur quoi repose telle relation, ce dont cette relation peut avoir besoin… La section « Renforcements » peut d’ailleurs suggérer des moyens d’améliorer une relation : rappeler une date à ne pas oublier, une raison d’appeler…
Le plombier n’a rien demandé
« Pour qu’un agent soit utile et puisse réellement vous aider à atteindre vos objectifs, il doit disposer d’un certain contexte sur vous et sur les personnes avec lesquelles vous interagissez », explique un porte-parole de Meta. « Muse rassemble ces informations à partir de données publiques et de ce que vous avez choisi de partager. C’est ainsi qu’il peut se souvenir que la personne qui vous a envoyé une facture est en fait le plombier que vous aviez précédemment engagé pour effectuer des travaux dans votre salle de bains, ou encore l’envoi à votre conjoint de ses fleurs préférées. »
Une déclaration apparemment de bon sens, à laquelle on peut ajouter l’infrastructure de Muse. Il s’agit d’une machine virtuelle dans laquelle sont stockés les données de l’utilisateur et le contexte. Les agents tiers n’y ont pas accès sans autorisation, et l’utilisateur peut déconnecter les services tiers connectés à Muse, ou tout simplement en effacer la mémoire.
Muse va néanmoins plus loin que d’autres bots IA dans le stockage d’informations sur les personnes connues de l’utilisateur. ChatGPT possède une mémoire structurée, mais OpenAI la présente comme une synthèse évolutive du contexte entourant l’utilisateur. L’IA sélectionne les infos jugées pertinentes et la synthèse se met à jour et s’enrichit au fil du temps.
Le système de Meta organise les informations sur la relation qu’entretient un utilisateur avec une personne, leur historique, le degré de proximité, les sujets en suspens et peut même proposer des moyens de renforcer cette relation. Le problème ici, c’est la réputation exécrable de Meta quand il s’agit de manipuler les données personnelles, comme on l’a vu encore très récemment avec… Muse :
Enfin, le conjoint, les collègues, ou ce fameux plombier n’ont rien demandé, et surtout pas à être intégrés dans les petites fiches de Muse. Mais il suffit que l’utilisateur ait évoqué ces relations pour que ces personnes se retrouvent dans la mémoire de l’agent. L’utilisateur a certes accepté de partager des données publiques, mais pas nécessairement de ficher son entourage.
Sony Music prend le taureau par les cornes pour lutter contre les streams illégaux de chansons générées par IA. Fin septembre, la major a demandé aux plateformes le retrait de plus de 260 000 morceaux, un volume multiplié par deux par rapport aux trois premiers mois de l’année.
« Nous continuerons à faire respecter les droits de nos artistes et nous attendons des plateformes qu’elles agissent rapidement et empêchent la réapparition des mêmes contenus », a affirmé Sony Music au Financial Times. « Mais la tâche devient de plus en plus difficile », ajoute l’entreprise, une des trois majors de l’industrie du disque avec Universal (UMG) et Warner (WMG).
Le groupe a demandé aux plateformes de streaming de retirer plus de 260 000 morceaux fin septembre, alors que ce volume avait été de 135 000 fin mars. Ces titres sont des deepfakes générés par IA d’artistes signés par Sony (Adele, Queen, Michael Jackson…). Le phénomène prend « une ampleur considérable, porte préjudice aux artistes, trompe les fans et compromet une utilisation éthique de l’IA », précise la maison de disques.
Les bots écoutent les bots
Les services de streaming sont noyés sous les chansons générées par IA. Deezer avait ainsi indiqué qu’elles représentaient plus de la moitié des nouveaux morceaux téléversés en juillet. Ces titres sont très peu écoutés, et quand ils le sont, c’est souvent lié à des cas de fraude aux streams. Des bots « écoutent » ces chansons, ce qui en retour génère des revenus pour les fraudeurs, spoliant au passage les artistes légitimes.
Le rapport semestriel de la Sonic Intelligence Academy publié le mois dernier montre que plus de 9 chansons sur 10 (92,8 %) des morceaux soumis avaient été générés par Suno. Avec cette nuance : le pourcentage porte sur l’échantillon de l’étude, soit 1 743 titres provenant de 886 artistes dans 54 pays. Sur cet échantillon, 77,6 % ont été distribués aux plateformes par DistroKid, un distributeur payant permettant à ses clients d’être diffusé sur plus de 150 plateformes. Ces chiffres donnent toutefois une petite idée de la provenance de ces titres.
Sony Music et Universal poursuivent d’ailleurs Suno en septembre. La start-up est accusée d’avoir copié des enregistrements sans autorisation pour entraîner ses modèles IA. DistroKid est aussi la cible d’UMG, qui a porté plainte contre le distributeur le 15 septembre (PDF). Ce dernier se serait livré à « des pratiques commerciales trompeuses et à des violations flagrantes du droit d’auteur ». Plus précisément, DistroKid aurait contribué « à faire passer les morceaux IA pour ce qu’ils ne sont pas, et à en tirer profit ».
La riposte contre la fraude aux streams s’organise dans la filière, qui a couché sur le papier un ensemble de pratiques pour aider les acteurs du secteur – en particulier les distributeurs – à prévenir, détecter et traiter la fraude.
De leur côté, les plateformes ont mis en place des systèmes de badges pour indiquer aux auditeurs que tel artiste ou telle chanson est générée par IA. Bien souvent, les écoutes de ces morceaux sont démonétisées dès leur mise en ligne.
Régulièrement, sur les réseaux sociaux, on voit passer une phrase du genre : demandez à une IA de proposer un nombre entre 1 et 30, elle répondra 17. C’est vrai dans la grande majorité des cas, mais c’est bien plus large que cela… la suite pourrait bien vous surprendre.
Chez Next, on a évidemment tenté l’expérience, depuis des mois au moins ; effectivement, 17 revient quasiment tout le temps. Mais on prend aussi de la hauteur par rapport à cette expérience : que se passe-t-il avec une autre demande, entre 1 et 50 ou 1 et 100 ? Puis avec une lettre de l’alphabet ?
On ne se contente pas d’une poignée de requêtes, on a testé des dizaines de modèles avec des dizaines de demandes, pour des milliers de réponses. Surprise, il n’y a pas d’aléatoire… Étonnant pour un modèle statistique ? Pas vraiment non, et l’explication est assez simple.
Un point important : une IA générative n’est pas un générateur de nombres aléatoires. Quand on demande à une IA de donner un nombre, elle estime une réponse à partir de sa base de connaissance, c’est-à-dire ses données d’entraînement, et donc principalement des données provenant des humains.
17 « manque » à la roulette, mais pas dans les IA génératives
On pourrait dire que l’IA générative essaie de répondre à ce qui s’approche le plus, selon elle, d’une réponse humaine. Le cheminement est assez simple pour un nombre entre 1 et 30 : 17 est assez proche du milieu, impair et premier, il « attire » ; d’autant que nous allons voir que ce n’est pas la seule explication. Comme pour le reste, les IA génératives reproduisent donc les biais humains.
Nous avons testé plusieurs cas de figure. Pour commencer, nous reprenons l’exemple populaire d’un nombre entre 1 et 30, mais sur une large panoplie de modèles d’Anthropic, OpenAI et Google (GPT-5 à GPT-6, Sonnet 4.6 à Fable 5.1, Gemini 3.1 à 3.8) avec ou sans raisonnement. En tout, 171 requêtes sont envoyées à OpenAI, 48 à Anthropic et 55 à Gemini ; il ne s’agit pas de modèles différents à chaque fois, mais de configurations de version avec différents niveaux de raisonnement.
Il reste 82% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Pi est un harnais minimaliste open source, compatible avec plus de 1 500 modèles et variantes. C’est une alternative à Claude Code ou Codex, sans dépendre des modèles d’Anthropic ou d’OpenAI. Il vient de passer en version 1.0.0, signe de maturité selon ses développeurs. Pi Durable, capable de résister à des pannes « catastrophiques », est aussi présenté.
Dans le monde des intelligences artificielles, on parle souvent des chatbots : vous posez une question, ils répondent. Mais il y a beaucoup plus que cela : associées aux bons outils, les IA génératives peuvent générer du code, lire des fichiers, exécuter des commandes, etc.
Le harnais Pi est un agent IA minimaliste, mais extensible
On distingue alors souvent deux éléments : le modèle en lui-même (un peu le cœur du réacteur) et le harnais. Le modèle ne fait que générer du texte ou du contenu multimédia, tandis que le harnais regroupe tout ce qui tourne autour du modèle pour lui permettre d’accéder à des fichiers, de faire des recherches sur Internet, etc.
Vous connaissez certainement déjà des harnais, Claude Code par exemple, avec un moteur limité aux modèles d’Anthropic. Avec d’autres harnais, vous n’êtes pas limité sur les modèles (commerciaux ou à poids ouverts, en local) et pouvez ajouter celui que vous voulez, le remplacer en cours de route, etc. Pi est l’un de ces harnais ; il joue sur le côté minimaliste et vient de passer en version 1.0.0.
Il reste 79% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Le patron de SpaceXAI va participer à la création d’un important rapport prospectif sur les futurs visages de la guerre. Outre son retour officiel dans les sphères du pouvoir, plusieurs médias pointent les risques de conflits d’intérêt.
Le 30 septembre, le secrétaire américain à la Guerre, Pete Hegseth, a tenu un grand discours à la base des Marines de Quantico. Entre autres diatribes contre l’éternel « wokisme », se félicitant en particulier d’avoir sorti les « clowns idéologues » et d’avoir augmenté le nombre de tests de testostérone chez les soldats, il a évoqué une réduction de 20 % du nombre de généraux et amiraux. « Aujourd’hui, les médias parlent de purge. Moi, j’appelle cela rendre des comptes, et ça aurait dû être fait depuis longtemps », a-t-il déclaré, comme le relève Le Monde.
Le ministre était surtout venu annoncer six initiatives pour l’armée, dont plusieurs se distinguent par leur importance potentielle. C’est le cas notamment de l’Autonomous Warfare Command (Commandement de la guerre autonome).
Le communiqué le présente comme devant étendre la guerre autonome à l’ensemble des forces interarmées, sous la forme d’un « commandement de combat fonctionnel à quatre étoiles d’ici le 1ᵉʳ octobre 2027 ». Il s’appuie sur le programme Drone Dominance, qui aurait livré des milliers de systèmes robotisés au Moyen-Orient dans le cadre de l’opération Epic Fury.
De la bataille d’Azincourt à FORTRESS
Pour accoucher de ce commandement, une structure de transition chargée de préparer le terrain est mise en place, sous le nom de « Project Agincourt ». Agincourt, qui se traduit en français par Azincourt, est le nom d’une célèbre bataille de la Guerre de Cent Ans (en 1415), au cours de laquelle la chevalerie française fut écrasée par les Anglais et leurs redoutables arcs longs.
Le nom ne fait pas tant référence à la défaite française en elle-même qu’à la possibilité d’employer une arme bon marché en masse, qui l’emporte alors sur une force plus coûteuse et plus « prestigieuse ». Le projet a été confié au DRPM-UxS (Direct Reporting Portfolio Manager for Unmanned Systems), un poste créé trois mois plus tôt pour regrouper les activités du ministère de la Guerre dans le domaine des systèmes non habités.
Autre initiative importante, FORTRESS, pour « Federal Operations for Resilience, Troop Resources, Energy, Supply, and Survivability ». À terme, chaque grande installation militaire américaine produirait ainsi sa propre électricité de façon autonome, pour continuer à fonctionner si le réseau civil tombe à la suite d’une cyberattaque ou d’un sabotage.
Cette initiative prévoit aussi de relocaliser les chaînes d’approvisionnement critiques : terres rares, métaux spéciaux, semi-conducteurs et ergols. Elle comprend également la constitution de réserves stratégiques de munitions, de carburant, de médicaments et de sang. Enfin, elle couvre le durcissement des installations contre les intrusions informatiques, le sabotage et les drones, ainsi que la protection des satellites et du spectre radioélectrique.
Meridian et le « retour » d’Elon Musk
Outre la création d’une nouvelle grande base sur le sol national ou encore celle d’un « Bureau des affaires religieuses », on remarque sous le projet Meridian. Il s’agit d’une étude prospective qui doit couvrir tous les domaines de combat futurs, des profondeurs souterraines à l’espace cislunaire. Cette mission doit aboutir sous 120 jours à un rapport public non classifié, mais accompagné d’une annexe classifiée. L’échéance est fixée au 28 janvier 2027 par le mémorandum, qui prévoit que le projet soit commandé par l’intermédiaire d’une organisation partenaire (aucun nom n’a été donné).
Si le projet Meridian fait couler de l’encre, ce n’est pas tellement parce qu’il sera piloté par Emil Michael, directeur technique du ministère de la Guerre, mais parce qu’il y associe Elon Musk, Palmer Luckey et Newt Gingrich. Beaucoup y voient un retour du patron de SpaceXAI dans le giron de la Maison-Blanche, même s’il faut nuancer le propos. Dans le cadre de Meridian, son rôle relève du Pentagone, il ne revient pas dans l’exécutif présidentiel, comme c’était le cas quand il pilotait le DOGE. En outre, la mission est bornée dans le temps et limitée à un rapport.
Selon le magazine Time, le processus de réconciliation avec Donald Trump aurait commencé en décembre 2025 lors d’une « réunion clandestine » à la Maison-Blanche. Le président aurait passé plusieurs heures à tester Grok, le chatbot IA de SpaceXAI. Il aurait notamment demandé comment les Vénézuéliens réagiraient si les États-Unis capturaient Maduro, alors au pouvoir. Grok aurait caractérisé ce dernier de « dictateur répressif et profondément impopulaire », ce qui aurait aidé Donald Trump à décider sa capture le mois suivant.
En revanche, la question des conflits d’intérêts bat son plein. Axios rappelle par exemple que les entreprises d’Elon Musk et de Palmer Luckey détiennent d’importants contrats avec le Pentagone. SpaceXAI assure ainsi l’essentiel des lancements liés à la sécurité nationale, tandis qu’Anduril fournit brouilleurs, intercepteurs, moteurs de roquette et drones d’accompagnement. Même Fox News, pourtant favorable à l’administration, relève que des dirigeants d’entreprises en concurrence pour des marchés de défense vont aider à définir les capacités que l’armée devrait acquérir.
Changer de langue permet de consommer moins de tokens, c’est un fait et nous l’avons mesuré aussi bien chez Anthropic, OpenAI et Google. Moins de tokens, c’est un coût de revient plus faible et moins de calcul, donc une empreinte écologique plus faible.
Les IA génératives ne travaillent pas sur des mots, mais sur des tokens (ou jetons). C’est une manière de découper des phrases, propre à chaque famille de modèle. C’est le rôle du tokenizeur : vous saisissez votre prompt, il le transforme en tokens qui sont envoyés au modèle.
Il fait des centaines de milliards d’opérations sur chaque token et renvoie le résultat, de nouveau en tokens. Opération inverse du tokeniseur et voilà la réponse affichée.
Les grands modèles de langage ne parlent qu’en tokens, c’est l’unité de base pour les calculs et la facturation. Plus il y a de tokens en entrée et en sortie, plus vous payez cher (ou plus cela entame votre forfait). Il y a aussi plus de calculs, dont une empreinte environnementale plus importante.
Quel rapport avec le titre de notre actualité et donc avec les langues ? La création de tokens (ou jetons) n’est pas universelle : elle dépend de chaque famille de modèle, mais également de la langue. Pour mettre en lumière cette différence, nous avons pris comme référence le règlement général sur la protection des données (RGPD) de la Commission européenne, un long texte traduit dans les 24 langues de l’Union.
Une précision importante : le gain dont nous parlons ici reste anecdotique par rapport à un usage responsable : ne demandez pas à ChatGPT de faire de la reconnaissance de caractère basique sur une image ou de traduire un texte, des IA spécialisées le feront bien mieux et pour moins cher (en argent et en consommation). Vous pouvez aussi demander aux modèles d’être moins bavards, d’aller à l’essentiel. Les économies seront bien plus importantes.
Les tokens dans 24 langues et près de 10 millions de caractères
Chaque texte ne fait pas la même longueur : entre 320 000 et 415 000 caractères, avec 371 000 de moyenne environ. Mais ce règlement est assez long pour en tirer une métrique intéressante : le nombre de caractères moyens par token et par langue.
Il reste 74% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Alors que les deux mastodontes Anthropic et OpenAI sont lancés dans une course à l’échalote sur les performances (et la désobéissance) de leurs modèles, Google veut revenir dans la course avec Gemini 4 Argon. La cybersécurité et le code sont particulièrement mis en avant.
Mise à jour 13/10 – À chaque jour son nouveau LLM, ou pas loin. Après Meta et Muse Wonder, c’est au tour de Google de lancer Gemini 4 Argon auprès du grand public, après une disponibilité limitée à des spécialistes de la cybersécurité. Le modèle est accessible via l’API dans AI Studio et Gemini, ainsi que pour les abonnés Google AI Ultra (y compris dans la plateforme de création d’agents Antigravity) et Pro dans l’app Gemini et le mode IA de la recherche.
Article original, 1er/10 – Avec ce LLM qualifié de « frontier model », Google se présente comme un bon élève face à Donald Trump : « Nous participons activement au processus volontaire du gouvernement américain pour l’accès anticipé au modèle de prélancement, tout en élargissant progressivement cet accès ». C’est en effet ce que demande le président dans son décret du 2 juin.
Traduction : ne comptez pas en profiter pour l’instant. Ce modèle est « déployé auprès d’un groupe de spécialistes de la cybersécurité de confiance par le biais de notre programme Fairwind ». C’était aussi le cas pour Gemini 3.8 Flash Cyber au début du mois. Cela ne concerne donc que des gouvernements, des autorités nationales de cybersécurité, des opérateurs d’infrastructures critiques et d’autres spécialistes triés sur le volet. Une ouverture à tous est prévue, sans calendrier.
1 million de tokens : Google multiplie par 15 la limite de sortie
Premier changement important, la limite de sortie explose : « nous augmentons la limite de jetons de sortie du modèle à 1 million de jetons, une performance inégalée dans l’industrie, contre 64 000 auparavant ». À titre de comparaison, Fable 5.1 d’Anthropic et GPT-6 Astra d’OpenAI ont une fenêtre de contexte de 1 million de tokens, mais de « seulement » 128 000 tokens en sortie. Une limite huit fois plus large donc chez Google.
Google insiste sur ce point : « Grâce à cette capacité de traitement, le modèle peut analyser en profondeur et générer des centaines de milliers de jetons en une seule étape, ce qui lui permet de résoudre des problèmes complexes d’un seul coup ».
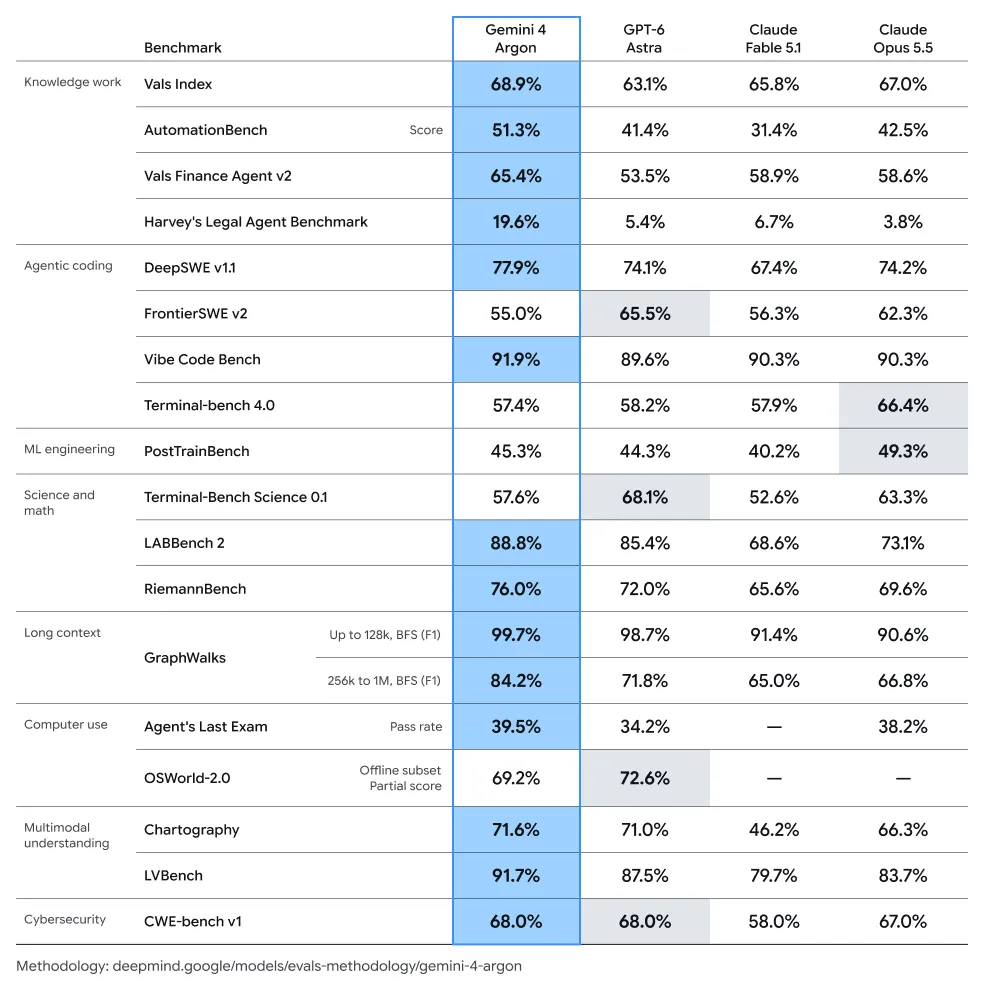
Cette annonce s’accompagne comme toujours d’une série de benchmarks maison, dans lesquels Gemini 4 Argon dépasse généralement GPT-6 Astra et Claude Fable 5.1 et Opus 5.5. Google affirme que son nouveau modèle est particulièrement bon « pour les tâches de codage spécialisées ». On attendra de voir pour les tâches courantes sur le code, car Gemini 3.8 n’était pas bon dans notre test sur l’extension Next.
Google revendique la couronne sur DeepSWE v1.1 et CWE-bench v1
Google en remet une couche : « Les ingénieurs de Google utilisent Argon au quotidien, du débogage courant aux migrations de code à grande échelle et à la conception d’algorithmes. Il établit une nouvelle référence sur DeepSWE v1.1 (77,9 %), qui mesure la performance d’un modèle dans des tâches d’ingénierie logicielle concrètes et à long terme ». GPT-6 Astra est à 74,3 %, Claude Opus 5.5 à 74,2 % et Fable 5.1 à 67,4 %.
Autre exemple : « les agents Argon travaillent à la migration des bases de code C/C++ vers Rust chez Google, allant de quelques dizaines de milliers de lignes pour les bibliothèques essentielles comme re2 et libgav1 à plus de 800 000 lignes pour le noyau Zircon de Fuchsia OS ».
Sujet sensible, ce n’est pas l’ingénieur Galen Hunt de Microsoft qui dira le contraire. Il s’était pris une volée de bois vert quand il avait annoncé vouloir « éliminer toutes les lignes de C et C++ de Microsoft d’ici 2030 », grâce à l’IA. Depuis, il y a eu rétropédalage en règle.
Autre axe largement mis en avant par Google : la cybersécurité. « Pour mieux préparer les équipes de cyberdéfense à la nouvelle ère des cyberattaques, nous avons entraîné Gemini 4 Argon à exceller en matière de défense contre les cybermenaces. Argon est capable de détecter, valider et corriger de manière autonome les vulnérabilités logicielles critiques ».
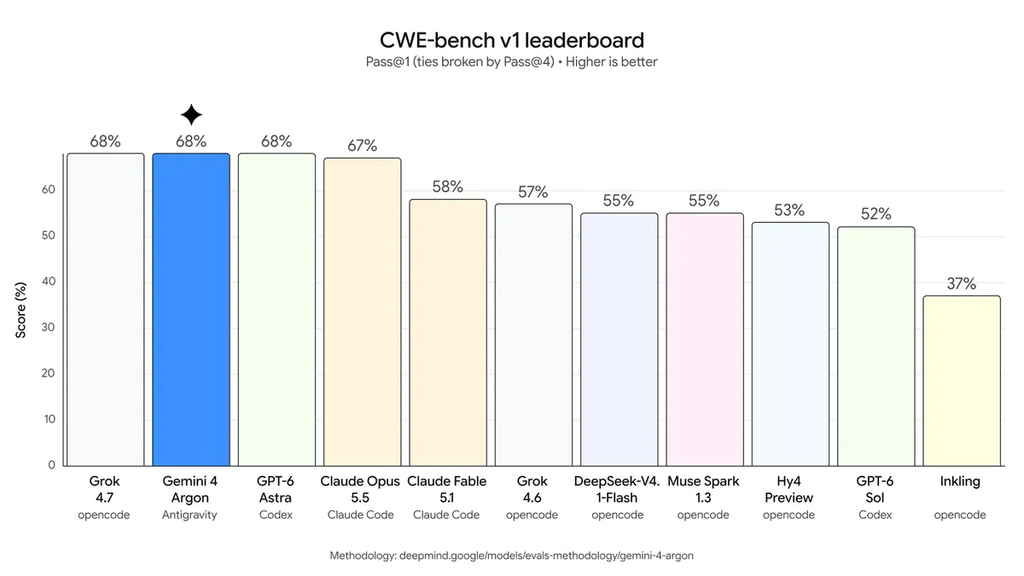
Pour mettre des chiffres sur ces mots, Google annonce un score CWE-bench v1 de 68 %, à égalité avec Grok 4.7 et GPT-6 Astra.
Google fait également une annonce surprenante vu l’actualité autour des agents IA qui font un peu n’importe quoi : « Pour nos équipes de confiance et nos équipes internes chez Google, nous déploierons Argon sans aucune restriction de sécurité afin qu’elles puissent exploiter pleinement ses capacités de pointe en matière de cybersécurité ».
La version anglaise du communiqué de Google est cependant moins forte : « Pour nos partenaires de confiance et nos équipes internes chez Google, nous déploierons Argon sans garde-fous cyber [cyber guardrails en VO, ndlr] afin qu’ils puissent exploiter pleinement ses capacités de pointe en cybersécurité ».
Sans restriction, mais pas sans protection. Pour le grand public, en revanche, des garde-fous sont prévus : « Afin d’empêcher toute utilisation malveillante d’Argon à des fins de cyberattaques ou d’attaques chimiques, biologiques, radiologiques et nucléaires (CBRN), le modèle est conçu pour refuser les requêtes malveillantes tout en préservant la recherche scientifique légitime à double usage, conformément à notre cadre de sécurité Frontier ». Pour Google, comme les autres, le message est simple : ne vous inquiétez pas, on s’occupe de tout. Pas facile vu l’actualité récente.
Pour terminer, le prix : Gemini 4 Argon est à 2 dollars en entrée et 10 dollars en sortie, par million de tokens dans les deux cas (le cache en entrée a une réduction de 95 % du prix). C’est un prix promotionnel, il sera par la suite doublé avec 4 et 20 dollars respectivement. Google n’a pas précisé quand cette promotion se terminera.
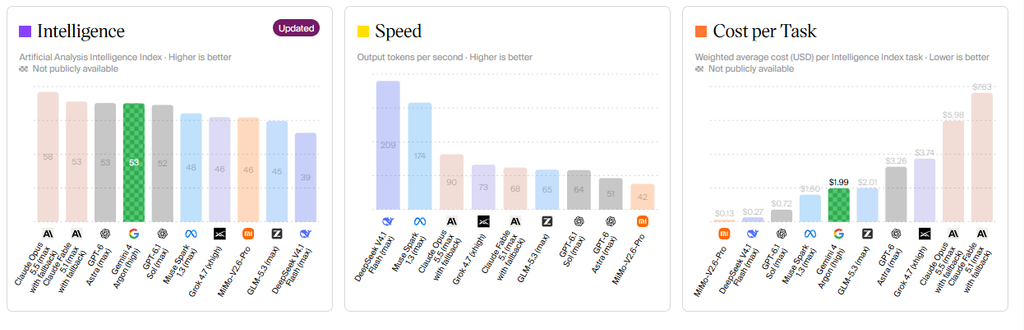
Fable 5.1 et GPT-6 Astra sont tous les deux à 10 et 50 dollars par million de tokens, respectivement en entrée et en sortie. Gemini 4 Argon est-il donc cinq fois moins cher ? Non, car nous n’avons ici qu’une moitié de l’équation. L’autre partie, c’est la consommation de tokens. Facturer deux fois moins mais produire deux fois plus n’apporterait aucune économie.
Sur ce point, le nouveau modèle ne semble pas tirer son épingle du jeu, selon Artificial Analysis, spécialisé dans les benchmarks d’IA : « Gemini 4 Argon fait en moyenne 62 000 jetons de sortie par tâche, contre 27 000 pour GPT-6 Astra (max) ». Pour rappel, OpenAI double le prix de certains modèles – dont GPT-6 Astra – quand l’entrée dépasse les 272 000 tokens.
Gemini 4 Argon, prix par tâche, tarif promotionnel à 2/10 dollars
À défaut de bouger en France, les lignes entre droit d’auteur et intelligence artificielle générative pourraient-elles se déplacer à l’échelle européenne ? Bruxelles vient de donner un signe allant dans le sens d’une possible évolution du cadre réglementaire. La Commission européenne a en effet lancé, mardi 29 septembre, une consultation visant à recueillir des « commentaires sur les défis et les perspectives d’avenir concernant l’impact des technologies sur le droit d’auteur ».
Bien que le droit communautaire protège déjà le droit d’auteur (notamment via la directive de 2019 sur le droit d’auteur dans le marché unique numérique), Bruxelles estime que « les nouveaux défis et l’évolution du marché soulèvent la question de savoir si ce cadre devrait être renforcé par d’éventuelles mesures supplémentaires ».
Entre autres sujets d’étude, la consultation se concentre notamment sur « l’utilisation de contenus protégés par le droit d’auteur en intelligence artificielle ».
Illustration Flock
À ce sujet, la Commission indique, dans l’avant-propos du questionnaire dédié, vouloir étudier « des moyens de faciliter l’octroi de licences et l’application du droit d’auteur et des droits connexes dans le contexte de l’IA et d’améliorer les conditions de rémunération des créateurs, tout en permettant aux fournisseurs de modèles et de systèmes d’IA, y compris les start-up, d’accéder légalement au contenu protégé par le droit d’auteur et de l’utiliser pour l’innovation en matière d’intelligence artificielle ».
La consultation ne se limite cependant pas à l’IA. Elle interroge aussi la « lutte contre le piratage en ligne de contenus tels que les événements en direct », « l’application du droit à une rémunération équitable unique pour les artistes-interprètes et les producteurs de musique » et « le droit d’auteur sur la recherche scientifique ».
Ouverte jusqu’au 3 novembre prochain, cette démarche qui vise donc à explorer des solutions s’adresse notamment aux titulaires de droits d’auteur et droits voisins, aux acteurs de l’IA générative, aux organismes de gestion collective, mais aussi aux organismes de recherche, aux associations de consommateurs et aux autorités nationales ou organisations non gouvernementales.
Bruxelles avait déjà procédé à une phase de cadrage (call for evidence) entre le 18 mai et le 25 juin 2026. À l’époque, l’exécutif européen évoquait explicitement la possibilité de faire évoluer la directive de 2019.

 Connexion