❌

Vue lecture

Situation critique pour la recherche, le budget de l’ANR « insoutenable » d’ici 2028

Une ambition affichée qui fait pshitt
Situation critique pour la recherche, le budget de l’ANR « insoutenable » d’ici 2028

L’Agence nationale de la recherche, pilier de la politique de financement scientifique de la France sous la présidence d’Emmanuel Macron, « se situe à un point critique », selon la Cour des comptes. Son budget décroche depuis la loi de programmation de la recherche votée en 2020. L’institution prévoit qu’il devienne « insoutenable » entre 2028 et 2029 sans mesure corrective.

Le rôle de l’Agence nationale de la recherche (ANR), qui a maintenant 20 ans, a été boosté par la loi de programmation de la recherche (LPR) en 2020. Mais la Cour des comptes constate que son budget ne suit pas les prévisions. La juridiction administrative constate que « son budget sera insoutenable d’ici la fin de l’année 2028 » si rien n’est fait. Le projet de loi 2027 présenté par le gouvernement ne va pas dans ce sens puisqu’il prévoit même une petite baisse du budget de l’ANR.

La loi de 2020 avait notamment été soutenue par le PDG du CNRS de l’époque, Antoine Petit, qui voulait une loi « ambitieuse, inégalitaire – oui, inégalitaire, une loi vertueuse et darwinienne ». De son côté, le Comité national de la recherche scientifique (CoNRS), lui, préconisait le financement récurrent des laboratoires. En consacrant le financement par projets via l’ANR, cette loi a poussé la recherche française vers une sélection des « meilleurs » projets digne du spencérisme (autre nom du « darwinisme social »). Mais l’ambition demandée par l’ancien PDG et affichée dans la loi n’est finalement pas au rendez-vous.

« Une trajectoire budgétaire devenue insoutenable »

C’est dans un rapport publié sur son site le 8 octobre dernier que la Cour des comptes tire le signal d’alarme. Titré « L’ANR, une trajectoire budgétaire devenue insoutenable, une réponse indispensable de l’État », ce document met le gouvernement devant un constat implacable. Alors que le budget de l’ANR devait être l’outil financier central d’une augmentation du financement de la recherche de la loi votée en 2020, sa trajectoire « décroche » par rapport à celle prévue par cette loi. Et ce depuis deux ans : « la croissance des engagements de l’ANR portée depuis 2021 par la LPR a connu un arrêt à partir de 2024 », constate la Cour.


Il reste 74% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

Arrêt d’une offre gratuite MS 365 pour associations : Watertrek a perdu 600 Go de données

Oups !
Arrêt d’une offre gratuite MS 365 pour associations : Watertrek a perdu 600 Go de données

Microsoft a arrêté brutalement l’accès à 365 Business Premium et Office 365 E1 qu’elle proposait gratuitement aux organismes sans but lucratif. L’association française Watertrek a mis en demeure l’entreprise : elle a perdu 600 Go de données qui y étaient stockées alors que sa licence courait jusqu’au 18 octobre 2029.

En mai 2025, Microsoft a annoncé l’arrêt de son offre « philanthropique » permettant à des organismes sans but lucratif l’accès gratuit aux offres MS 365 Business Premium et Office 365 E1 sans préciser, au moins dans son premier message, les modalités et dates relatives à cette décision. Comme d’autres organismes, début juin 2026, l’association française Watertrek a perdu suite à cette interruption plusieurs centaines de gigaoctets de données. Après avoir mis en demeure la filiale française de la multinationale au mois d’août, elle n’a toujours pas récupéré ses données.

Comme nous l’expliquions déjà au mois d’août, Microsoft avait affirmé mettre fin à cette offre « afin de rationaliser [son] offre d’aides et de simplifier [son] portefeuille d’aides ». Elle en profitait pour pousser ces organisations à passer à d’autres offres, notamment MS 365 Business Basic pour laquelle elle promettait d’offrir 300 licences. Mais la communication de l’entreprise a laissé des associations dans le flou. Et des données ont même été supprimées alors que l’abonnement a bien été renouvelé.

L’association française Watertrek, qui « œuvre à la protection de l’eau et des écosystèmes aquatiques », affirme à Next être dans ce cas, avec plus de 600 Go de données perdues dans la manœuvre.

Une perte brutale des données alors que la licence n’est pas arrivée à expiration

En juin dernier, l’association a brutalement perdu accès à son environnement Microsoft 365 suite à la décision de l’entreprise d’arrêter son offre. Si elle avait annoncé publiquement que cette offre s’arrêtait, Microsoft n’a pas prévu la gestion des licences encore actives.


Il reste 74% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

☕️ Xandr : amende de 8,6 millions d’euros en Norvège pour avoir utilisé des données de Grindr


La Datatilsynet (l’équivalent de la CNIL en Norvège) vient d’infliger une amende de 8,6 millions d’euros (92 millions de couronnes norvégiennes) pour avoir « traité et partagé » des données personnelles venant de comptes utilisateurs de Grindr.

L’autorité norvégienne avait déjà sanctionné Grindr sur le sujet avec une amende de 5,8 millions d’euros qu’elle avait confirmée en octobre 2023.

Grindr
CC BY 2.0 DEED Ivan Radic

Ici, elle sanctionne l’intermédiaire publicitaire racheté en 2022 par Microsoft pour la violation du traitement des données sans s’appuyer sur une base légale prévue par le RGPD, dont des données « à caractère personnel relevant d’une catégorie particulière concernant l’orientation sexuelle sans bénéficier d’une dérogation valable », comme elle l’explique dans sa décision [PDF].

Elle lui reproche aussi d’avoir partagé ces données avec d’autres clients. Xandr a argué qu’elle interdit, par contrat, à ses clients de lui partager ce genre de données. Ainsi, pour la filiale de Microsoft, c’est bien son client qui est le seul responsable. Mais « l’Autorité norvégienne de protection des données ne considère pas qu’il soit acceptable que les parties concernées se renvoient simplement la responsabilité les unes aux autres », explique-t-elle dans son communiqué.

Elle « considère comme une circonstance aggravante le fait que Xandr ait tiré des avantages financiers de ces infractions, dans la mesure où la collecte et le partage de données à caractère personnel auraient permis à Xandr de faciliter des transactions publicitaires et, partant, de réaliser des bénéfices », ajoute sa décision.

L’autorité norvégienne a estimé son amende sur le nombre d’utilisateurs norvégiens touchés.

« Nous nous réjouissons vivement de cette décision. Les entreprises spécialisées dans les technologies publicitaires en ligne, telles que Xandr, opèrent souvent en coulisses et sont rarement tenues de rendre des comptes sur leurs pratiques. Cela crée un précédent précieux pour des affaires similaires », a commenté Felix Mikolasch, l’un des avocats de l’association noyb qui avait participé aux plaintes concernant ce dossier déposées contre Grindr et plusieurs autres entreprises du numérique.

  •  

3 datacenters de Yandex attaqués par des drones ukrainiens : le géant russe accuse le coup

Le numérique a bel et bien besoin d'une infrastructure physique
3 datacenters de Yandex attaqués par des drones ukrainiens : le géant russe accuse le coup

Depuis jeudi 8 octobre, Yandex a subi trois attaques de drones ukrainiens contre des datacenters situés sur le territoire russe. L’entreprise, souvent présentée comme le « Google russe », a annoncé que ses services de moteur de recherche, de cartographie mais aussi de paiement en ligne étaient en panne. Plus insidieusement, la question se pose d’un impact sur le réseau d’influence numérique de la Russie.

Dans la guerre de défense de leur territoire contre la Russie, les Ukrainiens ont trouvé une nouvelle cible pour toucher leur ennemi : les datacenters de Yandex. Jeudi 8 octobre, vendredi 9 octobre et dimanche 11 octobre, des drones ukrainiens ont attaqué des datacenters du géant du numérique russe et ont réussi à faire des dégâts, forçant Yandex à annoncer la suspension de l’activité de plusieurs de ses services phares.

Une bonne partie des services de Yandex sont hors service

Selon Reuters, l’entreprise a affirmé que personne n’avait été blessé lors de la dernière attaque sur le data center situé à Vladimir, une ville située à 180 km à l’est de Moscou. Mais cette infrastructure hébergeait notamment certains services de Yandex Pay, l’outil de paiement en ligne de l’entreprise russe lancé en 2021. Dans un message sur Telegram, l’entreprise affirmait à ses utilisateurs dimanche soir que les données concernant leur argent étaient en sécurité, le datacenter touché ne gérant « que » le fonctionnement des services.

Quelques heures avant, Yandex annonçait tout juste que certains de ses services revenaient progressivement à la normale. En effet, d’autres datacenters de l’entreprise russe avaient déjà été touchés par des attaques de drones les jeudi 8 et vendredi 9 octobre dernier. Ceux-ci hébergeaient notamment l’IA de Yandex nommée « Alice », son moteur de recherche, l’outil de cartographie de l’entreprise ainsi que celui d’appels de taxi. Elle s’était d’ailleurs excusée du fait que son service client était aussi touché.

Yandex avait expliqué que son centre de données situé à Sasovo avait été touché dans la nuit du mercredi 7 au jeudi 8 octobre. Puis, le 9 octobre, c’est celui situé à Kalouga qui a été ciblé. L’entreprise affirmait, là aussi, qu’aucun personnel n’avait été blessé.

En attaquant les services de Yandex, les drones ukrainiens ont déstabilisé de façon importante l’infrastructure numérique russe. Même si l’entreprise n’est pas un monopole dans le pays, elle n’a pas à rougir en interne de la comparaison avec Google. Sur le service d’indication des pannes de Yandex, on peut constater qu’un bon nombre de services de Yandex Cloud ne sont plus disponibles depuis le 8 octobre. C’est le cas, par exemple, de ses outils de gestion pour Kubernetes, MySQL, PostgreSQL, ClickHouse, l’API de YandexGPT, son service SpeechKit ou encore de son outil de reconnaissance de caractères « vision OCR ».

Le trafic des crawlers russes non affecté

Rapidement, certains internautes se sont posé la question de la répercussion de ces défaillances chez Yandex sur les outils automatisés russes, que ce soit les bots de propagande sur les réseaux sociaux ou les bots de crawlers. Il est difficile, pour l’instant, de connaître exactement les conséquences sur le dispositif de propagande.

Concernant le trafic des bots en général (crawlers, scan d’adresses IP, etc.), Cloudflare a constaté pendant la nuit du 7 au 8 octobre une baisse de 33 % du trafic des bots provenant de Yandex. Sur le radar de Cloudflare, on peut voir que cette activité s’est complètement arrêtée dimanche 11 octobre pour reprendre de manière très dégradée depuis.

Cependant, selon le même outil de CloudFlare, cela n’aurait pas affecté le trafic total des bots russes :

On peut donc imaginer que les différentes organisations utilisant les services de Yandex pour leurs crawlers ont tout simplement migré vers un autre fournisseur.

  •  

OpenAI inonde la recherche avec 722 « prépublications » de mathématiques générées par IA

Démerdez-vous avec ça
OpenAI inonde la recherche avec 722 « prépublications » de mathématiques générées par IA

Tout à son idée de montrer la puissance de ses outils, OpenAI a mis en ligne 722 prépublications de mathématiques générées par IA. L’entreprise met en ligne des « résultats » se trouvant pourtant à « différents stades de vérification », en s’appuyant sur l’avis d’un groupe de chercheurs pour « mettre en place les meilleures pratiques » concernant leur partage. L’un de ses membres, le mathématicien François Charles, explique à Next que ce groupe veut être « un canal de communication » entre les entreprises et la communauté.

OpenAI a publié la nuit dernière 772 documents PDF de mathématiques dans un dépôt GitHub. Alors que l’entreprise affichait récemment une volonté de dialogue avec les mathématiciens, elle intensifie la mise en ligne d’articles qu’elle appelle « prépublications » (preprints, en anglais). Elle affirme s’appuyer sur le travail d’un groupe de chercheurs indépendants qui a publié des recommandations concernant l’ « utilisation responsable des résultats mathématiques générés par l’IA ».

Alors que des milliers de mathématiciens déploraient récemment que l’IA menace la pratique scientifique et qu’OpenAI a été accusée de mauvaises pratiques scientifiques pour résoudre un problème de maths, l’entreprise présente sur son dépôt GitHub ces fichiers comme des « des manuscrits mathématiques et des éléments justificatifs de démonstration générés par un modèle interne d’OpenAI ». Mais ceux-ci n’ont que l’apparence d’articles de mathématiques travaillés par des chercheurs : aucune signature de chercheurs n’apparait sous leur titre, ils ne sont signés que par le nom de l’entreprise dirigée par Sam Altman.

« Des résultats se trouvant à différents stades de vérification »

Dans son fichier Readme, OpenAI explique que le dépôt « regroupe des résultats se trouvant à différents stades de vérification. Tous ne sont pas accompagnés de formalisations Lean [langage d’assistant de preuve, ndlr]. Nous continuerons à mettre à jour ce référentiel avec des formalisations Lean au fur et à mesure que nous les obtiendrons ».

Ainsi, si l’entreprise regroupe tous ces PDF dans un dossier intitulé « preprints », ils ne sont pas du tout prêts à la publication comme sont censés l’être les articles désignés comme tels et mis en ligne sur les serveurs comme arXiv. Même si ces serveurs autorisent les chercheurs à modifier avec un système de gestion de versions, le terme de « prépublications » implique que les chercheurs assument que ces articles pourraient être présentés dans une revue scientifique.


Il reste 67% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

AI Slop : Google met en pause son programme de bug bounty pour le logiciel libre


AI Slop : Google met en pause son programme de bug bounty pour le logiciel libre

Google a suspendu son programme de bug bounty Open Source Software Vulnerability Rewards Program (OSS VRP). L’entreprise explique qu’elle reçoit trop de rapports erronés générés par IA.

Depuis le 1er octobre dernier, Google n’accepte « plus les signalements de vulnérabilités de produits soumis au programme OSS VRP [Open Source Software Vulnerability Rewards Program] », a-t-elle expliqué sur la page dédiée à ce programme.

L’entreprise avait ouvert ce programme spécifique aux logiciels libres en 2022. Elle expliquait à l’époque qu’ « en fonction de la gravité de la faille de sécurité et de l’importance du projet, les récompenses varieront entre 100 et 31 337 dollars ». L’idée était notamment de faire émerger les vulnérabilités de la supply chain, mais aussi les problèmes de design informatique causant des problèmes de sécurité, par exemple.

« Une forte augmentation des soumissions automatisées »

Mais le système mis en place par Google pour recueillir ces signalements (qui peuvent donc être lucratifs pour leurs auteurs) montre des signes de fragilité face à l’affluence des signalements de plus en plus automatisés via l’IA générative. Comme Apple cet été, Google ferme le robinet.

L’entreprise le dit dans un message posté sur X : « Cette interruption est due à une forte augmentation des soumissions automatisées, dont la grande majorité n’est pas valide. Nous allons poursuivre le remaniement et le travail sur cet aspect du programme OSS VRP et nous nous engageons à faire le point au premier trimestre 2027 ».

Tous les programmes de bug bounty de Google ne sont pas touchés : uniquement l’OSS VRP. L’entreprise redirige donc les personnes qui voudraient signaler une faille notamment vers son programme Patch Rewards.

Ces entreprises, qui par ailleurs font la course aux modèles d’IA générative, n’ont pas trouvé la solution pour éviter la submersion de contenus générés par IA de qualité médiocre qui les empêche de traiter convenablement les signalements réellement utiles.

« Impact psychologique considérable »

Mais ce problème touche d’autres organisations. Ainsi, en janvier dernier, le créateur du fameux logiciel libre cURL, Daniel Stenberg, avait annoncé : « Le programme de bug bounty de cURL n’existe plus. Il prendra officiellement fin le 31 janvier 2026 ». « La gestion de ces soumissions incessantes de contenus de mauvaise qualité a un impact psychologique considérable et prend parfois beaucoup de temps à démystifier. C’est du temps et de l’énergie complètement gaspillés, qui sapent en outre notre envie de vivre », expliquait-il.

Du côté de la communauté du noyau Linux, le sujet est vu différemment. Si Linus Torvalds avait pesté un moment contre les nombreux rapports d’erreurs générés par les LLM et peu efficaces, cet été il avait changé d’avis sur le sujet et refusait de rejeter en bloc les rapports d’erreurs générés de la sorte, se disant prêt à peser de tout son poids de mainteneur principal du noyau si nécessaire. Il faut préciser qu’on ne parle pas ici de signalements faisant appel à rétribution. Le système des bug bounty attribuant une récompense aux signalements, avec une somme plus importante en fonction de l’importance du bug pousse sans doute davantage certains à utiliser des systèmes automatisés de signalements de bugs, sans se préoccuper de leur qualité et de la possible submersion du système.

  •  

☕️ La Norvège va interdire temporairement les lunettes connectées dans certains lieux publics


Le gouvernement norvégien avait déjà annoncé qu’il voulait durcir la législation du pays concernant l’utilisation des lunettes connectées alors que la grogne s’amplifie contre les lunettes Meta un peu partout. Il explique maintenant que ce durcissement devrait passer par une « interdiction temporaire » de ces lunettes dans certains lieux publics.

« Le temps de mener une étude approfondie et d’avoir un débat éclairé qui pourra jeter les bases d’une réglementation durable », précise le ministre de la Numérisation et de la Gouvernance publique, Torgeir Micaelsen, qui semble reprendre le dossier des mains de la ministre chargée du numérique, Karianne Tung. Celle-ci avait montré des signes de réticence à toute nouvelle législation sur le sujet au début de l’été.

Sans qu’un texte de loi ne soit encore rédigé, le communiqué évoque comme potentiels lieux interdits à ces lunettes les parcs, les plages, les musées, les aires de jeux, les parcs d’attractions, ainsi que les manifestations sportives, musicales et culturelles. Les lieux de scolarisation de la maternelle au lycée, voire aux établissements d’enseignement supérieur devraient figurer dans la liste aussi.

L’interdiction de ces lunettes connectées ne serait pas totale en Norvège. Le gouvernement évoque, comme l’explique Reuters, la possibilité de les utiliser dans des lieux purement privés et certains endroits où l’utilisation ne présente aucun risque d’être filmé sans son consentement.

  •  

Non, Anthropic n’a pas découvert un système biologique comparable à CRISPR

Une hypothèse crédible n'est pas une découverte
Non, Anthropic n’a pas découvert un système biologique comparable à CRISPR

Il y a un peu plus d’une semaine, Anthropic annonçait que Claude avait découvert un nouveau système enzymatique, « dont la structure rappelle celle du système CRISPR ». Mais « tout le travail reste à faire », nous explique Alexis Verger, biologiste au CNRS.

En parallèle des maths, les entreprises d’IA générative utilisent maintenant la recherche en biologie pour assurer la promotion de leurs outils alors qu’elles préparent leurs entrées en bourse, quitte à crier à une découverte qui n’en est encore qu’à l’étape d’hypothèse.

Ainsi, Anthropic a annoncé le 23 septembre 2026 que son IA Claude a « découvert un nouveau système enzymatique » que l’entreprise compare à CRISPR. La découverte de cette méthode d’édition du génome en 2012 avait permis à Emmanuelle Charpentier et Jennifer Doudna d’obtenir le prix Nobel de chimie en 2020.

Mais Anthropic est encore loin d’avoir prouvé la découverte d’un système comparable à CRISPR en n’ayant pas vérifié son hypothèse. « Tout le travail [en laboratoire de paillasse] reste à faire », nous explique Alexis Verger, biologiste au CNRS.

Anthropic a mis en ligne, au moment de l’annonce, un billet de blog et un « rapport technique » [PDF] rédigé par une équipe de chercheurs récemment embauchés par l’entreprise. Ce document n’a pas été publié dans une revue scientifique ni mis en ligne sur un serveur de prépublication habituellement utilisé par des chercheurs de la discipline.

Une campagne d’agents IA pour mettre en place une hypothèse crédible


Il reste 80% de l'article à découvrir.
Vous devez être abonné•e pour lire la suite de cet article.
Déjà abonné•e ? Générez une clé RSS dans votre profil.

  •  

arXiv limite les soumissions à 2 par mois pour faire face à la submersion due à la genAI

Buffer overflow
arXiv limite les soumissions à 2 par mois pour faire face à la submersion due à la genAI

Submergée par les propositions d’articles générés par IA, la plus ancienne et populaire des plateformes de prépublication scientifique resserre encore ses restrictions de soumissions.

La soumission incessante d’articles générés par IA commence à épuiser les équipes de plateformes de prépublications scientifiques. On l’a vu très récemment avec le cas du chercheur Nicholas Polson qui a mis en ligne plus de 200 prépublications depuis le début de l’année, essentiellement sur la plateforme SSRN de la multinationale Elsevier.

Mais la plus ancienne et populaire de ces plateformes n’est pas épargnée, au contraire. En octobre 2025, elle prenait la décision de ne plus accepter aucune prépublication d’articles de synthèse ou d’argumentaires sur l’IA. Dans ce champ disciplinaire, seuls les articles sur une nouveauté scientifique sont acceptés depuis.

En mai dernier, elle avait annoncé la mise en œuvre d’une sanction spécifique concernant l’utilisation de l’IA : une suspension d’un an pour celles et ceux qui soumettent des articles générés par IA qui n’ont manifestement pas été vérifiés. Après cette suspension, arXiv n’accepte de nouveau des articles signés par l’auteur confondu que s’ils ont été acceptés par des revues ou des conférences (ce qui enlève beaucoup d’intérêt à soumettre sur la plateforme).

Les soumissions d’articles à arXiv continuent de grimper

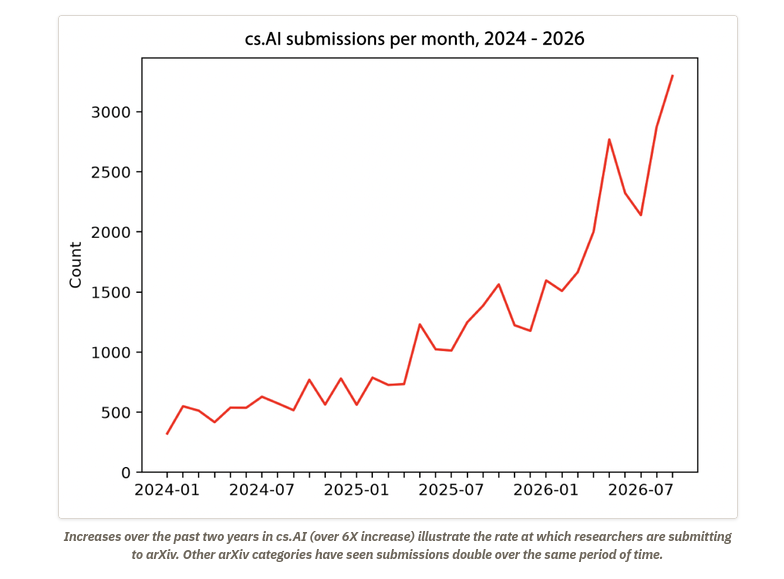
Mais ces mesures ne semblent pas avoir suffi. Rien que pour le domaine de l’IA, les soumissions continuent à monter en flèche :

Et arXiv précise que pour les autres domaines, les soumissions ont doublé depuis janvier 2024.

Pour la plateforme, limiter les soumissions par utilisateur s’impose de plus en plus. « Avant l’avènement de l’IA, il existait une limite pratique clairement identifiable quant au rythme auquel des soumissions indépendantes pouvaient être produites, et les modérateurs bénévoles d’arXiv limitaient le nombre de soumissions des auteurs qui dépassaient largement ce seuil », explique-t-elle dans un billet de blog.

Mais maintenant, « les outils d’IA devenant de plus en plus sophistiqués et accessibles aux auteurs, la « limite pratique » du nombre d’articles pouvant être soumis fait désormais l’objet d’un débat », ajoute-t-elle.

La limite des bénévoles est atteinte

Surtout que la plateforme s’appuie sur des bénévoles. « Une proportion relativement faible d’auteurs soumet un grand nombre d’articles de mauvaise qualité et accapare une part disproportionnée du temps des modérateurs », souligne le président du Conseil consultatif éditorial d’arXiv, Thomas Dietterich. « Cette situation est injuste pour les auteurs qui continuent à soumettre des articles de qualité : leurs articles peuvent en effet subir des retards de plusieurs jours, voire de plusieurs semaines », constate-t-il.

Deux soumissions par mois, une limite raisonnable

L’équipe a choisi de mettre en œuvre une limite de deux soumissions par mois (calendaire) par auteur ainsi qu’une limite de trois soumissions en attente de vérification. Cette limite s’applique de toute façon, même si les articles soumis avant ont été rejetés. Elle rappelle aussi que « les articles soumis à arXiv doivent présenter des travaux de recherche originaux, novateurs et significatifs, constitués en un tout cohérent et s’inscrivant dans les catégories d’arXiv ».

En décidant cette limite drastique du nombre de soumissions par auteur, arXiv semble avoir trouvé le bon moyen de limiter la submersion. En effet, il n’est pas simple de créer un compte sur la plateforme et un auteur qui aurait envie de soumettre plus d’articles ne peut pas éviter la restriction via un nouveau compte. Ainsi, libre à chacun de choisir les deux articles maximum qu’il veut mettre en ligne sur arXiv pendant un mois, ce qui est déjà une limite très importante comparée au taux moyen de publication des chercheurs dans des revues scientifiques.

  •  

Deepfakes sexuels : Cloudflare, Google et Namecheap accusés de ne pas agir suffisamment

À grand pouvoir, grandes responsabilités
Deepfakes sexuels : Cloudflare, Google et Namecheap accusés de ne pas agir suffisamment

Depuis quelques années, la création et diffusion de deepfakes pornographiques ont explosé sur Internet. Trois chercheurs pointent la responsabilité des fournisseurs de services comme Cloudflare, Namecheap et Google dans la diffusion de ces images violentes qui poussent souvent les victimes-survivantes dans une rupture sociale.

En mai 2025, MrDeepfakes, l’un des sites les plus courus pour produire ce type de contenu, a fermé en annonçant qu’« un prestataire de services essentiel a mis fin définitivement à ses prestations. La perte de données a rendu impossible la poursuite de l’activité ». Les chercheuses et chercheurs Sarah Morgan, Sophie J. Nightingale et Hany Farid pointent, dans une étude, la responsabilité des fournisseurs de services : « une poignée des plus grandes entreprises Internet mondiales fournissent l’infrastructure de base (hébergement web, réseau de diffusion de contenu, etc.) » des sites de deepfakes, montrent-ils en citant notamment Cloudflare, Namecheap et Google.

Même si SpaceXAI est allègrement l’une des entreprises qui a généré et hébergé le plus de contenus de deepfakes à caractères sexistes et sexuels ces derniers temps, d’autres sites ont prospéré sur ce phénomène violent.

Cloudflare, Google et d’autres géants du numérique supportent les infrastructures de ces sites

Comme l’expliquent les trois chercheurs dans leur article publié dans la revue Journal of Online Trust and Safety, la détection des deepfakes a progressé de 500 000 images en 2023 à 8 millions en 2025. Ces chiffres sont des estimations des deepfakes en général, mais une étude montre que la plupart sont générées pour cibler les femmes dans l’intention de produire des images sexualisantes sans consentement.

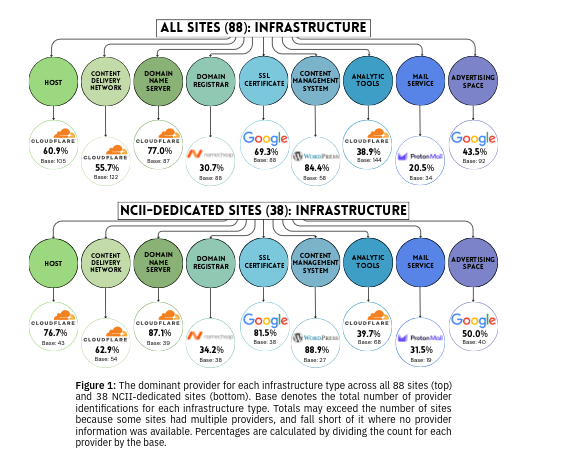
Dans leur étude, ils se sont intéressés « au rôle que joue l’infrastructure technologique générale — souvent invisible — dans la création et la diffusion » de ces deepfakes en analysant pendant un mois et demi 88 sites hébergeant des deepfakes de célébrités trouvés via des recherches par mots-clés et par des alertes Google, dont 38 uniquement dédiés aux deepfakes à caractères sexistes et sexuels.

En analysant ces sites, ils se sont rendu compte que la plupart (80) étaient des sites de vidéos pour adultes, cinq étaient des forums pour adultes. Enfin, pour les trois autres, l’un était un forum généraliste avec un fil de discussion spécifique sur le sujet, un autre était « une plateforme de créateurs accessible par abonnement contenant du contenu pour adultes » et le dernier était un site de partage de fichiers basé sur le cloud.

Concernant les fournisseurs de services de ces sites, « cinq acteurs se sont imposés comme des fournisseurs d’infrastructure dominants : Cloudflare, Google, Namecheap, WordPress et Protonmail », écrivent-ils.

Ainsi « Cloudflare a fourni la majeure partie des services, se classant en tête dans quatre des neuf composantes d’infrastructure : l’hébergement de sites web (64/105), le CDN (68/122), le DNS (67/87) et les outils d’analyse (56/144). Google occupait une position dominante dans la fourniture de certificats SSL (61/88) et d’espaces publicitaires (40/92). Namecheap, WordPress et ProtonMail étaient les principaux fournisseurs de services d’enregistrement de noms de domaine (27/88), de systèmes de gestion de contenu (49/58) et de services de messagerie (7/34) », expliquent-ils. Le constat était peu ou prou le même concernant la sous-partie des sites dédiés uniquement à ce genre de contenu.

Des chiffres impressionnants, mais qu’il convient de remettre en perspective : Cloudflare et Google sont omniprésents sur Internet, sur de nombreuses couches du réseau, notamment l’hébergement, le CDN, le DNS… Namecheap est connu pour pratiquer des tarifs peu chers par rapport à la concurrence, et attire donc facilement les personnes peu scrupuleuses souhaitant prendre un nom de domaine. WordPress est librement téléchargeable, il est impossible de bloquer la création de site avec ce CMS.

« Pas à un simple problème de création ou de modération »

« La prolifération de ces deepfakes à caractères sexistes et sexuels ne se résume pas à un simple problème de création ou de modération de contenu pour les producteurs et les plateformes d’hébergement ; il s’agit également d’un problème d’infrastructure engendré par les services — souvent cachés — qui permettent la création et la diffusion », concluent-ils.

Allant à rebrousse-poil de la neutralité des infrastructures, ces chercheurs estiment « que tous les fournisseurs d’infrastructures devraient bloquer de manière permanente les sites qui hébergent exclusivement ou principalement du contenu relevant [de ce genre de contenu]. Une interdiction permanente ne devrait bien sûr pas être prise à la légère et devrait être réservée aux seuls acteurs les plus répréhensibles ».

Ils s’appuient aussi sur l’exemple de la décision de Cloudflare prise en 2017 de fermer le compte du site néonazi The Daily Stormer pour montrer que ce genre d’infrastructure a la possibilité de mettre en œuvre ce genre de décision. « Nos conditions générales d’utilisation nous réservent le droit de résilier le compte des utilisateurs de notre réseau, à notre entière discrétion », écrivait à l’époque Matthew Prince, le CEO de Cloudflare.

Il a ensuite expliqué à ses équipes regretter cette décision : « Je me suis réveillé de mauvaise humeur et j’ai décidé que quelqu’un ne devrait pas avoir accès à Internet […] Personne ne devrait avoir ce pouvoir », a-t-il expliqué dans une lettre envoyée aux employés.

Depuis, on sent que le sujet est sensible pour Cloudflare, comme en témoigne la position de l’entreprise face à 8chan, après les tueries à El Paso et Dayton aux États-Unis en 2019 : « Nous tolérons à contrecœur les contenus que nous trouvons répréhensibles. Mais nous rejetons les plateformes qui ont démontré qu’elles inspiraient directement des événements tragiques et qu’elles étaient, par nature, sans foi ni loi. 8chan a franchi cette ligne. Il ne leur sera donc plus permis d’utiliser nos services ».

Il y a également eu le cas Kiwi Farms, un forum connu pour organiser des campagnes de harcèlement. Une « décision extraordinaire de notre part », explique Matthew Prince. Il ajoute même que c’est « une décision dangereuse avec laquelle nous ne sommes pas à l’aise ». Elle avait été prise car il y avait « une urgence sans précédent et une menace immédiate pour la vie humaine ».

Bloquer de manière permanente un site ou un compte n’a rien de compliqué, et bien sûr les géants du Net le font. Ce qui est par contre plus compliqué, c’est d’empêcher une personne malintentionnée de recréer un compte, avec une autre adresse.

Comme souvent sur Internet en pareille situation, on retombe sur le jeu du chat et de la souris, version 2.0. La solution pourrait être davantage du côté de la justice qui peut, elle, condamner directement les personnes responsables. Mais les auteurs cachent au maximum leur identité et les différentes juridictions mondiales n’aident pas.

  •  

Deepfakes sexuels : Cloudflare, Google et Namecheap accusés de ne pas agir suffisamment

À grand pouvoir, grandes responsabilités
Deepfakes sexuels : Cloudflare, Google et Namecheap accusés de ne pas agir suffisamment

Depuis quelques années, la création et diffusion de deepfakes pornographiques ont explosé sur Internet. Trois chercheurs pointent la responsabilité des fournisseurs de services comme Cloudflare, Namecheap et Google dans la diffusion de ces images violentes qui poussent souvent les victimes-survivantes dans une rupture sociale.

En mai 2025, MrDeepfakes, l’un des sites les plus courus pour produire ce type de contenu, a fermé en annonçant qu’« un prestataire de services essentiel a mis fin définitivement à ses prestations. La perte de données a rendu impossible la poursuite de l’activité ». Les chercheuses et chercheurs Sarah Morgan, Sophie J. Nightingale et Hany Farid pointent, dans une étude, la responsabilité des fournisseurs de services : « une poignée des plus grandes entreprises Internet mondiales fournissent l’infrastructure de base (hébergement web, réseau de diffusion de contenu, etc.) » des sites de deepfakes, montrent-ils en citant notamment Cloudflare, Namecheap et Google.

Même si SpaceXAI est allègrement l’une des entreprises qui a généré et hébergé le plus de contenus de deepfakes à caractères sexistes et sexuels ces derniers temps, d’autres sites ont prospéré sur ce phénomène violent.

Cloudflare, Google et d’autres géants du numérique supportent les infrastructures de ces sites

Comme l’expliquent les trois chercheurs dans leur article publié dans la revue Journal of Online Trust and Safety, la détection des deepfakes a progressé de 500 000 images en 2023 à 8 millions en 2025. Ces chiffres sont des estimations des deepfakes en général, mais une étude montre que la plupart sont générées pour cibler les femmes dans l’intention de produire des images sexualisantes sans consentement.

Dans leur étude, ils se sont intéressés « au rôle que joue l’infrastructure technologique générale — souvent invisible — dans la création et la diffusion » de ces deepfakes en analysant pendant un mois et demi 88 sites hébergeant des deepfakes de célébrités trouvés via des recherches par mots-clés et par des alertes Google, dont 38 uniquement dédiés aux deepfakes à caractères sexistes et sexuels.

En analysant ces sites, ils se sont rendu compte que la plupart (80) étaient des sites de vidéos pour adultes, cinq étaient des forums pour adultes. Enfin, pour les trois autres, l’un était un forum généraliste avec un fil de discussion spécifique sur le sujet, un autre était « une plateforme de créateurs accessible par abonnement contenant du contenu pour adultes » et le dernier était un site de partage de fichiers basé sur le cloud.

Concernant les fournisseurs de services de ces sites, « cinq acteurs se sont imposés comme des fournisseurs d’infrastructure dominants : Cloudflare, Google, Namecheap, WordPress et Protonmail », écrivent-ils.

Ainsi « Cloudflare a fourni la majeure partie des services, se classant en tête dans quatre des neuf composantes d’infrastructure : l’hébergement de sites web (64/105), le CDN (68/122), le DNS (67/87) et les outils d’analyse (56/144). Google occupait une position dominante dans la fourniture de certificats SSL (61/88) et d’espaces publicitaires (40/92). Namecheap, WordPress et ProtonMail étaient les principaux fournisseurs de services d’enregistrement de noms de domaine (27/88), de systèmes de gestion de contenu (49/58) et de services de messagerie (7/34) », expliquent-ils. Le constat était peu ou prou le même concernant la sous-partie des sites dédiés uniquement à ce genre de contenu.

Des chiffres impressionnants, mais qu’il convient de remettre en perspective : Cloudflare et Google sont omniprésents sur Internet, sur de nombreuses couches du réseau, notamment l’hébergement, le CDN, le DNS… Namecheap est connu pour pratiquer des tarifs peu chers par rapport à la concurrence, et attire donc facilement les personnes peu scrupuleuses souhaitant prendre un nom de domaine. WordPress est librement téléchargeable, il est impossible de bloquer la création de site avec ce CMS.

« Pas à un simple problème de création ou de modération »

« La prolifération de ces deepfakes à caractères sexistes et sexuels ne se résume pas à un simple problème de création ou de modération de contenu pour les producteurs et les plateformes d’hébergement ; il s’agit également d’un problème d’infrastructure engendré par les services — souvent cachés — qui permettent la création et la diffusion », concluent-ils.

Allant à rebrousse-poil de la neutralité des infrastructures, ces chercheurs estiment « que tous les fournisseurs d’infrastructures devraient bloquer de manière permanente les sites qui hébergent exclusivement ou principalement du contenu relevant [de ce genre de contenu]. Une interdiction permanente ne devrait bien sûr pas être prise à la légère et devrait être réservée aux seuls acteurs les plus répréhensibles ».

Ils s’appuient aussi sur l’exemple de la décision de Cloudflare prise en 2017 de fermer le compte du site néonazi The Daily Stormer pour montrer que ce genre d’infrastructure a la possibilité de mettre en œuvre ce genre de décision. « Nos conditions générales d’utilisation nous réservent le droit de résilier le compte des utilisateurs de notre réseau, à notre entière discrétion », écrivait à l’époque Matthew Prince, le CEO de Cloudflare.

Il a ensuite expliqué à ses équipes regretter cette décision : « Je me suis réveillé de mauvaise humeur et j’ai décidé que quelqu’un ne devrait pas avoir accès à Internet […] Personne ne devrait avoir ce pouvoir », a-t-il expliqué dans une lettre envoyée aux employés.

Depuis, on sent que le sujet est sensible pour Cloudflare, comme en témoigne la position de l’entreprise face à 8chan, après les tueries à El Paso et Dayton aux États-Unis en 2019 : « Nous tolérons à contrecœur les contenus que nous trouvons répréhensibles. Mais nous rejetons les plateformes qui ont démontré qu’elles inspiraient directement des événements tragiques et qu’elles étaient, par nature, sans foi ni loi. 8chan a franchi cette ligne. Il ne leur sera donc plus permis d’utiliser nos services ».

Il y a également eu le cas Kiwi Farms, un forum connu pour organiser des campagnes de harcèlement. Une « décision extraordinaire de notre part », explique Matthew Prince. Il ajoute même que c’est « une décision dangereuse avec laquelle nous ne sommes pas à l’aise ». Elle avait été prise car il y avait « une urgence sans précédent et une menace immédiate pour la vie humaine ».

Bloquer de manière permanente un site ou un compte n’a rien de compliqué, et bien sûr les géants du Net le font. Ce qui est par contre plus compliqué, c’est d’empêcher une personne malintentionnée de recréer un compte, avec une autre adresse.

Comme souvent sur Internet en pareille situation, on retombe sur le jeu du chat et de la souris, version 2.0. La solution pourrait être davantage du côté de la justice qui peut, elle, condamner directement les personnes responsables. Mais les auteurs cachent au maximum leur identité et les différentes juridictions mondiales n’aident pas.

  •  

Comment OpenAI et Anthropic se voient en futurs financeurs de la recherche mondiale

Philantropie avec des dollars virtuels
Dépassée par son succès, Anthropic suspend son offre Claude for Startups

Via la création de fondations « philantropiques » et de « financements sur projet », les entreprises d’IA générative et notamment OpenAI se présentent comme les futurs financeurs de la recherche mondiale, alors qu’elles ne font paradoxalement pas de profits.

Les financements publics de la recherche sont particulièrement menacés ces temps-ci, en France mais aussi aux États-Unis et ailleurs. Les entreprises de l’IA générative affichent une volonté de prendre le relai avec de l’argent qu’elles n’ont pour l’instant pas, et ainsi attirer (et choisir) les chercheuses et chercheurs qui ont besoin de financements pour faire tourner leurs laboratoires.

Une « philanthropie » donnant droit à des avantages fiscaux et finançant des entreprises

Les entreprises du numérique et leurs décideurs états-uniens ont souvent affiché une « philanthropie » à travers des fondations comme la Gate Foundation de Bill Gates et Melinda French Gates, dont le budget 2025 atteignait 91 millions de dollars [PDF]. On peut citer aussi la Chan Zuckerberg Initiative de Mark Zuckerberg et Priscilla Chan, critiquée l’année dernière pour avoir abandonné bon nombre de causes qu’elle soutenait. Ces fondations proposent des « financements sur projet » souvent dans le domaine de la recherche et de la santé.

Ce « philanthrocapitalisme » a été notamment étudié par les chercheurs Linsey McGoey, Darren Thiel et Robin West dans un article (publié en 2018) dans lequel elles expliquent que cette nouvelle philanthropie consistait notamment « à distribuer à des entreprises des subventions « philanthropiques » donnant droit à des avantages fiscaux ». Elles y ajoutaient que « les organisations philanthrocapitalistes orientent de plus en plus leurs dons vers des entreprises à but lucratif » et prenaient l’exemple de la Fondation Gates qui « a commencé à octroyer un pourcentage croissant de ses subventions à des entreprises telles que Vodafone, Mastercard et Scholastic (l’un des plus grands éditeurs d’ouvrages éducatifs au monde) sous forme d’aides non remboursables ».

OpenAI et Anthropic suivent la même voie

Les startups de l’IA générative suivent la même voie. Ainsi, la fondation OpenAI, créée en octobre 2025, vient d’annoncer dans la revue scientifique Nature s’être engagée à hauteur de 125 millions de dollars de financements pour des projets concernant la création de données librement accessibles pour la recherche dans les domaines de la santé et des sciences de la vie (mise au point des vaccins contre le cancer, recherche sur la maladie d’Alzheimer, réutilisation de données provenant d’entreprises de biotechnologie en faillite…).

En juillet dernier, Anthropic annonçait des « financements sur projet » pour la recherche scientifique sur les maladies rares. La présidente d’Anthropic, Daniela Amodei, a aussi affirmé récemment à The Economist que la santé mondiale devenait « une priorité pour Anthropic, qui collabore avec des organisations humanitaires à travers l’Afrique afin d’utiliser Claude dans le domaine des soins de santé et pour prévoir les famines ». Rappelons que Donald Trump, sur recommandation d’Elon Musk, a mis fin l’année dernière à l’Agence des États-Unis pour le développement international (USAID) et ainsi coupé les financements publics d’un nombre colossal de projets concernant la santé mondiale.

« Mais les initiatives passées visant à intégrer la technologie dans l’aide humanitaire nous rappellent qu’un accès moins coûteux à l’expertise ne suffit pas », prévient The Economist. « Les outils de santé numériques ont souvent donné de bons résultats lors des essais, mais n’ont pas réussi à s’imposer dans les systèmes de santé locaux », cite en exemple le média, qui ajoute : « les donateurs ont également tendance à percevoir le monde à travers le prisme de leur propre expertise ».

Avec quel argent ?

On peut aussi se demander comment ces entreprises financent ces projets. Elles ne dégagent en effet, aucun profit pour l’instant. Du côté des financements sur projet d’Anthropic, ils ne se font pas en argent sonnant et trébuchant, mais en crédits d’utilisation de Claude sur une période de 6 mois (« jusqu’à 50 000 dollars sous forme de crédits Claude » indique l’entreprise).

La fondation OpenAI, elle, compte sur l’entrée en bourse de l’entreprise. Celle-ci ne fait toujours pas de bénéfice et n’a pas encore indiqué quand elle prévoyait d’en faire, mais elle vise une valorisation d’environ 1 400 milliards dollars. Avec une participation de 26 % dans OpenAI, sa fondation s’imagine déjà créer un fonds de 25 milliards de dollars, ce qui en ferait une des organisations sans but lucratif les plus riches du monde.

Ainsi, Jacob Trefethen, qui est à la tête de la fondation OpenAI, affirme à Nature : « Au cours de notre première année, nous avons pour objectif d’octroyer plus d’un milliard de dollars de subventions dans tous les domaines ». Et il ajoute : « Lors de nos six premiers mois d’activité, nous avons déjà octroyé plus d’un quart de milliard de subventions dans le domaine des sciences de la vie et de la lutte contre les maladies ». Mais tout cela reste donc suspendu à la valorisation d’une entreprise dont on ignore si ses comptes seront un jour à l’équilibre.

  •  

Comment OpenAI et Anthropic se voient en futurs financeurs de la recherche mondiale

Philantropie avec des dollars virtuels
Comment OpenAI et Anthropic se voient en futurs financeurs de la recherche mondiale

Via la création de fondations « philantropiques » et de « financements sur projet », les entreprises d’IA générative et notamment OpenAI se présentent comme les futurs financeurs de la recherche mondiale, alors qu’elles ne font paradoxalement pas de profits.

Les financements publics de la recherche sont particulièrement menacés ces temps-ci, en France mais aussi aux États-Unis et ailleurs. Les entreprises de l’IA générative affichent une volonté de prendre le relai avec de l’argent qu’elles n’ont pour l’instant pas, et ainsi attirer (et choisir) les chercheuses et chercheurs qui ont besoin de financements pour faire tourner leurs laboratoires.

Une « philanthropie » donnant droit à des avantages fiscaux et finançant des entreprises

Les entreprises du numérique et leurs décideurs états-uniens ont souvent affiché une « philanthropie » à travers des fondations comme la Gate Foundation de Bill Gates et Melinda French Gates, dont le budget 2025 atteignait 91 millions de dollars [PDF]. On peut citer aussi la Chan Zuckerberg Initiative de Mark Zuckerberg et Priscilla Chan, critiquée l’année dernière pour avoir abandonné bon nombre de causes qu’elle soutenait. Ces fondations proposent des « financements sur projet » souvent dans le domaine de la recherche et de la santé.

Ce « philanthrocapitalisme » a été notamment étudié par les chercheurs Linsey McGoey, Darren Thiel et Robin West dans un article (publié en 2018) dans lequel elles expliquent que cette nouvelle philanthropie consistait notamment « à distribuer à des entreprises des subventions « philanthropiques » donnant droit à des avantages fiscaux ». Elles y ajoutaient que « les organisations philanthrocapitalistes orientent de plus en plus leurs dons vers des entreprises à but lucratif » et prenaient l’exemple de la Fondation Gates qui « a commencé à octroyer un pourcentage croissant de ses subventions à des entreprises telles que Vodafone, Mastercard et Scholastic (l’un des plus grands éditeurs d’ouvrages éducatifs au monde) sous forme d’aides non remboursables ».

OpenAI et Anthropic suivent la même voie

Les startups de l’IA générative suivent la même voie. Ainsi, la fondation OpenAI, créée en octobre 2025, vient d’annoncer dans la revue scientifique Nature s’être engagée à hauteur de 125 millions de dollars de financements pour des projets concernant la création de données librement accessibles pour la recherche dans les domaines de la santé et des sciences de la vie (mise au point des vaccins contre le cancer, recherche sur la maladie d’Alzheimer, réutilisation de données provenant d’entreprises de biotechnologie en faillite…).

En juillet dernier, Anthropic annonçait des « financements sur projet » pour la recherche scientifique sur les maladies rares. La présidente d’Anthropic, Daniela Amodei, a aussi affirmé récemment à The Economist que la santé mondiale devenait « une priorité pour Anthropic, qui collabore avec des organisations humanitaires à travers l’Afrique afin d’utiliser Claude dans le domaine des soins de santé et pour prévoir les famines ». Rappelons que Donald Trump, sur recommandation d’Elon Musk, a mis fin l’année dernière à l’Agence des États-Unis pour le développement international (USAID) et ainsi coupé les financements publics d’un nombre colossal de projets concernant la santé mondiale.

« Mais les initiatives passées visant à intégrer la technologie dans l’aide humanitaire nous rappellent qu’un accès moins coûteux à l’expertise ne suffit pas », prévient The Economist. « Les outils de santé numériques ont souvent donné de bons résultats lors des essais, mais n’ont pas réussi à s’imposer dans les systèmes de santé locaux », cite en exemple le média, qui ajoute : « les donateurs ont également tendance à percevoir le monde à travers le prisme de leur propre expertise ».

Avec quel argent ?

On peut aussi se demander comment ces entreprises financent ces projets. Elles ne dégagent en effet, aucun profit pour l’instant. Du côté des financements sur projet d’Anthropic, ils ne se font pas en argent sonnant et trébuchant, mais en crédits d’utilisation de Claude sur une période de 6 mois (« jusqu’à 50 000 dollars sous forme de crédits Claude » indique l’entreprise).

La fondation OpenAI, elle, compte sur l’entrée en bourse de l’entreprise. Celle-ci ne fait toujours pas de bénéfice et n’a pas encore indiqué quand elle prévoyait d’en faire, mais elle vise une valorisation d’environ 1 400 milliards dollars. Avec une participation de 26 % dans OpenAI, sa fondation s’imagine déjà créer un fonds de 25 milliards de dollars, ce qui en ferait une des organisations sans but lucratif les plus riches du monde.

Ainsi, Jacob Trefethen, qui est à la tête de la fondation OpenAI, affirme à Nature : « Au cours de notre première année, nous avons pour objectif d’octroyer plus d’un milliard de dollars de subventions dans tous les domaines ». Et il ajoute : « Lors de nos six premiers mois d’activité, nous avons déjà octroyé plus d’un quart de milliard de subventions dans le domaine des sciences de la vie et de la lutte contre les maladies ». Mais tout cela reste donc suspendu à la valorisation d’une entreprise dont on ignore si ses comptes seront un jour à l’équilibre.

  •  

Discord accusée d’être un « terrain de chasse de mineurs » et de ne pas les protéger

🤢️
Discord accusée d’être un « terrain de chasse de mineurs » et de ne pas les protéger

Alors que le procès d’un membre du réseau 764 va s’ouvrir à Paris la semaine prochaine, l’association e-Enfance pointe l’explosion des violences faites aux mineurs sur la plateforme Discord.

Attention : le sujet de cet article est particulièrement difficile et certains détails évoqués peuvent heurter.

Le 5 octobre prochain s’ouvrira, devant la cour d’assises de Paris, le procès d’un des leaders présumés du groupe CVLT (rebaptisé « 764 »), accusé de tortures et actes de barbarie sur douze filles âgées de 11 à 16 ans.

Cet homme, qui reconnaît une fascination depuis son adolescence pour « la fraternité aryenne et le fascisme », comme l’expliquait Nice Matin en mars 2025, est accusé d’avoir attiré et piégé des adolescentes via un forum Discord qu’il administrait pour notamment les forcer à s’infliger des actes de tortures sexuelles.

e-Enfance a annoncé qu’elle se constituait partie civile dans ce procès. Cette association – qui gère le numéro de téléphone 3018 de signalement pour les victimes de cyberharcèlement – a tenu à souligner l’augmentation du nombre de signalements visant Discord pour la première moitié de cette année 2026.

Rappelons que, sur Discord, la modération repose surtout sur les administrateurs et éventuels modérateurs de chaque serveur, et que la modération y est très variable. L’entreprise est quand même responsable de la gestion des signalements des « signaleurs de confiance » prévus par le DSA.

Une augmentation importante des signalements à propos de Discord en 2026

e-Enfance, premier signaleur de confiance en France, assure [PDF] avoir reçu 138 signalements entre le 1er janvier et le 30 juin dernier, « contre 44 pour l’ensemble de l’année 2025 : en seulement six mois, ce volume dépasse le triple de celui enregistré sur toute l’année 2025 », s’alarme l’association. Elle ajoute que l’analyse effectuée par son observatoire « identifie une proportion croissante de faits d’une particulière gravité : exploitation sexuelle de mineurs, extorsion, grooming, doxing assorti de menaces de mort ou de swatting ». Et elle souligne que certains signalements « traduisent des modes opératoires rattachables à des mouvances extrémistes violentes issues du réseau cybercriminel « The Com » [dont fait partie CVLT/« 764 »] ».

Son observatoire pointe les manquements de Discord suite aux signalements : « un taux de retrait des contenus signalés limité à 33 % », constate l’association. Elle explique ce faible taux par la condition imposée par la plateforme de l’envoi de l’identifiant utilisateur Discord de l’auteur pour considérer toute notification émise par le 3018. Mais cette information est « difficile d’accès pour les victimes , et rendue inaccessible lorsque celles-ci ont bloqué l’auteur des faits », ajoute e-Enfance. Pour appuyer son analyse, l’association affirme que, depuis le début de l’année, 15 signalements sont dans ce cas, dont 13 concernent des victimes mineures.

Un mécanisme d’extorsion sexuelle envers les mineurs

« Un signalement concernant une adolescente de 14 ans, contrainte à produire des contenus sexuels violents selon un mode opératoire rattachable à la mouvance « The Com », a ainsi pu être transmis au parquet au titre de l’article 40 alinéa 1 du Code de procédure pénale, sans qu’aucune notification ait pu être adressée à Discord », ajoute l’association.

France Info a eu accès à des enregistrements d’enfants victimes de harcèlement et d’extorsion sexuelle et décrit le mécanisme mis en place en citant plusieurs exemples. « Il a commencé à me dire ‘Maintenant, tu es à moi, tu ne parles plus à personne et dès que je te demande un truc, tu le fais », confie une lycéenne. De son côté, un garçon, incité à se dénuder par un adulte se faisant passer pour un jeune joueur, explique : « Il m’a dit « j’ai tes données personnelles, envoie tes parties [intimes], sinon je vais divulguer tes infos personnelles, ton adresse, ton prénom, tout ce qu’il y a sur toi ».

e-Enfance explique que son observatoire a identifié, au premier semestre de cette année, 4 signalements « portant sur des faits particulièrement graves commis à l’encontre de mineurs sur Discord : incitation à l’automutilation, contrainte à la production de contenus sexuels violents et dégradants, exposition à des contenus de torture et de mort, discours de domination et d’emprise ». L’association juge « inégales » les réponses apportées par Discord et souligne que, concernant l’un d’entre eux, la plateforme a affirmé avoir pris des « mesures appropriées », « sans en préciser la nature, ni transmission au NCMEC (National Center for Missing and Exploited Children), malgré la gravité des faits ».

Contactée par Next, Discord n’a pas directement réagi aux affirmations d’e-Enfance. Elle affirme cependant qu’elle « s‘engage pleinement en faveur de la sécurité de ses utilisateurs » et qu’elle « souhaite que [sa] plateforme de communication soit le lieu idéal où les amis peuvent échanger avant, pendant et après leurs parties ». L’entreprise rappelle que ses conditions d’utilisation prévoient que « tous les utilisateurs doivent être âgés d’au moins 13 ans ». Et elle met en avant que « contrairement aux réseaux sociaux qui utilisent des algorithmes pour sélectionner les contenus et maximiser l’engagement, notre service s’efforce de favoriser des interactions et des liens naturels, en temps réel », en oubliant qu’elle est responsable de la modération des contenus signalés concernant ces liens réels.

« Nous combinons des technologies de pointe et des équipes de modération formées pour détecter et supprimer de manière proactive les contenus qui enfreignent nos règles. Nous mettons en œuvre des systèmes robustes destinés à empêcher la propagation de l’exploitation sexuelle et du grooming sur notre plateforme, et nous collaborons également avec d’autres entreprises technologiques et organismes de sécurité afin d’améliorer la sécurité en ligne sur l’ensemble d’Internet », assure Discord. Enfin, elle évoque l’existence de son « Discord Family Center ».

La plateforme a aussi commencé le déploiement mondial de ses outils de contrôle de l’âge qui catégorisent automatiquement les utilisateurs selon les données qu’elle a recueillies sur eux.

  •  
❌