« L’État impose de partager des données sensibles mais faillit à sa mission de protection »
Des associations féministes étaient mobilisées mardi pour demander une action plus ferme contre Brixhub, le moteur de recherche de données personnelles issues de fuites de données, et interpeller l’État sur son manque de protection des données des administrés.
Elles étaient une dizaine, le 20 octobre, à Bercy. Des militantes et militants féministes et pour les droits numériques, réunis à deux pas du Ministère de l’Économie et des Finances, pour demander à l’État de mettre des moyens concrets dans la protection des données de la population.
« Les risques sont partagés par tous », expose Alice Apostoly, chargée de plaidoyer chez Féministes contre le cyberharcèlement, auprès de Next. « Ils sont d’autant plus forts pour les femmes et les filles, dans la mesure où ils facilitent le traçage de celles qui sont exposées à des violences, ou renforcent les risques liés à des campagnes de cyberharcèlement. »
Dans le viseur des personnes rassemblées ce soir-là : Brixhub, un site web fournissant un moteur de recherches dans la foule des fuites de données personnelles des derniers mois. Début octobre, la ministre déléguée de l’intelligence artificielle et du numérique Anne le Hénanff a saisi la procureure de Paris pour réduire la visibilité de la plateforme sur le web ouvert. Mais celui-ci n’a pas tardé à faire éclore des sites miroirs, dont le plus accessible indique être hébergé en Russie.
Crédit Next
Répertoire de fuites de données publiques et privées
Étudiante, Lola passe devant le rassemblement puis s’arrête. Elle connaît Brixhub, et la logique de ces sites et boucles de discussion parfois qualifiés de « lookups ». Elle a fait le test de chercher son nom et celui de ses parents, pour voir : « J’ai des données qui avaient fuité, et j’ai appris que c’était via Ameli. »
Il reste 74% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Devant le Sénat, Vincent Strubel, le directeur général de l'Anssi, a attribué le piratage des frigos de supermarchés à des « défauts de sécurisation élémentaires ». Il écarte la piste des failles publiées par des chercheurs ces deux dernières années.
Alors que l'équipe de PHP doit publier ce 21 octobre 2026 un correctif d'urgence pour deux failles critiques, un recensement mondial place la France très loin devant tous les autres pays, en partie à cause de Freebox OS. Selon les informations de Frandroid, Freebox OS n'embarque pourtant aucun serveur PHP : le scanner aurait été trompé par une simple extension de fichier. Les sites web qui tournent sous PHP doivent, eux, toujours se mettre à jour.
Huit clés privées de l’autorité de certification eMudhra étaient tellement faibles qu’elles pouvaient être retrouvées presque instantanément. Révélé le 20 octobre 2026, l’incident permet de fabriquer de faux certificats pour usurper l’identité de sites web auprès de logiciels vulnérables. Les principaux navigateurs ont réagi, mais les correctifs doivent encore atteindre de nombreux autres outils.
Que ce soit par les collectivités ou les opérateurs, la récupération de chaleur est fréquemment citée comme argument valorisant la présence de ces bâtiments au sein d’un territoire. En pratique, le chercheur Loup Cellard constate la complexité des négociations relatives à la mise en place de la récupération et de la réutilisation de la chaleur émise.
Un ordinateur, ça chauffe. Des dizaines d’ordinateurs, ou plutôt de serveurs, stockés dans un seul bâtiment pour héberger des services de cloud ou des modèles d’IA, ça chauffe d’autant plus. C’est la raison pour laquelle, depuis des années, les acteurs de l’industrie des centres de données proposent aux collectivités de récupérer la chaleur fatale (énergie émise par l’activité, sans en être la finalité, et souvent sans être réutilisée) qu’ils émettent, entre autres arguments pour faciliter leur implantation.
En France, ce réusage est même passé dans la loi. L’article 26 de la directive européenne sur l’efficacité énergétique, adoptée en 2023 et transposée en France par un décret de décembre 2025, « oblige les centres de données les plus énergivores à valoriser la chaleur qu’ils produisent ». Pourtant, d’après les données de la Commission européenne, 0,1 % de la chaleur fatale émise par les centres de données implantés dans le pays est effectivement récupérée. C’est nettement moins que la moyenne européenne, quand bien même celle-ci plafonne de 2 à 9 % de chaleur fatale réutilisée.
Dans un récent rapport de l’Observatoire sur l’impact environnemental de l’IA de l’École normale supérieure, titré « La chaleur des data centers, un déchet qui voulait devenir une ressource pour les territoires », le chercheur Loup Cellard se penche sur les raisons de ces difficultés. Côté freins, il relève non seulement les problématiques techniques et géographiques facilement compréhensibles – certains centres de données se trouvent trop loin d’une clientèle susceptible d’être intéressée par la chaleur émise, par exemple –, mais aussi des problèmes de coordination et de négociation entre acteurs impliqués.
Votre data center, vous le prendrez avec ou sans gestion de l’énergie et de la chaleur ?
L’industrie des centres de données n’est pas connue pour sa transparence – fin septembre, un collectif de journalistes regrettait même, enquête à l’appui, l’absence de volonté des États membres et de l’Union européenne sur le sujet. « C’est ici que l’une des missions sociales de la recherche académique se dessine », écrit Loup Cellard, avant de détailler la trentaine d’acteurs rencontrés pour des entretiens semi-directifs.
Pour dessiner une image précise des complexités relatives à l’émission de chaleur fatale des centres de données, le chercheur a rencontré des opérateurs ou ex-opérateurs de centres de données de colocation classiques ou alternatifs, des gestionnaires de réseaux de chaleur urbains, des agents publics chargés de la gestion de centres de données, des énergéticiens, des architectes et divers autres acteurs impliqués dans la construction et l’intégration des centres de données dans le tissu urbain ou rural.
Parmi les principaux constats que ces rencontres lui permettent d’établir : l’argumentaire de la réutilisation de la chaleur reste opérant dans la mesure où il permet aux data centers de se présenter « comme de bons acteurs énergétiques, à la fois performants dans leur optimisation des systèmes et volontaires à valoriser leur chaleur ». Depuis ce point de vue, ils promettent de « valoriser la chaleur comme un déchet dans une économie circulaire », par ailleurs intensifiée ces dernières années par le déploiement de l’IA générative.
Pour autant, la mise en place effective de ces circuits reste complexe. Ces deux axes placent les opérateurs de centres de données face à un paradoxe. Ils peuvent, d’un côté, maintenir une stricte division entre leurs métiers et ceux des énergéticiens. Ils risquent cependant d’être rangés dans la catégorie des gros consommateurs industriels d’énergie, avec tous les débats que cela suscite.
Autre possibilité : s’engager réellement dans la réutilisation de la chaleur émise, ou dans la gestion et le stockage de l’électricité. Dans ce cas, en revanche, c’est le métier lui-même qui mute, pour tenter de « faire coïncider leurs activités avec les valeurs et objectifs d’une économie circulaire ».
À qui revient la charge d’assurer la récupération de chaleur ?
Au sein des territoires, l’intérêt pour la récupération de la chaleur émise par les centres de données se justifie de plusieurs façons. Un argument quelquefois utilisé est celui de l’autonomie énergétique : en la matière, les data centers permettraient de « devenir moins dépendants des chaînes d’approvisionnement fossiles et lointaines (pétrole, gaz russes ou américains) ». Un autre consiste à s’assurer que le bâtiment s’intègre au territoire « de manière écologiquement positive », alors que le scénario de maintien des températures mondiales sous le seuil de 1,5 °C de réchauffement par rapport au niveau pré-industriel vient d’être dépassé. Dans un tel cas, la chaleur devient « une forme de compensation pour ce que l’opérateur va retirer au territoire (emprise au sol, grande réservation d’électricité, risque de pollution associé) », écrit Loup Cellard.
Mais le problème qui émerge rapidement est celui de la responsabilité et de la coordination des acteurs, y compris au gré des variations saisonnières. Directeur général des services de Generia, le syndicat réseau de chaleur de La Défense, Gérald Chirouze témoigne par exemple du cas d’un centre de données branché au sous-réseau de Courbevoie « Seinergie », qu’il approvisionne à hauteur de 20 MW. Or, pour approvisionner les 14 000 logements raccordés, le besoin courant est de 45 MW, mais tombe à 9 MW l’été. Il faut, dans ces cas-là, trouver un autre usage à la chaleur.
Plus généralement, des freins techniques sont mis en avant, à commencer par celui selon lequel l’essentiel des centres implantés en France émettent une chaleur trop basse, entre 20 et 25 °C, pour être raccordés directement aux réseaux de chaleur. En général, ces derniers nécessitent en effet des chaleurs de plus de 60 °C. Et même si la chaleur est destinée à de la production de culture maraîchère, l’eau doit être remontée à 55 °C pour chauffer correctement. Dans la plupart des cas, il faut donc ajouter une pompe à chaleur :
À ceci viennent s’ajouter des contraintes géographiques – à Nozay ou aux Ulis, en Essonne, les projets de Data4 et de Digital Realty ne trouvent pas de clientèle pour leur chaleur, par exemple –, ou spatiales. Si les bâtiments sont installés à plus de 3 km de leur destination, « la chaleur descend trop pour pouvoir être utilisée sans être maintenue ». Et puis vient la question de la négociation économique : difficile de savoir qui, « entre collectivités, gestionnaires de réseaux de chaleur et opérateurs de data centers », doit payer pour l’installation de pompes à chaleur et les travaux de raccordement. En la matière, les collectivités sollicitées indiquent ne pas connaître les capacités financières des opérateurs, ce qui complique la négociation de la répartition des coûts d’investissement.
Juridiquement, les data centers sont contraints depuis le 29 décembre 2025 à organiser la récupération d’au moins 20 % de leur chaleur fatale, « sauf si l’opérateur est capable de démontrer auprès des collectivités locales compétentes que le projet n’est pas faisable économiquement ou techniquement ». En l’espèce, le rapport suggère que les opérateurs n’auront pas de mal à démontrer la complexité de cette entreprise, sauf si l’administration se fait « particulièrement intransigeante en la matière ».
En définitive, son auteur souligne les besoins « de concertation et de planification énergétique » remontés par les spécialistes interrogés sur le terrain. À l’heure actuelle, « lorsque les contraintes techniques d’injection de chaleur sont maîtrisées », si la chaleur des data centers reste inutilisée, c’est le plus souvent par « manque d’anticipation et de connaissances mutuelles entre opérateurs d’infrastructures et réseaux de chaleur ».
En guise d’exemple réussi, le rapport se penche sur le cas d’un data center d’Equinix géré par une filiale d’Engie Solutions et alimentant logements, bureaux et centre aquatique de Saint-Denis. « Comme pour d’autres projets de récupération de chaleur (géothermie, usines de déchets, etc), la valorisation de la chaleur des data centers est grandement facilitée lorsqu’elle rencontre les ambitions d’un territoire en termes de décarbonation du mix énergétique. » Pour cela, souligne-t-il encore, il faut aussi que l’industrie concernée s’engage réellement.
Alors que le deuxième tour de la présidentielle brésilienne arrive, Meta est accusée d’avoir introduit des biais dans ses algorithmes, dans ses IA et dans son traitement de la modération pour favoriser Flávio Bolsonaro contre le président actuel Luiz Inácio Lula da Silva. La justice brésilienne a donné 24 h à l’entreprise de Mark Zuckerberg pour montrer son impartialité.
Les élections dans les pays d’Amérique latine ne sont pas à l’abri de l’ingérence des entreprises états-uniennes proches de Donald Trump. Ainsi, à l’approche du deuxième tour de l’élection présidentielle qui aura lieu le 25 octobre, le camp du président brésilien sortant, Luiz Inácio Lula da Silva, a formellement accusé Meta d’ingérence électorale en faveur de Flávio Bolsonaro, son opposant d’extrême droite.
Déjà, avant le premier tour, son équipe s’était plainte que Meta avait brièvement suspendu le recours à la publicité de sa page Facebook. Mais ce n’est pas la seule difficulté qu’a rencontrée l’équipe de Lula avec les différents outils de l’entreprise propriétaire d’Instagram, Facebook et WhatsApp . « La succession de problèmes techniques non expliqués par l’entreprise laisse fortement soupçonner que l’action de Meta constitue une tentative d’ingérence dans le processus électoral brésilien au profit de la candidature de Flávio Bolsonaro », a déclaré le 10 octobre dernier un des porte-paroles du Parti des travailleurs représenté par Lula.
Des biais dans les algorithmes et les IA de Meta en faveur de Bolsonaro ?
L’équipe du président a attaqué la semaine dernière l’entreprise de Mark Zuckerberg en justice, l’accusant de biaiser les algorithmes de ses réseaux sociaux et les réponses de ses modèles d’IA pour favoriser Bolsonaro. Le juge de la Cour supérieure de justice brésilienne, Marco Aurélio Bellizze, s’est prononcé jeudi 15 octobre.
Selon Associated Press qui a eu accès à la délibération, il a statué que Meta ne pouvait pas réduire la diffusion de contenus politiques, restreindre les recherches ou supprimer des publications d’une manière susceptible de créer un déséquilibre entre les deux candidats. Meta devait aussi s’assurer que ses outils d’intelligence artificielle soient impartiaux. Le jugement appliquait une peine de jour-amende à Meta de 500 000 reales (89 000 euros) en cas de non-respect de la décision.
Le tribunal a rendu ce lundi une nouvelle décision, selon l’AFP, donnant cette fois 24 heures à Meta pour prouver qu’elle n’a pas mis en place d’ingérence dans la campagne électorale brésilienne. Le juge a multiplié par deux la peine de jour-amende si l’entreprise ne répond pas.
Des messages internes confirment, Meta réfute, invoquant des problèmes techniques
Le journal brésilien Folha de S.Paulo a pu consulter des messages internes entre employés de Meta montrant que l’entreprise a mis en place des restrictions sur le compte Instagram de Lula concernant sa promotion mais aussi une recommandation du profil de Flávio Bolsonaro. La loi électorale brésilienne interdit toute recommandation algorithmique sur les réseaux sociaux : la promotion est donc le seul moyen pour les candidats d’augmenter leur audience. Nos confrères brésiliens expliquent que l’entreprise de Mark Zuckerberg détient un quasi-monopole concernant la publicité électorale numérique puisque Google a arrêté ce genre de publicité depuis 2024.
Meta réfute les accusations, invoquant auprès de nos confrères d’Associated Press une série de défaillances techniques mondiales sans lien entre elles, de mesures anti-fraude strictes et du respect des réglementations, plutôt qu’une censure ciblée. Elle affirme que l’une de ces mesures concerne le décompte des vues sur les Reels Instagram dans plus de 100 pays. Un autre aurait perturbé, toujours sur Instagram, la création de publicités reprenant des publications déjà existantes. L’agence de presse pointe que l’entreprise n’a « toutefois pas expliqué pourquoi les comptes Instagram et WhatsApp de Bolsonaro bénéficiaient de recommandations algorithmiques ».
Les arguments de Meta ne semblent pas avoir convaincu les militants de Lula qui ont manifesté devant le siège social brésilien de l’entreprise.
Deutsche Telekom, Orange, Telefónica et Vodafone ont signé une lettre d'intention pour étudier une candidature commune aux fréquences européennes qui servent à connecter un smartphone directement à un satellite. Les quatre opérateurs ne prévoient pas de lancer de satellites eux-mêmes.
Le parti d’extrême droite allemand Alternative für Deutschland (AfD) a été touché par un « gigantesque vol de données », explique le média Bild.
Des pirates ont revendiqué la récupération de 421 179 emails provenant de boites de différents dirigeants du parti qui n’hésite pas à jouer sur ses affiches avec les symboles du IIIe Reich. Des emails de la responsable du parti, Alice Weidel, du président d’honneur, Alexander Gauland et du député Leif-Erik Holm feraient partie du lot.
L’AFD confirme à Bild le piratage : « En septembre 2026, un prestataire de services d’hébergement de notre parti a été victime d’une cyberattaque au cours de laquelle certaines parties d’un petit nombre de boîtes mail – dont la plupart n’avaient plus été utilisées depuis des années – ont apparemment été copiées illégalement ».
Illustration : Flock
Les pirates ont créé un site pour l’occasion. Mais il n’y publient pas tous les emails, ils y proposent une sorte d’index dans lequel les documents qu’ils ont obtenus sont classés en fonction de leur gravité supposée selon différents critères que sont le racisme, l’antisémitisme mais aussi les menaces de violence, les références au Mouvement des citoyens du Reich, ou d’autres « activités illégales ».
Les items en question ne donnent pas accès aux conversations complètes : une fiche manifestement générée grâce à un extract IA liste des dates, des adresses mail, et d’autres éléments censés permettre l’identification des mails d’origine.
Le site ne donne accès à aucune information tangible quant au contenu des mails en question. Pour y accéder, les pirates renvoient vers une archive de 281 Go via torrent, qui n’a pour l’instant pas été auditée de façon indépendante, où se retrouveraient les e-mails originaux complets avec les en-têtes, corps de message et pièces jointes dans leur intégralité et les signatures DKIM intactes.
L’action ne semble pas avoir été officiellement revendiquée, il faudra maintenant attendre que les médias allemands ou des internautes se saisissent de cette base de données pour la vérifier.
Les nouvelles conditions d’utilisation de Meta prévoyaient à partir du 30 octobre la possibilité de moissonner le contenu des pages web associées à des utilisateurs professionnels. Les organisations gérant une page Facebook ou Instagram auraient dû autoriser le géant des réseaux sociaux à aspirer les contenus de leurs sites pour entraîner les modèles IA de Meta. L’entreprise a fait marche arrière, mais les inquiétudes demeurent.
Meta voulait simplifier les conditions d’utilisation de ses services pour les utilisateurs gérant des comptes Facebook ou Instagram pour leur association, organisation ou leur entreprise. Ces conditions, qui seront mises en œuvre le 30 octobre autorisaient Meta à utiliser des logiciels automatisés (des crawlers, robots, collecteurs, bots d’indexation, agents utilisateurs) pour « accéder, indexer, mettre en cache, analyser, collecter, récupérer ou explorer les domaines, les pages Web ou les URL (…) associés à vos produits ou services ».
Le groupe de Mark Zuckerberg indiquait surtout qu’il pouvait utiliser « tout contenu [provenant de ces URL] pour fournir, développer, améliorer, rechercher, entraîner et maintenir l’intégrité des produits, des services et des fonctionnalités des entités Meta ». De quoi faire craindre le pire, notamment aux éditeurs de presse qui gèrent une page Facebook (ils sont nombreux, dont Next). Au vu de ces conditions, rien n’empêche en effet le géant des réseaux sociaux de moissonner les sites web pour entraîner ses modèles IA, sans avoir à rémunérer personne.
Moisson sans rémunération
Des experts juridiques interrogés par Nieman Lab expliquent que les termes utilisés par Meta dans ses conditions lui donnent un accès à des contenus dont les licences lui coûteraient normalement des millions de dollars.
L’entreprise a expliqué à nos confrères que les dispositions relatives à l’exploration des sites web étaient auparavant dispersées dans différentes conditions d’utilisation. La mise à jour ne fait que les rassembler dans un même endroit. Par ailleurs, « les propriétaires de contenus peuvent toujours contrôler l’accès à leurs contenus à l’aide du fichier robots.txt », affirme aussi le porte parole.
Meta se donnant la possibilité de créer des « identifiants de test » pour explorer et collecter des données sur les sites web, la question du respect des consignes du fichier robots.txt se pose alors. La société s’engage-t-elle à les suivre également lorsqu’elle explore un site à l’aide de ces comptes de test ? La controverse a monté durant quelques heures, avant que Meta ne clarifie ses intentions auprès de Next et d’autres publications.
« Nous vous avons entendus et souhaitons apporter une précision : les conditions relatives à l’exploration automatisée du web que nous avons regroupées ne s’appliquaient qu’à nos produits publicitaires et professionnels », nous a expliqué l’entreprise. « Cela ne change pas la manière dont Meta utilise les robots d’exploration du web. Comme toujours, les propriétaires de contenus peuvent utiliser le fichier robots.txt pour indiquer leurs préférences », assure-t-elle. Surtout :
« Il n’est pas question ici de collecter automatiquement le contenu de sites d’information, et ces mises à jour ne nous accordent aucun nouveau droit qui primerait sur ces préférences ».
Meta revoit ses conditions
La précision est bienvenue, et les changements ont effectivement été apportées aux conditions. D’abord, le verbe « entraîner » a disparu, la finalité vise désormais explicitement les « produits publicitaires et commerciaux » comme la diffusion de publicités, l’information sur les produits et services, et la mise en relation avec des utilisateurs intéressés. Enfin, l’intégrité et la sécurité restent un objectif portant plus largement sur les produits des entités Meta.
L’alerte a été chaude, mais elle n’est pas passée inaperçue du côté du GESTE. Laure de Lataillade, la directrice générale du groupement des éditeurs de services en ligne, s’alarme d’un problème qui « dépasse largement le seul cas de Meta ». Elle déplore que, depuis plusieurs années, « les grandes plateformes numériques intègrent dans leurs conditions générales des clauses leur permettant d’exploiter les contenus qu’elles hébergent ou distribuent pour développer leurs technologies et services, notamment d’intelligence artificielle. »
Il n’existe pas, écrit-elle, de réelle possibilité de négociation dans ces contrats « imposés par des acteurs dont les médias dépendent fortement pour distribuer leurs contenus, toucher leurs audiences et développer leurs activités ». Les médias se retrouvent donc « entre le marteau et l’enclume », ils n’ont pas d’autre choix que d’accepter des contrats défavorables « qui peuvent les conduire à concéder des droits qu’ils cherchent précisément à protéger, sous peine de se priver de canaux de distribution devenus incontournables. »
Une des solutions préconisées par le GESTE est de séparer les autorisations nécessaires à l’hébergement et à la distribution des contenus de celles permettant leur exploitation pour l’entraînement des modèles ou d’autres usages d’IA.
Les nouveaux appareils Bee veulent soulager la mémoire défaillante de leurs utilisateurs, en écoutant les conversations pour en tirer des résumés, des listes de tâches… et des suggestions d’achat sur Amazon.
Qui n’aurait pas envie de partager toutes ses conversations avec Amazon ? Le géant américain du commerce en ligne ne voit pas ce qui pourrait mal se passer, et a lancé deux nouveaux produits Bee – du nom d’une start-up achetée l’an dernier. Ils partagent les mêmes fonctions, mais leurs designs sont très différents.
Tout retenir, même les envies d’achats
Le Bee Frontier ressemble à un bracelet de suivi de la santé, le Bee Eclipse à une batterie externe pour smartphone (il est maintenu au dos du téléphone avec des aimants). Les deux enregistrent les conversations en continu, afin de générer des résumés, des listes de tâches, des aides mémoire. Un bouton permet d’activer l’enregistrement audio ; un témoin lumineux s’allume alors sur l’appareil. Il est aussi possible de configurer une période d’enregistrement (5 minutes, 15 minutes, etc.)
Image : Amazon
Amazon donne un exemple d’utilisation : organiser des vacances avec des amis. Le Bee retient les détails pratiques évoqués pendant la conversation, comme les horaires d’arrivée ou les restos préférés de chacun. L’application mobile compagnon, chargée de collecter l’audio et de l’envoyer vers les serveurs pour traitement, propose des résumés et classe les informations. Elle fournit également des « mémoires » des derniers jours de conversations et suggère des objectifs personnalisés à accomplir.
Il est aussi possible de brancher l’app Bee à Gmail, Google Calendar et Outlook pour qu’elle génère des brouillons de courriel ou crée des invitations dans le calendrier en se basant sur les échanges vocaux de l’utilisateur. La plateforme de santé HealthKit d’Apple est également compatible « pour obtenir une vue plus complète de votre bien-être ».
Amazon oblige, Bee saura aussi se connecter à Alexa+ afin de nourrir l’assistant des données collectées par les appareils et accéder aux résumés et tâches en les demandant avec la voix. Mieux encore (ou pire), en connectant le Bee à Amazon, les informations enregistrées par un appareil Bee peuvent être utilisées pour des suggestions d’achats.
Un abonnement et des promesses de confidentialité
Amazon propose également un abonnement mensuel, Bee Pro, facturé 11,99 dollars pour obtenir un nombre illimité de résumés de conversations récentes, des suggestions de tâches, les « mémoires » quotidiennes, un assistant de discussion, l’intégration avec Alexa+ et Amazon. Le Bee Frontier est proposé à 74,99 dollars, l’Eclipse coûte 99,99 dollars.
Amazon n’a pas annoncé de lancement européen pour les produits Bee, probablement en raison du casse-tête que représente le consentement vis à vis du RGPD : non seulement celui de l’utilisateur (ce qui est a priori acté), mais aussi celui de ses correspondants. Sur le plan de la confidentialité, les appareils Bee s’appuient sur une infrastructure Private Compute.
Bee transcrit les conversations en temps réel sans conserver l’audio après le traitement, promet Amazon. Les transcriptions, résumés et tâches sont chiffrés et traités dans un environnement sécurisé auquel ni Amazon ni Bee n’ont accès. Seul l’utilisateur peut les consulter, et décider de les partager avec d’autres services, avec la possibilité d’arrêter ce partage à tout moment. On peut également supprimer les transcriptions et les résumés à tout moment.
Amazon a publié un livre blanc. L’entreprise a aussi fait réaliser un audit par Trail of Bits au printemps (PDF). Ce dernier, qui révèle les grands principes architecturaux de l’infrastructure dédiée à Bee, a permis l’identification de 19 vulnérabilités potentielles, dont 17 ont été corrigées par les équipes d’Amazon.
Extrait du rapport Trail of Bits – capture d’écran
Si le moteur de recherche de Yahoo a largement disparu du paysage, balayé par l’ouragan Google, plusieurs services de l’entreprise demeurent très utilisés. C’est le cas du courriel, et à partir de mars 2027, les utilisateurs devront faire un choix important concernant l’affichage de publicités.
À compter du 18 mars 2027, Yahoo demandera aux utilisateurs de ses services, comme le mail, les actualités ou la finance, de choisir entre deux options : accepter la publicité personnalisée sans frais supplémentaires, ou souscrire un abonnement payant pour ne plus la subir. Un troisième choix est possible, celui de ne plus utiliser les services de Yahoo.
La première option ne changera pas fondamentalement l’expérience actuelle : « Si vous choisissez d’utiliser les services de Yahoo avec des publicités personnalisées, c’est ainsi que la publicité fonctionne déjà en grande partie pour de nombreux utilisateurs aujourd’hui », explique la société dans sa FAQ.
Elle précise à toutes fins utiles que la pub personnalisée ne signifie pas que le contenu des mails sont lus ou analysés, en revanche les annonces sont choisies en fonction des centres d’intérêt, de la localisation approximative et de la manière d’utiliser les services de Yahoo.
2,49 euros par mois pour moins de pubs et moins de ciblage
En souscrivant l’abonnement payant fixé à 2,49 euros par mois, Yahoo n’utilisera plus les données de l’internaute pour personnaliser les réclames ; elles ne seront pas non plus partagées avec des partenaires. L’abonné verra également moins d’annonces sur les différents services du groupe, même si le contenu sponsorisé, les liens d’affiliation et « d’autres contenus publicitaires » resteront présents.
Un délai de rétractation légal de 14 jours à compter de la date de la première inscription est bien sûr présent, et Yahoo préviendra au moins 30 jours à l’avance d’un changement dans le prix de l’abonnement. Pour tous ceux qui ne voudraient ni l’une ni l’autre option, Yahoo propose de transférer la boîte de réception vers un autre fournisseur. Un outil de migration est disponible à cette adresse, pour copier les mails, contacts et agenda vers la nouvelle adresse.
Une fois la boîte de réception migrée, Yahoo transférera automatiquement les nouveaux mails envoyés à l’adresse Yahoo Mail vers la nouvelle adresse « pendant sept mois, gratuitement ».
Ces options rappellent ce que Meta avait tenté de mettre en place dans l’Union européenne avec une offre de type « consentir ou payer ». Mais après une amende de 200 millions d’euros pour infraction au DMA, Meta a dû changer son fusil d’épaule : depuis début 2026, Meta donne le choix entre le partage de toutes les données nécessaires à la publicité personnalisée, et une personnalisation limitée basée sur moins de données. Yahoo ne fait pas partie du club des plateformes du DMA, elle n’est pas tenue de suivre le même chemin que Meta.
Trois actualités à retenir cette semaine dans le cyberespace, un piratage qui a fait grimper la température dans les rayons frais de centaines de supermarchés français, Andrej Karpathy qui décrit le fossé grandissant entre l’IA que connaît le grand public et celle que voient les laboratoires, et un effondrement du trafic de bots russes qui mérite d’être nuancé.
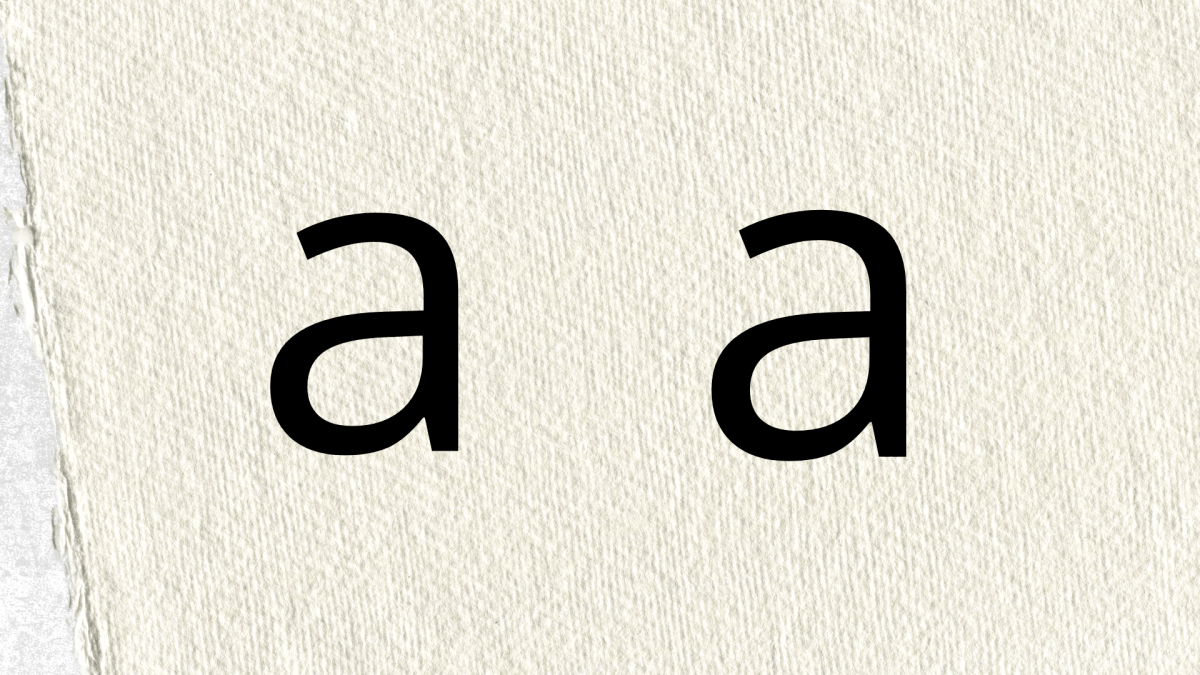
Une simple lettre venue de l’alphabet cyrillique suffit à créer une fausse adresse web presque impossible à distinguer de la vraie à l’œil nu. Un piège connu des spécialistes, qui reste redoutablement efficace.
Le plus prolifique des éditeurs de sites d’infos générés par IA est de retour. Blacklisté l’an passé, après avoir spammé Discover, l’algorithme de recommandation de contenus de Google, de milliers d’articles et de fake news,trois de ses sites ont capté jusqu’à 4 % du trafic début octobre, publiant à lui tout seul 26 000 articles, contre 34 000 pour tout Ouest France, qui emploie plus de 700 journalistes.
Article mis à jour le 17 octobre à 10h30 avec des précisions de l’APIG sur la différence entre « clics » et « visites ».
La semaine passée, on apprenait que la fréquentation des principaux sites d’informations avait chuté de près de 25 % en un an. Cette chute serait en partie due à des modifications effectuées dans l’algorithme de recommandations de contenus Discover de Google.
Principale source de trafic des sites d’information, Discover représentait en effet plus de 60 % du trafic d’un panel de 68 titres de l’Alliance de la presse d’information générale (APIG) en juin 2025. À lui seul, Discover représentait 72 % du trafic en provenance de Google (contre 21 % depuis son moteur de recherche, et 7 % depuis Google Actualités), qui représentait lui-même 70 % du trafic total, contre moins de 8 % seulement en provenance des réseaux sociaux.
L’algorithme Discover de recommandation de contenus de Google est la principale source de trafic de la presse – APIG
Or, d’après 1492.vision, un puissant dashboard d’analyse des contenus recommandés par Discover (qui ne prétend pas à l’exhaustivité, mais dont les chiffres font autorité dans la profession), le pourcentage d’articles émanant de sites d’information identifiés par Next comme étant générés par IA (GenAI) était passé d’un peu plus de 8 % en décembre 2025 à un peu plus de 3 % en avril, oscillant depuis entre 4 et 6 %.
Au mois d’août, le ratio oscillait entre 6 et 7 %, avant d’exploser en septembre, au point de frôler les 12 % début octobre, avant de brusquement retomber à moins de 5 % après que Google ait blacklisté un spammeur.
Début octobre, 12 % des contenus recommandés sur Discover provenaient de sites d’infos GenAI – 1492.vision
Le graphique des performances comparant le ratio entre le nombre d’impressions et le nombre d’articles uniques montre que les sites GenAI sous-performaient les sites « humains » avant que, en juin dernier, ces derniers soient dépassés, et que les articles GenAI ne les surclassent pendant tout l’été et en octobre.
Près de 7 % des URLs, et 8,5 % des hits sur les sites en français en septembre dernier émanaient de 145 sites d’infos générés par IA. Ces derniers ne représentaient pourtant qu’un peu plus de 2,6 % des 5 552 domaines y ayant été recommandés le mois dernier.
Pourcentages de sites GenAI sur Discover en septembre et juin 2026, vs août 2025 – 1492.vision
À titre de comparaison, les 159 sites GenAI recommandés par Discover en juin dernier représentaient un peu moins de 3 % du total des noms de domaine identifiés par 1492.vision, mais seulement 3,32 % des URLs, et 3,69 % des hits. En août 2025, alors que Discover était floodé par des spammers, 1492.vision y dénombrait 357 sites GenAI, représentant 7,59 % du total des sites recommandés, totalisant plus de 9 % des URLs, et plus de 8 % des hits.
Rappelons que nous avons d’ores et déjà publié une cinquantaine d’articles dans le cadre de notre enquête au long cours sur cette pollution de sites d’info générés par IA. Next a aussi développé une extension web (gratuite) pour les navigateurs basés sur Chrome et Firefox, afin d’alerter les personnes qui l’utilisent lorsqu’elles consultent l’un des sites GenAI que nous avons (manuellement) identifiés. Notre base de données en dénombrait un peu plus de 1 000 en février 2025. Elle en dénombre désormais plus de 19 000 (rien qu’en français).
« Google a ré-ouvert les vannes de Discover » aux spammers
« Google a ré-ouvert les vannes de Discover », tweetait 1492.vision la semaine passée, notant que « des spammers sont entrés », et voyaient leurs articles propulsés par Discover. Dans un second tweet, 1492.vision relevait que trois noms de domaine expirés, depuis rachetés par des professionnels du référencement, avaient capté à eux seuls 2 % du flux Discover en septembre, et plus de 4 % la première semaine d’octobre, avant d’être blacklistés.
Il reste 62% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.

 Connexion