Google ne manque jamais une occasion de faire la promotion de Chrome ou de sa propre application de recherche dans Safari, tout particulièrement sur iPhone. Apple voudrait en avoir le cœur net et mesurer précisément le volume et la fréquence de ces bannières et de ces panneaux souvent envahissants.
Illustration : Flock
La bêta 2 d’iOS 27.2 contient en tout cas des outils de télémétrie pour relever l’usage que fait Google de ces promotions dans Safari, d’après le code découvert par le site 9to5Mac. Cela ne veut pas nécessairement dire qu’ils seront présents dans la version finale d’iOS 27.2, mais leur présence dans la bêta confirme l’expérimentation par Apple de cette fonction.
Safari injecte un script JavaScript dans certaines pages du site de Google : accueil et résultats de recherche. Il cherche les bannières et les éléments visuels qui incitent les utilisateurs à lancer Chrome ou l’app Google. Lorsqu’une de ces promotions est détectée, le navigateur peut enregistrer plusieurs informations : si elle a été affichée, si l’utilisateur a interagi avec elle, ou encore s’il semble connecté à un compte Google.
Apple est ainsi en mesure de déterminer si l’utilisateur a accepté ou ignoré les sollicitations de Google. Reste à savoir pour quoi faire. 9to5Mac avance l’idée que ces outils pourraient être indispensables dans un cadre réglementaire. Dans l’UE, le règlement sur les marchés numériques oblige Apple à proposer aux internautes le choix du navigateur et du moteur de recherche. Mais pourquoi dans ce cas se limiter à Chrome ?
Les « aperçus IA » qui s’affichent en tête des résultats d’une recherche Google sont générés à partir de contenus produits par des sites web. Après avoir capté une partie de leur trafic grâce à ces résumés, Google aurait commencé à rémunérer des éditeurs pour leurs contenus.
Avec les AI Overviews (Aperçus IA en France), Google prive les sites web d’une partie de leur trafic et donc, de leurs revenus publicitaires. Les internautes ne sont plus incités à se rendre sur ces sites, se contentant bien souvent des résumés générés par IA. C’est la double peine pour les éditeurs, qui se font voler à la fois leurs contenus et leurs lecteurs. Et cela explique aussi la méfiance de plus en plus grande de plusieurs d’entre eux, qui envisagent tout simplement de couper les ponts avec le moteur de recherche dominant.
Fin 2025, la Commission européenne ouvrait une enquête sur Google, accusé de fausser la concurrence en imposant des conditions abusives aux éditeurs et aux créateurs de contenu qui désavantagent les développeurs d’IA concurrents.
Poussé par les régulateurs, Google a dû mettre en place cet été un réglage permettant aux éditeurs d’interdire la collecte de leurs articles pour entraîner les modèles IA de l’entreprise. Tout en autorisant tout de même l’indexation de ces mêmes articles, pour les intégrer dans les résultats de recherche classiques.
Le baiser de la mort
Mais avant de générer des aperçus IA, faut-il encore avoir la matière première : les contenus. Et Google a toujours besoin des sites web. Le site The Information rapporte l’existence d’un programme pilote lancé il y a moins d’un an ; il rémunère une centaine d’éditeurs de sites web. Les sommes varient en fonction de la contribution de leurs contenus aux réponses générées par l’IA dans son moteur de recherche, ainsi que dans le mode IA et dans le chatbot Gemini.
Un éditeur anonyme aurait, depuis son inscription au programme, touché entre 50 000 et 60 000 dollars, ce qui ne représente qu’une petite partie de son activité. Un autre perçoit plus d’un million de dollars par an, ce qui est une part plus significative de son chiffre d’affaires. Les sommes peuvent sembler importantes, mais tout dépend de la taille des éditeurs et de leurs rédactions. Certains sites doivent se contenter de moins de 1 000 dollars sur plusieurs mois.
Pour les petits sites qui participent à ces tests, les sommes versées par Google pèseraient pour moins de 0,1 % de leurs revenus publicitaires, d’après les sources de The Information. La petitesse de ces enveloppes auraient même dissuadé des éditeurs plus importants de se lancer. Ce faisant, ils espèrent pousser Google à mieux valoriser les contenus utilisés pour l’entraînement des IA.
Un modèle pour le secteur de la presse en ligne ?
Plus pragmatiques, d’autres éditeurs espèrent comprendre le type de contenus favorisés par Google et son IA, afin d’optimiser leurs articles et profiter de la manne. Un dirigeant d’un éditeur indique que Google décide seule de la valeur des contenus afin de garder le mystère sur la boîte noire de son système de génération IA.
Des participants au programme n’auraient aucune idée de la manière dont Google calcule les rémunérations, ni ce que Google considère comme une contribution significative à un aperçu IA. Des contenus consacrés à des sujets niches (comme les anime ou les jeux vidéo) mais suscitant un fort intérêt de la part des internautes, semblent toutefois rapporter davantage.
Beaucoup des participants espèrent que ce programme fera figure de modèle à suivre pour les autres acteurs de l’IA qui ont tendance à jeter par dessus bord le copyright au nom d’un « usage légitime » qui a parfois bon dos. Il faudra au préalable que Google officialise l’initiative et que davantage d’éditeurs y participent.
OpenAI déploie son outil de filigrane sur le texte généré par ChatGPT. Cette fonctionnalité, réservée au Vieux continent en vertu de l’AI Act, demeure une solution imparfaite à un problème complexe.
Après Anthropic qui a intégré une fonction de filigrane dans le texte généré par Claude (depuis Fable 5.1 plus précisément), c’est au tour d’OpenAI de respecter l’obligation européenne de permettre l’identification d’un texte généré par ChatGPT. Cette mesure, inscrite dans l’AI Act, est en vigueur depuis début août – les systèmes d’IA présents sur le marché ont jusqu’au 2 décembre pour respecter les obligations de marquage technique.
OpenAI a donc dévoilé sa feuille de route pour le tatouage des textes. La technologie, baptisée textGrain, ajoute un « signal statistique invisible » sur les choix des mots. Autrement dit, c’est une technique qui « modifie subtilement la manière dont le modèle choisit de façon aléatoire entre plusieurs mots ou fragments de mots possibles au fil de la génération [du texte] », explicite l’entreprise dans une fiche technique.
« Sur l’ensemble d’un passage, ces choix créent un motif qu’un détecteur peut repérer, même après certaines modifications du texte. » Le résultat est censé être invisible aux yeux du lecteur, la technique n’ajoutant « aucun caractère caché, espace invisible ou signe de ponctuation inhabituel ». Anthropic a choisi une solution similaire.
Pangram, qui a beaucoup fait parler ces dernières semaines suite à l’affaire Thélyson Orélien, analyse les textes après leur génération, en se basant sur des caractéristiques comme le choix des mots. Il ne détecte pas les signaux intégrés à même les textes, comme c’est le cas des filigranes.
Le code des bonnes pratiques sur la transparence des contenus de l’AI Act n’impose pas de watermark sur les textes de moins de 200 tokens, ce qui représente environ 150 mots en anglais. De toute manière, les techniques de filigrane ne sont pas efficaces sur les textes courts, comme le rappelle OpenAI.
Image : OpenAI
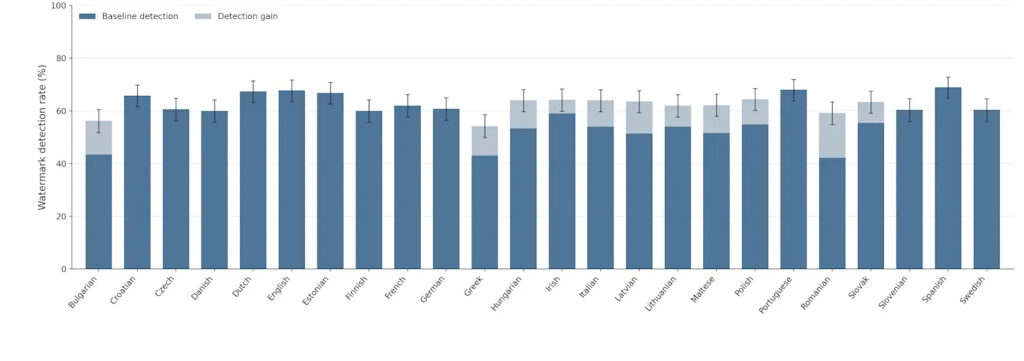
Le taux de détection varie en fonction de la langue, certaines d’entre elles se montrant « plus faciles à détecter que d’autres ». Sur les tests réalisés par l’entreprise – 500 prompts générés en anglais, puis traduits –, l’espagnol obtient le meilleur taux de détection (69 %), le roumain affichant le taux le plus faible (42,2 %). Avec un taux qui dépasse 60 %, le français est plus proche de l’espagnol.
OpenAI ajoute à textGrain un paramètre d’ajustement de l’intensité pour renforcer ou réduire le signal du filigrane en fonction des domaines. Le taux de détection de certaines langues, qui se situe normalement sous le seuil des 60 %, s’améliore grâce à ce paramètre. L’entreprise a l’intention de proposer sa technologie en open source.
Image : OpenAI
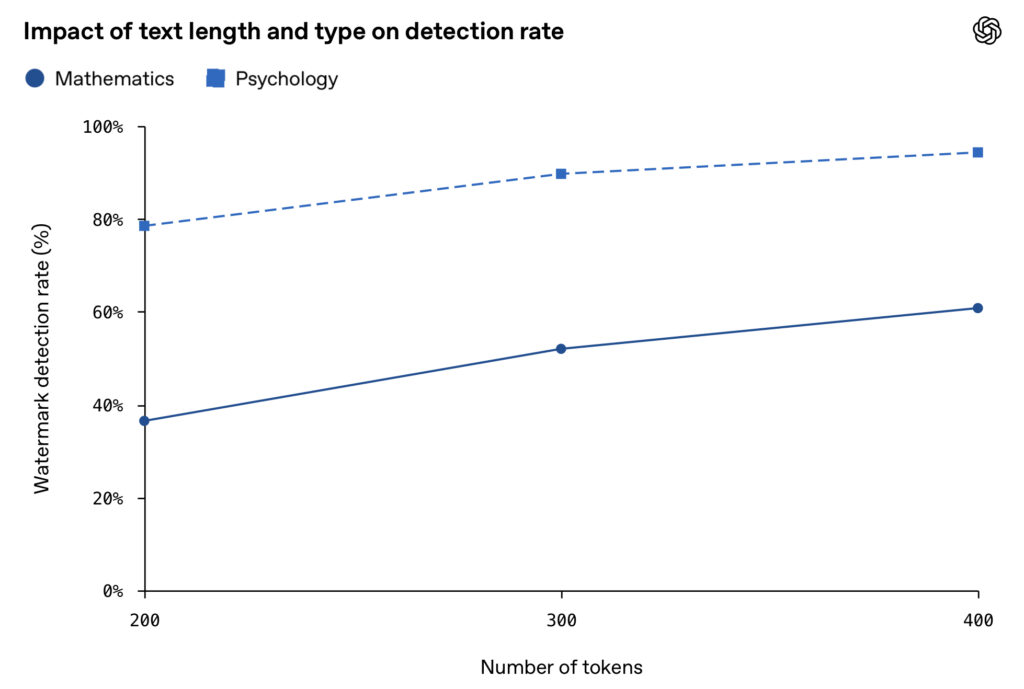
OpenAI explique que les détecteurs peuvent commettre deux types d’erreurs de détection : faux positifs (signaler la présence d’un filigrane qui n’existe pas) et faux négatifs (ne pas repérer la présence d’un filigrane existant). Sur des passages de 400 tokens, avec un taux de faux positifs cible de 1 %, le détecteur a identifié un filigrane dans 95 % des cas – mais tout dépend du contenu. Sur les textes portant sur la psychologie, le taux de détection est particulièrement élevé ; il l’est beaucoup moins quand il s’agit de mathématiques, où le choix des mots est plus limité.
Brouiller les pistes
Autre limite : modifier les textes générés par IA a un impact sur le taux de détection. Un taux de détection à 92 % peut tomber à 66 % si 10 % des mots ont été remplacés par des synonymes. Remplacer 25 % des mots fait chuter le taux à 17 %. Ce qui est logique, au vu du fonctionnement du filigrane.
L’entreprise prévient aussi que les filigranes sur le texte ne sont pas la panacée. Un watermark ne mesure pas la contribution d’un humain, il se contente de dire qu’un modèle a généré ou modifié un texte. Il ne détermine pas non plus à qui appartient le texte ou qui en est le responsable. Il n’identifie pas non plus l’utilisateur et ne mesure pas la fiabilité du texte. Enfin, l’absence d’un filigrane ne prouve pas qu’un texte a été écrit par un humain.
textGrain est disponible dès aujourd’hui dans l’API, où la fonction peut être activée via les réglages (uniquement dans l’UE). Il se déploiera au sein de ChatGPT et Codex dans les prochaines semaines. En revanche, l’accès à l’outil de détection demeure encore la chasse gardée des chercheurs et des organisations sélectionnés qui travaillent à l’amélioration de la fiabilité de l’outil.
ChatGPT, Claude ou Gemini ont une mémoire qui leur permettent d’enregistrer certaines informations importantes sur leurs utilisateurs, afin de se « souvenir » d’un détail, d’un nom, d’un événement ou d’une date utile à une réponse. C’est le cas aussi de Muse, mais le nouvel agent de Meta pousse le principe beaucoup plus loin.
Avec Muse, Meta semble enfin avoir trouvé sa voie dans la course à l’IA. L’agent, lancé le 6 septembre mais toujours indisponible dans l’Union européenne, va bien plus loin qu’un « simple » chatbot : il peut chasser des informations sur internet en permanence et agir au nom de l’utilisateur, par exemple pour réserver un restau ou faire des courses (ce qui déplaît beaucoup à Amazon). Le succès de Muse ne tombe pas du ciel : Meta s’est fortement inspirée d’OpenClaw pour développer son propre agent. Et l’entreprise peut aussi compter sur l’immense surface de ses réseaux sociaux pour se donner une confortable longueur d’avance.
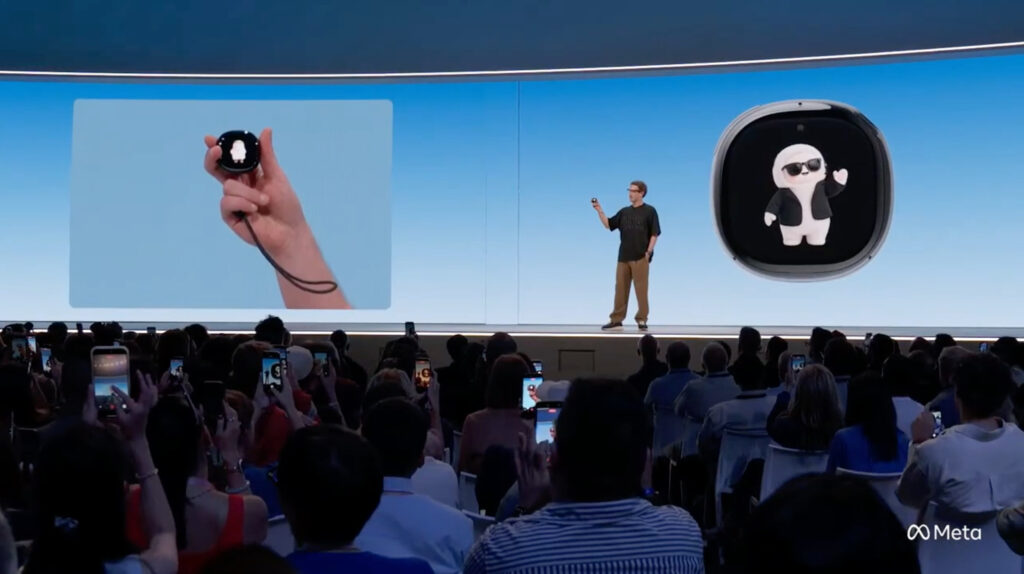
Le Charm dévoilé par Mark Zuckerberg durant la dernière conférence Meta Connect.
Le succès de Muse n’est pas tombé dans l’oreille d’un sourd : OpenAI a présenté pas plus tard que la semaine dernière son propre agent IA, Dots. Et Meta compte bien battre le fer tant qu’il est chaud. Muse est mis à toutes les sauces dans les autres produits et services du groupe, qu’il s’agisse de lunettes connectées… ou de Tamagotchi.
Les petites fiches de Muse
Mais Meta traîne derrière elle suffisamment de casseroles sur la vie privée pour que le fonctionnement de Muse mérite qu’on y regarde de plus près. Karan Joshi, chercheur en sécurité indépendant, a pu extraire un grand volume d’instructions et de prompts de l’agent, simplement en utilisant astucieusement l’interface de discussion. Il en a partagé une copie avec Wired, ce qui permet de jeter un œil dans les cuisines.
Il se trouve que Muse crée une page pour chaque personne importante dans la vie de l’utilisateur. Il s’agit de compiler des informations sur la famille, les intimes, les amis, les collègues, les personnes suivies par l’utilisateur. Cette mémoire, en fait des fichiers de texte structuré, se remplit au fur et à mesure des événements et des interactions ; ces données permettent à l’agent de construire une « représentation » des relations, avec le degré de proximité, l’historique, et même des pistes pour les renforcer.
D’après la documentation fournie par Karan Joshi, une « page » s’enrichit progressivement avec des sections : « Faits », « Historique », « Relation », « Points communs », « Sujets en suspens » et « Renforcement ». Muse doit uniquement utiliser les éléments qu’il a sous la main, et ne pas inventer des informations même si la page est vide.
Selon les instructions de Meta, Muse doit conserver « les sujets qui reviennent régulièrement (le déménagement, l’objectif commun d’épargne) », où vivent les relations de l’utilisateur, ce qu’elles font dans la vie. Le modèle peut également enregistrer les dates importantes comme les anniversaires, et des éléments de contexte comme une dispute terminée (certains parlent de beaucoup de choses très personnelles avec leur bot), une réunion importante la semaine dernière, un voyage…
L’enregistrement de l’état des relations est aussi manifestement important pour Muse : degré de proximité, sur quoi repose telle relation, ce dont cette relation peut avoir besoin… La section « Renforcements » peut d’ailleurs suggérer des moyens d’améliorer une relation : rappeler une date à ne pas oublier, une raison d’appeler…
Le plombier n’a rien demandé
« Pour qu’un agent soit utile et puisse réellement vous aider à atteindre vos objectifs, il doit disposer d’un certain contexte sur vous et sur les personnes avec lesquelles vous interagissez », explique un porte-parole de Meta. « Muse rassemble ces informations à partir de données publiques et de ce que vous avez choisi de partager. C’est ainsi qu’il peut se souvenir que la personne qui vous a envoyé une facture est en fait le plombier que vous aviez précédemment engagé pour effectuer des travaux dans votre salle de bains, ou encore l’envoi à votre conjoint de ses fleurs préférées. »
Une déclaration apparemment de bon sens, à laquelle on peut ajouter l’infrastructure de Muse. Il s’agit d’une machine virtuelle dans laquelle sont stockés les données de l’utilisateur et le contexte. Les agents tiers n’y ont pas accès sans autorisation, et l’utilisateur peut déconnecter les services tiers connectés à Muse, ou tout simplement en effacer la mémoire.
Muse va néanmoins plus loin que d’autres bots IA dans le stockage d’informations sur les personnes connues de l’utilisateur. ChatGPT possède une mémoire structurée, mais OpenAI la présente comme une synthèse évolutive du contexte entourant l’utilisateur. L’IA sélectionne les infos jugées pertinentes et la synthèse se met à jour et s’enrichit au fil du temps.
Le système de Meta organise les informations sur la relation qu’entretient un utilisateur avec une personne, leur historique, le degré de proximité, les sujets en suspens et peut même proposer des moyens de renforcer cette relation. Le problème ici, c’est la réputation exécrable de Meta quand il s’agit de manipuler les données personnelles, comme on l’a vu encore très récemment avec… Muse :
Enfin, le conjoint, les collègues, ou ce fameux plombier n’ont rien demandé, et surtout pas à être intégrés dans les petites fiches de Muse. Mais il suffit que l’utilisateur ait évoqué ces relations pour que ces personnes se retrouvent dans la mémoire de l’agent. L’utilisateur a certes accepté de partager des données publiques, mais pas nécessairement de ficher son entourage.

 Connexion