Des agents IA par-ci, des agents par là… les entreprises d’IA générative ont toutes ce mot à la bouche. On parle également de plus en plus de harnais. Mais de quoi s’agit-il ? Next vous explique !
L’intelligence artificielle existe depuis des décennies, elle remonte même aux années 1950. Après quelques « hivers » – des périodes durant lesquelles l’IA stagne et se fait oublier, elle a fait un bond avec l’arrivée des cartes graphiques modernes. En 2022, le grand public est entré de plein fouet dans l’ère de l’intelligence artificielle générative (ou GenAI), capable de produire du texte et des contenus multimédias et propulsée par ChatGPT.
De l’IA générative, nous voilà désormais dans l’ère de l’IA agentique. Pour la CNIL, il s’agit d’un « ensemble de systèmes qui reposent sur la coordination de plusieurs sous-systèmes appelés agents IA ». Ces agents sont bien plus qu’une IA générative, ils sont capables « d’agir sur un environnement défini […] et d’en modifier l’état […], avec des niveaux variables d’autonomie ».
Un agent IA, c’est un harnais avec un modèle d’IA générative
Si l’IA générative produit du texte et du contenu multimédia, un agent IA va en plus pouvoir exécuter des actions, en s’appuyant sur cette même IA. On touche du doigt la notion de harnais, qui est l’infrastructure logicielle. Le modèle d’IA générative et le harnais forment un agent IA. S’il se dégage un consensus sur le harnais, il n’existe pas (encore) de définition précise ; il faut dire que le terme est récent et n’est utilisé couramment que depuis le début de l’année.
Il reste 76% de l'article à découvrir. Vous devez être abonné•e pour lire la suite de cet article. Déjà abonné•e ? Générez une clé RSS dans votre profil.
Nouvelle mouture pour le « petit modèle » d’Anthropic, Haiku. Moins spectaculaire qu’un nouvel Opus, cette version était attendue pour ses tarifs accessibles. Le bond en performances est majeur, mais plusieurs points sont à connaître.
Présenté ce 7 octobre, Haiku 5.5 est ainsi mis en avant par Anthropic comme son modèle le moins cher, le plus rapide et le plus « capable ». Il est destiné aux tâches à fort volume (résumés, compaction, requêtes de bases de données, classification…) et peut servir de sous-agent pour Opus/Sonnet 5.5. Il est aussi conçu pour les usages sensibles à la latence comme l’assistance client et le pilotage de navigateur.
Haiku a bien changé
Cela faisait quand même près d’un an qu’Anthropic n’avait pas mis à jour ce modèle, depuis Haiku 4.5 (aucune version 5 n’avait été lancée). L’attente en valait-elle la peine ? Sur le papier, le bond est majeur. Haiku 5.5 présente ainsi une fenêtre de contexte d’un million de tokens (jetons) et de 128 000 en sortie, contre respectivement 200 000 et 64 000 pour Haiku 4.5. Le nouveau venu se dote pour la première fois d’un réglage d’effort, calé sur « Moyen » par défaut.
Côté tarifs, on reste sur une approche agressive, avec 0,10 dollar par million de tokens en entrée et 0,50 dollar en sortie. Mais attention, ces chiffres ne concernent que les requêtes inférieures à 100 000 tokens. Au-delà de cette frontière, les tarifs sont multipliés par 5, tout en restant inférieurs à ceux de Haiku 4.5 (la moitié en moyenne). Selon Anthropic, 90 % des requêtes adressées à Haiku 4.5 étaient sous le seuil des 100 000 jetons.
Si la baisse de prix est réelle, elle est aussi conditionnelle. Haiku 5.5 est plus verbeux que son prédécesseur, selon Artificial Analysis. Tout dépend aussi désormais du niveau d’effort configuré. Mais si l’on en croit le testeur indépendant, Haiku 5.5 présente un coût par tâche systématiquement plus intéressant que l’ancien Haiku. Anthropic positionne d’ailleurs Haiku 5.5 face à GPT-6 Luna, contre lequel il se montre plus avantageux. Mais là encore attention, car la majoration tarifaire sur Luna intervient à 272 000 tokens, contre 100 000 « seulement » pour Haiku.
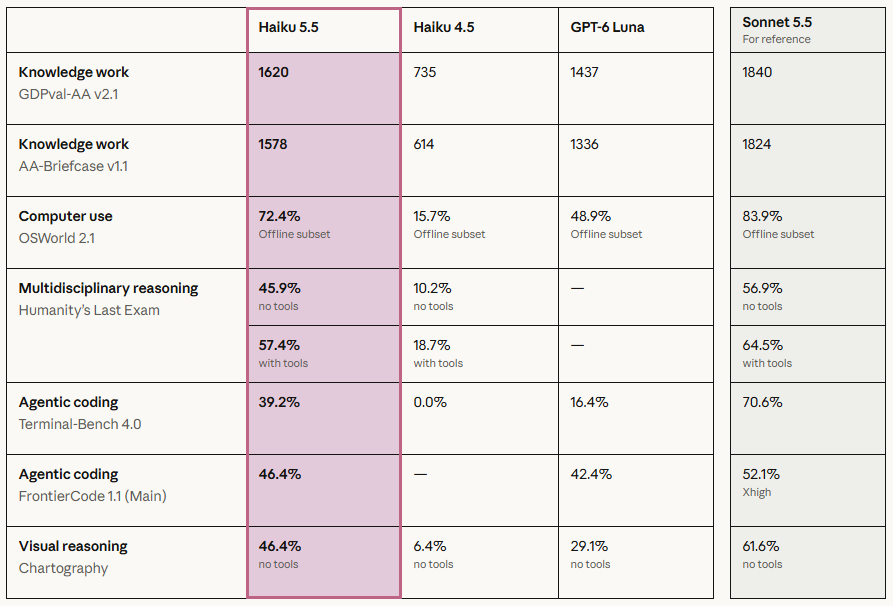
Côté performances, Anthropic met en avant un bond assez spectaculaire dans les différents benchs. Par exemple, un score de 39,2 % sur Terminal-Bench 4.0 (développement agentique), contre 0 pour Haiku 4.5. De l’ancien modèle au nouveau, on relève un passage de 735 à 1 620 sur GDPval-AA v2.1, de 15,7 à 72,4 % sur OSWorld 2.1, ou encore de 6,4 à 46,4 % sur Chartography.
Source : Anthropic
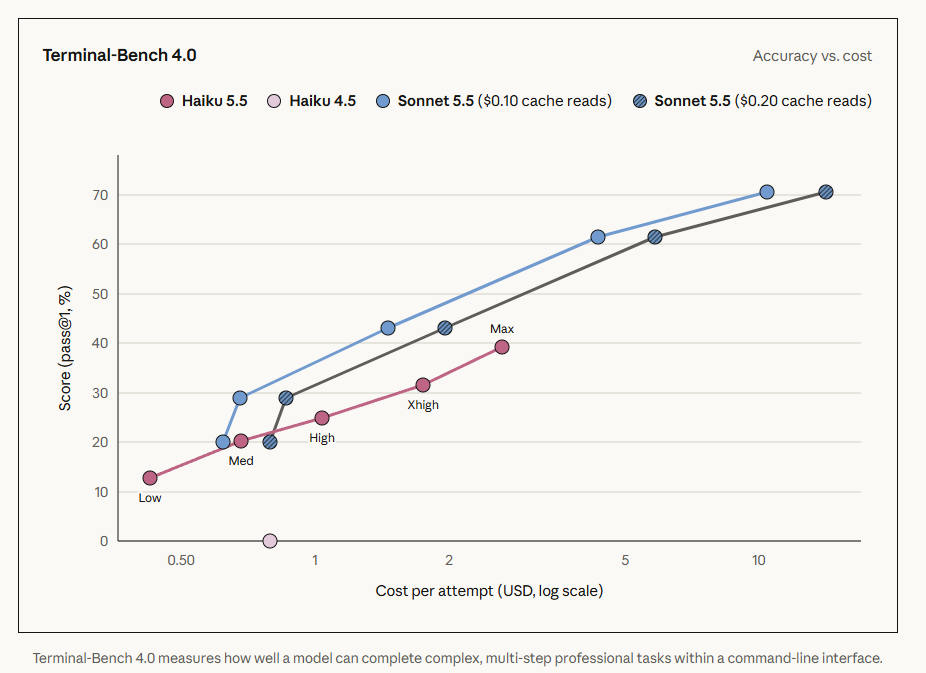
« Capable » semble donc être le mot, mais il faut souligner un point important : les scores affichés dans le tableau fourni par Anthropic sont tous en effort maximal. On peut le voir facilement dans le graphique plus bas dans la page de l’annonce : sur les exemples donnés, l’entreprise relève toujours le score correspondant à l’effort Max. Mieux vaut garder ce détail en mémoire, car les scores n’ont bien sûr rien à voir en « Moyen » (le mode par défaut), le score Terminal-Bench 4.0 étant par exemple divisé par deux, avec 20,3.
Source : Anthropic
En outre, le seul effort mentionné dans le tableau est dans la colonne de Sonnet 5.5, donnée en référence : 52,1 % en Xhigh sur FrontierCode 1.1. Une manière sans doute d’attirer l’attention sur les performances de Haiku 5.5, qui obtient 46,4 % sur ce test, donc avec un écart de moins de 6 points. Impressionnant ? En quelque sorte, mais sur Terminal-Bench 4.0, Sonnet 5.5 grimpe à 70,6 % (niveau d’effort inconnu), contre 39,2 % pour Haiku. L’écart est cette fois énorme.
Comme l’indique Anthropic dans son annonce, ces résultats ne sont donnés qu’à titre de « référence », car Haiku 5.5 « convient mieux aux tâches plus étroites qui auraient autrement été coûteuses avec les versions précédentes de Claude – comme la compaction, la synthèse ou le travail sur les sous-agents ».
Un mot enfin sur la cybersécurité. Selon l’éditeur, les garde-fous de cybersécurité sont plus stricts que ceux de Haiku 4.5, mais moins que ceux de Sonnet 5.5. Ils autorisent davantage de tâches défensives et bloquent toujours les tests d’intrusion. Peut-être une manière de faire un clin d’œil à Hugging Face, qui avait fustigé l’impossibilité d’utiliser les modèles commerciaux américains pour se défendre, alors qu’elle était attaquée par des agents d’OpenAI.
Anthropic a profité de son annonce sur Haiku 5.5 pour annoncer plusieurs changements tarifaires qui, dans certains cas, peuvent avoir une influence importante pour les projets exploitant l’API commerciale (facture à l’usage).
Le tarif pour la lecture de cache dans Sonnet 5.5 est ainsi réduit de moitié, « ce qui signifie que Sonnet 5.5 coûte désormais environ 20 % moins cher sur la plupart des travaux d’agent » affirme Anthropic.
L’entreprise déploie également un nouveau crédit API mensuel pour les abonnements Max et Team sur la Claude Platform. Les utilisateurs Max 5x recevront 100 dollars de crédits par mois, les Max 20x auront 200 dollars et les Teams auront jusqu’à 500 dollars, à répartir entre les utilisateurs. « Ces crédits sont conçus pour permettre à nos utilisateurs d’expérimenter la création d’outils, d’applications et d’agents qui appellent notre API », indique Anthropic.
Enfin, les SDK (kits de développement) pour Python et TypeScript ont été mis à jour pour ajouter la prise en charge de l’utilisation de l’ordinateur et du navigateur. Il s’agit pour l’instant de bêtas, et Anthropic braque la lumière sur Haiku 5.5, décrit comme « particulièrement adapté » à ce type d’usage.

 Connexion